阅读时间:约 45 分钟 难度:进阶 前置知识:Java 基础、网络编程基础、分布式系统概念
一、开篇:从一个远程调用说起
假设你写了一个 UserService.getUserById(long id) 方法,当这个方法在本地 JVM 内调用时,一切都很简单——传参、压栈、执行、返回。但如果 UserService 部署在另一台机器上,你需要通过网络让远端机器执行这个方法并拿回结果,事情就变复杂了。
RPC(Remote Procedure Call,远程过程调用)要解决的核心问题就是:让远程方法调用像本地方法调用一样简单。这句话看似简单,背后却牵涉一整套技术栈:
调用方(Consumer)                         服务方(Provider)
┌──────────────┐                          ┌──────────────┐
│  Business    │                          │  Business    │
│  Logic       │                          │  Logic       │
├──────────────┤                          ├──────────────┤
│  Stub/Proxy  │  ─── 网络传输 ───→       │  Skeleton    │
├──────────────┤                          ├──────────────┤
│ 序列化/反序列化│                         │ 序列化/反序列化│
└──────────────┘                          └──────────────┘
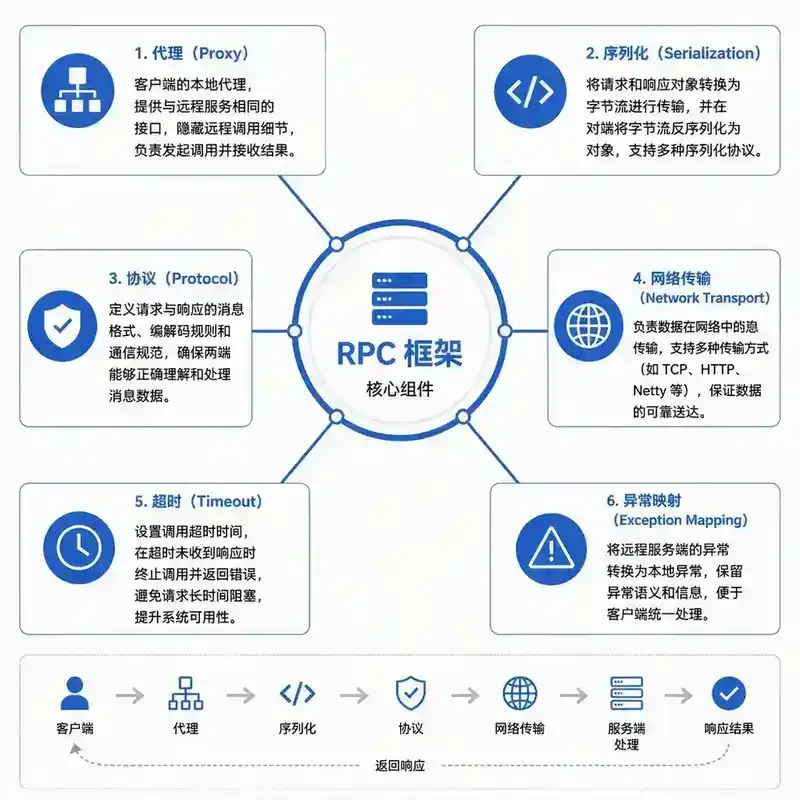
本文将从六个维度拆解 RPC 的底层原理,贯穿 Dubbo、gRPC 等主流框架的实现细节,帮助你建立完整的技术认知。
二、代理(Proxy):屏蔽远程调用的第一层魔法
2.1 为什么需要代理?
在 RPC 框架中,调用方拿到的只是一个接口引用,不存在实现类。但调用方却可以像调用本地对象一样调用这个接口的方法——这就是代理的作用。
代理对象拦截方法调用,把方法名、参数、类型等信息打包成 RPC 请求,通过网络发送给服务端,等待响应后返回结果。
// 调用方看到的代码——你以为在调本地方法
UserService userService = rpcClient.create(UserService.class);
User user = userService.getUserById(10086L);

// 实际上 userService 是一个代理对象
// 它的 invoke 方法里做了:
// 1. 构造 RpcRequest(methodName="getUserById", args=[10086L], ...)
// 2. 序列化请求
// 3. 发送网络请求
// 4. 等待响应
// 5. 反序列化结果
// 6. 返回给调用方
2.2 JDK 动态代理
Java 原生的动态代理基于 java.lang.reflect.Proxy 和 InvocationHandler:
public class RpcProxy implements InvocationHandler {
    private final Class<?> serviceInterface;
    private final String remoteHost;
    private final int remotePort;

    @Override

    public Object invoke(Object proxy, Method method, Object[ ] args) throws Throwable {

        // 1. 构造请求
        RpcRequest request = new RpcRequest();
        request.setInterfaceName(serviceInterface.getName());
        request.setMethodName(method.getName());
        request.setParameterTypes(method.getParameterTypes());
        request.setParameters(args);

        // 2. 网络调用
        RpcResponse response = networkClient.send(request);

        // 3. 返回结果
        if (response.getException() != null) {
            throw response.getException();
        }
        return response.getResult();
    }

    @SuppressWarnings("unchecked")
    public static <T> T create(Class<T> interfaceClass, String host, int port) {
        return (T) Proxy.newProxyInstance(
            interfaceClass.getClassLoader(),

            new Class[ ]{interfaceClass},

            new RpcProxy(interfaceClass, host, port)
        );
    }
}
JDK 动态代理的核心限制:只能代理接口,不能代理类。这是因为生成的代理类已经继承了 Proxy 类(Java 单继承),只能通过实现接口来扩展。
2.3 CGLIB 与 Javassist
当需要代理没有接口的类时,就需要字节码增强技术:
- CGLIB:通过生成目标类的子类来实现代理,基于 ASM 字节码框架。Spring AOP 在没有接口时会退化为 CGLIB 代理。
- Javassist:提供源码级别的字节码操作 API,Dubbo 早期版本使用 Javassist 生成代理类。
// CGLIB 代理示例
Enhancer enhancer = new Enhancer();
enhancer.setSuperclass(TargetClass.class);
enhancer.setCallback((MethodInterceptor) (obj, method, args, proxy) -> {
    // 前置处理:构造 RPC 请求
    RpcRequest request = buildRequest(method, args);
    RpcResponse response = sendRequest(request);
    return response.getResult();
});
TargetClass proxy = (TargetClass) enhancer.create();
2.4 Dubbo 中的代理工厂
Dubbo 使用 ProxyFactory 抽象代理创建,默认使用 Javassist:
// Dubbo 中获取代理的入口
// ProxyFactory 的 SPI 扩展点,默认 JavassistProxyFactory
public interface ProxyFactory {
    <T> T getProxy(Invoker<T> invoker) throws RpcException;
    <T> Invoker<T> getInvoker(T proxy, Class<T> type, URL url) throws RpcException;
}
Dubbo 的代理做了更多事情:集群容错、负载均衡、路由选择、过滤链——这些都在代理的 invoke 链路中串联。

2.5 代理的核心价值
代理不仅仅是"屏蔽网络细节",它在 RPC 框架中承担了以下关键职责:
| 职责 | 说明 |
|---|---|
| 接口绑定 | 将本地接口与远程服务关联 |
| 调用拦截 | 拦截方法调用,转换为 RPC 请求 |
| 服务治理 | 集成负载均衡、熔断、限流等治理能力 |
| 透明路由 | 根据注册中心信息选择目标节点 |
| 协议适配 | 根据配置选择不同的序列化和通信协议 |
三、序列化(Serialization):数据如何跨越网络
3.1 序列化的本质
序列化是将内存中的对象转换为可传输的字节流;反序列化则是将字节流还原为对象。在 RPC 中,序列化贯穿整个调用链路:
调用方 Java 对象 → [序列化] → 字节流 → [网络传输] → 字节流 → [反序列化] → 服务方 Java 对象
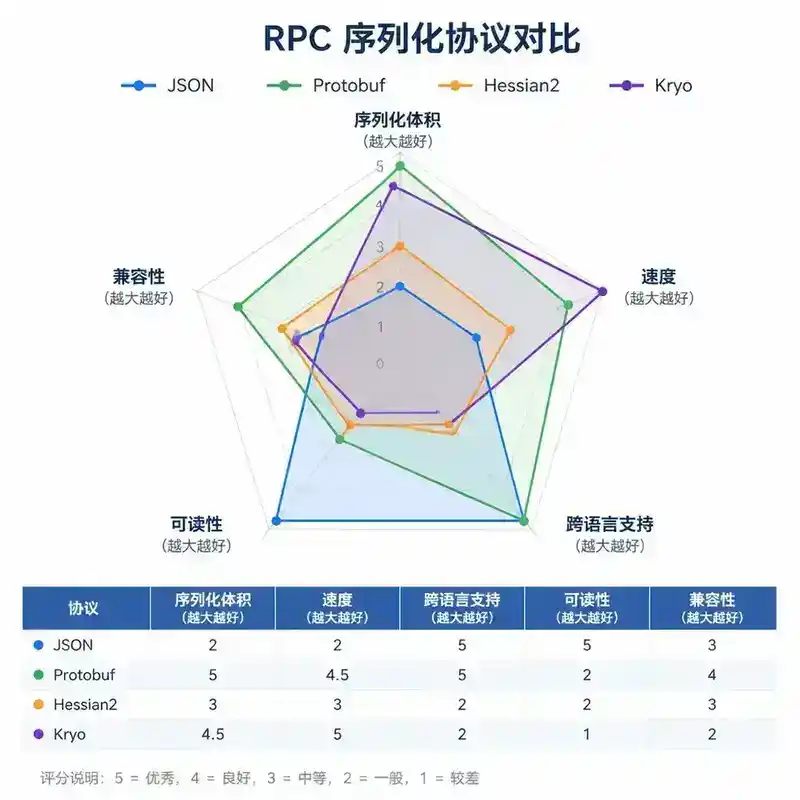
一个好的序列化协议需要权衡以下指标:
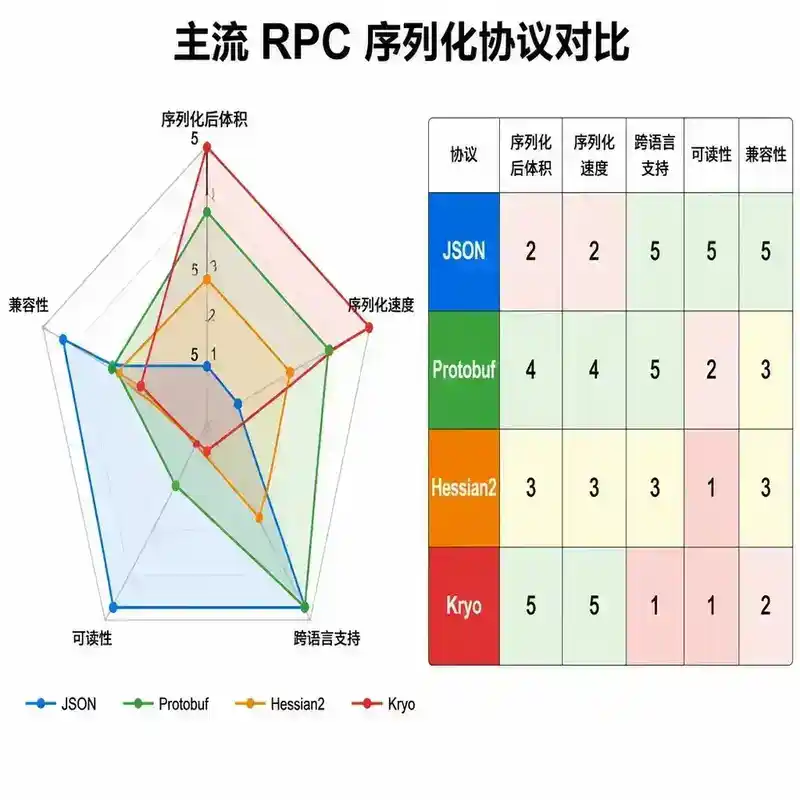
| 维度 | 含义 |
|---|---|
| 序列化后体积 | 越小越好,节省带宽和存储 |
| 序列化/反序列化速度 | 越快越好,降低 CPU 开销和延迟 |
| 跨语言支持 | 异构系统间互通能力 |
| 兼容性 | 向前/向后兼容,支持字段增删 |
| 可读性 | 调试和问题排查的便利性 |
3.2 主流序列化协议对比
JSON(Jackson / Fastjson / Gson)
// 序列化
User user = new User("张三", 25);
String json = JSON.toJSONString(user);
// → {"name":"张三","age":25}

// 反序列化
User user2 = JSON.parseObject(json, User.class);
- 优点:可读性强,跨语言,生态成熟
- 缺点:体积大(字段名重复),速度慢,不支持复杂类型(如
java.sql.Timestamp需要额外处理) - 适用场景:HTTP REST API、配置数据、前后端交互
Protobuf(Protocol Buffers)
// 定义 .proto 文件
message User {
  int64 id = 1;
  string name = 2;
  int32 age = 3;
}
- 优点:体积极小(基于 varint 和 tag-length-value 编码),速度极快,强类型,向后兼容
- 缺点:需要预定义 schema,可读性差(二进制),额外构建步骤
- 适用场景:gRPC 默认协议、高性能内部服务通信
Hessian2
// Dubbo 默认序列化协议
Hessian2Output out = new Hessian2Output(outputStream);
out.writeObject(user);
out.flush();
- 优点:跨语言(Java、PHP、C++),二进制传输,自描述(不需要 schema)
- 缺点:兼容性隐患(字段变更需谨慎),某些 Java 对象序列化不完美
- 适用场景:Dubbo 默认序列化,Java 为主的微服务生态
Kryo
Kryo kryo = new Kryo();
Output output = new Output(new ByteArrayOutputStream());
kryo.writeObject(output, user);
- 优点:速度极快(比 Hessian 快 2-3 倍),体积小,支持任意 Java 对象
- 缺点:线程不安全(需池化),跨语言支持弱,非线程安全的实例需 ThreadLocal 隔离
- 适用场景:Java 内部高性能场景,如 Spark、Flink 的序列化
3.3 序列化协议选型决策树
需要跨语言? ─┬─ 是 → 选择 Protobuf(性能优先)或 JSON(可读性优先)
              │
              └─ 否(纯 Java 生态)→
                  ├─ 极致性能 → Kryo
                  ├─ 平衡性能与兼容性 → Hessian2
                  └─ 调试/HTTP 接口 → JSON
3.4 序列化的深层问题
泛型擦除:Java 泛型在编译后会被擦除,序列化时丢失类型信息。例如 List<User> 在字节码层面只是 List。Dubbo 通过在请求中携带参数类型签名来解决。
循环引用:对象 A 引用 B,B 又引用 A。JSON 直接序列化会栈溢出,Hessian 和 Kryo 通过引用追踪来处理。

版本兼容:服务端新增字段,旧客户端不传。Protobuf 通过 optional 字段天然支持,JSON 通过 @JsonIgnoreProperties(ignoreUnknown = true) 处理,Hessian 需要谨慎处理字段顺序。
四、协议(Protocol):约定通信的"语言"
4.1 RPC 协议解决什么问题?
网络传输的是字节流,服务端收到一串字节后,需要知道:这是哪个服务的哪个方法?参数是什么?请求 ID 是多少?协议就是定义这些信息的格式约定。
4.2 协议设计的核心要素
一个典型的 RPC 协议帧包含以下部分:
┌──────────────┬──────────────┬──────────────┬──────────────┬──────────────┐
│  Magic Number│  Header      │  Body Length │  Header Data │  Body Data   │
│  (2 bytes)   │  (1 byte)    │  (4 bytes)   │  (variable)  │  (variable)  │
└──────────────┴──────────────┴──────────────┴──────────────┴──────────────┘
| 字段 | 说明 |
|---|---|
| Magic Number | 魔数,用于快速识别协议类型,过滤非法请求 |
| Header | 协议版本、消息类型(请求/响应/心跳)、序列化方式、压缩方式 |
| Body Length | 消息体长度,用于 TCP 粘包拆包处理 |
| Header Data | 扩展头部,携带链路追踪 ID、调用方信息等 |
| Body Data | 序列化后的业务数据 |
4.3 Dubbo 协议详解
Dubbo 默认协议(dubbo://)是专门为 RPC 设计的私有协议:
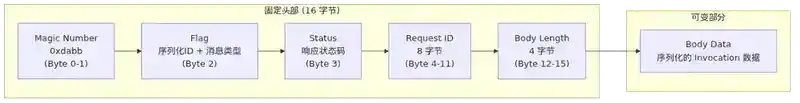
Dubbo 协议帧(共 16 字节固定头部 + 可变部分)
Byte 0-1:  Magic Number (0xdabb)
Byte 2:    Flag (序列化 ID + 消息类型)
Byte 3:    Status (响应状态码)
Byte 4-11: Request ID (8 字节,long 类型)
Byte 12-15: Body Length (4 字节,int 类型)

= 变长部分
Data: 序列化后的 Invocation 数据(接口名、方法名、参数类型、参数值)
Dubbo 协议的设计特点:
- 紧凑:固定头部仅 16 字节,比 HTTP 协议头部小得多
- 单连接复用:一个 TCP 连接可以同时承载多个请求(通过 Request ID 区分)
- 异步非阻塞:天然的异步通信模型,不阻塞 IO 线程
- 心跳保活:协议层面支持心跳,减少连接重建开销
4.4 gRPC 的协议选择——HTTP/2
gRPC 基于 HTTP/2,利用其特性:
- 多路复用:一个 TCP 连接上并发多个 Stream,互不阻塞
- 头部压缩(HPACK):减少重复头部传输
- 双向流:支持客户端流、服务端流、双向流
- Server Push:服务端可以主动推送(虽然实际使用较少)
// gRPC 的服务定义
service UserService {
  // 一元 RPC
  rpc GetUser (GetUserRequest) returns (GetUserResponse);

  // 服务端流式 RPC
  rpc ListUsers (ListUsersRequest) returns (stream User);

  // 客户端流式 RPC
  rpc BatchCreateUsers (stream CreateUserRequest) returns (BatchCreateUserResponse);

  // 双向流式 RPC
  rpc Chat (stream ChatMessage) returns (stream ChatMessage);
}
4.5 协议层关键设计决策
定长 vs 变长头部:定长头部解析简单、性能高,但扩展性弱;变长头部(如 HTTP/2 的 HPACK)扩展性好,但解析复杂。
粘包拆包策略:
- 固定长度:每个帧固定大小,简单但浪费空间
- 分隔符:用特殊字符分隔(如 Redis 的
\r\n),不适合二进制数据 - 长度字段:头部携带 Body 长度,这是 RPC 协议最常用的方案
协议版本协商:多版本协议共存时,客户端和服务端如何协商使用哪个版本?Dubbo 通过 URL 参数指定,gRPC 通过 HTTP/2 的 SETTINGS 帧。
五、网络传输(Network Transport):数据的"高速公路"
5.1 RPC 的网络通信模型
RPC 框架需要一个高性能的网络通信层来承载协议数据。度量指标包括:
- 吞吐量:单位时间处理多少请求
- 延迟:单个请求从发送到收到响应的耗时
- 连接数:支持多少并发连接
- 稳定性:连接断开、超时、重连的处理能力
┌──────────────────────────────────────┐
│            RPC 框架层                │
│  (Dubbo / gRPC / Thrift)            │
├──────────────────────────────────────┤
│            协议层                    │
│  (Dubbo Protocol / HTTP/2)          │
├──────────────────────────────────────┤
│          网络传输层                  │
│  (Netty / Mina / JDK NIO)           │
├──────────────────────────────────────┤
│          操作系统                    │
│  (TCP/IP Stack / epoll)             │
└──────────────────────────────────────┘
5.2 Netty——RPC 网络传输的事实标准
绝大多数 Java RPC 框架(Dubbo、gRPC-Java、Motan、Sofa-RPC)都基于 Netty 构建网络层。Netty 的核心优势:
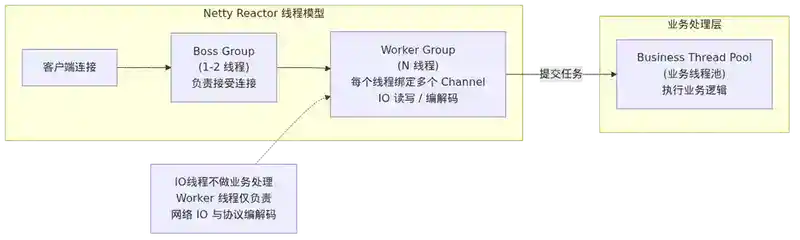
Reactor 线程模型:
                    ┌─────────────┐
                    │  Boss Group  │  ← 接受连接,注册到 Worker
                    │ (1-2 threads)│
                    └──────┬───────┘
                           │
           ┌───────────────┼───────────────┐
           │               │               │
    ┌──────▼──────┐ ┌──────▼──────┐ ┌──────▼──────┐
    │ Worker      │ │ Worker      │ │ Worker      │  ← 处理 IO 读写
    │ Thread      │ │ Thread      │ │ Thread      │
    └──────┬──────┘ └──────┬──────┘ └──────┬──────┘
           │               │               │
    ┌──────▼──────┐ ┌──────▼──────┐ ┌──────▼──────┐
    │ Channel     │ │ Channel     │ │ Channel     │  ← 每个连接绑定一个线程
    │ Pipeline    │ │ Pipeline    │ │ Pipeline    │
    └─────────────┘ └─────────────┘ └─────────────┘
ChannelPipeline 责任链:
// Netty 的 Handler 链
pipeline.addLast("decoder", new RpcDecoder());      // 解码
pipeline.addLast("encoder", new RpcEncoder());      // 编码
pipeline.addLast("idleHandler", new IdleStateHandler(60, 0, 0)); // 心跳
pipeline.addLast("handler", new RpcServerHandler()); // 业务处理
零拷贝:Netty 的 CompositeByteBuf 和 FileRegion 减少数据在用户态和内核态之间的拷贝,DirectByteBuffer 直接操作堆外内存。
5.3 连接管理
RPC 框架的连接管理策略直接影响性能和稳定性:
连接池 vs 单连接复用:
单连接复用(Dubbo 默认):
Consumer ──[单 TCP 连接]──> Provider
  ├─ Request#1 (id=1001)
  ├─ Request#2 (id=1002)
  └─ Request#3 (id=1003)
  → 通过 Request ID 匹配请求和响应

连接池(gRPC 推荐):
Consumer ──[连接池]──> Provider
  ├─ Connection#1 → Request#1
  ├─ Connection#2 → Request#2
  └─ Connection#3 → Request#3
  → 每个连接串行,多连接并行
连接数计算:连接数 = 单机 QPS × 平均响应时间(秒) + 冗余
例如单机 QPS=1000,平均 RT=10ms,则单连接可承载 1000/0.01=100,000 QPS,远超过需求。但实际需要预留连接以应对突发,通常 2-4 个连接足够。
连接保活与心跳:
Provider 端:IdleStateHandler 检测读空闲
  → 60s 未收到数据 → 关闭连接

Consumer 端:定时发送心跳(通常 30s 间隔)
  → 心跳包:协议头的 Flag 标记为心跳类型
  → 无 Body,仅消耗极少的网络带宽
5.4 I/O 线程与业务线程隔离
这是 RPC 性能的关键设计——I/O 线程不能做业务处理:
// 错误做法:在 Netty 的 I/O 线程中执行业务逻辑
// 会阻塞 I/O 线程,导致其他连接无法读写
public class BadHandler extends ChannelInboundHandlerAdapter {
    @Override
    public void channelRead(ChannelHandlerContext ctx, Object msg) {
        // 这里直接调用业务方法——大忌!
        Object result = userServiceImpl.getUserById(request.getId());
        ctx.writeAndFlush(result);
    }
}

// 正确做法:将业务处理提交到业务线程池
public class GoodHandler extends ChannelInboundHandlerAdapter {
    private final ExecutorService bizThreadPool;

    @Override
    public void channelRead(ChannelHandlerContext ctx, Object msg) {
        bizThreadPool.execute(() -> {
            Object result = userServiceImpl.getUserById(request.getId());
            ctx.writeAndFlush(result);
        });
    }
}
Dubbo 中,Netty 的 I/O Worker 线程只负责编解码和网络读写,业务逻辑在 Dubbo 的业务线程池中执行,线程池隔离保证了 I/O 和业务的性能互不干扰。
六、超时(Timeout):分布式系统的"保险丝"
6.1 为什么超时至关重要?
在分布式系统中,没有超时保护的调用是一条"不归路":
没有超时:
  客户端线程 → 发起 RPC 调用 → 服务端挂起/死锁 → 客户端线程永久阻塞
  → 线程池耗尽 → 整个服务不可用 → 级联故障

有超时:
  客户端线程 → 发起 RPC 调用 → 超时(1s) → 抛出 TimeoutException
  → 线程释放 → 降级/重试 → 服务部分降级但可用
超时不是一个简单的参数,而是一个系统性的设计决策。
6.2 超时机制的实现层次
RPC 框架中的超时实现在多个层次:
层级 1: 客户端调用超时
  userService.getUserById(id, timeout=1000ms)
  → 整个调用链的总超时,包括网络、序列化、服务端处理

层级 2: 连接超时
  → 建立 TCP 连接的超时,通常 100-500ms

层级 3: 读写超时
  → Socket read/write 的超时,避免半开连接永久阻塞

层级 4: 服务端处理超时
  → 服务端执行业务逻辑的超时,防止慢请求拖垮线程池
6.3 Netty 中的超时实现
// Netty 的超时基于 HashedWheelTimer(时间轮算法)
// 发送请求时注册超时任务
public class RpcClient {
    private final HashedWheelTimer timer = new HashedWheelTimer();

    public RpcResponse send(RpcRequest request, long timeoutMs) {
        RpcFuture future = new RpcFuture(request.getRequestId());
        FUTURES.put(request.getRequestId(), future);

        // 注册超时任务
        Timeout timeout = timer.newTimeout(t -> {
            RpcFuture f = FUTURES.remove(request.getRequestId());
            if (f != null) {
                f.setException(new TimeoutException("Request timeout after " + timeoutMs + "ms"));
            }
        }, timeoutMs, TimeUnit.MILLISECONDS);

        // 发送请求
        channel.writeAndFlush(request);

        // 阻塞等待响应或超时
        try {
            return future.get(timeoutMs, TimeUnit.MILLISECONDS);
        } finally {
            timeout.cancel(); // 响应到达后取消超时任务
        }
    }
}
6.4 超时传播(Deadline Propagation)
在微服务调用链中,超时需要在整个调用链中传播:
Client (timeout=3s)
  → Service A (timeout=3s - elapsed)
    → Service B (timeout=2.5s - elapsed)
      → Service C (timeout=2s - elapsed)
        → Service D (timeout=1.5s - elapsed)
gRPC 通过 gRPC Deadline 实现超时传播,每个下游服务都会收到"剩余时间":
// gRPC 的 Deadline 传播
// 调用方设置 3 秒超时
UserServiceGrpc.UserServiceBlockingStub stub =
    UserServiceGrpc.newBlockingStub(channel)
        .withDeadlineAfter(3, TimeUnit.SECONDS);

// 服务端收到的请求中携带了 deadline
// 如果服务端调用下游,会自动减去已用时间
public void getUser(GetUserRequest req, StreamObserver<User> resp) {
    // 获取剩余时间
    long remainingNanos = Context.current()
        .getDeadline().timeRemaining(TimeUnit.NANOSECONDS);
    // 使用剩余时间调用下游
    downstreamStub.withDeadlineAfter(remainingNanos, TimeUnit.NANOSECONDS)
        .getRelatedData(request);
}
6.5 超时时间设置原则
超时不是越短越好,也不是越长越好:
| 场景 | 建议超时 | 原因 |
|---|---|---|
| 实时查询接口 | 100-500ms | 用户体验要求高 |
| 内部服务调用 | 1-3s | 正常业务处理时间 |
| 异步任务 | 5-30s | 批量/耗时操作 |
| 数据同步 | 30-60s | 大数据量传输 |
黄金法则:超时时间 = P99 响应时间 × 2~3,但不超过上游调用方的超时时间。
6.6 超时与重试的协同
超时和重试必须配合使用,但需要谨慎:
// 超时重试的风险:服务端可能已经处理成功
// 只是响应超时,重试会导致重复执行

// 解决方案:幂等性设计
// 1. 请求携带幂等键(Idempotency-Key)
// 2. 服务端根据幂等键去重
// 3. 重试时使用相同的幂等键

// 示例:Dubbo 的幂等重试
public Result invoke(Invoker<?> invoker, Invocation invocation) {
    // 请求中携带唯一 ID
    String idempotentKey = invocation.getAttachment("idempotent-key");
    if (idempotentKey != null) {
        // 检查是否已处理过
        if (idempotentCache.contains(idempotentKey)) {
            return idempotentCache.get(idempotentKey);
        }
    }
    Result result = invoker.invoke(invocation);
    if (idempotentKey != null) {
        idempotentCache.put(idempotentKey, result);
    }
    return result;
}
七、异常映射(Exception Mapping):让错误可理解
7.1 RPC 中的异常分类
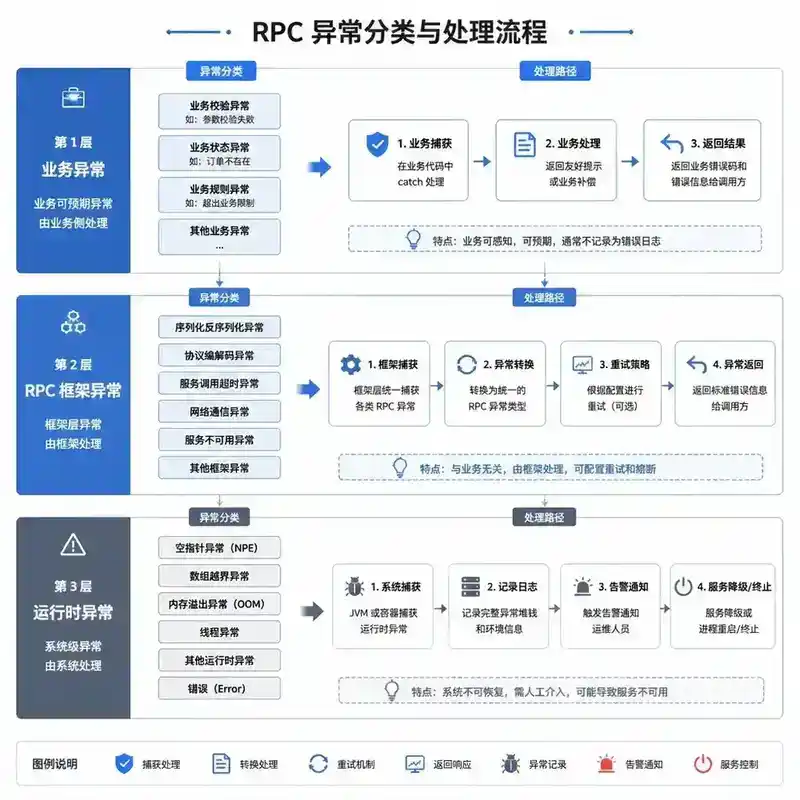
RPC 调用涉及的异常可以分为三类:
┌────────────────────────────────────────────┐
│              业务异常                       │
│  (UserNotFoundException,                   │
│   InsufficientBalanceException, ...)        │
│  → 服务端业务逻辑抛出的异常                  │
│  → 应该透传给调用方,调用方需要知道业务含义   │
├────────────────────────────────────────────┤
│              RPC 框架异常                   │
│  (RemotingException, TimeoutException,      │
│   SerializationException, ...)              │
│  → 框架层面的异常,与业务无关                │
│  → 通常触发重试或降级                       │
├────────────────────────────────────────────┤
│              运行时异常                     │
│  (NullPointerException,                     │
│   ClassCastException, ...)                  │
│  → 服务端代码 Bug,理论上不应该出现          │
│  → 需要告警和修复                           │
└────────────────────────────────────────────┘
7.2 异常序列化的挑战
Java 异常是对象,包含类型、消息、堆栈跟踪、cause 链。要在网络中传输异常,需要:
- 异常类型恢复:调用方可能不存在服务端抛出的异常类
- 堆栈保留:保留原始堆栈还是替换为调用方的堆栈?
- cause 链处理:嵌套异常需要完整传输
Dubbo 的异常处理策略:
// Dubbo 的 ExceptionFilter 处理异常
// 1. 如果是受检异常且在接口方法签名中声明 → 直接抛出
// 2. 如果是 RuntimeException → 直接抛出
// 3. 如果是接口签名中声明的受检异常 → 直接抛出
// 4. 其他异常 → 包装为 RuntimeException 抛出

// 异常序列化
// 异常类名 + 消息 + 堆栈 = 序列化传输
// 调用方反序列化时,如果本地没有对应的异常类
// → 使用 DecodeableRpcResult 中的通用异常包装
gRPC 的异常处理:使用标准状态码(io.grpc.Status),类似于 HTTP 状态码的设计:
// gRPC 服务端
public void getUser(GetUserRequest req, StreamObserver<User> resp) {
    try {
        User user = userService.getUser(req.getId());
        if (user == null) {
            resp.onError(Status.NOT_FOUND
                .withDescription("User not found: " + req.getId())
                .asRuntimeException());
            return;
        }
        resp.onNext(user);
        resp.onCompleted();
    } catch (Exception e) {
        resp.onError(Status.INTERNAL
            .withDescription(e.getMessage())
            .withCause(e)
            .asRuntimeException());
    }
}
7.3 异常映射的最佳实践
1. 区分业务异常和系统异常:
// 定义业务异常基类
public class BusinessException extends RuntimeException {
    private final int errorCode;
    private final String errorMessage;

    public BusinessException(int errorCode, String errorMessage) {
        super(errorMessage);
        this.errorCode = errorCode;
        this.errorMessage = errorMessage;
    }
}

// 具体业务异常
public class UserNotFoundException extends BusinessException {
    public UserNotFoundException(long userId) {
        super(10001, "用户不存在: " + userId);
    }
}

// 在 RPC 异常过滤器中处理
public class RpcExceptionFilter {
    public Result handleException(Throwable t) {
        if (t instanceof BusinessException) {
            BusinessException be = (BusinessException) t;
            return Result.error(be.getErrorCode(), be.getErrorMessage());
        }
        if (t instanceof TimeoutException) {
            return Result.error(50001, "调用超时,请稍后重试");
        }
        // 未预期的异常:返回通用错误码,记录日志,触发告警
        log.error("Unexpected exception in RPC call", t);
        alertingService.send("RPC异常", t.getMessage());
        return Result.error(50000, "系统繁忙,请稍后重试");
    }
}
2. 异常屏蔽:不要向调用方暴露服务端的内部细节(如数据库表名、SQL 语句、堆栈信息),防止信息泄露。
3. 异常传播链:多级 RPC 调用时,异常需要正确传播,丢失 cause 链会导致排查困难。
八、一个 RPC 调用的完整生命周期
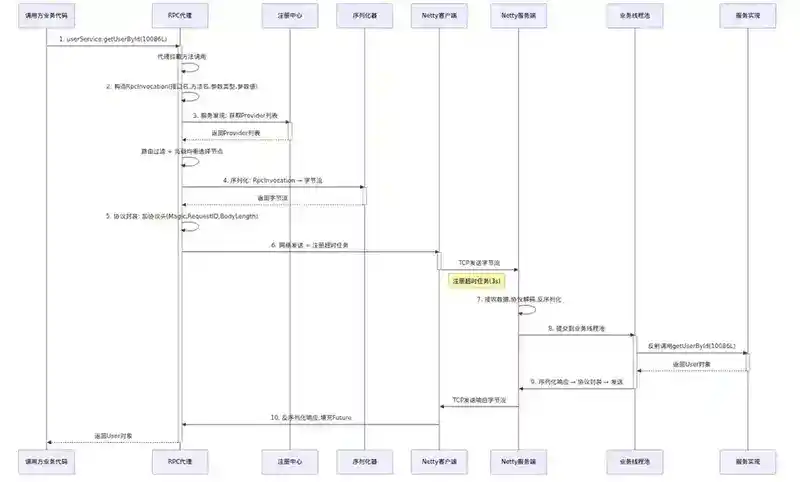
把以上六个维度串联起来,看一个完整的 RPC 调用流程:
步骤 1: 代理拦截
  userService.getUserById(10086L)
  → RpcProxy.invoke() 被调用

步骤 2: 构造请求
  → RpcInvocation {
      interfaceName: "com.example.UserService",
      methodName: "getUserById",
      parameterTypes: [long.class],
      arguments: [10086L],
      attachments: {traceId: "abc123", timeout: "3000"}
    }

步骤 3: 服务发现与路由
  → 从注册中心获取 Provider 列表
  → 根据路由规则过滤
  → 负载均衡选择一个节点

步骤 4: 序列化
  → RpcInvocation 对象 → 字节流(Hessian2/Protobuf/...)

步骤 5: 协议封装
  → 加上协议头(Magic Number, Request ID, Body Length, ...)

步骤 6: 网络发送
  → Netty channel.writeAndFlush()
  → 注册超时任务(3s)
  → 注册 Future 等待响应

步骤 7: 服务端接收
  → Netty Worker 线程读取数据
  → 协议解码 → 反序列化 → 得到 RpcInvocation

步骤 8: 服务端业务处理
  → 提交到业务线程池
  → 反射调用 UserServiceImpl.getUserById(10086L)
  → 返回 User 对象

步骤 9: 服务端响应
  → 序列化 User 对象 → 协议封装 → 网络发送

步骤 10: 客户端接收响应
  → 反序列化 → 填充 Future → 返回给调用方
九、生产实践与常见陷阱
9.1 序列化兼容性事故
案例:某团队在 UserInfo 中新增了一个 lastLoginIp 字段并部署了服务端,旧版客户端调用时报 NoSuchFieldError。
根因:Hessian2 序列化要求字段顺序严格一致。新增字段改变了序列化后的字节布局,旧客户端反序列化时字段位置错乱。
解决方案:
- 使用 Protobuf(天然支持字段新增)
- 或者在 Hessian2 中新增字段追加到末尾,并确保客户端升级兼容
9.2 超时设置不当导致的雪崩
案例:服务 A 调用服务 B 超时设为 5s,但服务 B 的 P99 为 3s。某次服务 B 慢查询导致 RT 升至 4s,服务 A 的线程池在 5s 内全部阻塞,新请求无法处理,服务 A 不可用。
修复:
- 服务 A 超时降到 2s(P99 × 2)
- 服务 B 加入慢查询熔断
- 服务 A 加入降级逻辑(返回缓存数据)
9.3 代理对象序列化问题
案例:Dubbo 调用返回了一个 CGLIB 代理对象,序列化时报错。
根因:CGLIB 生成的代理类包含 MethodInterceptor 等无法序列化的字段,跨网络传输时会失败。
解决:只传输数据对象(DTO),不传输代理对象和 Service 对象。
9.4 异常信息泄露
案例:生产环境 RPC 调用超时,返回的异常信息中包含了完整的 SQL 语句和表结构信息。
风险:如果异常信息被前端展示或记录在公开日志中,会造成严重的信息泄露。
修复:在异常映射层统一处理,对外只返回通用错误码和脱敏信息。
延伸阅读:
十、面试追问
以下问题从面试官视角设计,建议先独立回答再查看提示:
Q1:为什么 Dubbo 选择单连接复用而不是连接池?什么场景下连接池更好?
Q2:Protobuf 为什么比 JSON 快?从编码原理层面解释。
Q3:RPC 超时时间已经设置了,为什么还需要服务端的超时控制?
Q4:如果 RPC 调用返回了一个异常,如何判断这个异常应该重试还是不重试?
Q5:描述一下 Dubbo 的线程模型,为什么 Netty I/O 线程不能干业务活?
Q6:如何设计一个跨语言的 RPC 异常处理机制?
点击查看参考答案
A1:Dubbo 选择单连接复用是因为 Dubbo 协议的设计天然支持多路复用(通过 Request ID 区分请求),单连接可以减少 TCP 握手和挥手开销,降低服务端连接数压力。但连接池在以下场景更好:① 需要流量隔离(不同业务走不同连接避免相互影响);② 单连接 SEQ 性能瓶颈(高并发时单连接写锁竞争);③ 负载均衡粒度更细(每个连接可以被路由到不同的后端)。
A2:Protobuf 比 JSON 快的原因:① 编码方式:Protobuf 使用 varint 和 tag-length-value 二进制编码,JSON 是文本编码。JSON 中的数字 \ 需要 5 字节文本,Protobuf 的 varint 只需要 2 字节。② 字段名:JSON 每次传输都带字段名 \,Protobuf 用字段编号(tag)替代字段名,省去大量重复字符串。③ 解析:Protobuf 二进制直接映射到内存结构,JSON 需要词法分析、语法分析。④ 整数编码:Protobuf 的 varint 对小整数(如 1-127)只用 1 字节。
A3:RPC 客户端的超时覆盖的是端到端的时间,但服务端线程池可能被慢请求拖垮。如果只有客户端超时,客户端超时断开后,服务端线程仍然在消耗资源处理请求,当大量慢请求堆积时,服务端线程池耗尽,影响其他正常请求。服务端超时可以主动中断长时间运行的业务逻辑,释放线程资源。
A4:判断标准:① 业务异常→不重试(如库存不足、用户不存在);② 系统异常(超时、连接断开)→ 重试,但需保证幂等;③ 框架异常(序列化失败)→ 不重试,因为没有意义;④ 服务端明确返回当前不可用→ 重试其他节点。实现上,Dubbo 通过异常类名或异常类型判断是否重试,通常在集群容错层处理。
A5:Dubbo 的 Netty I/O 线程只负责 TCP 连接的读写、编解码、协议解析。如果 I/O 线程执行了耗时的业务逻辑(如数据库查询),该线程绑定的所有连接都无法被处理,导致超时和连接堆积。正确做法是 I/O 线程读完数据后立即提交到业务线程池,自己返回处理下一个请求。这是典型的 Reactor 模式:I/O 线程做调度,业务线程池做执行。
A6:跨语言 RPC 异常处理的核心挑战是不同语言的异常机制不同(Java 有 checked exception,Go 用 error 返回值,C++ 用异常类)。推荐方案:① 使用标准状态码(如 gRPC 的 Status Code),所有语言都支持;② 异常信息用 key-value 结构传输(code + message + details),不依赖语言特定的异常类;③ 对于需要携带额外信息的场景,使用 \ 或自定义的 error details;④ 在 SDK 层面将标准状态码映射为各语言习惯的异常/错误处理方式。