阅读时间:约 45 分钟 | 难度:中高级 | 分类:微服务与服务治理
目录
1. 引言:为什么负载均衡是分布式系统的"交通指挥"
想象一个场景:你运营着一个有 10 台服务器的电商网站,双十一当天涌入 100 万用户。如果所有请求都打到同一台服务器上,这台机器瞬间崩溃,而另外 9 台却闲着——这是最糟糕的资源浪费。负载均衡(Load Balancing)就是解决这个问题的核心机制。
负载均衡的本质:将一组任务(请求、连接、数据)尽可能均匀地分配到一组计算资源(服务器、服务实例、存储节点)上,目标是最大化资源利用率、最小化响应时间,同时避免任何单点过载。
1.1 负载均衡的四个层次
在分布式系统中,负载均衡可以在不同层次发挥作用:
| 层次 | 说明 | 典型实现 |
|---|---|---|
| 客户端负载均衡 | 客户端自己选择目标实例 | Ribbon、gRPC 客户端负载均衡 |
| DNS 负载均衡 | DNS 返回不同 IP 地址 | DNS 轮询、GeoDNS |
| 反向代理/网关层 | 7 层或 4 层代理分发流量 | Nginx、HAProxy、Envoy |
| 服务端负载均衡 | 注册中心下发实例列表,SDK 选择 | Dubbo(服务目录 + 路由 + 负载均衡) |
1.2 负载均衡算法的四个核心维度
在设计或选择算法时,需要关注四个维度:
- 均衡性:请求分布是否均匀
- 稳定性:节点上下线时,已建立映射是否被大量破坏
- 响应性:是否感知后端节点的实时负载
- 复杂度:计算开销和状态维护成本
不同的算法在这四个维度上有不同的取舍,没有银弹。
2. 轮询与加权轮询
2.1 轮询(Round Robin)
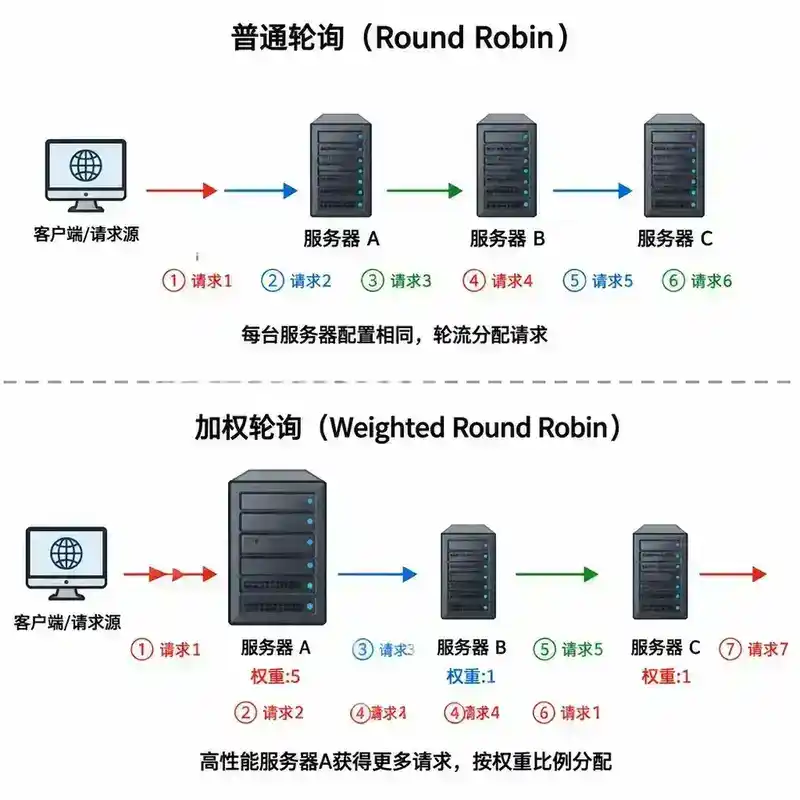
轮询是最简单的负载均衡算法:将请求按顺序依次分配给每个后端服务器。当分配到最后一个节点后,回到第一个节点重新开始。
核心实现:维护一个计数器(或原子索引),每次请求时 index = (index + 1) % N,选择对应服务器。
请求序列:1 → Server A, 2 → Server B, 3 → Server C, 4 → Server A, ...
Java 实现示例:
public class RoundRobinLoadBalancer {
    private final List<Server> servers;
    private final AtomicInteger position = new AtomicInteger(0);

    public Server select() {
        int pos = Math.abs(position.getAndIncrement() % servers.size());
        return servers.get(pos);
    }
}
优点:
- 实现简单,无状态,不需要记录连接数
- 在节点性能完全一致的场景下,能实现绝对公平分配
缺点:
- 假设所有节点处理能力相同,不会考虑各节点的实时负载差异
- 如果某个节点处理慢,请求仍然会不断分配给它,造成请求堆积
- 不能应对节点性能差异(一台 8 核 16G 和一台 2 核 4G 得到相同流量)
2.2 加权轮询(Weighted Round Robin)
加权轮询引入了"权重"概念,为每个节点分配一个权重值,处理能力强的节点分到更多请求。
实现思路:假设有 A(权重5)、B(权重1)、C(权重1) 三台服务器,总共 7 次请求中,A 分到 5 次,B 和 C 各 1 次。但要注意分配顺序——如果前 5 次都给 A,会造成瞬时负载不均。
平滑加权轮询(Smooth Weighted Round Robin):Nginx 和 Dubbo 使用的经典算法。核心思想是每个节点维护一个"当前权重"(currentWeight),每次选择 currentWeight 最大的节点,然后该节点 currentWeight 减去总权重,所有节点 currentWeight 加上各自有效权重。
Java 核心实现(Dubbo 同款,精简版):
public class SmoothWeightedRoundRobin {
    static class WeightedServer {
        Server server;
        int weight;        // 配置的固定权重
        int currentWeight; // 当前动态权重

        WeightedServer(Server server, int weight) {
            this.server = server;
            this.weight = weight;
            this.currentWeight = 0;
        }
    }

    private final List<WeightedServer> servers;

    public Server select() {
        WeightedServer best = null;
        int totalWeight = 0;

        for (WeightedServer ws : servers) {
            ws.currentWeight += ws.weight; // 每次累加固定权重
            totalWeight += ws.weight;
            if (best == null || ws.currentWeight > best.currentWeight) {
                best = ws;
            }
        }

        best.currentWeight -= totalWeight; // 被选中节点减去总权重
        return best.server;
    }
}
算法演示:A(权重5)、B(权重1)、C(权重1),总权重=7
| 轮次 | 选前 | 选中 | 选后 |
|---|---|---|---|
| 1 | A=5, B=1, C=1 | A | A=-2, B=1, C=1 |
| 2 | A=3, B=2, C=2 | A | A=-4, B=2, C=2 |
| 3 | A=1, B=3, C=3 | B | A=1, B=-4, C=3 |
| 4 | A=6, B=-3, C=4 | A | A=-1, B=-3, C=4 |
| 5 | A=4, B=-2, C=5 | C | A=4, B=-2, C=-2 |
| 6 | A=9, B=-1, C=-1 | A | A=2, B=-1, C=-1 |
| 7 | A=7, B=0, C=0 | A | A=0, B=0, C=0 |
7 次请求的分配序列:A, A, B, A, C, A, A —— 权重分布 (5, 1, 1) 完美吻合,且 B 和 C 均匀穿插在 A 之间,避免连续堆积。
2.3 轮询的适用场景
- 普通轮询:所有实例配置完全相同的场景(如 K8s 中同规格的 Pod)
- 加权轮询:异构硬件环境(如部分服务器是新购高配,部分是旧机器)
- 不适合:长连接场景(轮询被分配到空闲连接可能性不大)、有状态服务(session 粘性需求)
3. 随机与加权随机
3.1 随机算法(Random)
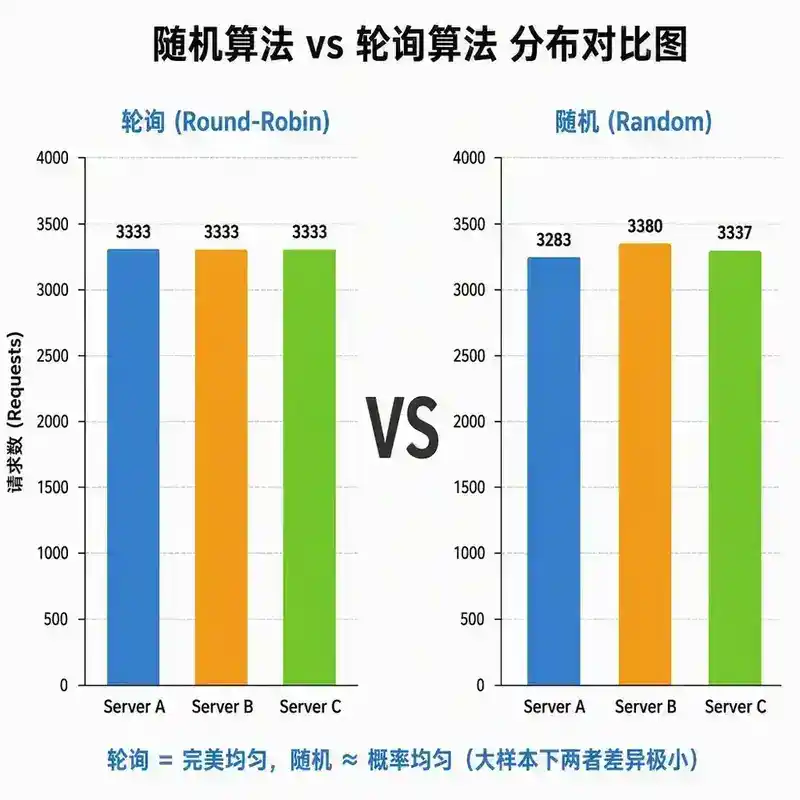
从可用服务器列表中随机选择一个。在统计学上,如果请求量足够大,分布会趋向均匀。
Java 实现:
public class RandomLoadBalancer {
    private final List<Server> servers;
    private final Random random = new Random();

    public Server select() {
        return servers.get(random.nextInt(servers.size()));
    }
}
关于均匀性的数学直觉:假设有 3 台服务器,收到 10000 个请求,每台期望收到 3333 个。根据二项分布,标准差约为 sqrt(N × p × (1-p)) ≈ 47。实际上 10000 次请求后,各服务器收到的请求数通常在 3333 ± 50 左右,非常均匀。所以在大量请求下,随机和轮询的实际效果没有显著差异。
3.2 加权随机(Weighted Random)
类似于加权轮询,但用随机选择替代顺序选择。实现方式:按权重划分区间,生成随机数落在哪个区间就选哪个节点。
Java 实现:
public class WeightedRandomLoadBalancer {
    private final List<Server> servers;

    private final int[ ] weightRanges; // 累加权重区间

    private final int totalWeight;
    private final Random random = new Random();

    public WeightedRandomLoadBalancer(List<Server> servers) {
        this.servers = servers;
        this.weightRanges = new int[servers.size()];
        int sum = 0;
        for (int i = 0; i < servers.size(); i++) {
            sum += servers.get(i).getWeight();
            weightRanges[i] = sum;
        }
        this.totalWeight = sum;
    }

    public Server select() {
        int r = random.nextInt(totalWeight);
        // 二分查找效率更高,这里用线性扫描展示原理
        for (int i = 0; i < weightRanges.length; i++) {
            if (r < weightRanges[i]) {
                return servers.get(i);
            }
        }
        return servers.get(servers.size() - 1);
    }
}
3.3 随机 vs 轮询:如何选择
| 维度 | 轮询 | 随机 |
|---|---|---|
| 单次请求 | 可预测 | 不可预测 |
| 大量请求 | 完美均匀 | 概率均匀(偏差极小) |
| 热点问题 | 可能连续请求同一台 | 分散 |
| 实现复杂度 | 需维护计数器 | 只需随机数生成器 |
| 时钟同步依赖 | 无 | 无 |
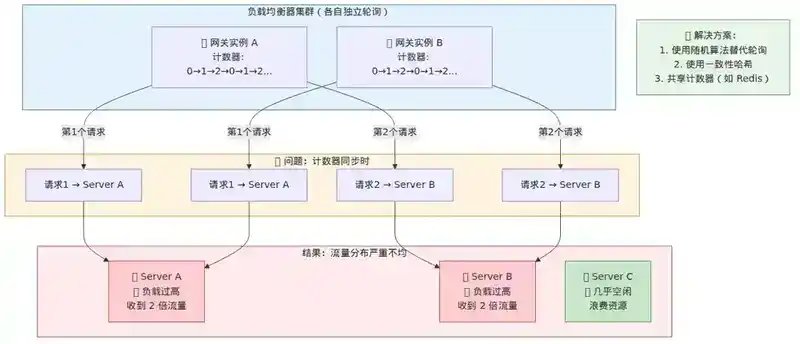
关键洞察:在分布式环境下,随机算法有一个轮询没有的优势——不需要全局状态同步。多个负载均衡器实例各自独立随机选择,整体效果自然趋于均匀。而轮询需要共享计数器,在多实例部署时如果各自独立计数,会导致某些节点分配不均。
4. 一致性哈希
一致性哈希是分布式系统中最"著名"的负载均衡算法之一,它解决了一个特殊但极其重要的问题:当节点数量变化时,如何最小化数据/请求的重新映射。
4.1 问题的起源
考虑一个分布式缓存集群:有 3 台缓存服务器,使用 hash(key) % 3 决定数据存储在哪台。当增加一台服务器变成 4 台时,hash(key) % 4 会导致约 75% 的缓存数据失效(需要重新映射)。在流量高峰期,这相当于一次"缓存雪崩"。
4.2 一致性哈希的核心思想
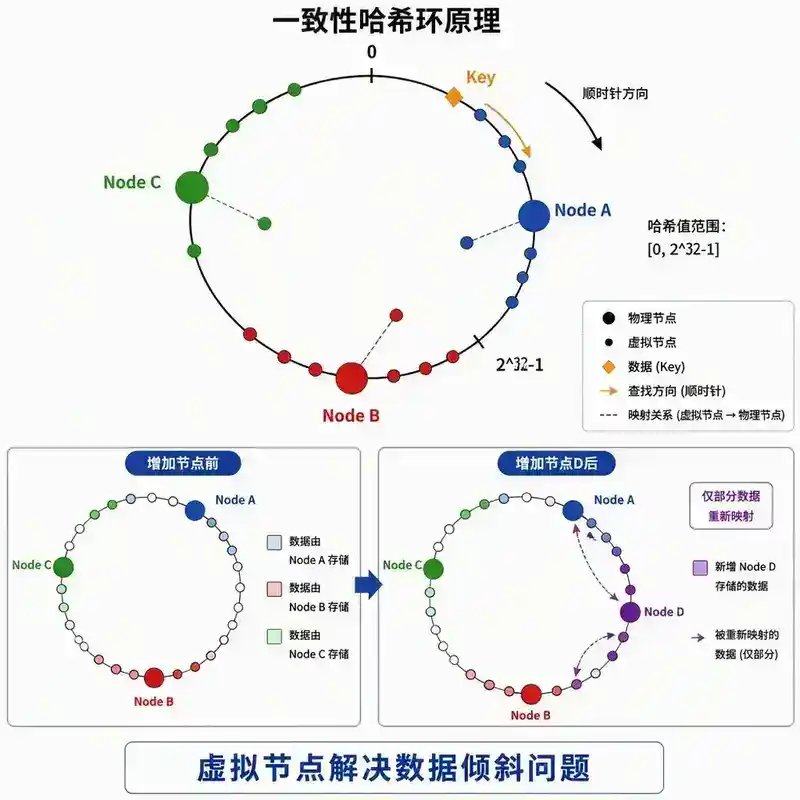
环形哈希空间:将整个哈希值域(0 到 2^32-1)组织成一个环。每个节点和每个数据 key 都通过哈希函数映射到环上的一个点。
分配规则:数据 key 沿环顺时针方向寻找,遇到的第一个节点就是它的归属节点。
节点变化的优雅处理:
- 节点加入:只影响环上紧邻新节点"逆时针方向"的那一段数据(约 1/N 的数据需要迁移)
- 节点离开:只影响离开节点上原本的数据(约 1/N 的数据需要迁移到下一个节点)
4.3 虚拟节点:解决数据倾斜
普通一致性哈希可能导致数据倾斜:如果节点在环上分布不均匀,有些节点会承担过多数据。虚拟节点(Virtual Nodes)是标准解法:
- 每个物理节点在环上创建多个虚拟节点(如 150 个)
- 虚拟节点均匀分布在环上
- 数据 key 映射到虚拟节点,虚拟节点再映射到物理节点
效果:虚拟节点越多,数据分布越均匀。Dubbo 默认每个服务提供者创建 160 个虚拟节点。
Java 核心实现(TreeMap 基于环):
public class ConsistentHashLoadBalancer {
    private final TreeMap<Integer, Server> ring = new TreeMap<>();
    private final int virtualNodes; // 每个物理节点的虚拟节点数

    public ConsistentHashLoadBalancer(List<Server> servers, int virtualNodes) {
        this.virtualNodes = virtualNodes;
        for (Server server : servers) {
            addServer(server);
        }
    }

    private void addServer(Server server) {
        for (int i = 0; i < virtualNodes; i++) {
            int hash = hash(server.getAddress() + "#" + i);
            ring.put(hash, server);
        }
    }

    public Server select(String key) {
        if (ring.isEmpty()) return null;
        int hash = hash(key);
        // 环上顺时针查找第一个 >= hash 的节点
        Map.Entry<Integer, Server> entry = ring.ceilingEntry(hash);
        if (entry == null) {
            entry = ring.firstEntry(); // 超过最大值,回到环起点
        }
        return entry.getValue();
    }

    private int hash(String key) {
        // 使用 MurmurHash 或 MD5 的低位,保证分布均匀
        return Math.abs(key.hashCode()); // 简化示例
    }
}
4.4 一致性哈希的适用场景
| 适用 | 不适用 |
|---|---|
| 分布式缓存(Memcached、Redis Cluster) | 节点数量相对固定的场景 |
| 数据分片(数据库分表路由) | 无状态服务(轮询/随机更简单) |
| 有状态服务路由 | 需要精确控制流量比例的场景 |
| CDN 节点选择 | 节点频繁上下线但单次变动影响小 |
4.5 一致性哈希的局限性
- 在节点数量较少时,即使有虚拟节点,数据倾斜仍然存在
- 节点频繁上下线时,虚拟节点的重建成本较高
- 不能直接表达"权重"概念(需要不同数量的虚拟节点来间接实现)
5. 最少连接与加权最少连接
5.1 最少连接(Least Connections)
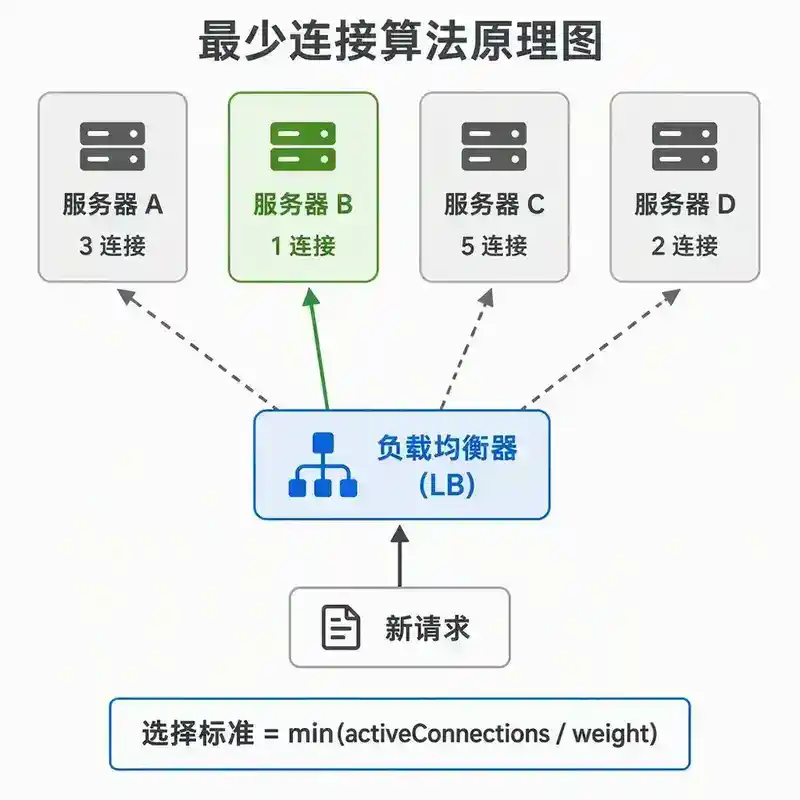
前面几种算法都是"静态"的——它们不关心后端节点的实时负载。最少连接算法则动态地将请求分配给当前活跃连接数最少的服务器。
核心思想:假设每台服务器处理请求的能力相近,那么当前连接数最少的服务器就是负载最轻的。
实现:每次选择时遍历所有服务器,找出 activeConnections 最小的那个。
public class LeastConnectionsLoadBalancer {
    private final List<Server> servers;

    public Server select() {
        Server best = null;
        int min = Integer.MAX_VALUE;
        for (Server s : servers) {
            if (!s.isHealthy()) continue;
            if (s.getActiveConnections() < min) {
                min = s.getActiveConnections();
                best = s;
            }
        }
        return best;
    }
}
5.2 加权最少连接(Weighted Least Connections)
这是 Nginx 默认的负载均衡算法(least_conn)。它结合了权重和连接数两个维度:
选择标准:min(activeConnections / weight)
也就是说,权重高的服务器可以承载更多连接。当一个连接数为 10、权重为 5 的服务器,和一个连接数为 4、权重为 2 的服务器相比,前者比值 2.0,后者比值 2.0,它们"同等繁忙"。
public Server select() {
    Server best = null;
    double minRatio = Double.MAX_VALUE;
    for (Server s : servers) {
        if (!s.isHealthy()) continue;
        double ratio = (double) s.getActiveConnections() / s.getWeight();
        if (ratio < minRatio) {
            minRatio = ratio;
            best = s;
        }
    }
    return best;
}
5.3 最少连接的陷阱
连接数 ≠ 实际负载。一个处理视频转码的慢请求和一个查询缓存的快请求,连接数都是"1",但实际负载差异巨大。这就是为什么最少连接在长连接场景(如数据库连接池、WebSocket)效果最好,在短连接 HTTP 请求场景下优势不明显。
6. 自适应算法
6.1 自适应算法的本质
自适应负载均衡(Adaptive Load Balancing)是负载均衡的"终极形态"——它不依赖固定的权重配置或简单的连接计数,而是持续采集后端节点的实时性能指标,动态调整流量分配策略。
自适应的核心是一个反馈控制系统:
采集指标 → 分析决策 → 调整权重 → 观察效果 → 再采集
6.2 关键指标
| 指标类型 | 具体指标 | 时效性 |
|---|---|---|
| 延迟 | 平均响应时间、P99、P999 | 实时(秒级) |
| 错误率 | 5xx、超时比例 | 实时(秒级) |
| 资源利用率 | CPU、内存、连接数 | 近实时(秒-分钟级) |
| 吞吐量 | QPS、活跃请求数 | 实时 |
6.3 简易实现:基于 EWMA 的自适应策略
指数加权移动平均(EWMA)能平滑近期数据,对瞬时抖动不敏感,同时能快速响应趋势变化:
public class AdaptiveLoadBalancer {
    private static final double ALPHA = 0.2; // 平滑系数,越大越敏感

    static class ServerStats {
        double ewmaResponseTime; // EWMA 平滑后的响应时间
        double weight;

        void recordResponseTime(long rtMs) {
            if (ewmaResponseTime == 0) {
                ewmaResponseTime = rtMs;
            } else {
                // EWMA 公式:newAvg = alpha × current + (1-alpha) × oldAvg
                ewmaResponseTime = ALPHA * rtMs + (1 - ALPHA) * ewmaResponseTime;
            }
        }
    }

    public Server select(List<ServerStats> stats) {
        // 选择 EWMA 延迟最低的节点
        ServerStats best = null;
        double minLatency = Double.MAX_VALUE;
        for (ServerStats s : stats) {
            if (s.ewmaResponseTime < minLatency && s.ewmaResponseTime > 0) {
                minLatency = s.ewmaResponseTime;
                best = s;
            }
        }
        return best != null ? best.server : fallbackRandom();
    }
}
6.4 主流实现:P2C(Power of Two Choices)
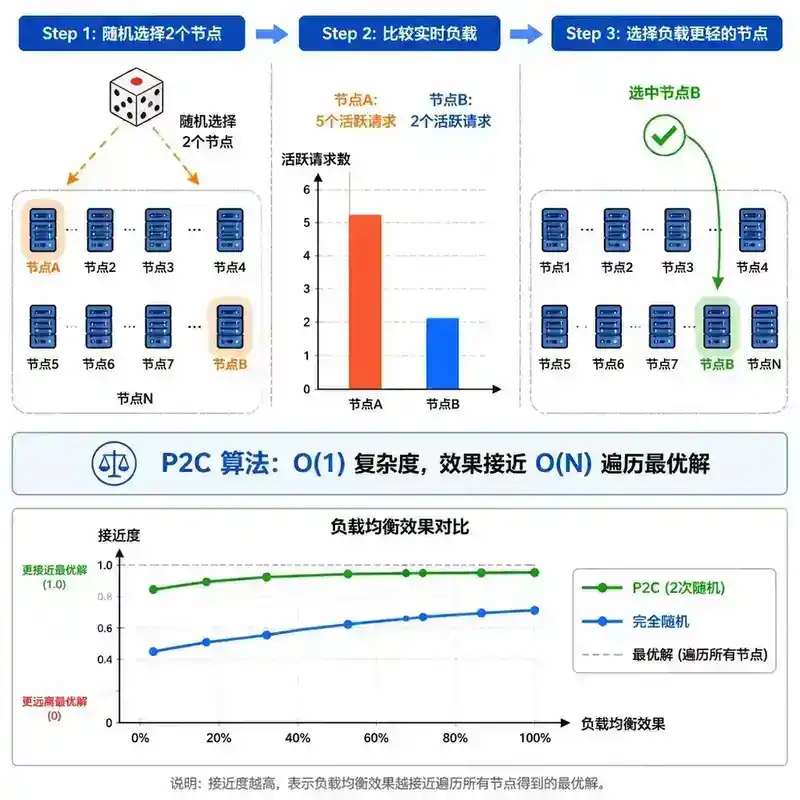
P2C 是 Google 在实践中最推崇的自适应算法之一,被 gRPC、Linkerd 等广泛采用。它的核心极其简单:
- 随机选择 2 个可用节点
- 比较两者的实时负载(如活跃请求数或 EWMA 延迟)
- 选择负载更轻的那个
为什么是 2 个? 数学上,"随机选 2 个取最优"和"遍历所有取最优"的效果差异极小,但前者 O(1),后者 O(N)。当 N=100 时,选 2 个的负载分布已经非常接近最优。
public Server selectP2C(List<Server> servers) {
    // Fisher-Yates 风格随机选 2 个
    Server a = servers.get(random.nextInt(servers.size()));
    Server b = servers.get(random.nextInt(servers.size()));
    return a.getActiveConnections() < b.getActiveConnections() ? a : b;
}
6.5 自适应算法的挑战
- 反馈延迟:从采集指标到调整策略存在延迟,可能导致"过调"(oscillation)
- 度量陷阱:选择错误的指标可能误导决策。例如,仅看 CPU 使用率,可能忽略了 I/O 等待
- 冷启动:新加入的节点没有历史数据,需要特殊处理(如给初始权重,观察一段时间)
- 多指标融合:如何将延迟、错误率、资源利用率合并成一个综合指数,是一个工程难题
7. 生产实践与选型指南
7.1 主流框架的默认算法
| 框架/组件 | 默认算法 | 备注 |
|---|---|---|
| Nginx | 加权轮询(默认)/ 加权最少连接 | least&#95;conn 需显式配置 |
| Dubbo | 加权随机(3.x 默认改为自适应) | 还支持一致性哈希、最短响应时间 |
| Spring Cloud LoadBalancer | 轮询 | 可自定义 |
| gRPC | 轮询 / P2C | 客户端负载均衡 |
| HAProxy | 轮询 / 最少连接 | 多种策略可选 |
| Envoy | 轮询 / 最少连接 / 随机 | 支持 Zone-Aware 路由 |
| LVS | 加权轮询 / 加权最少连接 | 4 层负载均衡 |
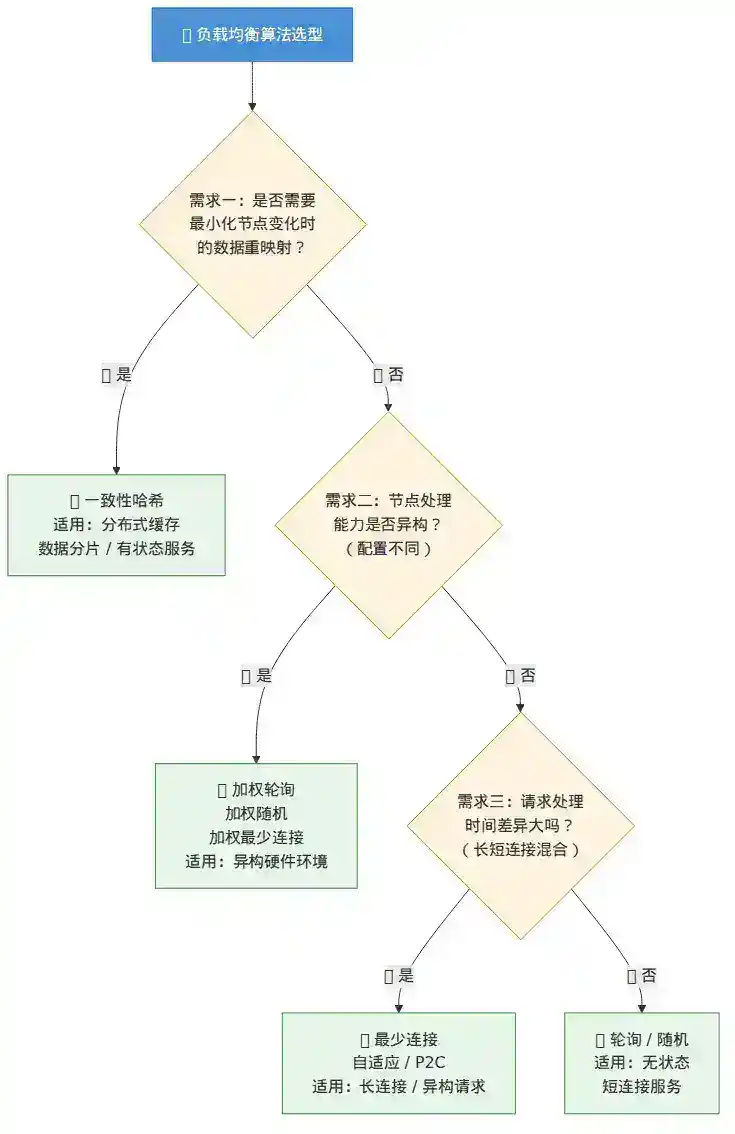
7.2 选型决策树
是否需要节点变化时最小化数据重映射?
├── 是 → 一致性哈希(缓存、分片场景)
└── 否 → 继续
    ├── 节点处理能力是否异构?
    │   ├── 是 → 加权轮询 / 加权随机 / 加权最少连接
    │   └── 否 → 继续
    └── 请求处理时间差异大吗?
        ├── 是 → 最少连接 / 自适应(长连接、异构请求)
        └── 否 → 轮询 / 随机(无状态短连接服务)
7.3 多维度负载均衡
在实际生产环境中,负载均衡往往是多层次的:
┌─────────────────────────────────────────────────┐
│  DNS 层:GeoDNS 将用户路由到最近的 IDC          │
│  ↓                                              │
│  L4 层:LVS/HAProxy 将流量分发到网关集群         │
│  ↓                                              │
│  L7 层:Nginx/Envoy 根据 URL/Header 路由         │
│  ↓                                              │
│  SDK 层:Dubbo/gRPC 客户端负载均衡选择实例        │
└─────────────────────────────────────────────────┘
每一层可以使用不同的算法,形成互补。例如:DNS 层用 GeoDNS,L4 层用加权轮询,L7 层用一致性哈希(基于 session id),SDK 层用自适应。
8. 常见陷阱与故障案例
陷阱 1:只关注算法,忽略了健康检查
问题:无论算法多么精妙,如果后端节点已经宕机或响应超时,算法仍然会选中它。
案例:某电商平台压测时,加权轮询算法仍将 30% 流量分配给已 OOM 的节点,导致持续 502 错误。
解法:健康检查是负载均衡的前置条件,必须将不可用节点从候选列表中剔除。Nginx 的 max_fails + fail_timeout、Dubbo 的心跳检测都是为此设计的。
陷阱 2:一致性哈希选错哈希函数
问题:使用 hashCode() 或简单取模,导致哈希分布不均,环上节点严重倾斜。
案例:某团队用 String.hashCode() 做一致性哈希,发现 80% 的 key 落在 30% 的环上区域,导致 3 台缓存服务器中 1 台负载是另外 2 台的 3 倍。
解法:使用 MurmurHash、FNV 或 MD5 的低 32 位,确保哈希值在环上均匀分布。Dubbo 使用 md5 + & 0x7fffffff 保证非负。
陷阱 3:自适应算法的"正反馈循环"
问题:自适应算法可能陷入恶性循环——某节点收到少量慢请求导致延迟升高,算法降低其权重,该节点负载下降、延迟恢复,算法又提高其权重,造成振荡。
案例:某微服务系统使用基于 P99 延迟的自适应策略,导致流量在节点间反复"漂移",每次漂移伴随短暂超时。
解法:
- 使用 EWMA 平滑,避免瞬时波动
- 引入滞回(hysteresis):权重变化需超过阈值才生效
- 限制权重变化幅度和频率
陷阱 4:多负载均衡器实例的轮询偏差
问题:多个 Nginx/网关实例各自独立轮询,可能导致某些后端节点被多次选中(因为多个实例的计数器刚好同步)。
解法:对于无状态服务,随机算法比轮询更适合多实例网关场景。或者使用一致性哈希作为更稳定的策略。
总结
| 算法 | 核心思想 | 均衡性 | 稳定性 | 响应性 | 复杂度 | 最佳场景 |
|---|---|---|---|---|---|---|
| 轮询 | 顺序分配 | 高 | 低 | 无 | 低 | 同构实例、短连接 |
| 加权轮询 | 按权重顺序分配 | 高 | 低 | 无 | 低 | 异构实例、短连接 |
| 随机 | 随机选择 | 高(大样本) | 低 | 无 | 低 | 多网关实例、同构实例 |
| 加权随机 | 按权重随机选择 | 高(大样本) | 低 | 无 | 低 | 异构实例、多网关 |
| 一致性哈希 | 哈希环映射 | 中(有虚拟节点) | 高 | 无 | 中 | 缓存、数据分片、有状态服务 |
| 最少连接 | 选连接数最少 | 高 | 低 | 中 | 中 | 长连接、异构请求 |
| 自适应 | 实时指标反馈 | 高 | 中 | 高 | 高 | 负载波动大、性能敏感 |
| P2C | 随机选 2 取最优 | 高 | 中 | 高 | 低 | 大规模集群、gRPC 场景 |
负载均衡算法的选择,本质上是对均衡性、稳定性、响应性和复杂度四个维度的权衡。没有完美的算法,只有合适的场景。在工程实践中,建议从最简单的轮询或随机开始,根据实际遇到的问题逐步演进,而不是一开始就做"过度设计"。
下一篇预告:185|超时、重试与退避:重试风暴、指数退避、抖动和截止时间传播。
本文基于 Java 技术专家与架构师面试 250 个高频考点总览编写,编号 184。
面试官视角:追问与深度思考
以下问题模拟技术专家/架构师面试中,面试官对"负载均衡算法"这一主题的追问路径。这些问题不局限于知识复述,而是考察你能否在真实场景中做出合理的技术决策。
Q1:你有一个 100 台机器的服务集群,使用加权轮询。现在需要上线一批新机器,怎么安全地把流量切过去?
参考答案:
关键不是"怎么配置权重",而是渐进式引流。常见的做法是:
- 新机器上线时先给极小权重(如 1),观察 5-10 分钟
- 监控核心指标:错误率、P99 延迟、CPU、内存、GC 频率
- 如果指标正常,逐步上调权重,每步间隔 5-10 分钟
- 如果指标异常,立即摘除(权重设为 0),不要等人工判断
这里有一个容易被忽略的点:新机器的 JIT 预热。Java 服务刚启动时,JIT 尚未完成热点编译,性能只有稳定态的 60-70%。如果按老机器的同等权重分配流量,新机器可能被直接打垮。所以第一批流量应更保守,给 JIT 预热留出时间。
追问:如果你们的注册中心(如 Nacos)不支持分步调整权重,只能一次性上线,怎么办?——可以通过分批发布,每次只上线一小部分机器,替代单机权重调整。
Q2:一致性哈希中,你提到虚拟节点解决数据倾斜。那如果物理节点数量本身就很有限(比如只有 3 台),虚拟节点能完全解决倾斜问题吗?为什么?
参考答案:
不能完全解决。虚拟节点只是让数据在环上分布更均匀,但物理节点数量本身的限制始终存在。
假设有 3 台物理节点,每台 150 个虚拟节点,共 450 个虚拟节点分布在环上。理想情况下,每个物理节点对应 1/3 的环空间。但在随机哈希映射下,150 个虚拟节点在环上的位置是随机的,实际覆盖的环空间可能在 30%-36% 之间波动(标准差约 √(150)/150 ≈ 8.2% 的相对误差)。
也就是说,即使有 150 个虚拟节点,最差情况下某台物理节点可能承担 36% 的负载,而另一台只承担 30%——相差约 20%。这在极限压测场景下可能成为瓶颈。
追问:有什么办法进一步改善?——两个方向:(1) 增加虚拟节点数量(但收益递减);(2) 使用跳跃一致性哈希(Jump Consistent Hash),它不依赖虚拟节点,在节点数固定时可以达到完美均匀分布,但缺点是只支持在末尾添加/删除节点,不支持任意节点移除。
Q3:你在生产环境用 Nginx 做反向代理,配置了 。但你会发现某些后端节点的 CPU 使用率远高于其他节点。可能是什么原因?怎么排查?
参考答案:
least_conn 只看连接数,不看请求的实际开销。可能出现这种情况:
- 慢请求粘滞:某节点恰好处理了多个大文件下载或复杂查询请求,这些请求占用连接时间长,但 CPU 并不高(可能在等 I/O)。而其他节点虽然连接数多,但都是轻量请求,CPU 反而更高。
- 连接与请求不等价:HTTP/2 或 WebSocket 连接上,一个连接可能承载多个请求。
least_conn会低估这些节点上的实际负载。
排查步骤:
- 在 Nginx 侧开启
$upstream_addr和$request_time日志,按后端节点聚合分析请求分布和平均响应时间 - 在后端节点上对比
active_connections和实际 CPU/请求处理速率 - 如果连接数分布均匀但 CPU 差异大,说明请求复杂度差异大,应该考虑用最短响应时间策略(如 Nginx Plus 的
least_time)或自适应算法
追问:能否在 Nginx 开源版中实现类似 least_time 的效果?——开源版不直接支持,但可以通过 Lua 模块(OpenResty)自定义负载均衡逻辑,在后端响应时记录延迟,下次选择时优先选延迟低的节点。
Q4:假如你需要设计一个全局负载均衡系统,跨 3 个机房,每个机房各自有独立的负载均衡集群。一致性哈希和 GeoDNS 结合使用,会遇到什么问题?
参考答案:
核心问题在于两级哈希的冲突:
- DNS 层按用户地理位置(或 IP 段)将用户路由到最近的机房——这是第一层"哈希"。
- 机房内的一致性哈希将用户请求映射到具体的缓存/服务节点——这是第二层。
问题出在:如果按 session_id 做一致性哈希,同一个用户的请求可能被 DNS 路由到机房 A,但一致性哈希认为该 session 的数据在机房 B 的节点上。这就产生了跨机房路由——延迟增加,缓存命中率下降。
解决方案:
- 方案一(推荐):一致性哈希 key 中包含机房信息,如
hash(region + session_id),确保同一机房的请求只落在本机房节点上。 - 方案二:在 DNS 层不做一致性哈希,网关层接收请求后,根据 session_id 做一致性哈希,跨机房转发到目标节点。代价是增加一次跨机房网络开销。
- 方案三:每个机房独立维护一份完整缓存(数据冗余),DNS 层就近路由即可。适合数据量不大、对一致性容忍度较高的场景。
追问:方案三中,如果缓存数据需要更新,怎么保证跨机房一致性?——可以用消息队列广播失效事件,或使用 Redis 主从跨机房同步(代价是延迟),或接受最终一致性(设置合理 TTL)。
Q5:P2C 算法说"随机选 2 个"的效果接近最优,这在数学上怎么证明?当 N 趋于无穷时,最大负载的期望是多少?
参考答案:
这是经典的Balls-in-Bins问题。
普通随机(选 1 个):把 M 个球随机放入 N 个箱子,最大负载的期望是 Θ(log N / log log N)。
P2C(选 2 个取轻的):把 M 个球依次放入 N 个箱子,每次随机选 2 个箱子,把球放入球较少的那个。最大负载的期望是 Θ(log log N / log 2) + Θ(1) ≈ log₂ log₂ N + O(1)。
当 N=10000 时:
- 普通随机最大负载:约 log(10000)/log(log(10000)) ≈ 9.21/2.22 ≈ 4.1 倍均值
- P2C 最大负载:约 log₂(log₂(10000)) ≈ log₂(13.29) ≈ 3.73,加上常数约 4-5 倍
实际上 P2C 的常数项比较大,在 N 较小时优势不明显,但 N 很大时,P2C 的最大负载增长极慢(双重对数),而普通随机是对数增长。这是一个渐近优势——当 N 达到百万级别时,P2C 的最大负载几乎不再增长,而普通随机仍在增长。
追问:如果选 3 个呢?——选 d 个的效果是 Θ(log log N / log d),选 3 个比选 2 个好,但提升幅度从 log₂ 变为 log₃,边际收益递减。工程上选 2 个就是性价比最高的选择。
Q6:你设计了一个自适应负载均衡器,基于 CPU 使用率来调整权重。但上线后发现,流量老是"漂移"——一会儿全打到 A 节点,一会儿全打到 B 节点。怎么解决?
参考答案:
这是典型的振荡(Oscillation)问题,根因是反馈控制的滞后性和过调。
振荡的机制:
- A 节点 CPU 低 → 自适应器给 A 更多流量
- A 节点 CPU 飙升 → 自适应器降低 A 权重,把流量切给 B
- A 节点 CPU 快速下降(因为流量走了)→ 自适应器又认为 A 恢复了,提高权重
- 循环往复...
解决方案(按优先级):
- EWMA 平滑:用指数加权移动平均替代瞬时值,α 设置 0.1-0.3,避免对短时抖动过度反应
- 滞回阈值:权重调整需要超过一定阈值(如 10%)才生效,避免微小波动触发调整
- 调整频率限制:限制两次权重调整的最小间隔(如 30 秒),避免高频切换
- 分布式共识:如果多个自适应器各自独立决策,可能互相冲突。可以考虑引入中心化决策者,或使用 Gossip 协议同步状态
追问:如果不用 CPU 指标,用什么指标更不容易振荡?——请求延迟(特别是 P99 或 EWMA 延迟) 通常比 CPU 更稳定,因为延迟是"结果"而非"原因",直接反映了用户体验。但延迟也有问题:当一个节点被摘除后,它的延迟数据无法更新,需要额外处理冷启动。
面试准备提示:负载均衡算法本身不难理解,但面试官更关注的是你在真实场景中做 trade-off 的能力——选什么算法、为什么选、遇到问题怎么排查。建议结合你实际项目中的负载均衡选型经验准备 1-2 个案例。