阅读时间:约 40-50 分钟 适合人群:Java 高级工程师、技术专家、架构师 关键词:熔断器、状态机、降级策略、舱壁模式、线程池隔离、信号量隔离、Hystrix、Resilience4j、Sentinel
一、引子:为什么这些模式如此重要
想象一个场景:某电商大促期间,订单服务依赖的库存服务因为数据库连接池耗尽,每次请求都要等待 30 秒才会超时。订单服务的线程池只有 200 个线程,30 秒内涌入 5000 个请求,所有线程都被卡在等待库存服务响应上。JVM 的可用线程耗尽,连 Tomcat 的健康检查端点都无法响应,K8s 判定 Pod 不健康,开始重启 Pod。但重启后线程池是空的,很快又被新请求填满——服务彻底不可用。
这就是经典的级联故障(Cascading Failure)。 一个下游服务的故障,像多米诺骨牌一样依次击倒上游服务,最终导致整个系统雪崩。
解决这类问题,就是熔断、降级与隔离三件套的用武之地。这三个模式不是相互独立的,而是层层递进、协同工作的"服务韧性铁三角":
- 隔离是第一道防线:把不同依赖的资源隔开,防止一个出问题拖垮全局
- 熔断是第二道防线:当依赖故障达到阈值,快速切断请求,避免资源持续浪费
- 降级是第三道防线:当熔断器打开、依赖不可用时,提供有损但可用的兜底方案
三者的关系可以用一句话概括:隔离防止扩散,熔断快速止损,降级优雅兜底。

二、降级:在"不可用"面前优雅地活下去
2.1 降级的本质
降级(Degradation / Fallback)的核心理念是:宁可返回不完美的结果,也不让系统崩溃。 当某个依赖服务不可用、超时或响应缓慢时,不再等待它返回正确结果,而是执行一个备选方案。
降级不等同于"功能不可用"。优秀的降级设计让用户感知不到部分依赖的故障——比如推荐模块挂了,但首页照样展示热门内容;用户详情服务的头像加载失败,但昵称和基本信息仍然正常返回。
2.2 降级策略全景图
| 策略 | 英文 | 描述 | 适用场景 | 用户感知 |
|---|---|---|---|---|
| 返回默认值 | Return Default | 返回一个预设的默认值 | 非关键数据 | 几乎无感知 |
| 返回缓存 | Return Cached | 返回本地缓存或分布式缓存中的数据 | 读多写少的数据 | 可能数据稍旧 |
| 返回静态兜底 | Return Static Fallback | 返回预定义的静态数据 | 页面骨架、推荐 | 内容降级 |
| 返回空列表 | Return Empty | 返回空集合或空对象 | 列表查询 | 显示为空 |
| 静默失败 | Fail Silent | 不返回错误,仅记录日志 | 非关键异步操作 | 无感知 |
| 调用备用服务 | Call Backup Service | 切换到备用服务或备用集群 | 多活部署 | 可能有延迟增加 |
| 功能降级 | Feature Toggle | 关闭非核心功能 | 大促期间 | 功能减少 |
| 限流降级 | Throttle | 拒绝部分请求,优先服务核心用户 | 过载保护 | 部分用户被拒绝 |
2.3 降级的分级体系
在设计降级方案时,不能一刀切。一个成熟的分级降级体系通常包含三个等级:
Level 1 — 核心功能(不可降级): 支付、下单、库存扣减等核心交易链路。这些功能一旦降级意味着业务受损,应该通过一切手段保障可用性——多机房、多活、异地容灾。不是不能降级,而是降级的代价极高,需要投入更多资源保障。
Level 2 — 重要功能(可降级但需感知): 商品详情、用户信息、优惠券查询等。这些功能降级后用户仍可完成核心交易,但体验会下降。降级策略通常是返回缓存数据或默认值。
Level 3 — 非核心功能(可降级且可无感知): 推荐商品、用户评论、浏览历史、广告等。这些功能降级后用户几乎无感知,甚至可以直接静默失败。
分级的目的是:当系统资源紧张时,把有限的资源集中到核心链路上,牺牲次要功能,保住核心业务。 这就像战时资源分配——弹药优先供给前线,后方可以先吃粗粮。
2.4 降级的触发方式
降级不是想来就来的,需要明确的触发条件:
1. 手动降级(开关降级): 通过配置中心(Nacos、Apollo)动态下发降级开关。大促前手动开启非核心功能的降级,大促后恢复。优点是可控,缺点是依赖人工判断。
2. 自动降级(自适应降级): 基于实时指标(RT、异常率、成功率)自动触发降级。例如 Sentinel 的 DegradeRule 配置:
- 慢调用比例(Slow Request Ratio):当资源的慢调用比例超过阈值,触发降级
- 异常比例(Error Ratio):当资源的异常比例超过阈值,触发降级
- 异常数(Error Count):当资源的异常数超过阈值,触发降级
3. 半自动降级(告警+人工确认): 系统监测到异常后发送告警,运维人员确认后执行降级。适合关键功能的降级,避免误触发。
2.5 降级的代码实现
以 Sentinel 为例,一个典型的降级实现:
// 定义降级规则
@PostConstruct
public void initDegradeRule() {
    List<DegradeRule> rules = new ArrayList<>();
    DegradeRule rule = new DegradeRule("getProductDetail")
            .setGrade(CircuitBreakerStrategy.SLOW_REQUEST_RATIO.getType())
            .setCount(200)        // 慢调用临界值 200ms
            .setSlowRatioThreshold(0.5)  // 慢调用比例阈值 50%
            .setMinRequestAmount(10)     // 最小请求数
            .setStatIntervalMs(10000)    // 统计窗口 10s
            .setTimeWindow(30);          // 熔断时长 30s
    rules.add(rule);
    DegradeRuleManager.loadRules(rules);
}

// 业务代码中使用降级
@SentinelResource(value = "getProductDetail",
        fallback = "getProductDetailFallback",
        fallbackClass = ProductFallbackHandler.class)
public ProductDetail getProductDetail(Long productId) {
    return productService.queryById(productId);
}

// 降级方法
public class ProductFallbackHandler {
    public static ProductDetail getProductDetailFallback(Long productId) {
        // 从本地缓存获取
        ProductDetail cached = localCache.get(productId);
        if (cached != null) return cached;
        // 返回默认值
        return ProductDetail.defaultProduct(productId);
    }
}
三、熔断:状态机驱动的快速止损
3.1 从电闸到代码:熔断的隐喻
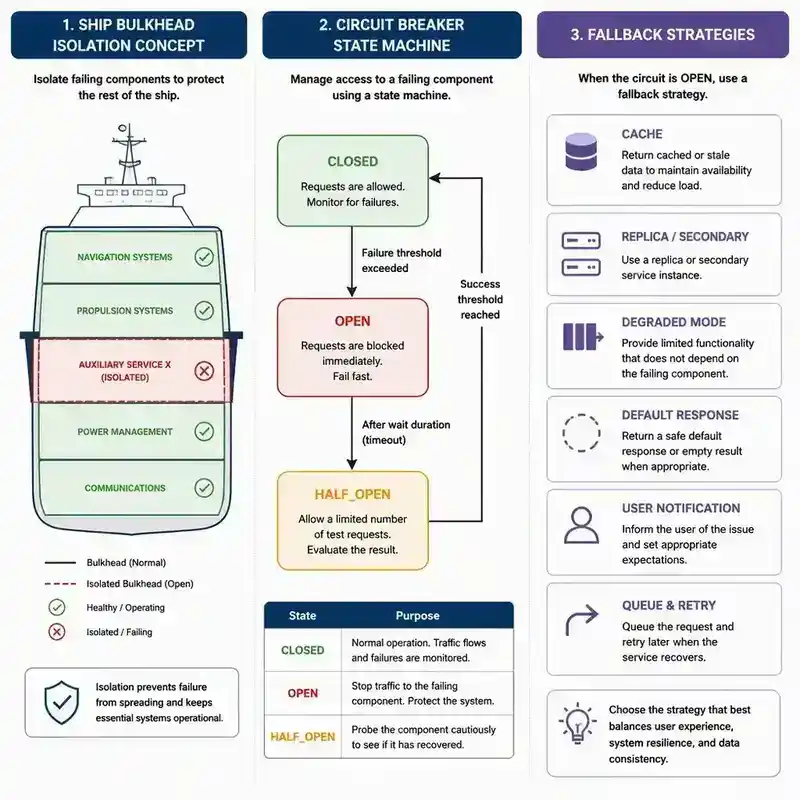
熔断器(Circuit Breaker)的概念来自电气工程。当电路中的电流过大时,熔断器自动断开,保护电器设备不被烧毁。在分布式系统中,熔断器的作用完全一致:当依赖服务的错误率超过阈值,自动"断开"对该服务的调用,快速失败,给下游服务恢复喘息的时间。
与电气熔断器不同,软件熔断器是可恢复的——它不会永久断开,而是会周期性地尝试"半开"状态,检测下游是否恢复。
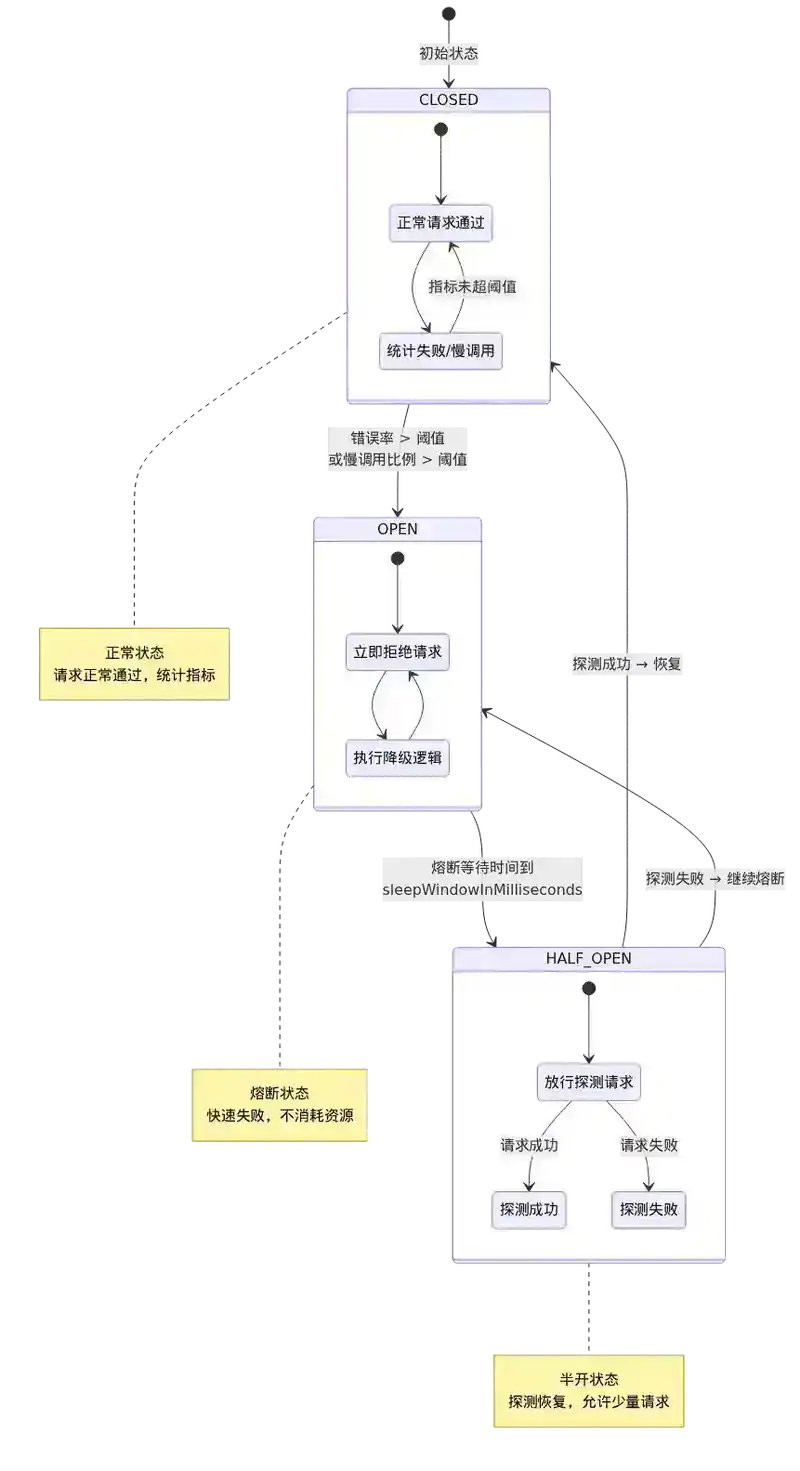
3.2 熔断器状态机:三段式核心模型
熔断器的核心是一个三段式状态机:
         ┌──────────┐
         │  CLOSED  │ ← 正常状态:请求正常通过
         └─────┬────┘
               │ 错误率 > 阈值
               ▼
         ┌──────────┐
         │   OPEN   │ ← 熔断状态:立即拒绝请求,快速失败
         └─────┬────┘
               │ 等待超时后,允许一个探测请求
               ▼
         ┌──────────┐
         │ HALF_OPEN│ ← 半开状态:探测请求成功 → CLOSED
         └──────────┘        探测请求失败 → OPEN
CLOSED(闭合)状态:
- 所有请求正常放行
- 统计窗口内持续收集指标(失败数、慢调用数、超时数)
- 当失败率超过阈值时,切换到 OPEN 状态
OPEN(断开)状态:
- 所有请求立即拒绝,抛出
CircuitBreakerOpenException或执行降级逻辑 - 不消耗线程资源等待超时,这是熔断最大的价值
- 经过设定的
sleepWindowInMilliseconds后,切换到 HALF_OPEN 状态
HALF_OPEN(半开)状态:
- 允许少量探测请求通过(通常 1-3 个)
- 如果探测请求成功 → 切换到 CLOSED(恢复)
- 如果探测请求失败 → 切换回 OPEN(继续熔断)
3.3 熔断器核心参数
以 Hystrix 和 Resilience4j 为例,关键参数对照:
| 参数 | Hystrix | Resilience4j | 含义 |
|---|---|---|---|
| 统计窗口 | metrics.rollingStats.timeInMilliseconds |
slidingWindowSize |
统计数据的滑动窗口大小 |
| 请求量阈值 | circuitBreaker.requestVolumeThreshold |
minimumNumberOfCalls |
窗口内最小请求数,低于此值不熔断 |
| 错误率阈值 | circuitBreaker.errorThresholdPercentage |
failureRateThreshold |
错误率超过此值触发熔断 |
| 熔断时长 | circuitBreaker.sleepWindowInMilliseconds |
waitDurationInOpenState |
OPEN 状态持续多久后进入 HALF_OPEN |
| 半开请求数 | 固定 1 | permittedNumberOfCallsInHalfOpenState |
HALF_OPEN 状态允许通过的请求数 |
| 慢调用阈值 | 不支持 | slowCallDurationThreshold |
超过此耗时的调用算慢调用 |
| 慢调用比例 | 不支持 | slowCallRateThreshold |
慢调用比例阈值 |
3.4 熔断器的滑动窗口实现
熔断器需要统计窗口内的错误率,这涉及到滑动窗口的实现。主流方案有两种:
方案一:固定时间窗口(Hystrix 默认)
Hystrix 使用 HystrixRollingNumber 实现,将时间窗口(如 10s)分为 N 个桶(bucket),每个桶存储该秒内的统计数据。当有新请求时,统计当前窗口内所有桶的合计值。这种实现的问题是:窗口边界处可能出现"双倍计数"的精度问题。
方案二:环形缓冲区(Resilience4j)
Resilience4j 使用基于大小(count-based)或时间(time-based)的环形缓冲区:
- Count-based sliding window:环形数组存储最近 N 次调用的结果(成功/失败/慢调用),每次新调用覆盖最旧的一条记录。窗口大小固定,内存占用可控。
- Time-based sliding window:环形数组的每个桶代表一个时间段(epoch),总计 N 个桶覆盖整个窗口。通过
(currentTime / epochSize) % N确定当前桶的位置。
// Resilience4j count-based 滑动窗口的核心数据结构
public class SlidingTimeWindowMetrics {
    private final int timeWindowSize;  // 总窗口大小(秒)
    private final int bucketSize;      // 每个桶的大小(秒)
    private final int bucketCount;     // 桶的数量 = timeWindowSize / bucketSize
    private final CircularBitSet bitSet;  // 每个桶的成功/失败计数

    // 清理过期桶
    private void cleanUpObsoleteBuckets(long currentTime) {
        long currentBucketIndex = currentTime / bucketSizeInMillis;
        // 清理超过窗口范围的桶
        // ...
    }
}
3.5 熔断器不是银弹:常见误区
误区 1:熔断时间设置过长 有些团队为了"保险",把熔断时间设置为 5 分钟甚至更长。但实际上,熔断的本质是给下游恢复的时间——如果下游 30 秒就能恢复,多等 4 分半就是浪费。合理的熔断时长应该根据下游的恢复时间(如数据库主从切换时间)来设定。
误区 2:熔断后不做降级 熔断只是"不调用了",但如果不做降级,上游仍然会返回错误给用户。熔断 + 降级才是完整的方案。
误区 3:对所有依赖一视同仁 核心依赖和次要依赖的熔断阈值应该不同。核心依赖可以设置更高的容错阈值,次要依赖可以更激进地熔断。
误区 4:忽略熔断器的自身故障 熔断器本身也是代码,也可能出 bug。如果熔断器误触发,大量正常请求被拒绝,这比依赖故障造成的影响可能更大。因此需要监控熔断器的状态变化,并及时告警。
四、隔离:舱壁模式与资源隔离
4.1 舱壁模式的隐喻
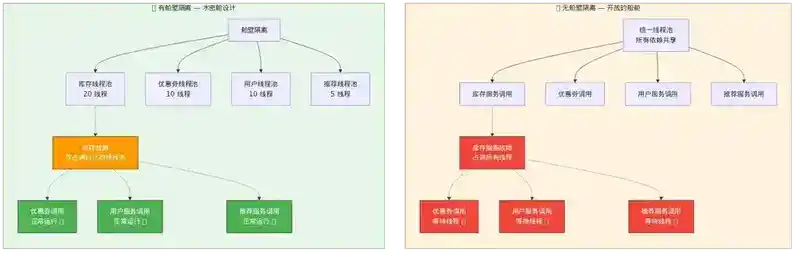
舱壁(Bulkhead)的概念来自船舶设计。一艘船在船体内部分隔成多个独立的水密舱,即使某个舱进水,船只也不会沉没。在软件架构中,舱壁模式就是将系统的不同部分隔离开来,限制故障的传播范围。
没有舱壁隔离的系统就像一个开放的船舱——一个依赖的故障可以拖垮所有依赖。
4.2 线程池隔离
原理: 为每个依赖服务分配独立的线程池,每个线程池有自己的任务队列和拒绝策略。当某个依赖服务变慢导致线程池被占满时,只影响该依赖的调用,不会影响其他依赖。
以 Hystrix 为例:
public class OrderService {
    // 订单服务对库存服务的调用,使用独立的线程池
    @HystrixCommand(
        fallbackMethod = "inventoryFallback",
        threadPoolKey = "inventoryThreadPool",
        threadPoolProperties = {
            @HystrixProperty(name = "coreSize", value = "20"),
            @HystrixProperty(name = "maxQueueSize", value = "100"),
            @HystrixProperty(name = "queueSizeRejectionThreshold", value = "80")
        },
        commandProperties = {
            @HystrixProperty(name = "execution.isolation.thread.timeoutInMilliseconds", value = "3000")
        }
    )
    public InventoryResult checkInventory(Long productId) {
        return inventoryService.check(productId);
    }

    // 订单服务对优惠券服务的调用,使用另一个独立的线程池
    @HystrixCommand(
        fallbackMethod = "couponFallback",
        threadPoolKey = "couponThreadPool",
        threadPoolProperties = {
            @HystrixProperty(name = "coreSize", value = "10")
        }
    )
    public CouponResult checkCoupon(Long couponId) {
        return couponService.check(couponId);
    }
}
线程池隔离的优点:
- 完全隔离:一个依赖的线程池满了不会影响其他依赖
- 支持超时:每个调用可以在独立线程中设置超时,超时后中断线程
- 支持排队:线程池的任务队列天然支持背压
线程池隔离的缺点:
- 线程开销:每个依赖一个线程池,线程数量 = Σ(各线程池核心线程数),线程上下文切换开销大
- 计算开销:线程创建、销毁、上下文切换有 CPU 开销
- 难以确定线程池大小:小了大促不够用,大了平时浪费资源
4.3 信号量隔离
原理: 信号量隔离是在调用线程中直接执行依赖调用,通过信号量(Semaphore)控制并发数。超过并发限制的请求直接拒绝或降级。
与线程池隔离的关键区别:
| 维度 | 线程池隔离 | 信号量隔离 |
|---|---|---|
| 执行线程 | 独立线程池中的线程 | 调用方线程(如 Tomcat 线程) |
| 隔离粒度 | 完全隔离,包括线程资源 | 仅限制并发数,不隔离线程 |
| 超时控制 | 可通过 Future.get(timeout) 实现 | 无法中断已开始的调用 |
| 上下文传递 | 需要额外处理(ThreadLocal 丢失) | 天然支持(同一线程) |
| 开销 | 线程上下文切换开销 | 几乎无额外开销 |
| 适用场景 | 网络调用(RPC、HTTP) | 本地计算、缓存访问 |
代码示例:
@HystrixCommand(
    fallbackMethod = "localCacheFallback",
    commandProperties = {
        @HystrixProperty(name = "execution.isolation.strategy", value = "SEMAPHORE"),
        @HystrixProperty(name = "execution.isolation.semaphore.maxConcurrentRequests", value = "50")
    }
)
public UserProfile getUserProfile(Long userId) {
    // 本地缓存查询,执行很快,用信号量隔离即可
    return localCache.get(userId);
}
为什么信号量隔离不能用于网络调用? 因为信号量隔离不提供超时中断能力。如果网络调用阻塞,调用方线程(Tomcat 线程)也会被阻塞,无法释放。信号量只能限制"有多少个调用在进行",但无法在调用超时后中断它。而线程池隔离可以通过 Future.cancel(true) 中断线程。
记忆口诀: "信号量管并发,线程池管隔离。网络调用用线程池,本地计算用信号量。"
4.4 舱壁模式在架构层面的应用
舱壁模式不仅适用于服务调用层面,也适用于架构设计:
1. 物理舱壁:
- 为不同业务线部署独立的服务集群,物理隔离
- 例如:订单服务集群 A 只服务华北用户,集群 B 只服务华南用户
2. 逻辑舱壁:
- 同一个服务实例内,为不同租户或不同业务场景分配独立的资源池
- 例如:同一个数据库连接池,VIP 用户独占 20 个连接,普通用户共享 30 个连接
3. 数据舱壁:
- 不同租户的数据存储在独立的数据库或独立的表中
- 例如:SaaS 系统中,每个租户一个 schema,租户之间的数据操作互不影响
4. 网络舱壁:
- 不同服务之间使用独立的网络连接池
- 例如:HTTP 连接池为每个下游服务分配独立的连接数上限
4.5 线程池大小的估算
线程池隔离最大的挑战之一是确定线程池大小。以下是几种估算方法:
方法一:基于 RT 和 QPS 的 Little 定律
线程数 = QPS × 平均 RT(秒)
例如:库存服务 QPS 峰值 500,平均 RT 50ms,则线程数 = 500 × 0.05 = 25。加上 20% 的缓冲,设置为 30。
方法二:基于历史监控数据
从监控系统(如 Sunfire、Prometheus)获取历史峰值 QPS 和 P99 RT,计算最大需求线程数。
方法三:基于压测
进行全链路压测,观察在不同线程池大小下的表现,找到拐点。线程池太小会导致大量拒绝,太大则浪费资源。
方法四:动态调整(Sentinel 方式)
Sentinel 不要求预设线程池大小,而是通过滑动窗口实时统计当前资源的并发线程数,当超过阈值时触发流控。这种方式更灵活,但本质上也是一种信号量隔离。
五、三者的协同:熔断 + 降级 + 隔离的组合拳
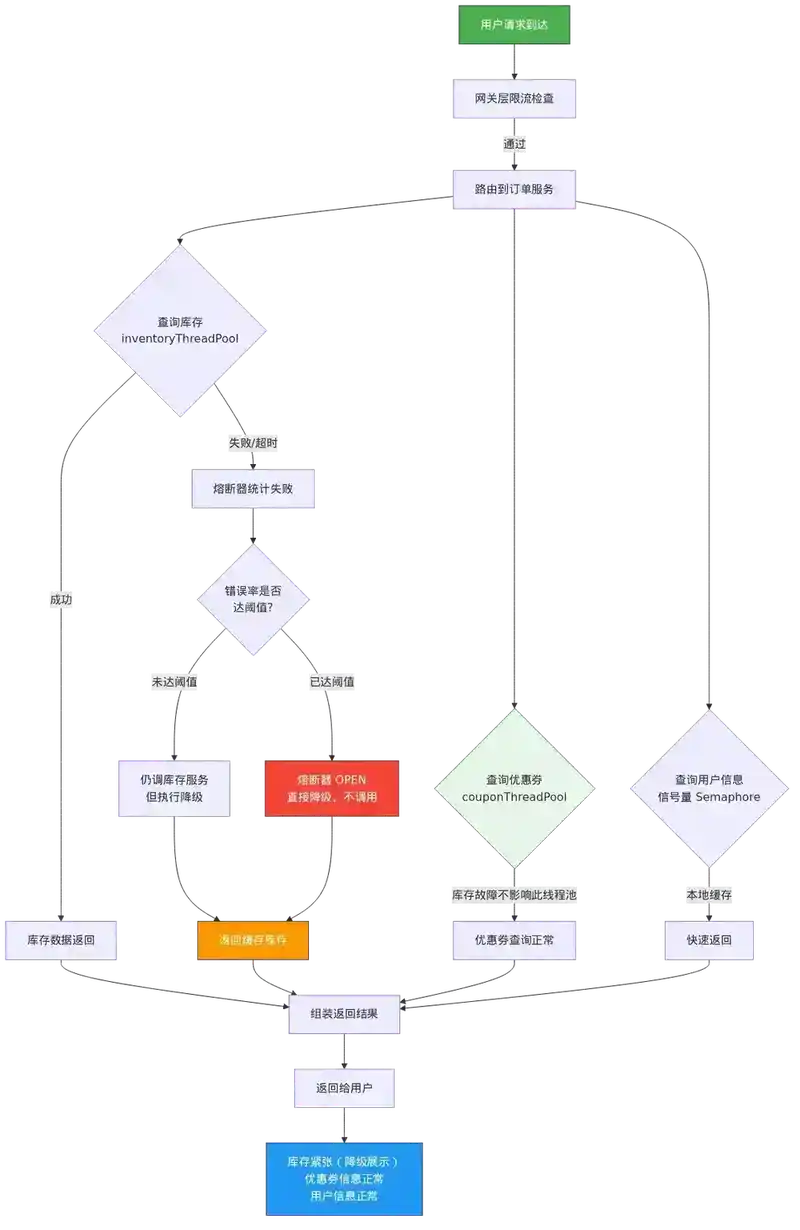
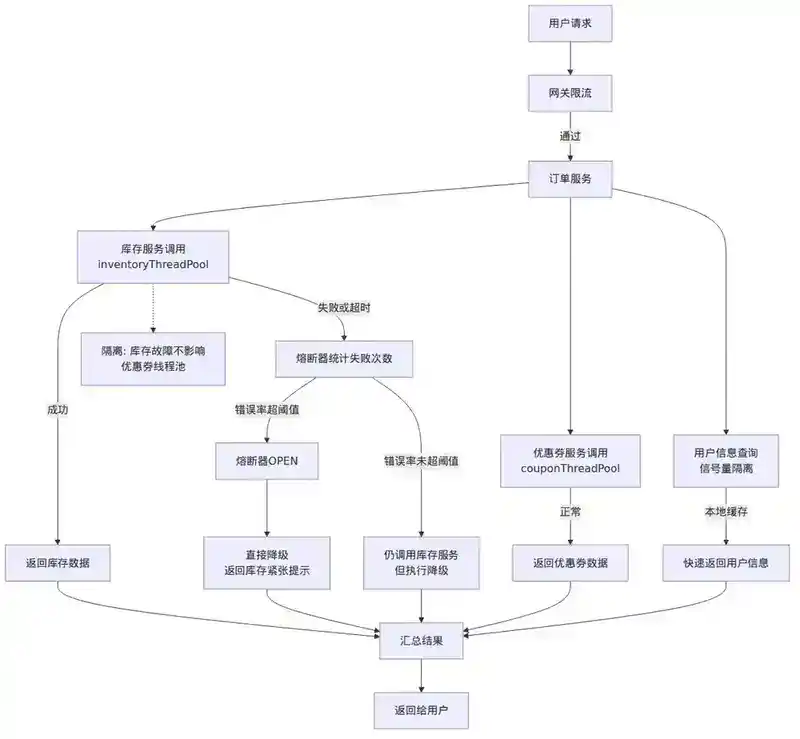
5.1 一个请求的完整生命周期
让我们跟踪一个请求在企业级微服务架构中的完整生命周期:
1. 请求到达 → 网关层限流(没被限流)
2. 网关路由 → 订单服务
3. 订单服务 → 查询库存(线程池隔离:inventoryThreadPool)
   ├─ 成功 → 继续
   └─ 失败/超时 → 熔断器统计失败次数
                  ├─ 错误率未达阈值 → 仍调库存服务,但执行降级
                  └─ 错误率达阈值 → 熔断器 OPEN,直接降级,不调库存服务
4. 订单服务 → 查询优惠券(线程池隔离:couponThreadPool)
   ├─ 库存服务的故障不影响优惠券线程池 ← 隔离的价值
   └─ 优惠券查询正常执行
5. 订单服务 → 查询用户信息(信号量隔离:semaphore)
   └─ 本地缓存,快速返回
6. 返回组装结果给用户
   ├─ 库存查询失败 → 降级展示"库存紧张"(而非报错)
   └─ 其他信息正常展示
5.2 不同故障场景下的应对策略
| 故障场景 | 隔离策略 | 熔断策略 | 降级策略 |
|---|---|---|---|
| 下游服务响应变慢(RT 翻倍) | 线程池隔离——慢调用占满线程池后不再接收新请求 | 慢调用比例触发熔断 | 返回缓存数据 |
| 下游服务直接报错(500) | 信号量隔离——限制并发,避免重试风暴 | 错误率触发熔断 | 返回默认值 |
| 下游服务完全不可达 | 线程池隔离——超时后释放线程 | 快速熔断(错误率 100%) | 返回兜底数据 |
| 大促流量峰值 | 信号量隔离——限制并发 | 不触发熔断(只是流量大,不是下游故障) | 功能降级(关闭非核心功能) |
| 数据库连接池耗尽 | 线程池隔离——数据库连接池与业务线程池分离 | 错误率触发熔断 | 返回缓存或拒绝服务 |
5.3 关键技术选型对比
| 特性 | Hystrix | Resilience4j | Sentinel |
|---|---|---|---|
| 维护状态 | 停维(进入维护模式) | 活跃 | 活跃(阿里开源) |
| 熔断器 | ✅ 基于错误率 | ✅ 基于错误率 + 慢调用 | ✅ 基于错误率 + 慢调用 |
| 线程池隔离 | ✅ | ❌(认为太重) | ❌(推荐信号量) |
| 信号量隔离 | ✅ | ✅(Bulkhead) | ✅(默认方式) |
| 限流 | ❌ | ✅(RateLimiter) | ✅(核心能力) |
| 重试 | ❌ | ✅(Retry) | ❌ |
| 控制台 | Hystrix Dashboard | ❌ | ✅ Sentinel Dashboard |
| 规则动态下发 | ❌ | ❌ | ✅(推送到客户端) |
选型建议:
- 如果你还在用 Hystrix 且没有明显痛点 → 迁移到 Resilience4j 或 Sentinel
- 如果你的技术栈是 Spring Cloud → Resilience4j 是 Spring Cloud Circuit Breaker 的默认实现
- 如果你需要完善的限流能力 + 控制台 → Sentinel
- 如果你是阿里系技术栈 → Sentinel 配合 Nacos 做配置中心是天作之合
六、实践指南:从设计到落地
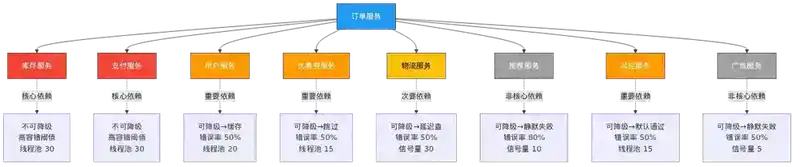
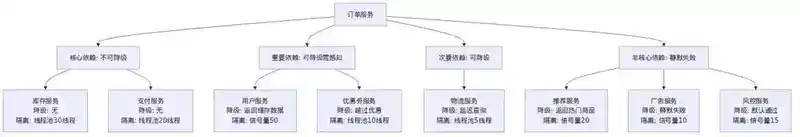
6.1 服务依赖梳理(第一步)
在实施熔断降级之前,先梳理服务依赖关系:
订单服务依赖关系图:
订单服务
├── 库存服务(核心依赖)——— 不可降级,高容错阈值
├── 支付服务(核心依赖)——— 不可降级,高容错阈值
├── 用户服务(重要依赖)——— 可降级,返回缓存
├── 优惠券服务(重要依赖)——— 可降级,跳过优惠
├── 物流服务(次要依赖)——— 可降级,延迟查询
├── 推荐服务(非核心依赖)——— 可降级,静默失败
└── 广告服务(非核心依赖)——— 可降级,静默失败
梳理完成后,为每个依赖标注:
- 依赖等级(核心/重要/次要/非核心)
- 降级策略(返回什么兜底数据)
- 熔断阈值(错误率、慢调用比例)
- 隔离方式(线程池/信号量)及资源大小
6.2 监控与告警
熔断降级不是"设完就忘"的配置,需要持续的监控告警:
关键监控指标:
- 熔断器状态变化(CLOSED → OPEN → HALF_OPEN)
- 降级调用次数和比例
- 线程池使用率、队列长度、拒绝次数
- 信号量并发数
告警规则:
- 熔断器 OPEN → P1 告警:下游服务可能故障,需要立即排查
- 降级比例 > 30% → P2 告警:大量请求被降级,体验下降
- 线程池使用率 > 80% → P3 告警:资源接近瓶颈,需要扩容或限流
6.3 常见陷阱与最佳实践
陷阱 1:熔断后的"惊群效应" 当熔断器从 OPEN 切换到 HALF_OPEN 时,如果放行太多探测请求,而这些请求恰好都成功,那么熔断器迅速切换到 CLOSED,大量积压请求涌入——如果下游其实还没完全恢复,就会再次被打垮。 解决: 设置半开状态允许的请求数(permittedNumberOfCallsInHalfOpenState)为较小值,如 3-5。
陷阱 2:降级逻辑本身引发故障 降级逻辑如果调用其他服务,可能引发新的级联故障。 解决: 降级逻辑应该尽量简单、本地化,不依赖外部服务。如果降级逻辑需要调用 Redis,也要确保 Redis 有足够的容量。
陷阱 3:ThreadLocal 丢失 使用线程池隔离时,请求在线程池的不同线程中执行,父线程中的 ThreadLocal 变量(如 TraceId、用户信息)会丢失。 解决: 使用 Hystrix 的 HystrixConcurrencyStrategy 包装 Callable,或使用阿里开源的 transmittable-thread-local。
陷阱 4:熔断阈值设置不当 错误率阈值设得太高 → 熔断太慢,资源已经浪费;设得太低 → 熔断太敏感,频繁切换状态。 建议: 错误率阈值 50%,慢调用阈值设为 P99 RT 的 2 倍,最小请求数 10-20 个。
七、总结
熔断、降级、隔离是分布式系统韧性的三大基石,它们各有侧重又紧密配合:
- 隔离是基础设施——把不同的依赖放在不同的资源池中,防止"一颗老鼠屎坏了一锅粥"
- 熔断是快速止损——一旦检测到依赖故障,立即切断,避免资源被持续占用
- 降级是优雅兜底——当依赖不可用时,用有损但可用的方案替代,让用户基本无感知
三个模式的核心思想可以归结为一句:"假设一切都会失败,设计好失败后的行为。" 这不是悲观,而是分布式系统的基本素养——在成千上万的节点中,故障是常态,不是异常。
正如 Netflix 的 Chaos Monkey 所倡导的:"与其祈祷系统不出故障,不如让系统在故障中依然可用。"
熔断、降级、隔离三件套,就是你在分布式系统中对抗故障的三把利剑。
八、面试官视角:请你回答
以下问题不计入 40 分钟阅读时间,建议在理解文章内容后认真思考。
Q1:请描述熔断器三种状态之间的转换条件,以及为什么需要 HALF_OPEN 状态而不是直接从 OPEN 跳到 CLOSED?
参考答案:
三种状态及转换条件:
- CLOSED → OPEN:在统计窗口内,失败率(或慢调用比例)达到预设阈值,且请求量达到最小调用数阈值。
- OPEN → HALF_OPEN:经过预设的休眠时间后自动切换,不依赖任何外部事件。
- HALF_OPEN → CLOSED:探测请求的成功率达到阈值(通常全部成功)。
- HALF_OPEN → OPEN:探测请求失败,立即回到 OPEN 状态,重新计时。
为什么需要 HALF_OPEN? 如果从 OPEN 直接跳到 CLOSED,所有积压请求会瞬间涌入下游服务。但下游服务可能只是"看起来恢复了"——比如只恢复了部分能力,或者恢复后容量只有原来的 50%。直接全量放开会导致下游再次被打垮,形成"熔断 → 恢复 → 打垮 → 熔断"的震荡循环。HALF_OPEN 的作用就是用小流量探测,验证下游是否真正恢复,确认安全后再逐步放开。这本质上是一种"灰度恢复"策略:先放 1-3 个请求试探,确认没问题再全量放开。
Q2:线程池隔离和信号量隔离的核心区别是什么?为什么信号量隔离不适合用于网络调用?
参考答案:
核心区别在于执行线程归属和超时中断能力:
| 维度 | 线程池隔离 | 信号量隔离 |
|---|---|---|
| 执行线程 | 独立线程池中的线程 | 调用方线程(如 Tomcat worker 线程) |
| 超时中断 | 可通过 Future.cancel(true) 中断 | 无法中断已发起的调用 |
| 资源开销 | 线程上下文切换 + 栈内存(~1MB/线程) | 几乎无额外开销 |
| ThreadLocal 传递 | 丢失,需额外处理 | 天然支持(同一线程) |
| 队列缓冲 | 线程池自带队列 | 无队列,信号量满直接拒绝 |
信号量隔离不适合网络调用的根本原因:信号量只控制"有多少个调用正在执行",但无法在调用超时后中断它。当网络调用阻塞时(比如下游服务 hang 住不返回),调用方线程(Tomcat worker)会一直阻塞,直到 TCP 超时(可能数分钟)。信号量许可虽然被占用,但没有机制释放它。最终所有 Tomcat worker 线程都被卡住,服务完全不可用。而线程池隔离中,每个调用在独立线程中执行,可以通过 Future.get(timeout) 在超时后中断线程,释放资源。
记忆口诀:"信号量管并发,线程池管隔离。网络调用用线程池,本地计算用信号量。"
Q3:假设你负责一个电商系统的订单服务,它依赖 8 个下游服务(库存、支付、用户、优惠券、物流、推荐、风控、广告)。请设计完整的熔断/降级/隔离方案,包括:每个依赖的依赖等级、降级策略、熔断阈值、隔离方式。并说明不同依赖故障时,用户体验的差异。
参考答案:
| 依赖 | 等级 | 隔离方式 | 熔断配置 | 降级策略 |
|---|---|---|---|---|
| 库存服务 | 核心 | 线程池(20线程) | 错误率50%, 慢调用200ms, 熔断10s | 返回 Redis 缓存的库存快照,标注"库存信息可能不准确" |
| 支付服务 | 核心 | 线程池(20线程) | 错误率30%, 熔断5s | 不可降级,返回明确错误引导用户重试。支付是资金链路,降级意味着少收/多收钱,不可接受 |
| 用户服务 | 重要 | 信号量(50并发) | 错误率50%, 熔断30s | 返回本地缓存的用户基本信息,头像使用默认图 |
| 优惠券服务 | 重要 | 线程池(10线程) | 错误率50%, 熔断15s | 跳过优惠券计算,按原价下单,提示"优惠暂不可用" |
| 物流服务 | 次要 | 信号量(20并发) | 错误率80%, 熔断30s | 延迟查询,先返回"物流信息获取中",异步补推 |
| 推荐服务 | 非核心 | 信号量(10并发) | 错误率50%, 熔断60s | 返回热门商品静态列表(预热好的兜底数据) |
| 风控服务 | 核心 | 线程池(15线程) | 错误率30%, 熔断5s | 需谨慎——宁可保守拒绝可疑订单,也不能跳过风控。降级为本地规则引擎(IP 黑名单、频率限制) |
| 广告服务 | 非核心 | 信号量(5并发) | 错误率50%, 熔断120s | 静默失败,不展示广告位 |
用户体验差异:
- 库存 + 支付正常 → 核心交易可完成,用户基本无感知
- 优惠券降级 → 用户看到"优惠暂不可用"提示,可以原价购买,体验略降但可接受
- 推荐降级 → 展示热门商品,用户感知不到推荐内容不再个性化
- 风控降级 → 用户可能被保守策略误拦截,但这是权衡后的安全决策
- 库存 + 支付同时故障 → 极端场景,触发全局降级,展示"系统繁忙,请稍后重试"并记录用户上下文以便恢复
Q4:在高并发场景下,如果顶层服务(如网关)的线程池耗尽,即使熔断器正常工作,请求也可能无法进入业务层。如何解决这个问题?
参考答案:
这是典型的"熔断器生效了但请求进不来"的问题,根源在于熔断器保护的是业务调用层,但线程池在更上层就已经满了。解决方案分五层:
第一层——网关层限流(预防):在网关层做全局限流,确保进入业务层的请求量不超过系统承载能力。当网关检测到下游服务熔断比例升高时,主动降低限流阈值,从源头减少请求量。
第二层——快速失败(止损):网关线程池使用有界队列 + 拒绝策略。不要用无界队列——否则线程池满只是表象,真实问题是队列中积压了大量请求等待超时(每个请求要等 30 秒超时,队列里 1000 个请求意味着新请求要等 30000 秒)。推荐使用 AbortPolicy 立即抛出异常,让网关直接返回降级响应。
第三层——自适应降级(协同):将熔断器状态通过配置中心或服务发现暴露给网关。网关在路由时检查下游依赖的熔断器状态,如果关键依赖全部熔断,网关直接返回降级响应,不占用业务线程池。这本质上是把熔断判断前置到网关层。
第四层——资源隔离(架构):为不同优先级的请求使用不同的线程池。健康检查、监控端点使用独立线程池,确保即使业务线程池满,K8s 的 Liveness Probe 仍能返回成功,避免 Pod 被误杀重启——重启会导致冷启动,雪上加霜。
第五层——弹性扩容(兜底):HPA 基于线程池使用率自动扩容。当线程池使用率 > 70% 时触发扩容,在流量峰值到来前增加 Pod 数量。
关键设计原则:每层超时逐层递减,不能让外层超时大于内层,否则外层连接先断开,内层还在空转。
Q5:假设你使用 Resilience4j 实现熔断器,设置 failureRateThreshold=50%, minimumNumberOfCalls=10, slidingWindowSize=100。在以下场景中,熔断器何时会 OPEN?
参考答案:
Resilience4j 使用 count-based 滑动窗口(slidingWindowSize=100 表示存储最近 100 次调用结果的环形缓冲区),minimumNumberOfCalls=10 表示窗口内至少 10 次调用才计算失败率。判断逻辑:失败率 >= failureRateThreshold 且 调用次数 >= minimumNumberOfCalls。
- 场景 A(10 成功 + 1 失败):不会 OPEN。窗口内共 11 次调用(≥10),失败率 1/11 ≈ 9.1% < 50%,不满足阈值。
- 场景 B(5 成功 + 5 失败 + 90 成功):不会 OPEN。窗口内最近 100 次调用含 5 次失败,失败率 5/100 = 5% < 50%。注意:前 5 次成功和 5 次失败都在滑动窗口内,但 5 次失败远低于阈值。
- 场景 C(连续 10 次失败):会 OPEN。窗口内共 10 次调用(≥10),失败率 10/10 = 100% > 50%,立即触发熔断。
- 场景 D(前 50 成功 + 后 50 失败):会 OPEN。窗口内最近 100 次调用,失败率 50/100 = 50%。注意:Resilience4j 判断条件是
>=,50% ≥ 50% 为 true,触发熔断。
追问思考:如果 slidingWindowSize=1000,场景 B 和 D 的结果会变化吗?
- 场景 B:失败率 5/1000 = 0.5%,不会 OPEN,结论不变。
- 场景 D:如果窗口内只有这 100 次调用,失败率 50/100 = 50%,会 OPEN。但如果窗口内还有更早的 900 次成功调用,失败率 50/1000 = 5%,不会 OPEN。这就是滑动窗口大小对熔断敏感度的实际影响。
Q6:在实际项目中,你是如何验证熔断降级配置的有效性的?有没有做过故障演练(Chaos Engineering)?请分享具体的方法和经验。
参考答案:
验证方法(三层递进):
1. 单元测试:使用 Resilience4j 的 CircuitBreakerRegistry 测试模式,模拟失败场景验证状态机转换。
CircuitBreaker cb = registry.circuitBreaker("test");
// 模拟连续失败
for (int i = 0; i < 10; i++) {
    assertThatThrownBy(() -> cb.executeSupplier(() -> { throw new RuntimeException(); }))
        .isInstanceOf(CallNotPermittedException.class);
}
assertThat(cb.getState()).isEqualTo(CircuitBreaker.State.OPEN);
2. 集成测试:使用 WireMock 模拟下游服务,注入延迟和错误,验证熔断 → 降级 → 恢复的完整链路。
3. 压测验证:全链路压测中逐步提高下游延迟,观察熔断器是否在预期阈值触发、降级后的吞吐量是否可接受。
故障演练(Chaos Engineering):
| 层面 | 工具 | 演练内容 |
|---|---|---|
| 网络 | ChaosBlade / Chaos Mesh | 注入网络延迟、丢包。如 blade create network delay --time 3000 --interface eth0 --destination-ip 10.0.1.5,模拟下游延迟 3 秒 |
| 应用 | Arthas | 热更新代码,让特定方法抛异常或 sleep |
| 资源 | cgroup / Stress | 限制下游 CPU/内存,模拟资源耗尽 |
| 依赖 | 人工下线 | 在预发环境手动停掉下游服务,观察上游行为 |
演练流程:制定演练计划 → 预发环境先验证 → 通知相关团队 → 生产环境灰度演练(先演练一个 Pod)→ 观察监控大盘(熔断器状态、降级比例、RT、错误率)→ 记录问题 → 复盘改进。
实操经验:第一次演练时发现库存服务降级逻辑中读取的 Redis 缓存 key 拼写错误,导致降级后缓存也读不到,直接返回了空对象,用户看到"已售罄"——这比不降级还糟糕。所以在演练中不仅验证"是否触发了降级",更要验证"降级后的结果是否正确"。降级逻辑的 bug 往往在平时不会被触发,只有故障演练才能暴露出来。
面试官视角点评:这道题考察的是候选人的工程实践能力,而不是理论背诵。好的回答会包含具体的工具名称、命令、演练中踩过的坑和改进措施。如果候选人能说出"降级逻辑的 bug 平时不会被触发,只有故障演练才能暴露",说明有真实的线上经验。
下一篇预告:189|配置中心设计:版本、推送、灰度、回滚、审计和一致性。