阅读时间:约 45 分钟 | 难度:进阶 | 前置知识:消息队列基本概念、AMQP 协议基础
一、开篇:RabbitMQ 为什么值得深入理解
在消息队列的三大主流选型(RabbitMQ、RocketMQ、Kafka)中,RabbitMQ 是最"老牌"但也是最"灵活"的一个。它严格遵循 AMQP 0-9-1 协议,将消息路由抽象为一套清晰的概念模型——Exchange、Queue、Binding——这套模型赋予了它远超其他 MQ 的路由灵活性。
但灵活性是有代价的。如果你不理解 Exchange 和 Queue 之间的解耦关系、不清楚 Binding Key 和 Routing Key 的区别、不知道 Publisher Confirm 和 Consumer Ack 各自保证什么——那么 RabbitMQ 的"灵活"就会变成"不可预测"。
本文的目标是:让你对 RabbitMQ 核心模型达到"能画出完整架构图、能解释每一条消息的完整流转路径、能独立排查生产问题"的程度。
二、AMQP 0-9-1 协议模型全景
2.1 核心概念关系
RabbitMQ 的消息模型可以概括为一句核心原则:
生产者把消息发给 Exchange,Exchange 根据 Binding 规则把消息路由到 Queue,消费者从 Queue 拉取消息。
这个模型的关键在于:生产者永远不知道消息会进入哪个 Queue,消费者永远不知道消息来自哪个 Exchange。生产者和消费者通过 Exchange + Queue + Binding 这一中间层完全解耦。
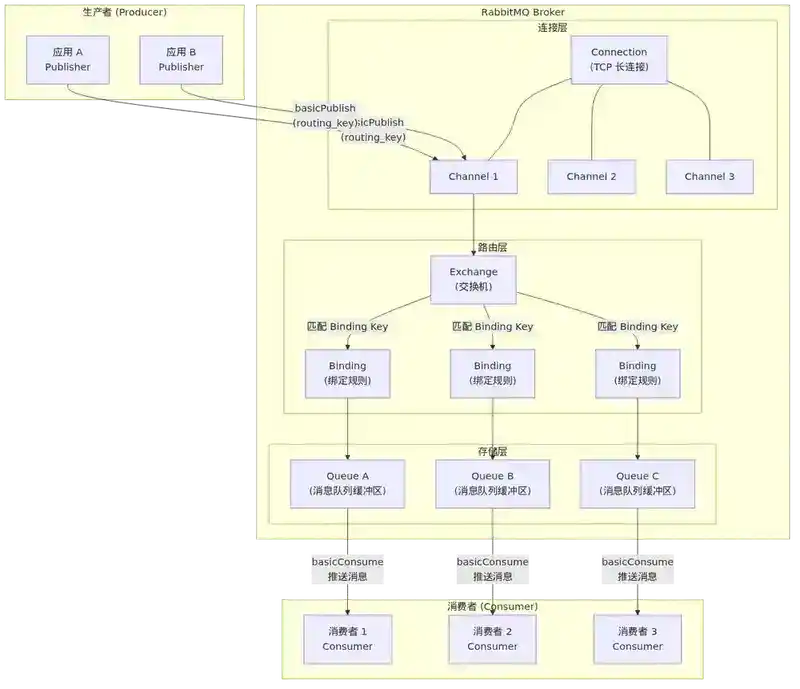
2.2 消息的完整流转路径
一条消息从生产到消费的完整路径:
Producer → Connection → Channel → Exchange → (Binding) → Queue → Channel → Consumer
每个概念的含义:
| 概念 | 作用 | 类比 |
|---|---|---|
| Connection | TCP 长连接,一个 Producer/Consumer 与 Broker 之间的物理连接 | 电话线 |
| Channel | Connection 内的虚拟连接,轻量级,复用 TCP 连接 | 电话线里的分机号 |
| Exchange | 消息路由交换机,接收消息并决定投递到哪些 Queue | 邮局的分拣中心 |
| Binding | Exchange 到 Queue 的绑定关系,包含 Binding Key | 分拣规则 |
| Queue | 消息缓冲区,存储待消费的消息 | 收件人的邮箱 |
2.3 Channel 的重要性
为什么需要 Channel 而不直接用 Connection?因为建立 TCP 连接成本高(三次握手),而且每个连接都会在 Broker 上占用文件描述符和内存。Channel 在同一个 TCP 连接上多路复用,创建开销极低。
生产环境建议:一个 Connection 上可以开几十个 Channel,但不要一个线程一个 Connection。每个 Channel 有自己的 channelId,发送的命令带上 channelId,Broker 就能正确路由到对应的 Channel。
Channel 不是线程安全的——多个线程不要同时使用同一个 Channel 发送消息。标准做法是线程池里的每个线程使用自己的 Channel。
三、Exchange 详解
Exchange 是 RabbitMQ 消息路由的核心。它的职能很单一:接收消息,然后根据路由规则把消息投递到零个或多个 Queue。
3.1 Exchange 的通用属性
所有 Exchange 类型共享以下属性:
| 属性 | 说明 |
|---|---|
| Name | Exchange 名称,全局唯一 |
| Type | 路由类型:direct、fanout、topic、headers |
| Durability | 是否持久化(durable/transient),Broker 重启后是否保留 |
| Auto-delete | 当最后一个绑定 Queue 解绑后,自动删除 Exchange |
| Internal | 是否为内部 Exchange(客户端不能直接发送消息到内部 Exchange,只能通过 Exchange-to-Exchange 绑定) |
| Arguments | 可选参数,如 alternate-exchange |
3.2 Direct Exchange(直连交换机)
规则:Routing Key 与 Binding Key 完全匹配时投递。
Direct Exchange 是最简单的路由方式。一个 Queue 用一个 Binding Key 绑定到 Exchange,生产者发送消息时指定 Routing Key。如果 Routing Key 等于 Binding Key,消息投递到该 Queue。
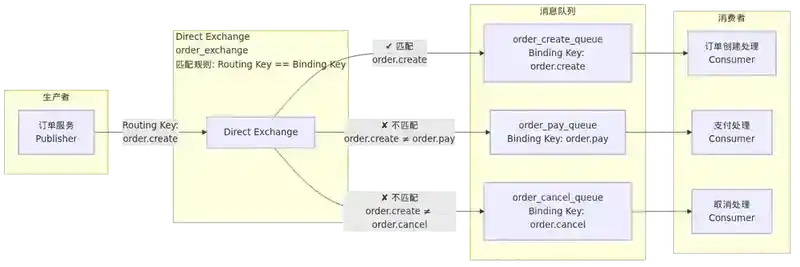
典型场景:
// 声明一个 Direct Exchange
channel.exchangeDeclare("order_exchange", "direct", true);

// 订单创建队列绑定到路由键"order.create"
channel.queueBind("order_create_queue", "order_exchange", "order.create");
// 订单支付队列绑定到路由键"order.pay"
channel.queueBind("order_pay_queue", "order_exchange", "order.pay");
// 订单取消队列绑定到路由键"order.cancel"
channel.queueBind("order_cancel_queue", "order_exchange", "order.cancel");

// 发送消息
channel.basicPublish("order_exchange", "order.create", null, "订单创建消息".getBytes());
// → 只进入 order_create_queue
注意:Direct Exchange 也支持多个 Queue 用相同的 Binding Key 绑定。这种场景下,一条消息会同时投递到所有匹配的 Queue(类似 Fanout 但限定路由键)。这适用于"一消息多消费"的场景(如搜索服务和推荐服务都需要消费同一份商品变更消息)。
3.3 Fanout Exchange(广播交换机)
规则:忽略 Routing Key,消息投递到所有绑定的 Queue。
Fanout 是最快的 Exchange 类型,因为它不需要做任何路由键匹配。
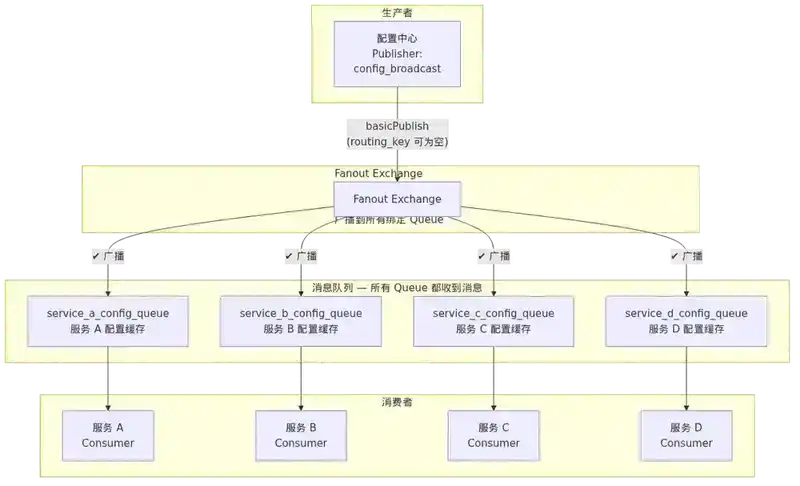
典型场景:配置更新广播、缓存失效通知。
channel.exchangeDeclare("config_broadcast", "fanout", true);

// 多个服务实例各自绑定自己的 Queue
channel.queueBind("service_a_config_queue", "config_broadcast", "");
channel.queueBind("service_b_config_queue", "config_broadcast", "");
channel.queueBind("service_c_config_queue", "config_broadcast", "");

// 发布配置更新,所有服务都能收到
channel.basicPublish("config_broadcast", "", null, "config:db.max_pool=50".getBytes());
3.4 Topic Exchange(主题交换机)
规则:Routing Key 与 Binding Key 的模式匹配。Binding Key 使用 . 分隔的单词列表,支持两个通配符:
*(星号):匹配恰好一个单词#(井号):匹配零个或多个单词
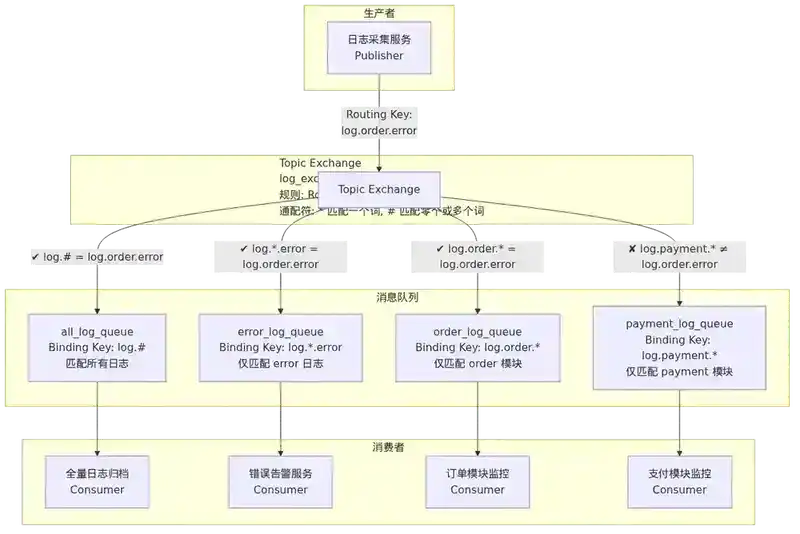
示例:
Binding Key: "order.*.error"  → 匹配 order.create.error、order.pay.error
                                不匹配 order.error、order.create.pay.error

Binding Key: "order.#"        → 匹配 order.create、order.pay.success、order.cancel.error
                                不匹配 product.create

Binding Key: "#.error"        → 匹配 order.error、product.update.error、error
                                匹配所有以.error结尾的routing key
典型场景:日志分级路由,是 Topic Exchange 最经典的用例。
channel.exchangeDeclare("log_exchange", "topic", true);

// 所有级别日志进一个队列
channel.queueBind("all_log_queue", "log_exchange", "log.#");

// 只收集 error 日志
channel.queueBind("error_log_queue", "log_exchange", "log.*.error");

// 只收集 order 模块的日志
channel.queueBind("order_log_queue", "log_exchange", "log.order.*");

// 发布日志
channel.basicPublish("log_exchange", "log.order.error", null, "订单支付超时".getBytes());
// → all_log_queue ✓
// → error_log_queue ✓
// → order_log_queue ✓
性能提示:Topic Exchange 的模式匹配比 Direct 的精确匹配慢,但差距在微秒级。在绝大多数场景下,Topic Exchange 的灵活性收益远大于性能损失。但如果你的系统每秒处理百万级消息且路由键结构简单,Direct Exchange 的多个绑定可能更优。
3.5 Headers Exchange(头部交换机)
规则:忽略 Routing Key,根据消息的 Header 属性匹配。绑定时可以指定 x-match 参数:
x-match=all:消息 Header 必须包含所有指定的键值对(默认)x-match=any:消息 Header 至少包含一个指定的键值对
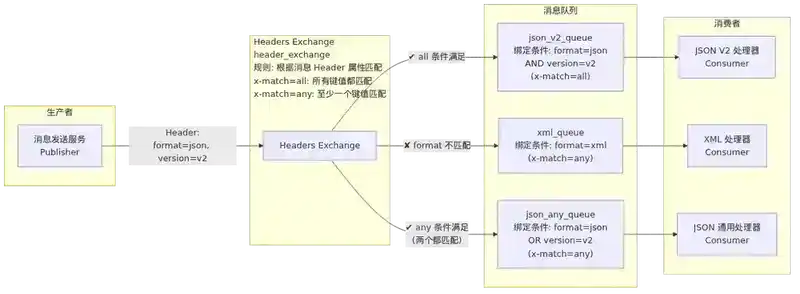
典型场景:按消息的元数据属性(而非路由键)进行路由,如按消息格式(JSON/XML/Protobuf)路由到不同的处理队列。
Map<String, Object> bindingArgs = new HashMap<>();
bindingArgs.put("x-match", "all");
bindingArgs.put("format", "json");
bindingArgs.put("version", "v2");
channel.queueBind("json_v2_queue", "header_exchange", "", bindingArgs);

// 发送消息
Map<String, Object> headers = new HashMap<>();
headers.put("format", "json");
headers.put("version", "v2");
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder().headers(headers).build();
channel.basicPublish("header_exchange", "", props, "消息体".getBytes());
注意:Headers Exchange 在实际生产中使用较少。它比 Topic Exchange 慢,而且大多数路由需求都可以用 Topic Exchange 解决。但它在某些特定场景下(如按消息格式版本路由)比 Topic Exchange 更清晰。
3.6 Exchange 的其他重要特性
Default Exchange:RabbitMQ 内置的无名 Exchange(名称为空字符串 ""),类型为 Direct。每个新创建的 Queue 会自动绑定到 Default Exchange,Binding Key 就是 Queue 名称。你不需要显式声明绑定就能通过 Queue 名称直接发送消息——这是 RabbitMQ 最初级的用法。
Alternate Exchange:当消息无法路由到任何 Queue(没有任何 Binding 匹配)时,消息会被投递到 Alternate Exchange 而不是直接丢弃。这个功能对消息可靠性的保障至关重要。
Map<String, Object> args = new HashMap<>();
args.put("alternate-exchange", "unroutable_exchange");
channel.exchangeDeclare("main_exchange", "direct", true, false, args);
// 未被路由的消息会投递到 unroutable_exchange
Exchange-to-Exchange 绑定:Exchange 可以绑定到另一个 Exchange,实现消息的多级路由。这在复杂路由场景下很有用,比如先按业务域路由(一级 Exchange),再按消息类型路由(二级 Exchange)。
四、Queue 详解
如果说 Exchange 是"分拣中心",Queue 就是"收件人的邮箱"。但它远不止是一个 FIFO 队列那么简单。
4.1 Queue 的核心属性
| 属性 | 说明 | 默认值 |
|---|---|---|
| Name | Queue 名称,全局唯一(或由 Broker 自动生成) | 必填 |
| Durable | 是否持久化,Broker 重启后 Queue 是否保留 | true(推荐) |
| Exclusive | 是否独占(仅当前 Connection 可用,Connection 断开自动删除) | false |
| Auto-delete | 当最后一个 Consumer 断开后,自动删除 Queue | false |
| Arguments | 扩展参数,如 TTL、死信、最大长度等 | 无 |
Durable 和 Exclusive 的排他性:Exclusive 的 Queue 不能是 Durable 的——因为独占 Queue 的生命周期与 Connection 绑定,没有持久化的必要。
4.2 消息持久化
Queue 的 Durable 属性和消息的 Delivery Mode 是两个独立的概念:
- Queue Durable:Broker 重启后 Queue 元数据保留
- Message Persistent(
deliveryMode=2):Broker 重启后消息内容保留
两者必须同时满足才能保证消息不丢失:Durable Queue + Persistent Message。
// 声明持久化队列
channel.queueDeclare("durable_queue", true, false, false, null);

// 发送持久化消息
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .deliveryMode(2)  // 持久化
    .build();
channel.basicPublish("", "durable_queue", props, "重要消息".getBytes());
持久化的代价:持久化消息在写入内存后还需要 fsync 到磁盘,吞吐量会下降。RabbitMQ 的做法是批量刷盘(而非每条消息同步刷盘),在性能和可靠性之间折中。如果对可靠性要求极高,可以配合 Publisher Confirm 使用。
4.3 TTL(Time To Live)
RabbitMQ 支持两种 TTL:
消息 TTL:单个消息的过期时间。过期后消息被丢弃或转入死信队列。
// 设置单条消息的 TTL 为 10 秒
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .expiration("10000")
    .build();
channel.basicPublish("", "queue", props, "消息".getBytes());
Queue TTL:队列级别的过期时间。队列中所有消息共享同一个 TTL。
Map<String, Object> args = new HashMap<>();
args.put("x-message-ttl", 10000);  // 10 秒
channel.queueDeclare("ttl_queue", true, false, false, args);
重要区别:消息级 TTL 和 Queue 级 TTL 的过期行为不同。Queue 级 TTL 的消息一旦过期,会立即从队列头部移除(如果头部消息过期)。但消息级 TTL 的消息只有在到达队列头部时才会被判断是否过期——即使消息已经过期,只要前面还有未消费的消息,它就不会被移除。这在生产环境中可能导致"消息堆积 → 过期消息无法被清理 → 死信队列延迟触发"的连锁反应。
4.4 死信队列(Dead Letter Queue)
当消息满足以下任一条件时,会成为"死信"(Dead Letter):
- 消息被 Consumer 拒绝(
basicReject/basicNack)且requeue=false - 消息 TTL 过期
- 队列达到最大长度,消息被溢出
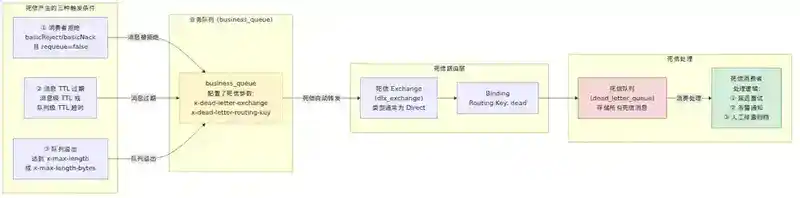
配置死信队列:
// 声明死信 Exchange 和 Queue
channel.exchangeDeclare("dlx_exchange", "direct", true);
channel.queueDeclare("dead_letter_queue", true, false, false, null);
channel.queueBind("dead_letter_queue", "dlx_exchange", "dead");

// 业务队列绑定死信交换机
Map<String, Object> args = new HashMap<>();
args.put("x-dead-letter-exchange", "dlx_exchange");
args.put("x-dead-letter-routing-key", "dead");
args.put("x-message-ttl", 30000);  // 30 秒过期
channel.queueDeclare("business_queue", true, false, false, args);
死信队列的典型用途:
- 延迟重试:消费失败的消息进入死信队列,由专门的消费者处理重试逻辑
- 延迟队列:利用 TTL + 死信队列实现延时消息(RabbitMQ 原生不支持延迟消息,这是社区通用方案)
- 异常消息归档:将无法处理的消息保存起来,供后续人工排查
4.5 队列长度限制与溢出策略
Map<String, Object> args = new HashMap<>();
args.put("x-max-length", 10000);          // 最多 10000 条消息
args.put("x-max-length-bytes", 104857600); // 最多 100MB
args.put("x-overflow", "reject-publish");  // 溢出时拒绝发布(默认 drop-head)
channel.queueDeclare("limited_queue", true, false, false, args);
溢出策略选项:
drop-head(默认):丢弃队列头部(最旧)的消息reject-publish:拒绝新消息的发布,返回basic.nackreject-publish-dlx:拒绝发布并路由到死信队列(RabbitMQ 3.8+)
4.6 其他重要 Queue 参数
| 参数 | 说明 |
|---|---|
x-max-priority |
最大优先级(0-255),值越大优先级越高 |
x-queue-mode |
default(常规)或 lazy(惰性,消息优先存磁盘) |
x-single-active-consumer |
单活跃消费者模式,同一时刻只有一个 Consumer 消费 |
x-queue-type |
classic(经典)或 quorum(仲裁队列,RabbitMQ 3.8+) |
Lazy Queue:适用于消息量极大但消费速度不高的场景(如日志缓冲)。它将消息尽可能存到磁盘而非内存,大幅降低内存占用,但会增加延迟。
Quorum Queue:基于 Raft 协议的队列,强调数据安全性和一致性。相比 Classic Queue(基于镜像),Quorum Queue 在节点故障时数据更安全,但不支持消息优先级和 TTL 等高级特性。
五、Binding 详解
Binding 是 Exchange 和 Queue 之间的"连线"。它的核心要素是 Binding Key,用于和消息的 Routing Key 进行匹配。
5.1 Routing Key vs Binding Key
这是最容易混淆的两个概念,但它们的作用完全不同:
| 概念 | 定义者 | 位置 | 作用 |
|---|---|---|---|
| Routing Key | 生产者 | 消息属性 | 标识消息的"目的地意图" |
| Binding Key | 管理员/开发者 | Queue 绑定 Exchange 时 | 标识 Queue"接受什么消息" |
Exchange 做的就是把 Routing Key 和 Binding Key 进行匹配(根据 Exchange 类型的不同规则),匹配成功就把消息投递到对应的 Queue。
一句话总结:Routing Key 是"我想去哪",Binding Key 是"我接受什么"。
5.2 多绑定与绑定模式
一个 Queue 可以绑定到多个 Exchange,一个 Exchange 可以绑定到多个 Queue。这种多对多的关系构成了 RabbitMQ 极度灵活的路由能力。
// 同一个 Queue 绑定到两个不同的 Exchange
channel.queueBind("order_queue", "order_exchange", "order.create");  // 来自订单服务
channel.queueBind("order_queue", "admin_exchange", "order.manual");  // 来自管理后台
绑定模式:同一个 Queue 用不同的 Binding Key 多次绑定到同一个 Exchange:
// 一个日志队列接收 order 和 payment 两个模块的 error 日志
channel.queueBind("log_queue", "log_exchange", "log.order.error");
channel.queueBind("log_queue", "log_exchange", "log.payment.error");
5.3 绑定的生命周期
Binding 在 Queue 删除时自动解除。如果 Exchange 是 auto-delete 的,最后一个 Binding 解除后 Exchange 也会被删除。
注意:在 AMQP 0-9-1 协议中,Binding 是 Queue 的属性,不是 Exchange 的属性。删除 Exchange 不会自动删除 Binding,而是会导致已有的 Binding 失效(因为绑定目标不存在了)。
六、四种路由类型深入对比
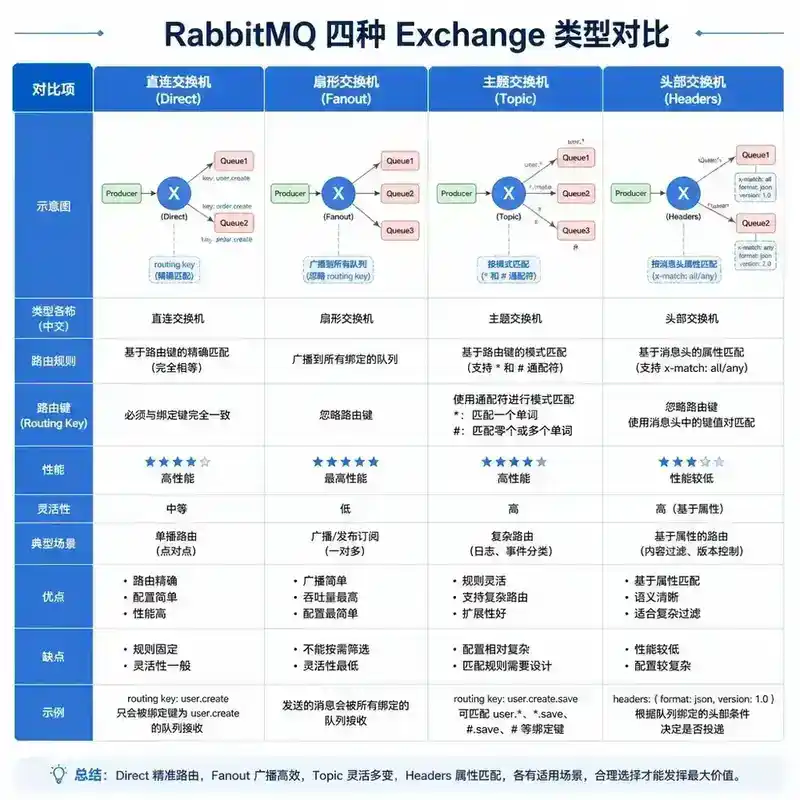
| 维度 | Direct | Fanout | Topic | Headers |
|---|---|---|---|---|
| 匹配方式 | Routing Key 精确匹配 | 忽略 Routing Key,全量广播 | Routing Key 模式匹配(*、#) |
消息 Header 键值匹配 |
| 性能 | 极高 | 最高 | 高(微秒级差异) | 较低 |
| 灵活性 | 低 | 最低 | 高 | 中 |
| 典型场景 | 点对点、任务分发 | 广播通知、配置推送 | 日志分级、多条件路由 | 按元数据路由 |
| 生产使用频率 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐ |
6.1 选型决策树
需要把消息发给所有消费者?
├─ 是 → Fanout Exchange
└─ 否 → 需要复杂的路由规则?
    ├─ 是 → 路由规则是层级结构的?
    │   ├─ 是 → Topic Exchange
    │   └─ 否(基于属性而非键) → Headers Exchange
    └─ 否 → Direct Exchange
6.2 实际生产中的组合使用
场景一:电商订单系统
订单创建消息 → Topic Exchange "order"
  ├─ Binding "order.create" → Queue "order_create_queue" → 订单处理服务
  ├─ Binding "order.*" → Queue "order_log_queue" → 日志服务
  └─ Binding "order.#" → Queue "order_audit_queue" → 审计服务

订单支付成功消息 → Topic Exchange "order"
  ├─ Binding "order.pay.success" → Queue "order_pay_queue" → 支付回调处理
  └─ Binding "order.pay.*" → Queue "order_state_queue" → 订单状态同步
场景二:微服务事件广播
用户注销事件 → Fanout Exchange "user.cancelled"
  ├─ Queue "order_cleanup_queue" → 清理未支付订单
  ├─ Queue "coupon_recycle_queue" → 回收优惠券
  └─ Queue "notification_unsubscribe_queue" → 取消推送订阅
七、消息确认机制
消息确认是 RabbitMQ 可靠性的基石。它分为两个独立的方向:生产者到 Broker(Publisher Confirm)和 Broker 到消费者(Consumer Ack)。
7.1 Publisher Confirm(发布确认)
解决的问题:生产者怎么知道消息是否成功到达 Broker?
默认情况下,basicPublish 不返回任何确认——消息发出去了,但不知道 Broker 是否成功接收和路由。Publisher Confirm 通过 confirmSelect 模式解决这个问题。
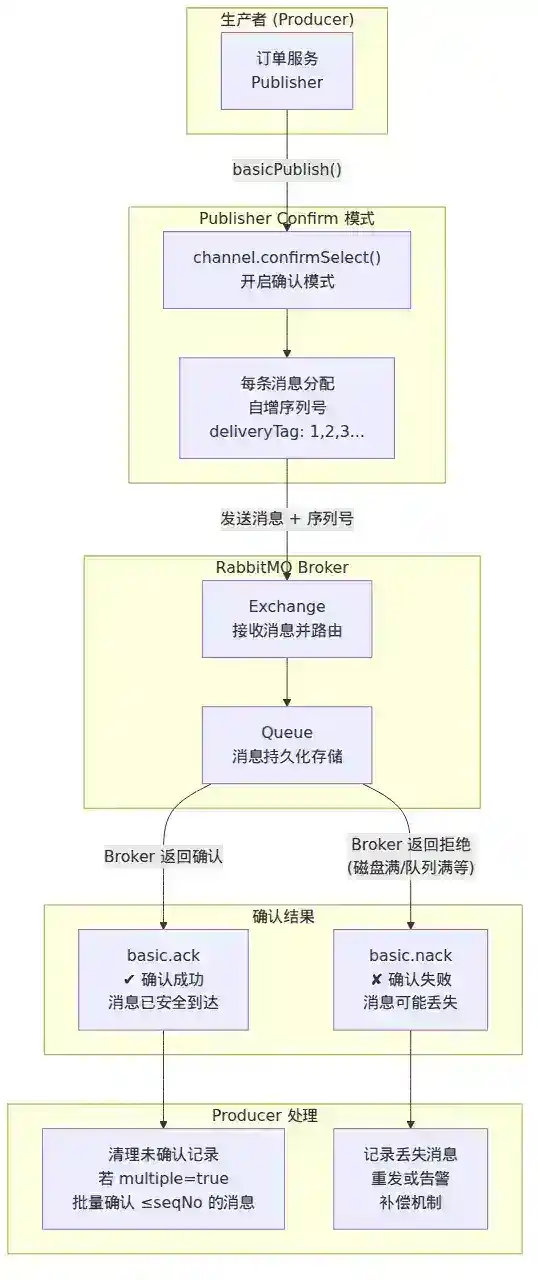
三种使用方式:
方式一:逐条同步确认(最慢,每发一条等一条确认)
channel.confirmSelect();
channel.basicPublish("exchange", "routing_key", null, "msg".getBytes());
if (channel.waitForConfirms()) {
    // 确认成功
}
方式二:批量确认(折中,发一批等一批)
channel.confirmSelect();
for (int i = 0; i < 100; i++) {
    channel.basicPublish("exchange", "routing_key", null, ("msg" + i).getBytes());
}
channel.waitForConfirms(); // 等待这一批全部确认
方式三:异步确认(推荐,高性能)
channel.confirmSelect();
ConcurrentSkipListMap<Long, String> outstandingConfirms = new ConcurrentSkipListMap<>();

channel.addConfirmListener(
    (sequenceNumber, multiple) -> {
        // 确认成功回调
        if (multiple) {
            // 清除所有 <= sequenceNumber 的未确认消息
            outstandingConfirms.headMap(sequenceNumber, true).clear();
        } else {
            outstandingConfirms.remove(sequenceNumber);
        }
    },
    (sequenceNumber, multiple) -> {
        // 确认失败(Nack)回调 — 消息丢失了!
        String lostMsg = outstandingConfirms.get(sequenceNumber);
        // 重发或记录
    }
);

// 发送消息时记录
long seqNo = channel.getNextPublishSeqNo();
outstandingConfirms.put(seqNo, messageBody);
channel.basicPublish("exchange", "routing_key", null, messageBody.getBytes());
关键细节:
multiple=true表示小于等于当前 sequenceNumber 的所有消息都已确认,不需要逐条处理- 确认失败(Nack)意味着消息可能丢失,需要重发
- 结合
mandatory标志和ReturnListener可以处理"消息无法路由到任何 Queue"的情况
7.2 Consumer Ack(消费者确认)
解决的问题:Broker 怎么知道消费者是否成功处理了消息?
RabbitMQ 的消费确认有两种模式:
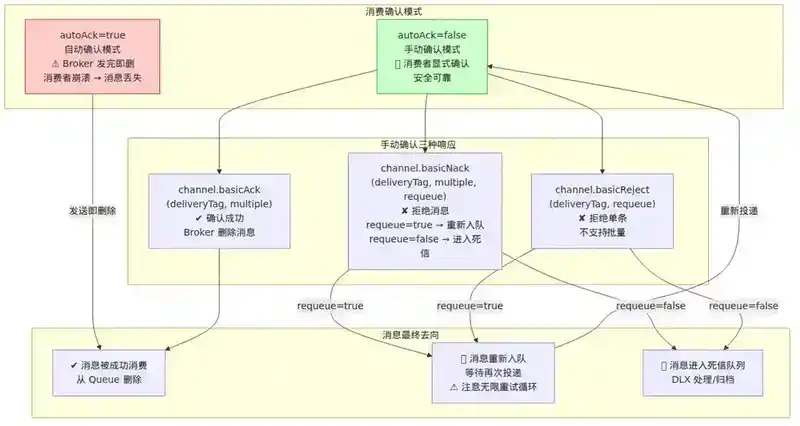
自动确认(autoAck=true):Broker 发送消息后立即认为消息已消费(从 Queue 中删除)。消费者崩溃时消息丢失。
手动确认(autoAck=false):消费者完成处理后,显式发送 basicAck 或 basicNack。
// 消费端设置
boolean autoAck = false;
channel.basicConsume("queue", autoAck, (consumerTag, delivery) -> {
    String message = new String(delivery.getBody());
    try {
        processMessage(message);
        // 单条确认
        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
    } catch (Exception e) {
        // 拒绝并重新入队
        channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
        // 或者:拒绝且不重新入队(进入死信队列)
        // channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, false);
    }
}, consumerTag -> {});
三种确认操作:
| 操作 | 含义 | 适用场景 |
|---|---|---|
basicAck |
确认成功,消息从 Queue 删除 | 正常处理 |
basicNack(requeue=true) |
处理失败,消息重新入队 | 临时故障,重试 |
basicNack(requeue=false) |
处理失败,不重新入队 | 消息数据有问题,需人工处理 |
basicReject(单条) |
同 basicNack,但只能拒绝单条 | 旧版 API |
Prefetch 与消费并发控制:
// Qos:未确认消息数上限
channel.basicQos(50); // 每个 Consumer 最多同时持有 50 条未确认消息
Prefetch 是 RabbitMQ 消费端的核心调优参数。如果设为 1,相当于严格串行消费(Round-Robin 分发);如果设得太大,可能导致消息分配不均(某些消费者很忙,某些很闲)。
生产建议:Prefetch 设为 Consumer 线程数 × 2 到 5 之间。例如 10 个消费者线程,Prefetch 设为 20-50。太小 → 吞吐量低;太大 → 负载不均 + 消费者崩溃时丢失消息多。
7.3 确认机制的完整闭环
将 Publisher Confirm 和 Consumer Ack 结合,形成一个完整的可靠性链条:
Producer → basicPublish → Exchange → Queue → Consumer
   │                         │                  │
   │  Publisher Confirm ←────┘                  │
   │                                            │
   └──────────── 业务完成 ──────────────────────┘
三者结合才能保证端到端的可靠性:
- Publisher Confirm:保证消息从 Producer 到达 Broker
- 消息持久化:保证 Broker 重启后消息不丢失
- Consumer Ack:保证消息被消费者成功处理
八、实战场景与最佳实践
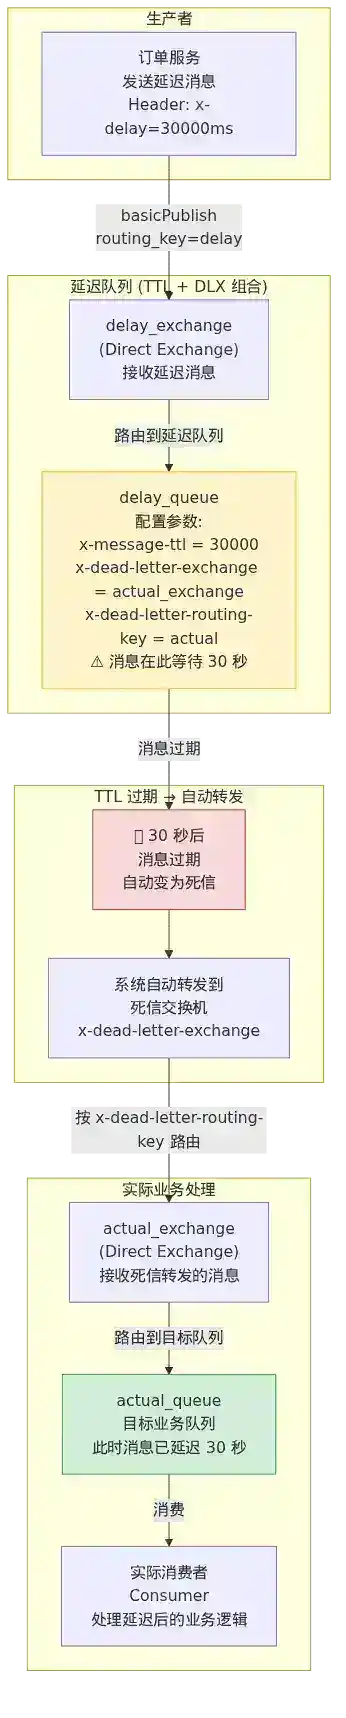
8.1 延迟队列实现(TTL + 死信队列)
RabbitMQ 没有内置的延迟消息功能,但可以通过 TTL + 死信队列组合实现:
Producer → "delay_exchange" → "delay_queue" (TTL 30s)
                                   ↓ (过期后)
                             "dlx_exchange" → "target_queue" → Consumer
// 延迟队列实现
Map<String, Object> delayArgs = new HashMap<>();
delayArgs.put("x-dead-letter-exchange", "actual_exchange");
delayArgs.put("x-dead-letter-routing-key", "actual");
delayArgs.put("x-message-ttl", 30000); // 30 秒延迟
channel.queueDeclare("delay_queue", true, false, false, delayArgs);

// 目标队列
channel.queueDeclare("actual_queue", true, false, false, null);
channel.queueBind("actual_queue", "actual_exchange", "actual");
注意:这种方案有一个限制——所有消息的延迟时间相同(由 Queue 的 TTL 决定)。如果需要不同延迟时间,可以创建多个不同 TTL 的延迟队列,或使用 RabbitMQ 3.8+ 的 Delayed Message Plugin。
8.2 消息优先级队列
Map<String, Object> args = new HashMap<>();
args.put("x-max-priority", 10);
channel.queueDeclare("priority_queue", true, false, false, args);

// 发送高优先级消息
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .priority(10)
    .build();
channel.basicPublish("", "priority_queue", props, "高优先级消息".getBytes());
警告:优先级队列会显著降低吞吐量(约 2-3 倍),因为它需要在内部维护一个堆结构。如果大多数消息优先级相同,可以不用优先级队列,改用多个队列(一个高优先级队列 + 一个普通队列)+ 消费者优先消费高优先级队列。
8.3 生产环境部署建议
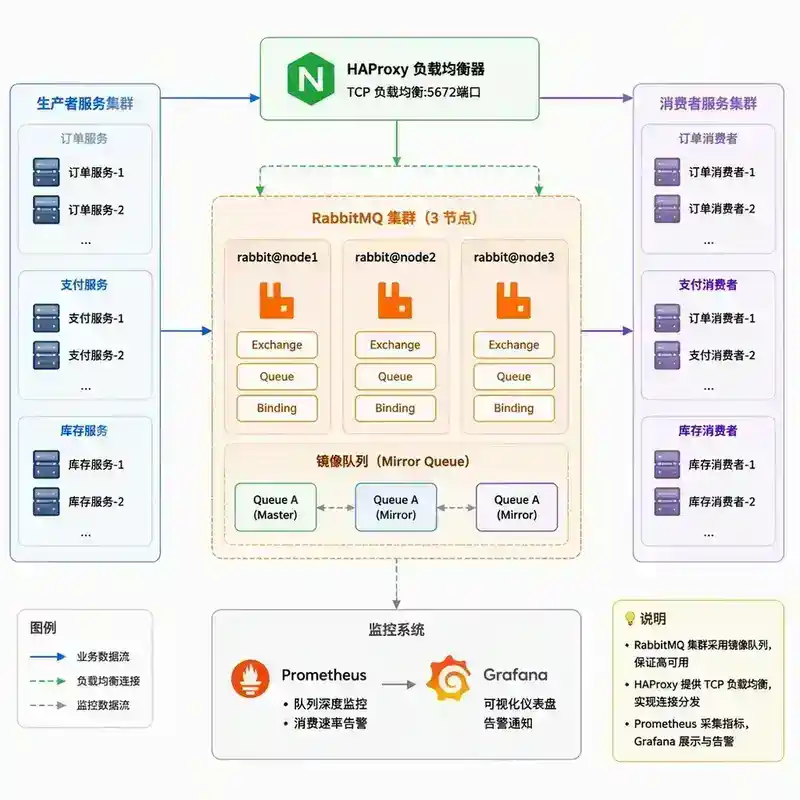
连接管理:
- 一个应用实例一个 Connection,不要每个线程一个 Connection
- 每个线程一个 Channel,Channel 用完及时关闭
- 设置
connectionTimeout和heartbeat防止僵死连接
队列设计:
- 队列名有明确的命名规范(如
{服务名}.{业务}.{用途}) - 设置合理的队列长度上限,避免无限制堆积
- 为所有关键队列配置死信交换机
确认机制:
- 关键业务消息必须开启 Publisher Confirm
- Consumer 必须使用手动 Ack(
autoAck=false) - 设置合理的 Prefetch 值(建议 20-50)
监控告警:
- 监控队列深度(
queue_depth)和消费速率(consume_rate) - 监控未确认消息数(
unacked_messages) - 设置堆积告警阈值(如超过 10 万条消息告警)
九、常见问题与排查
9.1 消息丢失排查
场景一:消息发了但消费者没收到
排查步骤:
- 检查 Exchange 是否声明正确(
exchangeDeclare) - 检查 Binding 是否正确(Routing Key 和 Binding Key 匹配)
- 检查消息是否被路由(设置
mandatory=true和ReturnListener捕获未路由消息) - 检查 Queue 是否存在(Manager 界面查看)
- 检查 Auto-delete 或 TTL 是否导致 Queue/消息被提前删除
场景二:Consumer 重启后消息丢失
排查:
- Queue 是否声明为
durable=true - 消息是否声明为
persistent(deliveryMode=2) - Consumer 是否使用了
autoAck=true(消息被 Broker 立即删除,但 Consumer 还没处理完)
9.2 消息堆积排查
- 检查 Consumer 数量是否足够
- 检查 Prefetch 值是否过小
- 检查 Consumer 是否有慢处理逻辑(数据库慢查询、外部 API 调用超时)
- 检查是否有队列被阻塞(顺序消费场景下某条消息处理失败)
- 检查是否有未确认消息堆积(
channel.basicGet查看 Unacked 计数)
9.3 性能调优
- 批量发送:使用
basicPublish的异步模式,客户端内部批量发送 - 批量确认:使用 Publisher Confirm 的异步模式,而非逐条确认
- Consumer 并发:增加 Consumer 实例数,而非单实例增加线程数(避免单点故障)
- Lazy Queue:消息量大但消费慢时,使用 Lazy Queue 降低内存压力
- 避免优先级队列:除非必要,否则不使用优先级队列
十、总结
RabbitMQ 的核心模型只有四个概念:Exchange、Queue、Binding、Message。但每个概念都有丰富的配置选项和语义细节。以下是本文的要点回顾:
- Exchange 是路由器:四种类型各有用武之地,大部分场景 Topic + Direct 组合足够
- Queue 是缓冲区:持久化、TTL、死信、优先级等特性根据不同业务需求配置
- Binding 是连接线:Routing Key 和 Binding Key 是两个概念,一个来自生产者,一个来自绑定配置
- 确认机制是可靠性基石:Publisher Confirm 保障生产端,Consumer Ack 保障消费端,两者缺一不可
- 灵活性的代价是复杂度:RabbitMQ 的灵活性意味着你需要理解更多概念,才能避免踩坑
掌握这些核心概念后,RabbitMQ 就不再是一个"黑盒",而是一个可以精确控制消息流转的可靠基础设施。
面试官提问
以下问题从面试官视角设计,考察对 RabbitMQ 核心模型的深度理解。建议在理解全文后尝试回答,每题思考 3-5 分钟。
Q1:RabbitMQ 的 Topic Exchange 使用 * 和 # 通配符进行路由匹配。假设有 Binding Key 为 "a.*.b.#" 的一个 Queue,请问 Routing Key 为 "a.x.b" 和 "a.x.y.b" 的消息分别会投递到这个 Queue 吗?为什么?如果 Binding Key 改为 "a.#.b.#" 呢?
Q2:你在生产环境中遇到了消息丢失的问题。排查后发现 Queue 声明为 durable=true,消息 deliveryMode=2,但 Consumer 重启后仍有少部分消息丢失。请分析可能的原因,并说明如何验证和修复。
Q3:项目组决定用 RabbitMQ 的延迟队列(TTL + 死信队列)实现"下单 30 分钟未支付自动关单"。但上线后发现,当订单量激增时,部分订单的关单延迟远超 30 分钟(有时达到 1 小时以上)。请分析原因并提出解决方案。
Q4:你的系统同时使用了 RabbitMQ 和 Kafka。请从消息模型(Exchange/Topic)、消费模型(Push/Pull)、确认机制(Ack/Offset Commit)三个维度,对比两者的核心差异,并说明各自的适用场景。
Q5:一个 Direct Exchange 绑定了 5 个 Queue,所有 Queue 使用相同的 Binding Key。生产者发送一条 Routing Key 匹配的消息后,这条消息会被投递到几个 Queue?如果使用 basicGet 从这 5 个 Queue 中取消息,消费者能拿到这条消息吗?这和 Fanout Exchange 有什么区别?
Q6:在 Spring Boot 中使用 @RabbitListener 注解消费消息,默认的确认模式是什么?如果消息处理过程中抛出异常,消息会怎样?如果你想实现"消费失败后延迟 5 秒重试,最多重试 3 次,仍失败则进入死信队列",应该如何配置?
Q7:假设你有一个高并发场景(每秒 10 万条消息),每条消息需要写入数据库。你发现 Consumer 的处理速度跟不上生产速度,消息堆积严重。请从 RabbitMQ 配置和消费端设计两个角度,给出你的优化方案。
面试官视角 · 参考答案
Q1 答案:Topic Exchange 通配符匹配规则
a.x.b:会投递。解析:a.*.b.# 中 * 匹配恰好一个单词 x,# 匹配零个单词(即末尾没有更多段),所以 a.x.b 完全匹配。
a.x.y.b:不会投递。解析:a..b.# 第一段 a 匹配, 匹配 x,第三段要求 b,但 a.x.y.b 的第三段是 y,不匹配。# 只能匹配从当前位置开始的部分,而 a.*.b.# 要求第三段是 b,a.x.y.b 的第三段是 y,在前三段就不匹配。
a.#.b.#:a.x.b 会投递,a.x.y.b 也会投递。解析:# 匹配零个或多个单词。a.x.b 中第一个 # 匹配零个单词(a. + 空 + .b. + 空),a.x.y.b 中第一个 # 匹配 x.y(a. + x.y + .b. + 空)。注意第一个 # 是贪婪的,它会尽可能多地匹配,但要保证后续的 .b 段能匹配上。
关键考察点:是否理解 * 和 # 的语义差异,以及 # 的贪婪匹配特性。
Q2 答案:Consumer 重启后消息丢失的根因分析
即使 Queue 声明为 durable=true,消息 deliveryMode=2,Consumer 重启后仍可能丢失消息,原因集中在 Consumer Ack 模式。
最可能的原因:使用了 autoAck=true
当 autoAck=true 时,Broker 将消息推送给 Consumer 后立即从 Queue 中删除该消息,无论 Consumer 是否真正处理完成。如果 Consumer 在收到消息后、处理完成前崩溃,消息就丢失了——Broker 以为消息已被消费,但实际上处理失败了。
验证方法:
- 检查 Consumer 端代码中 basicConsume 的 autoAck 参数是否为 true
- 在 RabbitMQ Management 界面查看 unacked 计数——如果 autoAck=true,unacked 在消息推送后立即归零
- 模拟 Consumer 崩溃场景:发送消息后立即 kill Consumer 进程,查看消息是否还在 Queue 中
其他可能原因:
- Prefetch 过大:Consumer 从 Broker 拉取了大量消息到本地缓冲区但未处理完就崩溃了
- Queue 的 auto-delete 属性:如果最后一个 Consumer 断开后 Queue 被自动删除,重启后 Queue 不存在
- 消息 TTL 过期:如果 Queue 设置了 TTL 且 Consumer 处理速度慢,消息在 Queue 中过期被删除
修复方案:
// 1. 设置手动确认
boolean autoAck = false;
channel.basicConsume("queue", autoAck, (consumerTag, delivery) -> {
    try {
        processMessage(delivery);
        // 2. 处理成功后才确认
        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
    } catch (Exception e) {
        // 3. 失败时重新入队(或转入死信队列)
        channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
    }
}, consumerTag -> {});

// 4. 设置合理的 Prefetch
channel.basicQos(50); // 限制未确认消息数
Q3 答案:延迟队列延迟时间异常的原因与解决方案
根因:消息级 TTL 的惰性过期机制
当使用 Queue 级别的 TTL 实现延迟队列时,所有消息共享同一个过期时间,这没问题。但如果使用的是消息级 TTL(每条消息设置自己的 expiration),就会出现问题。RabbitMQ 判断消息是否过期的方式是:只有当消息到达 Queue 头部时,才会检查它是否过期。如果前面的消息还没过期,后面的消息即使已经过期也不会被移除。
具体场景:订单 A 先入队,过期时间 30 分钟;订单 B 晚 5 分钟入队,过期时间也是 30 分钟。正常情况下,A 在 T+30 分钟过期,B 在 T+35 分钟过期。但如果 A 因为某些原因(如死信队列处理慢)卡在头部,B 即使到了 T+35 分钟也不会被移除——因为 B 还在 A 后面,没到头部。
解决方案一:使用 Queue 级 TTL(不同延迟时间用不同 Queue)
// 为不同延迟时间创建不同的 Queue
Map<String, Object> args30s = new HashMap<>();
args30s.put("x-dead-letter-exchange", "order_dlx");
args30s.put("x-dead-letter-routing-key", "order_close");
args30s.put("x-message-ttl", 30000); // 30秒
channel.queueDeclare("order_delay_30s", true, false, false, args30s);
解决方案二:使用 RabbitMQ Delayed Message Plugin(推荐)
RabbitMQ 3.5.8+ 提供了 rabbitmq_delayed_message_exchange 插件,直接在 Exchange 层面支持延迟消息,不依赖 TTL+DLX:
Map<String, Object> args = new HashMap<>();
args.put("x-delayed-type", "direct");
channel.exchangeDeclare("delayed_exchange", "x-delayed-message", true, false, args);

// 发送延迟消息
Map<String, Object> headers = new HashMap<>();
headers.put("x-delay", 30000); // 延迟 30 秒
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .headers(headers).build();
channel.basicPublish("delayed_exchange", "order_close", props, body);
解决方案三:多队列分片 + 轮询消费
如果消息量极大,可以创建多个相同 TTL 的队列,然后用一致性哈希或轮询方式将消息分布到不同队列,避免单队列堆积。
关键考察点:是否了解消息级 TTL 的惰性过期机制,以及 Delayed Message Plugin 的存在。
Q4 答案:RabbitMQ vs Kafka 核心差异对比
消息模型:RabbitMQ 采用 Exchange→Queue 灵活路由,支持 Direct/Fanout/Topic/Headers 四种类型;Kafka 采用 Topic→Partition 顺序写入,消息按 Key 哈希到 Partition,无路由逻辑。
消费模型:RabbitMQ 默认 Push 模式(Broker 推送给 Consumer),也可用 basicGet 拉取;Kafka 采用 Pull 模式(Consumer 主动拉取),通过 offset 控制消费位置。
确认机制:RabbitMQ 的 Consumer Ack 是单条消息确认(basicAck/basicNack),支持 requeue,Publisher Confirm 是异步确认;Kafka 的 Offset Commit 是 Consumer 提交 offset 表示已消费,消息不会重新入队。
消息回溯:RabbitMQ 不支持(消息消费后即删除);Kafka 支持(消息保留一定时间,可重置 offset 重新消费)。
吞吐量:RabbitMQ 万级/秒;Kafka 百万级/秒。
深度对比:
- Push vs Pull 的工程权衡:Push 模式对 Consumer 的保护更弱——如果 Consumer 处理慢,Broker 持续推送会导致 Consumer 内存溢出。Kafka 的 Pull 模式让 Consumer 按自身能力拉取,天然支持背压。
- 确认机制的根本差异:RabbitMQ 的 Ack 是删除式的——确认后消息从 Queue 中物理删除。Kafka 的 Offset Commit 是标记式的——消息实际保留在 Partition 中,直到超过保留时间,这意味着 Kafka 天然支持消息回溯和重放。
- 路由能力的差异:RabbitMQ 的 Exchange+Binding 模型提供了极强的路由灵活性,适合一份消息需要被多个不同消费者以不同规则消费的场景。Kafka 的 Topic+Partition 模型更简单,适合流水线式的数据处理。
选型建议:需要复杂路由、低延迟、单条消息确认 → RabbitMQ;需要高吞吐、消息回溯、流处理、事件溯源 → Kafka。
Q5 答案:Direct Exchange 多 Queue 绑定行为
会被投递到 5 个 Queue。当多个 Queue 使用相同的 Binding Key 绑定到同一个 Direct Exchange 时,Exchange 会将消息复制并投递到所有匹配的 Queue。这是 AMQP 协议的设计——Exchange 对所有匹配的 Binding 都会投递。
basicGet 能否取到消息:能。basicGet 是同步拉取模式,它直接从指定的 Queue 中获取消息。每个 Queue 中都有这条消息的副本,所以从任意一个 Queue 中 basicGet 都能取到。
与 Fanout Exchange 的区别:Direct + 相同 Binding Key 是选择性广播(必须 Routing Key 匹配,可以只让部分 Queue 接收),Fanout Exchange 是无条件广播(忽略 Routing Key,所有 Queue 必然接收)。Exchange 投递的是消息副本,每个 Queue 独立存储。
关键考察点:是否理解 Exchange 投递的是消息副本、每个 Queue 独立存储,以及 Direct 和 Fanout 的本质区别——前者是选择性广播,后者是无条件广播。
Q6 答案:Spring Boot @RabbitListener 确认模式与重试配置
默认确认模式:AUTO(AcknowledgeMode.AUTO)。Spring AMQP 默认使用 AUTO 模式,其行为是:如果 Listener 方法正常返回(无异常抛出),Spring 自动调用 basicAck 确认消息;如果 Listener 方法抛出异常,Spring 自动调用 basicNack(默认 requeue=true),消息重新入队。
异常抛出后消息的行为:消息会立即重新入队,然后 Broker 再次推送。如果异常是持久性的(如消息格式错误),消息会陷入"推送→抛异常→重新入队→再次推送"的死循环。
实现"延迟 5 秒重试,最多 3 次,失败进死信队列"的配置:
@Configuration
public class RabbitMQConfig {

    // 1. 定义死信交换机和队列
    @Bean
    public DirectExchange dlxExchange() {
        return new DirectExchange("order_dlx_exchange");
    }

    @Bean
    public Queue deadLetterQueue() {
        return new Queue("order_dead_letter_queue", true);
    }

    @Bean
    public Binding dlxBinding() {
        return BindingBuilder.bind(deadLetterQueue())
            .to(dlxExchange()).with("order_dead");
    }

    // 2. 业务队列绑定死信
    @Bean
    public Queue businessQueue() {
        return QueueBuilder.durable("order_queue")
            .deadLetterExchange("order_dlx_exchange")
            .deadLetterRoutingKey("order_dead")
            .build();
    }

    // 3. 重试耗尽后发送到死信队列
    @Bean
    public MessageRecoverer messageRecoverer(RabbitTemplate rabbitTemplate) {
        return new RepublishMessageRecoverer(rabbitTemplate,
            "order_dlx_exchange", "order_dead");
    }

    // 4. 配置重试拦截器
    @Bean
    public RetryOperationsInterceptor retryInterceptor(
            MessageRecoverer messageRecoverer) {
        return RetryInterceptorBuilder.stateless()
            .maxAttempts(3)                    // 最多重试3次
            .backOffOptions(5000, 2.0, 15000)  // 首5秒, 乘2, 最长15秒
            .recoverer(messageRecoverer)       // 重试耗尽后进死信
            .build();
    }

    // 5. Listener 容器工厂
    @Bean
    public SimpleRabbitListenerContainerFactory rabbitListenerContainerFactory(
            ConnectionFactory connectionFactory,
            RetryOperationsInterceptor retryInterceptor) {
        SimpleRabbitListenerContainerFactory factory =
            new SimpleRabbitListenerContainerFactory();
        factory.setConnectionFactory(connectionFactory);
        factory.setAcknowledgeMode(AcknowledgeMode.MANUAL);
        factory.setAdviceChain(retryInterceptor);
        return factory;
    }
}

// 消费者
@RabbitListener(queues = "order_queue")
public void handleOrder(Order order, Channel channel,
        @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) {
    try {
        processOrder(order);
        channel.basicAck(deliveryTag, false);
    } catch (Exception e) {
        throw new AmqpRejectAndDontRequeueException("处理失败", e);
    }
}
关键点:RetryInterceptorBuilder 控制重试次数和退避策略,重试在 Consumer 端进行,消息不会重新入队;重试耗尽后通过 RepublishMessageRecoverer 将消息发布到死信队列;必须使用 AcknowledgeMode.MANUAL,否则 AUTO 模式会在抛异常时 requeue,导致重试和死信队列机制失效。
Q7 答案:高并发消息堆积优化方案
场景分析:每秒 10 万条消息,每条需写数据库。消息堆积说明消费速度 < 生产速度。
RabbitMQ 配置端优化:
- 增加 Consumer 实例数(最直接):水平扩展 Consumer 应用实例,利用 RabbitMQ 的 Round-Robin 分发机制
- 调整 Prefetch 值:channel.basicQos(100-200),让每个 Consumer 同时持有更多消息,减少网络往返
- 使用 Lazy Queue:x-queue-mode=lazy,消息优先存磁盘,降低 Broker 内存压力,避免因内存告警触发流控
- 关闭不必要的特性:不用优先级队列(x-max-priority),减少 Broker 内部开销
- 拆分 Queue:如果业务允许,将消息按某种维度(如用户 ID)哈希到多个 Queue,每个 Queue 独立消费,提高并行度
消费端设计优化:
- 批量处理:Consumer 累积一批消息后批量写入数据库,使用 INSERT INTO ... VALUES (...), (...), (...) 批量插入
- 异步写入 + 本地缓冲:Consumer 收到消息后不直接写 DB,而是写入本地内存队列(如 Disruptor),由独立写入线程批量刷盘
- 数据库写入优化:使用批量 insert 替代逐条 insert,使用异步写入(MySQL 的 rewriteBatchedStatements=true),使用连接池(HikariCP)确保连接数充足,如果数据库仍是瓶颈,考虑先写 Redis 再异步同步到 DB
- 线程池隔离:Consumer 线程只负责接收消息和 Ack,业务处理交给独立线程池
- Consumer 并发:单实例中使用 setConcurrentConsumers(10) 开启多个 Consumer 线程
架构级优化:
如果上述优化后仍有堆积,考虑:
- 将数据库写入从同步改为异步(先发 ACK,再异步写 DB),但需要额外的补偿机制保证数据不丢失
- 引入流处理框架(如 Flink)替代 Consumer 直接写 DB,利用其分布式处理能力
- 评估是否可以减少消息量(如合并、降采样)
关键考察点:是否理解优化是多维度的——Broker 配置、Consumer 设计、业务逻辑,而非仅仅加机器。
本文完成。如有疑问,建议回看核心章节并结合实际项目中的 RabbitMQ 配置进行验证。