阅读时间:约 45 分钟 | 难度:架构师入门 | 序号:191
引言:架构师的第一性原理
在面试中被问到"你怎么设计一个系统"时,多数人会直接开始画架构图:加缓存、上消息队列、搞微服务。但资深面试官想听的,从来不是这些技术名词的堆砌——他们想知道的是:你如何用质量属性来驱动架构决策。
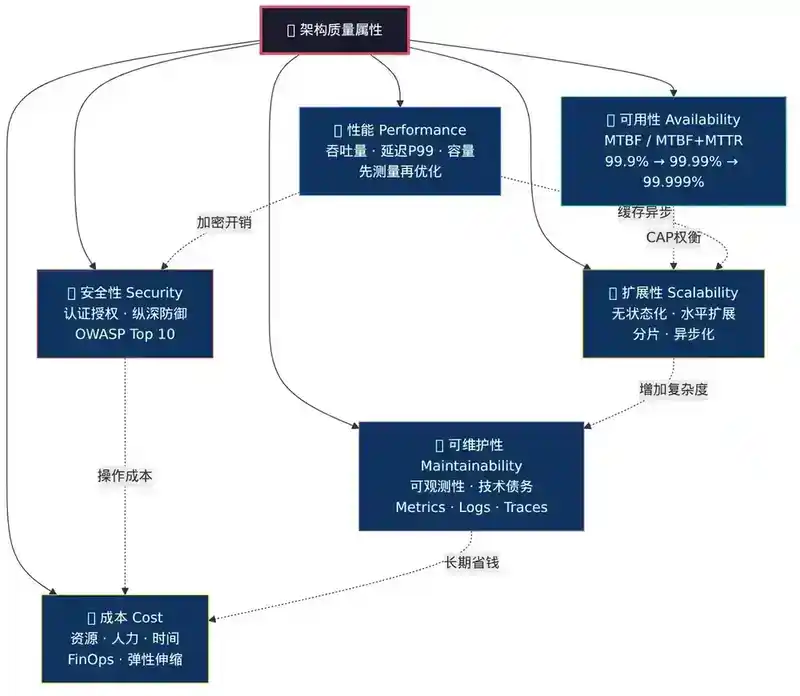
架构质量属性(Quality Attributes)是系统设计的"第一性原理"。它们是判断一个架构好坏的标准,而不是技术选型本身。本文将从六个核心维度展开:可用性、性能、扩展性、安全性、可维护性和成本,帮你建立一套完整的架构评估框架。
一、可用性(Availability)
1.1 定义:系统什么时候能正常工作
可用性不是"系统有没有 bug",而是"用户想用的时候,系统能不能用"。它的量化公式非常直接:
可用性 = MTBF / (MTBF + MTTR)
- MTBF(Mean Time Between Failures):平均故障间隔时间,衡量系统有多"结实"
- MTTR(Mean Time To Repair):平均修复时间,衡量团队有多"快"
这个公式揭示了一个反直觉的事实:可用性既取决于系统不出故障,也取决于出故障后恢复得有多快。一个能 1 分钟自动恢复的系统,比一个 100 天不坏但坏了要修 1 天的系统,可用性更高。
1.2 人人都背过的"几个 9"
| 可用性 | 年宕机时间 | 典型场景 |
|---|---|---|
| 99%(两个 9) | 3.65 天/年 | 内部工具、后台管理系统 |
| 99.9%(三个 9) | 8.76 小时/年 | 多数 B 端 SaaS |
| 99.99%(四个 9) | 52.6 分钟/年 | 支付、电商核心链路 |
| 99.999%(五个 9) | 5.26 分钟/年 | 电信级、金融核心交易 |
每提升一个 9,成本不是线性增长,而是指数增长。从 99.9% 到 99.99%,你需要在冗余、监控、自动化恢复上投入的数量级完全不同。
1.3 实现高可用的核心手段
冗余(Redundancy):没有单点故障。关键组件至少部署两个实例,数据库主从、消息队列多副本。但冗余不是免费的——它带来数据一致性问题(CAP 理论中的 P)。
故障检测与转移:健康检查(Health Check)要区分"进程活着"和"服务可用"。用探活(Liveness Probe)和就绪(Readiness Probe)分别判断。故障转移(Failover)需要处理脑裂(Split Brain)问题——两个节点都认为自己是主——Raft 共识或 Fencing Token 是常见解法。
超时、重试与降级:调用链路中每个节点都要有超时设置,超时后重试要有退避策略(Exponential Backoff + Jitter)。降级(Degradation)不是"系统坏了",而是"系统主动牺牲非核心功能以保证核心链路"。
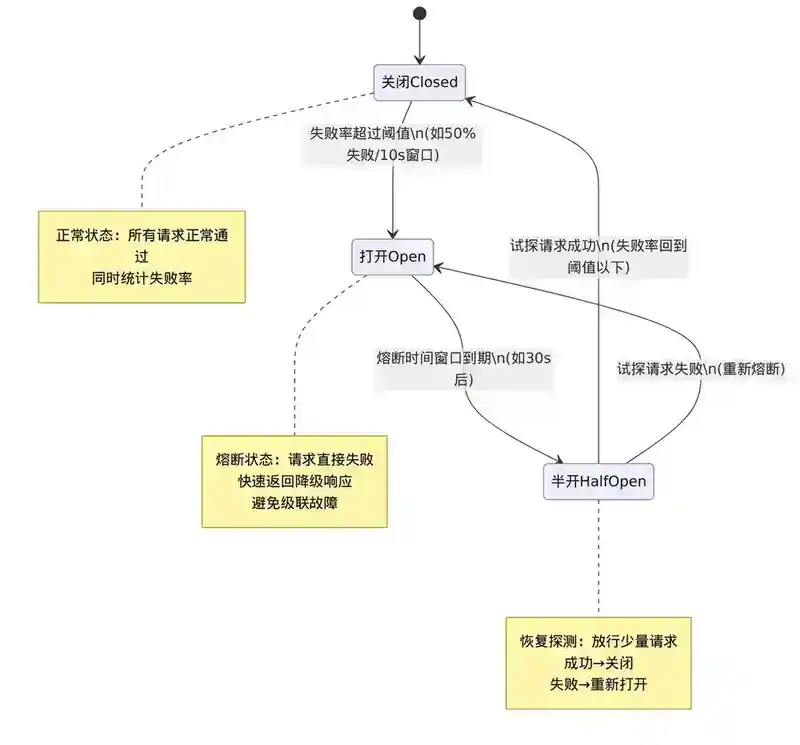
熔断(Circuit Breaker):当依赖服务故障率超过阈值时,快速失败而不是继续等待,避免级联故障。熔断器有三种状态:关闭(正常)→ 打开(快速失败)→ 半开(试探性恢复)。
1.4 生产案例:一次支付网关的可用性事故
某电商支付网关在一次大促中,依赖的银行接口响应变慢。由于没有设置合理的超时和熔断,大量 Tomcat 线程被阻塞在等待银行响应上,最终线程池耗尽,整个支付网关不可用——这就是典型的"级联故障"。修复方案:为每个银行渠道设置独立的线程池(舱壁隔离),接入熔断器(Hystrix/Sentinel),超时时间从 5 秒降到 2 秒,并增加降级到"稍后重试"页面的兜底逻辑。
二、性能(Performance)
2.1 性能不是"快"
性能是一个多维度的概念,至少包含三个核心指标:
- 吞吐量(Throughput):单位时间处理的请求数(QPS/TPS)。衡量系统"能扛多少"
- 响应时间(Response Time/Latency):单个请求的处理时间。衡量系统"有多快"
- 容量(Capacity):在满足某个延迟 SLO 的前提下,系统能承载的最大并发量
一个常见的误区是把"性能"等同于"响应时间"。实际上,一个批处理系统可能单次响应很慢,但吞吐量极高——这依然是高性能。
2.2 百分位延迟(Percentile Latency)
平均值(Avg)会掩盖问题。假设 100 个请求中 99 个在 10ms 内返回,1 个花了 10 秒——平均值是 110ms,看起来还不错,但那个 10 秒的用户体验极差。
- P50(中位数):一半请求比它快,衡量"典型体验"
- P99:99% 请求比它快,衡量"大多数最差体验"
- P999:99.9% 请求比它快,长尾延迟的边界
对于面向用户的在线服务,P99 才是真正需要关注的指标。P99 抖动通常来源:GC 停顿、锁竞争、网络抖动、慢磁盘 I/O。
2.3 性能优化的分层模型
性能优化不是盲目加缓存。从底层到上层,每一层都有优化空间:
- 基础设施层:CPU 亲和性、内存分配、磁盘 I/O 调度、网络参数调优
- JVM 层:GC 选型与参数、堆大小、JIT 编译优化、线程栈大小
- 框架层:连接池配置、线程池参数、序列化协议选择
- 应用层:算法复杂度、数据结构选择、缓存策略、SQL 优化
- 架构层:异步化、读写分离、分库分表、CDN、边缘计算
优化原则:先测量,再优化。没有 profiling 的性能优化就是瞎猜。用火焰图定位热点,用 Arthas 观察实时调用,用 JMH 做微基准测试。
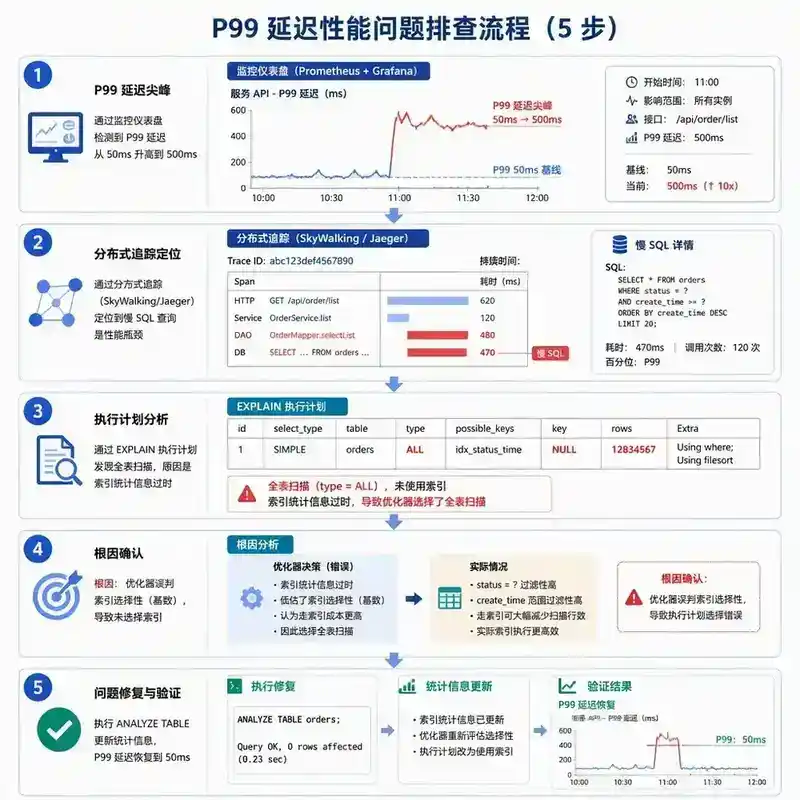
2.4 生产案例:一次 P99 毛刺的排查
某订单查询接口 P99 延迟从 50ms 突增到 500ms。排查过程:
- 链路追踪发现慢在数据库查询
- Explain 执行计划发现索引走了全表扫描
- 根因:统计信息过期,优化器误判了索引选择度
- 修复:
ANALYZE TABLE更新统计信息,P99 恢复到 50ms
教训:性能问题往往是"牵一发而动全身"——一个索引失效,拖垮整个链路。
三、扩展性(Scalability)
3.1 两种扩展方向
垂直扩展(Scale Up):换更大的机器。优点是简单,缺点是贵且有上限。适合单机就能撑住的场景。
水平扩展(Scale Out):加更多的机器。优点是理论无限,缺点是引入分布式复杂度。现代互联网架构几乎都走这条路。
一个系统是否"可扩展",不是看它现在能不能加机器,而是看加机器后吞吐量能否线性增长。如果加一倍的机器,吞吐量只增长 30%,那这个架构的扩展性就有问题。
3.2 可扩展架构的核心模式
无状态化:把状态(Session、缓存、业务数据)从应用层剥离到外部存储(Redis、DB)。无状态的服务可以任意水平复制,负载均衡按需分配。这是可扩展性最基础也是最重要的前提。
分片(Sharding):当数据量超过单库承载能力时,按某个维度(用户 ID、时间、地域)拆分数据。分片的关键是选对分片键——要避免热点(某个分片数据量/流量远超其他),也要考虑未来扩容的平滑性。一致性哈希是解决动态扩缩容时数据迁移量的经典方案。
异步化:同步调用链路中,请求处理的延迟等于各环节延迟之和。将非关键路径改为异步(消息队列、事件驱动),核心链路的延迟不再被拖累。但异步引入的代价是:数据一致性变弱,调试和排查变复杂。
缓存策略:缓存是读扩展最常用的手段。多级缓存(本地缓存 → 分布式缓存 → 数据库)可以大幅降低数据库压力,但需要处理缓存一致性、穿透、击穿、雪崩等问题。
3.3 扩展性陷阱
分布式单体:微服务拆分不彻底,服务间强耦合,一个服务的变更需要十几个服务配合发布——"微服务"变成了"分布式单体",比单体更难维护。
共享数据库:多个服务共享同一个数据库,数据模型相互耦合,单个服务的 SQL 变更可能影响其他服务的查询计划。这是微服务架构中最常见的反模式。
过早优化:在日活不到 1000 的时候就开始设计分库分表、异地多活,不仅是浪费资源,更是给团队增加了不必要的复杂度。
3.4 生产案例:从单体到水平扩展的演进
某 SaaS 系统从单机部署演进到支撑百万用户:
- 第一阶段:应用无状态化,Session 从 Tomcat 内存迁移到 Redis,支持多实例部署
- 第二阶段:数据库读写分离,读请求路由到从库
- 第三阶段:按租户 ID 分库,每个租户的数据落在独立数据库
- 第四阶段:引入消息队列异步处理报表生成、邮件发送等耗时任务
每一步的触发条件都是"当前架构的瓶颈即将到来",而不是"我觉得以后可能需要"。
四、安全性(Security)
4.1 安全不是功能,而是属性
安全性无法像"登录功能"一样被"开发完成"。它是一个持续的过程,需要贯穿系统设计、开发、测试、运维的全生命周期。
4.2 认证(Authentication)与授权(Authorization)
认证回答"你是谁":JWT、OAuth 2.0、SAML、Kerberos。JWT 是最常见的方案,但要注意:
- 不要在 JWT 中存放敏感信息(Payload 是 base64 编码,不是加密)
- 设置合理的过期时间,配合 Refresh Token 实现无感刷新
- Token 吊销是难点——可以用黑名单或版本号机制
授权回答"你能做什么":RBAC(基于角色)、ABAC(基于属性)。RBAC 简单直接,适合大多数场景;ABAC 更灵活但实现复杂,适合权限模型频繁变化的场景。
4.3 纵深防御(Defense in Depth)
安全不能依赖单点防护。每一层都要有安全措施:
- 网络层:防火墙、WAF、DDoS 防护
- 传输层:TLS 1.3、证书管理、HSTS
- 应用层:输入校验、SQL 注入防护、XSS 防护、CSRF Token
- 数据层:加密存储、脱敏、密钥管理(KMS)
- 运维层:最小权限、审计日志、定期渗透测试
4.4 OWASP Top 10 在 Java 中的体现
- SQL 注入:永远用 PreparedStatement,不要拼接 SQL
- XSS:输出编码(HtmlUtils.htmlEscape),CSP 头
- CSRF:Spring Security 的 CSRF Token 默认开启
- SSRF:校验 URL,禁止访问内网地址
- 反序列化漏洞:不使用 Java 原生序列化接收不可信数据,使用 JSON/Protobuf 替代
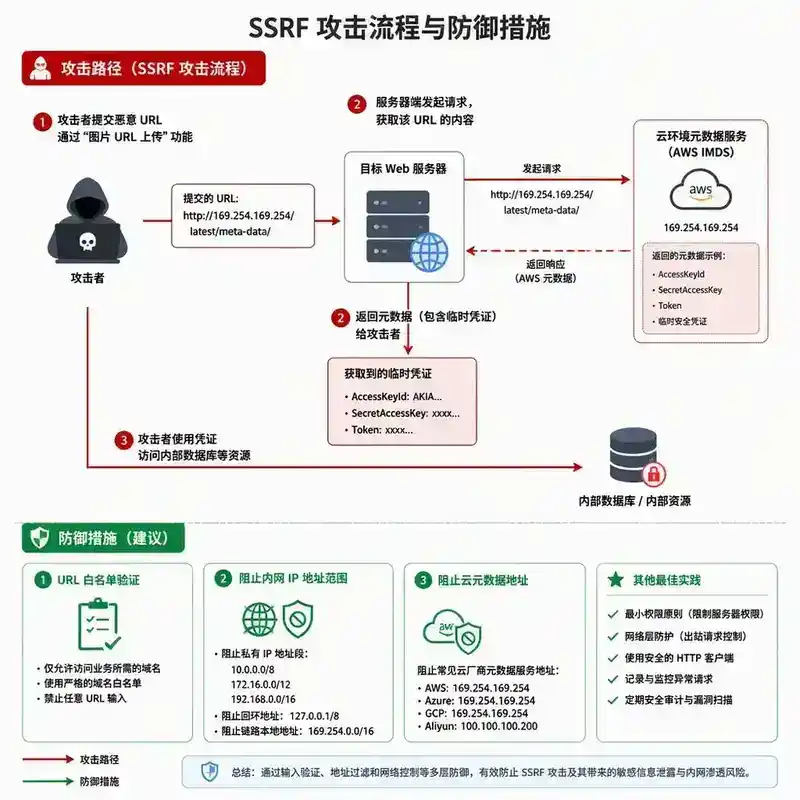
4.5 生产案例:一次 SSRF 导致的内网穿透
某系统提供了一个"通过 URL 上传图片"的功能。攻击者传入 http://169.254.169.254/latest/meta-data/(AWS 元数据服务地址),获取到了云主机的临时凭证,进而访问了内网数据库。修复:URL 白名单校验,禁止访问内网 IP 段和云元数据地址。
五、可维护性(Maintainability)
5.1 代码是写给人看的
可维护性是最容易被忽视的质量属性,但它的影响贯穿系统的整个生命周期——一个系统 80% 的成本在维护阶段,而不是开发阶段。
可维护性包含三个子维度:
- 可操作性(Operability):运维团队能否轻松地部署、监控、排查、扩缩容?
- 简洁性(Simplicity):新加入的开发者能否快速理解系统?
- 可演进性(Evolvability):未来需求变化时,改造成本有多高?
5.2 可观测性:让系统"透明"
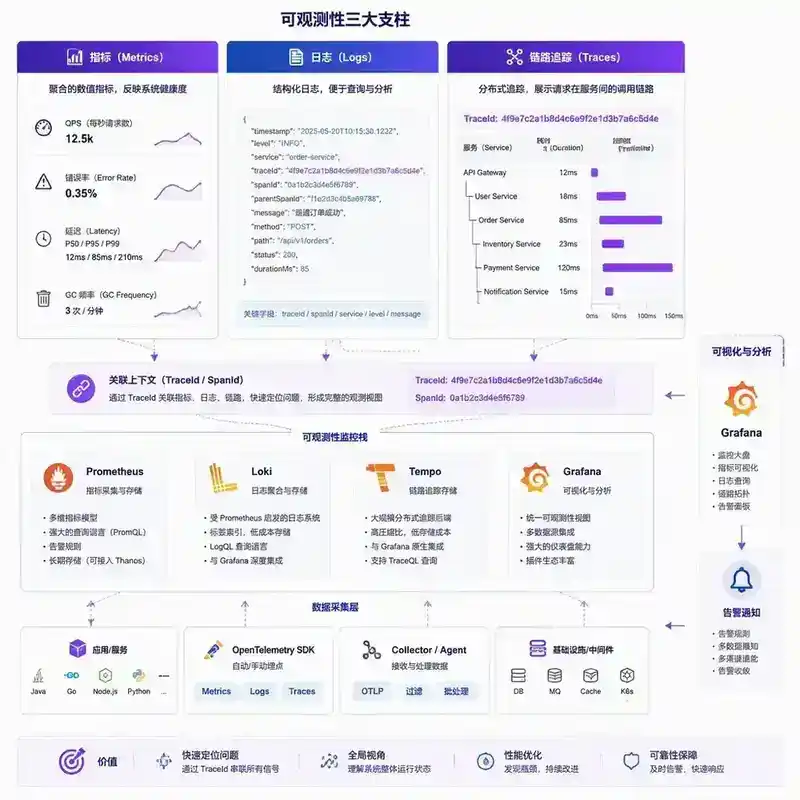
没有可观测性的系统就是黑盒。三大支柱:
- Metrics(指标):聚合数据,告诉你"系统是不是出了问题"。如 QPS、错误率、延迟分位数、GC 频率
- Logs(日志):离散事件,告诉你"具体发生了什么"。关键是要结构化(JSON 格式),包含 TraceId 用于关联
- Traces(链路):请求的全生命周期,告诉你"一次请求经过了哪些服务、各花了多少时间"
三者不是独立的,而是通过 TraceId 和 SpanId 串联在一起。Grafana + Prometheus + Loki + Tempo 是目前主流的开源可观测性方案。
5.3 技术债务管理
技术债务不等于"烂代码"。有些技术债务是刻意的——为了快速验证市场,先上线再优化。但技术债务必须被管理:
- 可视化:记录债务清单,评估影响范围
- 量化:每个债务项应标注"修复成本"和"不修复的代价"
- 偿还节奏:每个迭代拿出 20% 的时间偿还技术债务,而不是等"以后有空"
5.4 生产案例:一次因缺少监控导致的 4 小时故障
某系统数据库连接池默认配置为 10 个连接。随着业务增长,连接池逐渐吃紧,但由于没有连接池利用率监控,团队对此一无所知。直到某天流量高峰,连接池耗尽,所有请求失败。从发现问题到定位到修复,花了 4 小时——如果一开始就有连接池利用率的 Grafana 面板,这个问题在几分钟内就能被发现和解决。
六、成本(Cost)
6.1 成本不只是钱
架构中的"成本"是一个多维概念:
- 资源成本(Infrastructure Cost):服务器、带宽、存储、云服务费用
- 人力成本(People Cost):开发、测试、运维需要多少人?引入新技术需要多少学习成本?
- 时间成本(Time Cost):自研 vs 采购?自研需要 3 个月,采购可能 1 周上线
- 机会成本(Opportunity Cost):花时间做 A 架构,意味着放弃了做 B 架构的机会
6.2 成本与质量的权衡
成本与其他质量属性之间是零和博弈吗?不一定:
- 高可用需要冗余,冗余意味着额外成本。但合理的架构设计(如无状态 + 弹性伸缩)可以在保证可用性的同时控制成本
- 高性能可以从软件层面优化(算法、缓存、索引),不一定需要堆硬件
- 可维护性好的系统,长期看是省钱的——减少故障处理时间、降低新人上手成本
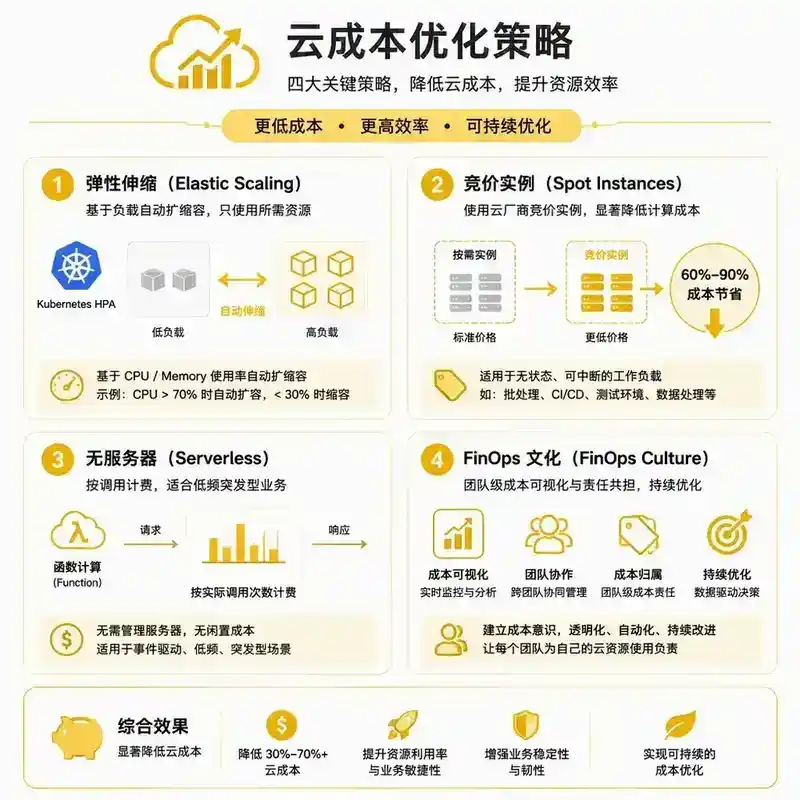
6.3 云原生时代的成本优化
- 弹性伸缩:按需使用,不用为峰值长期预留资源
- Spot 实例:适用于容错性强的无状态服务,可以节省 60-90% 成本
- Serverless:按调用次数付费,适合低频、突发性负载
- FinOps 文化:让每个团队看到自己的云资源账单,培养成本意识
七、质量属性之间的冲突与权衡
7.1 没有完美架构,只有合理的权衡
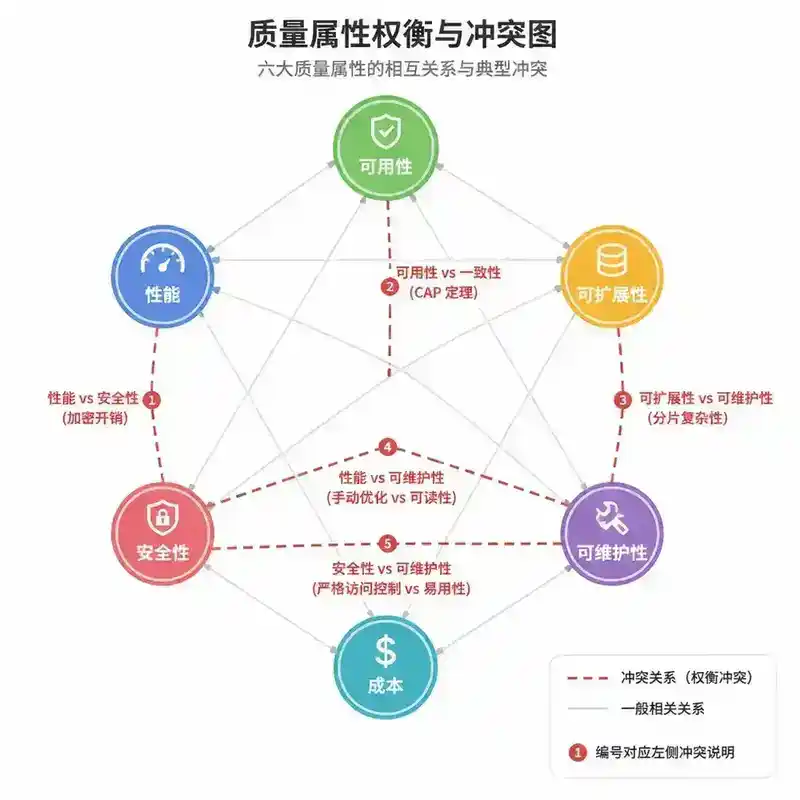
六个质量属性不可能同时最大化。以下是一些经典冲突:
| 冲突 | 说明 |
|---|---|
| 性能 vs 安全性 | 加密、签名、校验都会增加延迟。HTTPS 握手比 HTTP 多 1-2 个 RTT |
| 可用性 vs 一致性 | CAP 定理:分区发生时,你必须在可用性和一致性之间选择 |
| 扩展性 vs 可维护性 | 分库分表提高扩展性,但大幅增加了运维和开发复杂度 |
| 性能 vs 可维护性 | 极致的手工优化(位运算、对象池)提高性能,但降低代码可读性 |
| 安全性 vs 可维护性 | 严格的权限控制和审计使系统更安全,但增加了操作复杂度 |
7.2 权衡决策框架
当面对质量属性冲突时,按以下步骤决策:
- 明确业务优先级:这个系统是"不能挂"(支付)还是"不能慢"(搜索)还是"不能贵"(边缘业务)?
- 量化差距:不是"性能 vs 安全性",而是"P99 增加 50ms vs 无 SQL 注入防护"
- 分场景取舍:支付链路要一致性,非核心链路要可用性——不是非此即彼
- 记录决策:在 ADR(Architecture Decision Record)中记录为什么选择 A 而不是 B,给未来的自己和团队留下上下文
八、总结
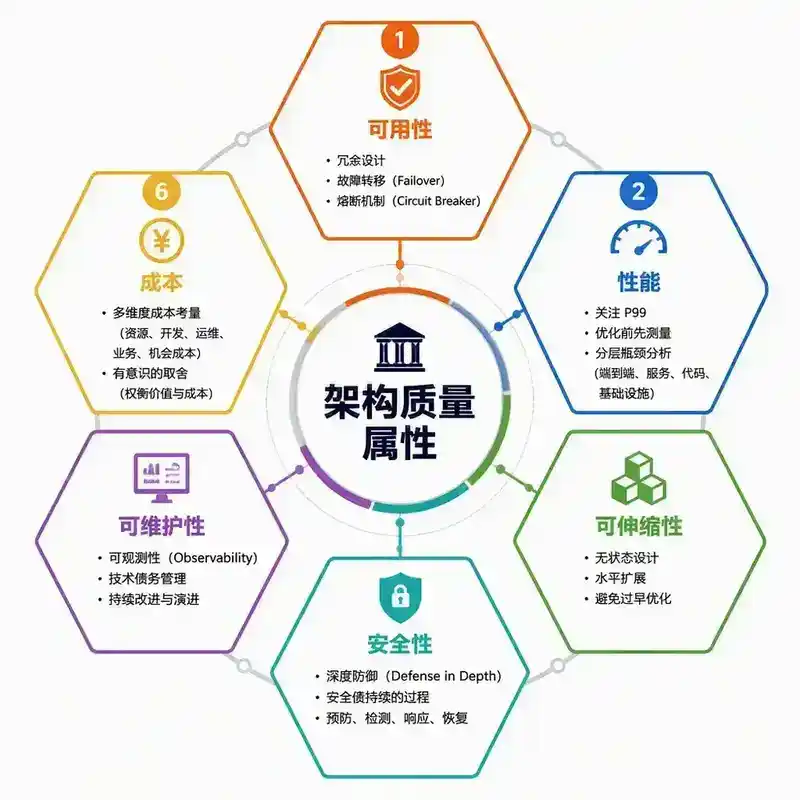
架构质量属性是架构师的基本功,也是系统设计面试中拉开差距的关键。记住以下要点:
- 可用性:冗余 + 故障转移 + 降级熔断,不是"不出 bug",而是"出问题后能快速恢复"
- 性能:关注 P99 而非平均值,先测量再优化,分层定位瓶颈
- 扩展性:无状态化是前提,水平扩展是方向,但要避免过早优化
- 安全性:纵深防御,安全不是功能而是持续过程
- 可维护性:可观测性 + 技术债务管理,降低长期维护成本
- 成本:多维度的成本概念,与质量属性做有意识的权衡
一个架构师的核心能力,不是知道多少种技术,而是能在具体的业务约束下,做出合理的质量属性权衡。
面试官视角提问
以下问题请尝试独立回答,建议每题思考 3-5 分钟后再看参考答案思路。
Q1:你设计一个电商订单系统,业务方要求 4 个 9 的可用性。你如何说服他们接受 3 个 9?或者如果你决定接受 4 个 9,你需要做哪些架构上的改变?请具体说明。
Q2:一个已上线的系统,P99 延迟从 100ms 逐渐增长到 500ms,但 QPS 没有明显变化。请给出你的排查思路,从最可能的原因到最不可能的原因排序,并说明每一步用什么工具。
Q3:你正在将一个单体应用拆分为微服务。团队有人建议"为了扩展性,把所有表都按用户 ID 分库分表"。你怎么回应?请给出你的分析和决策框架。
Q4:安全团队要求在系统中加入"用户操作二次确认"功能,但产品经理担心这会影响用户体验和转化率。作为架构师,你如何设计一个方案,在安全性和用户体验之间取得平衡?
Q5:你的团队正在评估两个技术方案:方案 A 使用自研的分布式事务框架,预计 3 个月开发,但可维护性极佳;方案 B 使用开源 Seata,1 周集成,但团队没有 Seata 运维经验。请给出你的决策过程和推荐方案。
Q6:一个支付系统,在"双十一"峰值流量是平时的 10 倍。你如何在控制成本的前提下保证系统可用性和性能?请给出具体策略。
下一篇预告:192|系统设计面试方法论:需求澄清、容量估算、API 设计、数据模型、架构演进、技术选型与权衡。
面试官追问:参考答案与深度解析
以下回答不是标准答案,而是面试中展现深度思考的参考框架。真正优秀的回答,需要结合你自己的项目经验。
Q1:你设计一个电商订单系统,业务方要求 4 个 9 的可用性。你如何说服他们接受 3 个 9?或者如果你决定接受 4 个 9,你需要做哪些架构上的改变?请具体说明。
核心判断:4 个 9 和 3 个 9 不是"更可靠"和"不可靠"的区别,而是成本级别的区别。
先说"说服"的话术:
从 99.9% 到 99.99%,宕机时间从 8.76 小时/年降到 52.6 分钟/年。但代价是什么?
- 基础设施成本:至少需要双机房异地部署,每个机房都有完整的冗余。单机房做到 3 个 9 可能需要 4 台机器(2 个应用 + 2 个 DB 主从),双机房至少 8 台,加上专线带宽,成本翻 3-4 倍
- 运维复杂度:需要自动故障切换(跨机房流量调度)、数据同步(跨机房主从复制延迟)、脑裂处理(Raft 共识或 Fencing Token)
- 团队要求:需要 7×24 小时 on-call,故障响应时间从 30 分钟缩短到 5 分钟
关键话术:"3 个 9 意味着一年最多宕机 8.76 小时。我们的订单系统不是支付系统,用户下单失败后可以重试。8.76 小时的年度宕机预算,分摊到每次故障(假设每次 10 分钟),意味着我们一年可以承受 52 次故障。这已经是非常宽松的容错空间了。"
如果决定接受 4 个 9,需要做的架构改变:
- 异地多活(不是冷备):两个机房同时承载流量,任何一个机房挂了,另一个机房自动接管。不是"主备切换",是"同时在线"——因为切换本身需要时间,会吃掉 4 个 9 的宕机预算
- 数据层:跨机房 MySQL 同步(如 MGR 多主),或 TiDB 分布式数据库,任何一个机房故障不影响写入
- 流量调度:DNS/GSLB 做机房级流量调度,健康检查粒度要 < 10 秒
- 混沌工程:定期主动注入故障,验证切换流程。不是"等故障来了再验证",而是"每周都在演练故障"
- 监控:SLO 驱动,P99 延迟、错误率、可用性都要有实时监控和自动告警
面试金句:"4 个 9 和 3 个 9 的差距,不是技术差距,是组织能力差距。你需要的不只是架构升级,而是整个团队的运维能力升级。"
Q2:一个已上线的系统,P99 延迟从 100ms 逐渐增长到 500ms,但 QPS 没有明显变化。请给出你的排查思路,从最可能的原因到最不可能的原因排序,并说明每一步用什么工具。
排查思路(按概率从高到低):
第一层:数据库层(概率最高,60%)
P99 增长通常是某条慢查询导致的。排查步骤:
- 慢查询日志:
SHOW FULL PROCESSLIST看有没有长时间运行的查询 - 执行计划:
EXPLAIN关键接口的 SQL,看是否出现了全表扫描、索引选择度变化 - 统计信息:
SHOW INDEX FROM table_name查看 Cardinality 是否合理,ANALYZE TABLE更新统计信息 - 锁等待:
SHOW ENGINE INNODB STATUS查看是否有锁等待、死锁
工具:MySQL 慢查询日志 + pt-query-digest(Percona Toolkit)+ 数据库监控面板
第二层:GC 停顿(概率 20%)
P99 毛刺很可能是 GC 导致的。排查:
- GC 日志:
-XX:+PrintGCDetails查看 GC 频率和停顿时间。如果 Full GC 频繁,P99 会出毛刺 - 堆内存:
jmap -heap <pid>看堆使用率,jstat -gcutil <pid> 1000实时看 GC 情况 - 内存泄漏:
jmap -histo:live <pid>看对象分布,有没有某个类实例数异常增长
工具:GC 日志 + jstat + Arthas(dashboard 命令看 GC 情况)
第三层:线程池/连接池排队(概率 10%)
- 线程池:Arthas
thread -b查看阻塞线程,thread -n 5看最忙的 5 个线程 - 连接池:检查 HikariCP/Druid 监控,看活跃连接数、等待连接数、等待时间
- Tomcat 线程:
curl localhost:8080/actuator/metrics/tomcat.threads.busy看线程利用率
工具:Arthas + Spring Boot Actuator + 连接池监控
第四层:依赖服务变慢(概率 5%)
- 链路追踪:SkyWalking/Jaeger 看调用链,哪一段变慢一目了然
- 下游监控:检查下游服务的 P99 延迟是否也增长了
工具:SkyWalking/Jaeger + 下游服务监控面板
第五层:网络抖动(概率 3%)
- 网络延迟:
ping、traceroute看网络延迟和丢包率 - TCP 重传:
netstat -s | grep retransmit看 TCP 重传率
面试金句:"排查 P99 增长最重要的是分层——先定位到是哪个组件慢了,再深入该组件。最怕的是上来就改代码,结果发现是 DBA 删了个索引。"
Q3:你正在将一个单体应用拆分为微服务。团队有人建议"为了扩展性,把所有表都按用户 ID 分库分表"。你怎么回应?请给出你的分析和决策框架。
直接回应:这是典型的"用分布式复杂度解决不存在的扩展性问题"。
分析框架:
第一步:先问三个问题
- 当前数据量多少?增长率多少? 如果当前数据量在 100GB 以内,单机 MySQL 完全够用,分库分表是过度设计
- 瓶颈在哪里? 是读瓶颈还是写瓶颈?如果是读瓶颈,加缓存和读写分离比拆库便宜得多
- 未来 1-2 年的数据增长预期是多少? 如果 2 年内数据量不会超过单机承载能力,现在不需要分库分表
第二步:分库分表的真正代价
- 失去了 JOIN:跨库 JOIN 不可能,应用层需要做多次查询再拼接
- 失去了事务:分布式事务(XA/Seata/Saga)比本地事务复杂一个数量级
- 失去了全局排序和分页:
ORDER BY create_time LIMIT 10 OFFSET 1000000在分库场景下需要"归并排序",性能极差 - 运维复杂度:DBA 需要管理 N 个库而不是 1 个,备份、恢复、DDL 变更都变成 N 倍
- 数据迁移:未来如果要换分片键,数据迁移的成本极高
第三步:正确的演进路径
| 阶段 | 数据量 | 方案 |
|---|---|---|
| 0-100GB | 单机 MySQL | 索引优化 + 慢查询优化 |
| 100GB-500GB | 读写分离 + 缓存 | 读请求分到从库,热点数据缓存 |
| 500GB-1TB | 垂直拆分 | 按业务域拆分到不同数据库(订单库、用户库、商品库) |
| 1TB+ | 水平分片 | 按业务场景选择分片键,通常只对核心表做分片 |
面试金句:"分库分表不是架构演进的起点,而是终局方案。在你真正需要之前,它只会带来痛苦。记住:你优化的不是'扩展性',而是'在数据量增长时维持系统性能的能力'。如果当前数据量根本不需要分库分表,那你的优化就是错的。"
Q4:安全团队要求在系统中加入"用户操作二次确认"功能,但产品经理担心这会影响用户体验和转化率。作为架构师,你如何设计一个方案,在安全性和用户体验之间取得平衡?
核心思路:不是"做不做",而是"什么情况下做"——用风险分级来驱动二次确认的触发条件。
方案设计:
第一层:风险分级(不是所有操作都需要二次确认)
| 风险等级 | 操作示例 | 二次确认策略 |
|---|---|---|
| 低风险 | 修改昵称、换头像 | 无需确认 |
| 中风险 | 修改收货地址、绑定手机号 | 弹窗确认(一键) |
| 高风险 | 转账、删除账号、修改密码 | 二次验证(短信/人脸) |
第二层:上下文感知(智能降噪)
不是所有高风险操作都需要同等强度的确认。核心逻辑:
- 可信设备:用户已登录超过 30 天的设备,降低确认强度(弹窗即可)
- 新设备 + 异地登录:最高强度(短信验证码 + 人脸)
- 异常时间:凌晨 3 点操作 → 提升确认强度
- 金额阈值:大于 5000 元需要二次确认
第三层:频次限制(不重复骚扰)
对于同一设备、同一操作类型,在一定时间窗口内(如 30 分钟)只要求一次二次确认。用 Redis 缓存确认状态,key 设计为 confirm_skip:{userId}:{deviceId}:{opType},TTL 设为 30 分钟。
与产品经理的沟通话术:
"不是所有用户都需要二次确认。我们只对'高风险场景'触发——比如新设备登录、异地登录、大额操作。这些场景本来就只占流量的 1-3%,对转化率的影响微乎其微。反而,如果因为没有二次确认导致用户账号被盗、资金损失,那才是真正的'转化率杀手'——用户会永远离开我们。"
面试金句:"安全不是'拦路虎',而是'保险丝'。好的安全设计让 99% 的合法用户无感知,让 1% 的异常行为无处遁形。"
Q5:你的团队正在评估两个技术方案:方案 A 使用自研的分布式事务框架,预计 3 个月开发,但可维护性极佳;方案 B 使用开源 Seata,1 周集成,但团队没有 Seata 运维经验。请给出你的决策过程和推荐方案。
推荐:方案 B(Seata),但附带条件。
决策过程:
第一步:量化"自研"的真实成本
3 个月开发只是冰山一角。自研分布式事务框架的真实成本:
| 成本项 | 估算 |
|---|---|
| 初始开发 | 3 人月 |
| 单元测试 + 集成测试 | 1 人月 |
| 文档 + 内部培训 | 0.5 人月 |
| Bug 修复(第一年) | 至少 2 人月 |
| 长期维护(每年) | 至少 1 人月 |
| 新人学习成本 | 每次换人 +1 周 |
| 总成本(第一年) | 至少 7.5 人月 |
第二步:评估 Seata 的风险
| 风险 | 缓解措施 |
|---|---|
| 缺乏运维经验 | 安排 2 人花 1 周时间深入学习 Seata 官方文档和源码 |
| 生产事故 | 先在非核心链路(如发优惠券、积分)试用 1 个月 |
| 社区支持 | Seata 是 Apache 顶级项目,社区活跃,GitHub Issue 响应快 |
| 版本升级 | 锁定版本,不盲目追新,等大版本稳定后再升级 |
第三步:决策矩阵
| 维度 | 自研 | Seata |
|---|---|---|
| 开发速度 | 慢(3 个月) | 快(1 周) |
| 可维护性 | 高(代码可控) | 中(需要理解源码) |
| 社区支持 | 无 | 强(Apache 顶级项目) |
| 风险 | 高(自研 bug 无人兜底) | 中(学习曲线) |
| 长期成本 | 高(持续维护) | 低(社区维护) |
推荐的最终方案:先用 Seata 跑起来,边用边学。如果 6 个月后发现 Seata 确实满足不了需求(比如性能瓶颈、特定场景不支持),再考虑自研。但大概率你会发现 Seata 足够用了。
面试金句:"自研框架的冲动,90% 源于'Not Invented Here'(NIH)综合症。在分布式事务这种高复杂度的领域,3 个月开发出来的框架,大概率只是 Seata 的劣化版。除非你的业务场景极其特殊(比如需要支持自定义的存储引擎、特殊的事务隔离级别),否则不要自研。"
Q6:一个支付系统,在"双十一"峰值流量是平时的 10 倍。你如何在控制成本的前提下保证系统可用性和性能?请给出具体策略。
核心原则:弹性伸缩 + 分级降级 + 提前预热。不要为峰值长期预留资源。
策略一:弹性伸缩(成本最优)
Kubernetes HPA 配置策略:
minReplicas: 5(平时)maxReplicas: 50(大促峰值)- CPU 目标利用率 60%,扩容更激进(60 秒),缩容更保守(300 秒)
- 结合定时伸缩:在已知的大促时间前 30 分钟提前扩容,避免"流量来了还在扩容"
策略二:流量分级与降级
| 流量层级 | 包含功能 | 大促策略 |
|---|---|---|
| L0(核心) | 支付、扣款、订单状态变更 | 100% 保障,不可降级 |
| L1(重要) | 支付结果通知、对账 | 正常处理,但可降级为异步 |
| L2(非核心) | 积分发放、优惠券赠送、营销推送 | 大促期间直接降级关闭 |
| L3(可关闭) | 用户画像更新、推荐算法、数据报表 | 大促期间暂停 |
策略三:成本优化组合拳
- Spot 实例/抢占式实例:大促期间扩容的 Pod 优先使用 Spot 实例(节省 60-90%),但要有快速重建能力
- 资源池化:多个业务线共享一个弹性资源池,按优先级调度。支付优先,非核心靠后
- 数据库:提前扩容数据库连接数,但不要永久扩容——大促结束后调回来
- Redis:临时扩容集群节点,大促后缩回
策略四:全链路压测 + 预热
大促前 1 周:全链路压测,验证 10 倍流量的系统表现,发现瓶颈提前修复。
大促前 1 小时:预热四件套——
- 缓存预热:提前加载热点数据到 Redis
- JVM 预热:用流量回放工具预热 JIT 编译
- 连接池预热:提前建立数据库连接
- DNS/负载均衡预热:确保流量分发策略生效
成本估算:
| 项目 | 平时成本 | 大促当天成本 | 策略 |
|---|---|---|---|
| 应用服务器 | 5 台 × 1000 元/月 | 50 台 × 按量付费(约 200 元/小时) | 弹性伸缩 + Spot |
| 数据库 | 2 台(主从) | 临时升级到更高规格 + 只读实例 | 大促后降配 |
| Redis | 3 节点集群 | 5 节点集群 | 临时扩容 |
| 总增量 | 基准 | 约 2000 元(大促当天) | 远低于长期预留 |
面试金句:"大促架构的核心不是'买更多机器',而是'让机器在正确的时间做正确的事'。弹性伸缩 + 分级降级 + 提前预热,三招搞定。如果你为了一年 1 天的双十一买了 365 天的峰值容量,那不是架构,是浪费。"
面试建议:以上问题在面试中通常会以"连环追问"的形式出现——面试官会根据你的回答不断深入追问。建议你不仅记住答案,更要理解每个答案背后的权衡逻辑。架构师的核心竞争力不是"知道答案",而是"能够在约束条件下做出合理决策并解释原因"。
本文是 Java 技术专家与架构师面试 250 个高频考点系列的第 191 篇。