阅读时间:约 45 分钟 | 难度:中高级 | 关键词:Bloom Filter、Bitmap、HyperLogLog、概率数据结构、误判率、基数估计
目录
- 引言:为什么需要"概率"数据结构
- Bitmap:位级别的极致压缩
- 布隆过滤器:判断"可能存在"的艺术
- 误判率深度解析
- 容量设计与参数调优
- 布隆过滤器的变体与演进
- HyperLogLog:基数估计的魔法
- 工程实践与踩坑指南
- 总结与对比
- 面试官视角:提问与回答
1. 引言:为什么需要"概率"数据结构
1.1 一个现实场景
假设你正在开发一个爬虫系统,每天需要爬取数亿个 URL。你面临一个核心问题:如何快速判断一个 URL 是否已经被爬取过?
最直观的方案是用 HashSet 存储所有已爬取的 URL。假设每个 URL 平均 60 个字符,加上 HashSet 的 overhead(Java 中每个 entry 约 80 字节),10 亿个 URL 需要约 80GB 内存——这显然不现实。
更通用的问题是:当数据量达到百亿、千亿级别时,精确的数据结构(HashSet、TreeSet 等)内存开销变得不可接受,我们需要"用精度换空间"。
1.2 概率数据结构的设计哲学
概率数据结构(Probabilistic Data Structure)的核心思想是:
允许可控的误差,换取数量级的内存节省。
| 特性 | 精确数据结构 | 概率数据结构 |
|---|---|---|
| 内存占用 | O(n) | O(k),k 为常数 |
| 查询结果 | 精确 | 近似(可控误差) |
| 典型场景 | 小规模数据 | 海量数据 |
| 代表结构 | HashSet、HashMap | Bloom Filter、HyperLogLog |
关键权衡:内存节省的倍数通常可以达到 10-1000 倍,而误差率可以控制在 0.01%-1%。
1.3 三种核心概率结构
本文聚焦三种最常用的概率数据结构:
| 结构 | 解决的问题 | 核心操作 | 误差类型 |
|---|---|---|---|
| Bitmap | 整数存在性 / 去重排序 | 位操作 | 无误差(精确) |
| Bloom Filter | 元素存在性判断 | 插入 / 查询 | 假阳性(误判) |
| HyperLogLog | 基数估计(去重计数) | 插入 / 计数 | 近似计数 |
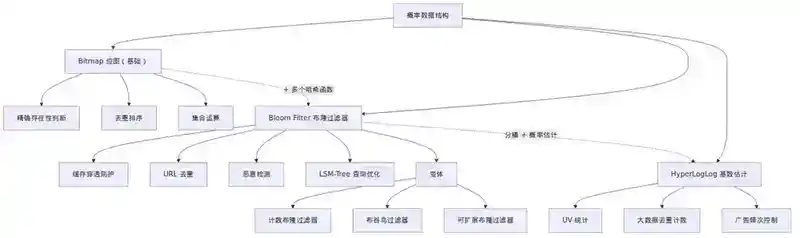
Bitmap 严格来说不是概率结构,但它是理解 Bloom Filter 和 HyperLogLog 的基石——它们都建立在位操作的思想之上。
2. Bitmap:位级别的极致压缩
2.1 核心思想
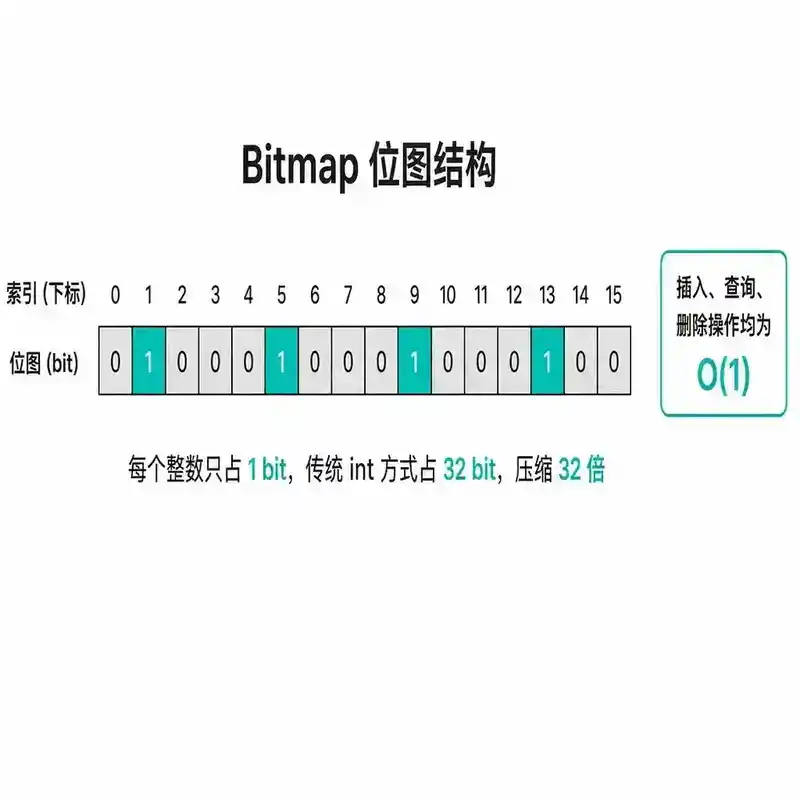
Bitmap 用一个 bit 表示一个整数是否存在,而不是用一个 int 或对象。这是你能想到的最极致的压缩方式。
传统方式:int[ ] visited = new int[100000000];  // 400MB

Bitmap:  BitSet visited = new BitSet(100000000); // 12.5MB
压缩了 32 倍。
2.2 数据结构
Bitmap 本质上是一个位数组(bit array),每个 bit 对应一个整数:
索引:  0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15 ...
位值:  0  1  0  0  1  0  0  0  1  0  0  0  1  0  0  0 ...
含义:  F  T  F  F  T  F  F  F  T  F  F  F  T  F  F  F ...
操作复杂度:全部 O(1)。
- 插入:
bits[offset] = 1 - 查询:
return bits[offset] == 1 - 删除:
bits[offset] = 0
2.3 Java 实现:BitSet 源码剖析
Java 的 java.util.BitSet 是 Bitmap 的经典实现,核心源码分析:
public class BitSet implements Cloneable, java.io.Serializable {

    // 内部用 long[ ] 数组存储,每个 long 64 位

    private long[ ] words;

    // 设置第 bitIndex 位为 true
    public void set(int bitIndex) {
        int wordIndex = wordIndex(bitIndex);  // 除以 64
        expandTo(wordIndex);                   // 按需扩容
        words[wordIndex] |= (1L << bitIndex); // 位操作
    }

    // 查询第 bitIndex 位
    public boolean get(int bitIndex) {
        int wordIndex = wordIndex(bitIndex);
        return (wordIndex < wordsInUse)
            && ((words[wordIndex] & (1L << bitIndex)) != 0);
    }

    // 计算 word 索引:bitIndex / 64
    private static int wordIndex(int bitIndex) {
        return bitIndex >> ADDRESS_BITS_PER_WORD; // >> 6 = /64
    }
}
核心优化点:
- 用 long 数组而非 byte 数组:一次操作处理 64 位,减少 CPU 指令数
- 位运算代替除法:
>> 6代替/64,& 63代替%64 - 懒扩容:按需分配 word,不预分配全部空间
2.4 高级应用:BitMap 的更多玩法
去重排序:对大量整数去重并排序,只需遍历 Bitmap 中值为 1 的位即可。
BitSet bits = new BitSet();
for (int num : numbers) bits.set(num);
// 遍历即得排序去重结果
for (int i = bits.nextSetBit(0); i >= 0; i = bits.nextSetBit(i + 1)) {
    System.out.println(i);
}
集合运算:Bitmap 支持高效的位运算来实现集合操作。
// 交集
BitSet intersection = (BitSet) a.clone();
intersection.and(b);  // a & b

// 并集
BitSet union = (BitSet) a.clone();
union.or(b);  // a | b

// 差集
BitSet difference = (BitSet) a.clone();
difference.andNot(b);  // a & ~b
布隆过滤器的基础:Bitmap 是布隆过滤器的底层存储结构——布隆过滤器本质上就是"多个哈希函数映射到一个 Bitmap 上"。
3. 布隆过滤器:判断"可能存在"的艺术
3.1 核心思想
布隆过滤器回答了这样一个问题:"我有没有见过这个元素?"
答案只有两种:
- "一定没有见过"(绝对可靠)
- "可能见过"(有小概率误判)
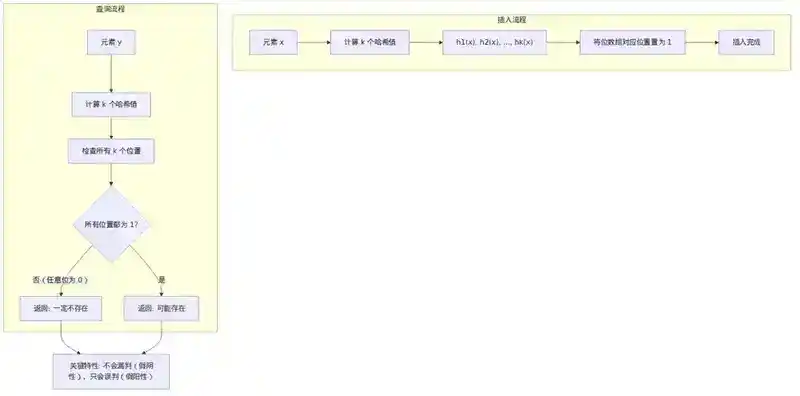
关键特性:不会漏判(假阴性),只会误判(假阳性)。
3.2 工作原理
布隆过滤器由一个 m 位的位数组 和 k 个独立的哈希函数 组成。
插入元素:
- 对元素 x 用 k 个哈希函数分别计算:
h1(x),h2(x), ...,hk(x) - 将位数组中对应位置全部置为 1
插入 "hello":
h1("hello") = 3  → bits[3] = 1
h2("hello") = 7  → bits[7] = 1
h3("hello") = 11 → bits[11] = 1
查询元素:
- 对元素 y 用同样的 k 个哈希函数计算
- 检查所有对应位置是否都为 1
- 如果任意一位为 0 → 元素一定不存在
- 如果全部为 1 → 元素可能存在(可能被其他元素"撞"了)
3.3 为什么不会漏判?
假设元素 x 被插入过,它的 k 个位置必然都被置为 1。后续查询 x 时,这 k 个位置仍然是 1(除非有删除操作,但标准布隆过滤器不支持删除),所以绝对不会漏判。
3.4 为什么会有误判?
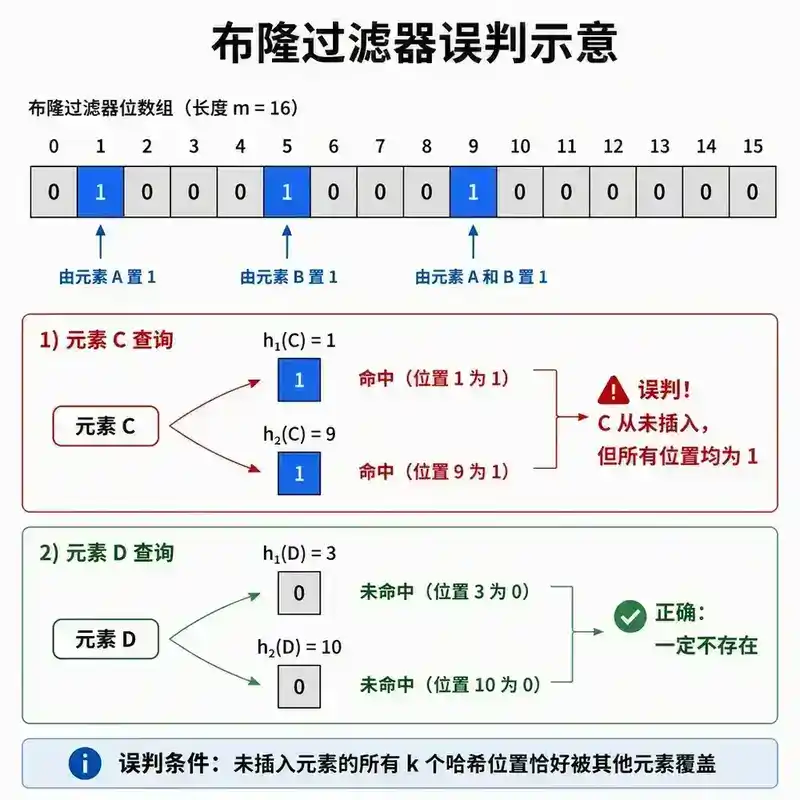
假设元素 y 从未被插入过,但它的 k 个哈希位置恰好被其他已插入元素覆盖成了 1,此时查询 y 会返回"可能存在",这就是误判(假阳性)。
3.5 一个具体的例子
假设 m = 16, k = 2:
初始状态: [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]

插入 "A":h1(A)=1, h2(A)=5
          [0, 1, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]

插入 "B":h1(B)=5, h2(B)=9    ← 注意 h1(B) 与 h2(A) 碰撞
          [0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0]

查询 "A":h1(A)=1 ✓, h2(A)=5 ✓ → "可能存在" ✓ (正确)
查询 "B":h1(B)=5 ✓, h2(B)=9 ✓ → "可能存在" ✓ (正确)
查询 "C":h1(C)=1 ✓, h2(C)=9 ✓ → "可能存在" ✗ (误判!C 从未插入)
查询 "D":h1(D)=3 ✗           → "一定不存在" ✓ (正确)
4. 误判率深度解析
4.1 误判率的数学推导
这是布隆过滤器最核心的理论。假设:
- m:位数组长度
- n:已插入元素数量
- k:哈希函数个数
推导步骤:
Step 1:一次哈希后,某一位仍为 0 的概率。
插入一个元素时,k 个哈希函数各自独立选择一个位置(均匀分布)。对于某一位,一次哈希没有选中它的概率:
$P(一次未选中) = 1 - \frac{1}{m}$
Step 2:插入 n 个元素后,某一位仍为 0 的概率。
总共 n × k 次哈希,每次独立:
$P(仍为 0) = \left(1 - \frac{1}{m}\right)^{kn}$
利用极限公式 $\lim_{x \to \infty} \left(1 - \frac{1}{x}\right)^{-x} = e$ :
$P(仍为 0) \approx e^{-kn/m}$
Step 3:某一位为 1 的概率。
$P(为 1) = 1 - e^{-kn/m}$
Step 4:误判率(一个不存在元素的 k 个位置恰好都为 1)。
$P(误判) = \left(1 - e^{-kn/m}\right)^k$
这就是布隆过滤器的误判率公式。
4.2 误判率的直观理解
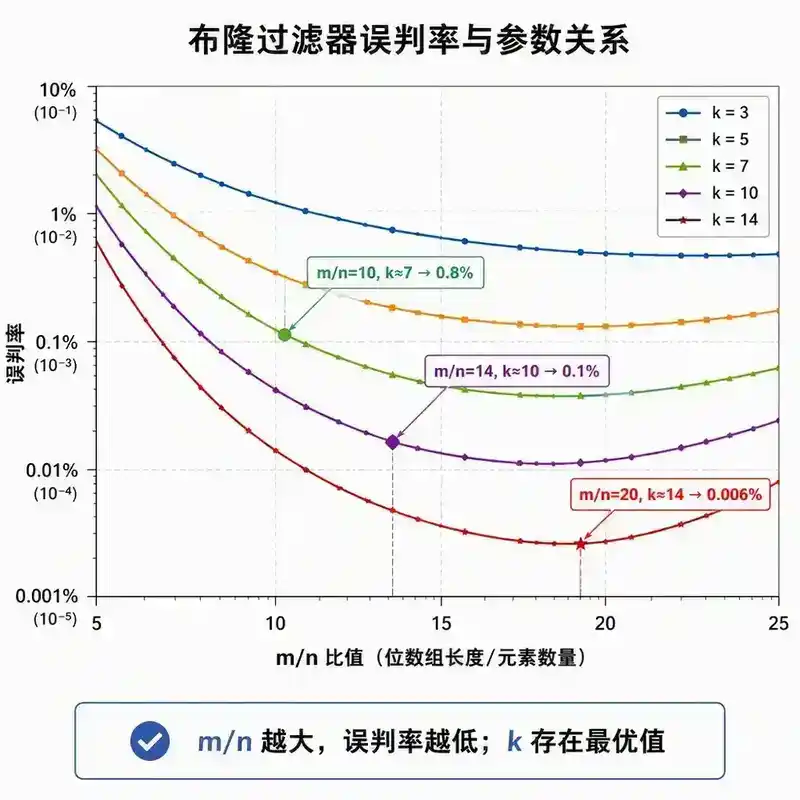
关键结论:
- m/n 越大,误判率越低:m/n 是位数组长度与元素数量的比值,它是布隆过滤器最核心的设计参数。m/n 越大,位数组越"稀疏",碰撞概率越低。
- k 存在最优值:哈希函数太少,不能充分利用位数组;哈希函数太多,位数组被快速填满。最优 k 使得误判率最小。
- 误判率随 n 增长而增长:随着插入元素增多,位数组被越来越多的位置填充为 1,误判率会逐渐上升——这是布隆过滤器必须控制的"退化"问题。
4.3 最优哈希函数个数
对误判率公式求导,令导数为 0,得到最优 k:
$k_{opt} = \frac{m}{n} \ln 2 \approx 0.693 \times \frac{m}{n}$
此时误判率最小值为:
$P_{min} = \left(\frac{1}{2}\right)^k \approx 0.6185^{m/n}$
这意味着什么? 当选定了 m/n 和最优 k 后,误判率是确定的。例如:
- m/n = 10, k ≈ 7 → 误判率 ≈ 0.8%
- m/n = 14, k ≈ 10 → 误判率 ≈ 0.1%
- m/n = 20, k ≈ 14 → 误判率 ≈ 0.006%
4.4 反向推导:给定误判率求参数
实际工程中,我们更常遇到的是:给定预期元素数量 n 和可接受的误判率 p,求 m 和 k。
由误判率公式反推:
$m = -\frac{n \ln p}{(\ln 2)^2} \approx -1.44 \times n \times \ln p$
$k = \frac{m}{n} \ln 2 \approx 0.693 \times \frac{m}{n}$
示例:n = 10 亿,p = 0.01%(万分之一)
m = -1.44 × 10^9 × ln(0.0001)
  = -1.44 × 10^9 × (-9.21)
  ≈ 13.3 × 10^9 位
  ≈ 1.66 GB

k = 0.693 × 13.3 / 1
  ≈ 9.2 → 取 9

对比 HashSet:10 亿 × 80 字节 ≈ 80 GB
节省:80 / 1.66 ≈ 48 倍
5. 容量设计与参数调优
5.1 设计流程
布隆过滤器的容量设计遵循以下步骤:
1. 确定预期元素数量 n
2. 确定可接受误判率 p
3. 计算位数组长度 m = -n × ln(p) / (ln(2))²
4. 计算最优哈希函数数 k = (m/n) × ln(2)
5. 选择合适的哈希函数实现
6. 预留扩容空间(通常 1.2-1.5 倍 n)
5.2 哈希函数的选择
布隆过滤器对哈希函数的要求:
- 均匀分布:哈希值均匀覆盖整个位数组
- 独立性:k 个哈希函数之间尽量独立
- 速度快:性能瓶颈在哈希计算
常用方案:双哈希函数法(Kirsch-Mitzenmacher 方法)
不需要真的实现 k 个不同的哈希函数,只需两个基础哈希函数:
$g_i(x) = h_1(x) + i \times h_2(x) \mod m, \quad i = 0, 1, ..., k-1$
// 只用两个哈希函数模拟 k 个
long hash1 = murmur3_128(x);
long hash2 = murmur3_128(x + seed);
for (int i = 0; i < k; i++) {
    int index = (int) ((hash1 + i * hash2) % m);
    bits.set(index);
}
常用哈希算法:
| 算法 | 速度 | 分布质量 | 适用场景 |
|---|---|---|---|
| MurmurHash3 | 极快 | 优秀 | 通用场景首选 |
| xxHash | 最快 | 优秀 | 需要极致性能 |
| MD5 | 慢 | 最好 | 安全性要求高 |
| SHA-256 | 很慢 | 最好 | 安全场景 |
5.3 Guava BloomFilter 源码剖析
Google Guava 提供了优秀的布隆过滤器实现:
// 创建布隆过滤器
BloomFilter<String> filter = BloomFilter.create(
    Funnels.stringFunnel(Charsets.UTF_8),
    10_000_000,  // 预期插入 1000 万
    0.01         // 1% 误判率
);

// 使用
filter.put("hello");
boolean exists = filter.mightContain("hello"); // true
boolean notExists = filter.mightContain("world"); // false (大概率)
核心源码:
public final class BloomFilter<T> implements Predicate<T>, Serializable {
    private final LockFreeBitArray bits;  // 底层位数组
    private final int numHashFunctions;   // k
    private final Funnel<? super T> funnel; // 将对象转为字节流
    private final Strategy strategy;       // 哈希策略

    // 最优参数计算
    static long optimalNumOfBits(long n, double p) {
        if (p == 0) p = Double.MIN_VALUE;
        return (long) (-n * Math.log(p) / (Math.log(2) * Math.log(2)));
    }

    static int optimalNumOfHashFunctions(long n, long m) {
        return Math.max(1, (int) Math.round((double) m / n * Math.log(2)));
    }

    public boolean put(T object) {
        return strategy.put(object, funnel, numHashFunctions, bits);
    }

    public boolean mightContain(T object) {
        return strategy.mightContain(object, funnel, numHashFunctions, bits);
    }
}
Guava 的 Strategy 实现(MURMUR128_MITZ_64 策略):
static final class MURMUR128_MITZ_64 implements Strategy {
    @Override
    public <T> boolean put(T object, Funnel<? super T> funnel,
                           int numHashFunctions, LockFreeBitArray bits) {
        long bitSize = bits.bitSize();
        long hash64 = Hashing.murmur3_128().hashObject(object, funnel).asLong();
        int hash1 = (int) hash64;
        int hash2 = (int) (hash64 >>> 32);

        boolean bitsChanged = false;
        for (int i = 1; i <= numHashFunctions; i++) {
            int combinedHash = hash1 + (i * hash2);
            if (combinedHash < 0) combinedHash = ~combinedHash;
            bitsChanged |= bits.set(combinedHash % bitSize);
        }
        return bitsChanged;
    }
}
5.4 Redis Bloom Filter 模块
Redis 通过 RedisBloom 模块提供布隆过滤器:
# 创建布隆过滤器
BF.RESERVE myfilter 0.01 1000000
# 0.01 = 1% 误判率,1000000 = 预期容量

# 添加元素
BF.ADD myfilter "item1"
BF.MADD myfilter "item2" "item3" "item4"

# 查询
BF.EXISTS myfilter "item1"   # 返回 1
BF.EXISTS myfilter "item5"   # 返回 0

# 批量查询
BF.MEXISTS myfilter "item1" "item5" "item2"
# 返回 [1, 0, 1]
扩容策略:
- RedisBloom 支持
BF.INSERT的NONSCALING和SCALING两种模式 SCALING模式:当容量不足时自动创建新的子过滤器,多层叠加
6. 布隆过滤器的变体与演进
6.1 计数布隆过滤器
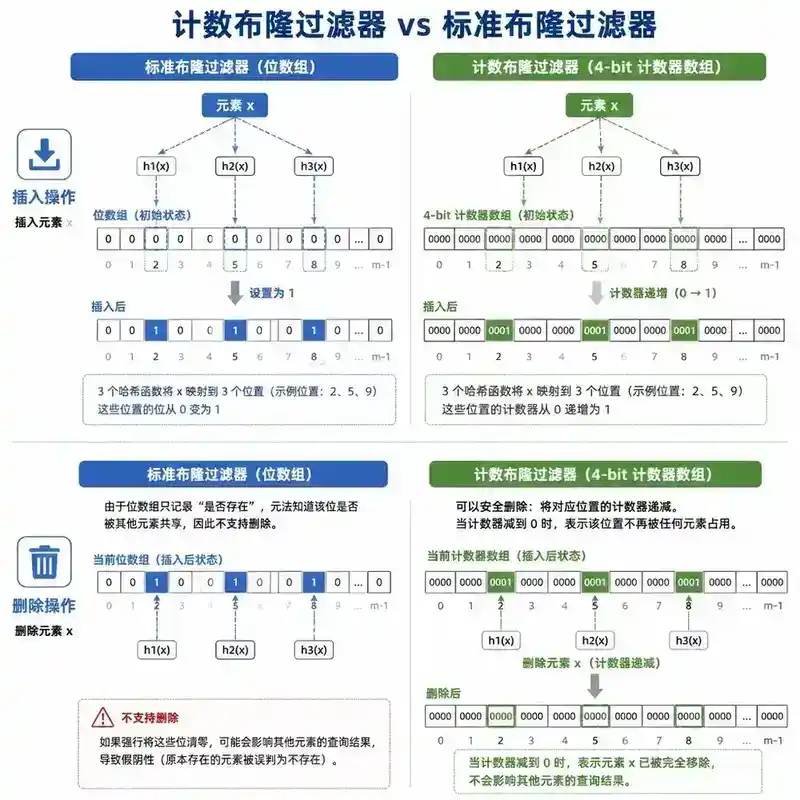
标准布隆过滤器不支持删除——因为将某位从 1 改为 0 可能影响其他元素。
计数布隆过滤器将每一位从 1 bit 扩展为一个小计数器(通常 4 bit),插入时递增,删除时递减。
标准布隆过滤器: [0][1][0][1][0]...
计数布隆过滤器: [0][3][0][2][0]...  (每个位置是一个 4-bit 计数器)
代价:内存增加 4 倍,且计数器可能溢出(4 bit 最大 15,但概率极低)。
6.2 布谷鸟过滤器
布谷鸟过滤器使用布谷鸟哈希的思想,每个元素有两个候选位置,支持删除且空间效率更高。
核心操作:
- 插入:尝试两个位置,都满则"踢出"现有元素到其另一个位置
- 查询:检查两个位置中是否有匹配的指纹
- 删除:直接删除匹配的指纹
对比:
| 特性 | 布隆过滤器 | 布谷鸟过滤器 |
|---|---|---|
| 删除支持 | 不支持 | 原生支持 |
| 空间效率 | 取决于误判率 | 低误判率时更优 |
| 插入性能 | O(k) | O(1) 均摊,可能重排 |
| 查询性能 | O(k) | O(1) |
6.3 可扩展布隆过滤器
当元素数量超过预期时,标准布隆过滤器的误判率会急剧上升。可扩展布隆过滤器通过动态创建多层过滤器来解决:
Filter_0: m=m₀, n=n₀, p=p₀   (第一层填满)
Filter_1: m=m₁, n=n₁, p=p₁   (第二层,误判率更严格)
Filter_2: m=m₂, n=n₂, p=p₂   (第三层,更严格)
...
查询时依次检查所有层,只要有一层返回"不存在"即可。
7. HyperLogLog:基数估计的魔法
7.1 问题定义
基数估计:给定一个包含重复元素的多重集,估计其中不同元素的数量(基数)。
传统方法用 HashSet 去重计数,内存 O(n)。HyperLogLog 用 约 12KB 内存即可估计十亿级别的基数,误差率约 2%。
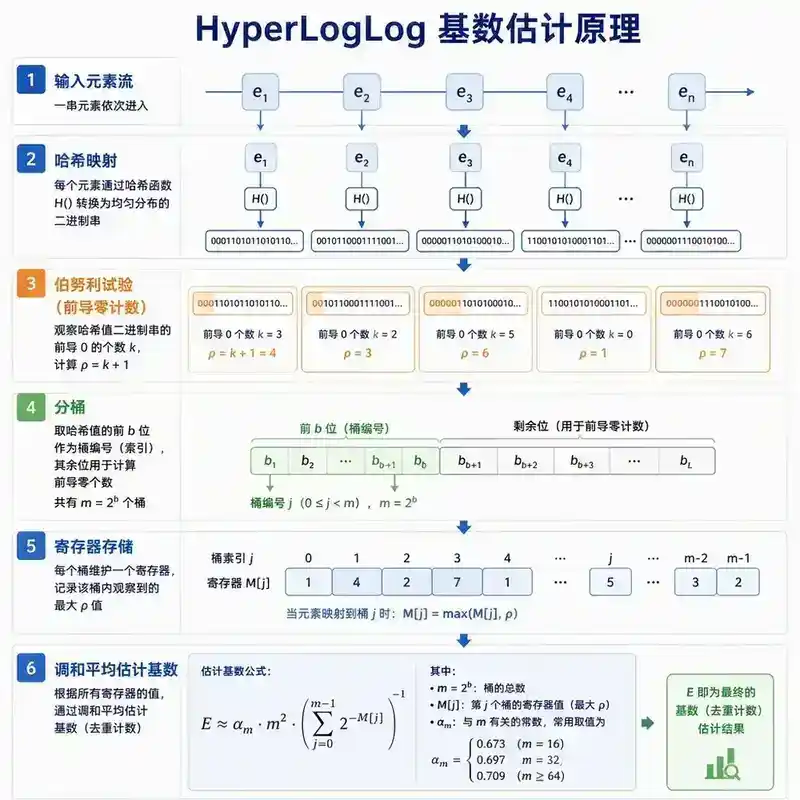
7.2 核心思想:伯努利试验
HyperLogLog 的核心来自一个巧妙的观察:
在均匀随机生成的比特串中,连续前缀 0 的个数 k 出现的概率是 1/2ᵏ。如果我们观察到某个元素哈希值的前缀有 5 个连续的 0,这意味着我们大约需要 2⁵=32 个不同的元素才能"期望"看到一次这样的模式。
关键步骤:
- 对每个元素计算哈希值,得到一个均匀分布的比特串
- 取哈希值的前 b 位作为桶编号(共 m = 2ᵇ 个桶)
- 对每个桶,记录剩余位中连续前缀 0 的最大个数 + 1
- 用调和平均数(Harmonic Mean)合并所有桶的估计值
- 乘以偏差修正因子得到最终基数估计
7.3 数学推导
Step 1:分桶计数
设桶数为 m = 2ᵇ,哈希值前 b 位决定桶编号,剩余位为 w。
对桶 j,定义:
$\rho(w) = \text{position of leftmost 1-bit in w} + 1$
例如 w = 00101... → ρ(w) = 3(第 3 位是第一个 1)
桶 j 的寄存器值:$M[j] = \max_{x \in \text{bucket j}} \rho(w_x)$
Step 2:调和平均
原始 LogLog 使用算术平均,HyperLogLog 改用调和平均以提高对小基数的准确性:
$Z = \left(\sum_{j=1}^{m} 2^{-M[j]}\right)^{-1}$
Step 3:偏差修正
原始估计:$E = \alpha_m \cdot m^2 \cdot Z$
其中 $\alpha_m$ 是偏差修正因子(与 m 有关)。
Step 4:范围修正
对于小基数(E < 5m/2)和大基数(E > 2³²/30),使用不同的修正算法。
7.4 空间复杂度分析
标准实现使用 m = 2¹⁴ = 16384 个桶,每个桶 6 位(存储 ρ 值,最大 64)。
总内存:16384 × 6 bit = 12 KB
代价:标准误差约 $\frac{1.04}{\sqrt{m}}$ ≈ 0.81%
7.5 Redis HyperLogLog
Redis 从 2.8.9 版本开始内置 HyperLogLog:
PFADD page_visitors user1 user2 user3
# 返回 1(基数发生变化)

PFADD page_visitors user1 user2
# 返回 0(基数未变化)

PFCOUNT page_visitors
# 返回 3(近似)
合并多个 HLL:
PFADD visitors_day1 user1 user2 user3
PFADD visitors_day2 user3 user4 user5

PFMERGE visitors_total visitors_day1 visitors_day2
PFCOUNT visitors_total
# 返回约 5(近似)
Redis 实现细节:
- 使用 16384 个寄存器(2¹⁴)
- 密集存储:每个寄存器 6 位
- 稀疏存储:对于小基数,使用更紧凑的编码
- 当寄存器值超过稀疏阈值时自动切换为密集存储
7.6 HLL 的局限与适用场景
适用场景:
- UV 统计(页面独立访客)
- 大数据去重计数
- 流式数据基数估计
- 广告曝光频次控制
不适用场景:
- 需要精确计数(如财务数据)
- 需要判断单个元素是否存在
- 需要高频查询小基数(HLL 对小基数也有误差)
8. 工程实践与踩坑指南
8.1 布隆过滤器的容量规划
常见错误:低估了实际元素数量,导致误判率远超预期。
// ❌ 错误:按当前数据量设计
BloomFilter<String> filter = BloomFilter.create(
    Funnels.stringFunnel(Charsets.UTF_8),
    1_000_000,  // 预期 100 万
    0.01        // 1% 误判率
);
// 一年后实际插入 500 万,误判率可能飙升至 10%+

// ✅ 正确:考虑增长,预留 3-5 倍空间
BloomFilter<String> filter = BloomFilter.create(
    Funnels.stringFunnel(Charsets.UTF_8),
    5_000_000,  // 预期 500 万
    0.001       // 0.1% 误判率
);
容量规划公式:
预期容量 = 当前数据量 × 预估增长率 × 时间窗口
位数组大小 = 预期容量 × (m/n 比值)
8.2 布隆过滤器不能做什么
| 误区 | 事实 |
|---|---|
| 认为可以存数据 | 布隆过滤器只存指纹,不存原始数据 |
| 认为可以遍历元素 | 无法枚举已插入的元素 |
| 认为可以删除 | 标准布隆过滤器不支持删除 |
| 认为误判率恒定 | 误判率随插入元素增多而上升 |
| 认为可以替代缓存 | 布隆过滤器防止缓存穿透,但本身不是缓存 |
8.3 经典应用场景
场景 1:缓存穿透防护
请求到达
  ↓
布隆过滤器检查 key 是否存在
  ↓ 不存在 → 直接返回空(避免击穿到 DB)
  ↓ 可能存在
查询缓存
  ↓ 缓存未命中
查询数据库
  ↓
回写缓存
场景 2:爬虫 URL 去重
BloomFilter<String> crawledUrls = BloomFilter.create(
    Funnels.stringFunnel(Charsets.UTF_8),
    1_000_000_000,  // 10 亿 URL
    0.001           // 0.1% 误判率
);

// 爬取前检查
if (crawledUrls.mightContain(url)) {
    // 可能已经爬过,跳过
    // 注意:可能有 0.1% 的新 URL 被误判跳过
    return;
}
crawl(url);
crawledUrls.put(url);
场景 3:数据库查询优化
在 HBase / Cassandra 等 LSM-Tree 数据库中,布隆过滤器用于快速判断一个 SSTable 文件是否包含某个 key,避免不必要的磁盘读取。
场景 4:恶意用户名检测
BloomFilter<String> maliciousUsers = loadMaliciousUserList();
if (maliciousUsers.mightContain(newUsername)) {
    // 可能存在,需要进一步验证
    verifyAgainstDatabase(newUsername);
}
8.4 HLL 的工程实践
HLL 的误差特性:
- 标准误差约 2%(Redis 默认 0.81%)
- 误差与基数大小无关(相对误差恒定)
- 对于小基数(< 几千),误差可能更大
合并的正确姿势:
HLL 的合并(PFMERGE)是无损的——两个 HLL 的合并结果与直接向一个 HLL 插入所有元素的结果相同。这使得 HLL 非常适合分布式场景:每个节点维护自己的 HLL,定期合并即可。
HLL 与 Bitmap 的对比:
| 场景 | 推荐方案 |
|---|---|
| 想要精确计数 | Bitmap(整数)/ HashSet |
| 只关心数量级(百万级以上) | HyperLogLog |
| 需要判断单个元素是否存在 | Bloom Filter / Bitmap |
| 需要多维度聚合分析 | HyperLogLog(可合并) |
9. 总结与对比
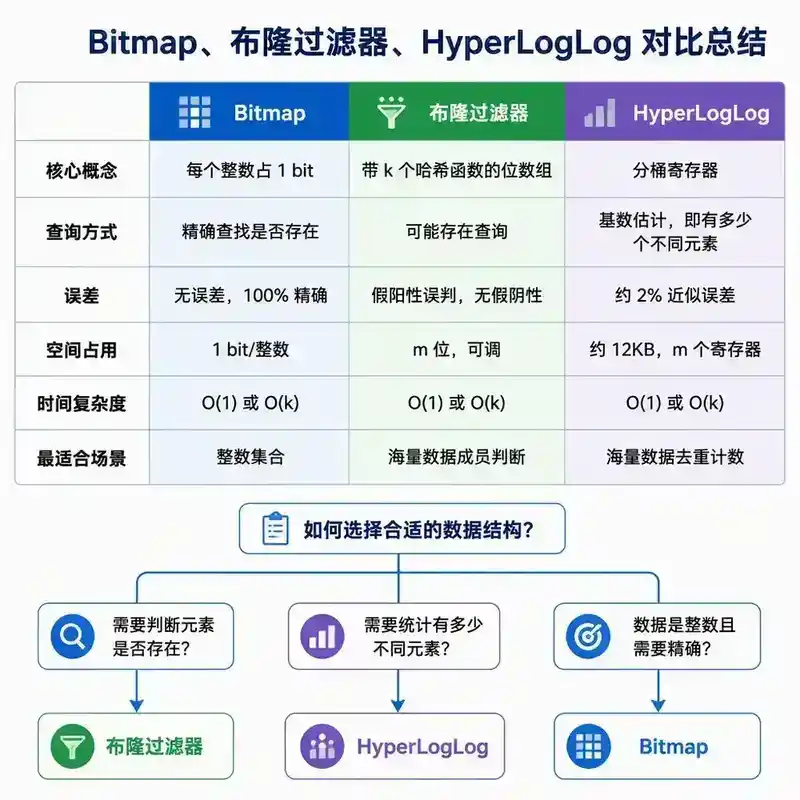
9.1 三者的核心关系
Bitmap 是最基础的位图结构
    ↓
Bloom Filter = Bitmap + 多个哈希函数
    ↓
HyperLogLog = 分桶 + 概率估计(基于哈希的位模式)
9.2 选型决策树
需要判断元素是否存在?
├── 数据是整数,范围可控? → Bitmap
├── 数据是任意类型,可接受误判? → Bloom Filter
│   ├── 需要删除? → 计数布隆过滤器 / 布谷鸟过滤器
│   └── 容量不确定? → 可扩展布隆过滤器
└── 数据是任意类型,需要精确? → HashSet(内存够用的话)

需要统计不同元素数量?
├── 需要精确计数? → HashSet / Bitmap
├── 可接受 2% 误差? → HyperLogLog
└── 需要多维度分析? → HyperLogLog(可合并特性)
9.3 核心公式速查
| 结构 | 核心公式 | 空间复杂度 |
|---|---|---|
| Bitmap | 1 bit / 整数 | O(值域范围) |
| Bloom Filter | m = -n·ln(p) / (ln2)² | O(n) 常数因子 |
| HyperLogLog | 误差 ≈ 1.04/√m | O(1) ≈ 12KB |
10. 面试官视角:提问与回答
以下问题从面试官视角设计,考察候选人对概率数据结构的理解深度、数学功底和工程思维。不限于文档内容,侧重知识迁移和临场推理。
Q1:布隆过滤器的误判率公式是怎么推导出来的?给你一块白板,现场推一遍。
考察点:概率论基础、能否在不查阅资料的情况下完成数学推导、对独立性和近似条件的理解。
参考回答:
假设哈希函数均匀分布,每位被选中的概率为 1/m。
第一步:插入一个元素时,某一位未被 k 个哈希函数中任意一个选中的概率:
$P(\text{一位未被选中}) = \left(1 - \frac{1}{m}\right)^k$
第二步:插入 n 个元素后,该位仍为 0 的概率:
$P(\text{仍为0}) = \left(1 - \frac{1}{m}\right)^{kn} \approx e^{-kn/m}$
这里用了极限 $\lim_{x\to\infty}(1-1/x)^{-x} = e$ 。面试官通常会追问这个近似的适用条件——当 m 较大时近似成立,而实际工程中 m 通常至少是百万级。
第三步:该位为 1 的概率:$P(1) = 1 - e^{-kn/m}$
第四步:一个未插入元素的 k 个位置恰好都为 1(误判):
$P(\text{误判}) = (1 - e^{-kn/m})^k$
面试官可能的追问:这个推导假设了哪些独立性?答:假设了 k 个哈希函数独立且均匀分布,但实际上用双哈希函数法(Kirsch-Mitzenmacher)模拟时并非完全独立,不过实践证明误差可以忽略。
Q2:你在生产环境用布隆过滤器做缓存穿透防护,上线半年后误判率从 1% 飙升到 20%。你会怎么排查?怎么解决?如果要在线修复,有什么方案?
考察点:故障排查思路、对容量退化的理解、在线运维能力。
参考回答:
排查思路:
- 先确认实际插入元素数量——大概率远超设计容量(n 从 1000 万涨到了 5000 万+)
- 检查位数组的使用率(1 的占比)——从设计时的 ~50% 涨到了 ~90%+
- 确认是否有代码 bug 导致重复插入或异常元素
解决方案:
- 方案 A(重建):用更大的 m 和新的 k 重建布隆过滤器,从数据库全量 reload。缺点:重建期间缓存穿透打到 DB。
- 方案 B(双写 + 灰度切流):新建一个大容量的布隆过滤器,新旧双写一段时间后切流到新的。零停机。
- 方案 C(升级为可扩展布隆过滤器):如果使用 RedisBloom,改用 SCALING 模式,自动创建子过滤器叠加。
面试官追问:如果必须零停机且不能接受重建期间的不一致呢?答:使用可扩展布隆过滤器(Scaling Bloom Filter),每层以更严格的误判率(如 p/2, p/4, ...)叠加,查询时遍历所有层。RedisBloom 的 BF.INSERT 的 SCALING 模式原生支持。
Q3:设计一个支持"昨天有没有见过这个用户"的分布式系统,要求精确去重,QPS 100 万,用户 ID 是 64 位整数。
考察点:能否区分"精确"与"概率"场景、Bitmap 的适用边界、分布式系统设计。
参考回答:
既然要求精确且用户 ID 是 64 位整数,Bitmap 是天然选择——但 2^64 位 ≈ 2 EB 显然不现实。所以只能存"昨天实际出现过的用户"。
方案设计:
- 使用 RoaringBitmap(压缩位图)而非朴素 Bitmap——对稀疏整数集合压缩率极高
- 分片策略:按 user_id % N 分片到 N 个 Redis 节点,每个节点维护当天的 RoaringBitmap
- 写入路径:
SETBIT user:2026-09-04:{shard} user_id 1 - 查询路径:
GETBIT user:2026-09-04:{shard} user_id - 过期策略:每天的数据设置 48 小时 TTL,自动清理
面试官追问:为什么用 RoaringBitmap 而不是布隆过滤器?答:题目要求精确去重,布隆过滤器有假阳性,会导致误判新用户为老用户。这是精确 vs 概率的经典取舍。
面试官再追问:如果 DAU 是 1 亿,RoaringBitmap 大概占多少内存?答:1 亿个 64 位整数,RoaringBitmap 压缩后大约几百 MB(取决于 ID 分布,连续 ID 压缩率极高,随机 ID 约 800MB-1GB)。
Q4:HyperLogLog 的误差为什么是 1.04/√m?如果要求误差降到 0.5%,需要多少内存?
考察点:对 HLL 原理的量化理解、能将理论公式转化为工程决策。
参考回答:
HLL 的标准误差公式为 $\sigma \approx 1.04 / \sqrt{m}$ ,其中 m 是桶数。
1.04 的来源:这个常数由两部分组成——调和平均带来的理论常数($\sqrt{3\ln 2 - 1} \approx 0.78$ )和实际模拟校正(乘以约 1.33)。最终经验值稳定在 1.04 左右。它不是精确推导出来的,而是 Flajolet 等人通过大量数值实验确定的。
误差 0.5% 需要多少内存:
$\text{所需桶数} = \left(\frac{1.04}{0.005}\right)^2 = 208^2 = 43264$
每个桶 6 位,总内存 = 43264 × 6 / 8 ≈ 32.4 KB。
面试官追问:Redis 的 HLL 为什么用 16384 个桶(12KB)?答:这是误差和内存的工程权衡。$\sigma = 1.04 / \sqrt{16384} \approx 0.81%$ ,对绝大多数场景(UV 统计、去重计数)足够。如果用户需要更高精度,可以用多个 HLL 分桶后合并,但大多数场景下 0.81% 的误差比业务数据本身的波动还小,不值得为精度翻倍内存。
Q5:布隆过滤器、布谷鸟过滤器、HyperLogLog、Count-Min Sketch——这四个概率结构分别解决什么问题?在什么场景下你会选哪个?
考察点:概率数据结构的全局视野、能准确区分不同结构的使用场景、有工程选型能力。
参考回答:
| 结构 | 解决的问题 | 操作 | 误差 | 空间 | 选型场景 |
|---|---|---|---|---|---|
| Bloom Filter | 集合成员判断 | add / contains | 假阳性 | O(n) | 缓存穿透、URL 去重、黑名单 |
| Cuckoo Filter | 集合成员判断+删除 | add / contains / delete | 假阳性 | 略优于 BF | 需要删除的集合成员判断 |
| HyperLogLog | 基数估计 | add / count | 约 0.81% | 12KB | UV 统计、去重计数 |
| Count-Min Sketch | 频率估计 | add / estimate | 高估 | O(1) | Top-K、流量统计、频率限制 |
选型决策:
- 要判断"见没见过"→ BF / CF(需删除选 CF,否则 BF)
- 要统计"有多少个不同的"→ HLL
- 要统计"每个出现了多少次"→ Count-Min Sketch
- 要精确结果 → 这些都不能用,用 HashSet / HashMap
面试官追问:Count-Min Sketch 和 HyperLogLog 能组合使用吗?答:可以。例如实时统计"访问超过 10 次的独立用户数"——用 Count-Min Sketch 过滤低频用户,再用 HLL 去重计数。这是典型的概率结构组合模式。
Q6:给你一个新的业务场景——短视频平台的"视频去重检测"(判断新上传的视频是否和已有视频高度相似)。你会用布隆过滤器吗?如果不会,为什么?
考察点:能否识别布隆过滤器的适用边界、对"相似性"vs"相等性"的区别理解、知识迁移能力。
参考回答:
不会用布隆过滤器。原因:
- 布隆过滤器只能判断"完全相等",不能判断"相似"。视频去重需要的是相似度检测(感知哈希、特征向量距离),而不是精确匹配。
- 布隆过滤器依赖哈希函数,哈希的特性是"输入微小变化导致输出完全不同"——两个几乎一样的视频,哈希值完全不同,布隆过滤器无法感知它们的相似性。
正确的技术选型:
- 感知哈希(pHash):对视频帧提取感知哈希,汉明距离小于阈值则判定相似
- SimHash + 海明距离:Google 用于网页去重,也可用于视频指纹
- 向量数据库 + 近似最近邻搜索(ANN):用深度学习模型提取视频 embedding,通过 FAISS/Milvus 做相似检索
但布隆过滤器可以用在辅助环节:比如用布隆过滤器快速排除"绝对不同的视频"(哈希值不匹配),减少进入相似度计算的数据量。
关于本文:本文是"Java 技术专家与架构师面试:250 个高频考点"系列的第 144 篇。下篇预告:序号 145——分布式 ID 生成器:雪花算法、号段模式与美团 Leaf 方案。