阅读时间:约 40-50 分钟 难度:中级偏上 前置知识:Redis 基本使用、操作系统基础(fork、写时复制、文件 I/O)
一、引言:Redis 为什么需要持久化?
Redis 以"快"著称,但它的"快"有一个前提——数据主要在内存中。内存是易失性的,一旦进程退出或服务器宕机,所有数据都会消失。对于一个缓存场景来说,丢数据可能还能接受;但对于一个用 Redis 做分布式锁、做计数器、做消息队列的系统,数据丢失就是事故。
Redis 提供了两种持久化机制来应对这个问题:
| 机制 | 全称 | 核心思想 |
|---|---|---|
| RDB | Redis Database | 某一时刻的内存快照,保存为二进制文件 |
| AOF | Append Only File | 记录所有写命令,重启时重放恢复数据 |
两者可以单独使用,也可以组合使用。Redis 4.0 还引入了混合持久化,在 AOF 重写时将 RDB 格式嵌入 AOF 文件头部,兼顾恢复速度和数据安全性。
本章从原理到源码,从配置到故障排查,把持久化这件事讲透。
二、RDB 持久化:内存快照
2.1 核心原理
RDB 做的事情很简单:在某个时刻,把 Redis 内存里的所有数据拍一张"照片",保存到磁盘上的 dump.rdb 文件。这个文件是一个紧凑的二进制文件,包含了那个时刻所有键值对的完整副本。
时间线:
  t0: 触发 RDB 保存
  t1: Redis fork 子进程
  t2: 子进程遍历内存、序列化写入磁盘
  t3: 子进程完成,原子替换旧的 dump.rdb
2.2 SAVE 与 BGSAVE
Redis 提供了两条命令来触发 RDB:
| 命令 | 执行方式 | 阻塞? | 适用场景 |
|---|---|---|---|
SAVE |
主进程直接执行 | 是,阻塞所有客户端请求 | 几乎没有生产用途 |
BGSAVE |
fork 子进程执行 | 否,主进程继续服务 | 生产环境标准方式 |
SAVE 命令:在主进程中直接完成数据序列化和磁盘写入。如果数据量是 10GB,这 10GB 的序列化期间 Redis 完全无法响应任何请求。生产环境千万别用。
BGSAVE 命令:主进程调用 fork() 创建一个子进程,子进程负责写 RDB 文件,主进程继续处理客户端请求。这是生产环境的标准做法。
2.3 Fork 与写时复制(Copy-on-Write)
BGSAVE 的核心依赖操作系统两个机制:
fork() 系统调用:创建一个子进程,子进程是父进程的完整副本。但这里的"完整副本"不是真的复制所有内存——那太慢了。现代操作系统使用写时复制(Copy-on-Write, COW):
fork() 后:
  ┌──────────────┐     ┌──────────────┐
  │   主进程      │     │   子进程      │
  │  (共享页表)   │─────│  (共享页表)   │
  └──────┬───────┘     └──────┬───────┘
         │                    │
    ┌────▼────────────────────▼────┐
    │       物理内存页(共享)       │
    │   key1, key2, key3, ...      │
    └──────────────────────────────┘

主进程修改 key1 时:
  ┌──────────────┐     ┌──────────────┐
  │   主进程      │     │   子进程      │
  │  key1 → NEW  │     │  key1 → OLD  │
  └──────┬───────┘     └──────┬───────┘
         │                    │
    ┌────▼────────┐     ┌────▼────────┐
    │ 新物理页     │     │ 旧物理页     │
    │ key1=NEW    │     │ key1=OLD    │
    └─────────────┘     └─────────────┘
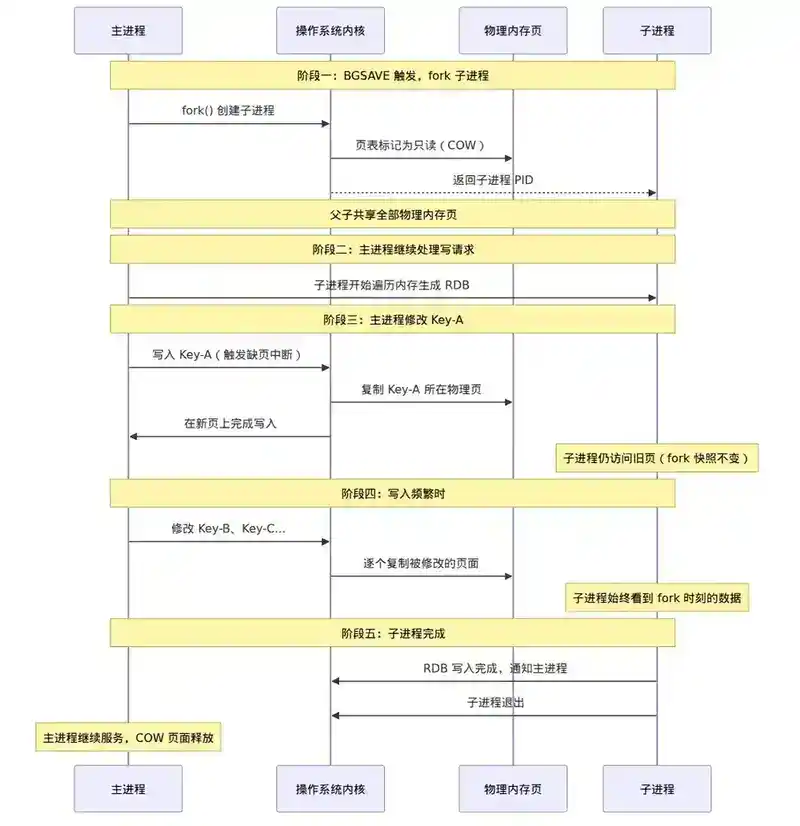
关键点:
- fork 瞬间,父子进程共享所有物理内存页(页表标记为只读)。
- 当主进程要修改某个内存页时,触发缺页中断,操作系统复制该页,修改复制后的页。
- 子进程看到的始终是 fork 那一刻的内存快照,不受主进程后续修改影响。
fork 的性能开销:
- fork 本身的时间与进程内存大小相关(需要复制页表),10GB 内存的 Redis 进程 fork 大约需要 100-200ms。
- 这个耗时虽然不长,但 fork 期间主进程是阻塞的——如果 Redis 正在处理大量请求,这 100ms 会造成明显的延迟抖动。
- COW 的内存开销:如果 BGSAVE 期间写入量很大,会触发大量页复制,导致内存占用翻倍。
2.4 RDB 触发条件
RDB 可以通过三种方式触发:
1. 手动触发:执行 BGSAVE 或 SAVE 命令。
2. 配置自动触发(redis.conf):
save 900 1      # 900 秒内至少 1 次修改
save 300 10     # 300 秒内至少 10 次修改
save 60 10000   # 60 秒内至少 10000 次修改
多个 save 条件是"或"关系,满足任意一个就触发 BGSAVE。Redis 内部通过 dirty 计数器(记录上次保存后的修改次数)和 lastsave 时间戳来判断。
3. 其他隐式触发:
- 主从复制时,从库执行全量同步,主库会触发 BGSAVE 生成 RDB 发给从库。
- 执行
SHUTDOWN时,如果没有开启 AOF,会自动执行一次 SAVE。 - 执行
DEBUG RELOAD时。
2.5 RDB 配置参数详解
# 自动触发条件
save 900 1
save 300 10
save 60 10000

# 当 BGSAVE 出错时是否停止写入
stop-writes-on-bgsave-error yes

# 是否压缩 RDB 文件(LZF 压缩)
rdbcompression yes

# 是否校验 RDB 文件(CRC64)
rdbchecksum yes

# RDB 文件名
dbfilename dump.rdb

# RDB 文件存储路径
dir /var/lib/redis
**stop-writes-on-bgsave-error**:默认 yes。如果最近一次 BGSAVE 失败(比如磁盘满了),Redis 会拒绝所有写入请求,以此提醒运维人员持久化已经失效。如果你用 Redis 做纯缓存且不在乎数据丢失,可以设为 no。
**rdbcompression**:默认 yes,使用 LZF 算法压缩字符串类型的值。压缩能显著减小 RDB 文件体积(通常 50%-80%),但会增加 CPU 开销。如果 Redis 是 CPU 瓶颈,可以考虑关闭。
**rdbchecksum**:默认 yes。在 RDB 文件末尾写入 CRC64 校验和,加载时校验。这能防止使用损坏的 RDB 文件,但会带来约 10% 的性能开销。
2.6 RDB 的优缺点
| 优点 | 缺点 |
|---|---|
| 文件紧凑,适合备份和灾难恢复 | 两次 RDB 之间的数据可能丢失 |
| 恢复速度快(直接加载二进制) | fork 子进程可能造成毫秒级阻塞 |
| 对主进程性能影响小(子进程写盘) | COW 导致内存可能翻倍 |
| 适合做定期冷备份 | 不支持秒级持久化 |
三、AOF 持久化:命令日志
3.1 核心原理
AOF 的思路和 RDB 完全不同:它不保存数据本身,而是保存所有修改数据的写命令。重启时,Redis 逐条重放 AOF 文件中的命令来重建数据库。
AOF 文件示例:
  *3
  $3
  SET
  $4
  name
  $5
  alice
  *3
  $3
  SET
  $4
  age
  $2
  25
这套格式就是 Redis 的 RESP 协议(REdis Serialization Protocol),和客户端发送的命令格式完全一致。
3.2 AOF 写入流程:从命令到磁盘
一条写命令从客户端到 AOF 文件,经过以下路径:
客户端 → Redis 服务器
         │
         ▼
    ┌─────────┐
    │ 执行命令  │  ← 先执行,成功后记录
    └────┬────┘
         ▼
    ┌─────────────┐
    │ 追加到 AOF 缓冲区 │  ← aof_buf(内存)
    └────┬────────┘
         │ (根据 appendfsync 策略决定何时刷盘)
         ▼
    ┌─────────────┐
    │ 写入 AOF 文件   │  ← 磁盘
    └─────────────┘
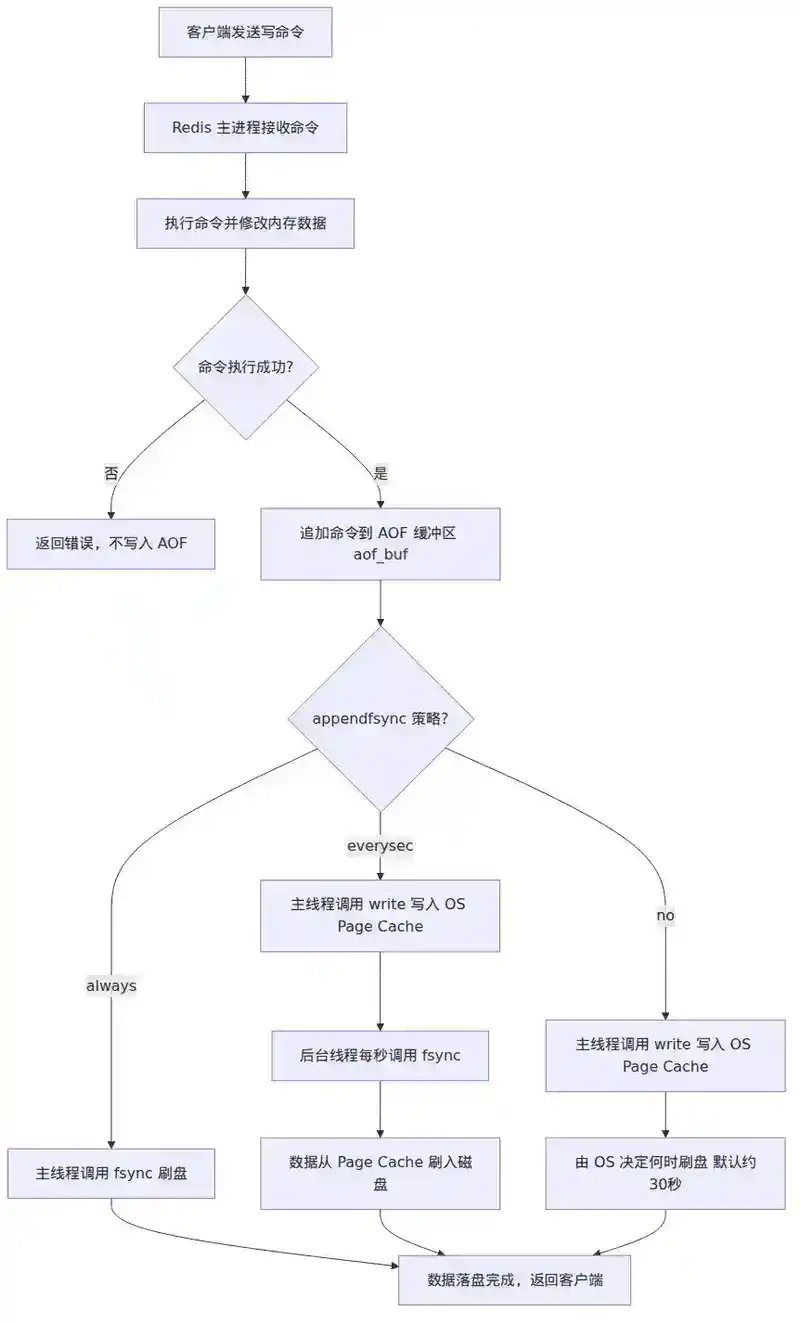
关键设计决策:Redis 先执行命令,成功后才写入 AOF。这样保证 AOF 中不会记录错误的命令,同时避免了对命令的语法检查开销。
3.3 三种刷盘策略(appendfsync)
这是 AOF 配置中最关键的参数,直接影响性能和数据安全性:
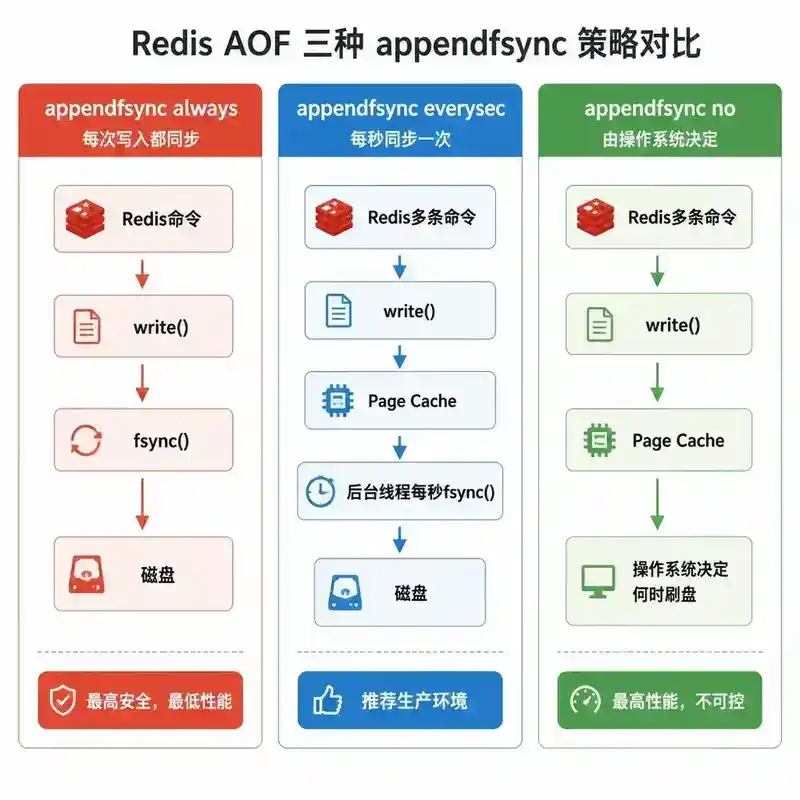
| 策略 | 行为 | 数据安全 | 性能 | 适用场景 |
|---|---|---|---|---|
always |
每条命令都 fsync | 最高,最多丢一条 | 最低(磁盘瓶颈) | 金融、支付等对数据要求极高的场景 |
everysec |
每秒 fsync 一次 | 较高,最多丢 1 秒 | 较高(默认推荐) | 生产环境首选 |
no |
由操作系统决定刷盘 | 不可控 | 最高 | 纯缓存,不在意数据丢失 |
**always**策略详解:每条写命令执行后立即调用 fsync()。从 Redis 视角看,确认写入成功即意味着数据已落盘。但代价极高——Redis 的写入性能完全受限于磁盘的 fsync 性能。普通 SATA SSD 的 fsync 延迟约 0.1-1ms,意味着 Redis 每秒最多写入 1000-10000 条命令。
**everysec**策略详解(默认):Redis 开一个后台线程,每秒执行一次 fsync()。主线程写入 AOF 缓冲区后立即返回(不阻塞),由后台线程负责刷盘。这是生产环境的最佳实践——在性能和数据安全之间取得了很好的平衡。
**everysec**的写入细节:
主线程:
  ① write() 将数据从 aof_buf 写到 OS 的 page cache  → 立即返回
  ② 通知后台线程"有数据需要 fsync"

后台线程(每秒一次):
  ③ fsync() 将 page cache 刷到磁盘
**everysec**的异常处理:如果上一次 fsync 耗时超过 2 秒,Redis 会记录慢日志,但不会阻塞写入。如果磁盘 I/O 持续过载,fsync 可能会延迟,导致数据丢失超过 1 秒。
**no**策略:Redis 只调用 write(),不调用 fsync()。数据何时真正落盘完全由操作系统的脏页回写策略决定(Linux 默认每 30 秒一次)。性能最高,但宕机可能丢失 30 秒以上的数据。
3.4 AOF 重写(Rewrite)
为什么需要重写?
AOF 文件会随着时间不断增长。假设你对同一个 key 执行了 100 次 INCR,AOF 里就有 100 条命令。但实际上,只需要一条 SET key 100 就能表达最终状态。AOF 重写就是做这个"压缩"——消除冗余命令,用最精简的方式表达当前数据状态。
重写前(AOF 文件):
  SET counter 1
  SET counter 2
  ...
  SET counter 100
  LPUSH list "a"
  LPUSH list "b"
  LPUSH list "c"

重写后(新 AOF 文件):
  SET counter 100
  RPUSH list "a" "b" "c"
重写触发方式:
- 手动触发:
BGREWRITEAOF命令 - 自动触发(配置参数):
auto-aof-rewrite-percentage 100   # 当前 AOF 文件比上次重写后增长了 100%
auto-aof-rewrite-min-size 64mb    # 且 AOF 文件至少 64MB
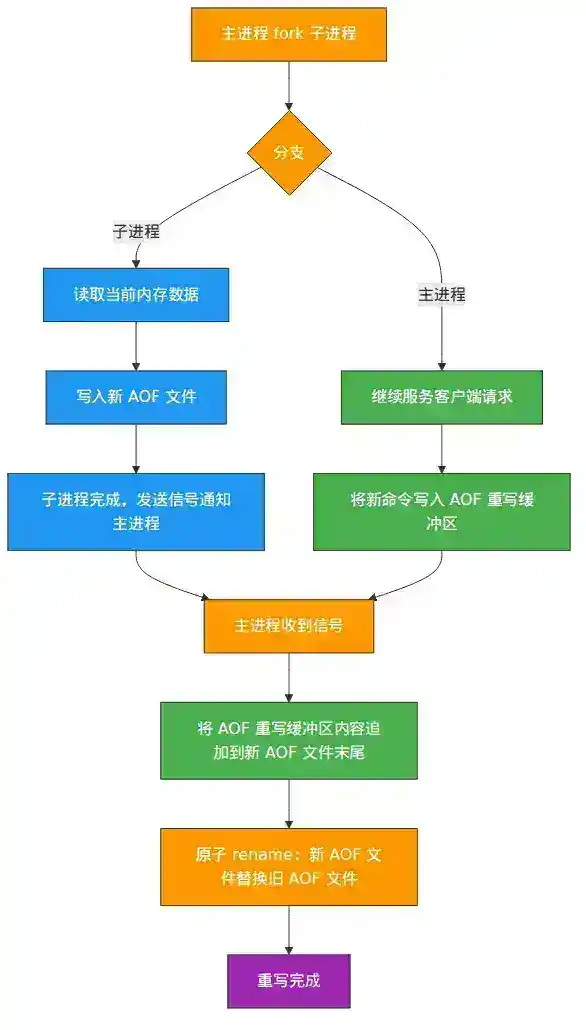
重写流程:
主进程 fork 子进程
     │
     ▼
┌──────────────────────────────────────┐
│  子进程:读取当前内存数据,写入新 AOF  │
│  主进程:继续服务请求,同时将新命令    │
│           写入「AOF 重写缓冲区」      │
└──────────────────────────────────────┘
     │
     ▼
子进程完成 → 信号通知主进程
     │
     ▼
主进程将 AOF 重写缓冲区内容追加到新 AOF 文件
     │
     ▼
原子 rename 新 AOF 文件替换旧 AOF 文件
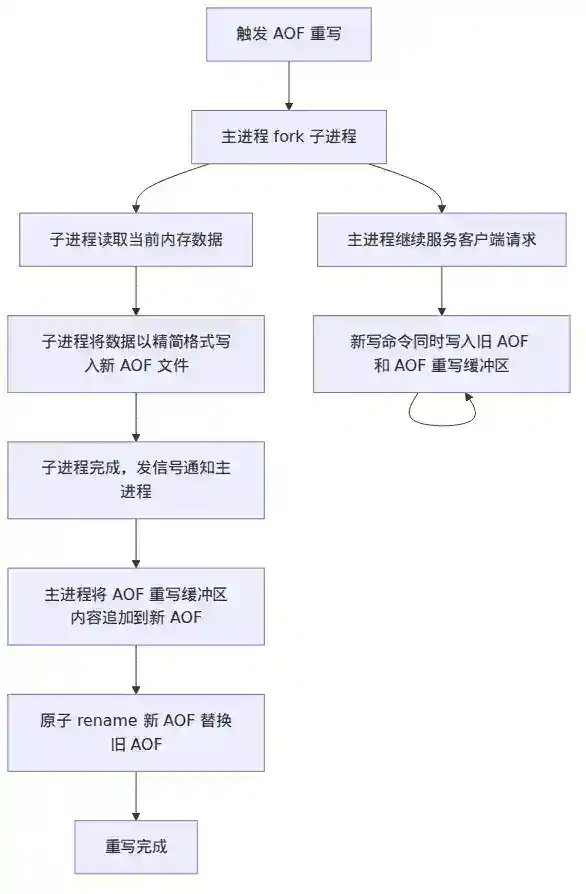
关键细节:
- 子进程不会读取旧 AOF 文件,而是直接读取当前内存中的数据。
- 重写期间的新写入,主进程同时写入旧 AOF 和 AOF 重写缓冲区。
- 子进程完成后,主进程将重写缓冲区的增量数据追加到新 AOF,实现数据一致。
- 整个过程不阻塞主进程服务。
3.5 AOF 配置参数详解
# 开启 AOF
appendonly yes

# AOF 文件名
appendfilename "appendonly.aof"

# 刷盘策略
appendfsync everysec

# 重写时是否 fsync
no-appendfsync-on-rewrite no

# 重写触发条件
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb

# 加载时遇到截断的 AOF 是否继续
aof-load-truncated yes

# 是否使用 RDB 前导码(混合持久化)
aof-use-rdb-preamble yes
**no-appendfsync-on-rewrite**:默认 no。如果设为 yes,在 AOF 重写期间不执行 fsync,将数据安全交给操作系统。这能减少重写期间的磁盘 I/O 压力,但增加了数据丢失风险。如果你的磁盘 I/O 是瓶颈,可以设为 yes。
**aof-load-truncated**:默认 yes。AOF 文件可能因为系统崩溃而尾部截断。设为 yes 时,Redis 启动时会丢弃不完整的尾部命令并继续启动;设为 no 时,Redis 会拒绝启动,需要手动修复。
3.6 AOF 的优缺点
| 优点 | 缺点 |
|---|---|
| 数据安全性高,最多丢 1 秒数据 | AOF 文件通常比 RDB 大 |
| 可读性好,可以手动编辑修复 | 恢复速度比 RDB 慢(重放命令) |
| 支持秒级持久化 | 写 QPS 高时,AOF 文件增长快 |
| 重写机制可以压缩文件 | everysec 也有性能损耗(约 5%-15%) |
四、混合持久化(Redis 4.0+)
4.1 设计动机
RDB 和 AOF 各有优劣:
- RDB 恢复快,但数据窗口大(可能丢失几分钟的数据)。
- AOF 数据安全,但恢复慢(几十 GB 的 AOF 重放可能要几十分钟)。
混合持久化结合两者优点:用 RDB 做"全量",用 AOF 做"增量"。
4.2 混合持久化原理
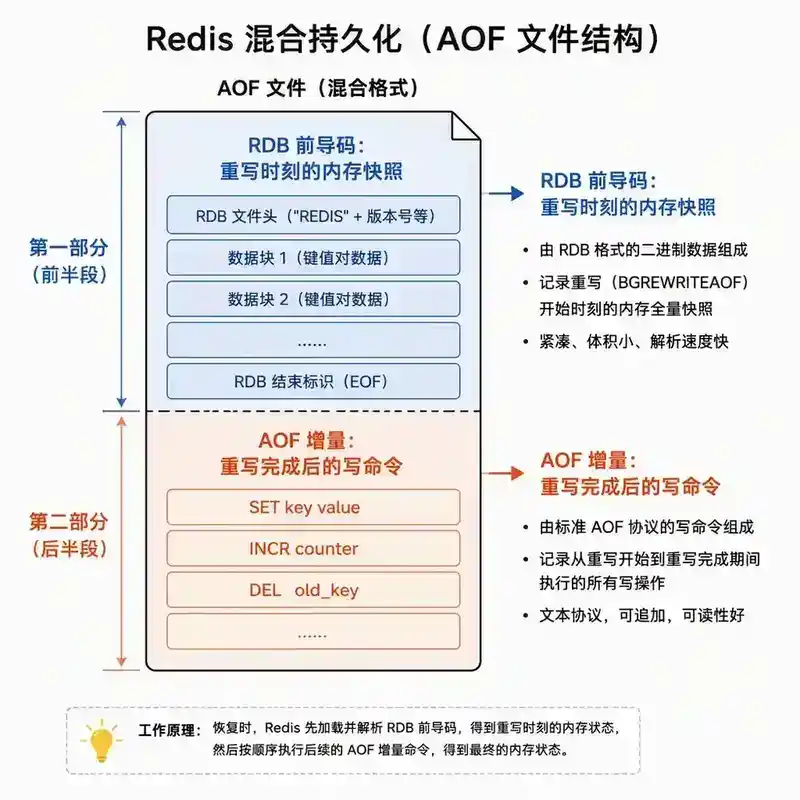
开启混合持久化后(aof-use-rdb-preamble yes),AOF 重写时不再是纯命令格式,而是:
┌──────────────────────────────────┐
│  RDB 格式(前导码)               │  ← 重写时刻的内存快照
│  二进制紧凑格式                   │
│  包含所有 key-value              │
├──────────────────────────────────┤
│  AOF 格式(增量)                 │  ← 重写完成后的增量命令
│  SET key "new_value"            │
│  INCR counter                   │
│  ...                            │
└──────────────────────────────────┘
重写时的流程:
- 子进程将当前内存数据以 RDB 格式写入新 AOF 文件头部。
- 主进程将重写期间的增量命令以 AOF 格式追加到 RDB 数据之后。
- 原子 rename 替换。
恢复时的流程:
- Redis 启动时发现 AOF 文件前半部分是 RDB 格式,直接加载(快速)。
- 然后重放后半部分的 AOF 增量命令(少量)。
- 总恢复时间 ≈ RDB 恢复时间 + 少量 AOF 重放时间。
4.3 混合持久化的优势
| 对比维度 | 纯 RDB | 纯 AOF | 混合持久化 |
|---|---|---|---|
| 恢复速度 | 快(二进制加载) | 慢(逐条重放) | 快(RDB 主体 + 少量 AOF) |
| 数据安全 | 差(分钟级窗口) | 好(秒级) | 好(秒级) |
| 文件体积 | 小 | 大 | 中等 |
| 可读性 | 二进制,不可读 | 可读 | 前半部分不可读 |
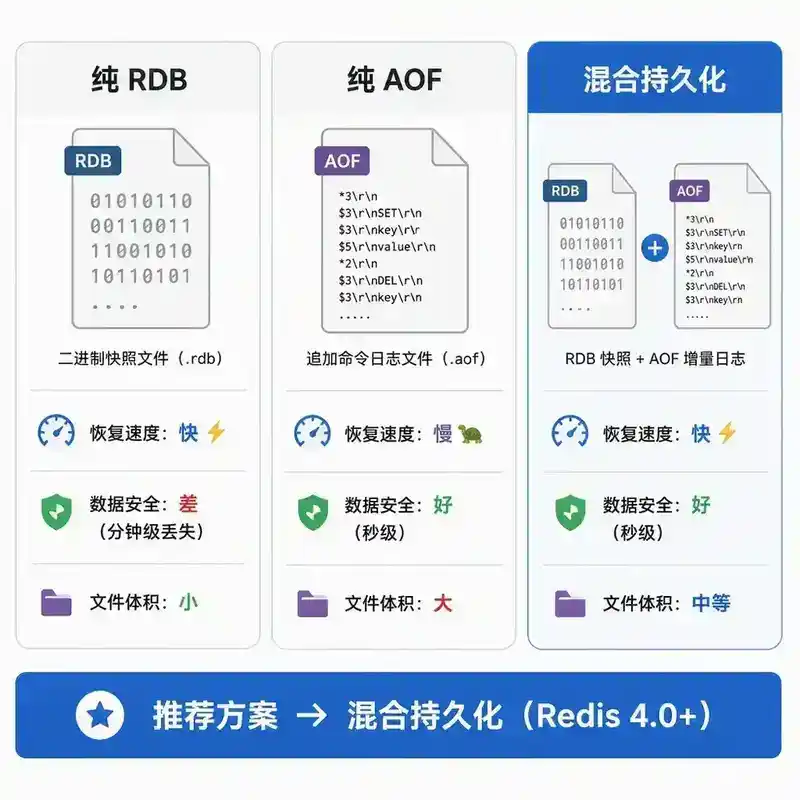
混合持久化是 Redis 4.0 后生产环境的推荐配置。它本质上就是 AOF 的一个增强——重写时用 RDB 格式代替纯命令格式。
五、数据恢复流程
5.1 启动时的加载优先级
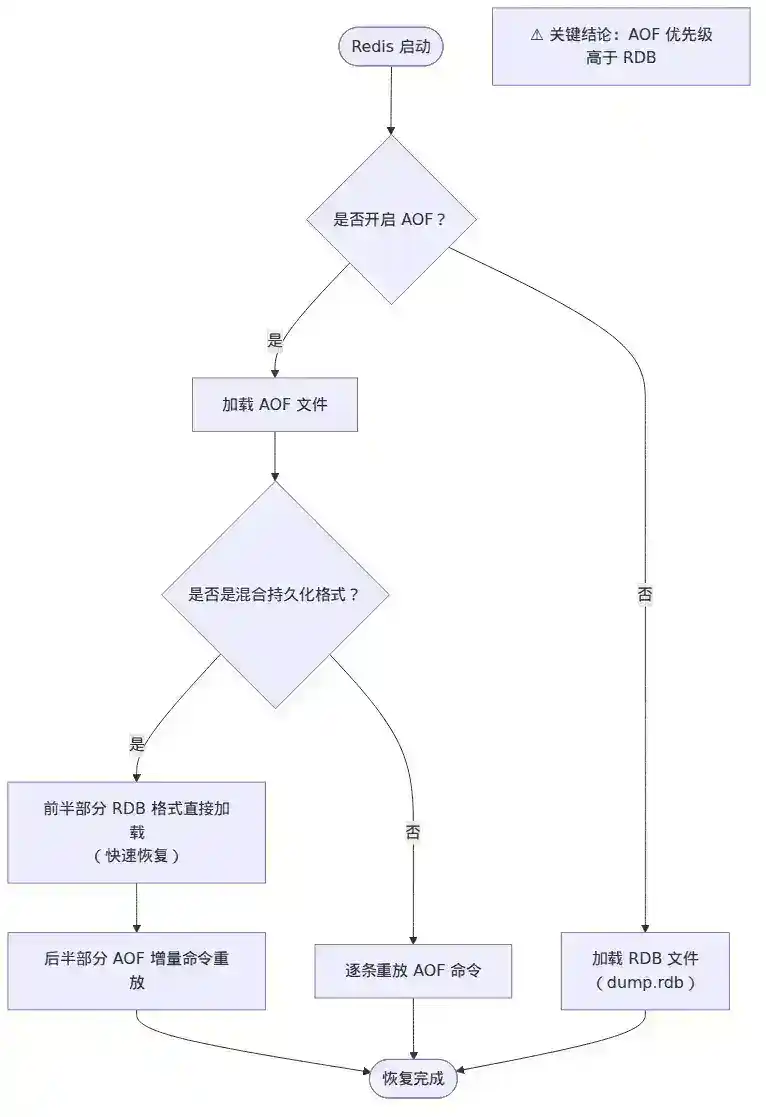
Redis 启动时,按以下优先级决定加载哪个持久化文件:
Redis 启动
    │
    ▼
AOF 是否开启?
    │
    ├── 是 → 加载 AOF 文件
    │         (混合持久化下,前半部分 RDB 格式直接加载,后半部分 AOF 格式重放)
    │
    └── 否 → 加载 RDB 文件(dump.rdb)
关键结论:AOF 的优先级高于 RDB。如果同时开启了 AOF 和 RDB,Redis 启动时只会加载 AOF 文件,RDB 文件被忽略。这是因为 AOF 通常包含更完整的数据。
5.2 恢复过程中的异常处理
RDB 文件损坏:
- 如果
rdbchecksum开启,Redis 会在加载时校验 CRC64,发现损坏则停止启动。 - 可以使用
redis-check-rdb工具检查文件:redis-check-rdb dump.rdb - 如果 RDB 文件无法修复,只能删除它,Redis 将以空数据库启动。
AOF 文件损坏或截断:
- 如果
aof-load-truncated yes(默认),Redis 会丢弃尾部不完整的命令,打印警告日志后继续启动。 - 如果
aof-load-truncated no,Redis 拒绝启动,需要手动修复。 - 修复工具:
redis-check-aof --fix appendonly.aof - 修复原理:扫描 AOF 文件,找到最后一个完整的 RESP 协议命令,截断之后的内容。
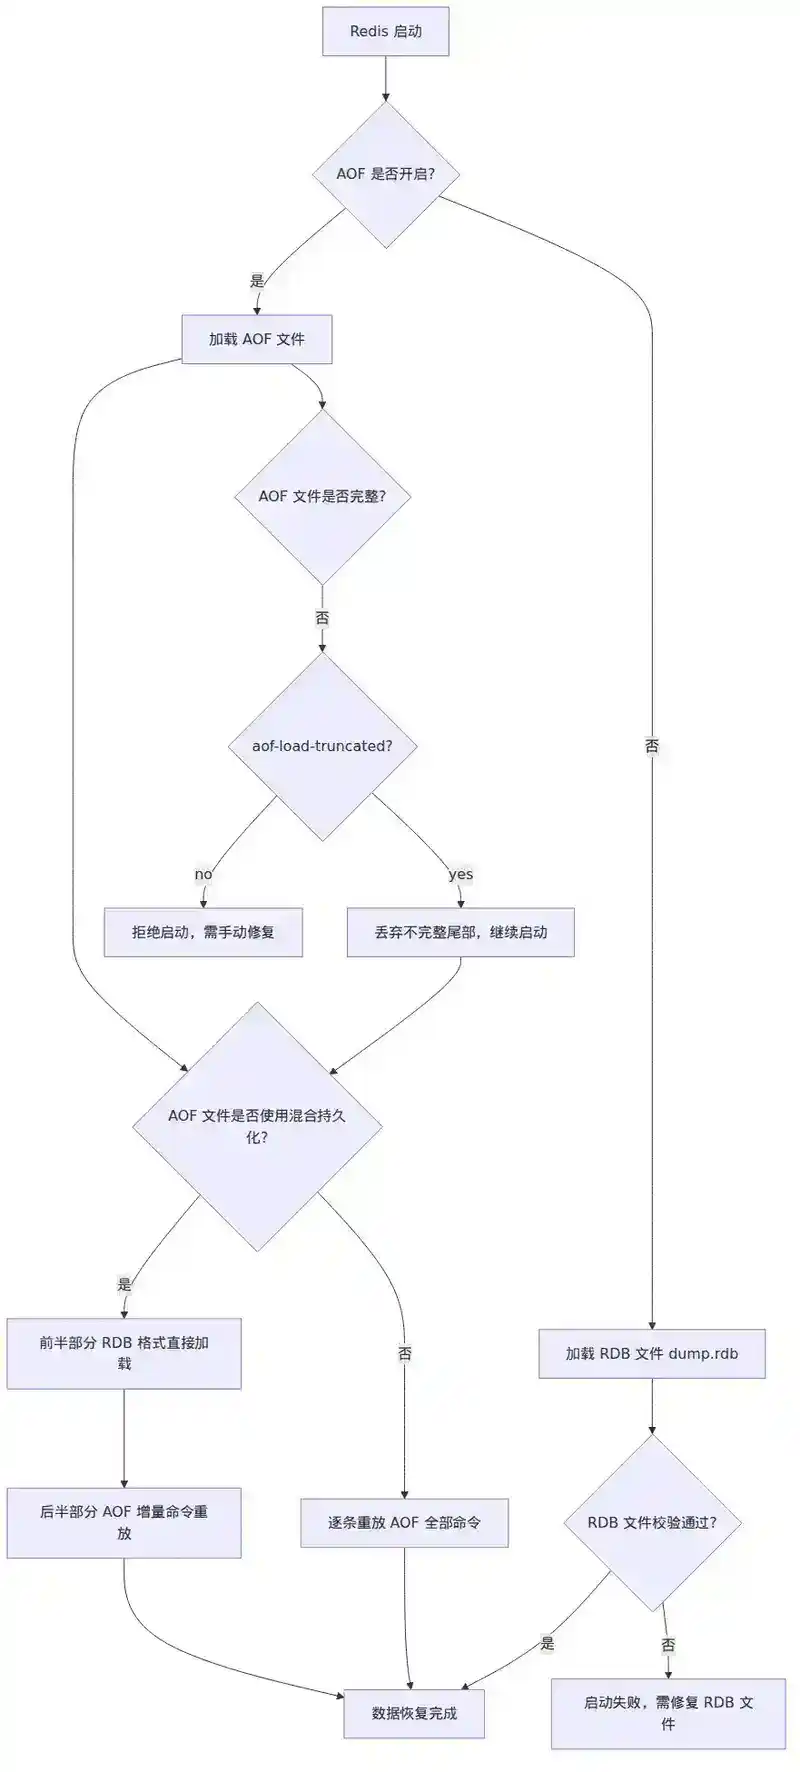
AOF 文件被意外清空或替换:
- 如果 Redis 在运行中 AOF 文件被删除,Redis 不会自动创建新文件——需要重启或执行
BGREWRITEAOF。 - 如果 AOF 文件被替换为错误内容,Redis 重启后可能加载错误数据。
5.3 恢复时间估算
RDB 恢复:主要受文件大小和磁盘读取速度影响。10GB 的 RDB 文件,在普通 SSD 上恢复大约需要 30-60 秒。
纯 AOF 恢复:受命令数量和命令复杂度影响。10GB 的 AOF 文件(纯命令格式),恢复可能需要 10-30 分钟——因为每条命令都要解析、执行。
混合持久化恢复:RDB 部分快速加载,AOF 增量部分很小(通常几百 KB 到几 MB),几乎可以忽略。恢复时间接近纯 RDB。
六、生产实践指南
6.1 持久化方案选型
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 纯缓存,数据可重建 | 关闭持久化,或只用 RDB(低频) | 减少性能开销 |
| 一般业务缓存 | RDB + AOF(everysec)+ 混合持久化 | 数据安全与性能平衡 |
| 计数器、分布式锁 | AOF(everysec)+ 混合持久化 | 不能丢数据 |
| 金融、支付 | AOF(always)或同步写数据库 | 最高数据安全 |
| 大数据量(>20GB) | RDB + AOF(everysec)+ 混合持久化 | 必须用混合持久化加速恢复 |
6.2 常见问题与排查
问题 1:BGSAVE 时出现延迟飙升
原因:fork 子进程时,主进程短暂阻塞。如果内存很大(>10GB),fork 时间可达到数百毫秒。
排查:
# 查看最近一次 fork 的耗时
INFO stats | grep latest_fork_usec
解决:减少内存占用、使用 Redis Cluster 分片减小单实例内存、考虑关闭 THP(Transparent Huge Pages)。
问题 2:AOF 文件增长过快
原因:写操作频繁,重写跟不上写入速度。
排查:
# 查看 AOF 当前大小和重写状态
INFO persistence | grep aof
解决:降低 auto-aof-rewrite-percentage 或增加 auto-aof-rewrite-min-size,手动触发 BGREWRITEAOF。
问题 3:AOF 重写期间磁盘 I/O 打满
原因:重写子进程大量写磁盘,同时主进程也在同步写 AOF。
解决:开启 no-appendfsync-on-rewrite yes,或将 AOF 文件放在单独的磁盘上。
问题 4:fork 子进程时内存翻倍导致 OOM
原因:BGSAVE 或 AOF 重写期间,COW 复制了大量内存页。
解决:预留足够内存(至少 1.5 倍的实际数据量),禁用 THP,使用 vm.overcommit_memory=1。
问题 5:RDB 文件损坏
原因:磁盘满、系统崩溃、硬件故障。
排查:
redis-check-rdb dump.rdb
解决:使用备份的 RDB 文件恢复,或删除损坏的 RDB 从头开始。
6.3 监控指标
# 持久化相关关键指标
INFO persistence
| 指标 | 含义 | 告警阈值 |
|---|---|---|
rdb_last_bgsave_status |
最近一次 BGSAVE 是否成功 | 应当为 ok |
rdb_last_bgsave_time_sec |
最近一次 BGSAVE 耗时 | > 预期的 2 倍 |
aof_last_write_status |
最近一次 AOF 写入是否成功 | 应当为 ok |
aof_last_bgrewrite_status |
最近一次 AOF 重写是否成功 | 应当为 ok |
aof_current_size |
AOF 文件当前大小 | > 磁盘空闲的 80% |
aof_buffer_length |
AOF 缓冲区长度 | > 0 持续增长 |
aof_rewrite_buffer_length |
AOF 重写缓冲区长度 | > 0 持续增长 |
aof_delayed_fsync |
延迟的 fsync 次数 | > 0 |
6.4 最佳实践清单
- 生产环境同时开启 RDB 和 AOF,AOF 使用
everysec策略。 - 开启混合持久化(
aof-use-rdb-preamble yes),Redis 4.0+。 - 定期备份 RDB 文件,保留最近 N 天的备份(如
dump_20260903.rdb)。 - AOF 文件单独放一个磁盘,避免和其他 I/O 密集操作竞争。
- 关闭 THP(
echo never > /sys/kernel/mm/transparent_hugepage/enabled),避免 fork 延迟。 - 设置
**vm.overcommit_memory=1**,确保 fork 有足够内存。 - 监控持久化状态,对 BGSAVE/AOF 重写失败设置告警。
- 定期演练数据恢复,确认 RDB/AOF 文件可用且恢复时间在预期内。
- 不要用
**always**策略除非必要,它会让 Redis 性能降为磁盘性能。 - 主从架构中,持久化放在从节点,减轻主节点压力(如果业务允许)。
七、面试提问
以下问题从面试官视角设计,考察对 Redis 持久化的深层理解,不限于本文内容。
Q1:Redis 同时开启了 RDB 和 AOF,重启时优先加载哪个?为什么?
Q2:在高写入场景下,AOF 的**everysec**策略实际能保证只丢 1 秒数据吗?什么情况下可能丢更多?
Q3:BGSAVE 期间,主进程修改了一个 1GB 的大 key,COW 会复制整个 1GB 吗?为什么?
Q4:你线上 Redis 实例 32GB 内存,BGSAVE 需要 5 分钟,期间写入量较大。如何估算 COW 带来的额外内存开销?
Q5:当 AOF 重写正在进行时,Redis 进程崩溃了。重启后 AOF 文件的状态是什么?数据会丢失吗?
Q6:Redis 7.0 引入了 Multi-Part AOF,它解决了什么问题?相比传统 AOF 有什么改进?
Q7:如果**appendfsync always**和**appendfsync everysec**在同一个集群的不同节点上,主从切换后数据一致性会有什么差异?
Q8:为什么 Redis 推荐关闭 Transparent Huge Pages(THP)?THP 对 BGSAVE 具体有什么影响?
Q9:设计一个方案:如何在保证 Redis 持久化数据安全的前提下,将 Redis 的写入吞吐量提升到 10 万 QPS?
Q10:RDB 文件和 AOF 文件都存在磁盘上,但磁盘 I/O 负载已经很高。在不增加硬件的前提下,有哪些优化手段?
延伸阅读:Redis 官方文档 Persistence、Redis 源码
rdb.c和aof.c。
参考答案
Q1:Redis 同时开启了 RDB 和 AOF,重启时优先加载哪个?为什么?
优先加载 AOF。因为 AOF 的更新频率更高(默认 everysec),数据更新更完整,通常比 RDB 保存的数据更接近崩溃时刻。Redis 在 server.c 的 loadDataFromDisk() 中,会先检查 AOF 是否开启,若开启则直接加载 AOF 忽略 RDB。只有当 AOF 关闭时,才会回退到 RDB 加载。这也是为什么即使 RDB 文件更大更完整,只要 AOF 开启,Redis 就信任 AOF——语义上 AOF 是 write-ahead log,它的写入顺序决定了它代表最新的状态。
Q2:在高写入场景下,AOF 的**everysec**策略实际能保证只丢 1 秒数据吗?什么情况下可能丢更多?
不能完全保证。everysec 的语义是"最多丢 1 秒的数据",但实际上可以丢 2 秒甚至更多。原因是:everysec 通过一个后台线程每秒执行一次 fsync,但如果系统的 I/O 负载很高,一次 fsync 耗时超过 1 秒,下一轮的 fsync 就会延迟执行。更严重的情况是,如果 Redis 主进程在写入 AOF 缓冲区时被阻塞(例如内存分配延迟、磁盘 I/O 卡顿),且正好在两次 fsync 之间崩溃,丢失的数据量就可能超过 2 秒。此外,当 aof_fsync_offset 落后于 aof_current_size 太多时,Redis 会跳过某些 fsync 调用(延迟 fsync),此时丢失的数据量可能更大。可以通过 INFO persistence 中的 aof_delayed_fsync 指标监控。
Q3:BGSAVE 期间,主进程修改了一个 1GB 的大 key,COW 会复制整个 1GB 吗?为什么?
不会复制整个 1GB。COW(Copy-On-Write)以内存页(通常 4KB)为单位工作。当主进程修改 key 时,只有被修改的内存页才会触发复制。一个 1GB 的 key 分配在大量内存页上,如果修改只涉及其中一个页(比如修改了 value 中的一个字段),那么只有这一个页(4KB)会被复制,而不是整个 1GB。但需要注意:如果修改操作涉及大量内存页(例如对 1GB 的 String 做 append,触发 SDS 扩容并重新分配内存),那么实际复制的内存会远大于 4KB。Redis 的 SDS 使用 sdsMakeRoomFor 进行扩容,如果新长度超过 1MB,会分配新长度 + 1MB 的空间,这会导致较多页的 COW 复制。不过,无论如何,COW 不会复制未被修改的页。
Q4:你线上 Redis 实例 32GB 内存,BGSAVE 需要 5 分钟,期间写入量较大。如何估算 COW 带来的额外内存开销?
核心公式:COW 内存 ≈ 写入速率 × BGSAVE 持续时间 × 内存页大小。实际操作步骤:
- 通过
INFO stats获取instantaneous_ops_per_sec(写入 OPS),假设为 5000 writes/s。 - 估算每次写入涉及的内存页数:简单场景下,每个写操作修改 1-2 个 key,每个 key 可能涉及 1-N 个内存页。假设平均每个写操作触发 2 个内存页的 COW(8KB)。
- 5 分钟 = 300 秒,总写入次数 = 5000 × 300 = 150 万次。
- COW 内存 ≈ 150 万 × 8KB ≈ 12GB。
- 加上 fork 时子进程自身的页表开销(32GB 实例约需 1-2GB 页表),总额外内存约 13-14GB。
- 所以需要预留 32GB + 14GB = 46GB 的
vm.overcommit_memory=1环境或足够的物理内存。
更精确的监控方式:在 BGSAVE 期间用 INFO memory 对比 used_memory 和实际的 RSS(通过 /proc/<pid>/smaps),观察内存增长。或者用 sar -r 监控系统级内存变化。
Q5:当 AOF 重写正在进行时,Redis 进程崩溃了。重启后 AOF 文件的状态是什么?数据会丢失吗?
这取决于 AOF 重写处于哪个阶段:
- 阶段 1(fork 后,子进程写入中): 子进程正在生成新的 AOF 文件(临时文件),主进程同时将新命令写入 AOF 重写缓冲区。如果此时崩溃,临时 AOF 文件不完整,原始 AOF 文件依然存在且完整。重启后 Redis 会加载原始 AOF 文件,不会丢失数据(只丢失
everysec策略下最多 1 秒的未 fsync 数据)。 - 阶段 2(子进程完成,父进程准备 rename): 子进程已完成临时 AOF 写入,父进程收到信号后,将重写缓冲区中的增量命令追加到临时文件,然后执行
rename()原子替换。如果崩溃发生在 rename 之前,同阶段 1,原始 AOF 文件完整,不会丢失数据。 - 阶段 3(rename 执行中):
rename()是原子系统调用,要么成功要么失败。如果 rename 成功但马上崩溃,新的 AOF 文件可能缺少重写缓冲区中的部分增量命令,但这个问题很小。Redis 7.0 的 Multi-Part AOF 通过多文件 manifest 机制进一步保障了这个场景。
总结:AOF 重写崩溃不会破坏已有的 AOF 数据,因为原始 AOF 文件始终保留直到 rename 成功。
Q6:Redis 7.0 引入了 Multi-Part AOF,它解决了什么问题?相比传统 AOF 有什么改进?
Multi-Part AOF 解决了传统 AOF 的三大痛点:
- AOF 重写期间的增量数据丢失风险: 传统 AOF 在重写完成后,需将重写缓冲区中的增量命令追加到临时 AOF 文件再 rename。这一步不是原子的,如果在此过程中崩溃,可能丢失增量数据。Multi-Part AOF 将 AOF 分为基础文件(base)和增量文件(incr),重写时只生成新的 base 文件,增量命令写入新的 incr 文件,通过 manifest 文件管理所有 AOF 文件,任何时刻崩溃都不会丢失数据。
- AOF 文件过大导致恢复慢: 传统 AOF 只有一个大文件,即使重写后文件仍然可能很大。Multi-Part AOF 允许将 AOF 拆分为多个文件,恢复时可以并行加载,加快恢复速度。
- AOF 重写只能全量生成: Multi-Part AOF 支持增量式重写,不需要每次都全量遍历整个数据集,降低了重写的 CPU 和内存开销。
Q7:如果**appendfsync always**和**appendfsync everysec**在同一个集群的不同节点上,主从切换后数据一致性会有什么差异?
**always**节点提升为主: 由于每条命令都同步 fsync 到磁盘,其数据是最完整的。切换后,客户端看到的数据几乎无丢失(fsync 成功后才返回 OK)。但always的写入性能极低(约 1-2 万 QPS),通常只在对数据安全性要求极高的场景使用。**everysec**节点提升为主: 最多丢失 1 秒的数据(实际可能更多,见 Q2)。如果原主节点是always,从节点是everysec,切换后可能丢失最近 1-2 秒的写入,对于一些金融场景可能不可接受。
生产建议:如果主节点用 always 保证数据安全,从节点也建议用 always(或至少 everysec),否则主从切换后会出现数据窗口丢失。更好的方案是使用 Redis 7.0+ 的 Multi-Part AOF + everysec,在性能和数据安全之间取得平衡,同时通过集群的同步复制(min-replicas-to-write)来保证多副本一致性,而不是单纯依赖 always 策略。
Q8:为什么 Redis 推荐关闭 Transparent Huge Pages(THP)?THP 对 BGSAVE 具体有什么影响?
THP 对 fork 操作有严重的负面影响:
- fork 延迟增加: 当 Redis 的数据使用了 THP(2MB 大页),fork 子进程时需要复制父进程的页表。对于 2MB 大页,内核需要先将其拆分为 512 个 4KB 的小页,再复制页表,这个过程非常耗时。对于 32GB 的 Redis 实例,如果大量使用 THP,fork 时间可能从几十毫秒暴增到几百毫秒甚至秒级。
- COW 内存放大: COW 的最小单位是内存页。如果使用 2MB 大页,即使只修改了 1 字节,整个 2MB 页都需要被复制,导致内存开销急剧膨胀。原本 4KB 的 COW 开销变成 2MB,放大了 512 倍。
- 内存碎片化: THP 的分配和拆分过程会导致内存碎片,进一步影响 Redis 的内存分配效率。
Redis 官方建议在启动脚本中执行 echo never > /sys/kernel/mm/transparent_hugepage/enabled,同时设置 echo never > /sys/kernel/mm/transparent_hugepage/defrag 关闭 THP 碎片整理。
Q9:设计一个方案:如何在保证 Redis 持久化数据安全的前提下,将 Redis 的写入吞吐量提升到 10 万 QPS?
这是一个系统设计题,需要从多个维度优化:
- 持久化策略: 使用 RDB + AOF 混合持久化,AOF 使用
everysec策略。核心思路是用 RDB 做全量快照、AOF 做增量补充,减少 AOF 文件大小和重写频率。 - I/O 分离: 将 AOF 文件和 RDB 文件写入不同的磁盘(SSD),避免 I/O 竞争。AOF 文件放在 NVMe SSD 上,降低 fsync 延迟。
- 主从分工: 主节点只负责处理读写请求,AOF 写入和 RDB 持久化放在从节点上执行。主节点可以关闭 AOF 或设为
no(不 fsync),从节点开启everysec。这样主节点的写入吞吐量不受持久化影响。 - 多实例部署: 在一台机器上部署多个 Redis 实例,每个实例负责一部分数据(分片),每个实例的写入量降低,从而降低整体持久化压力。
- Pipeline 批量写入: 客户端使用 Pipeline 批量发送命令,减少网络往返,但要注意 AOF 中每条命令仍然独立记录。
- AOF 重写优化: 设置
auto-aof-rewrite-percentage和auto-aof-rewrite-min-size为较大值,降低 AOF 重写频率。在低峰期手动触发BGREWRITEAOF。 - 使用 Redis 7.0+ Multi-Part AOF: 降低重写开销,提升恢复速度。
- 监控与兜底: 对
aof_delayed_fsync设置告警,如果出现延迟 fsync 说明 I/O 瓶颈,需要扩容或优化。
Q10:RDB 文件和 AOF 文件都存在磁盘上,但磁盘 I/O 负载已经很高。在不增加硬件的前提下,有哪些优化手段?
- 调整 BGSAVE 和 AOF 重写的时间窗口: 通过
cron定时在业务低峰期(如凌晨 3 点)手动触发BGSAVE和BGREWRITEAOF,避免与业务高峰的 I/O 竞争。 - 降低 RDB 频率: 增大
save配置的间隔和修改次数阈值,例如从save 900 1改为save 3600 1,让 RDB 更少触发。 - 增大 AOF 重写阈值: 将
auto-aof-rewrite-percentage设为 200% 甚至更高,auto-aof-rewrite-min-size设为 16GB 以上,减少重写频率。 - AOF 使用
**no**策略 + 从节点持久化: 主节点设appendfsync no(完全交给 OS 刷盘),在从节点上做everysec持久化。但需要接受主节点崩溃时可能丢失数据的风险。 - 关闭 AOF 仅用 RDB: 如果业务允许丢失数分钟的数据,可以关闭 AOF 只用 RDB,大幅降低 I/O 压力。
- 使用 I/O 调度器优化: 将磁盘 I/O 调度器从
cfq改为deadline或noop,减少 I/O 延迟。 - 文件系统优化: 使用
noatime挂载选项,减少元数据写入。对于 ext4,可以设置data=writeback降低 journal 开销。 - AOF 文件压缩: 定期对旧的 AOF 文件进行压缩(gzip),但注意恢复时需解压,会延长恢复时间。
- 使用
**ionice**限制子进程 I/O 优先级: 对 BGSAVE 和 AOF 重写的子进程使用ionice -c 2 -n 7降低 I/O 优先级,避免影响主进程。