阅读时间:约 45 分钟 | 难度:中高级 | 编号:131
一、引言:五种类型,十种编码
Redis 对外暴露的是 String、Hash、List、Set、ZSet 五种数据类型,但这只是"表面"。每种类型在底层都有 1-2 种不同的编码实现,Redis 会根据数据量大小和元素长度自动在编码之间切换,在内存效率和访问性能之间做权衡。
这正是 Redis 设计中最值得学习的部分:同一个对外接口,底层用不同的数据结构实现,并且能在运行时动态切换。不理解编码切换机制,就无法回答"为什么 Hash 存了 200 个字段后突然变慢""为什么小 Set 和大 Set 的内存占用差异巨大"这类问题。
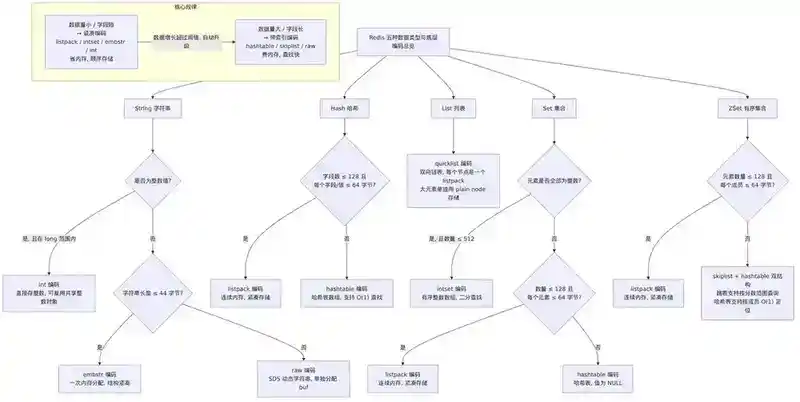
本文按"结构原理 → 编码转换 → 应用场景"的顺序,逐个拆解五种数据类型。
二、String:不只是字符串
2.1 SDS:简单动态字符串
Redis 没有直接用 C 语言的字符串(以 \0 结尾的 char 数组),而是自己实现了 SDS(Simple Dynamic String)。原因:
- C 字符串获取长度是 O(n),SDS 用
len字段记录长度,O(1) 获取 - C 字符串拼接容易缓冲区溢出,SDS 有
alloc记录已分配空间,自动检查扩容 - C 字符串不能保存二进制数据(
\0会被当作结束符),SDS 用len判断结束,可以存图片、序列化对象等任意二进制内容 - SDS 通过
flags区分 5 种头部类型(sdshdr5/8/16/32/64),根据字符串长度选择最小的头部结构,节省内存
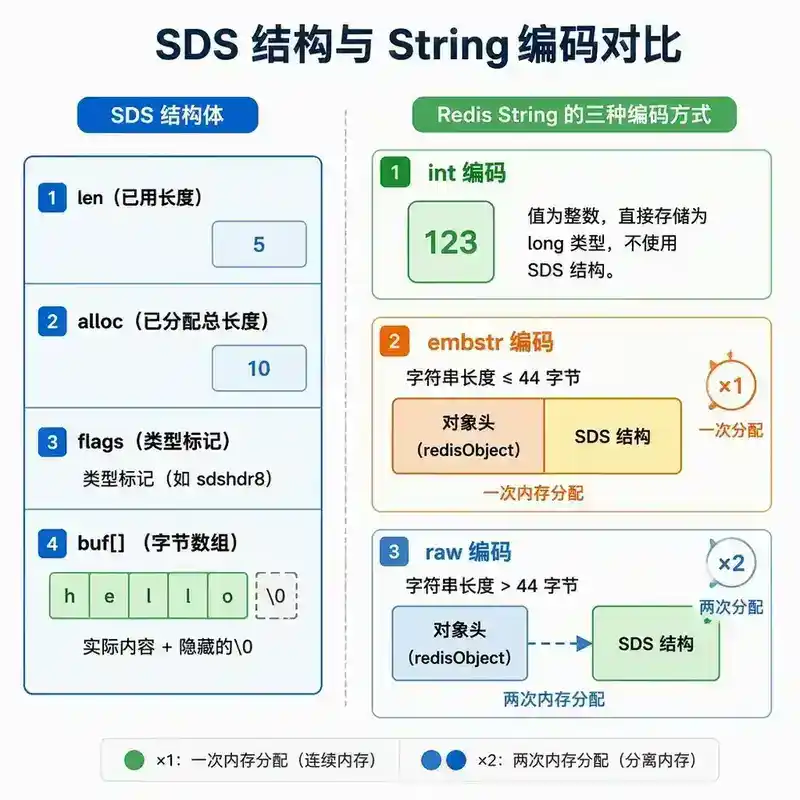
SDS 结构(以 sdshdr8 为例):
struct sdshdr8 {
    uint8_t len;        // 已用长度
    uint8_t alloc;      // 已分配总长度
    unsigned char flags;// 类型标记

    char buf[ ];          // 实际内容 + 末尾隐藏的 \0

}
2.2 三种内部编码
String 类型在 OBJECT ENCODING 命令下会显示三种编码之一:
| 编码 | 触发条件 | 说明 |
|---|---|---|
| int | 值是整数且能用 long 表示 | 直接存 long,不用 SDS,省内存 |
| embstr | 字符串长度 ≤ 44 字节 | embstr 是"嵌入式字符串",对象头和 SDS 内存一次分配,连续存储 |
| raw | 字符串长度 > 44 字节 | 对象头和 SDS 分开分配两块内存 |
embstr 和 raw 的区别核心在内存分配次数:embstr 一次 malloc 分配对象头+SDS,raw 需要两次分配。embstr 因此创建更快、内存更紧凑,但是不可修改(一旦追加内容超过阈值就会转成 raw)。44 字节的阈值来自 Redis 对象头(16 字节)和 SDS 头(3 字节)在 64 字节 jemalloc 分配单元下能容纳的最大字符串长度。
2.3 典型应用场景
- 缓存:直接
SET/GET,最基础的用法 - 计数器:
INCR/DECR是原子操作,天然支持高并发下的库存扣减、点赞数、访问计数 - 分布式锁:
SET key value NX EX seconds一条命令同时完成"不存在才设置"和"过期时间",是 Redis 分布式锁的基础 - Bitmap:本质是 String,但通过
SETBIT/GETBIT/BITCOUNT按位操作,用极小内存表示海量布尔状态(如用户签到、UV 统计) - 分布式 Session:存储序列化后的用户会话数据
三、Hash:字段化的对象存储
3.1 两种编码:listpack 与 hashtable
Hash 类型用来存储字段-值对的集合,类似一个小型的 KV 表。它有两种底层编码:
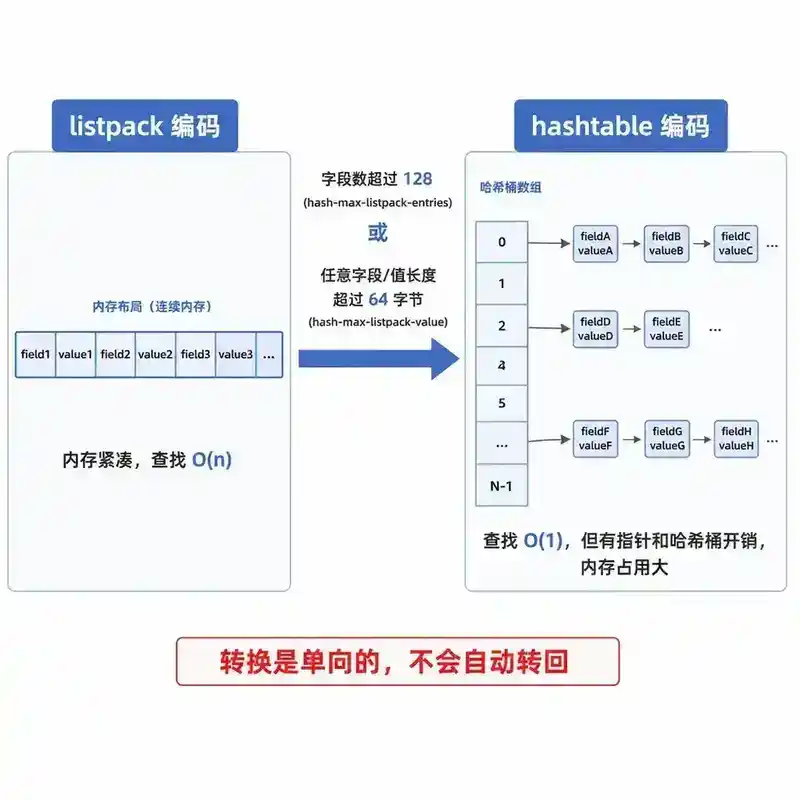
listpack(Redis 7.0 之前叫 ziplist):一段连续内存,每个字段和值紧凑排列,没有指针开销。适合字段数少、值不大的场景,内存利用率极高,但是查找需要遍历(O(n))。
hashtable:标准哈希表结构,数组 + 链表处理哈希冲突,查找是 O(1),但每个键值对都要额外的指针和哈希桶开销,内存占用大。
3.2 编码转换阈值
Redis 通过配置项控制转换时机:
hash-max-listpack-entries 128   # 字段数超过 128 转 hashtable
hash-max-listpack-value 64      # 任意字段或值长度超过 64 字节转 hashtable
只要触发任意一个条件,整个 Hash 就会从 listpack 一次性转换为 hashtable,转换是单向的——即使后续删除字段导致数量回落到阈值以下,也不会转回 listpack(除非重建)。这是一个常见的内存"陷阱":如果业务中曾经出现过一个字段特别长的记录,即使后来清空重设,这个 key 也会永远停留在 hashtable 编码,内存占用比同类 key 高很多。
3.3 典型应用场景
- 对象存储:用一个 Hash 存用户信息(
HSET user:1001 name "张三" age 28),比拆成多个 String key 更省内存,也支持部分字段更新 - 购物车:
HSET cart:1001 product:2001 2(商品 ID 为 field,数量为 value),天然支持增删改单个商品 - 计数器聚合:如按维度统计的 PV/UV,一个 Hash 存多个维度的计数,比多个 String key 减少 key 数量,降低 Redis 的 key 管理开销
四、List:消息队列的基石
4.1 从 ziplist/linkedlist 到 quicklist
List 的编码演进最能体现 Redis 的迭代思路:
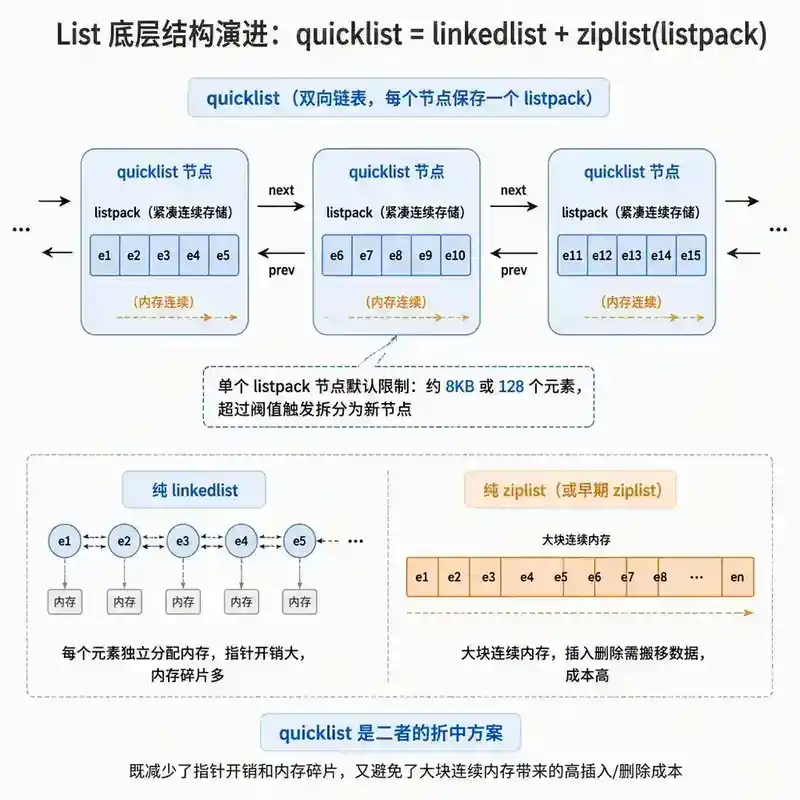
- 早期(❤️.2):元素少用 ziplist(连续内存),元素多或大用 linkedlist(双向链表,每个节点独立分配内存,有前后指针)
- 3.2 之后引入 quicklist:quicklist 是"双向链表 + 多个 ziplist 节点"的混合结构——外层是链表,链表的每个节点内部是一个 ziplist,存一小段连续的元素
- 7.0 之后:ziplist 被 listpack 取代(listpack 修复了 ziplist 级联更新的问题),quicklist 的节点变成 listpack
quicklist 这样设计的原因:纯 linkedlist 每个元素都要额外的指针开销(前后指针各 8 字节),内存浪费严重;纯 ziplist 在元素很多时,单次插入/删除的内存搬移成本高,而且一次性分配大块连续内存容易造成内存碎片。quicklist 把大列表拆成多个小 ziplist 节点,每个节点大小可控(默认 8KB 或 128 个元素触发拆分),既省内存又兼顾操作效率。
4.2 队列操作与阻塞
List 支持双端操作:LPUSH/RPUSH(头/尾插入)、LPOP/RPOP(头/尾弹出)。配合阻塞版本 BLPOP/BRPOP,可以实现简单的消费者阻塞等待,这是很多轻量级消息队列基于 Redis List 实现的原理。
4.3 典型应用场景
- 轻量级消息队列:
LPUSH生产,BRPOP消费,适合对可靠性要求不高、追求简单的场景(对比 Kafka/RocketMQ,Redis List 没有持久化保证、没有消费组、消息丢失风险高) - 时间线/最新动态:如朋友圈动态,
LPUSH插入新内容,LRANGE分页读取 - 最新日志/操作记录:保留最近 N 条记录,配合
LTRIM控制列表长度
五、Set:去重与集合运算
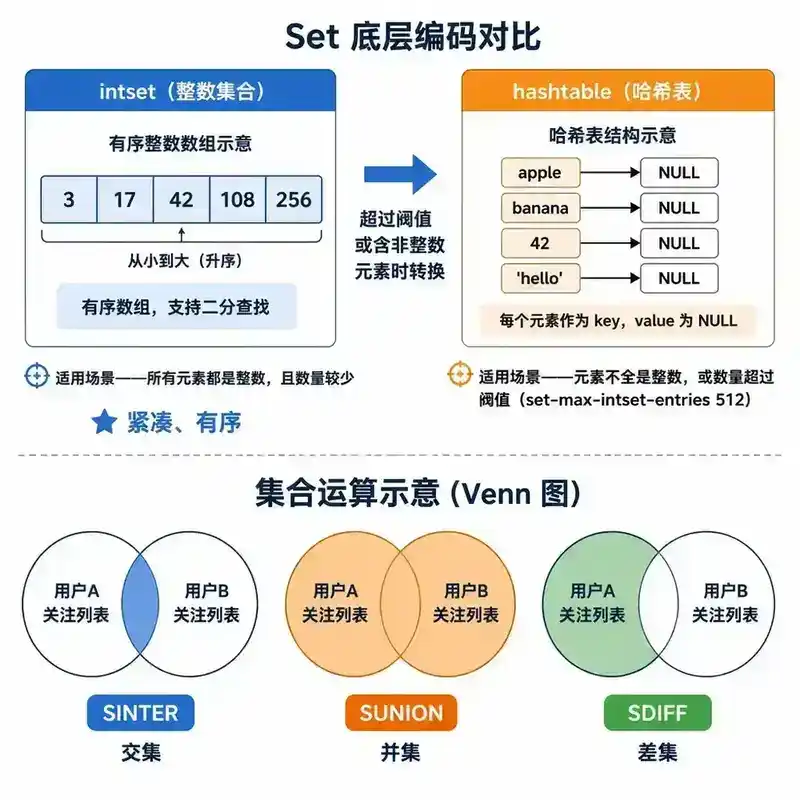
5.1 两种编码:intset 与 hashtable
Set 用于存储无序、不重复的元素集合,两种编码:
intset(整数集合):当集合中所有元素都是整数,且元素数量较少时使用。内部是一个有序的整数数组,支持二分查找,非常紧凑。
hashtable:当元素不全是整数,或数量超过阈值时,转为标准哈希表,每个元素作为 key,value 统一设为 null。
转换阈值:
set-max-intset-entries 512      # 整数个数超过 512 转 hashtable
set-max-listpack-entries 128    # 非纯整数场景,Redis 7.2+ 引入的 listpack 编码,字段数上限
set-max-listpack-value 64       # listpack 编码下单个元素长度上限
(说明:Redis 7.2 为小规模的非纯整数 Set 也引入了 listpack 编码,进一步节省内存;超出阈值同样转为 hashtable。)
5.2 集合运算
Set 最大的价值在于原生支持集合运算,这些操作在应用层实现代价很高,Redis 用一条命令完成:
SINTER:交集——如两个用户的共同关注SUNION:并集——如合并多个来源的标签SDIFF:差集——如推荐系统中"未浏览过的商品"
5.3 典型应用场景
- 标签系统:
SADD article:1001:tags "Redis" "数据库" "面试",天然去重 - 共同好友/共同关注:两个用户好友集合求交集
- UV 统计:
SADD用户 ID,SCARD获取去重后的独立访客数(数据量大时用 HyperLogLog 更省内存,牺牲精确度) - 抽奖/随机推荐:
SRANDMEMBER/SPOP随机取元素
六、ZSet:排行榜的标准答案
6.1 双结构:skiplist + hashtable
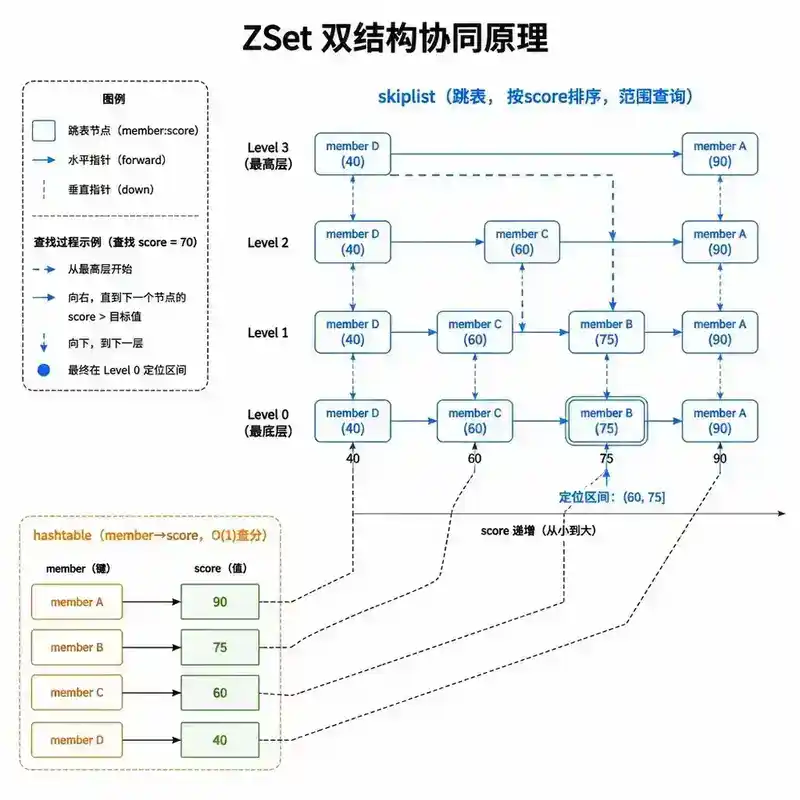
ZSet(有序集合)是五种类型中实现最复杂的一个。小数据量时用 listpack(同 Hash/Set 的压缩编码逻辑),数据量大时用一个双结构:
- hashtable:member → score 的映射,用于 O(1) 复杂度按成员查分数(
ZSCORE) - skiplist(跳表):按 score 排序的链表结构,用于范围查询(
ZRANGE)、排名查询(ZRANK)
这两个结构共享同一份元素数据(不重复存储),协同支撑 ZSet 的两类核心操作。
转换阈值:
zset-max-listpack-entries 128
zset-max-listpack-value 64
6.2 跳表原理
为什么用跳表而不是平衡树(如红黑树)实现有序结构?跳表的核心思想是"用空间换查询速度":
- 普通有序链表查找是 O(n)
- 跳表在链表基础上建立多级"索引层",每一层是下一层的子集(大约每 2 个节点抽取 1 个进入上一层)
- 查找时从最高层开始,逐层下降,类似二分查找,平均复杂度 O(log n)
选跳表而非红黑树的原因:
- 跳表实现简单,代码量远小于红黑树的旋转平衡逻辑,维护成本低
- 跳表天然支持范围查询(找到起点后沿链表顺序遍历即可),红黑树做范围查询需要中序遍历,代码更复杂
- 跳表的插入删除只需要修改局部指针,不需要像红黑树那样做树旋转,在高并发场景下锁粒度更小
6.3 典型应用场景
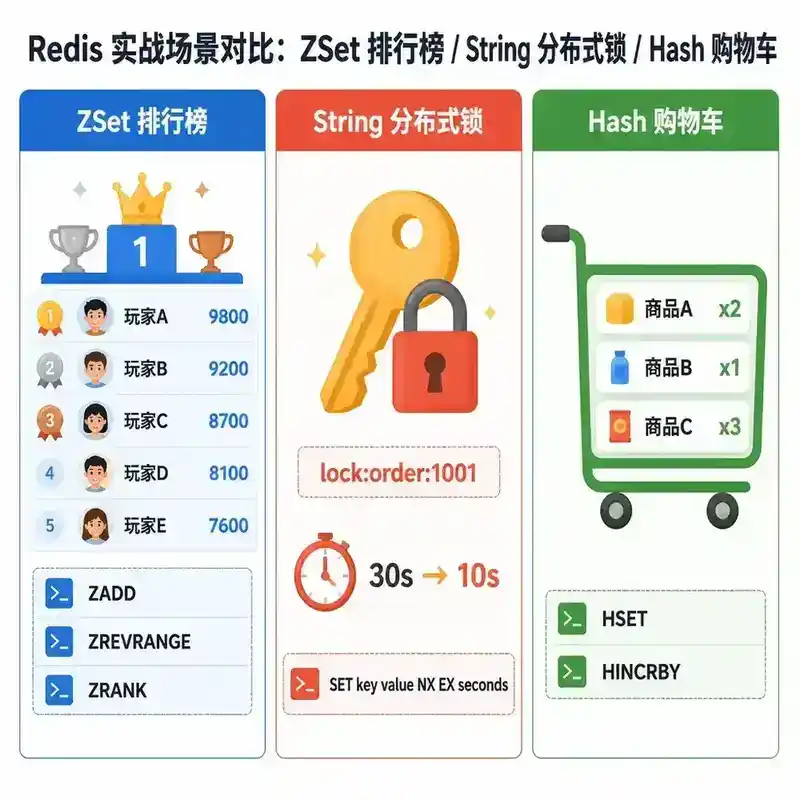
- 排行榜:
ZADD leaderboard 9500 "player1",ZREVRANGE leaderboard 0 99一条命令拿 Top 100,ZRANK查询任意玩家排名,MySQL 做实时排行榜需要ORDER BY+ 索引扫描,在高并发写入下代价远高于 ZSet - 延迟队列:用时间戳作为 score,
ZRANGEBYSCORE取出到期任务,实现简单的延迟任务调度 - 限流:滑动窗口限流算法,用请求时间作为 score,定期
ZREMRANGEBYSCORE清理窗口外的记录,ZCARD统计窗口内请求数
七、五种类型编码转换总表
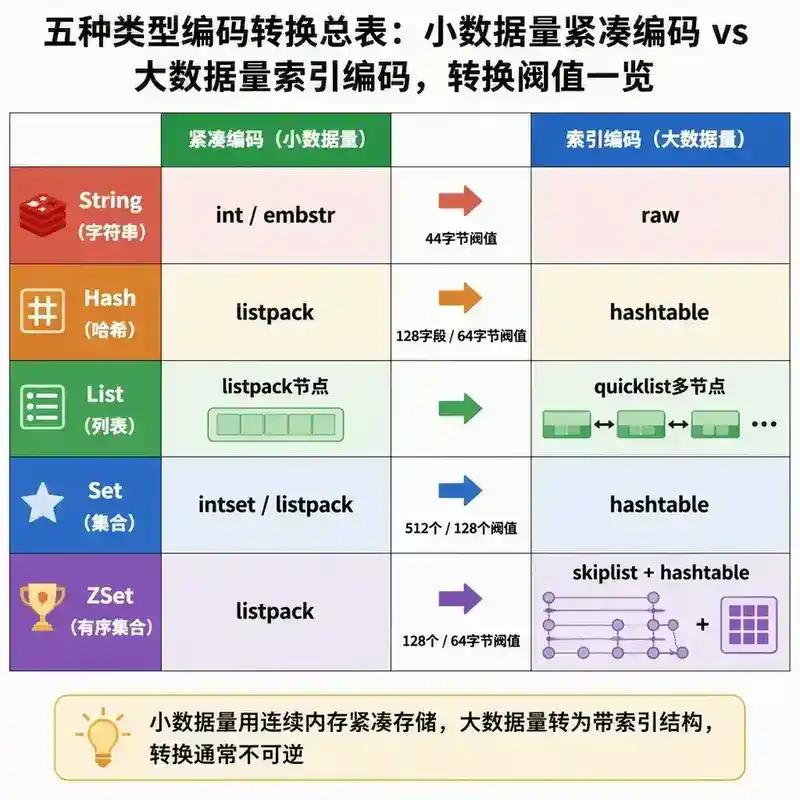
| 类型 | 编码 1(小) | 编码 2(大) | 关键配置项 |
|---|---|---|---|
| String | int / embstr | raw | 无阈值配置,长度 44 字节固定分界 |
| Hash | listpack | hashtable | hash-max-listpack-entries / value |
| List | listpack(quicklist 节点) | quicklist(多节点) | list-max-listpack-size |
| Set | intset / listpack | hashtable | set-max-intset-entries / listpack-entries |
| ZSet | listpack | skiplist + hashtable | zset-max-listpack-entries / value |
共同规律:小数据量用紧凑的连续内存结构(省内存,牺牲部分性能),大数据量转为带索引的结构(O(1) 或 O(log n) 访问,多占内存)。转换绝大多数是单向的,业务上要留意"曾经写入过大字段/大量元素"的 key 不会自动降级。
八、实战案例
案例一:如何用 ZSet 实现一个游戏排行榜
需求: 100 万玩家,实时更新分数,查询任意玩家的全球排名和 Top 100
方案:
ZADD rank:global <score> <player_id>       # 更新分数,O(log n)
ZREVRANGE rank:global 0 99 WITHSCORES       # 取 Top 100,O(log n + 100)
ZREVRANK rank:global <player_id>            # 查询排名,O(log n)
MySQL 实现同样功能需要在写入时维护排名(代价高),或每次查询时排序(性能差)。ZSet 的跳表结构让这两个操作都是对数复杂度,这是选择 Redis 而非关系型数据库做排行榜的根本原因。
案例二:为什么分布式锁要用 而不是先 再
问题: 如果用两条命令,SETNX 成功后进程在执行 EXPIRE 之前崩溃,锁就变成永久锁,其他线程永远拿不到锁。
方案:SET key value NX EX seconds 是原子命令,加锁和设置过期时间在一条命令内完成,不存在中间状态。这也说明了理解 String 底层机制之外,还要理解 Redis 命令的原子性边界。
案例三:购物车用 Hash 还是用 String 存 JSON
对比:
- String 存整个购物车的 JSON:每次改一个商品数量都要反序列化整个 JSON、修改、再序列化写回,网络传输和 CPU 开销大
- Hash 存每个商品为一个字段:
HINCRBY cart:1001 product:2001 1一条命令原子地修改单个商品数量,不影响其他字段,网络传输量小
结论: 字段需要独立更新的场景优先用 Hash;只需要整体读写、不需要单独修改字段的场景可以用 String 存 JSON(更省 key 数量,但更新成本高)。
九、总结速查卡
| 类型 | 核心结构 | 时间复杂度(典型操作) | 典型场景 |
|---|---|---|---|
| String | SDS | O(1) GET/SET | 缓存、计数器、分布式锁 |
| Hash | listpack/hashtable | O(1) HGET | 对象存储、购物车 |
| List | quicklist | O(1) 头尾操作 | 消息队列、时间线 |
| Set | intset/hashtable | O(1) 判存 | 标签、去重、集合运算 |
| ZSet | skiplist+hashtable | O(log n) | 排行榜、延迟队列、限流 |
一句话: Redis 的每种类型都不是"一种结构打天下",而是根据数据规模在多种编码间自动切换——理解这个切换机制,才能真正解释 Redis 的内存占用和性能表现。
十、面试官视角提问
Q1:一个 Hash 曾经写入过一个 10KB 的大字段,后来把这个字段删除了,但这个 key 的内存占用依然很高。为什么?你怎么排查和解决?
Q2:quicklist 为什么不直接用一个大的 ziplist/listpack,而要拆成"链表 + 多个小节点"?如果全部揉进一个连续内存块会有什么问题?
Q3:ZSet 的跳表和 hashtable 是两份独立数据还是共享数据?如果只保留 skiplist,去掉 hashtable,**ZSCORE**的复杂度会变成多少?为什么 Redis 要牺牲这部分内存做双结构?
Q4:Set 的 intset 编码在元素全是整数时使用,如果我先**SADD**一个字符串再删除它,Set 会不会自动转回 intset?为什么?
Q5:如果让你设计一个"新型 SDS",在现有的 int/embstr/raw 三种编码基础上,你会考虑增加什么编码来进一步优化内存?(提示:可以从字符串的具体内容特征,比如是否为 UUID、是否高度重复等角度思考)
Q6:Redis 单线程处理命令,但 quicklist/skiplist 等结构的插入删除都涉及指针操作,为什么单线程模型下还需要关注这些操作的时间复杂度?如果一个 ZSET 有 100 万个元素,一次**ZADD**可能带来什么风险?
作者注:本文为系列第 131 篇,「09 Redis 与缓存体系」分类的第一篇。上一篇(130)完成了「08 MySQL 与关系型数据库」分类的收尾,本篇开始进入缓存体系的原理拆解。