阅读时间:约 45 分钟 | 难度:进阶 | 适用:Java 技术专家、架构师面试准备
一、开篇:一个"反直觉"的性能奇迹
如果你问一个后端工程师"Redis 为什么快",最常见的回答是"因为它是单线程的"。这个回答流传如此之广,以至于很多人把它当成了 Redis 高性能的唯一原因。
但真相远比这个答案复杂——而且 Redis 6.0 之后,Redis 已经不是纯粹的单线程了。
本文将从源码级深度拆解 Redis 的线程模型演进:从经典的单线程事件循环,到 Redis 6.0 引入的 I/O 多线程,再到为什么命令执行始终是单线程的。同时回答那个最核心的问题:Redis 到底为什么这么快?
先给结论:Redis 的高性能是"内存操作 + 高效数据结构 + I/O 多路复用 + 单线程避免锁竞争"四重因素的叠加,单线程只是其中一环。理解 Redis 线程模型,本质上是理解"简单性"作为一种工程选择的智慧。
二、Redis 线程模型演进史
2.1 版本演进时间线
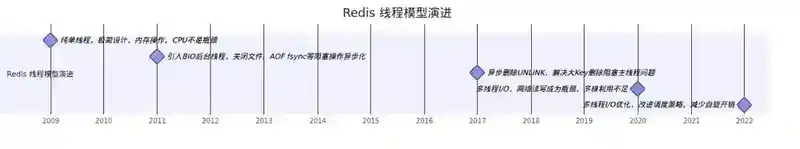
在深入技术细节之前,先梳理 Redis 线程模型的时间线,理解每个版本的设计决策背景:
| 版本 | 年份 | 线程模型变化 | 设计动机 |
|---|---|---|---|
| 1.0 | 2009 | 纯单线程 | 极简设计,内存操作,CPU 不是瓶颈 |
| 2.6 | 2011 | 引入 BIO 后台线程 | 关闭文件、AOF fsync 等阻塞操作异步化 |
| 4.0 | 2017 | 异步删除(UNLINK) | 解决大 Key 删除阻塞主线程问题 |
| 6.0 | 2020 | 多线程 I/O | 网络读写成为瓶颈,多核利用不足 |
| 7.0 | 2022 | 多线程 I/O 优化 | 改进调度策略,减少自旋开销 |
图 1:Redis 线程模型演进时间线——从单线程到多线程 I/O 的渐进式演进
2.2 设计哲学:为什么 Redis 如此"克制"?
Redis 的多线程演进与很多数据库形成了鲜明对比。MySQL 在 5.5 到 8.0 之间经历了巨大的线程模型重构,而 Redis 直到 6.0 才迈出第一步,且这一步走得极为克制——只在 I/O 层引入多线程。
这种克制源于 Redis 作者 antirez 的核心信念:
"We believe that simplicity is a feature, and we try to add features only when they are strictly necessary."
翻译过来就是:简单本身就是一种特性。每增加一个线程,就意味着增加调试难度、增加潜在 bug、增加用户的理解成本。如果单线程已经足够快,为什么要冒险?
2.3 与其他系统的线程模型对比
| 系统 | 线程模型 | 核心思路 |
|---|---|---|
| Redis | 单线程事件循环 + 可选多线程 I/O | 命令执行串行,I/O 可并行 |
| Nginx | 多进程 + 每个进程单线程事件循环 | 进程间无共享,各自独立 |
| Node.js | 单线程事件循环 + Worker Threads | 与 Redis 最相似,libuv 驱动 |
| Memcached | 多线程 + 全局锁 | 比 Redis 多线程更激进,但数据结构更简单 |
| MySQL | 每连接一线程(one-thread-per-connection) | 线程池模式,大量并发时上下文切换开销大 |
Nginx 和 Redis 都选择了基于事件循环的单线程模型,但动机不同:Nginx 是为了解决 C10K 问题(高并发连接),Redis 是为了避免数据结构锁竞争。
三、基础回顾:Redis 的经典单线程模型
3.1 什么叫"单线程"?
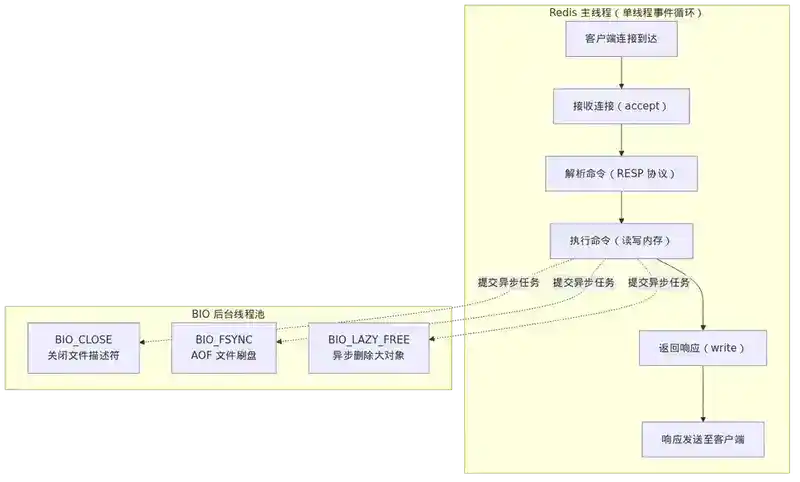
在 Redis 6.0 之前,Redis 的核心工作线程只有一个。这个线程负责:
- 接收客户端连接(accept)
- 解析客户端命令(RESP 协议解析)
- 执行命令(读写内存数据)
- 返回响应给客户端(write)
- 处理定时任务(过期键删除、AOF 重写触发、主从复制心跳等)
所有这些操作都在一个线程里,通过事件驱动的方式串行完成。
┌─────────────────────────────────────────────────────────────────┐
│                    Redis 主线程(单线程)                          │
│                                                                   │
│  ┌──────────┐  ┌──────────┐  ┌──────────────┐  ┌──────────┐    │
│  │ 接收连接  │→│ 解析命令  │→│ 执行命令(读写) │→│ 返回响应  │    │
│  │ accept() │  │  RESP    │  │ 内存操作      │  │ write()  │    │
│  └──────────┘  └──────────┘  └──────────────┘  └──────────┘    │
│                                                                   │
│  后台线程(BIO,非核心路径,不参与命令执行):                       │
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────┐           │
│  │ close 文件    │  │ AOF fsync    │  │ UNLINK 异步删除│          │
│  │ (BIO_CLOSE)  │  │ (BIO_FSYNC)  │  │ (BIO_LAZY)   │           │
│  └──────────────┘  └──────────────┘  └──────────────┘           │
└─────────────────────────────────────────────────────────────────┘
图 2:Redis 经典单线程模型总览——主线程负责全部业务逻辑,BIO 线程仅处理阻塞性系统调用
3.2 为什么选择单线程?
Redis 作者 antirez 在设计之初就明确了一个核心洞察:
Redis 的性能瓶颈不在 CPU,而在网络 I/O 和内存带宽。
基于这个判断,单线程有三个显著优势,每个都值得展开细说:
| 优势 | 详细说明 |
|---|---|
| 无锁竞争 | 不需要对任何数据结构加锁,没有死锁风险,没有上下文切换开销(每次切换约 1-5μs) |
| 代码简单 | 无并发控制逻辑,可维护性极高,调试成本低。Redis 核心代码只有约 3 万行 |
| 原子性保证 | 每个命令天然原子执行,不需要事务包装。INCR 就是原子操作,无需加锁 |
核心代码只有几万行,却能支撑每秒数十万次操作——这种简洁性和性能的组合,正是 Redis 设计哲学的精髓。
3.3 单线程模型的局限性
单线程模型也带来了明确的约束,理解这些约束是正确使用 Redis 的前提:
- 慢命令阻塞一切:
KEYS *、SMEMBERS大集合、SORT等 O(N) 命令会阻塞所有其他请求 - CPU 单核瓶颈:单线程只能跑满一个 CPU 核心,多核服务器无法充分利用
- 大 Value 读写:一个 10MB 的 value 的
GET/SET会长时间占用主线程
四、深入核心:Redis 事件循环(aeEventLoop)
Redis 的事件循环是整个系统的"心脏"。理解它,就理解了 Redis 单线程模型的全部秘密。事件循环的实现位于 ae.c(约 500 行),是 Redis 中最精妙的代码之一。
4.1 aeEventLoop 数据结构
typedef struct aeEventLoop {
    int maxfd;                  // 当前注册的最大文件描述符(用于 epoll 边界判断)
    int setsize;                // 最大可监听的文件描述符数(默认 10128,即 maxclients + 128)
    long long timeEventNextId;  // 下一个时间事件的 ID(自增)
    aeFileEvent *events;        // 已注册的文件事件数组,下标为 fd
    aeFiredEvent *fired;        // 已触发的文件事件数组(epoll_wait 的结果)
    aeTimeEvent *timeEventHead; // 时间事件双向链表头
    int stop;                   // 事件循环停止标志
    void *apidata;              // 多路复用库的私有数据(epoll fd / kqueue fd 等)
    aeBeforeSleepProc *beforesleep; // 每次进入 epoll_wait 前的回调
    aeBeforeSleepProc *aftersleep;  // 每次 epoll_wait 返回后的回调
    int flags;                  // 标志位
} aeEventLoop;
关键设计点:
events数组按 fd 下标直接索引,O(1) 查找文件事件timeEventHead是双向链表(不是时间轮),因为时间事件数量极少(通常不到 10 个)apidata是抽象层,将 epoll/kqueue/select 的实现细节封装在平台相关代码中
4.2 事件循环主流程
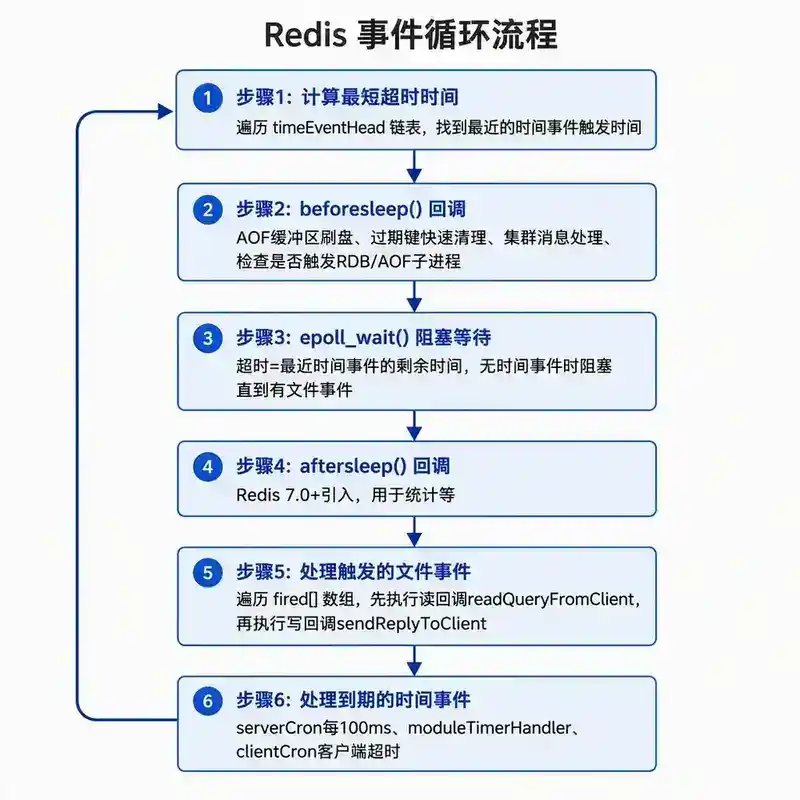
事件循环的入口函数 aeMain() 极其简洁:
void aeMain(aeEventLoop *eventLoop) {
    eventLoop->stop = 0;
    while (!eventLoop->stop) {
        aeProcessEvents(eventLoop, AE_ALL_EVENTS|
                                   AE_CALL_BEFORE_SLEEP|
                                   AE_CALL_AFTER_SLEEP);
    }
}
aeProcessEvents 的核心逻辑(简化版):
int aeProcessEvents(aeEventLoop *eventLoop, int flags) {
    int processed = 0;

    // 1. 找到最近的时间事件,计算最短睡眠时间
    long long shortest = getShortestTimeEvent(eventLoop);
    long long ms_until_timer = shortest - now_ms();

    // 2. 如果没有任何事件(闲时),阻塞等待
    if (ms_until_timer > 0) {
        tvp.tv_sec = ms_until_timer / 1000;
        tvp.tv_usec = (ms_until_timer % 1000) * 1000;
    } else {
        tvp.tv_sec = 0;
        tvp.tv_usec = 0;  // 不阻塞,立即返回
    }

    // 3. beforesleep 回调
    if (flags & AE_CALL_BEFORE_SLEEP)
        eventLoop->beforesleep(eventLoop);

    // 4. 等待文件事件
    numevents = aeApiPoll(eventLoop, &tvp);

    // 5. aftersleep 回调
    if (flags & AE_CALL_AFTER_SLEEP)
        eventLoop->aftersleep(eventLoop);

    // 6. 处理触发的文件事件
    for (int j = 0; j < numevents; j++) {
        aeFileEvent *fe = &eventLoop->events[eventLoop->fired[j].fd];
        int mask = eventLoop->fired[j].mask;
        int fd = eventLoop->fired[j].fd;

        // 先处理读事件,再处理写事件
        if (fe->mask & mask & AE_READABLE)
            fe->rfileProc(eventLoop, fd, fe->clientData, mask);
        if (fe->mask & mask & AE_WRITABLE)
            fe->wfileProc(eventLoop, fd, fe->clientData, mask);
        processed++;
    }

    // 7. 处理到期的时间事件
    if (flags & AE_TIME_EVENTS)
        processed += processTimeEvents(eventLoop);

    return processed;
}
     ┌──────────────────────────────────┐
     │        aeMain() 无限循环           │
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  1. 计算最短超时时间               │
     │     遍历 timeEventHead 链表        │
     │     找到最近的时间事件触发时间       │
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  2. beforesleep() 回调             │
     │     · AOF 缓冲区刷盘               │
     │     · 过期键快速清理 (active-expire)│
     │     · 集群消息处理                  │
     │     · 检查是否需要触发 RDB/AOF 子进程│
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  3. epoll_wait() 阻塞等待          │
     │     超时 = 最近时间事件的剩余时间     │
     │     无时间事件时:阻塞直到有文件事件   │
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  4. aftersleep() 回调             │
     │     (Redis 7.0+ 引入,用于统计等)   │
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  5. 处理触发的文件事件              │

     │     遍历 fired[ ] 数组              │

     │     先执行 rfileProc(读回调)      │
     │     再执行 wfileProc(写回调)      │
     │     ┌──────────────────────┐      │
     │     │ 读回调:readQueryFrom  │      │
     │     │  Client()             │      │
     │     │  → read() 读取数据     │      │
     │     │  → processInputBuf()  │      │
     │     │  → call() 执行命令    │      │
     │     │  → 注册写事件          │      │
     │     └──────────────────────┘      │
     │     ┌──────────────────────┐      │
     │     │ 写回调:sendReplyTo   │      │
     │     │  Client()             │      │
     │     │  → write() 发送响应    │      │
     │     │  → 发送完毕则移除写事件  │      │
     │     └──────────────────────┘      │
     └──────────────┬───────────────────┘
                    │
                    ▼
     ┌──────────────────────────────────┐
     │  6. 处理到期的时间事件              │
     │     遍历 timeEventHead 链表        │
     │     执行 timeProc 回调             │
     │     · serverCron (每 100ms)       │
     │     · moduleTimerHandler          │
     │     · clientCron (客户端超时)       │
     └──────────────┬───────────────────┘
                    │
                    ▼
              (回到步骤 1)
> **图 3**:Redis 事件循环的完整执行流程——6 个步骤构成了 Redis 的运行心跳
4.3 两类事件详解
文件事件(File Event):基于 I/O 多路复用,监听 socket 的可读/可写状态。
typedef struct aeFileEvent {
    int mask;                  // AE_READABLE(1) | AE_WRITABLE(2) | AE_BARRIER(4)
    aeFileProc *rfileProc;    // 可读回调(readQueryFromClient)
    aeFileProc *wfileProc;    // 可写回调(sendReplyToClient)
    void *clientData;         // 指向 client 结构体
} aeFileEvent;
AE_BARRIER 是 Redis 7.0 引入的新标志,用于反转读写处理顺序:正常情况下先读后写,但某些场景下(如主从复制中,从节点的写入缓冲区已满),需要先写(清空缓冲区)再读(接收新数据),避免死锁。
时间事件(Time Event):基于单调时钟(monotonic clock),在指定时间点执行。
typedef struct aeTimeEvent {
    long long id;              // 事件 ID(自增)
    monotime when;             // 触发时间戳(毫秒级单调时钟)
    aeTimeProc *timeProc;      // 回调函数,返回下次触发的毫秒间隔
    aeEventFinalizerProc *finalizerProc; // 清理回调(删除事件时调用)
    void *clientData;
    struct aeTimeEvent *prev;  // 双向链表
    struct aeTimeEvent *next;
} aeTimeEvent;
serverCron() 是最重要的周期性时间事件,它通过返回值 1000/server.hz 来控制执行频率。hz 默认 10,即每 100ms 执行一次。可配置 hz 100 来提升精度(但会增加 CPU 开销)。serverCron 负责:
- 过期键的惰性删除(ACTIVE_EXPIRE_CYCLE_SLOW)和定期删除(ACTIVE_EXPIRE_CYCLE_FAST)
- 检查 AOF 重写和 RDB 保存的触发条件
- 主从复制的重连和同步
- 集群的 Gossip 通信(PING/PONG/FAIL)
- 客户端超时断开(timeout 配置)
- 内存碎片整理(activedefrag)
- 渐进式 rehash 的步进
4.4 事件分发的优先级与饥饿防护
在一次事件循环中,文件事件的优先级高于时间事件。但 Redis 做了饥饿防护:
// aeProcessEvents 中的饥饿防护逻辑
int maxIterations = 1024*1024;  // 防止无限循环
while (numevents--) {
    // 处理文件事件...
    if (--maxIterations == 0) break;  // 安全阀
}
此外,aeProcessEvents 还有一个 AE_DONT_WAIT 标志,当设置为该标志时,epoll_wait 不会阻塞。这在 beforesleep 回调中有时会用到——Redis 可能在处理完一个客户端请求后,立即触发一轮不阻塞的事件循环,快速处理已经就绪的更多事件。
4.5 零拷贝在事件循环中的体现
在写事件的处理中,Redis 使用 writev() 系统调用实现零拷贝写:
// networking.c 中的简化逻辑
ssize_t _writevToClient(client *c, struct iovec *iov, int iovcnt) {
    ssize_t nwritten = 0;
    while (nwritten < totlen) {
        nwritten = writev(c->fd, iov, iovcnt);
        // writev 将多个不连续的缓冲区一次性写入 socket
        // 避免了将多个缓冲区拼接成一个大缓冲区的拷贝操作
    }
}
writev 允许 Redis 将响应头和响应体(它们可能位于不同的内存区域)一次性写入 socket,减少了一次内存拷贝和一次系统调用。
五、I/O 多路复用:单线程处理万级并发的秘密
5.1 多路复用的本质
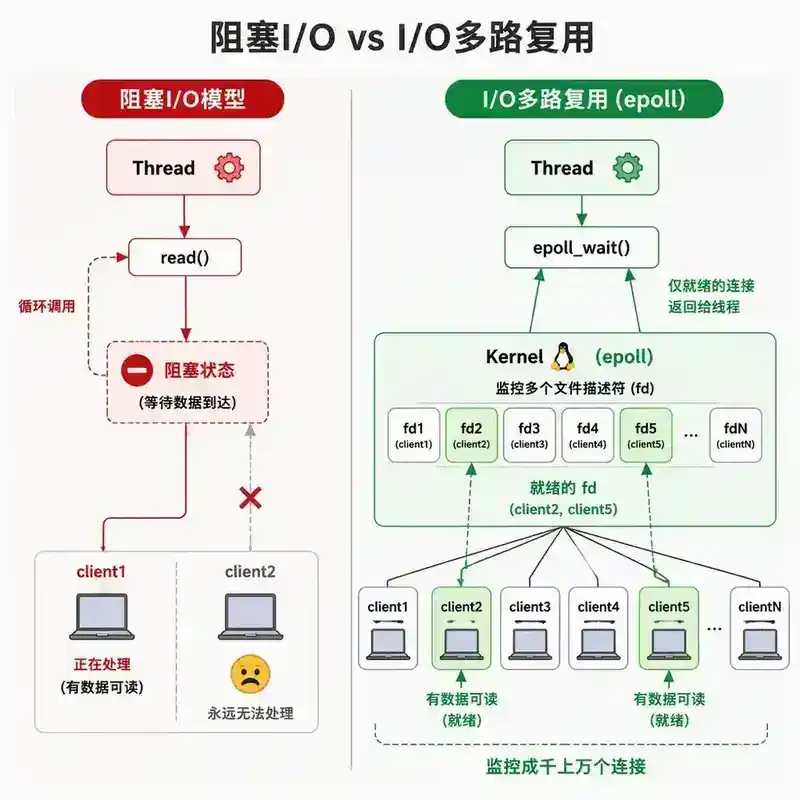
如果没有 I/O 多路复用,一个单线程服务器如何同时处理多个客户端连接?三种方案对比:
方案 A(阻塞 I/O):read() 阻塞等待一个客户端的数据,其他客户端全部饿死。
方案 B(非阻塞轮询):不断对所有 socket 调用 read(),大部分返回 -1(EAGAIN),CPU 100% 空转。
方案 C(多路复用):把多个 socket 的监听任务交给内核,内核通知哪个 socket 可读/可写,然后只处理那些就绪的。
        方案 A:阻塞 I/O                      方案 C:多路复用
   ┌──────────┐                         ┌──────────┐
   │  read()  │ 阻塞等待                  │epoll_wait│ 等待任意就绪
   │  client1 │────────────────         │          │
   └──────────┘                         └────┬─────┘
         │  client2 被饿死                     │
         ▼                                    ▼
   (永远不会处理 client2)              ┌───────┴───────┐
                                      │ 只处理就绪的 fd │
                                      │ client2,client5│
                                      └───────────────┘
图 4:阻塞 I/O vs I/O 多路复用的对比——多路复用让单线程能同时监控成千上万个连接
5.2 select / poll / epoll 的深度对比
Redis 在 Linux 上默认使用 epoll,但也支持 select 和 kqueue(macOS)。深入理解三者差异是面试高频考点。
| 特性 | select | poll | epoll |
|---|---|---|---|
| 数据结构 | 固定大小 fd_set(默认 1024) | 动态 pollfd 数组 | 红黑树 + 就绪链表 |
| fd 数量限制 | 1024(可重编译内核) | 无限制 | 无限制(受系统 fd 上限约束) |
| 内核态→用户态拷贝 | 每次全量拷贝 | 每次全量拷贝 | 只拷贝就绪 fd |
| 遍历方式 | O(n) 全量遍历 | O(n) 全量遍历 | O(1) 只遍历就绪的 |
| 触发模式 | 水平触发 | 水平触发 | 水平触发 + 边缘触发 |
| fd 增删开销 | O(1) 修改位图 | O(1) 修改数组 | O(log n) 红黑树增删 |
| 适用场景 | fd 总数小(< 100) | fd 总数中等 | fd 总数大(> 1000),大部分不活跃 |
epoll 的核心优势在于"事件通知"而非"状态查询":
- epoll_create:内核创建一个 eventpoll 对象,包含一棵红黑树(存储所有注册的 fd)和一个就绪链表
- epoll_ctl:向红黑树中插入/修改/删除 fd,同时向内核驱动注册回调函数
- epoll_wait:内核直接返回就绪链表中的 fd,无需遍历
关键是:当数据到达网卡时,内核通过 DMA 将数据写入内存,触发中断,中断处理程序中调用 epoll 的回调函数,将 fd 加入就绪链表。整个过程是中断驱动的,不需要用户态轮询。
5.3 水平触发 vs 边缘触发——Redis 为什么用水平触发?
- 水平触发(LT):只要 fd 可读/可写,每次 epoll_wait 都会返回该 fd
- 边缘触发(ET):只在新数据到达或状态从不可读变为可读时通知一次
Redis 选择水平触发,原因很简单:
- 编程简单:不需要一次性读完所有数据,可以分多次读
- 兼容管道:Redis 的 RESP 协议是基于文本行的,适合分批读取
- 健壮性:如果某次读取不完整,下次 epoll_wait 会再次通知,不会丢失事件
边缘触发在 Nginx 中被广泛使用,配合非阻塞 I/O 和循环读取,能减少 epoll_wait 的调用次数,但编程复杂度更高。
5.4 Redis 中的 epoll 封装
Redis 将多路复用封装成统一的 API,在 Linux 上底层使用 epoll:
// ae_epoll.c 中的核心封装

// 创建 epoll 实例
static int aeApiCreate(aeEventLoop *eventLoop) {
    aeApiState *state = zmalloc(sizeof(aeApiState));
    state->epfd = epoll_create(1024);  // 初始大小 1024,内核会动态扩容
    eventLoop->apidata = state;
    return 0;
}

// 注册 fd 事件(ADD 或 MOD)
static int aeApiAddEvent(aeEventLoop *eventLoop, int fd, int mask) {
    aeApiState *state = eventLoop->apidata;
    struct epoll_event ee = {0};
    int op = eventLoop->events[fd].mask == AE_NONE
             ? EPOLL_CTL_ADD : EPOLL_CTL_MOD;
    ee.events = 0;
    mask |= eventLoop->events[fd].mask;  // 合并新旧 mask
    if (mask & AE_READABLE) ee.events |= EPOLLIN;
    if (mask & AE_WRITABLE) ee.events |= EPOLLOUT;
    ee.data.fd = fd;
    epoll_ctl(state->epfd, op, fd, &ee);
    return 0;
}

// 删除 fd 事件
static void aeApiDelEvent(aeEventLoop *eventLoop, int fd, int delmask) {
    aeApiState *state = eventLoop->apidata;
    struct epoll_event ee = {0};
    int mask = eventLoop->events[fd].mask & (~delmask);
    ee.events = 0;
    if (mask & AE_READABLE) ee.events |= EPOLLIN;
    if (mask & AE_WRITABLE) ee.events |= EPOLLOUT;
    ee.data.fd = fd;
    if (mask != AE_NONE) {
        epoll_ctl(state->epfd, EPOLL_CTL_MOD, fd, &ee);
    } else {
        epoll_ctl(state->epfd, EPOLL_CTL_DEL, fd, &ee);
    }
}

// 等待事件
static int aeApiPoll(aeEventLoop *eventLoop, struct timeval *tvp) {
    aeApiState *state = eventLoop->apidata;
    int retval = epoll_wait(state->epfd, state->events, eventLoop->setsize,
                            tvp ? (tvp->tv_sec*1000 + tvp->tv_usec/1000) : -1);
    for (int j = 0; j < retval; j++) {
        int mask = 0;
        if (state->events[j].events & EPOLLIN)  mask |= AE_READABLE;
        if (state->events[j].events & EPOLLOUT) mask |= AE_WRITABLE;
        if (state->events[j].events & EPOLLERR) mask |= AE_WRITABLE;  // 错误也当作可写处理
        if (state->events[j].events & EPOLLHUP) mask |= AE_WRITABLE;  // 挂起也当作可写处理
        eventLoop->fired[j].fd = state->events[j].data.fd;
        eventLoop->fired[j].mask = mask;
    }
    return retval;
}
注意:EPOLLERR 和 EPOLLHUP 被映射为 AE_WRITABLE——这样写回调能够检测到连接错误并执行清理,是一个巧妙的设计。
5.5 一个完整的请求处理链路(从网络包到响应)
当客户端发送 GET user:1001 时,从事件循环视角看发生了什么:
- TCP 数据到达:内核协议栈处理 TCP 报文,数据写入 socket 接收缓冲区
- epoll 通知:epoll 就绪链表中加入该 fd
- epoll_wait 返回:
fired[0] = {fd=5, mask=AE_READABLE} - 触发读事件回调
readQueryFromClient():- 调用
read(fd, buf, 16384)从 socket 读取数据到客户端缓冲区(每次最多 16KB) - 调用
processInputBuffer()解析 RESP 协议 - 使用
processMultibulkBuffer()解析出GET和user:1001
- 调用
- 调用命令执行
call(c, CMD_CALL_FULL):- 查找命令表
server.commands,找到getCommand - 调用
getGenericCommand(c),从全局 dictserver.db[0].dict中查找键user:1001 - 找到对应的
robj对象,写入客户端的输出缓冲区
- 查找命令表
- 注册写事件:
aeCreateFileEvent(el, fd, AE_WRITABLE, sendReplyToClient, c) - 下一次 epoll_wait 返回:socket 变为可写
- 触发写事件回调
sendReplyToClient():- 调用
writev(fd, iov, iovcnt)将响应数据发送给客户端 - 数据发送完毕,
aeDeleteFileEvent(el, fd, AE_WRITABLE)移除写事件
- 调用
关键点:整个过程中,主线程"忙"的时间极短——大部分时间数据在内存中操作,每次 read()/write() 调用通常只需要几微秒。真正占用时间的是 epoll_wait 的阻塞等待,但那是"等待"而非"计算"。
六、Redis 6.0 多线程 I/O:单线程模型的进化
6.1 为什么需要多线程?
Redis 的单线程模型在绝大部分场景下足够快,但有一个明显的瓶颈:
当 QPS 达到 10 万级别时,网络 I/O(读写 socket)本身消耗了大量 CPU 时间。
具体来说,瓶颈出现在三个维度:
- 协议解析:RESP 协议的解析是纯 CPU 操作,大 value 的解析尤其消耗 CPU
- 网络读写:
read()和write()系统调用本身有开销,每次调用涉及用户态/内核态切换 - 多核利用不足:现代服务器通常有 16-64 核,但单线程 Redis 只能跑满一个核心
Redis 作者 antirez 的 benchmark 数据:
| 场景 | QPS | CPU 利用率 | 瓶颈 |
|---|---|---|---|
| Pipeline(64 条命令/次) | ~100 万 | 100% (单核) | CPU |
| 普通请求(无 Pipeline) | ~10 万 | 100% (单核) | 网络 I/O |
pipelining 场景下能跑到 100 万 QPS,说明 Redis 的命令执行本身不是瓶颈。普通请求只能跑到 10 万 QPS,说明瓶颈是单个线程处理网络读写的能力。
6.2 多线程 I/O 的架构设计
Redis 6.0 引入的多线程 I/O 设计非常克制——只在网络读写阶段使用多线程,命令执行仍然是单线程的。
                     Redis 6.0 多线程 I/O 架构

  ┌──────────────────────────────────────────────────────────────┐
  │                      主线程(事件循环)                         │
  │                                                              │
  │  ┌─────────┐   ┌─────────┐   ┌──────────┐   ┌───────────┐  │
  │  │epoll    │   │分配客户端│   │执行命令   │   │分配客户端  │  │
  │  │收集就绪  │→  │到 I/O   │→  │(单线程)   │→  │到 I/O     │  │
  │  │连接     │   │线程读   │   │           │   │线程写     │  │
  │  └─────────┘   └────┬────┘   └──────────┘   └────┬──────┘  │
  │                     │                             │          │
  └─────────────────────┼─────────────────────────────┼──────────┘
                        │                             │
         ┌──────────────┼──────────────┐              │
         │              │              │              │
         ▼              ▼              ▼              ▼
   ┌──────────┐  ┌──────────┐  ┌──────────┐  ┌──────────┐
   │ I/O线程1  │  │ I/O线程2  │  │ I/O线程3  │  │ I/O线程4  │
   │          │  │          │  │          │  │          │
   │ read()   │  │ read()   │  │ read()   │  │ write()  │
   │ 解析协议  │  │ 解析协议  │  │ 解析协议  │  │ 发送响应  │
   └──────────┘  └──────────┘  └──────────┘  └──────────┘
图 5:Redis 6.0 多线程 I/O 架构——主线程负责事件循环和命令执行,I/O 线程仅在读/写阶段并行工作
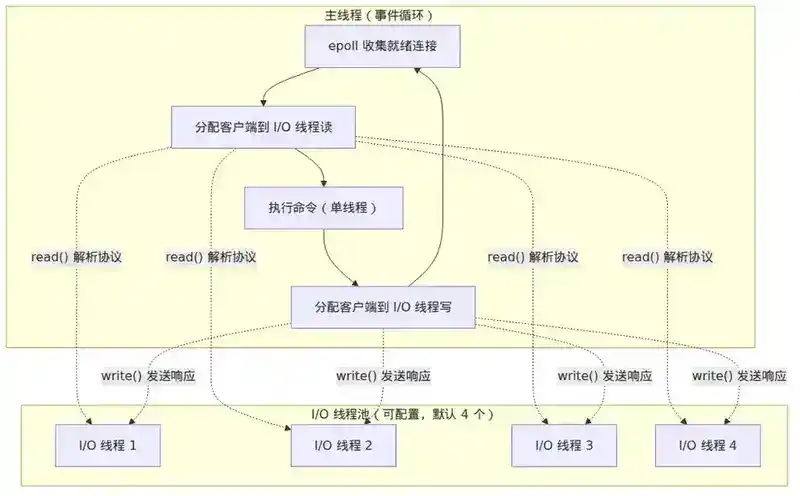
6.3 配置与源码分析
多线程 I/O 通过 io-threads 配置开启:
# redis.conf
io-threads 4               # I/O 线程数(包含主线程,所以实际子线程数 = 4-1 = 3)
io-threads-do-reads yes     # 是否在读阶段也使用多线程(默认 yes,写阶段始终多线程)
建议:4 核以下设为 2-3,4-8 核设为 4-6,不要超过 8。超过 8 个线程时,自旋同步的开销会超过并行收益。
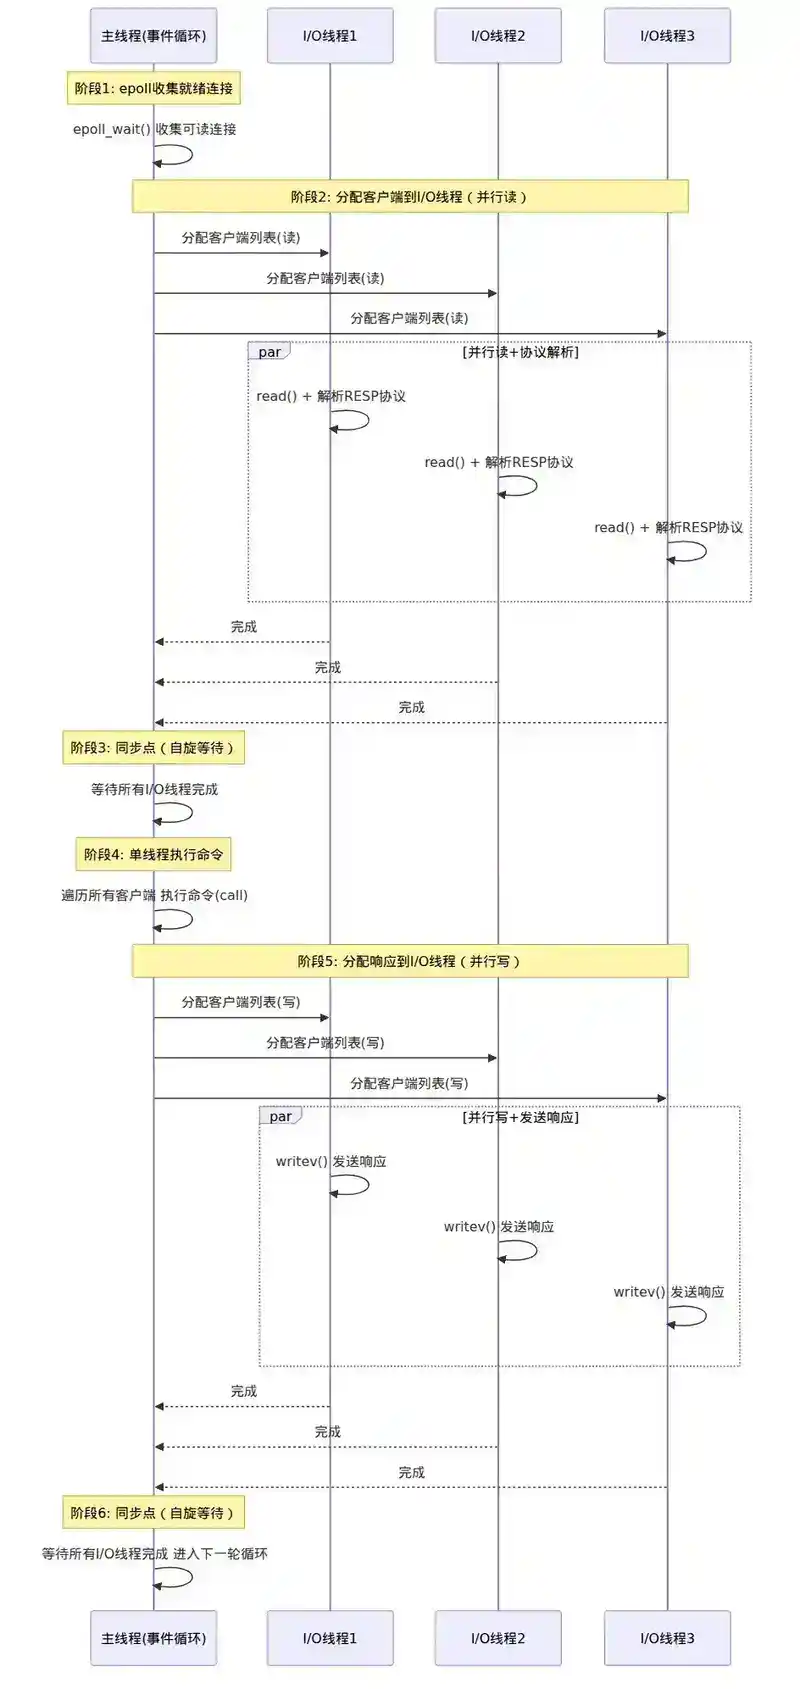
核心实现在 networking.c 中。写阶段入口 handleClientsWithPendingWritesUsingThreads():
int handleClientsWithPendingWritesUsingThreads(void) {
    // 如果待写客户端数量少于 I/O 线程数的 2 倍,直接用单线程写
    // 避免线程调度的开销大于并行收益
    if (server.clients_pending_write < server.io_threads_num * 2) {
        return handleClientsWithPendingWrites();  // 回退到单线程
    }

    // 1. 主线程将待写客户端均匀分配到各 I/O 线程
    listIter li;
    listNode *ln;
    int item_id = 0;
    listRewind(server.clients_pending_write, &li);
    while ((ln = listNext(&li)) != NULL) {
        client *c = listNodeValue(ln);
        int target_id = item_id % server.io_threads_num;
        listAddNodeTail(io_threads_list[target_id], c);
        item_id++;
    }

    // 2. 设置 I/O 线程的待处理数量,唤醒它们
    io_threads_op = IO_THREADS_OP_WRITE;
    for (int j = 1; j < server.io_threads_num; j++)
        io_threads_pending[j] = listLength(io_threads_list[j]);

    // 3. 主线程也处理自己的一份(id=0)
    listRewind(io_threads_list[0], &li);
    while ((ln = listNext(&li)) != NULL) {
        client *c = listNodeValue(ln);
        writeToClient(c, 0);
    }

    // 4. 自旋等待所有 I/O 线程完成
    while (1) {
        unsigned long pending = 0;
        for (int j = 1; j < server.io_threads_num; j++)
            pending += io_threads_pending[j];
        if (pending == 0) break;
    }

    // 5. 清理
    listRewind(server.clients_pending_write, &li);
    while ((ln = listNext(&li)) != NULL) {
        client *c = listNodeValue(ln);
        // 检查是否还有未发送完的数据,重新加入待写队列
        if (clientHasPendingReplies(c)) {
            installClientWriteHandler(c);
        }
    }
    listEmpty(server.clients_pending_write);
    return 1;
}
I/O 线程的主函数 IOThreadMain() 是一个自旋等待循环:
void *IOThreadMain(void *myid) {
    long id = (unsigned long)myid;
    while (1) {
        // 自旋等待主线程分配任务(忙等待 100 万次)
        for (int j = 0; j < 1000000; j++) {
            if (io_threads_pending[id] != 0) break;
        }
        if (io_threads_pending[id] == 0) {
            // 长时间无任务则休眠(通过互斥锁 + 条件变量等待)
            pthread_mutex_lock(&io_threads_mutex[id]);
            pthread_mutex_unlock(&io_threads_mutex[id]);
            continue;
        }

        // 处理分配给自己的客户端列表
        listIter li;
        listNode *ln;
        listRewind(io_threads_list[id], &li);
        while ((ln = listNext(&li)) != NULL) {
            client *c = listNodeValue(ln);
            if (io_threads_op == IO_THREADS_OP_WRITE) {
                writeToClient(c, 0);
            } else if (io_threads_op == IO_THREADS_OP_READ) {
                readQueryFromClient(c->conn);
            }
        }
        listEmpty(io_threads_list[id]);
        io_threads_pending[id] = 0;  // 通知主线程本线程完成
    }
}
6.4 读阶段与写阶段的详细时序
  时间线:
  ────────────────────────────────────────────────────────────→

  主线程:  [epoll]  [分配]  [等待]  [执行命令]  [分配]  [等待]
                        │                         │
  I/O线程1:          [read]                    [write]
  I/O线程2:          [read]                    [write]
  I/O线程3:          [read]                    [write]

  阶段:    收集就绪   并行读    同步点   单线程执行   并行写   同步点
图 6:主线程与 I/O 线程的交互时序——读阶段并行、执行阶段单线程、写阶段并行
读阶段(Read Phase):
- 主线程通过 epoll_wait 收集所有就绪的可读连接
- 将连接均匀分配到各 I/O 线程(Round-Robin 分配)
- 每个 I/O 线程对其负责的连接执行
read()+processInputBuffer()(协议解析) - 主线程自旋等待所有 I/O 线程完成
- 主线程单线程遍历所有客户端,执行命令
写阶段(Write Phase):
- 主线程执行完命令后,将需要返回响应的客户端加入
clients_pending_write队列 - 如果待写客户端数量 ≥
io_threads_num * 2,启用多线程写 - 将待写客户端均匀分配到各 I/O 线程
- 每个 I/O 线程对其负责的客户端执行
writeToClient()(调用writev) - 主线程自旋等待所有 I/O 线程完成
- 检查是否还有未发送完的数据,如有则重新注册写事件,下次 epoll 再写
6.5 为什么命令执行必须是单线程的?
这是 Redis 多线程设计中最重要的约束。原因有三:
1. 数据结构的无锁设计
Redis 的所有核心数据结构(dict、skiplist、listpack、intset、ziplist 等)都没有内部锁。如果允许多个线程同时执行命令,就需要在数据结构层面加锁——这会带来巨大的复杂度和性能开销,完全违背了 Redis"简单即特性"的设计哲学。
2. 事务和 Lua 脚本的原子性
Redis 的事务(MULTI/EXEC)和 Lua 脚本依赖单线程执行来保证原子性。如果命令可以并行执行,MULTI/EXEC 的隔离性将无法保证(它依赖的是"执行期间没有其他命令插入"这个事实,而非真正的隔离级别)。
-- 这段简单的 Lua 脚本依赖单线程原子性
local old = redis.call('GET', KEYS[1])
if old < ARGV[1] then
    redis.call('SET', KEYS[1], ARGV[1])
end
return old
如果在 GET 和 SET 之间另一个线程修改了 KEYS[1],逻辑就完全错了。这段代码在单线程下天然正确,在并发下就是一个 race condition。
6.6 Redis 7.0+ 的多线程 I/O 改进
Redis 7.0 对多线程 I/O 做了几项重要改进:
1. 自适应单线程回退
Redis 7.0 优化了"小批量回退到单线程"的判断逻辑。当待处理的客户端数量少于 io_threads_num * 2 时,自动回退到单线程模式。这个阈值在 7.0 中可以根据实际负载动态调整,避免不必要的线程唤醒开销。
2. 读阶段默认开启
在 Redis 6.0 中,io-threads-do-reads 默认是 no,因为当时担心读阶段的多线程解析可能引入 bug。经过 6.x 系列的验证,7.0 将默认值改为 yes,正式承认读阶段多线程的稳定性和收益。
3. 无锁化改进
Redis 7.0 减少了 I/O 线程与主线程之间的共享状态,将部分全局变量改为线程本地变量,减少了 cache line 的 false sharing 问题。具体来说,每个 I/O 线程的 io_threads_list[id] 和 io_threads_pending[id] 被放置在不同的 cache line 上,避免了"一个线程写入,导致其他线程的 cache line 失效"的问题。
4. 实际收益量化
在 Redis 7.0 的官方 benchmark 中,相比 6.0:
| 场景 | 6.0 QPS | 7.0 QPS | 提升 |
|---|---|---|---|
| SET (4 线程, 无 pipeline) | 18 万 | 22 万 | ~22% |
| GET (4 线程, 无 pipeline) | 20 万 | 25 万 | ~25% |
| SET (4 线程, pipeline=16) | 70 万 | 75 万 | ~7% |
Pipeline 场景下提升较小,因为 pipeline 已经将系统调用批量化,多线程 I/O 的边际收益递减。
6.7 一个被忽略的细节:BIO 线程
在讨论 Redis 的"多线程"时,很多人只关注 6.0 的 I/O 多线程,却忽略了 Redis 从 2.6 版本就有的 BIO(Background I/O)线程。
BIO 线程是 Redis 的"后台线程池",与 I/O 多线程有本质区别——BIO 线程不参与命令执行,不处理客户端请求,只处理可能导致主线程阻塞的系统调用:
// bio.c 中的定义
#define BIO_CLOSE_FILE    0  // 关闭文件(close() 可能阻塞)
#define BIO_AOF_FSYNC     1  // AOF 文件刷盘(fsync() 可能阻塞数百毫秒)
#define BIO_LAZY_FREE     2  // 惰性删除(UNLINK,释放大对象内存)
#define BIO_NUM_OPS       3
BIO 的工作模式是生产者-消费者:
- 主线程(生产者)将任务放入 job 队列
bio_jobs[type] - BIO 线程(消费者)从队列中取出任务执行
- 使用
pthread_mutex+pthread_cond实现线程间同步
// 主线程提交任务
void bioCreateBackgroundJob(int type, void *arg1, void *arg2, void *arg3) {
    struct bio_job *job = zmalloc(sizeof(*job));
    job->arg1 = arg1;
    job->arg2 = arg2;
    job->arg3 = arg3;
    pthread_mutex_lock(&bio_mutex[type]);
    listAddNodeTail(bio_jobs[type], job);
    bio_pending[type]++;  // 计数器 +1
    pthread_cond_signal(&bio_newjob_cond[type]);  // 唤醒 BIO 线程
    pthread_mutex_unlock(&bio_mutex[type]);
}

// BIO 线程的执行循环
void *bioProcessBackgroundJobs(void *arg) {
    int type = (long)arg;
    while (1) {
        pthread_mutex_lock(&bio_mutex[type]);
        while (listLength(bio_jobs[type]) == 0) {
            pthread_cond_wait(&bio_newjob_cond[type], &bio_mutex[type]);
        }
        job = listFirst(bio_jobs[type]);
        pthread_mutex_unlock(&bio_mutex[type]);
        // 执行实际任务...
    }
}
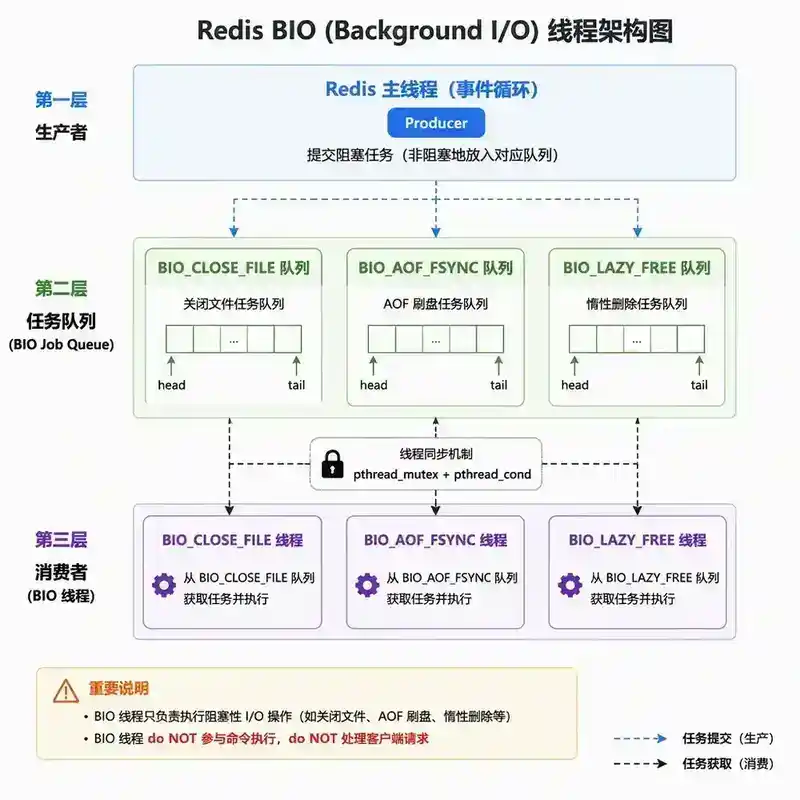
BIO 与 I/O 多线程的核心区别:
| 维度 | BIO 线程 (2.6+) | I/O 多线程 (6.0+) |
|---|---|---|
| 处理内容 | 阻塞性系统调用(close, fsync, unlink) | 网络读写(read, write, 协议解析) |
| 与请求路径关系 | 离线任务,不参与请求处理 | 在线任务,直接参与请求处理 |
| 同步方式 | 互斥锁 + 条件变量 | 自旋锁 + 计数器 |
| 线程数 | 固定 3 个(每种类型 1 个) | 可配置 1-16 |
理解 BIO 线程的存在,有助于消除一个常见误解:Redis 并不是 6.0 才"有"多线程,而是 6.0 才让多线程"参与请求处理"。
3. 命令执行的 CPU 开销极低
antirez 做过测试,执行一个 SET 命令只需要约 1-2 微秒,其中大部分时间花在系统调用上。将命令执行并行化,线程切换的开销(1-5 微秒)可能比执行命令本身还大。不值得并行化的事情,就不要并行化。
七、Redis 高性能的完整解构
7.1 性能全景图
Redis 的高性能不是单一原因造成的,而是七层设计共同作用的结果:
              Redis 高性能原因全景

  ┌─────────────────────────────────────────────────────────────────┐
  │                         Redis 高性能                             │
  │                                                                 │
  │  ┌───────────┐  ┌───────────┐  ┌───────────────┐               │
  │  │ ①纯内存操作 │  │②高效数据结构│  │③ I/O 多路复用  │               │
  │  │           │  │           │  │               │               │
  │  │ · ns 级读写│  │ · SDS     │  │ · epoll/kqueue│               │
  │  │ · 无磁盘  │  │ · dict    │  │ · 事件驱动    │               │
  │  │   I/O 延迟│  │ · skiplist│  │ · 非阻塞 I/O  │               │
  │  │ · 零拷贝  │  │ · listpack│  │ · 水平触发    │               │
  │  └───────────┘  └───────────┘  └───────────────┘               │
  │                                                                 │
  │  ┌───────────┐  ┌───────────┐  ┌───────────────┐               │
  │  │④单线程执行  │  │⑤ 简洁协议  │  │ ⑥高效编码     │               │
  │  │           │  │           │  │               │               │
  │  │ · 无锁竞争 │  │ · RESP    │  │ · C 语言     │               │
  │  │ · 无上下文│  │ · 二进制安全│  │ · 精心优化   │               │
  │  │   切换    │  │ · 解析极快 │  │ · 极简代码   │               │
  │  │ · 天然原子│  │ · 无状态   │  │ · jemalloc   │               │
  │  └───────────┘  └───────────┘  └───────────────┘               │
  │                                                                 │
  │  ┌─────────────────────────────────────────────┐               │
  │  │ ⑦ Pipeline + 多线程 I/O (6.0+)              │               │
  │  │                                             │               │
  │  │ · Pipeline 批量发送,减少 RTT                │               │
  │  │ · 多线程 I/O 并行读写,多核利用               │               │
  │  │ · 两者互补:Pipeline 减少往返,多线程 I/O    │               │
  │  │   加速单次往返中的读写                       │               │
  │  └─────────────────────────────────────────────┘               │
  └─────────────────────────────────────────────────────────────────┘
图 7:Redis 高性能原因全景——七层设计共同作用,而非单一因素
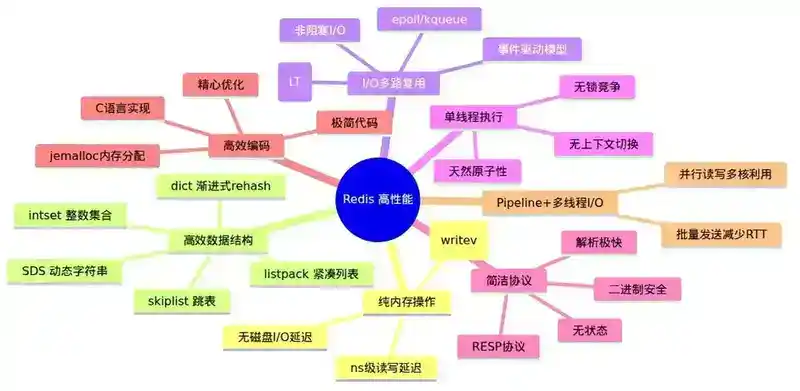
7.2 逐层深度分析
第一层:纯内存操作
这是最根本的原因。Redis 的所有数据都在内存中,读写的延迟是纳秒级别(内存访问 ~100ns),而磁盘 I/O 是毫秒级别(SSD 随机读 ~0.1ms,HDD 随机读 ~10ms)。两者相差约 1000-10 万倍。
即使 Redis 需要持久化,它通过以下方式避免影响常态读写:
- RDB:fork 子进程执行,利用 COW(Copy-On-Write)机制
- AOF:先写缓冲区,由后台线程异步 fsync
- 混合持久化(4.0+):RDB + 增量 AOF,兼顾恢复速度和数据完整性
第二层:高效的数据结构
Redis 的每种数据结构都经过精心设计,追求极致的内存效率和时间效率:
- SDS(Simple Dynamic String):在 C 字符串基础上增加了
len和alloc字段。获取长度 O(1)(C 字符串是 O(n)),追加操作预分配额外空间(最多 1MB),避免频繁realloc - dict(哈希表):使用渐进式 rehash——扩容时不是一次性迁移所有数据,而是每次操作时迁移一小部分,分散到多次操作中完成,避免一次性卡顿。Redis 维护两个哈希表
ht[0]和ht[1],rehash 期间查询需要同时查两个表 - skiplist(跳表):平衡了实现复杂度(远低于红黑树)和查询效率(O(log n)),支持范围查询,是 ZSet 的底层实现之一
- listpack(紧凑列表,7.0 替代 ziplist):每个元素记录自身长度,消除了 ziplist 的"连锁更新"问题。用于 Hash 和 ZSet 的小数据量场景
- intset(整数集合):当 Set 中全部是整数且数量较少时,使用紧凑的有序数组存储,比 hashtable 节省大量内存
第三层:I/O 多路复用(epoll)
单线程能同时处理成千上万个连接,完全依赖 epoll 的事件通知机制。具体原理在前文第五章已详细展开。
第四层:单线程避免锁竞争
多线程程序中,共享数据结构的访问需要加锁,开销不容忽视:
- pthread_mutex:无竞争时 ~25ns,有竞争时涉及 futex 系统调用,可达数微秒
- CAS 自旋:在竞争激烈时大量浪费 CPU 周期
- 上下文切换:每次线程切换约 1-5μs,包括保存/恢复寄存器、TLB 刷新等
Redis 单线程完全避免了这些开销,每个命令执行都是"一路畅通"。
第五层:简洁高效的 RESP 协议
RESP(REdis Serialization Protocol)协议极其简单,所有数据类型用第一个字节标识:
+ 简单字符串   - 错误       : 整数
$ 批量字符串   * 数组       _ null
# 布尔        , 双精度     ( 大数
! 批量错误     = 逐字字符串  % 映射
~ 集合        > 推送
解析速度快,不需要复杂的状态机,二进制安全。这也意味着网络传输的数据量相对较小。
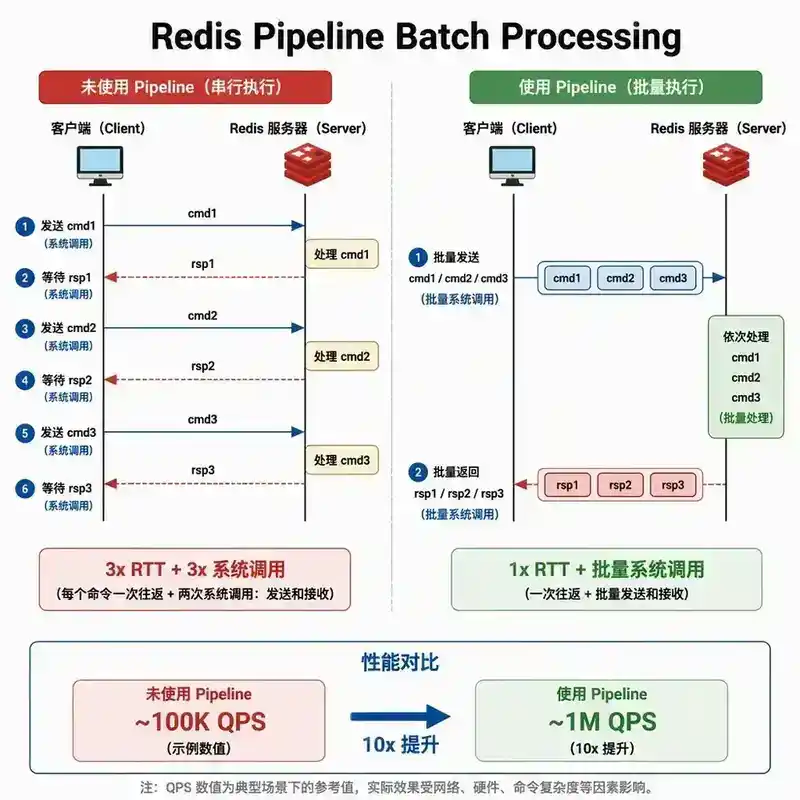
第六层:Pipeline 批量处理
Pipeline 允许客户端一次性发送多个命令而不等待每个命令的响应:
无 Pipeline:          有 Pipeline:
Client    Server       Client    Server
  │─ cmd1 ─→│             │─ cmd1 ─→│
  │←─ rsp1 ─│             │─ cmd2 ─→│
  │─ cmd2 ─→│             │─ cmd3 ─→│
  │←─ rsp2 ─│             │←─ rsp1 ─│
  │─ cmd3 ─→│             │←─ rsp2 ─│
  │←─ rsp3 ─│             │←─ rsp3 ─│
  3x RTT + 3x 系统调用     1x RTT + 1x 批量系统调用
Pipelining 将 N 次 RTT 合并为 1 次,同时将 N 次 read()/write() 系统调用合并为更少的批量调用,是 Redis 达到百万 QPS 的关键。
7.3 性能基准数据
以下是典型场景下的 Redis 性能基准(单实例,标准配置,Intel Xeon 2.5GHz):
| 场景 | QPS | 延迟 (p50/p99) | 瓶颈 |
|---|---|---|---|
| SET/GET 小数据(单线程) | 10-12 万 | 0.3ms / 1ms | 网络 I/O 系统调用 |
| SET/GET 小数据(Pipeline=16) | 60-80 万 | 0.5ms / 2ms | CPU(单核) |
| SET/GET 小数据(Pipeline=64) | 80-100 万 | 1ms / 5ms | CPU(单核) |
| SET/GET 小数据(多线程 I/O, 4 线程) | 18-25 万 | 0.3ms / 1ms | CPU(多核) |
| 复杂命令(ZADD+ZRANGE) | 5-8 万 | 0.5ms / 2ms | CPU(数据结构操作) |
| Lua 脚本(简单的 GET+SET) | 3-5 万 | 1ms / 3ms | CPU(Lua 解释执行) |
数据来自 Redis 官方 benchmark 及社区测试,具体数值因硬件、网络、value 大小而异。
八、生产实践与常见陷阱
8.1 多线程 I/O 决策树
你的 Redis QPS 是否超过 8 万?
├── 否 → 保持单线程(默认配置)
└── 是 → 是否大量使用 Pipeline?
    ├── 是 → Pipeline 已提供批量处理,多线程 I/O 收益有限,保持单线程
    └── 否 → 服务器 CPU 核心数?
        ├── < 4 核 → 多线程收益被线程切换抵消,保持单线程
        └── ≥ 4 核 → 开启多线程 I/O
            io-threads 4-6
            io-threads-do-reads yes
8.2 配置建议
# redis.conf 推荐配置
io-threads 4                      # 4 核起步,设为 CPU 核心数的 1/2 到 3/4
io-threads-do-reads yes           # 读阶段也开启多线程

# 在 redis-cli 中验证配置
CONFIG GET io-threads
CONFIG GET io-threads-do-reads

# 压测验证效果
redis-benchmark -t set,get -n 1000000 -c 50 -d 256 --threads 4
8.3 常见陷阱
陷阱 1:误以为多线程 I/O 能提升所有场景
多线程 I/O 只在网络 I/O 是瓶颈时有帮助。瓶颈在 CPU 时(如 SORT、ZUNIONSTORE、大量 Lua 脚本),多线程 I/O 不会有任何帮助。先用 redis-cli --latency 和 INFO commandstats 确认瓶颈。
陷阱 2:线程数越多越好
Redis 的多线程 I/O 使用自旋同步,I/O 线程数超过 CPU 核心数会导致上下文切换。建议不超过 8,且设为 CPU 核心数的 1/2 到 3/4。
陷阱 3:把 Redis 当多线程数据库用
即使有了多线程 I/O,Redis 的命令执行仍然是单线程的。一个 KEYS * 仍然会阻塞所有其他请求。O(N) 命令在生产环境应该禁用(rename-command KEYS "")。
陷阱 4:忽略持久化对性能的影响
AOF 的 fsync 策略直接影响性能:
| fsync 策略 | 性能影响 | 数据安全性 |
|---|---|---|
always |
QPS 下降 90%+ | 最高 |
everysec |
几乎无影响 | 最多丢失 1 秒 |
no |
无影响 | 不可控 |
陷阱 5:大 Key 问题
单线程执行意味着一个大 Key 操作(如 DEL 一个包含百万元素的 Set)会阻塞事件循环数百毫秒。4.0+ 使用 UNLINK 异步删除,6.0+ 的 lazyfree 相关配置可以自动异步化:
lazyfree-lazy-eviction yes
lazyfree-lazy-expire yes
lazyfree-lazy-server-del yes
陷阱 6:CPU 亲和性(NUMA 架构)
在多路服务器上,Redis 进程可能被调度到不同 NUMA 节点,导致内存访问延迟增大。建议使用 taskset 或 numactl 绑定 Redis 进程到特定 CPU 和 NUMA 节点:
taskset -c 0-3 redis-server redis.conf
8.4 实战案例:从单线程到多线程 I/O 的迁移
背景:某电商平台 Redis 集群,高峰期单实例 QPS 约 12 万,CPU 使用率 95%(单核),出现间歇性延迟抖动。
排查过程:
INFO stats查看:instantaneous_ops_per_sec: 118000redis-cli --latency查看:p50 = 0.5ms, p99 = 8ms(抖动明显)INFO commandstats查看:cmdstat_get占 70%,cmdstat_set占 20%,无慢命令- 结论:瓶颈在网络 I/O 系统调用,CPU 单核已达上限
解决方案:
# 1. 开启多线程 I/O(4 核机器)
io-threads 4
io-threads-do-reads yes

# 2. 滚动重启 Redis 实例
效果:
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| QPS | 11.8 万 | 19.5 万 | +65% |
| CPU 使用率 | 95% (单核) | 60% (4 核) | 单核压力分散 |
| p50 延迟 | 0.5ms | 0.3ms | -40% |
| p99 延迟 | 8ms | 1.5ms | -81% |
关键教训:
- 多线程 I/O 对 p99 延迟的改善比对 p50 更大——因为并行降低了单个请求的排队等待时间
- 迁移前需要确认没有慢命令,否则多线程 I/O 不会带来收益
- 建议先在从节点上验证,确认无问题后再推广到主节点
九、面试官视角提问(Q&A)
以下问题来自面试官视角,考察对 Redis 线程模型的深度理解。建议先自己思考,再对照答案。
Q1:Redis 6.0 的多线程 I/O 和传统数据库(如 MySQL)的线程池模型有什么区别?为什么 Redis 不采用线程池模型?
答案要点:
Redis 的多线程 I/O 是阶段并行——只在网络读写的短暂阶段使用多线程,命令执行阶段又回到单线程。而 MySQL 的线程池模型是全程并行——每个请求分配一个线程,线程内部完成读、解析、执行、写的全部流程。
Redis 不采用线程池模型的核心原因:
- 数据结构无锁设计,加锁会破坏简洁性
- 命令执行本身极快(微秒级),线程切换开销可能大于执行开销
- 事务和 Lua 脚本依赖单线程原子性
- 内存操作不需要 I/O 等待(这是线程池模型的主要收益场景)
Q2:如果 Redis 是单线程的,为什么还会有并发安全问题?举一个具体的 race condition 场景。
答案要点:
Redis 单线程指的是单个实例内部的命令执行是串行的。并发安全问题出现在以下层面:
具体场景:秒杀库存扣减
客户端 A: GET stock → 10
客户端 B: GET stock → 10
客户端 A: SET stock 9  (10-1)
客户端 B: SET stock 9  (10-1)  ← 本应扣到 8!
虽然每个命令都是原子的,但"读-判断-写"的组合不是原子的。解决方案:
- Lua 脚本:
EVAL "if redis.call('GET',KEYS[1])>0 then return redis.call('DECR',KEYS[1]) end" 1 stock - WATCH 乐观锁:
WATCH stock; GET stock; ...; MULTI; DECR stock; EXEC - INCRBY/DECRBY:直接用原子命令,但无法做"大于 0"的判断
Q3:Redis 6.0 的多线程 I/O 线程间同步为什么用自旋锁而不是互斥锁?自旋等待 100 万次后为什么还要 fallback 到互斥锁?
答案要点:
用自旋锁的原因:
- I/O 线程的工作周期极短(通常几十微秒),互斥锁的 futex 系统调用开销(数微秒)占比较大
- 自旋等待避免了内核态切换,延迟更低
- 主线程需要等待 I/O 线程完成才能继续执行命令,这期间主线程本来就在等待
100 万次自旋后 fallback 到互斥锁的原因:
- 100 万次空循环在现代 CPU 上约 1-2 毫秒
- 如果超过这个时间还没有任务,说明 Redis 处于空闲状态
- 此时应该让线程休眠(futex),释放 CPU 资源给其他进程
- 这是"忙等 + 休眠"的混合策略:忙等应对高频任务,休眠应对空闲
Q4:Redis 的事件循环和 Node.js 的事件循环有什么异同?beforesleep 在 Node.js 中有对应吗?
答案要点:
相同点:
- 都是单线程事件循环,基于 I/O 多路复用(epoll/kqueue)
- 都分为多个阶段,处理不同类型的事件
- 都将 I/O 操作异步化
不同点:
- Redis 事件循环只有文件事件和时间事件两类,极简;Node.js 事件循环有 6 个阶段(timers、pending callbacks、idle/prepare、poll、check、close callbacks)
- Redis 没有 microtask/macrotask 的区分(不需要 Promise)
- Node.js 的
process.nextTick()和setImmediate()在 Redis 中没有对应
beforesleep 在 Node.js 中有没有对应? 没有直接对应。最接近的概念是 Node.js 事件循环中 poll 阶段到 check 阶段之间的过渡,但语义不同。beforesleep 是 Redis 的独特设计——它利用"主线程即将进入阻塞等待"这个时机,执行一些"现在不做,等会儿也要做"的后台任务。这种设计让 Redis 在"忙"时能尽量处理客户端请求,在"闲"时能及时处理后台任务。
Q5:Redis 的 pipeline 和 多线程 I/O 有什么本质区别?两者可以叠加吗?
答案要点:
本质区别:
- Pipeline 是客户端侧的优化:减少 RTT 次数,将 N 次请求-响应合并为 1 次
- 多线程 I/O 是服务端侧的优化:并行处理多个连接的
read()/write()系统调用
可以叠加:Pipeline 和多线程 I/O 是正交的优化。Pipeline 减少的是网络往返次数,多线程 I/O 加速的是单次往返中的网络读写。但叠加效果不是线性的:
- Pipeline 模式下,单次往返中已经包含了多条命令,网络读写的"批量化"已经实现
- 此时多线程 I/O 的收益主要来自"并行处理多个 Pipeline 连接"
- 如果客户端数量少(如 10 个),多线程 I/O 的收益有限
Q6:如果让你设计一个支持 100 万并发连接的 Redis 替代方案,你会怎么设计线程模型?
答案要点(开放性问题,考察系统设计能力):
- 连接层:使用独立的 Acceptor 线程池,通过 SO_REUSEPORT 将连接分散到多个线程
- 网络 I/O 层:使用 I/O 线程池(类似 Redis 6.0),但每个 I/O 线程有自己的 epoll 实例
- 命令执行层:采用分片单线程模型——将 key 哈希到不同的执行线程,每个线程内部仍是单线程,但不同分片之间可以并行
- 数据同步:每个分片线程有独立的数据结构实例,线程间无共享数据,避免锁
- 持久化:使用独立的持久化线程,从每个执行线程的写缓冲中拉取数据,合并后写入磁盘
- 跨分片操作:对于需要跨分片的事务(如 MGET 多个分片的 key),使用两阶段提交或分布式事务
关键权衡:分片单线程模型在单核利用率和简洁性之间取得了平衡,但引入了跨分片操作的复杂性。实际上,Redis Cluster 就是这种思路的分布式实现——每个节点仍是单线程,但通过分片实现了水平扩展。
Q7:Redis 的 serverCron 为什么设计为时间事件而不是独立线程?如果改为独立线程会有什么问题?
答案要点:
serverCron 设计为时间事件而非独立线程,核心原因是需要访问主线程的数据结构。serverCron 中的很多操作(如过期键删除、渐进式 rehash、客户端超时断开)都需要访问 server.db、server.clients 等全局数据结构。如果放在独立线程中,就需要对这些数据结构加锁,这与 Redis 的设计哲学相悖。
如果改为独立线程:
- 优点:不会抢占主线程 CPU,serverCron 的执行不会影响客户端请求延迟
- 缺点:
- 所有访问全局数据结构的操作都需要加锁,实现复杂度激增
- 锁竞争可能抵消独立线程的收益
- 过期键删除和渐进式 rehash 等操作与命令执行存在竞争关系,需要细粒度锁
- 调试难度大幅增加
Redis 的选择是:将 serverCron 拆分为"必须在主线程执行"和"可以异步执行"两部分。前者保留在时间事件中(如过期键采样、rehash 步进),后者放到 BIO 线程中(如 AOF fsync、文件关闭)。
十、总结
| 维度 | 核心要点 |
|---|---|
| 事件循环 | 基于 aeEventLoop,处理文件事件(epoll 驱动)和时间事件(serverCron),beforesleep 是独特设计 |
| 单线程理由 | 避免锁竞争、简化代码、保证原子性、CPU 不是瓶颈、内存操作极快 |
| 多线程 I/O | 6.0+ 引入,仅网络读写阶段并行,命令执行仍单线程,自旋同步 |
| 高性能原因 | 内存操作(100ns) + 高效数据结构(dict/skiplist/listpack) + epoll 多路复用 + 单线程无锁 + RESP 协议 + Pipeline |
| 适用场景 | QPS > 10 万且非 Pipeline 场景下开启多线程 I/O,4-6 线程 |
| 核心约束 | 慢命令阻塞一切,大 Key 操作需使用 UNLINK/lazyfree,持久化策略影响性能 |
理解 Redis 的线程模型,本质上是在理解"简单性"作为一种工程选择的智慧——在性能足够的前提下,保持模型简单比压榨最后一点性能更重要。这也是为什么 Redis 用了 11 年(2009-2020)才迈出多线程的第一步,而这一步走得如此克制。
本文基于 Redis 7.x 源码分析,部分 API 和数据结构在不同版本中可能有差异,请以实际版本为准。