阅读时间:约 45 分钟 | 难度:进阶 | 适用方向:架构师、高级 Java 工程师
目录
- 从一个页面打开说起
- 缓存分层:为什么需要多级?
- 第一级:本地缓存
- 第二级:分布式缓存
- 第三级:CDN 缓存
- 多级缓存间的数据一致性
- 失效传播机制
- 实战:拼装一个多级缓存架构
- 性能度量与监控
- 常见陷阱与反模式
- 面试官提问
1. 从一个页面打开说起
假设你在北京打开淘宝首页,页面在 0.3 秒内渲染完成。这段请求穿过光缆到达杭州机房、查询数据库、组装 HTML、再原路返回——在不考虑缓存的情况下,这一切不可能在 300 毫秒内完成。
真实情况是:用户请求命中的第一层可能是 CDN 边缘节点(北京本地),静态资源直接返回;动态数据请求到达后端,先查本地缓存(进程内),未命中再查分布式缓存(Redis 集群),仍未命中才落到数据库。这个链条就是本文要拆解的核心——多级缓存架构。
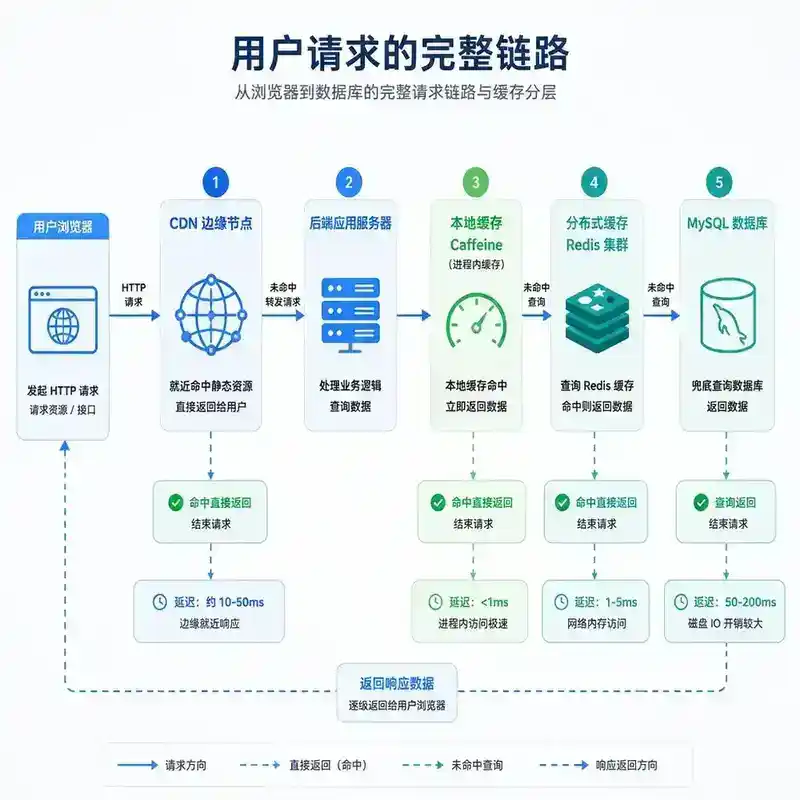
多级缓存的本质是用空间换时间,用距离换延迟。数据离计算单元越近,访问越快;但离得越近,存储容量越小,一致性维护越复杂。这构成了一个经典的三元权衡:
- 延迟:数据离 CPU / 用户越近,延迟越低
- 容量:越靠近源头,存储量越大
- 一致性:数据副本越多,保持一致越困难
理解了这三者之间的关系,就理解了多级缓存架构设计的全部动机。
2. 缓存分层:为什么需要多级?
2.1 单一缓存的困境
如果只用 Redis 做分布式缓存,会面临什么问题?
- 网络开销:即使是同机房 Redis,单次往返也在 0.2-0.5ms。对于 QPS 10 万的热点数据,累积的网络耗时不可忽略。
- 带宽瓶颈:所有缓存请求都打到 Redis 集群,网卡会成为瓶颈。
- 单点风险:Redis 集群故障时,所有请求穿透到数据库,可能引发雪崩。
如果只用本地缓存(Caffeine/Guava),又会如何?
- 内存容量受限:JVM 堆内缓存受限于堆大小,大规模缓存会挤压应用内存,触发 GC。
- 数据不一致:多个实例各自维护本地缓存,同一数据在不同实例上可能版本不同。
- 冷启动慢:实例重启后本地缓存为空,需要重新预热。
2.2 分层的逻辑
多级缓存的设计思路类似计算机体系结构中的存储层次(寄存器 → L1 → L2 → L3 → 内存 → 磁盘),每一层都是对上一层容量不足的补充,同时尽可能保持访问速度。
请求频率: 极高                     极低
访问延迟: <1ms   1-2ms   5-50ms   50-200ms
          ┌──────┐┌──────┐┌──────┐┌──────┐
          │ 本地  ││分布式││ CDN  ││ 数据库│
          │ 缓存  ││ 缓存  ││ 缓存  ││      │
          └──────┘└──────┘└──────┘└──────┘
容量:      MB~GB    GB~TB   TB~PB    PB+
一致性:   最弱     较弱     中等     最强(源)
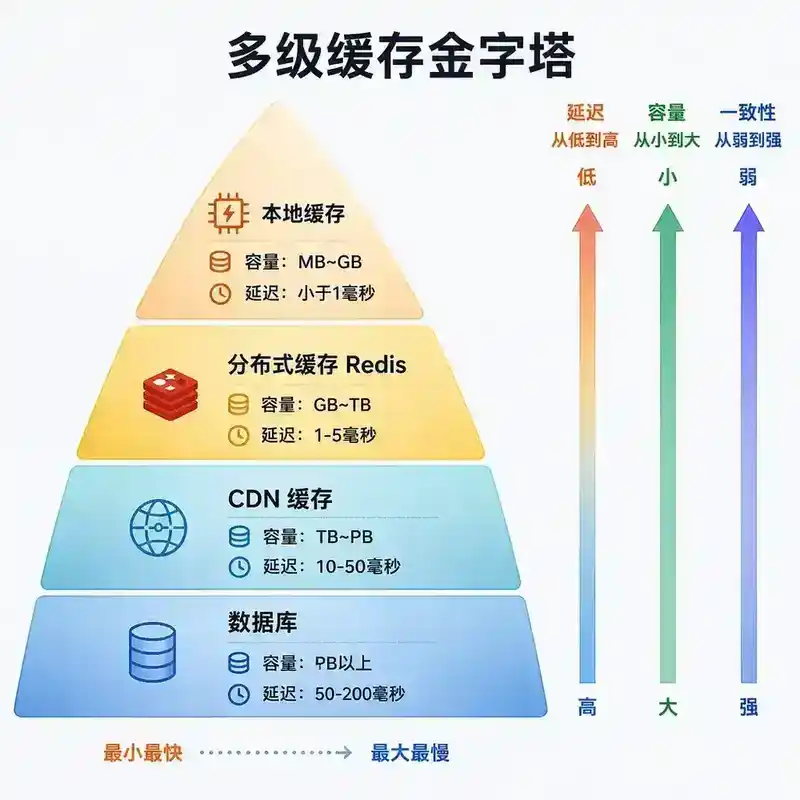
每一级缓存承担不同的职责:
| 层级 | 典型实现 | 延时 | 容量 | 数据特点 |
|---|---|---|---|---|
| 本地缓存 | Caffeine / Guava | <1ms | MB~GB | 热点数据、极高频率 |
| 分布式缓存 | Redis / Memcached | 1~5ms | GB~TB | 共享数据、中等频率 |
| CDN | 阿里云 CDN / CloudFront | 10~50ms | TB~PB | 静态资源、地域分发 |
| 数据库 | MySQL / PostgreSQL | 50~200ms | PB+ | 全量数据、权威来源 |
3. 第一级:本地缓存
3.1 本地缓存的本质
本地缓存是进程内缓存,数据直接存储在 JVM 堆内存中。它的核心优势是零网络开销——一次缓存访问就是一次 HashMap 查找,延迟通常在微秒级别。
Java 生态中主流的本地缓存方案:
| 方案 | 特点 | 适用场景 |
|---|---|---|
| Caffeine | 基于 W-TinyLFU,近乎最优命中率 | 高并发、大容量缓存 |
| Guava Cache | Google 出品,功能完善 | 中等规模缓存 |
| Ehcache | 支持堆外内存、持久化 | 需要持久化的场景 |
| ConcurrentHashMap | 最简单,无过期策略 | 极少变更的配置数据 |
3.2 Caffeine 的核心设计
Caffeine 是目前 Java 领域性能最好的本地缓存库,它的设计有三个关键点:
(1)W-TinyLFU 淘汰策略
传统 LRU 的问题在于容易被"扫描式"访问污染——比如一次全量数据导出会遍历所有记录,LRU 会把这些"只用一次"的数据全部提到顶部,把真正热数据挤出去。
LFU 虽然能区分频率,但无法应对"历史热数据变冷"的场景——一个曾经被访问 10 万次的数据,即使现在已经没人访问了,LFU 仍然认为它很"热"。
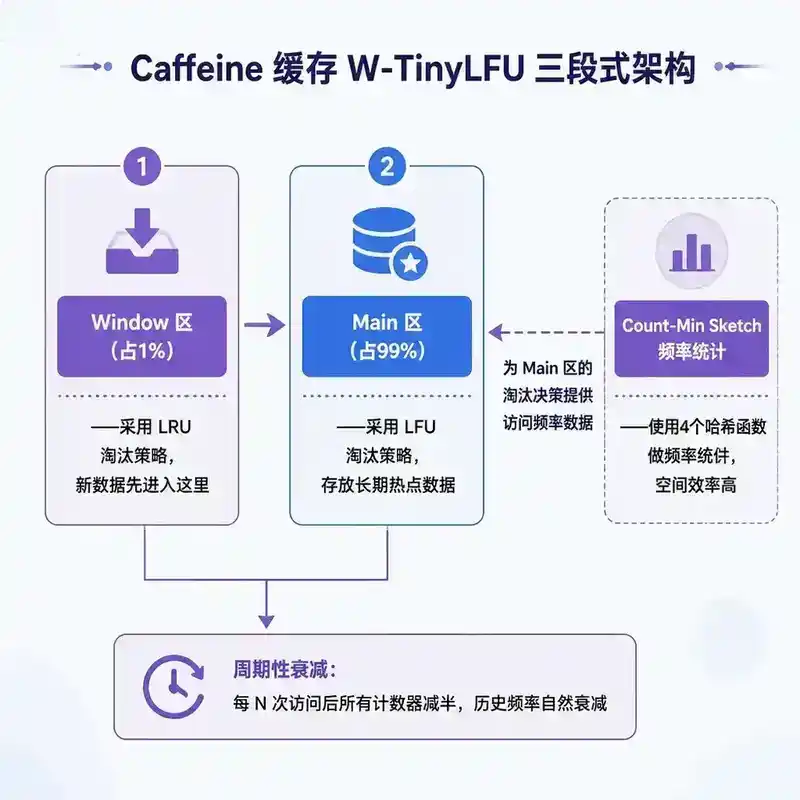
Caffeine 的 W-TinyLFU 结合了两种策略:
- Window 区:新数据先进入一个小的 Window 区(占 1%),用 LRU 淘汰
- Main 区:Window 区淘汰的数据进入 Main 区(占 99%),用 LFU 淘汰
- Count-Min Sketch:用 4 个 hash 函数做频率统计,空间效率极高
- 周期性衰减:每 N 次访问后,所有计数器减半,让历史频率自然衰减
Cache<String, User> cache = Caffeine.newBuilder()
    .maximumSize(10_000)              // 最大条目数
    .expireAfterWrite(10, TimeUnit.MINUTES)  // 写入后 10 分钟过期
    .expireAfterAccess(5, TimeUnit.MINUTES)  // 访问后 5 分钟过期
    .recordStats()                     // 开启统计
    .build();
(2)环形缓冲区的异步淘汰
Caffeine 的淘汰不发生在写入线程,而是通过一个环形缓冲区(RingBuffer)异步处理。写入线程只负责把淘汰事件放入缓冲区,不阻塞业务线程。这个设计与 Log4j2 的 AsyncLogger 思路一致——用极低的延迟换取吞吐量。
(3)过期策略的多时钟设计
Caffeine 支持三种过期模式:
expireAfterWrite:写入后固定时间过期,适合"写入后 TTL 固定"的场景expireAfterAccess:最后访问后固定时间过期,适合"不活跃即淘汰"的场景expireAfter(Expiry):自定义过期策略,每个条目可以有独立的过期时间
这三种模式通过时间轮(Timer Wheel)实现 O(1) 的过期扫描,而不是遍历所有条目。
3.3 本地缓存的内存风险
本地缓存的最大风险是内存膨胀。一个系统的 JVM 堆内存是有限的,如果本地缓存占了 4GB 中的 3GB,GC 停顿时间会急剧上升。
关键的防护措施:
- 设置
**maximumSize**:硬限制条目数,防止无限增长 - 设置
**maximumWeight**:按字节数限制,适合 value 大小不均的场景 - 使用弱引用/软引用:在 GC 压力大时自动释放
- 堆外内存:使用 Ehcache 的 off-heap 或直接使用 Chronicle Map,避免 GC 抖动
// 按字节数限制

Cache<String, byte[ ]> cache = Caffeine.newBuilder()

    .maximumWeight(512 * 1024 * 1024)  // 512MB

    .weigher((String key, byte[ ] value) -> value.length)

    .build();
4. 第二级:分布式缓存
4.1 为什么需要分布式缓存
本地缓存解决了单实例的热点问题,但无法解决:
- 多实例间的数据共享(如 Session 数据)
- 数据量超过单机内存上限
- 实例重启后缓存全量丢失
分布式缓存(以 Redis 为代表)是解决这些问题的标准方案。
4.2 Redis 作为缓存层的核心设计
Redis 能在缓存层站稳脚跟,不是因为它是"最快的 KV 存储",而是它在性能、功能、运维三者之间取得了最佳平衡。
数据结构丰富性:
- String:缓存序列化对象,支持 GET/SET/INCR
- Hash:缓存对象的部分字段,避免全量序列化
- Sorted Set:实现排行榜、延迟队列
- List:消息队列、最新列表
- Stream:可靠的消费组消息
过期与淘汰:
- 惰性删除 + 定期删除:访问时检查 + 每 100ms 随机抽 20 个 key 检查
- 8 种淘汰策略:
noeviction/allkeys-lru/volatile-lru/allkeys-lfu/volatile-lfu/allkeys-random/volatile-random/volatile-ttl
高可用能力:
- 主从复制 + Sentinel:自动故障转移
- Redis Cluster:分片 + 去中心化
- AOF + RDB:持久化保证数据不丢失
4.3 Redis 缓存设计模式
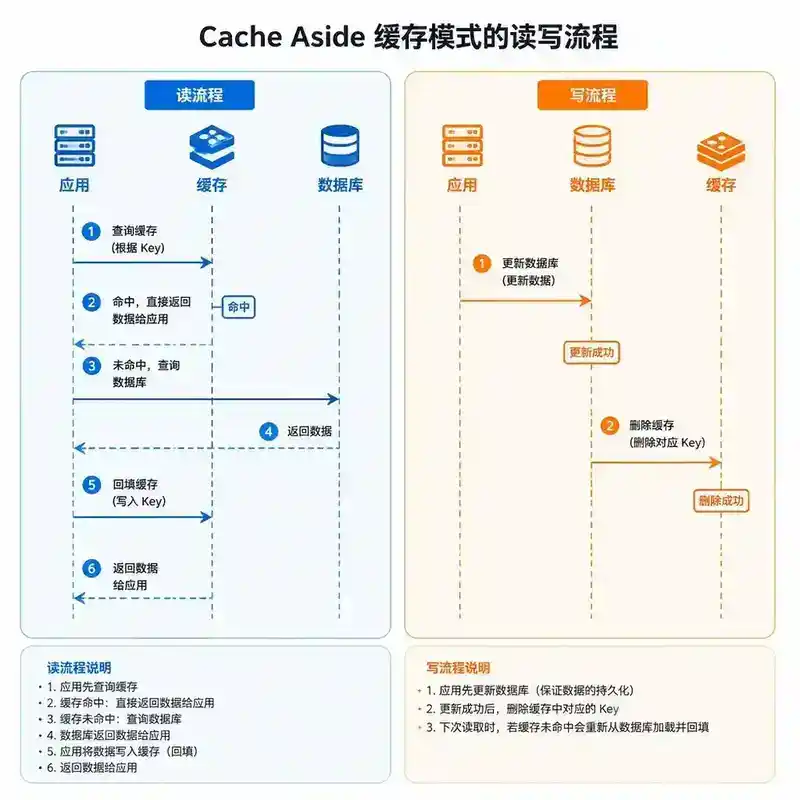
(1)Cache Aside(旁路缓存)
最常用的模式,读写的逻辑分离:
读: 查缓存 → 命中则返回 → 未命中查 DB → 写入缓存 → 返回
写: 更新 DB → 删除缓存(或更新缓存)
实际的 Java 代码:
public User getUser(Long id) {
    String key = "user:" + id;
    // 1. 查缓存
    String json = redis.get(key);
    if (json != null) {
        return JSON.parseObject(json, User.class);
    }
    // 2. 查数据库(加分布式锁防止缓存击穿)
    User user = db.findById(id);
    if (user != null) {
        // 3. 写缓存,设置过期时间
        redis.setex(key, 3600, JSON.toJSONString(user));
    } else {
        // 4. 缓存空值防止穿透(短过期时间)
        redis.setex(key, 60, "NULL");
    }
    return user;
}

public void updateUser(User user) {
    db.update(user);
    // 先删缓存,再更新 DB,还是反过来?
    // 标准做法:先更新 DB,再删缓存
    // 极端情况需要延迟双删
    redis.del("user:" + user.getId());
}
(2)Read/Write Through
缓存层代理了数据库的读写。应用只和缓存交互,缓存负责同步到数据库。这种模式在 Redis 中不够原生,通常需要自定义中间层。
(3)Write Behind(异步回写)
写操作只写缓存,异步批量刷入数据库。优点是写入吞吐极高,缺点是宕机时可能丢失未刷入的数据。适合对一致性要求不高的场景(如用户行为日志)。
4.4 Redis 的缓存三大问题
缓存穿透:查询一个不存在的数据,缓存和 DB 都没有。
- 方案:布隆过滤器 + 缓存空值(短过期)
缓存击穿:热点 key 过期瞬间,大量请求打到 DB。
- 方案:互斥锁(SET NX)+ 逻辑过期(永不过期,后台异步刷新)
缓存雪崩:大量 key 同时过期,DB 瞬间压力过大。
- 方案:过期时间加随机偏移 + 多级缓存 + 限流降级
// 缓存击穿的互斥锁方案
public String getWithMutex(String key) {
    String value = redis.get(key);
    if (value != null) {
        return value;
    }
    // 尝试获取锁
    String lockKey = "lock:" + key;
    if (redis.setnx(lockKey, "1", 10, TimeUnit.SECONDS)) {
        try {
            // 双重检查
            value = redis.get(key);
            if (value != null) return value;
            // 查 DB 并回填
            value = db.query(key);
            redis.setex(key, 3600, value);
        } finally {
            redis.del(lockKey);
        }
    } else {
        // 没拿到锁,短暂休眠后重试
        Thread.sleep(50);
        return getWithMutex(key);  // 递归重试
    }
    return value;
}
5. 第三级:CDN 缓存
5.1 CDN 在缓存体系中的位置
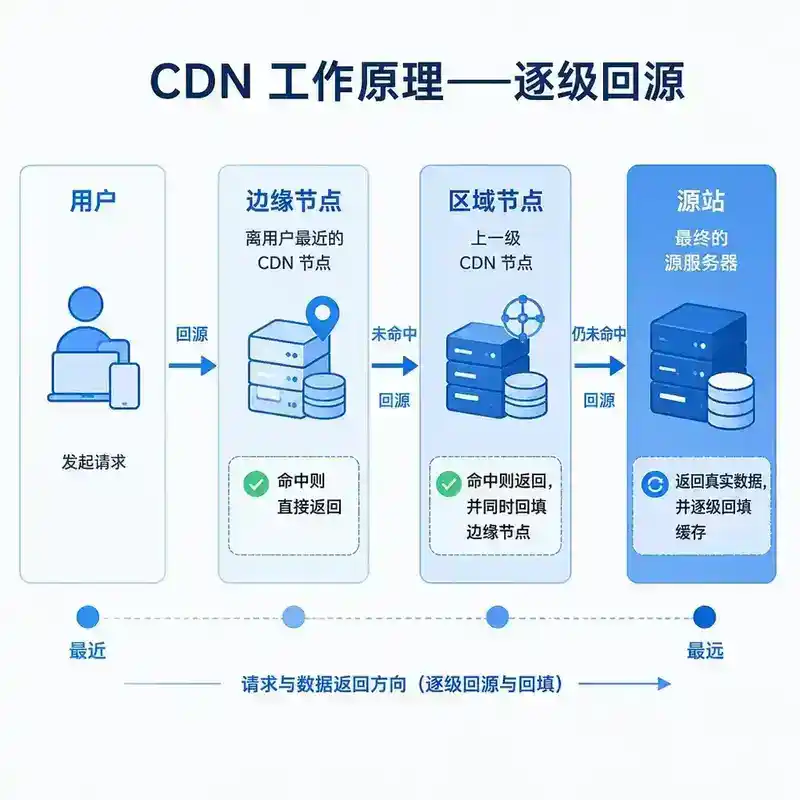
CDN(Content Delivery Network)解决的是地理距离带来的延迟问题。光在光纤中的传播速度约为 20 万公里/秒,北京到杭州直线距离约 1200 公里,理论最低往返延迟约 12ms。加上路由器转发、交换机处理,实际 RTT 在 25-40ms。
CDN 的思路是:把静态资源(图片、CSS、JS、视频)预先推送到离用户最近的边缘节点,让用户从本地城市的节点获取数据,而不是每次都跨越半个中国。
5.2 CDN 的缓存策略
缓存键:CDN 通常以 URL 作为缓存键。同一个 URL 的请求会被视为同一个资源。
缓存时间:通过 HTTP 响应头控制:
Cache-Control: max-age=3600:资源在 CDN 上缓存 1 小时Cache-Control: s-maxage=3600:仅对共享缓存(CDN)生效Cache-Control: no-cache:每次都验证,但可用 304 响应Cache-Control: no-store:完全不缓存
缓存版本控制: 最好的实践是文件名哈希——每次发布时,打包工具(Webpack/Vite)自动给文件名加 hash,内容变了 hash 就变,新 URL 自然不会命中旧缓存。
# 旧版本
https://cdn.example.com/js/app.a1b2c3d.js

# 新版本(内容变了,hash 变了,CDN 上这是新资源)
https://cdn.example.com/js/app.e4f5g6h.js
5.3 CDN 缓存刷新
当需要立即生效时,CDN 提供两种刷新方式:
- URL 刷新:删除指定 URL 的缓存,下次请求回源。适合少量紧急更新。
- 目录刷新:删除某个目录下所有缓存。适合批量更新,但会有瞬间回源压力。
- 预热:主动把热门资源推送到边缘节点,避免首次访问回源。适合大促前的准备。
CDN 刷新不是瞬间的——通常需要 5-10 分钟全网生效。这就是为什么文件名 hash 方案比 CDN 刷新更可靠:hash 变化本身就是"新资源",不需要等待刷新。
6. 多级缓存间的数据一致性
这是整个多级缓存架构中最复杂的问题。数据有多个副本分布在本地缓存、Redis、CDN 和数据库中,更新其中一个副本后,其他副本会短暂地"过时"。
6.1 一致性的层次
工程中不需要追求绝对的一致性(往往代价太高),而是根据业务场景选择合适的一致性级别:
- 强一致性:写入后立即在所有副本上可见。代价极高,通常需要分布式事务或共识协议。
- 最终一致性:写入后经过一段时间,所有副本最终一致。互联网业务的主流选择。
- 弱一致性:不保证何时一致,可能读到旧数据。仅用于对一致性零要求的场景(如访问计数)。
6.2 本地缓存与 Redis 的一致性
这是最常见的挑战:应用实例 A 更新了数据,先删了 Redis 缓存,再更新了 DB。但实例 B 的本地缓存中还有旧数据。
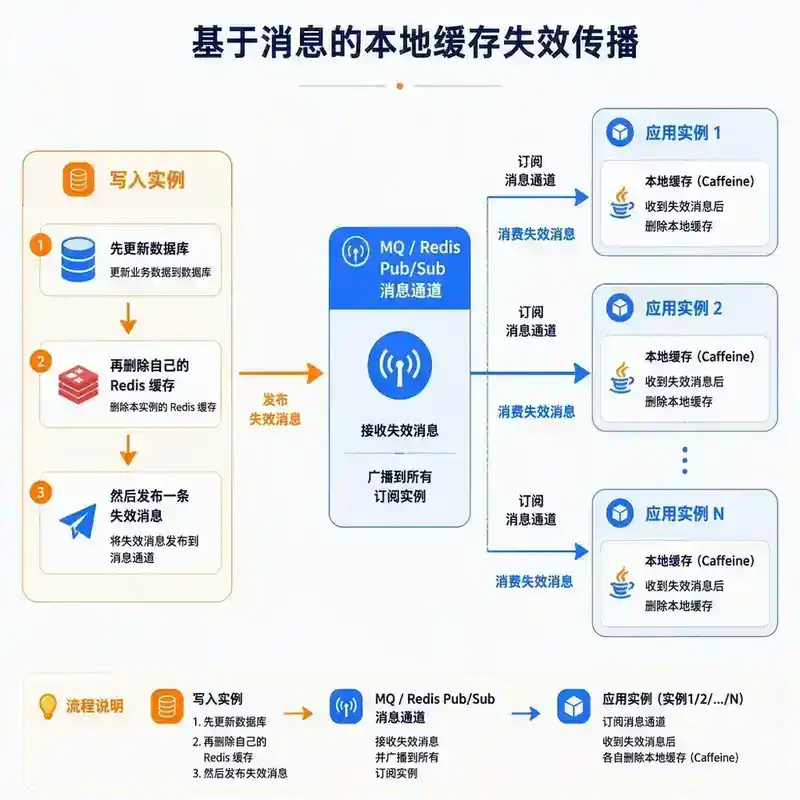
方案一:基于消息的失效通知
数据变更 → 发消息(MQ/Redis Pub/Sub) → 所有实例消费消息 → 删除本地缓存
// 发送失效消息
public void updateUser(User user) {
    db.update(user);
    redis.del("user:" + user.getId());
    // 通过 Redis Pub/Sub 通知所有实例
    redis.publish("cache:invalidate", "user:" + user.getId());
}

// 所有实例订阅失效消息
@Component
public class CacheInvalidateListener {
    @PostConstruct
    public void init() {
        redis.subscribe((message) -> {
            localCache.invalidate(message);
        }, "cache:invalidate");
    }
}
方案二:短 TTL + 主动刷新
不做精确失效,而是设置很短的本地缓存过期时间(如 5-10 秒),让不一致窗口可控。这是最简单的方案,适合对实时性要求不高的场景。
方案三:Canal + Binlog 订阅
通过监听 MySQL 的 binlog,感知数据变更,然后删除对应的缓存:
MySQL binlog → Canal → 消息队列 → 缓存失效处理器
这个方案的优点是解耦——业务代码不需要感知缓存失效,缺点是引入了 Canal 这一额外组件。
6.3 Redis 与 CDN 的一致性
CDN 缓存的过期机制与 Redis 不同:CDN 依赖 HTTP 头的 Cache-Control 或手动刷新。常见的策略:
- 静态资源用文件名 hash:这个方案天然解决了 CDN 一致性问题——更新后的资源有新的 URL,旧 URL 的资源自然过期。
- 动态内容用短 TTL:CDN 上缓存 5-10 秒,后端 Redis 做实际缓存。
- API 响应缓存:CDN 可以缓存 API 的 GET 响应,通过
Cache-Control: s-maxage控制。
6.4 最终一致性的可接受窗口
大部分互联网业务的数据一致性要求其实比想象中低:
| 业务场景 | 可接受不一致窗口 | 常见方案 |
|---|---|---|
| 商品详情 | 1-5 分钟 | 短 TTL 本地缓存 + Redis |
| 库存数量 | 秒级 | Redis 扣减 + 异步同步 DB |
| 用户头像 | 小时级 | CDN 长缓存 + 文件名 hash |
| 价格 | 分钟级 | 短 TTL 本地缓存 + 消息失效 |
| 订单状态 | 实时 | 直接查 DB,不做缓存 |
7. 失效传播机制
7.1 失效传播的三个维度
失效传播需要回答三个问题:
- 何时失效(when):数据变更时立即失效,还是到了 TTL 自然失效?
- 如何传播(how):消息队列、轮询、事件总线?
- 传播多快(how fast):秒级、分钟级,还是更久?
7.2 主动失效 vs 被动失效
被动失效(TTL):
- 优点:实现简单,零代码侵入
- 缺点:不一致窗口等于 TTL,TTL 太长不一致太久,TTL 太短缓存命中率降低
主动失效(事件驱动):
- 优点:不一致窗口极小(毫秒到秒级)
- 缺点:需要消息基础设施,有丢失消息的风险
最佳实践:两者结合
// 本地缓存:短 TTL(10s)+ 主动失效
Cache<String, User> localCache = Caffeine.newBuilder()
    .expireAfterWrite(10, TimeUnit.SECONDS)  // TTL 兜底
    .build();

// Redis 缓存:长 TTL(1h)+ 主动失效
redis.setex(key, 3600, value);

// 主动失效:通过消息传播
public void invalidateCache(String key) {
    localCache.invalidate(key);     // 本地立即失效
    redis.del(key);                 // Redis 立即失效
    mq.send("cache-invalidate", key);  // 通知其他实例
}
7.3 大规模失效传播的挑战
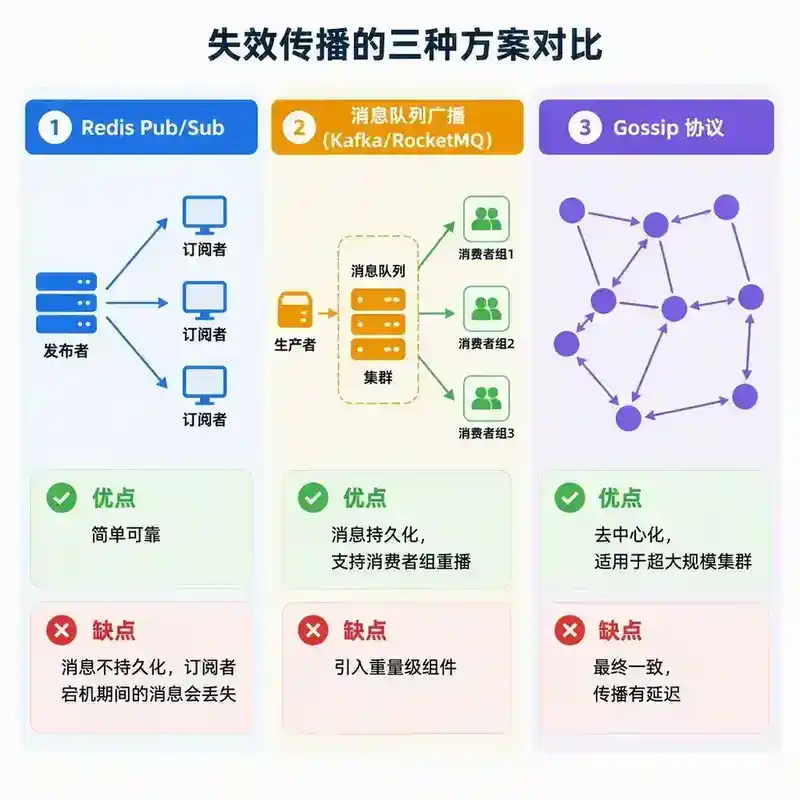
在 1000 个实例的集群中,一条消息要传播到所有实例并让它们删除本地缓存:
- Redis Pub/Sub:简单可靠,但消息不持久化,订阅者宕机期间的消息会丢失
- Kafka/RocketMQ:消息持久化,支持消费者组重播,但引入的重量级组件
- Gossip 协议:去中心化,每个节点随机向其他节点传播,最终一致,适用于超大集群
8. 实战:拼装一个多级缓存架构
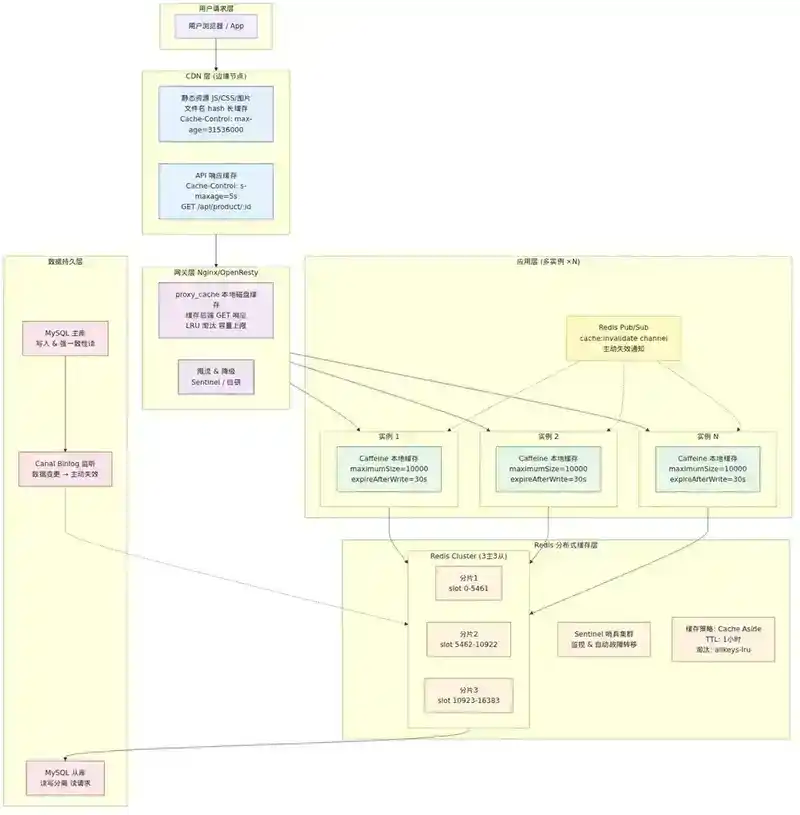
8.1 架构总览
下面是一个典型的电商商品详情页多级缓存架构:
┌─────────────────────────────────────────────────┐
│                    CDN 层                         │
│  静态资源(JS/CSS/图片): 文件名 hash + 长缓存       │
│  API 响应: s-maxage=5s                           │
└─────────────────────────────────────────────────┘
                        │
                        ▼
┌─────────────────────────────────────────────────┐
│                Nginx / Gateway                   │
│  基于 URL 的本地缓存 (proxy_cache / OpenResty)    │
└─────────────────────────────────────────────────┘
                        │
                        ▼
┌─────────────────────────────────────────────────┐
│              应用实例 (×N)                        │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐       │
│  │ Caffeine │  │ Caffeine │  │ Caffeine │       │
│  │本地缓存   │  │本地缓存   │  │本地缓存   │       │
│  └──────────┘  └──────────┘  └──────────┘       │
│       │              │              │            │
│       └──────────────┼──────────────┘            │
│                      │                           │
│              Pub/Sub 失效通知                     │
└─────────────────────────────────────────────────┘
                        │
                        ▼
┌─────────────────────────────────────────────────┐
│              Redis 分布式缓存                      │
│  ┌──────────────────────────────────────┐       │
│  │  Cluster Mode: 3 主 3 从, 分片存储    │       │
│  └──────────────────────────────────────┘       │
│  Sentinel: 自动故障转移                           │
└─────────────────────────────────────────────────┘
                        │
                        ▼
┌─────────────────────────────────────────────────┐
│                MySQL 数据库                       │
│  主从架构: 读写分离                               │
│  Canal 监听 Binlog → 主动失效缓存                  │
└─────────────────────────────────────────────────┘
8.2 关键代码实现
多级缓存读取器:
@Component
public class MultiLevelCache {

    private final Cache<String, Object> localCache;
    private final StringRedisTemplate redis;
    private final JdbcTemplate db;

    // 多级缓存读取:本地 → Redis → DB
    public <T> T get(String key, Class<T> type, Function<String, T> dbLoader) {
        // L1: 本地缓存
        Object localValue = localCache.getIfPresent(key);
        if (localValue != null) {
            return type.cast(localValue);
        }

        // L2: Redis
        String redisValue = redis.opsForValue().get(key);
        if (redisValue != null) {
            T result = JSON.parseObject(redisValue, type);
            localCache.put(key, result);  // 回填 L1
            return result;
        }

        // L3: 数据库
        T dbResult = dbLoader.apply(key);
        if (dbResult != null) {
            // 回填 L2 和 L1
            redis.opsForValue().set(key, JSON.toJSONString(dbResult),
                1, TimeUnit.HOURS);
            localCache.put(key, dbResult);
        }
        return dbResult;
    }

    // 失效传播
    public void invalidate(String key) {
        localCache.invalidate(key);  // 本地立即失效
        redis.delete(key);           // Redis 立即失效
        // 通过 Pub/Sub 通知其他实例
        redis.convertAndSend("cache:invalidate", key);
    }
}
8.3 多级缓存的数据流
以商品详情页为例:
- 用户请求
GET /product/12345 - CDN:检查是否缓存了该 API 响应,有则直接返回(5s TTL)
- Nginx:
proxy_cache检查是否缓存了后端响应,有则返回 - 应用本地缓存:Caffeine 查询
product:12345,命中率约 95% - Redis:
GET product:12345,命中率约 99%(本地未命中的 5% 中大部分命中) - MySQL:
SELECT * FROM product WHERE id=12345,最终数据源
假设各级命中率:
- 本地缓存命中率 95%,延时 0.01ms
- Redis 命中率 99%(在本地未命中的 5% 中),延时 1ms
- DB 命中率 100%(最后兜底),延时 50ms
综合平均延时 = 0.95 × 0.01 + 0.05 × 0.99 × 1 + 0.05 × 0.01 × 50 ≈ 0.084ms
而如果只用 Redis:平均延时 ≈ 1ms。如果只用 DB:平均延时 ≈ 50ms。
多级缓存将平均延时降低了约 12 倍(对比 Redis),约 600 倍(对比 DB)。
9. 性能度量与监控
9.1 关键指标
一个好的多级缓存系统需要监控以下指标:
| 指标 | 含义 | 目标值 |
|---|---|---|
| 本地缓存命中率 | 命中的请求 / 总请求 | > 90% |
| Redis 命中率 | keyspace_hits / (hits + misses) | > 95% |
| 缓存穿透率 | 穿透到 DB 的请求 / 总请求 | < 1% |
| 失效传播延迟 | 数据变更到所有副本失效的时间 | < 1s |
| 缓存内存占用 | 各级缓存的内存使用量 | < 阈值 |
| 热 Key 数量 | 被频繁访问的 key 数量 | 监控趋势 |
9.2 Caffeine 的监控
Cache<String, Object> cache = Caffeine.newBuilder()
    .recordStats()
    .build();

// 定期输出统计
ScheduledExecutorService scheduler = Executors.newScheduledThreadPool(1);
scheduler.scheduleAtFixedRate(() -> {
    CacheStats stats = cache.stats();
    log.info("缓存命中率: {:.2f}%, 命中: {}, 未命中: {}, 淘汰: {}",
        stats.hitRate() * 100,
        stats.hitCount(),
        stats.missCount(),
        stats.evictionCount());
}, 1, 1, TimeUnit.MINUTES);
9.3 Redis 的监控
# 实时监控
redis-cli --stat

# 查看命中率
redis-cli INFO stats | grep keyspace

# 查看内存
redis-cli INFO memory | grep used_memory_human

# 查看大 Key
redis-cli --bigkeys

# 查看热 Key(Redis 6.0+)
redis-cli --hotkeys
10. 常见陷阱与反模式
10.1 缓存无过期时间
设置了缓存但没设过期时间,导致:
- 内存无限增长,最终 OOM
- 数据永远不更新,读到的永远是旧数据
正确做法:每个缓存 key 都必须有明确的 TTL,即使你认为"这个数据不会变"。
10.2 缓存 null 时间过长
缓存空值是为了防止缓存穿透,但如果 null 缓存时间过长,新写入的数据在缓存过期前无法被读到。
正确做法:null 缓存 TTL 设置为 30-60 秒,远短于正常数据的 TTL。
10.3 缓存预热不当
新实例启动后,本地缓存为空,首批请求全部穿透到 Redis 和 DB,造成启动风暴。
正确做法:实例启动时从 Redis 批量加载热点数据到本地缓存,或者等流量自然涌入(依赖 Redis 的缓冲能力)。
10.4 本地缓存未设置最大容量
使用 ConcurrentHashMap 做本地缓存但不设上限,导致内存泄漏。
正确做法:始终使用 Caffeine/Guava 并设置 maximumSize 或 maximumWeight。
10.5 多级缓存的一致性问题被忽略
本地缓存 TTL 设了 1 小时,数据更新后 1 小时内不同实例返回不同数据。
正确做法:本地缓存 TTL 不超过 30 秒,或配合主动失效机制。
11. 面试官提问
以下问题模拟技术专家/架构师面试的真实考察视角,不限于本文内容,请独立作答。
Q1:你设计了一个三级缓存架构(Caffeine → Redis → MySQL),其中 Caffeine TTL 设为 30s,Redis TTL 设为 1h。现在有一个商品价格从 100 元改为 80 元,请问:在没有任何主动失效机制的情况下,用户最多需要多久才能看到新价格?如果你希望用户 1 秒内看到新价格,你会怎么设计?
Q2:Caffeine 的 W-TinyLFU 和 Redis 的 LFU 淘汰策略有什么区别?为什么 Caffeine 不用纯 LFU 而需要引入 Window 区?
Q3:一个每秒 10 万 QPS 的热点 key 突然过期了,大量请求打到数据库。请描述你的完整应对方案,包括短期止血和长期优化。如果这个 key 的数据每 5 分钟会更新一次,你的方案会有什么变化?
Q4:CDN 缓存了一个 API 响应(**s-maxage=10s**),在 10 秒内后端数据发生了变化。有没有办法让 CDN 立即感知到变化并刷新?如果不依赖 CDN 刷新,你还有什么其他方案保证用户看到最新数据?
Q5:1000 个应用实例,每个实例都有本地缓存。如何保证一条数据变更消息能可靠地到达所有实例并使本地缓存失效?如果消息中间件出现了故障,你有没有降级方案?
Q6:请对比以下三种缓存更新策略的优缺点,并说明各自适用的场景:Cache Aside、Read/Write Through、Write Behind。在电商下单场景中,库存扣减应该用哪种?为什么?
Q7:布隆过滤器在解决缓存穿透时有一个天然缺陷——无法删除元素。如果业务需要删除布隆过滤器中的元素,你有什么替代方案?各自的代价是什么?
本文是「Java 技术专家 / 架构师面试:250 个高频考点」系列的第 145 篇。下一篇:消息队列与事件驱动。