阅读时间:约 45 分钟 | 难度:中高级 | 知识点编号:139 适用场景:Redis 缓存故障排查、高并发系统设计、技术面试
一、问题定义:缓存的"不可能三角"
缓存是分布式系统中最常用的性能优化手段,它通过空间换时间的策略,将热点数据存储在高速存储介质中,从而减少对数据库的直接访问。但缓存并非万能的"银弹"——当缓存未能按预期工作时,系统不仅无法享受缓存的收益,反而可能因为流量直接打到数据库而引发连锁故障。
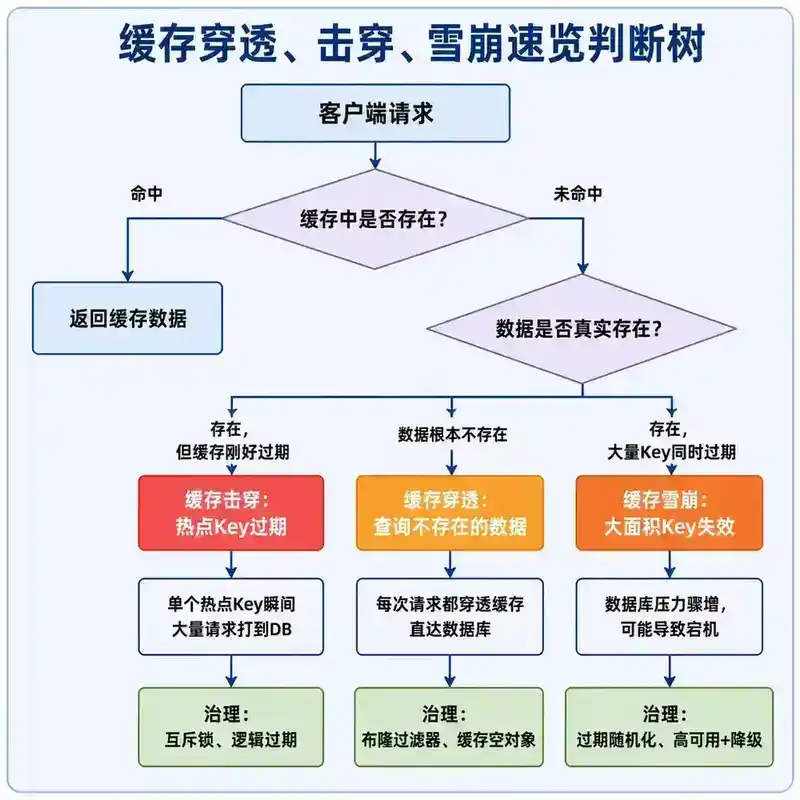
在 Redis 缓存体系中,有三个经典问题被称为"缓存三兄弟":缓存穿透、缓存击穿、缓存雪崩。它们虽然名字相似,但根因和治理手段差异巨大。本文将逐一深入剖析。
在开始之前,先用一句话区分这三个概念:
- 缓存穿透:查询一个根本不存在的数据,缓存和数据库都没有
- 缓存击穿:一个热点 key 在过期的瞬间,大量并发请求同时打到数据库
- 缓存雪崩:大量 key 在同一时间窗口内过期,或缓存服务整体宕机
核心类比:把缓存想象成防洪大坝。穿透是水流从大坝底下渗过去(数据不存在),击穿是大坝上出现一个洞(一个热点 key 失效),雪崩是整个大坝垮塌(大量 key 同时失效或缓存服务挂掉)。
二、缓存穿透:查询不存在的数据
2.1 问题描述
缓存穿透是指查询一个数据库中根本不存在的数据。由于缓存不会存储不存在的数据(常规做法是缓存未命中就查 DB,DB 返回空也不写缓存),所以每次请求都会穿透缓存,直接打到数据库。
攻击场景:恶意攻击者可以构造大量不存在的数据 ID(如负数的用户 ID、超长的订单号),发起海量请求,瞬间击垮数据库。
典型流量特征:
- 数据库中查询结果为空,但 QPS 极高
- 缓存命中率异常偏低
- 数据库 CPU 飙升,连接池耗尽
2.2 治理方案
方案一:缓存空对象(Cache Null Value)
最直接的方案:当数据库查询返回空结果时,也将这个"空"结果缓存起来,并设置一个较短的过期时间(如 1-5 分钟)。
public User getUserById(Long id) {
    String cacheKey = "user:" + id;
    User user = redis.get(cacheKey);
    if (user != null) {
        return user == NULL_PLACEHOLDER ? null : user;
    }
    user = db.queryById(id);
    if (user == null) {
        redis.set(cacheKey, NULL_PLACEHOLDER, 300, TimeUnit.SECONDS);
    } else {
        redis.set(cacheKey, user, 1800, TimeUnit.SECONDS);
    }
    return user;
}
优点:实现简单,立即生效。 缺点:
- 大量不存在的 key 会占用缓存内存(需要设置短过期时间缓解)
- 如果攻击者不断变换不存在的 ID,缓存依然会被占满
方案二:布隆过滤器(Bloom Filter)
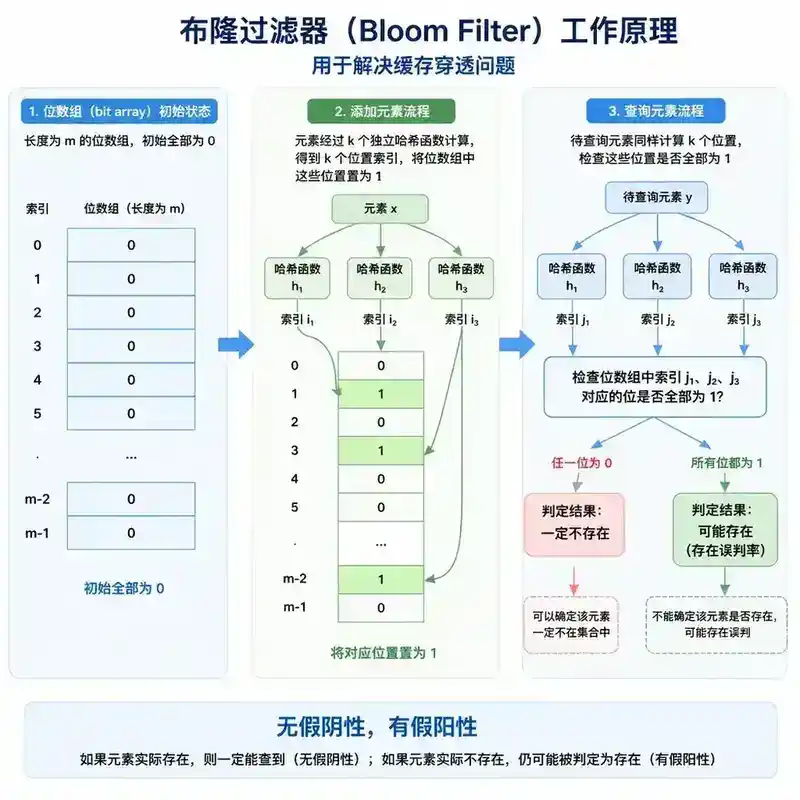
布隆过滤器是解决缓存穿透最优雅的方案。它是一种空间效率极高的概率性数据结构,用于判断一个元素是否可能存在于集合中。
核心特性:
- 如果布隆过滤器说"不存在",则元素一定不存在(无假阴性)
- 如果布隆过滤器说"存在",则元素可能不存在(有假阳性,即误判)
工作原理:
- 初始化一个长度为 m 的 bit 数组,所有位设为 0
- 对于每个元素,使用 k 个独立的哈希函数计算 k 个位置,将这些位置设为 1
- 查询时,同样计算 k 个位置,如果所有位都为 1,则判定"可能存在";如果任一位为 0,则判定"一定不存在"
关键参数计算:
- 误判率 p 与 bit 数组长度 m、哈希函数个数 k、元素个数 n 的关系:
- m = -n × ln(p) / (ln(2))²
- k = (m / n) × ln(2)
Redis 布隆过滤器实操:
// 使用 Redisson 的布隆过滤器
RBloomFilter<Long> bloomFilter = redisson.getBloomFilter("user:bloom");
// 初始化:预计 1000 万用户,误判率 0.01
bloomFilter.tryInit(10_000_000L, 0.01);

// 预热:将所有存在的用户 ID 加入布隆过滤器
List<Long> allUserIds = db.queryAllUserIds();
allUserIds.forEach(bloomFilter::add);

// 查询时先过布隆过滤器
public User getUserById(Long id) {
    if (!bloomFilter.contains(id)) {
        return null; // 一定不存在,直接返回
    }
    // 可能存在,继续查缓存和数据库
    String cacheKey = "user:" + id;
    User user = redis.get(cacheKey);
    if (user != null) return user;
    user = db.queryById(id);
    if (user != null) {
        redis.set(cacheKey, user, 1800, TimeUnit.SECONDS);
    }
    return user;
}
布隆过滤器的局限性:
- 不能删除元素(计数布隆过滤器可以,但空间开销更大)
- 需要预估数据规模,初始化后扩容需要重建
- 数据新增时需要同步更新布隆过滤器
方案三:请求参数校验
在网关层或业务层对请求参数进行基础校验,过滤掉明显非法的请求:
// 网关层拦截
if (id <= 0 || id > MAX_VALID_ID || String.valueOf(id).length() > 10) {
    return Response.fail("非法请求参数");
}
这种方案成本最低,但只能拦截明显的恶意请求,无法应对 ID 格式合法但实际不存在的情况。
方案四:增强型方案——布隆过滤器 + 缓存空对象
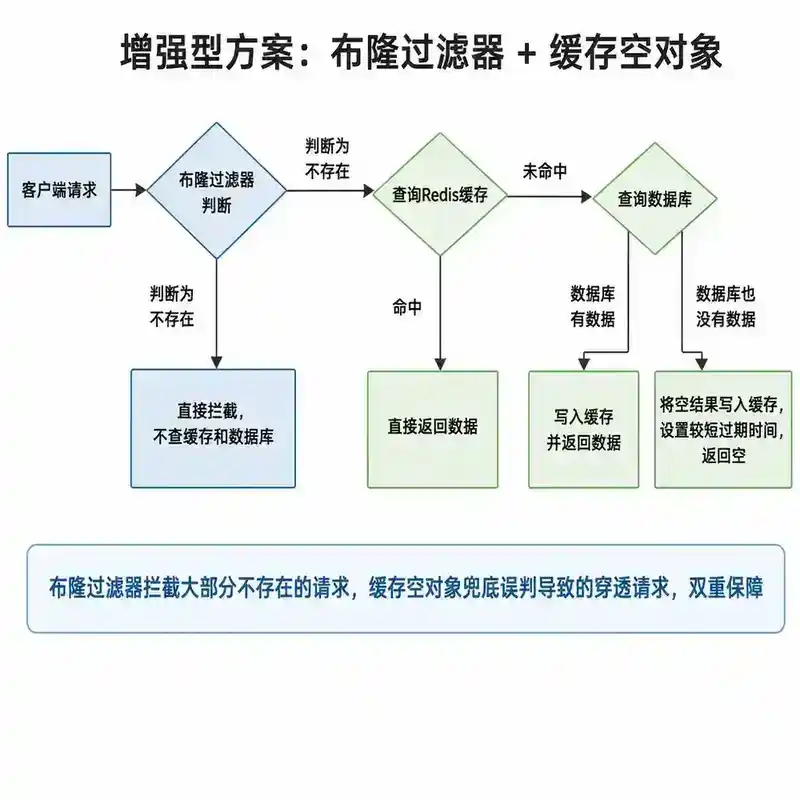
将两种方案结合使用:
请求 → 布隆过滤器(不存在则直接返回)→ 缓存(命中则返回)→ 数据库(空则缓存空对象)
布隆过滤器拦截大部分不存在的数据,缓存空对象处理布隆过滤器误判导致穿透到 DB 的请求,双重保障。
三、缓存击穿:热点 Key 过期
3.1 问题描述
缓存击穿是指一个热点 key(高并发访问的 key)在过期的瞬间,大量并发请求同时穿透缓存,直接打到数据库,造成数据库压力骤增。
典型场景:
- 秒杀活动的商品详情缓存过期
- 爆款文章的缓存恰好失效
- 定时任务批量刷新缓存,导致短暂的"缓存真空"
关键特征:问题集中在单个 key,而非大面积 key。
3.2 治理方案
方案一:互斥锁(Mutex Lock)——最常用
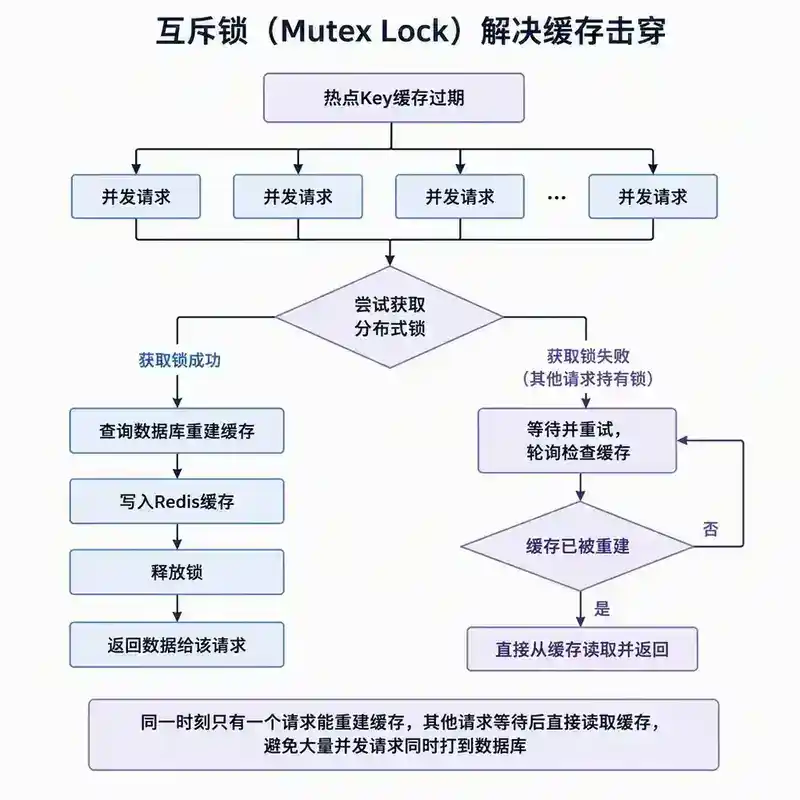
当缓存失效时,不是所有请求都去查数据库,而是用分布式锁保证只有一个请求去加载数据,其他请求等待锁释放后从缓存中读取。
public User getHotUser(Long id) {
    String cacheKey = "user:" + id;
    User user = redis.get(cacheKey);
    if (user != null) return user;

    // 互斥锁:同一时刻只有一个线程能重建缓存
    String lockKey = "lock:user:" + id;
    String lockValue = UUID.randomUUID().toString();
    try {
        // 自旋等待获取锁,最多等待 10 秒
        while (!redis.setnx(lockKey, lockValue, 10, TimeUnit.SECONDS)) {
            // 等待期间再次检查缓存是否已被其他线程重建
            user = redis.get(cacheKey);
            if (user != null) return user;
            Thread.sleep(50);
        }

        // 获取锁成功,再次检查缓存(双重检查)
        user = redis.get(cacheKey);
        if (user != null) return user;

        // 重建缓存
        user = db.queryById(id);
        if (user != null) {
            redis.set(cacheKey, user, 1800, TimeUnit.SECONDS);
        }
        return user;
    } finally {
        // 释放锁(用 Lua 脚本保证原子性)
        String lua = "if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) else return 0 end";
        redis.eval(lua, Collections.singletonList(lockKey), Collections.singletonList(lockValue));
    }
}
关键细节:
- 双重检查:获取锁后再次检查缓存,防止重复加载
- 锁超时:防止获取锁的线程挂掉导致死锁
- 原子释放:用 Lua 脚本保证只有锁的持有者才能释放锁
- 自旋 + 等待:等待期间轮询缓存,一旦缓存被重建立即返回
方案二:逻辑过期(永不过期 + 异步刷新)
给热点 key 设置一个逻辑过期时间(存储在 value 中),而非依赖 Redis 的物理过期。当发现逻辑过期时,返回旧值,同时异步启动一个线程去刷新缓存。
@Data
static class CacheWrapper<T> {
    private T data;             // 实际数据
    private long expireAt;      // 逻辑过期时间戳(毫秒)
}

public User getHotUserLogical(Long id) {
    String cacheKey = "user:" + id;
    CacheWrapper<User> wrapper = redis.get(cacheKey);
    if (wrapper == null) {
        // 缓存不存在,同步加载
        return loadAndCache(id);
    }
    if (wrapper.getExpireAt() > System.currentTimeMillis()) {
        return wrapper.getData(); // 未过期,直接返回
    }
    // 逻辑过期,异步刷新
    String lockKey = "lock:user:" + id;
    if (redis.setnx(lockKey, "1", 10, TimeUnit.SECONDS)) {
        threadPool.submit(() -> {
            try {
                User user = db.queryById(id);
                CacheWrapper<User> newWrapper = new CacheWrapper<>();
                newWrapper.setData(user);
                newWrapper.setExpireAt(System.currentTimeMillis() + 1800_000);
                redis.set(cacheKey, newWrapper);
            } finally {
                redis.del(lockKey);
            }
        });
    }
    // 返回旧值,保证可用性
    return wrapper.getData();
}
优点:完全不阻塞用户请求,体验最优。 缺点:短时间内可能返回旧数据,不适合一致性要求极高的场景。
方案三:Redis 4.0+ 的 LFU 淘汰策略
配置 Redis 使用 LFU(Least Frequently Used)淘汰策略,让真正的热点 key 不容易被淘汰:
maxmemory-policy volatile-lfu
配合 OBJECT FREQ 命令可以查看 key 的访问频率:
redis> OBJECT FREQ hotkey
(integer) 127
但这只是辅助手段,无法完全避免击穿问题。
四、缓存雪崩:大面积失效
4.1 问题描述
缓存雪崩是指在同一时间窗口内,大量缓存的 key 同时过期,或者 Redis 服务整体宕机,导致所有请求直接打到数据库,引发数据库崩溃,进而导致整个服务不可用。
触发条件:
- 同时过期:大量 key 设置了相同的过期时间,在某一时刻集中失效
- Redis 宕机:Redis 服务不可用,所有缓存查询失败
- Redis 集群抖动:主从切换、网络分区等导致短暂不可用
雪崩的连锁反应:
大量缓存过期 → 数据库压力骤增 → 数据库响应变慢 → 请求积压 → 连接池耗尽
→ 服务线程阻塞 → 上游服务超时 → 级联故障 → 整个系统雪崩
4.2 治理方案
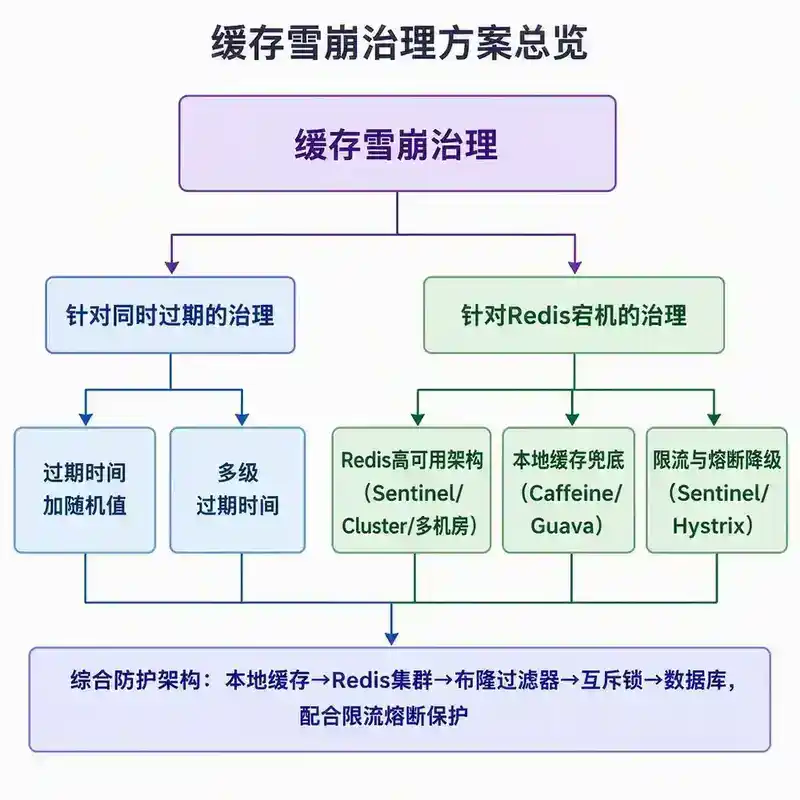
4.2.1 针对"同时过期"的治理
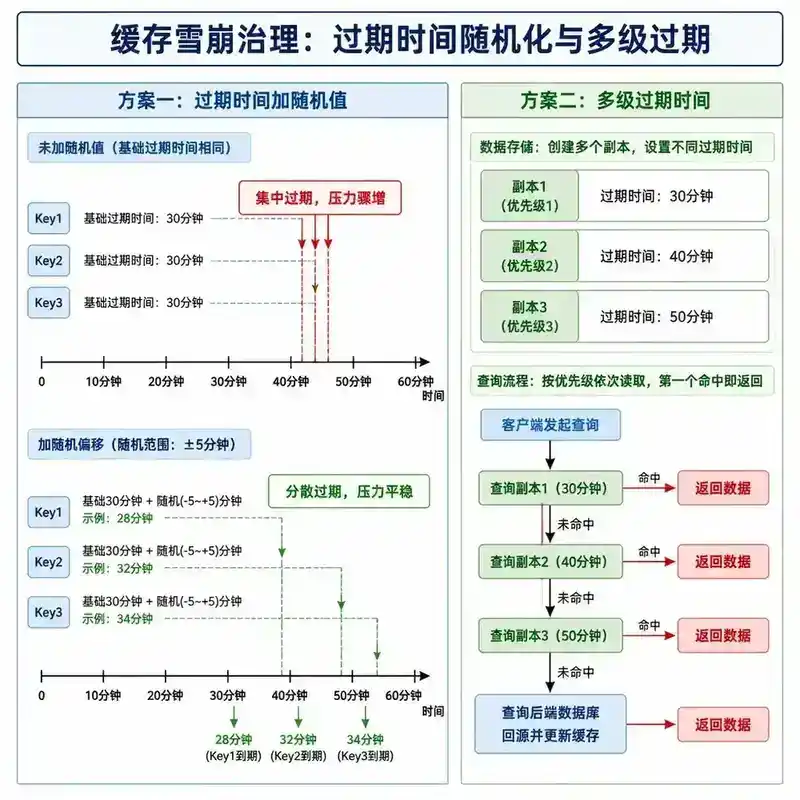
方案一:过期时间加随机值
给每个 key 的过期时间加上一个随机偏移量,避免集中过期:
public void setWithRandomExpire(String key, Object value, long baseSeconds, long randomRange) {
    long actualExpire = baseSeconds + ThreadLocalRandom.current().nextLong(randomRange);
    redis.set(key, value, actualExpire, TimeUnit.SECONDS);
}

// 使用示例:基础 30 分钟,随机偏移 ±5 分钟
setWithRandomExpire("user:" + id, user, 1800, 600);
方案二:多级过期时间
对热点数据设置多个不同过期时间的副本:
// 同一份数据,不同过期时间
redis.set("user:" + id + ":t1", user, 1800, TimeUnit.SECONDS);  // 30 分钟
redis.set("user:" + id + ":t2", user, 2400, TimeUnit.SECONDS);  // 40 分钟
redis.set("user:" + id + ":t3", user, 3000, TimeUnit.SECONDS);  // 50 分钟
查询时按优先级读取,第一个命中即返回。
4.2.2 针对"Redis 宕机"的治理
方案一:Redis 高可用架构
- Redis Sentinel:主从 + 哨兵自动故障转移
- Redis Cluster:分片集群,单节点故障不影响整体
- 多机房部署:异地多活或同城双活
方案二:本地缓存兜底
在应用层增加一层本地缓存(如 Caffeine、Guava Cache),当 Redis 不可用时,降级使用本地缓存:
// Caffeine 本地缓存作为兜底
private final Cache<String, User> localCache = Caffeine.newBuilder()
    .maximumSize(10_000)
    .expireAfterWrite(60, TimeUnit.SECONDS)
    .build();

public User getUserWithFallback(Long id) {
    String cacheKey = "user:" + id;
    try {
        User user = redis.get(cacheKey);
        if (user != null) {
            localCache.put(cacheKey, user); // 更新本地缓存
            return user;
        }
    } catch (Exception e) {
        log.warn("Redis 不可用,降级使用本地缓存", e);
    }
    // 从本地缓存读取
    User user = localCache.getIfPresent(cacheKey);
    if (user != null) return user;
    // 本地缓存也未命中,查数据库
    user = db.queryById(id);
    if (user != null) {
        localCache.put(cacheKey, user);
    }
    return user;
}
方案三:限流与熔断降级
当下游数据库压力过大时,通过限流和熔断保护数据库:
// Sentinel 限流 + 熔断
@SentinelResource(value = "getUser", fallback = "getUserFallback")
public User getUser(Long id) {
    // 正常的缓存+数据库查询逻辑
}

public User getUserFallback(Long id, Throwable t) {
    // 降级逻辑:返回兜底数据或空对象
    log.warn("查询用户触发降级, id={}", id);
    return new User(id, "默认用户", "系统繁忙,请稍后重试");
}
4.2.3 综合防护架构
请求 → 本地缓存 → Redis 集群 → 布隆过滤器 → 互斥锁 → 数据库
                ↑ 失败降级       ↑ 穿透防护   ↑ 击穿防护
        ↓ 限流熔断(Sentinel / Hystrix 保护数据库)
五、对比总结
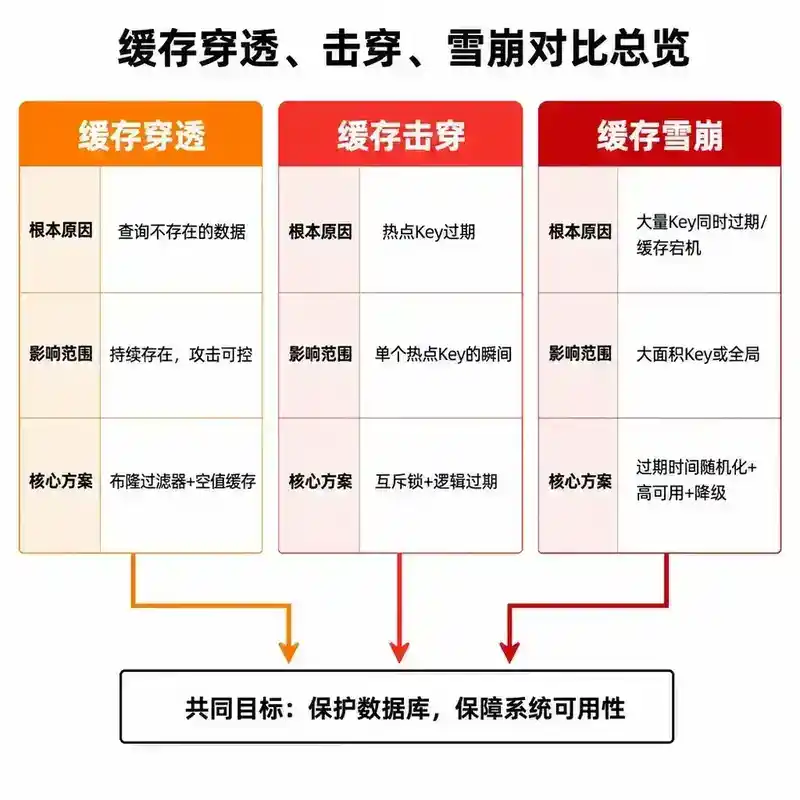
| 维度 | 缓存穿透 | 缓存击穿 | 缓存雪崩 |
|---|---|---|---|
| 根本原因 | 查询不存在的数据 | 热点 key 过期 | 大量 key 同时过期 / 缓存宕机 |
| 影响范围 | 持续存在,攻击可控 | 单个热点 key 的瞬间 | 大面积 key 或全局 |
| 典型表现 | 缓存命中率低,数据库 QPS 高 | 某个 key 过期瞬间 DB 压力骤增 | 数据库压力瞬间飙升,可能宕机 |
| 核心方案 | 布隆过滤器 + 空值缓存 | 互斥锁 + 逻辑过期 | 过期时间随机化 + 高可用 + 降级 |
| 预防难度 | 中等 | 较低 | 较高 |
| 恢复速度 | 快(按需过滤) | 快(重建单个 key) | 慢(需全部重建或恢复服务) |
六、生产实践:一个真实故障案例
6.1 故障背景
某电商平台大促期间,商品详情页出现大面积超时。排查发现:
- 现象:数据库 CPU 从 30% 飙升至 95%,连接池耗尽,大量请求超时
- 时间线:凌晨 2:00 缓存预热脚本执行,2:10 大量缓存同时过期,流量打到数据库
- 根因:缓存的 5000 个商品 key 都设置了 3600 秒过期时间,且预热脚本在同一时刻批量写入,导致这些 key 在 1 小时后同时过期
6.2 应急处理
- 立即扩容:数据库临时扩容,增加连接数
- 限流降级:对商品详情接口实施限流,非核心商品返回静态页面
- 手动预热:紧急执行缓存预热脚本,重建热点缓存
6.3 长效治理
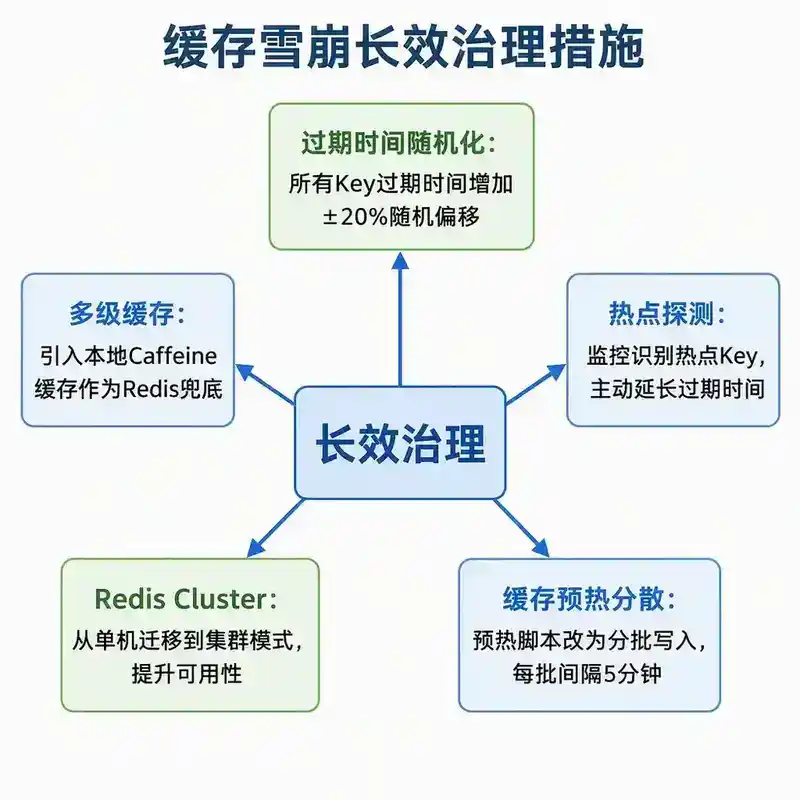
- 过期时间随机化:所有 key 的过期时间增加 ±20% 的随机偏移
- 多级缓存:引入本地 Caffeine 缓存作为 Redis 的兜底
- 热点探测:通过监控识别热点 key,主动延长其过期时间
- Redis Cluster:从单机 Redis 迁移到 Cluster 模式,提升可用性
- 缓存预热分散:预热脚本改为分批写入,每批间隔 5 分钟
七、面试追问与参考答案
Q1:布隆过滤器误判率怎么算?实际项目中你设置了多大?
参考答案:布隆过滤器的误判率 p ≈ (1 - e<sup>-kn/m</sup>)<sup>k</sup>。实际项目中,我根据预期数据量 n 和可接受的误判率 p 来计算 m 和 k。例如,预计 1000 万用户,误判率 0.01(1%),则 m ≈ 9585 万位 ≈ 11.4 MB,k ≈ 7。Redisson 的 RBloomFilter 提供了 tryInit(expectedInsertions, falseProbability) 方法,底层自动计算这些参数。
Q2:缓存穿透的"缓存空对象"方案有什么风险?如何应对?
参考答案:主要风险有两个。一是内存消耗——大量不存在的 key 会占用宝贵的缓存内存,需要设置较短的过期时间(如 1-5 分钟)来缓解。二是一致性问题——如果数据后来被创建了,但缓存的空对象还没过期,会导致短时间内查询不到新数据。解决方案是:在数据创建时主动删除对应的空对象缓存,或者使用布隆过滤器替代空对象缓存。
Q3:互斥锁方案中,如果获取锁的线程在执行数据库查询时挂了怎么办?
参考答案:给锁设置超时时间(如 10 秒),超过时间自动释放。还需要注意:锁的 value 必须是一个唯一标识(如 UUID),释放锁时用 Lua 脚本判断 value 是否匹配,防止误删其他线程的锁。如果数据库查询超过锁的超时时间,需要延长锁的过期时间(续期机制),类似于 Redisson 的 WatchDog 机制。
Q4:逻辑过期方案和互斥锁方案如何选择?
参考答案:逻辑过期方案用户体验更好——请求不阻塞,直接返回旧数据,但可能返回过期数据,适合对一致性要求不高的场景(如新闻资讯、商品详情)。互斥锁方案保证数据一致性——请求可能阻塞等待,但返回的一定是最新数据,适合对一致性要求高的场景(如库存、余额)。实际上,两者可以结合:对一致性要求高的场景用互斥锁,对可用性要求高的场景用逻辑过期。
Q5:Redis 宕机导致雪崩,除了高可用架构还有什么手段?
参考答案:第一,本地缓存兜底——Caffeine/Guava 作为二级缓存,Redis 不可用时降级使用。第二,限流熔断——Sentinel/Hystrix 保护数据库,防止流量击穿。第三,服务降级——非核心功能直接返回兜底数据,保证核心链路可用。第四,热点数据预热到 CDN 或 Nginx 缓存层,减少对 Redis 的依赖。第五,定期演练——通过混沌工程(Chaos Engineering)定期演练 Redis 宕机场景,验证降级方案的有效性。
八、延伸阅读
- 《Redis 设计与实现》——黄健宏
- Redis 官方文档:Key Eviction(https://redis.io/docs/manual/eviction/)
- 布隆过滤器论文:Bloom, B. H. (1970). "Space/Time Trade-offs in Hash Coding with Allowable Errors"
- 阿里技术博客:缓存穿透、击穿、雪崩的深度解析
- Redisson 官方文档:RBloomFilter 使用指南
本文是"Java 技术专家与架构师面试:250 个高频考点"系列的第 139 篇,下一篇将探讨【缓存与数据库一致性:Cache Aside、延迟双删、订阅 binlog 与最终一致】。