1. 从单机到集群:为什么需要 Redis Cluster
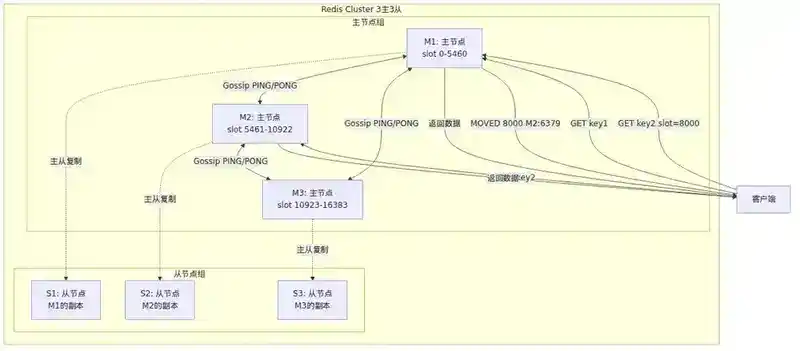
1.1 单机 Redis 的天花板
Redis 以高性能著称,单实例轻松达到 10 万 QPS。但现实是残酷的——任何单机都有物理极限:
| 瓶颈维度 | 具体表现 | 典型阈值 |
|---|---|---|
| 内存 | 数据量超过物理内存,无法继续存储 | 通常 32GB~256GB |
| CPU | 单线程处理命令,CPU 成为瓶颈 | 单核跑满 |
| 网络带宽 | 网卡吞吐量达到上限 | 10Gbps/25Gbps |
| 磁盘 I/O | RDB/AOF 持久化时的 IO 压力 | 取决于磁盘性能 |
当业务数据量增长到 TB 级别,或 QPS 达到百万级别,单机 Redis 就无能为力了。你可能会想:主从 + Sentinel 能不能解决?
1.2 主从 + Sentinel 的局限
Sentinel 方案解决的是高可用问题——主节点挂了自动切换。但它的致命缺陷是:所有数据都在一台机器上。
┌──────────────────────────────────────┐
│         Sentinel 高可用架构           │
│                                      │
│   ┌──────┐    ┌──────┐    ┌──────┐  │
│   │Master│───▶│Slave1│    │Slave2│  │
│   │ 64GB │    │ 64GB │    │ 64GB │  │
│   └──────┘    └──────┘    └──────┘  │
│                                      │
│   总容量 = 64GB(不是 192GB)         │
│   从节点只是副本,不扩大容量           │
└──────────────────────────────────────┘
三个节点各 64GB,总容量仍然是 64GB——因为从节点只是主节点的副本。Sentinel 让你的系统"不挂",但没法让你的系统"装得下更多数据"。
分片(Sharding) 是唯一的出路。
1.3 分片的基本思想
分片的核心思想朴素而强大:把数据打散,分散到多台机器上,每台只存一部分。
客户端分片(传统方案):         Redis Cluster(官方方案):
┌──────────┐                   ┌──────────────────────────┐
│  客户端   │                   │   Redis Cluster           │
│  ┌────┐  │                   │  ┌────┐ ┌────┐ ┌────┐   │
│  │路由│  │  ← 客户端负责     │  │N1  │ │N2  │ │N3  │   │
│  │逻辑│  │     数据路由      │  │0-5K│ │5K- │ │10K-│   │
│  └────┘  │                   │  │槽  │ │10K │ │16K │   │
│  /  \    │                   │  └────┘ └────┘ └────┘   │
│ ▼    ▼   │                   │   ↑ 服务端路由 + 重定向  │
│ R1   R2  │                   └──────────────────────────┘
└──────────┘
客户端分片的问题很明显:客户端需要感知所有节点,扩容时客户端配置也要改。Redis Cluster 的解决方案是:把路由逻辑内建到服务端,客户端只需连接任意一个节点,服务端通过重定向告诉客户端正确的目标节点。
1.4 Redis Cluster vs 其他方案
| 方案 | 架构 | 优点 | 缺点 |
|---|---|---|---|
| 客户端分片 | 客户端维护路由表 | 简单直接 | 客户端耦合,扩容困难 |
| Proxy 方案(Twemproxy/Codis) | 中间代理层路由 | 客户端无感 | 多一跳,代理层需高可用 |
| Redis Cluster | 服务端去中心化路由 | 官方原生,无中间层 | 客户端需支持,有功能限制 |
Redis Cluster 的选择是去中心化——没有 Proxy,没有中心协调节点,集群中的每个节点都是对等的。这是一个大胆的架构决策,带来了极高的可扩展性,也带来了复杂的分布式问题。
2. 哈希槽:16384 个槽位如何撑起整个集群
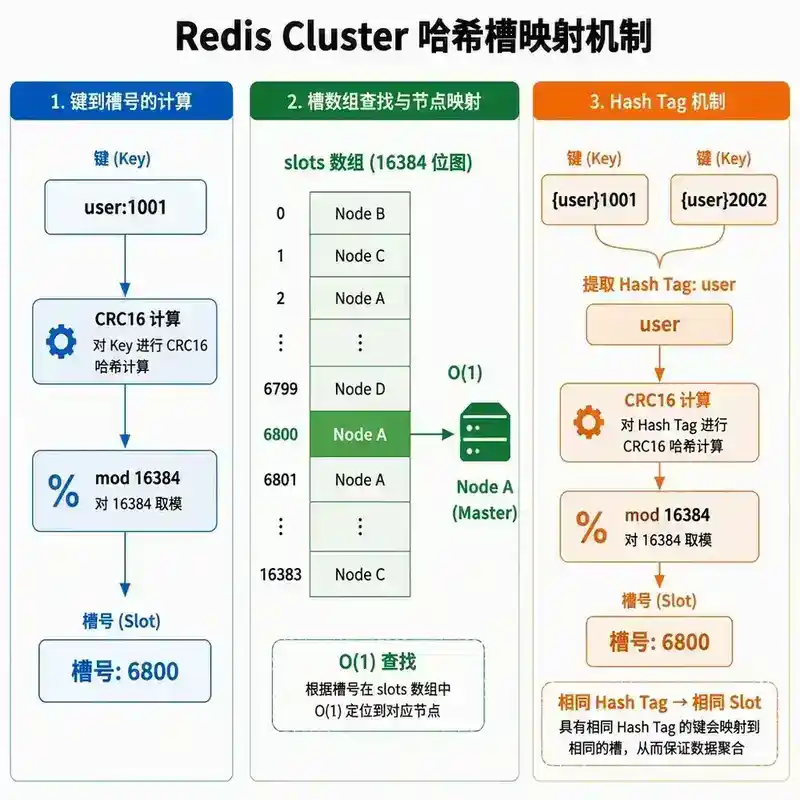
2.1 槽位映射:为什么是 16384?
Redis Cluster 将整个键空间划分为 16384 个哈希槽(Hash Slot)。每个 key 通过 CRC16 哈希后对 16384 取模,确定属于哪个槽:
HASH_SLOT = CRC16(key) mod 16384
每个槽被分配给一个主节点,一个主节点可以持有多个槽。槽是 Redis Cluster 中数据迁移和路由的最小单位。
为什么偏偏是 16384?
这个数字是精心计算的。Redis 作者 antirez 给出的理由:
- 心跳消息大小:节点间通过 Gossip 协议交换槽位信息,心跳包中需要携带本节点的槽位位图(bitmap)。16384 个槽 = 16384 bits = 2048 bytes = 2KB。如果选 65536,心跳包中位图就膨胀到 8KB,在 1000 个节点的集群中,PING 消息会变得巨大。
- CRC16 输出范围:CRC16 的输出是 0~65535,完全覆盖 16384 个槽有余量。
- 节点数上限:Redis 官方建议集群节点数不超过 1000。16384 / 1000 ≈ 16 个槽/节点,粒度足够细。
- 网络包大小友好:2KB 的位图在 TCP 传输中不会造成碎片。
一句话总结:16384 是心跳包大小、节点规模、槽粒度三者之间的最优平衡点。
2.2 槽位分配与查看
在集群中,槽位的分配是手动完成的(或通过 redis-cli 的 cluster addslots 命令):
# 创建 3 主 3 从的集群
redis-cli --cluster create \
  192.168.1.1:6379 192.168.1.2:6379 192.168.1.3:6379 \
  192.168.1.4:6379 192.168.1.5:6379 192.168.1.6:6379 \
  --cluster-replicas 1

# 查看槽位分布
redis-cli -h 192.168.1.1 -p 6379 cluster nodes
# 输出示例:
# 节点ID ... 192.168.1.1:6379@16379 master - 0 1234567890 1 connected 0-5460
# 节点ID ... 192.168.1.2:6379@16379 master - 0 1234567890 2 connected 5461-10922
# 节点ID ... 192.168.1.3:6379@16379 master - 0 1234567890 3 connected 10923-16383
每个节点输出中 connected 后面跟着它负责的槽位范围。0-5460 表示该节点负责第 0 到 5460 共 5461 个槽。
2.3 键到槽的精确计算
Redis Cluster 支持 Hash Tag 机制,让你可以控制哪些 key 落在同一个槽:
# 普通 key:对整个 key 做 CRC16
user:1001        → CRC16("user:1001") % 16384 → 槽位 X

# Hash Tag:只对 {} 中的部分做 CRC16
user:{1001}:name → CRC16("1001") % 16384 → 槽位 Y
user:{1001}:age  → CRC16("1001") % 16384 → 槽位 Y(同一槽!)
Hash Tag 的实现细节:Redis 会查找 key 中第一个 { 和第一个 } 之间的内容,如果两者都存在且 } 在 { 之后,则只对 {} 内的部分计算哈希。如果 {} 之间为空或格式不对,则回退到对整个 key 计算。
// Redis 源码中的 keyHashSlot 实现(简化版)
unsigned int keyHashSlot(char *key, int keylen) {
    int s, e; // {} 的起止下标

    for (s = 0; s < keylen; s++)
        if (key[s] == '{') break;

    // 没有找到 '{',对整个 key 计算哈希
    if (s == keylen) return crc16(key, keylen) & 0x3FFF;

    for (e = s+1; e < keylen; e++)
        if (key[e] == '}') break;

    // 没有找到 '}' 或 {} 之间为空,对整个 key 计算哈希
    if (e == keylen || e == s+1) return crc16(key, keylen) & 0x3FFF;

    // 只对 {} 之间的部分计算哈希
    return crc16(key+s+1, e-s-1) & 0x3FFF;
}
& 0x3FFF 等价于 % 16384,因为 16384 = 2^14,而 0x3FFF = 16383。
2.4 槽位在节点内部的数据结构
每个 Redis Cluster 节点在内存中维护一个 clusterState 结构,其中包含:
typedef struct clusterState {
    clusterNode *myself;              // 本节点
    dict *nodes;                      // 所有节点(key=节点ID, value=clusterNode)
    clusterNode *slots[16384];        // 槽→节点映射(核心!O(1)查找)
    // ...
} clusterState;

typedef struct clusterNode {
    char name[40];                    // 节点ID(40字符随机hex串)
    int flags;                        // 节点状态标志
    unsigned char slots[16384/8];     // 本节点负责的槽位位图
    int numslots;                     // 负责的槽位数量
    // ...
} clusterNode;
核心数据结构:slots[16384] 数组,每个元素指向负责该槽的 clusterNode。这意味着判断一个 key 属于哪个节点,只需要两次操作:
CRC16(key) % 16384→ 槽号server.cluster->slots[槽号]→ 目标节点
时间复杂度 O(1),没有任何遍历。
3. Gossip 协议:去中心化集群的通信基石
3.1 为什么选择 Gossip
Redis Cluster 是去中心化架构——没有 ZooKeeper、没有 etcd、没有中心配置节点。每个节点独立维护集群状态。如何在去中心化的前提下,让所有节点对集群状态达成一致?
答案就是 Gossip 协议(流言协议)。
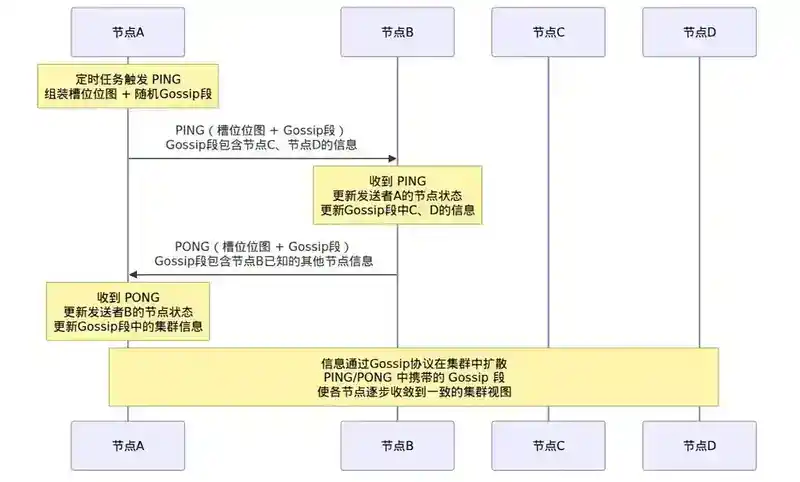
Gossip 协议的核心思想:每个节点周期性地随机选择几个其他节点,交换彼此知道的信息。就像办公室里的八卦——A 告诉 B,B 告诉 C,最终所有人都知道了。
3.2 消息类型:MEET、PING、PONG、FAIL、PUBLISH
Redis Cluster 的 Gossip 协议定义了五种消息类型:
| 消息类型 | 方向 | 用途 |
|---|---|---|
| MEET | 发送给指定节点 | 邀请一个新节点加入集群。类似"你好,加入我们吧" |
| PING | 发送给随机节点 | 心跳检测 + 交换集群状态信息。类似"我还在,这是我知道的节点信息" |
| PONG | 回复 PING/MEET | 响应心跳 + 交换集群状态信息。类似"收到,这是我知道的节点信息" |
| FAIL | 广播给所有节点 | 宣布某个节点已确认下线。类似"大家注意,X 节点挂了!" |
| PUBLISH | 广播给所有节点 | 传播 Pub/Sub 消息(集群模式下客户端可能连接任意节点) |
3.3 PING/PONG 消息的内部结构
每个 PING/PONG 消息的 body 包含两部分:
┌──────────────────────────────────────────────────┐
│                PING/PONG 消息头                    │
│  ┌────────────────────────────────────────────┐  │
│  │ 发送者节点ID、currentEpoch、configEpoch     │  │
│  │ 发送者负责的槽位位图(2048 bytes)          │  │
│  │ 发送者节点的主从关系信息                     │  │
│  └────────────────────────────────────────────┘  │
│                                                    │
│  ┌────────────────────────────────────────────┐  │
│  │          Gossip 段(最多 1/10 节点数)       │  │
│  │  ┌──────┐ ┌──────┐ ┌──────┐                │  │
│  │  │节点A │ │节点B │ │节点C │  ...           │  │
│  │  │状态  │ │状态  │ │状态  │                │  │
│  │  └──────┘ └──────┘ └──────┘                │  │
│  └────────────────────────────────────────────┘  │
└──────────────────────────────────────────────────┘
Gossip 段是随机选择的(发送者随机选几台它知道的节点,报告它们的状态)。这是 Gossip 协议的核心——我不是只告诉你我的状态,我还告诉你"我听说 XXX 的状态是 YYY"。
3.4 PING 发送时机与频率
每个节点每秒执行 10 次 clusterCron(),在其中:
- 随机 PING:随机选一个节点发送 PING。如果距离上次 PONG 超过
cluster-node-timeout/2(默认 7.5 秒),则优先选这个节点。 - Gossip 段填充:从已知节点中随机选
min(节点总数/10, 3)个节点,把它们的状态信息填入 Gossip 段。同时会确保包含那些长时间未更新的节点信息。 - PFAIL 超时检测:检查每个已知节点,如果距离上次收到 PONG 超过
cluster-node-timeout(默认 15 秒),标记为 PFAIL(疑似下线)。
// clusterCron 中的简化逻辑
void clusterCron(void) {
    // 1. 随机选节点发 PING,优先选超时的
    clusterNode *node = /* 随机选一个节点 */;
    if (node->ping_sent && now - node->ping_sent > timeout/2) {
        // 优先 ping 这个节点
    }
    clusterSendPing(node);

    // 2. 检查所有节点是否超时
    for (each known node) {
        if (now - node->pong_received > cluster_node_timeout) {
            node->flags |= PFAIL;  // 标记疑似下线
        }
    }
}
3.5 状态收敛速度
Gossip 协议的收敛是指数级的。假设集群有 N 个节点,每个节点每次随机选 k 个节点交换信息,那么:
- 一轮后,每个节点的新信息被 k 个节点知道
- 二轮后,被约 k² 个节点知道
- 经过 O(log N) 轮,所有节点达成一致
对于一个 100 个节点的集群,信息传播到所有节点大约需要 1~2 秒。这也是为什么 cluster-node-timeout 不能设得太小——要给 Gossip 留出足够的传播时间。
3.6 配置纪元(configEpoch)
在分布式系统中,"谁拥有这个槽"是一个关键的一致性决策。Redis Cluster 使用 配置纪元(configEpoch) 来解决冲突。
每次发生故障转移,新主节点的 configEpoch 会递增。槽位归属的冲突按 configEpoch 大者胜出 的规则解决。这确保了:
- 网络分区恢复后,旧主不会"夺回"槽位(因为它的 configEpoch 更小)
- 手工故障转移也能正确覆盖
configEpoch 与 currentEpoch 的区别:
currentEpoch:集群逻辑时钟,每次选举都递增,全局递增configEpoch:节点配置版本,仅在节点晋升为主节点时更新为该时刻的 currentEpoch
4. 客户端重定向:MOVED 与 ASK 的完整故事
4.1 为什么需要重定向
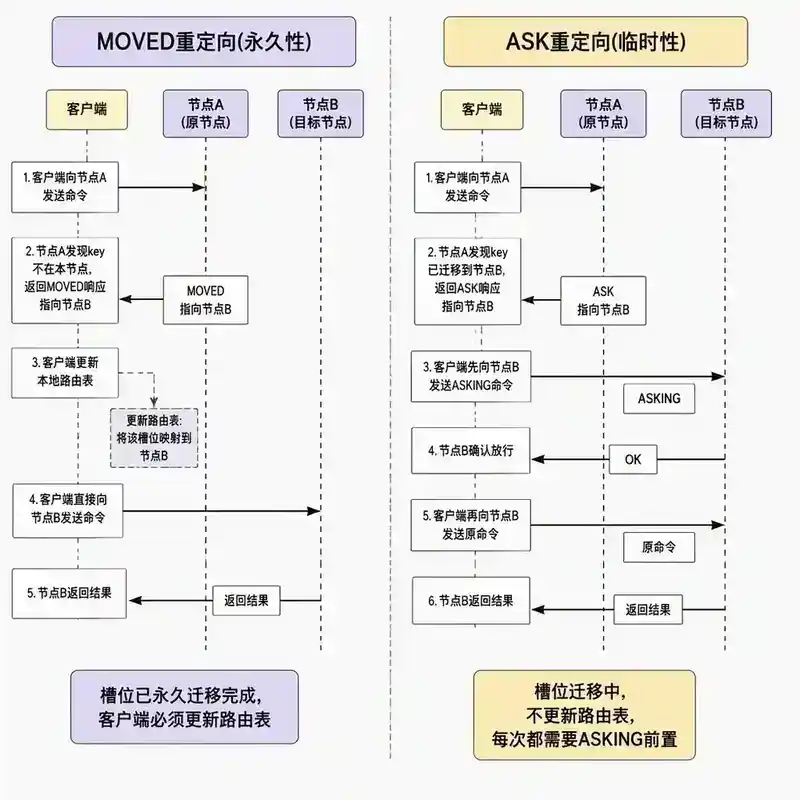
Redis Cluster 中,每个节点只知道一部分数据。当客户端向一个节点发送命令,而该 key 不在这个节点上时,节点不会代理请求——它直接返回一个重定向响应,告诉客户端"你去 XX 节点找"。
客户端                    节点A(槽 0-5000)           节点B(槽 5001-10000)
  │                           │                          │
  │ SET user:9000 "alice"    │                          │
  │─────────────────────────▶│                          │
  │                           │ user:9000 → 槽 8000     │
  │                           │ 不归我管!               │
  │ MOVED 8000 192.168.1.2:6379                         │
  │◀─────────────────────────│                          │
  │                           │                          │
  │ SET user:9000 "alice"    │                          │
  │─────────────────────────────────────────────────────▶│
  │                           │                          │ OK
  │◀─────────────────────────────────────────────────────│
  │                           │                          │
4.2 MOVED 重定向:永久性重定向
场景:key 的槽位归属已经稳定,只是客户端路由表过时了。
- MOVED 8000 192.168.1.2:6379
收到 MOVED 后,客户端应该:
- 更新本地路由表(槽 8000 → 192.168.1.2:6379)
- 向新节点重新发送命令
关键:MOVED 的语义是"永久性"的——槽位已经迁移完成,未来这个槽的所有请求都应该发给新节点。客户端必须更新路由表,否则每次都要多一次重定向。
4.3 ASK 重定向:临时性重定向
场景:槽位正在迁移中,部分 key 已经迁到目标节点,但槽位归属尚未正式切换。
- ASK 8000 192.168.1.2:6379
ASK 与 MOVED 的关键区别:
| 维度 | MOVED | ASK |
|---|---|---|
| 语义 | 槽位已永久迁移 | 槽位正在迁移中 |
| 路由表更新 | 必须更新 | 不更新 |
| 后续请求 | 直接发给新节点 | 先发给原节点,再次 ASK 才跳转 |
| 前置操作 | 无需 | 必须先发 ASKING 命令 |
ASKING 命令的必要性:目标节点收到 ASK 重定向的请求时,正常情况下会拒绝(因为槽位还不归它管)。客户端必须先发送 ASKING 命令,告诉目标节点"我收到了 ASK 重定向,请破例处理后续这条命令"。
客户端                    节点A(槽迁移中)          节点B(槽迁移中)
  │                           │                          │
  │ GET user:9000             │                          │
  │─────────────────────────▶│                          │
  │                           │ key 已迁到 B            │
  │ -ASK 8000 192.168.1.2:6379                          │
  │◀─────────────────────────│                          │
  │                           │                          │
  │ ASKING                    │                          │
  │─────────────────────────────────────────────────────▶│
  │                           │                          │ OK
  │ GET user:9000             │                          │
  │─────────────────────────────────────────────────────▶│
  │                           │                          │ "alice"
  │◀─────────────────────────────────────────────────────│
  │                           │                          │
4.4 客户端实现:Smart Client
现代 Redis 客户端(JedisCluster、Lettuce、redis-py-cluster)都实现了 Smart Client 模式:
Smart Client 内部结构:
┌─────────────────────────────────────┐
│          JedisCluster               │
│  ┌───────────────────────────────┐  │
│  │     槽位路由表(本地缓存)      │  │
│  │  slot 0-5460   → 192.168.1.1 │  │
│  │  slot 5461-10922 → 192.168.1.2│  │
│  │  slot 10923-16383 → 192.168.1.3│ │
│  └───────────────────────────────┘  │
│  ┌───────────────────────────────┐  │
│  │     连接池(每节点一个)        │  │
│  │  [Pool:1.1] [Pool:1.2] [Pool:1.3] │
│  └───────────────────────────────┘  │
│                                      │
│  流程:                              │
│  1. key → CRC16 → slot → 路由表查节点│
│  2. 从对应连接池取连接,发送命令      │
│  3. 收到 MOVED → 更新路由表 → 重试   │
│  4. 收到 ASK  → 发 ASKING → 重试     │
└─────────────────────────────────────┘
Lettuce 的集群拓扑刷新机制:
- 定期刷新(默认 30 秒)
- 收到 MOVED 重定向时触发刷新
- 连接断开时触发刷新
- 通过
CLUSTER NODES或CLUSTER SLOTS命令获取最新拓扑
4.5 一种特殊情况:MOVED 和 ASK 都不适用于的事务
如果你在集群模式下执行 MULTI 事务,但事务中的 key 分布在多个节点,会发生什么?
Redis Cluster 不支持跨节点事务。如果事务中的命令涉及多个节点,客户端需要在发送 EXEC 之前检查所有 key 是否在同一节点。如果不在同一节点,客户端通常直接报错。
这就是为什么需要 Hash Tag——让多个 key 落在同一个槽(同一个节点),从而支持事务操作。
5. 数据迁移与扩缩容:在线不停机操作
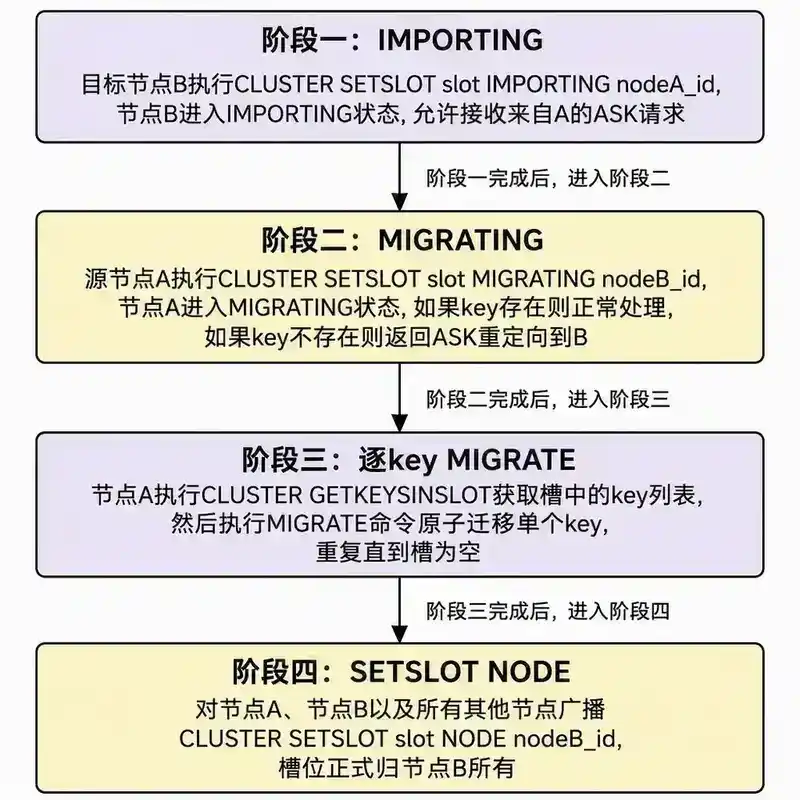
5.1 槽迁移的全流程
Redis Cluster 的扩缩容本质上是槽的重新分配。核心操作是 CLUSTER SETSLOT 和 MIGRATE 命令。
一个槽从节点 A 迁移到节点 B 的完整流程:
阶段 1:目标节点准备接收
  节点B: CLUSTER SETSLOT <slot> IMPORTING <nodeA_id>
  → 节点B 进入 IMPORTING 状态,允许接收来自 A 的 ASK 请求

阶段 2:源节点准备迁出
  节点A: CLUSTER SETSLOT <slot> MIGRATING <nodeB_id>
  → 节点A 进入 MIGRATING 状态:
    - 如果 key 存在:正常处理
    - 如果 key 不存在:返回 -ASK 重定向到 B

阶段 3:逐 key 迁移
  节点A: CLUSTER GETKEYSINSLOT <slot> <count>  → 获取槽中的 key 列表
  节点A: MIGRATE <host> <port> <key> 0 <timeout>  → 原子迁移单个 key
  重复直到槽为空

阶段 4:槽位归属切换
  对节点A和B以及所有其他节点(广播):
  CLUSTER SETSLOT <slot> NODE <nodeB_id>
  → 槽位正式归 B 所有
5.2 MIGRATE 命令的原子性
MIGRATE 是 Redis 中最强大的命令之一,它在源节点上原子地执行:
- 序列化 key 的 value 和 TTL
- 发送到目标节点
- 目标节点执行
RESTORE - 目标节点返回 OK 后,源节点删除 key
整个过程在源节点是阻塞的(对单个 key 而言),但阻塞时间极短(毫秒级)。对于大 key,MIGRATE 会阻塞较长时间,生产环境需要特别注意。
# MIGRATE 命令格式
MIGRATE 192.168.1.2 6379 "" 0 5000 KEYS key1 key2 key3

# 参数说明:
# 192.168.1.2 6379 → 目标节点地址
# "" → 目标数据库(空密码)
# 0 → 目标数据库编号
# 5000 → 超时时间(毫秒)
# KEYS key1 key2 → 要迁移的 key 列表
5.3 在线扩容操作步骤
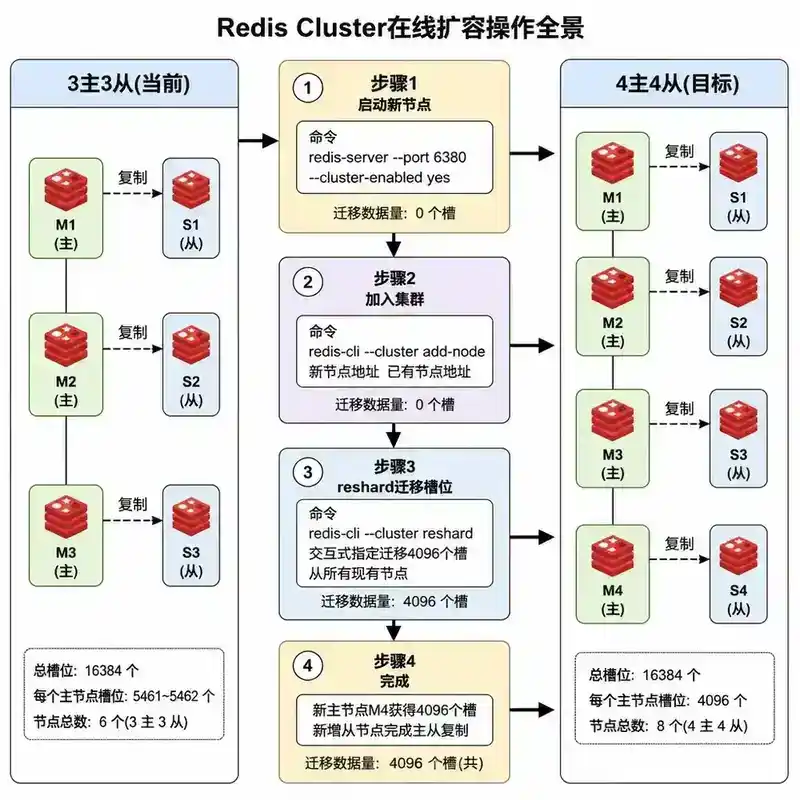
假设现有 3 主 3 从集群,扩容到 4 主 4 从

步骤 1:启动新节点
  redis-server --port 6380 --cluster-enabled yes --cluster-config-file nodes-6380.conf

步骤 2:将新节点加入集群
  redis-cli --cluster add-node 192.168.1.4:6380 192.168.1.1:6379

步骤 3:为新节点添加从节点(可选)
  redis-cli --cluster add-node 192.168.1.5:6381 192.168.1.1:6379 --cluster-slave --cluster-master-id <新主节点ID>

步骤 4:重新分配槽位
  redis-cli --cluster reshard 192.168.1.1:6379
  # 交互式输入:
  # How many slots do you want to move? 4096
  # What is the receiving node ID? <新主节点ID>
  # Source node? all  (从所有现有节点各匀一部分)
reshard 内部会循环执行:
CLUSTER SETSLOT IMPORTING/MIGRATINGCLUSTER GETKEYSINSLOT+MIGRATECLUSTER SETSLOT NODE
整个过程在线进行,不影响其他槽的读写。
5.4 迁移过程中的一致性保证
在槽迁移期间,集群如何保证数据一致性?
场景分析:槽 8000 正在从 A 迁移到 B,key user:9000 还在 A 上。
客户端请求 GET user:9000:
  → 路由表可能指向 A 或 B(取决于客户端刷新时间)

  情况 1:请求到达 A
    - key 在 A 上 → 正常返回
    - key 已迁走 → 返回 -ASK 8000 B

  情况 2:请求到达 B
    - B 在 IMPORTING 状态 → 先查本地,没有则返回 -ASK(但 key 在 A)
    - 实际上 B 会返回 -ASK 8000 A(因为 key 还没迁过来)
    - 客户端发 ASKING 到 A → A 正常返回(因为还在 MIGRATING 状态)
关键机制:
IMPORTING状态:节点 B 会接受 ASK 前缀的请求,即使槽位还不归它MIGRATING状态:节点 A 会正常处理仍存在的 key,对不存在的 key 返回 ASKASKING命令:一次性豁免,告诉节点"这次请求是重定向来的,请放行"
5.5 缩容操作
缩容是扩容的逆过程:
# 步骤 1:将待下线节点的槽全部迁出
redis-cli --cluster reshard 192.168.1.1:6379
# 源节点:待下线节点;目标节点:其他节点;数量:该节点的全部槽

# 步骤 2:验证槽位已清空
redis-cli -h 192.168.1.4 -p 6380 cluster nodes | grep "myself"
# 确认该节点 numslots=0

# 步骤 3:从集群中移除节点
redis-cli --cluster del-node 192.168.1.1:6379 <待下线节点ID>
6. 故障检测与自动转移:集群自愈机制
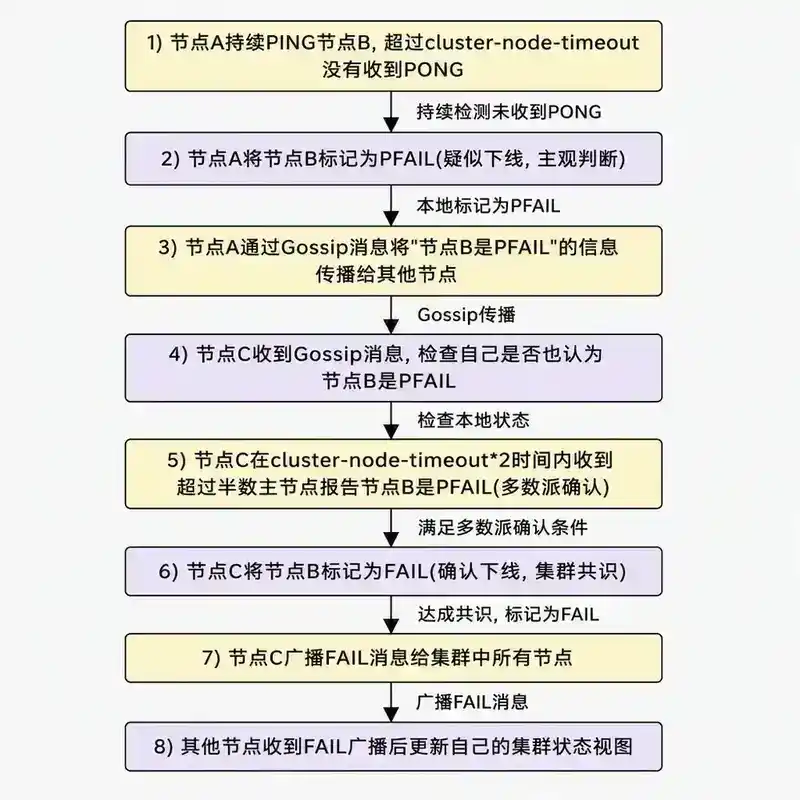
6.1 故障检测:PFAIL → FAIL
Redis Cluster 的故障检测分两步:
第一步:PFAIL(疑似下线) —— 单个节点的主观判断
节点A 持续 PING 节点B,超过 cluster-node-timeout 没有收到 PONG:
  → 节点A 将节点B 标记为 PFAIL
  → PFAIL 是"我怀疑 B 挂了",不是"B 确认挂了"
第二步:FAIL(确认下线) —— 集群多数派的共识
节点A 将节点B 标记为 PFAIL 后:
  → 节点A 在 Gossip 消息中携带"节点B 是 PFAIL"的信息
  → 其他节点收到后,检查自己是否也认为 B 是 PFAIL
  → 如果某个节点(如 C)在 cluster-node-timeout * 2 时间内,
    收到超过半数主节点报告 B 是 PFAIL:
    → 节点C 将 B 标记为 FAIL
    → 节点C 广播 FAIL 消息给所有节点
这里有一个重要细节:不是节点A 发起投票,而是每个收到 PFAIL 信息的节点独立判断。当某个节点发现有足够多的人认为 B 挂了,它就单方面宣布 B 挂了并广播 FAIL。
6.2 故障转移选举
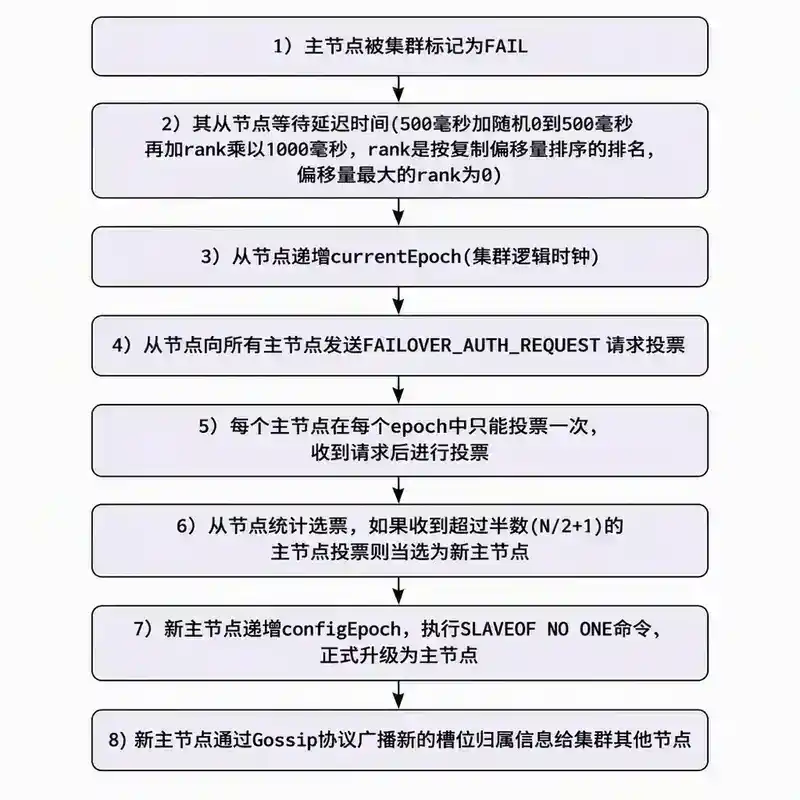
当某个主节点被标记为 FAIL 后,它的从节点会发起选举,选出新的主节点。
选举流程:
1. 从节点发现自己的主节点被标记为 FAIL
2. 从节点等待 cluster-node-timeout * 2 后,发起选举
3. 从节点递增 currentEpoch,向所有主节点发送 FAILOVER_AUTH_REQUEST
4. 每个主节点在每个 epoch 中只能投票一次(先到先得)
5. 从节点收到 ≥ N/2+1 张主节点票 → 当选
6. 新主节点递增 configEpoch,执行 SLAVEOF NO ONE
7. 通过 Gossip 广播新的槽位归属
从节点延迟选举的时间:
- 延迟 =
500ms + random(0, 500ms) + rank * 1000ms rank是按复制偏移量排序的排名(偏移量最大的 rank=0)- 这样设计是为了让数据最新的从节点最优先发起选举
6.3 与 Sentinel 故障转移的对比
| 维度 | Sentinel | Redis Cluster |
|---|---|---|
| 检测机制 | Sentinel 节点 PING Redis | 节点间 PING/PONG |
| 下线判定 | SDOWN → ODOWN(Sentinel 投票) | PFAIL → FAIL(节点间 Gossip) |
| 选举 | Sentinel 之间 Raft-like 选举 Leader,Leader 决定新主 | 从节点直接向主节点拉票 |
| 配置更新 | Sentinel 通知客户端 | 客户端通过 Gossip/MOVED 感知 |
| 外部依赖 | 需要独立 Sentinel 进程 | 无外部依赖,内建 |
6.4 脑裂与防护
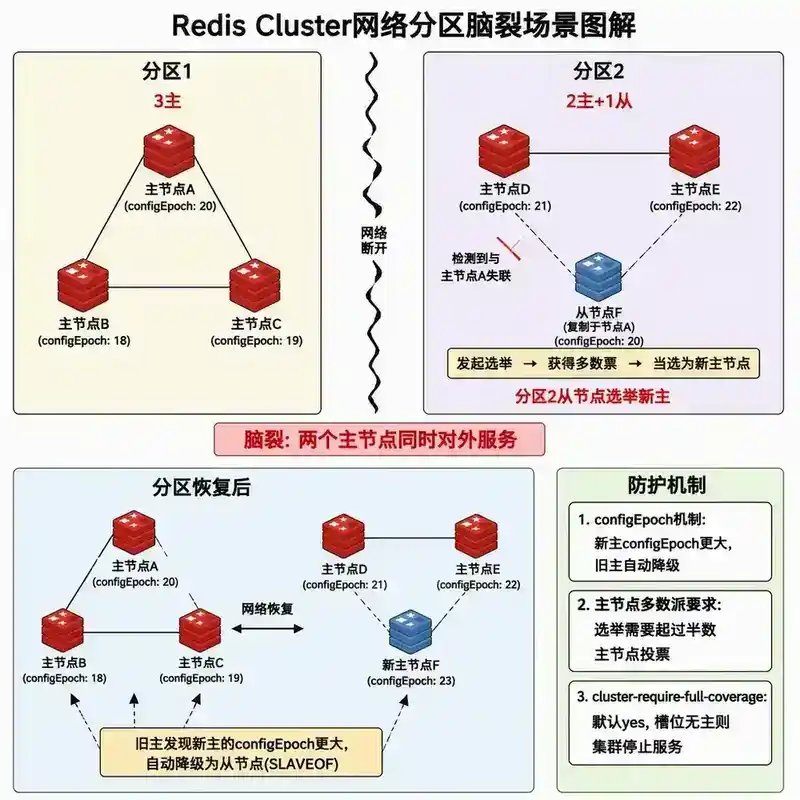
Redis Cluster 在网络分区时也可能发生脑裂:
集群分裂为两个分区:
  分区1:3 主(含主A) + 2 从
  分区2:2 主 + 1 从(主A的从)

分区2 中的从节点发现主A 失联超过 timeout:
  → 发起选举 → 当选为新主A'
  → 两个主A 同时对外服务 → 脑裂!
Redis Cluster 的脑裂防护机制:
- configEpoch 机制:新主A' 的 configEpoch 比旧主A 大,分区恢复后旧主A 发现自己的 configEpoch 更小,自动降级为从节点。
- 主节点多数派要求:选举需要超过半数主节点投票。如果分区中主节点数不足半数,从节点无法当选。
**cluster-require-full-coverage**:默认 yes,如果任何槽位没有主节点,集群停止服务。这可以防止少数派分区提供服务。
7. 集群的边界与限制
7.1 多键操作的局限
Redis Cluster 中,多键命令要求所有 key 在同一个槽。
# 失败:key1 和 key2 可能在不同槽
MGET key1 key2

# 成功:使用 Hash Tag 强制同槽
MGET {user:1001}:name {user:1001}:age
解决方案:对于需要批量操作的场景,使用 Hash Tag 将相关 key 聚合同一槽,或者将批量操作拆分为多次单 key 请求(并行执行)。
7.2 事务与 Lua 脚本的限制
- 事务(MULTI/EXEC):所有命令必须落在同一节点
- Lua 脚本(EVAL):脚本中涉及的所有 key 必须在同一节点
**EVALSHA**:集群中所有节点必须预先加载脚本
7.3 发布订阅(Pub/Sub)的特殊处理
集群模式下,Pub/Sub 不走槽位路由,而是广播到所有节点:
客户端在节点A 发布消息 → 节点A 广播 PUBLISH 到所有节点
→ 订阅该频道的客户端无论在哪个节点都能收到
这意味着 Pub/Sub 在集群中会产生跨节点带宽开销,大集群中 Pub/Sub 可能成为性能瓶颈。
7.4 数据库编号(SELECT)的限制
集群模式只支持 SELECT 0(即只有一个数据库)。多数据库在集群中没有意义,因为数据已经分散在不同节点。
7.5 大集群的规模限制
| 限制项 | 数值 | 原因 |
|---|---|---|
| 最大节点数 | ~1000 | Gossip 消息大小和频率 |
| 最大主节点数 | ~1000 | 同上 |
| 槽位数 | 16384 | 固定,不可变 |
| 单节点最大槽数 | 16384 | 理论上可以 |
8. 生产部署与运维实战
8.1 集群配置参数详解
# redis.conf 集群相关配置

cluster-enabled yes                    # 启用集群模式
cluster-config-file nodes-6379.conf    # 集群状态持久化文件(自动维护)
cluster-node-timeout 15000             # 节点超时时间(毫秒),默认15秒
cluster-slave-validity-factor 10       # 从节点有效性因子
cluster-migration-barrier 1            # 从节点迁移屏障
cluster-require-full-coverage yes      # 是否需要所有槽位都有主节点
cluster-allow-reads-when-down no       # 集群不可用时是否允许读
**cluster-node-timeout**的调优:
- 设得太小(如 3 秒):网络抖动可能导致频繁误判
- 设得太大(如 60 秒):故障转移太慢
- 建议值:15 秒(生产环境)或 5 秒(低延迟内网)
**cluster-slave-validity-factor**:
- 如果从节点与主节点断开时间超过
node-timeout * factor,该从节点不会参与故障转移 - 设为 0 表示永不过期,总是尝试故障转移
8.2 常用运维命令
# 查看集群状态
redis-cli -h 192.168.1.1 -p 6379 cluster info
# 输出:
# cluster_state:ok
# cluster_slots_assigned:16384
# cluster_slots_ok:16384
# cluster_slots_pfail:0
# cluster_slots_fail:0
# cluster_known_nodes:6
# cluster_size:3

# 查看节点详情
redis-cli cluster nodes

# 查看槽位分布
redis-cli cluster slots

# 手动故障转移
redis-cli -h <slave_ip> -p <slave_port> cluster failover
# 选项:
#   FORCE:强制故障转移(不检查主节点状态)
#   TAKEOVER:直接接管(不进行选举,危险!)

# 修复槽位
redis-cli --cluster fix 192.168.1.1:6379

# 检查集群
redis-cli --cluster check 192.168.1.1:6379
8.3 监控关键指标
| 指标 | 来源 | 含义 | 告警阈值 |
|---|---|---|---|
cluster_state |
CLUSTER INFO |
集群状态 | != ok |
cluster_slots_fail |
CLUSTER INFO |
不可用槽位数 | > 0 |
cluster_known_nodes |
CLUSTER INFO |
已知节点数 | 与预期不符 |
| 节点连接状态 | CLUSTER NODES |
节点是否 connected | 出现 disconnected |
instantaneous_ops_per_sec |
INFO stats |
每秒操作数 | 超过容量 80% |
used_memory_rss |
INFO memory |
实际内存使用 | 超过 maxmemory 80% |
repl_offset 差异 |
INFO replication |
主从复制延迟 | 差异过大 |
8.4 常见问题排查
问题 1:**cluster_state:fail**
原因:某些槽位没有节点负责
排查:
  redis-cli cluster nodes  → 检查哪些节点是 fail 状态
  redis-cli --cluster fix  → 尝试自动修复
解决:
  - 如果是主节点挂了从节点没触发故障转移:手动 failover
  - 如果槽位确实无主:手动 CLUSTER ADDSLOTS 或迁移槽位
问题 2:**MOVED**重定向风暴
现象:客户端日志大量 MOVED 错误
原因:路由表过期或刷新不及时
解决:
  - 检查客户端拓扑刷新配置
  - 确保 cluster-node-timeout 设置合理
  - 检查是否有频繁的扩缩容操作
问题 3:数据迁移导致延迟飙升
原因:MIGRATE 大 key 时阻塞主线程
排查:
  redis-cli --bigkeys  → 找出大 key
  SLOWLOG GET 100     → 检查慢日志
解决:
  - 对大 key 先拆分再迁移
  - 在低峰期进行迁移操作
  - 使用 redis-cli --cluster reshard --pipeline 参数加速
9. 面试官视角提问
以下问题从面试官视角设计,考察候选人对 Redis Cluster 的深层理解,而非简单记忆。建议先尝试独立回答,再对照参考答案。
Q1:16384 个槽位,如果集群有 1000 个节点,每个节点平均约 16 个槽。在这种极端情况下,Gossip 消息的位图仍然是 2KB(16384 bits),是否浪费?Redis 为什么不在节点数增多时动态压缩位图?
参考答案:Redis 选择不压缩位图是因为要维持 O(1) 的槽位查找。slots[16384] 数组可以直接通过索引访问,不需要任何解压操作。如果压缩为 [(0, 5460), (5461, 10922)] 这样的范围表示,查找时需要遍历,就从 O(1) 退化到 O(槽段数)。此外,2KB 的位图在现代网络中不算大——1000 个节点每秒 10 次 PING,也就是每秒 20MB 的带宽,对万兆网络来说完全可以接受。这是 Redis 在"简单高效"和"空间最优"之间的经典取舍。
Q2:Redis Cluster 中,槽迁移期间如果源节点宕机,会发生什么?槽位会丢失吗?
参考答案:如果源节点在迁移过程中宕机,情况取决于迁移所处的阶段:
- 如果槽位还在 MIGRATING 状态,且源节点宕机后无法恢复,则已迁移的 key 在目标节点上,未迁移的 key 丢失。这就是为什么 Redis Cluster 要求从节点在迁移过程中保持存活。
- 实践中,
redis-cli --cluster reshard会逐个迁移 key,并且源节点通常有从节点。如果源节点宕机,从节点可以接管,但由于 configEpoch 的关系,这个槽位仍然需要手动处理。 - 这也是为什么在生产环境中,扩缩容操作前必须先确保集群稳定、所有节点都有从节点。
Q3:如果集群中同时挂了两个主节点,会发生什么?为什么?
参考答案:这取决于挂掉的节点是否有从节点:
- 如果两个主节点都有从节点:从节点各自发起选举,正常完成故障转移。两个故障转移可以同时进行,互不影响。
- 如果其中一个主节点没有从节点:该主节点负责的槽位将变成不可用状态,
cluster_state变为fail(如果cluster-require-full-coverage=yes),整个集群拒绝服务。 - 如果两个主节点都没有从节点:同上,集群整体不可用。
但这里有一个微妙之处:如果两个主节点同时挂掉,它们的从节点同时发起选举,是否会因为竞争选票导致选举失败? 不会。因为每个主节点在每个 epoch 中只能投一票,但投票是投给"请求投票的从节点"而非"某个槽的从节点"。两个从节点同时请求不同主节点投票,互不冲突。
Q4:Redis Cluster 的 Gossip 协议中,FAIL 消息是广播的,但 PFAIL 是随 Gossip 消息传播的。为什么 FAIL 不也通过 Gossip 传播,而要单独广播?
参考答案:FAIL 消息需要最快速度传播到所有节点。因为 FAIL 意味着某个主节点被确认下线,其从节点需要立即发起故障转移。如果 FAIL 走 Gossip 传播,可能需要好几轮才能覆盖所有节点,延迟可达数秒。而广播 FAIL 消息可以在一次网络往返中通知所有节点,压缩故障转移的总时间。PFAIL 只是"疑似",不需要紧急处理,用 Gossip 慢慢传播即可——这是一个典型的消息优先级与传播延迟的权衡设计。
Q5:假设你有一个 Redis Cluster,3 主 3 从。你发现某个主节点的内存使用率持续增长,即将达到 maxmemory。你能在不增加新节点的情况下缓解这个问题吗?具体怎么做?
参考答案:可以,通过重新分配槽位来均衡负载。具体步骤:
- 分析槽位的数据分布:
redis-cli --cluster check查看每个节点的 key 数量和内存使用 - 找出内存压力大的节点上的槽位
- 将这些槽位迁移到内存使用较低的节点:
redis-cli --cluster reshard,指定源和目标节点 - 迁移完成后,各节点的内存压力趋于均衡
但要注意:这只是转移数据,总集群容量并没有增加。如果所有节点都快满了,必须加节点扩容。此外,迁移过程中会产生网络开销和短暂阻塞,应在低峰期进行。
Q6:Redis Cluster 为什么选择"服务端重定向"而不是"Proxy 转发"?两种方案各自的优劣是什么?
参考答案:
| 维度 | 服务端重定向(Redis Cluster) | Proxy 转发(Twemproxy/Codis) |
|---|---|---|
| 延迟 | 多一次往返(MOVED) | 多一跳(经过 Proxy) |
| 复杂度 | 客户端需要支持重定向 | 客户端简单,Proxy 复杂 |
| 故障域 | 无额外组件 | Proxy 需要高可用 |
| 扩展性 | 理论上无限 | Proxy 可能成为瓶颈 |
| 运维 | 节点对等,无中心 | 需要管理 Proxy 集群 |
Redis 选择重定向方案的核心原因:去中心化。没有 Proxy 意味着没有额外的故障点,没有额外的性能瓶颈。MOVED 重定向的开销只在客户端路由表过期时发生,稳态下开销为零。而 Proxy 方案的每次请求都要经过 Proxy,即使路由是稳定的。这是一个"稳态零开销" vs "每次请求都有开销"的取舍。
Q7:在生产环境中,如果一个 Redis Cluster 节点因为网络闪断被标记为 FAIL,然后网络恢复,这个节点会怎样?数据会丢失吗?
参考答案:不会丢失。流程如下:
- 节点 A 被标记为 FAIL 后,其从节点 A' 晋升为新主
- 新主 A' 的 configEpoch 递增(比旧主 A 大)
- 网络恢复后,旧主 A 重新加入集群
- 旧主 A 通过 Gossip 发现槽位已被 A' 接管,且 A' 的 configEpoch 更大
- 旧主 A 自动执行
SLAVEOF A',降级为 A' 的从节点 - 旧主 A 会清空自身数据,从新主 A' 全量同步
关键点:旧主 A 在闪断期间写入的数据会丢失(因为它的写入没有复制到从节点),但这是所有异步复制方案的固有特性。如果业务对数据丢失零容忍,需要使用 WAIT 命令或考虑采用强一致方案。
延伸阅读
- Redis Cluster Specification (官方)
- Redis Cluster Tutorial
- Gossip Protocol 论文
- Redis 源码
src/cluster.c和src/cluster.h