阅读时间:约 40-50 分钟 适合人群:Java 高级工程师、技术专家、架构师 前置知识:Redis 基本操作、Redis 核心数据结构
一、引言:Redis 事务的独特定位
当我们在关系型数据库中谈论"事务"时,脑海中浮现的是 ACID——原子性、一致性、隔离性、持久性。一个事务要么全部成功,要么全部回滚,中间状态对外不可见。但 Redis 的事务模型与关系型数据库截然不同,它是一种**"批处理"风格的命令集合**,而非传统意义上的 ACID 事务。
理解这种差异至关重要。许多工程师带着 MySQL 事务的惯性思维去使用 Redis 事务,结果在生产环境中踩坑。
Redis 事务的核心价值在于两点:
- 命令的批量执行:一组命令被序列化,按顺序执行,不会被其他客户端的命令插队。
- 乐观锁:通过 WATCH 机制实现 check-and-set 语义,在竞争不激烈的场景下保证数据一致性。
但在 Redis 7.0 之前,Redis 事务不支持回滚——一条命令执行失败,后续命令仍会继续执行。这颠覆了许多人对"事务"的认知。
二、Redis 事务基础:MULTI/EXEC/DISCARD
2.1 三个核心命令
Redis 事务由三个命令组成:
| 命令 | 作用 |
|---|---|
MULTI |
开启事务,后续命令进入队列 |
EXEC |
执行事务队列中的所有命令 |
DISCARD |
放弃事务,清空队列 |
2.2 事务的执行流程
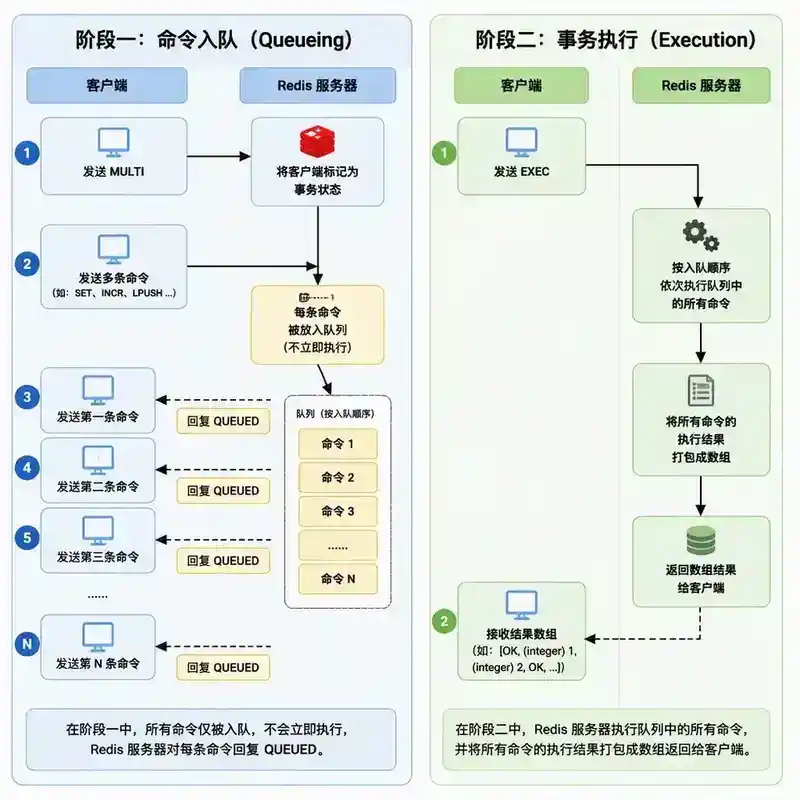
整个事务分为两个阶段:
阶段一:命令入队(Queueing)
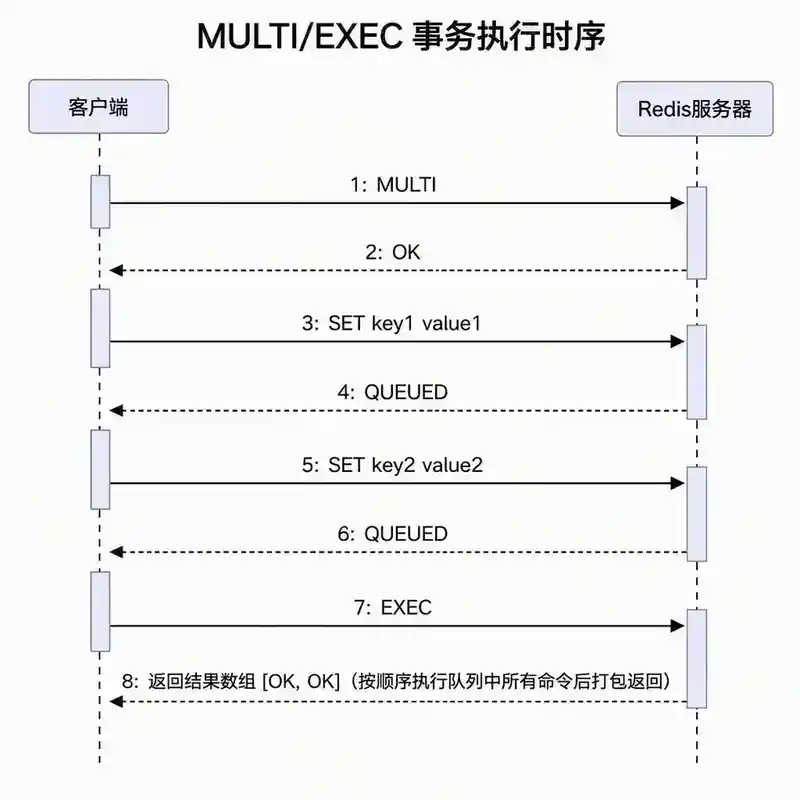
客户端发送 MULTI 后,Redis 服务器将该客户端标记为事务状态。此后客户端发送的每条命令不会被立即执行,而是被放入一个队列中。服务器对每条入队命令回复 QUEUED。
阶段二:事务执行(Execution)
客户端发送 EXEC 后,Redis 服务器按入队顺序依次执行队列中的所有命令,并将所有命令的执行结果打包返回给客户端。
下面是时序图:
2.3 源码视角:事务队列是如何实现的
在 Redis 源码中,每个客户端(client 结构体)维护一个 mstate 字段:
// redis.h / server.h
typedef struct multiState {
    multiCmd *commands;     // 命令队列(数组)
    int count;              // 已入队命令数量
    int minreplicas;        // MINREPLICAS 配置
    time_t minreplicas_timeout;
} multiState;

typedef struct multiCmd {
    robj **argv;            // 命令参数
    int argc;               // 参数个数
    struct redisCommand *cmd; // 指向命令的指针
} multiCmd;
当客户端发送 MULTI 时,flags 被设置为 CLIENT_MULTI。之后每个命令在 processCommand() 中被拦截,调用 queueMultiCommand() 追加到 mstate.commands 数组中。
执行 EXEC 时,call() 函数按顺序遍历 multiCmd 数组,逐条执行。这保证了命令执行期间不会被其他客户端打断,因为 Redis 单线程执行模型天然提供了隔离性。
2.4 事务期间的错误处理
这是 Redis 事务最容易让人困惑的地方。Redis 事务中的错误分为两类:
语法错误(编译时错误)
命令不存在或参数错误——在 queueMultiCommand() 阶段就会被发现。此时:
- 该条错误命令不会入队
- 服务器向客户端返回错误
- 但后续命令仍可继续入队
- 执行
EXEC时,如果队列中还有其他命令,它们会正常执行
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> SET key1 value1
QUEUED
127.0.0.1:6379> WRONGCOMMAND  (不存在的命令)
(error) ERR unknown command
127.0.0.1:6379> SET key2 value2
QUEUED
127.0.0.1:6379> EXEC
1) OK
2) OK
运行时错误
命令语法正确,但在执行时失败——例如对 String 类型执行 LPUSH:
- 错误命令执行失败,但不影响其他命令
- 没有回滚机制——前面已执行的命令不会撤销
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> SET key1 hello
QUEUED
127.0.0.1:6379> LPUSH key1 1 2 3    (key1 是 String 类型)
QUEUED
127.0.0.1:6379> SET key2 world
QUEUED
127.0.0.1:6379> EXEC
1) OK
2) (error) WRONGTYPE Operation against a key holding the wrong kind of value
3) OK
key1 被设置为 hello,key2 被设置为 world,中间那条 LPUSH 报错,但前后两条 SET 都成功了。这就是 Redis 事务"不回滚"的特性。
设计哲学:Redis 作者 Antirez 认为,Redis 事务中的错误几乎都是编程错误,应该在开发阶段被发现。在生产环境中引入回滚机制会显著增加复杂度,而收益有限。这种"简单即正确"的哲学贯穿 Redis 设计始终。
三、WATCH:乐观锁机制
3.1 为什么需要 WATCH
MULTI/EXEC 只能保证命令的隔离执行,但不能保证数据的一致性。考虑经典的转账场景:
账户 A 余额 100,账户 B 余额 0
线程 1:从 A 转 50 到 B
线程 2:从 A 转 30 到 B
如果两个线程几乎同时操作,可能发生:
- 线程 1 读取 A 余额 = 100
- 线程 2 读取 A 余额 = 100
- 线程 1 执行:A = 50, B = 50
- 线程 2 执行:A = 70, B = 30
最终 A 余额 70,B 余额 30(转了 50 又转了 30),但 A 的余额应该是 100 - 50 - 30 = 20!
这就是典型的 check-and-set 问题——需要在读取和写入之间保证数据未被修改。
3.2 WATCH 的工作原理
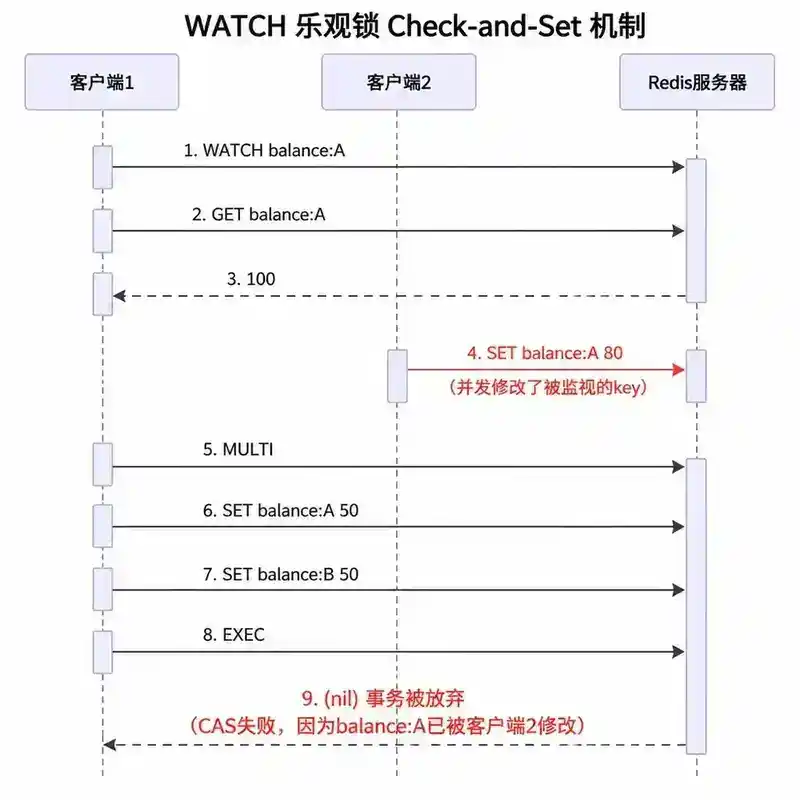
WATCH 命令用于监视一个或多个 key。在 EXEC 执行前,如果被监视的 key 被其他客户端修改,则当前事务的 EXEC 会失败(返回 nil),事务不会执行。
客户端 1                    客户端 2
WATCH balance:A
GET balance:A → 100
                            SET balance:A 80
MULTI
SET balance:A 50
SET balance:B 50
EXEC → (nil)  ← 事务被放弃
3.3 源码剖析:WATCH 的实现
在 Redis 中,每个被 WATCH 的 key 会记录在客户端的 watched_keys 列表中。同时,数据库维护一个全局的 watched_keys 字典:
// server.h
typedef struct redisDb {
    dict *watched_keys;  // key → 监视该 key 的客户端列表
    // ...
} redisDb;
当任何命令修改了一个 key,touchWatchedKey() 函数会被调用,遍历该 key 的监视客户端列表,将每个客户端的 CLIENT_DIRTY_CAS 标志位置位。
在 EXEC 执行时,execCommand() 函数检查 CLIENT_DIRTY_CAS 标志:
- 如果被置位,返回 nil,不执行任何命令
- 如果未被置位,执行事务队列中的所有命令
// multi.c: execCommand() 简化逻辑
void execCommand(client *c) {
    // 检查 CLIENT_DIRTY_CAS
    if (c->flags & CLIENT_DIRTY_CAS) {
        addReply(c, shared.null[c->resp]);
        discardTransaction(c);
        return;
    }
    // 执行队列中的命令
    for (int j = 0; j < c->mstate.count; j++) {
        c->argv = c->mstate.commands[j].argv;
        c->argc = c->mstate.commands[j].argc;
        call(c, CMD_CALL_FULL);
    }
    discardTransaction(c);
}
3.4 WATCH 的局限性
- WATCH 不能嵌套:执行 EXEC、DISCARD 或 UNWATCH 后,所有 WATCH 自动解除。
- WATCH 是乐观锁:在高竞争场景下,大量事务会因 CAS 冲突而失败,需要客户端重试,吞吐量可能下降。
- WATCH 监视的是 key 级别的修改:即使 key 的值没有实际变化,只要有 SET/DEL 等操作,就会触发 CAS 失效。
四、Redis 事务的局限性总结
| 特性 | 传统数据库(MySQL) | Redis 事务 |
|---|---|---|
| 原子性(Atomicity) | 全部成功或全部回滚 | 不回滚,错误命令不影响其他 |
| 一致性(Consistency) | 从一致状态到一致状态 | 依赖开发者保证 |
| 隔离性(Isolation) | 多级别隔离 | 串行执行,天然隔离 |
| 持久性(Durability) | 提交后持久 | 依赖 AOF/RDB 配置 |
| 回滚 | 支持 | 不支持 |
| 错误处理 | 自动回滚 | 错误命令只影响自身 |
Redis 事务的定位很清晰:它是命令的批量执行机制,不是传统意义上的 ACID 事务。对于需要真正原子性和回滚能力的场景,Redis 提供了 Lua 脚本。
五、Lua 脚本:Redis 的原子执行引擎
5.1 为什么需要 Lua 脚本
Redis 从 2.6 版本开始内置 Lua 解释器。Lua 脚本解决了 Redis 事务的多个痛点:
- 真正的原子性:脚本执行期间,Redis 不会执行其他命令,整个脚本是一个原子操作。
- 服务端逻辑:将多次网络往返缩减为一次,减少网络开销。
- 条件判断:在脚本内部可以基于读取的值做判断,实现复杂的 check-and-set 逻辑。
- 减少重复代码:将复杂的业务逻辑封装在脚本中,多处复用。
5.2 Lua 脚本执行模型
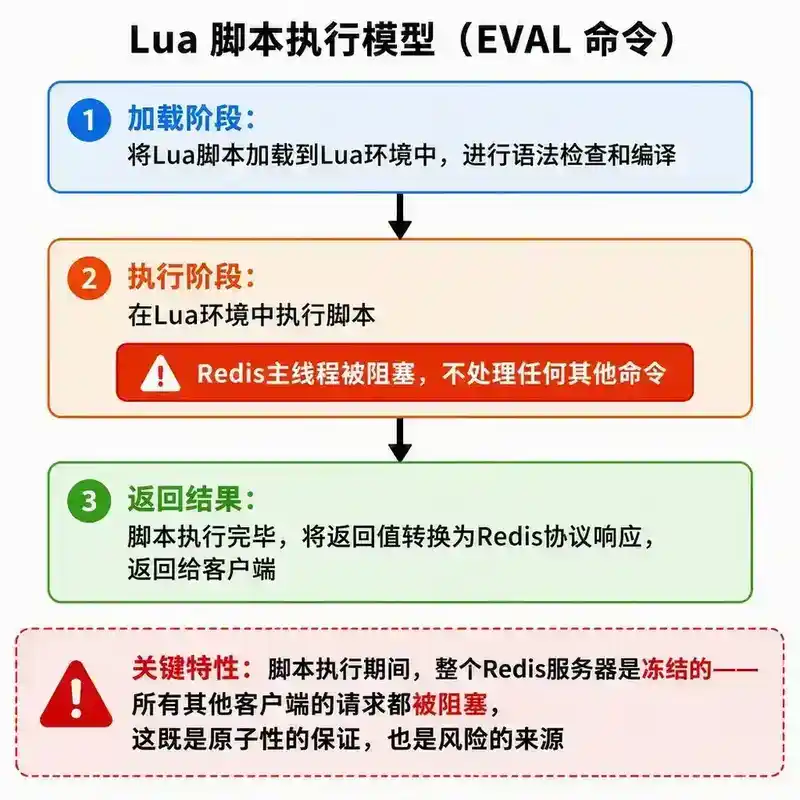
当 Redis 接收到 EVAL 命令时:
- 加载阶段:将 Lua 脚本加载到 Lua 环境中,进行语法检查和编译。
- 执行阶段:在 Lua 环境中执行脚本。期间 Redis 主线程被阻塞,不处理任何其他命令。
- 返回结果:脚本执行完毕后,将返回值转换为 Redis 协议的响应返回给客户端。
关键特性:脚本执行期间,整个 Redis 服务器是"冻结"的——所有其他客户端的请求都被阻塞。这既是原子性的保证,也是风险的来源。
5.3 EVAL 和 EVALSHA
# EVAL 语法
EVAL script numkeys key [key ...] arg [arg ...]

# 示例:原子性地扣减库存
EVAL "
  local stock = redis.call('GET', KEYS[1])
  if not stock then
    return -1
  end
  stock = tonumber(stock)
  if stock <= 0 then
    return 0
  end
  redis.call('DECR', KEYS[1])
  return stock - 1
" 1 product:stock:1001
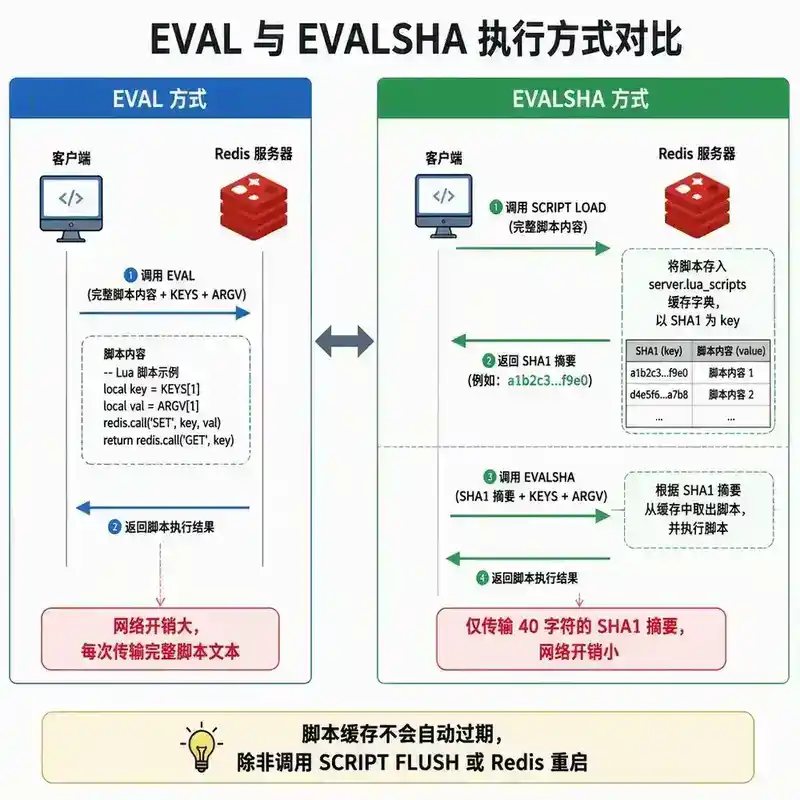
每次 EVAL 都会传输完整的脚本内容,网络开销大。Redis 提供了 SCRIPT LOAD + EVALSHA 机制:
# 加载脚本,返回 SHA1 摘要
SCRIPT LOAD "return redis.call('GET', KEYS[1])"
# → "a1b2c3d4..."

# 通过 SHA1 摘要执行脚本
EVALSHA a1b2c3d4... 1 mykey
5.4 脚本缓存机制
Redis 维护一个脚本缓存(server.lua_scripts 字典),以 SHA1 为 key,存储已编译的 Lua 函数。缓存特点:
- 不会自动过期:除非显式调用
SCRIPT FLUSH或 Redis 重启,脚本会一直保留在缓存中。 - 主从复制:脚本通过
EVAL执行时,主节点会将完整脚本复制到从节点。如果通过EVALSHA执行,主节点需要确保从节点也缓存了该脚本,否则会使用SCRIPT LOAD先同步。 - 内存影响:大量脚本缓存会占用内存,线上建议使用
SCRIPT KILL终止慢脚本,SCRIPT FLUSH清理缓存。
5.5 Lua 脚本的原子性边界
Lua 脚本的原子性是进程级别的:在脚本执行期间,Redis 不处理任何其他命令。但需要注意:
- 脚本可以调用
**redis.call()**执行任意 Redis 命令,这些命令在脚本上下文中执行,不会触发其他客户端命令的插入。 - 脚本中的写命令会被 AOF 和复制正确处理。对于带有随机性的脚本(如
redis.call('TIME')),Redis 会在复制时使用script replicate_commands确保主从一致。 - Redis 7.0 引入了
**FUNCTION**机制,作为 Lua 脚本的升级替代,支持更丰富的脚本管理能力。
六、Lua 脚本的常用场景
6.1 分布式锁
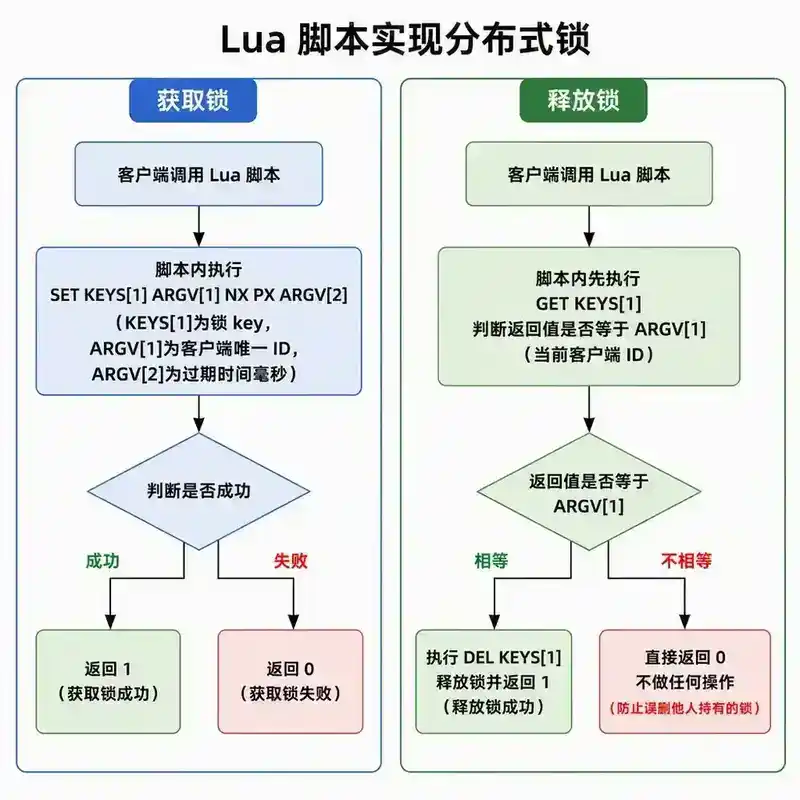
-- 获取锁:SET NX + 过期时间
-- KEYS[1]: lock key
-- ARGV[1]: client id (UUID)
-- ARGV[2]: expire time (ms)
if redis.call('SET', KEYS[1], ARGV[1], 'NX', 'PX', ARGV[2]) then
    return 1
else
    return 0
end

-- 释放锁:先检查再删除(防止误删他人的锁)
-- KEYS[1]: lock key
-- ARGV[1]: client id
if redis.call('GET', KEYS[1]) == ARGV[1] then
    return redis.call('DEL', KEYS[1])
else
    return 0
end
6.2 限流器
-- 滑动窗口限流
-- KEYS[1]: 限流 key
-- ARGV[1]: 窗口大小(秒)
-- ARGV[2]: 最大请求数
local now = redis.call('TIME')[1]
local window_start = now - tonumber(ARGV[1])
redis.call('ZREMRANGEBYSCORE', KEYS[1], 0, window_start)
local count = redis.call('ZCARD', KEYS[1])
if count < tonumber(ARGV[2]) then
    redis.call('ZADD', KEYS[1], now, now .. '-' .. count)
    redis.call('EXPIRE', KEYS[1], tonumber(ARGV[1]))
    return 1
else
    return 0
end
6.3 库存扣减
-- 原子库存扣减,防止超卖
-- KEYS[1]: 库存 key
-- ARGV[1]: 扣减数量
local stock = tonumber(redis.call('GET', KEYS[1]) or 0)
if stock < tonumber(ARGV[1]) then
    return -1  -- 库存不足
end
redis.call('DECRBY', KEYS[1], ARGV[1])
return stock - tonumber(ARGV[1])
6.4 计数器与排名
-- 原子更新分数和排名
local score = redis.call('ZINCRBY', KEYS[1], ARGV[2], ARGV[1])
local rank = redis.call('ZREVRANK', KEYS[1], ARGV[1])
return {score, rank}
七、Lua 脚本的阻塞风险
这是生产环境中最容易被忽视的严重问题。
7.1 阻塞的本质
Redis 是单线程执行模型(6.0+ 版本中 I/O 部分使用了多线程,但命令执行仍是单线程)。Lua 脚本执行期间,Redis 主线程完全被占用,无法处理其他客户端的任何请求。
如果脚本执行时间过长:
- 其他客户端请求超时,用户感知到延迟
- Sentinel 可能误判主节点下线,触发故障转移
- Cluster 模式下可能触发节点间超时,导致集群不稳定
7.2 阻塞风险的常见来源
1. 不合理的循环
-- 危险!如果 KEYS 数量很大,会长时间阻塞
for i = 1, #KEYS do
    redis.call('DEL', KEYS[i])
end
2. 大 Key 操作
-- 危险!如果 list 有数百万元素,LRANGE 会返回大量数据
local items = redis.call('LRANGE', KEYS[1], 0, -1)
-- 处理 items...
3. 复杂计算
-- 危险!在 Lua 中做大量计算
local result = 0
for i = 1, 10000000 do
    result = result + i
end
4. 无限循环或死循环
-- 极其危险!脚本永远不会结束
while true do
    redis.call('PING')
end
7.3 防御机制
Redis 提供了 lua-time-limit 配置(默认 5000ms)和 SCRIPT KILL 命令:
# 配置脚本最大执行时间
lua-time-limit 5000

# 终止执行中的脚本
SCRIPT KILL
但 SCRIPT KILL 有重要限制:只能终止未执行过写操作的脚本。如果脚本已经执行了 redis.call('SET', ...) 等写操作,SCRIPT KILL 会失败,因为终止脚本会破坏数据一致性。此时只能使用 SHUTDOWN NOSAVE 暴力重启。
7.4 最佳实践
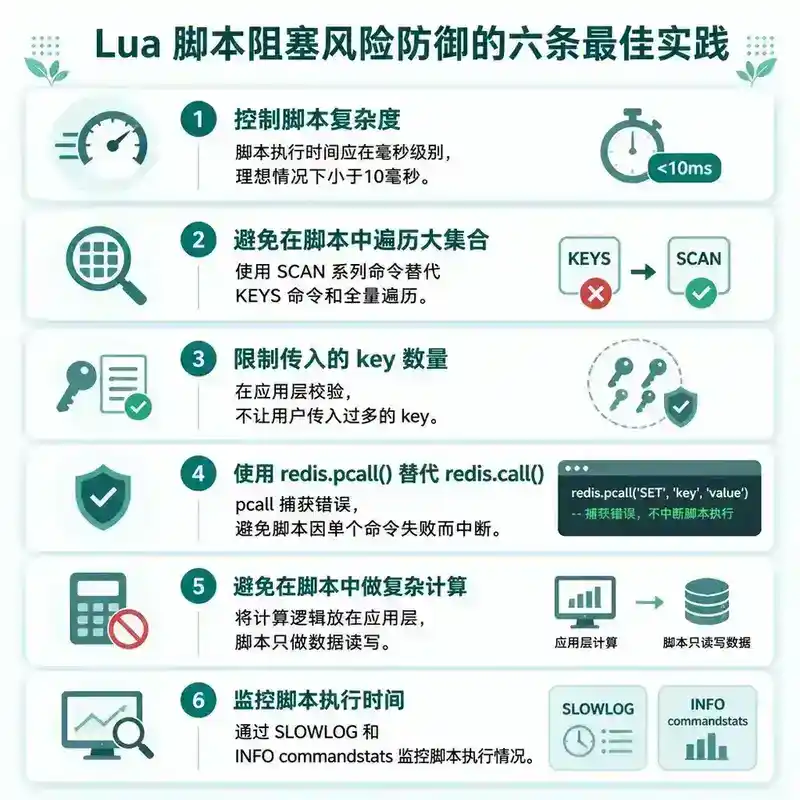
- 控制脚本复杂度:脚本执行时间应在毫秒级别,理想情况下 < 10ms。
- 避免在脚本中遍历大集合:使用
SCAN系列命令替代KEYS和全量遍历。 - 限制传入的 key 数量:在应用层校验,不让用户传入过多的 key。
- 使用
**redis.pcall()**替代**redis.call()**:pcall捕获错误,避免脚本因单个命令失败而中断。 - 避免在脚本中做复杂计算:将计算逻辑放在应用层,脚本只做数据读写。
- 监控脚本执行时间:通过
SLOWLOG和INFO commandstats监控脚本执行情况。
八、事务 vs Lua 脚本:选型指南
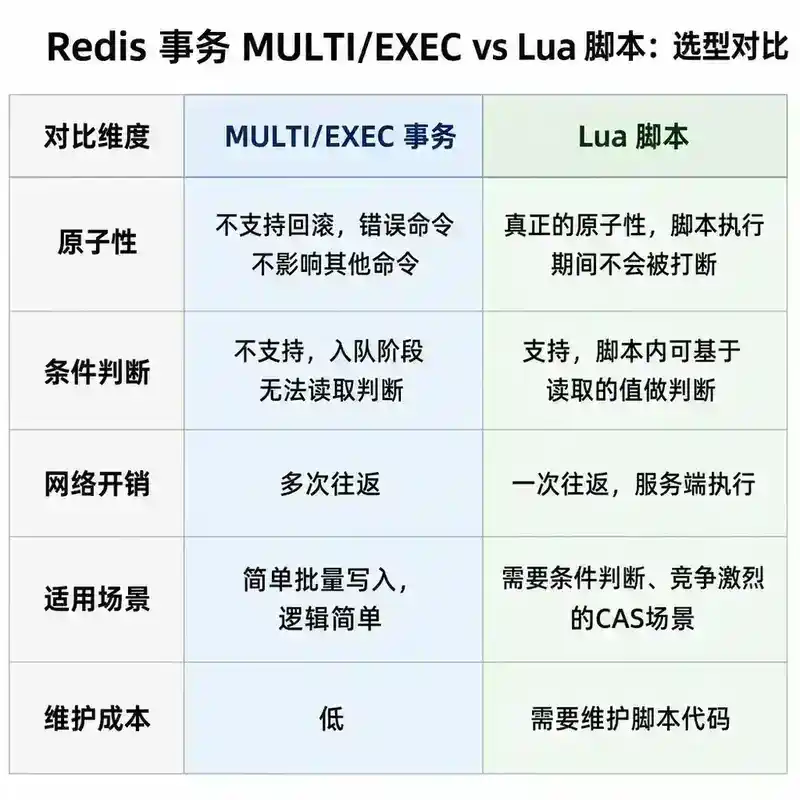
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 多个命令需原子执行 | Lua 脚本 | 真正的原子性,无竞态窗口 |
| 简单的批量写入 | MULTI/EXEC | 简单直接,无需维护脚本 |
| 需要条件判断 | Lua 脚本 | 事务不支持中间读取判断 |
| 竞争激烈的 CAS | Lua 脚本 | WATCH 重试成本高 |
| 逻辑非常简单 | MULTI/EXEC | 避免 Lua 脚本的维护成本 |
| 需要回滚能力 | 不适用 | 在应用层实现补偿逻辑 |
核心原则:如果需要在事务中"读取数据并根据读取结果做判断",请使用 Lua 脚本。如果只是批量执行一组独立的写命令,MULTI/EXEC 就足够了。
九、生产实践与最佳实践
9.1 脚本管理
// Java 中使用 Spring Data Redis 管理脚本
@Component
public class StockScriptManager {

    private final RedisScript<Long> deductScript;

    public StockScriptManager() {
        // 从 classpath 加载脚本,自动计算 SHA1
        this.deductScript = RedisScript.of(
            new ClassPathResource("scripts/deduct_stock.lua"),
            Long.class
        );
    }

    public Long deduct(StringRedisTemplate template, String key, int amount) {
        return template.execute(
            deductScript,
            Collections.singletonList(key),
            String.valueOf(amount)
        );
    }
}
9.2 错误处理模式
-- 推荐的错误处理模式
local function safe_call(func, ...)
    local ok, result = pcall(func, ...)
    if not ok then
        return redis.error_reply("Script error: " .. tostring(result))
    end
    return result
end

-- 使用
local stock = safe_call(redis.call, 'GET', KEYS[1])
9.3 集群模式注意事项
在 Redis Cluster 中,Lua 脚本涉及的所有 key 必须位于同一个 hash slot。如果脚本操作跨 slot 的多个 key,会收到 CROSSSLOT 错误。解决方案:
- 使用 hash tag(如
{user:1001}:info和{user:1001}:score)将相关 key 映射到同一个 slot。 - 从 Redis 7.0 开始,允许使用
ALLOW.CROSSSLOT标志,但需要谨慎使用。
9.4 主从复制与脚本
- 使用
EVAL执行脚本时,主节点会将完整脚本写入 AOF 和复制缓冲区。 - 使用
EVALSHA时,Redisson 等客户端会先尝试EVALSHA,失败后自动回退到EVAL。 - 脚本中不要使用随机函数或时间函数(如
TIME、RANDOMKEY),否则主从数据会不一致。Redis 5.0+ 的script replicate_commands可以缓解这个问题。
十、常见陷阱与故障案例
陷阱 1:以为事务会回滚
// 错误认知:以为 Redis 事务会回滚
redisTemplate.multi();
redisTemplate.opsForValue().set("key1", "value1");
redisTemplate.opsForList().leftPush("key1", "item1"); // 类型错误
redisTemplate.opsForValue().set("key2", "value2");
redisTemplate.exec(); // 第一条 SET 已生效,不会回滚!
陷阱 2:WATCH 后忘记重试
// 不完整的 WATCH 模式
redisTemplate.watch("balance");
Integer balance = (Integer) redisTemplate.opsForValue().get("balance");
redisTemplate.multi();
redisTemplate.opsForValue().set("balance", balance - 100);
List<Object> result = redisTemplate.exec();
// 如果 result 为 null(CAS 失败),需要重试!
陷阱 3:Lua 脚本中写了死循环
一个真实案例:某团队在 Lua 脚本中实现了 while true 循环处理队列数据,期望队列为空时退出。但生产环境中队列持续有新数据写入,脚本永远无法结束,导致 Redis 主节点阻塞超过 30 秒,触发 Sentinel 故障转移,造成短暂的服务不可用。
陷阱 4:集群模式下跨 Slot 操作未使用 hash tag
陷阱 5:EVALSHA 缓存丢失
Redis 重启后脚本缓存被清空,应用直接使用 EVALSHA 会报 NOSCRIPT 错误。推荐使用客户端库(如 Redisson、Lettuce)自动处理 NOSCRIPT 回退。
十一、Redis 7.0+ 的 Redis Functions
Redis 7.0 引入了 Functions 机制,作为 Lua 脚本的演进:
#!lua name=mylib

redis.register_function('myfunc', function(keys, args)
    return redis.call('GET', keys[1])
end)
优势:
- 持久化:Functions 存储在 RDB/AOF 中,重启不丢失。
- 版本管理:支持库的加载、替换和删除。
- 更好的隔离:每个库有独立的 Lua 环境。
这是 Redis 在脚本化方向上的重要改进,值得关注。
十二、面试提问
以下问题从面试官视角设计,考察候选人对 Redis 事务与 Lua 脚本的深度理解。
Q1:Redis 事务和 MySQL 事务有什么区别?为什么 Redis 选择不支持回滚?
Q2:WATCH 命令的内部实现原理是什么?在高并发场景下,WATCH 机制有什么性能问题?
Q3:如果有一个 Lua 脚本在生产环境中执行了 10 秒还没结束,你会怎么处理?SCRIPT KILL 一定能成功吗?
Q4:在 Redis Cluster 中使用 Lua 脚本需要注意什么?如果脚本需要操作多个 key,如何保证它们在同一个节点上?
Q5:请设计一个 Lua 脚本实现"先检查库存,再扣减库存,同时记录扣减日志到另一个 key"的操作。要求所有操作原子执行,且如果库存不足返回错误码。
Q6:为什么 Redis 事务不需要像 MySQL 那样的隔离级别?Redis 的隔离是如何保证的?
Q7:EVALSHA 在什么场景下会失败?你的应用中如何处理这种失败?
十三、延伸阅读与参考
- Redis 官方文档 - Transactions
- Redis 官方文档 - Lua scripting
- Redis 源码 - multi.c
- Redis 源码 - scripting.c
- Redis 7.0 Functions 官方文档
本文是《Java 技术专家与架构师面试:250 个高频考点》系列的第 138 篇。下一篇将探讨缓存穿透、击穿、雪崩的治理方案。
十二-A、面试提问参考答案
以下答案从面试官视角出发,不仅给出正确回答,更展示候选人应具备的深度思考能力。
Q1:Redis 事务和 MySQL 事务有什么区别?为什么 Redis 选择不支持回滚?
参考答案:
两者的核心差异在于设计哲学和实现模型完全不同:
| 维度 | MySQL 事务 | Redis 事务 |
|---|---|---|
| 原子性 | 全部成功或全部回滚 | 不回滚,错误命令只影响自身 |
| 隔离性 | 多级别(RU/RC/RR/SERIALIZABLE) | 串行执行,天然隔离 |
| 持久性 | 提交即持久(redo log + binlog) | 依赖 AOF/RDB 配置 |
| 回滚机制 | 基于 undo log 回滚 | 不支持回滚 |
| 并发控制 | MVCC + 锁(行锁/间隙锁等) | 单线程 + WATCH 乐观锁 |
Redis 选择不支持回滚的原因:
- 性能优先的设计哲学。Redis 是内存数据库,追求极致性能。引入回滚意味着需要维护 undo log、管理回滚段、处理回滚时的并发冲突,这会让 Redis 的核心路径变慢。Antirez 曾明确表示:"Redis 事务中的错误几乎都是编程错误,应该在开发阶段被发现,不值得为运行时错误付出回滚的复杂度代价。"
- 单线程模型简化了问题。Redis 命令执行是单线程的,事务执行期间不会被其他客户端打断。这与 MySQL 需要处理并发事务冲突的复杂度完全不同。在单线程模型下,很多 MySQL 需要回滚来保护的场景(如并发写冲突)在 Redis 中根本不会发生。
- 语法错误与运行时错误的区分。Redis 将错误分为两类:语法错误(命令不存在、参数错误)在入队阶段就能发现,通过客户端校验即可避免;运行时错误(如对 String 类型执行 LPUSH)本质上是 bug,在开发测试阶段就应该发现。
- Lua 脚本提供了更强的原子性保障。对于真正需要"全部成功或全部失败"的场景,Redis 引入了 Lua 脚本。脚本执行期间 Redis 不处理任何其他命令,这才是真正的原子操作。如果脚本中需要错误处理,开发者可以使用
redis.pcall()和redis.error_reply()自行实现回滚逻辑。
深度追问:面试官可能会追问 —— "如果我真的需要在 Redis 中实现类似回滚的效果,你会怎么做?"
答:在 Lua 脚本中自己实现。例如在转账场景中,先检查余额,不足则返回错误不执行任何写入;充足则执行扣减。如果需要多步操作的回滚,在脚本中用 pcall 包裹每步操作,失败时手动逆向操作。但要注意,脚本执行期间 Redis 是阻塞的,复杂的回滚逻辑可能导致脚本执行时间过长。
Q2:WATCH 命令的内部实现原理是什么?在高并发场景下,WATCH 机制有什么性能问题?
参考答案:
内部实现原理:
WATCH 的实现涉及三个核心数据结构:
- 客户端
**watched_keys**列表:每个 Redis 客户端(client结构体)维护一个被监视 key 的列表。当客户端执行WATCH key1 key2时,这些 key 被添加到该列表中。 - 数据库级
**watched_keys**字典:每个 Redis 数据库(redisDb)维护一个dict *watched_keys,以 key 为索引,value 是一个链表,存储所有监视该 key 的客户端指针。 **CLIENT_DIRTY_CAS**标志位:当任何客户端修改了一个被监视的 key 时,touchWatchedKey()函数被调用,遍历该 key 对应的客户端链表,将每个客户端的CLIENT_DIRTY_CAS标志置位。
执行流程:
WATCH key1 key2
  → 将 key1, key2 加入 client.watched_keys
  → 在 db.watched_keys[key1] 链表中添加当前客户端
  → 在 db.watched_keys[key2] 链表中添加当前客户端

其他客户端修改 key1
  → touchWatchedKey(db, key1)
  → 遍历 db.watched_keys[key1] 链表
  → 将每个客户端的 flags 设置 CLIENT_DIRTY_CAS

EXEC
  → 检查 client.flags & CLIENT_DIRTY_CAS
  → 如果为 true:返回 nil,放弃事务
  → 如果为 false:执行队列中的所有命令
  → 最后调用 unwatchAllKeys() 清理
高并发场景下的性能问题:
- CAS 冲突率高导致重试风暴。在竞争激烈的场景下(如秒杀),大量客户端同时 WATCH 同一个 key。一旦有任何一个客户端修改了该 key,所有其他客户端的事务都会失败。这导致大量重试,且重试之间可能再次冲突,形成"重试风暴"。极端情况下,系统吞吐量可能比不用 WATCH 还低。
**touchWatchedKey()**的性能开销。每次修改 key 时都需要遍历db.watched_keys[key]链表。如果大量客户端同时监视同一个热门 key,这个链表的遍历本身就有 O(N) 的开销。虽然 Redis 单线程避免了并发问题,但链表遍历仍会消耗 CPU 时间。- WATCH 不支持"条件监视"。WATCH 只能检测"key 被修改过",不能区分"值变成了什么"。即使 key 的值被修改后又恢复原值,WATCH 也会认为被修改了(CAS 失效)。这在某些场景下会导致不必要的重试。
- 与事务的耦合。WATCH 必须在 MULTI 之前调用,且 EXEC/DISCARD 后自动解除。这意味着不能在事务内部使用 WATCH,限制了复杂场景的灵活性。
深度追问:面试官可能会追问 —— "高并发场景下,WATCH 重试过多怎么办?"
答:改用 Lua 脚本。Lua 脚本在服务端原子执行,不存在 WATCH 的竞态窗口。例如秒杀扣库存场景,用 Lua 脚本比 WATCH + MULTI/EXEC 重试模式高效得多。
Q3:如果有一个 Lua 脚本在生产环境中执行了 10 秒还没结束,你会怎么处理?SCRIPT KILL 一定能成功吗?
参考答案:
应急处置流程:
- 立即确认影响范围。通过监控(如 Redis 连接数、命令延迟、慢查询日志)判断影响面。如果 Redis 是主节点,脚本阻塞会导致所有读写请求超时;如果是从节点,影响相对较小。
- 尝试
**SCRIPT KILL**。这是第一选择:
SCRIPT KILL
但 SCRIPT KILL 不一定能成功。它只能终止未执行过写操作的脚本。如果脚本已经执行了 redis.call('SET', ...)、redis.call('DEL', ...) 等写命令,Redis 会拒绝 KILL 操作,返回错误:
(error) UNKILLABLE Sorry the script already executed write commands against the dataset.
You can either wait the script termination or kill the server in a hard way using the SHUTDOWN NOSAVE command.
- 如果 SCRIPT KILL 失败:
- 等待脚本自然结束(风险:可能永远不结束,如果是死循环)
**SHUTDOWN NOSAVE**:暴力重启 Redis,不保存数据。这是最后的手段,会导致未持久化的数据丢失。- 如果部署了 Sentinel/Cluster:可以提前触发故障转移,将从节点提升为主节点。但要注意数据一致性 —— 如果脚本已经执行了部分写操作,这些操作可能已经复制到了从节点。
- 事后复盘:
- 分析慢查询日志,确认脚本内容
- 检查
lua-time-limit配置是否合理(默认 5000ms) - 将脚本执行时间监控纳入告警体系
为什么 SCRIPT KILL 对已写脚本无效?
这是 Redis 的数据一致性保护机制。Lua 脚本执行期间,Redis 不处理任何其他命令,这意味着脚本的写操作是"正在进行"的状态。如果强行终止一个已执行写操作的脚本,Redis 无法确定脚本的原子性边界 —— 哪些写操作已经生效、哪些还未执行,无法回滚。终止脚本会导致数据处于不一致状态。因此 Redis 宁愿让脚本继续执行,也不冒数据不一致的风险。
深度追问:面试官可能会追问 —— "如何预防 Lua 脚本长时间阻塞?"
答:多管齐下,包括代码审查(禁止在脚本中使用循环和全量遍历)、配置 lua-time-limit、使用 SLOWLOG 监控、在测试环境用大量数据压测脚本、以及在 Redis 7.0 中考虑使用 Functions 的 FCALL_RO 只读标志限制脚本行为。
Q4:在 Redis Cluster 中使用 Lua 脚本需要注意什么?如果脚本需要操作多个 key,如何保证它们在同一个节点上?
参考答案:
核心限制:
Redis Cluster 中,Lua 脚本涉及的所有 key 必须位于同一个 hash slot(严格来说,同一个节点是不够的,必须是同一个 slot)。如果脚本操作的 key 分布在不同的 slot,EVAL 命令会返回错误:
(error) CROSSSLOT Keys in request don't hash to the same slot
这是因为 Redis Cluster 的每个节点只负责一部分 slot,如果脚本需要操作多个 slot 的 key,就需要跨节点执行,而 Redis 的 Lua 脚本执行模型不支持分布式事务。
解决方案:Hash Tag
使用 hash tag 将相关 key 强制映射到同一个 hash slot。Redis Cluster 在计算 key 的 slot 时,只对 { 和 } 之间的子串进行哈希:
key: {user:1001}:profile    → hash slot 根据 "user:1001" 计算
key: {user:1001}:orders     → hash slot 根据 "user:1001" 计算
key: {user:1001}:balance    → hash slot 根据 "user:1001" 计算
这三个 key 会被映射到同一个 slot,可以在同一个 Lua 脚本中操作。
Hash Tag 的使用注意事项:
- 可能导致数据倾斜。如果某个 hash tag 的数据量特别大(如热门用户),该 slot 会比其他 slot 有更多数据,造成节点间的不均衡。
- 影响迁移灵活性。同一个 hash tag 下的所有 key 绑定在一起,迁移时必须一起迁移,限制了 slot 迁移的粒度。
- 命名规范。团队需要统一 hash tag 的命名规范,避免不同业务冲突。
Redis 7.0 的改进:
Redis 7.0 引入了 ALLOW.CROSSSLOT 标志,允许脚本跨 slot 操作:
EVAL "..." 2 key1 key2 ALLOW.CROSSSLOT
但这只是放宽了限制,并不是真正的分布式事务。跨 slot 的脚本仍然在单个节点上执行,需要确保所有涉及的 key 都在该节点上(通过 key 迁移或 hash tag 实现)。不建议在生产环境大量使用。
其他注意事项:
- 脚本缓存不跨节点。
SCRIPT LOAD只在当前节点生效,其他节点不会自动缓存。使用EVALSHA时,客户端需要确保目标节点已缓存脚本,或处理NOSCRIPT错误回退。 - 主从切换后缓存丢失。如果主节点故障转移,从节点提升为主节点,之前的脚本缓存会丢失(除非使用了 Redis 7.0 Functions)。
- 随机性脚本的复制问题。在 Cluster 模式下,脚本中的随机函数(如
TIME、RANDOMKEY)对主从复制的影响更大,因为从节点可能同时服务读请求。
Q5:请设计一个 Lua 脚本实现"先检查库存,再扣减库存,同时记录扣减日志到另一个 key"的操作。要求所有操作原子执行,且如果库存不足返回错误码。
参考答案:
-- 原子库存扣减 + 日志记录
-- KEYS[1]: 库存 key(如 stock:product:1001)
-- KEYS[2]: 日志 key(如 stock_log:product:1001)
-- ARGV[1]: 扣减数量
-- ARGV[2]: 订单 ID(用于日志关联)
-- ARGV[3]: 用户 ID(用于日志关联)
--
-- 返回值:
--   -1: 库存不足
--   -2: 库存 key 不存在
--   -3: 参数无效
--   >=0: 扣减后剩余库存

-- 1. 参数校验
local amount = tonumber(ARGV[1])
if not amount or amount <= 0 then
    return redis.error_reply("Invalid amount: " .. tostring(ARGV[1]))
end

local order_id = ARGV[2]
local user_id = ARGV[3]

-- 2. 检查库存
local stock = redis.call('GET', KEYS[1])
if not stock then
    return -2  -- 库存 key 不存在
end

stock = tonumber(stock)
if not stock then
    return redis.error_reply("Invalid stock value: " .. tostring(stock))
end

if stock < amount then
    return -1  -- 库存不足
end

-- 3. 扣减库存
local remaining = redis.call('DECRBY', KEYS[1], amount)

-- 4. 记录扣减日志(使用有序集合,以时间戳为 score,方便后续查询和清理)
local timestamp = redis.call('TIME')[1]  -- 秒级时间戳
local log_entry = string.format(
    "%s|%s|%s|%d|%d",
    timestamp, order_id, user_id, amount, remaining
)
redis.call('ZADD', KEYS[2], timestamp, log_entry)

-- 5. 设置日志过期时间(可选,避免日志无限增长)
-- 保留最近 30 天的日志
redis.call('EXPIRE', KEYS[2], 2592000)

return remaining
设计要点说明:
- 参数校验先行。在操作数据之前验证所有输入,避免参数错误导致部分操作成功。
- 使用
**DECRBY**而非**SET**。DECRBY天然是原子操作,避免了 read-modify-write 的竞态窗口。注意:这里用DECRBY是在 Lua 脚本内部调用,Redis 命令本身是原子的,但整个脚本也是原子的,所以即使分两步(GET + SET)也是安全的。但用DECRBY更简洁。 - 日志结构设计。使用
ZADD将日志存入有序集合,以时间戳为 score。这样做的好处是:- 可以按时间范围查询日志(
ZRANGEBYSCORE) - 可以方便地清理过期日志(
ZREMRANGEBYSCORE) - 每个日志条目是唯一的(timestamp + order_id 保证唯一性)
- 可以按时间范围查询日志(
- 返回值语义化。使用不同的返回值(-1、-2、>=0)区分不同的失败原因和成功状态,便于应用层处理。
- 日志过期。设置
EXPIRE防止日志 key 无限增长,避免内存泄漏。
面试官追问:如果日志量非常大,ZADD 会影响性能怎么办?
答:可以用 Redis Stream 替代 ZSet 存储日志,Stream 的追加性能更好,且支持消费者组消费日志到持久化存储。或者将日志写入剥离到独立脚本中,接受一定程度的一致性问题,通过异步对账来补偿。
Q6:为什么 Redis 事务不需要像 MySQL 那样的隔离级别?Redis 的隔离是如何保证的?
参考答案:
根本原因:Redis 是单线程执行模型。
MySQL 需要多级隔离(RU/RC/RR/SERIALIZABLE)的原因是它采用多线程并发 + MVCC 模型,多个事务可能同时执行,必须通过隔离级别来定义"一个事务能看到其他事务的什么数据"。更高的隔离级别意味着更强的数据一致性,但也意味着更低的并发度。
Redis 则完全不同 —— 命令执行是单线程的。这意味着:
- 天然串行化。任何时刻,Redis 只有一个命令在执行。不存在两个命令同时修改同一个 key 的情况。这天然实现了最高级别的隔离性(SERIALIZABLE)。
- 事务执行期间绝对隔离。当 Redis 执行
EXEC时,事务队列中的所有命令会连续执行,期间不会插入任何其他客户端的命令。这比 MySQL 的 SERIALIZABLE 级别更强 —— MySQL 的 SERIALIZABLE 只是保证了事务的"可串行化",而不是真正的"串行执行"。 - 单线程避免了锁竞争。MySQL 需要行锁、间隙锁、意向锁等复杂的锁机制来协调并发事务,而 Redis 的单线程模型根本不需要这些锁。这简化了实现,也避免了死锁问题。
但 Redis 事务的隔离性也有局限:
- WATCH 检查在 EXEC 时进行。事务入队期间,其他客户端可以修改数据。Redis 的隔离性只在 EXEC 执行时生效,入队期间的数据是不稳定的。这类似于 MySQL 的"快照读"发生在事务开始时,但 Redis 的隔离性保证更弱 —— 因为在入队期间,开发者无法读取数据做判断。
- Lua 脚本才是真正的隔离。Lua 脚本整个执行过程是原子的,从第一条命令到最后一条命令,中间不会插入任何其他操作。这才是 Redis 中最强的隔离保证。
- 没有"读已提交"概念。在 Redis 中,由于单线程,你读到的永远是最新写入的值。不存在"读未提交"或"读已提交"的区别,因为根本没有"未提交"的状态 —— 每个命令执行完就立即生效。
总结:Redis 的隔离性来自单线程架构,天然就是 SERIALIZABLE 级别,不需要额外的隔离级别设计。但 MULTI/EXEC 事务的隔离性仅限于执行阶段,入队阶段的数据可能被其他客户端修改,需要通过 WATCH 来检测。
Q7:EVALSHA 在什么场景下会失败?你的应用中如何处理这种失败?
参考答案:
EVALSHA 失败的场景:
- Redis 重启。脚本缓存(
server.lua_scripts字典)在 Redis 重启后会丢失,因为它是纯内存结构,不持久化到 RDB/AOF。应用使用之前缓存的 SHA1 调用EVALSHA会收到NOSCRIPT错误。 **SCRIPT FLUSH**被调用。运维人员或自动化脚本显式调用SCRIPT FLUSH清空了脚本缓存。- 主从切换。在 Sentinel/Cluster 模式下,故障转移后从节点提升为主节点。如果脚本是在旧主节点上
SCRIPT LOAD的,新主节点可能没有该脚本的缓存。 - Redis Cluster 节点变化。扩容或缩容时,slot 重新分配,请求被路由到不同的节点。新节点可能没有缓存该脚本。
- 脚本内容变更。应用升级后,脚本内容变了,但使用了旧的 SHA1 调用
EVALSHA。虽然 SHA1 不同,但如果应用代码中硬编码了旧的 SHA1,也会失败。 - 多实例部署。应用连接多个 Redis 实例,脚本只在部分实例上
SCRIPT LOAD过。
应用层处理方案:
方案一:客户端库自动处理(推荐)
主流 Redis 客户端库(Lettuce、Redisson、Jedis)都内置了 EVALSHA → EVAL 的回退机制:
// Spring Data Redis 的 RedisScript 自动处理 NOSCRIPT 回退
@Bean
public RedisScript<Long> deductScript() {
    // DefaultRedisScript 默认会尝试 EVALSHA,失败后自动回退到 EVAL
    DefaultRedisScript<Long> script = new DefaultRedisScript<>();
    script.setLocation(new ClassPathResource("scripts/deduct.lua"));
    script.setResultType(Long.class);
    return script;
}

// 使用时无需关心 EVALSHA vs EVAL
Long result = redisTemplate.execute(deductScript, keys, args);
方案二:手动实现回退
public <T> T executeScript(RedisScript<T> script, List<String> keys, Object... args) {
    try {
        // 先尝试 EVALSHA
        return redisTemplate.execute(script, keys, args);
    } catch (RedisSystemException e) {
        if (e.getMessage().contains("NOSCRIPT")) {
            // NOSCRIPT 错误,使用 EVAL 重新执行
            // Spring Data Redis 的 DefaultRedisScript 内部已经处理了这个回退
            // 这里展示的是手动处理逻辑
            String scriptContent = loadScriptContent(script.getScriptPath());
            return redisTemplate.execute(
                RedisScript.of(scriptContent, script.getResultType()),
                keys, args
            );
        }
        throw e;
    }
}
方案三:应用启动时预热
在应用启动时,主动将脚本 SCRIPT LOAD 到所有 Redis 节点,确保脚本缓存存在:
@Component
public class ScriptPreloader implements ApplicationListener<ApplicationReadyEvent> {

    @Override
    public void onApplicationEvent(ApplicationReadyEvent event) {
        // 将所有 Lua 脚本 SCRIPT LOAD 到 Redis
        for (RedisScript<?> script : allScripts) {
            String sha1 = redisTemplate.getConnectionFactory()
                .getConnection()
                .scriptLoad(script.getScriptAsString().getBytes());
            log.info("Script loaded: {} -> {}", script.getScriptPath(), sha1);
        }
    }
}
方案四:监控和告警
对 NOSCRIPT 错误进行监控,设置告警阈值。如果 NOSCRIPT 错误频繁出现,说明脚本缓存管理存在问题,需要排查。
推荐组合策略:依赖客户端库的自动回退 + 应用启动预热 + 异常监控。这样即使预热失败或运行时缓存丢失,客户端也能自动回退到 EVAL,保证业务不中断。
本文是《Java 技术专家与架构师面试:250 个高频考点》系列的第 138 篇。下一篇将探讨缓存穿透、击穿、雪崩的治理方案。