阅读时间:约 45 分钟 | 难度:高级 | 前置知识:Redis 基础命令、分布式系统基本概念、CAP 理论
一、问题定义:为什么需要分布式锁
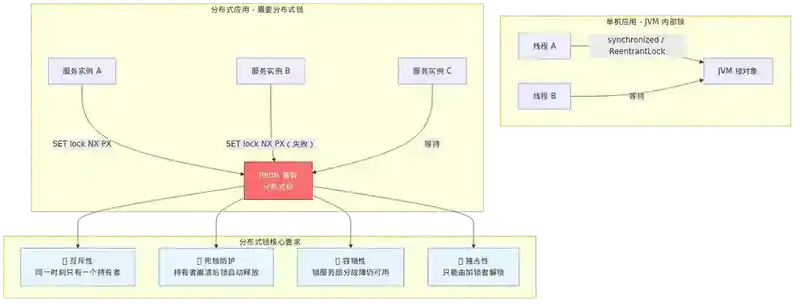
在单机 Java 应用中,保证互斥访问很简单——synchronized 或 ReentrantLock 足够了:
private final ReentrantLock lock = new ReentrantLock();

public void deductStock() {
    lock.lock();
    try {
        // 扣减库存,只有一个线程能执行
    } finally {
        lock.unlock();
    }
}
但当应用部署到多台机器上,JVM 内部的锁就失效了——每个 JVM 有自己的锁对象,互不感知。此时需要一把所有进程都能看到的锁,这就是分布式锁。
1.1 分布式锁的核心要求
一把合格的分布式锁必须满足:
| 属性 | 含义 | 如果缺失会导致 |
|---|---|---|
| 互斥性(Mutual Exclusion) | 任意时刻只有一个客户端持有锁 | 数据错乱、重复扣减 |
| 死锁防护(Deadlock Free) | 持有锁的客户端崩溃后,锁最终能被释放 | 资源永久锁定 |
| 容错性(Fault Tolerance) | 锁服务本身部分节点故障时仍能正常工作 | 锁服务不可用 |
| 独占性(Ownership) | 只能由加锁的客户端解锁 | 客户端 A 误删客户端 B 的锁 |
1.2 为什么选择 Redis 做分布式锁
Redis 天然适合做分布式锁:
- 单线程命令执行:
SET NX的互斥判断天然原子,不需要复杂的 CAS 循环 - 高性能:毫秒级响应,锁的获取和释放开销极低
- 广泛部署:几乎所有分布式系统都有 Redis,不需要额外引入 ZooKeeper/etcd
但 Redis 做分布式锁也有先天不足:主从异步复制可能导致锁丢失,这也是 Redlock 争议的根源。
二、SET NX PX:最基础的 Redis 分布式锁
2.1 命令演进
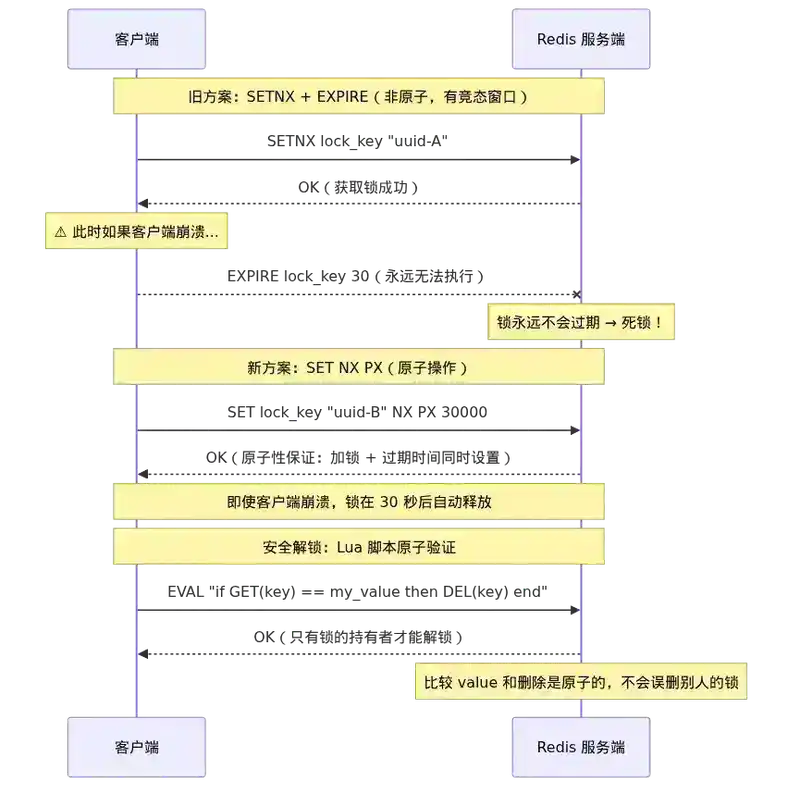
早期 Redis 实现分布式锁需要两条命令:
# 旧方案:非原子操作,有竞态窗口
SETNX lock_key unique_value   # 第 1 步:尝试获取锁
EXPIRE lock_key 30             # 第 2 步:设置过期时间
问题:如果客户端在第 1 步和第 2 步之间崩溃,锁永远不会过期——死锁。
Redis 2.6.12 引入了扩展的 SET 命令,将加锁和设过期合并为一个原子操作:
SET lock_key unique_value NX PX 30000
| 参数 | 含义 |
|---|---|
NX |
Not eXists——仅当 key 不存在时才设置成功 |
PX 30000 |
设置 30000 毫秒(30 秒)过期时间 |
unique_value |
唯一标识(通常是 UUID + 线程 ID),用于安全解锁 |
2.2 安全解锁:Lua 脚本保证原子性
解锁不能简单地 DEL lock_key——这会把别人的锁删掉:
# 客户端 A 获取锁,SET lock_key uuid-A NX PX 30000 → OK
# ... 客户端 A 执行耗时操作,锁过期了 ...
# 客户端 B 获取锁,SET lock_key uuid-B NX PX 30000 → OK
# 客户端 A 执行 DEL lock_key → 删掉了 B 的锁!
正确做法是用 Lua 脚本原子性地比较 value 再删除:
-- unlock.lua
if redis.call("GET", KEYS[1]) == ARGV[1] then
    return redis.call("DEL", KEYS[1])
else
    return 0
end
// Java 调用
String script = "if redis.call('GET', KEYS[1]) == ARGV[1] then " +
                "return redis.call('DEL', KEYS[1]) else return 0 end";
jedis.eval(script, Collections.singletonList("lock_key"),
           Collections.singletonList(uniqueValue));
为什么 Lua 脚本是原子的:Redis 执行 Lua 脚本时,整个脚本作为一个原子操作执行,期间不会插入其他命令。这保证了"比较"和"删除"之间没有竞态窗口。
2.3 锁过期时间的困境
过期时间设置是个两难:
- 太短:业务逻辑还没执行完锁就过期了,其他客户端获取锁,互斥被打破
- 太长:持有锁的客户端崩溃后,其他客户端要等很久才能获取锁,系统 hang 住
这个困境催生了锁续期机制。
三、锁续期(Lock Renewal / Watchdog)
3.1 核心思想
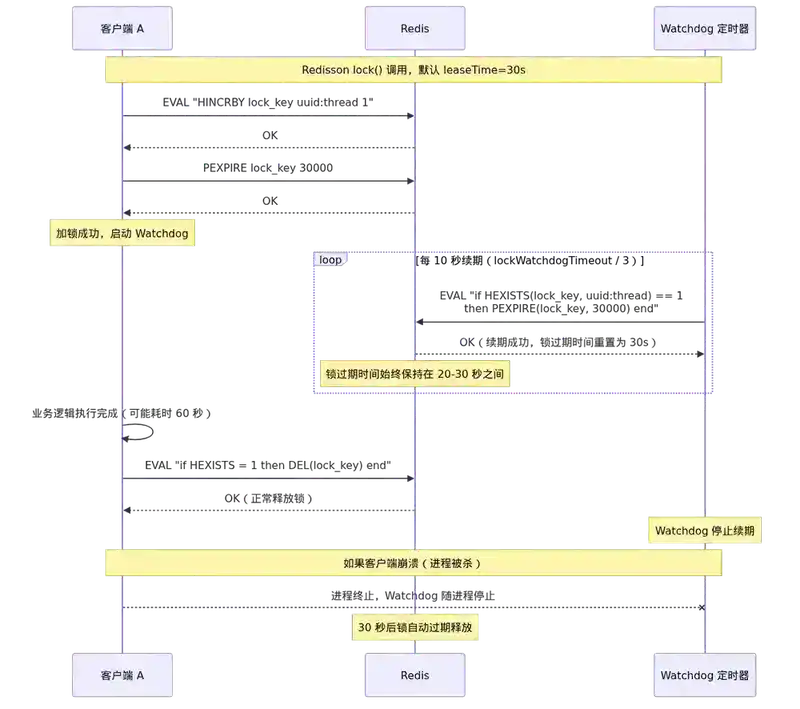
持有锁的客户端定期(如每 10 秒)检查自己是否还在持有锁,如果还在处理业务,就延长过期时间。这样即使业务执行时间超过初始过期时间,锁也不会意外释放。
3.2 Redisson 的 Watchdog 实现
Redisson 是 Java 最流行的 Redis 客户端之一,它的分布式锁实现 RLock 内置了 Watchdog 机制:
// Redisson 分布式锁使用示例
RLock lock = redisson.getLock("order:lock:10086");
try {
    // 尝试加锁,默认 30 秒过期,Watchdog 自动续期
    lock.lock();
    // 执行业务逻辑,无论多久锁都不会意外释放
    processOrder();
} finally {
    lock.unlock();
}
Watchdog 工作流程:
- 客户端调用
lock()时,默认设置锁过期时间为 30 秒(lockWatchdogTimeout) - 加锁成功后,启动一个后台定时任务(
netty timer),每 10 秒(lockWatchdogTimeout / 3)执行一次续期 - 续期操作通过 Lua 脚本原子执行:检查锁的 value 是否还是当前客户端的,如果是则
PEXPIRE重置为 30 秒 - 客户端释放锁或进程崩溃时,定时任务也随之终止,锁在 30 秒后自动过期
关键源码逻辑(Redisson RedissonLock 简化):
// 续期 Lua 脚本
// 如果锁的 value 匹配,则重置过期时间
if (redis.call('HEXISTS', KEYS[1], ARGV[2]) == 1) then
    redis.call('PEXPIRE', KEYS[1], ARGV[1]);
    return 1;
end
return 0;
Watchdog 的注意事项:
- 如果客户端显式指定了
leaseTime(如lock.lock(10, TimeUnit.SECONDS)),Watchdog 不会启动,锁将在指定时间后自动释放 - Watchdog 只在客户端正常运行时有效,如果客户端所在机器宕机(进程直接被杀),Watchdog 定时任务会随进程停止,锁在 30 秒后自动过期
- 如果客户端发生长时间 GC 停顿(如 Full GC 持续 40 秒),Watchdog 来不及续期,锁会过期释放
3.3 续期机制的局限性
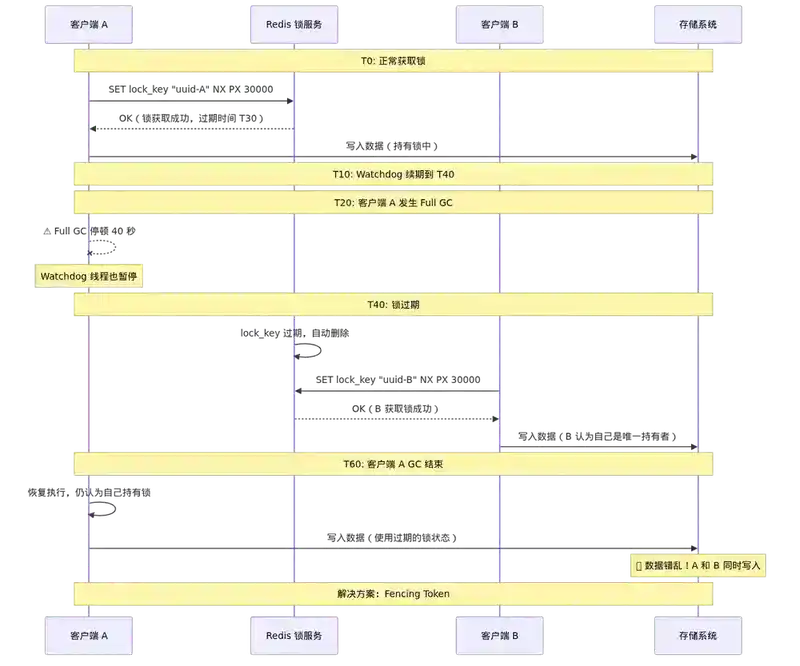
续期解决了"锁过期早于业务完成"的问题,但引入了新问题:如果客户端发生长时间 GC 停顿,锁过期后它仍认为自己持有锁。
时间线:
T0: 客户端 A 获取锁,Watchdog 启动
T10: Watchdog 续期到 T40
T20: 客户端 A 发生 Full GC,停顿 35 秒
T40: 锁过期,客户端 B 获取锁
T55: 客户端 A GC 结束,仍认为自己持有锁 → 继续写数据 → 数据错乱!
这正是 Fencing Token 要解决的问题。
四、Fencing Token:防止"僵尸"客户端
4.1 问题本质
分布式锁的互斥性不能仅靠"锁服务说我是持有者"来保证,还需要存储系统参与验证。因为锁服务和存储系统之间是异步的,锁过期后存储系统并不知道锁已经换了持有者。
4.2 Fencing Token 机制
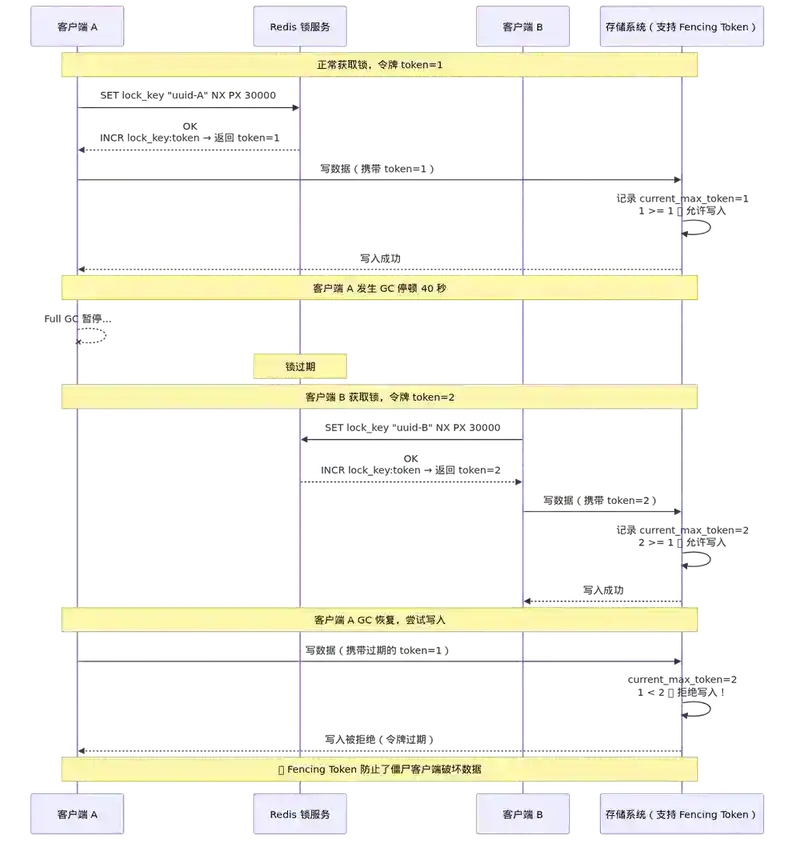
核心思想:锁服务在授予锁时,返回一个单调递增的令牌(fencing token)。客户端在写存储时,必须携带这个令牌。存储系统只接受令牌值大于等于已记录的最大令牌值的请求。
客户端 A 获取锁,令牌=1 ──→ 存储系统记录 max_token=1
客户端 A GC 停顿 40 秒...
客户端 A 锁过期,客户端 B 获取锁,令牌=2 ──→ 存储系统记录 max_token=2
客户端 A 醒来,拿着令牌=1 写存储 ──→ 存储: "你的令牌 1 < max_token=2,拒绝!"
4.3 实现方式
Redis 可以用 INCR 实现单调递增令牌:
public class RedisFencingLock {
    private final Jedis jedis;

    public LockResult tryLock(String lockKey, String clientId, int ttlSeconds) {
        String tokenKey = lockKey + ":token";
        // 原子操作:获取锁 + 获取递增令牌
        String script =
            "local ok = redis.call('SET', KEYS[1], ARGV[1], 'NX', 'EX', ARGV[2]) " +
            "if ok then " +
            "    local token = redis.call('INCR', KEYS[2]) " +
            "    return token " +
            "else " +
            "    return 0 " +
            "end";
        Object result = jedis.eval(script,
            Arrays.asList(lockKey, tokenKey),
            Arrays.asList(clientId, String.valueOf(ttlSeconds)));
        long token = (Long) result;
        return new LockResult(token > 0, token);
    }
}
存储端验证:
// 存储系统写操作时验证 fencing token
public boolean writeWithFencing(String key, String value, long fencingToken) {
    String script =
        "local current = redis.call('GET', KEYS[1] .. ':fencing') " +
        "if not current or tonumber(current) < tonumber(ARGV[1]) then " +
        "    redis.call('SET', KEYS[1] .. ':fencing', ARGV[1]) " +
        "    redis.call('SET', KEYS[1], ARGV[2]) " +
        "    return 1 " +
        "else " +
        "    return 0 " +
        "end";
    return (Long) jedis.eval(script,
        Collections.singletonList(key),
        Arrays.asList(String.valueOf(fencingToken), value)) == 1;
}
4.4 Fencing Token 的现实约束
Fencing Token 理论上很完美,但实际落地有成本:
- 需要存储系统配合:不是所有存储系统都支持 fencing token 验证
- 增加了写操作的复杂度:每次写入都要携带和验证令牌
- 对已有系统改造大:无法在不动存储层的情况下引入
因此实践中,大多数场景通过合理设置锁超时 + 业务层幂等来规避,而非引入完整的 fencing token。
五、Redlock 算法:Redis 作者提出的分布式锁方案
5.1 单节点 Redis 锁的问题
前面讨论的 SET NX PX 方案在 Redis 单节点(或主从哨兵)下有一个致命问题:主从异步复制导致锁丢失。
场景:
1. 客户端 A 在主节点获取锁,SET lock_key uuid-A NX PX 30000 → OK
2. 主节点在将这条 SET 同步给从节点之前崩溃了
3. 哨兵将从节点提升为新主节点
4. 客户端 B 在新主节点获取锁,SET lock_key uuid-B NX PX 30000 → OK
5. 现在 A 和 B 都认为自己持有锁 → 互斥被打破!
5.2 Redlock 算法流程
Redis 作者 antirez 提出了 Redlock 算法,通过多个独立的 Redis 节点来解决这个问题。算法流程(以 5 个节点为例):
- 获取当前时间(毫秒)
- 依次向 N 个 Redis 节点请求锁(SET NX PX,使用相同的 key 和随机 value,超时时间远小于锁过期时间)
- 计算获取锁的耗时:
当前时间 - 步骤 1 的时间 - 判断是否成功:当且仅当在大多数节点(N/2+1,即 ≥3 个)获取锁成功,且总耗时 < 锁的有效时间(TTL),才算获取成功
- 锁的有效时间 =
初始 TTL - 获取锁的耗时 - 如果获取失败,向所有节点发送解锁请求
// Redlock 伪代码
public boolean tryLock(String lockKey, String clientId, long ttlMillis) {
    long startTime = System.currentTimeMillis();
    int successCount = 0;

    for (RedisNode node : redisNodes) {
        try {
            if (node.set(lockKey, clientId, "NX", "PX", ttlMillis)) {
                successCount++;
            }
        } catch (Exception e) {
            // 节点不可用,跳过
        }
    }

    long elapsed = System.currentTimeMillis() - startTime;
    long validityTime = ttlMillis - elapsed;

    if (successCount >= majority && validityTime > 0) {
        // 获取锁成功
        return true;
    } else {
        // 获取锁失败,向所有节点解锁
        for (RedisNode node : redisNodes) {
            node.eval(unlockScript, lockKey, clientId);
        }
        return false;
    }
}
5.3 Redlock 的设计考量
| 考量点 | 设计决策 |
|---|---|
| 节点数量 | 奇数个(通常 5 个),容忍 2 个节点故障 |
| 时钟依赖 | 不依赖节点间时钟同步,但依赖各节点本地时钟的相对准确性 |
| 重试策略 | 失败后随机延迟重试,避免多个客户端同时竞争 |
| 锁释放 | 向所有节点发送 Lua 解锁脚本,无论是否在该节点获取成功 |
| 性能 | 每次加锁需要与 N 个节点通信,延迟约 N × 网络 RTT |
六、Redlock 争议:分布式系统领域的经典论战
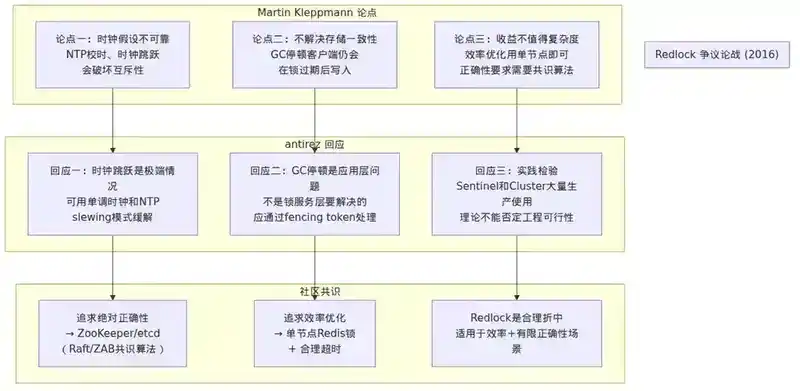
2016 年,分布式系统研究者 Martin Kleppmann 发表了一篇名为《How to do distributed locking》的文章,对 Redlock 提出了尖锐批评。antirez 随后发文回应。这场论战是分布式系统领域最经典的公开讨论之一。
6.1 Martin Kleppmann 的核心论点
论点一:Redlock 基于时钟假设,而时钟在分布式系统中不可靠
Redlock 依赖各节点本地时钟来判断锁的有效期。Martin 认为这不可靠:
场景(时钟跳跃):
1. 客户端 A 在节点 1、2、3 获取锁,TTL=10s
2. 节点 1 的时钟向前跳跃了 15 秒(NTP 校时)
3. 节点 1 上的锁立即过期
4. 客户端 B 在节点 1、4、5 获取锁成功
5. A 和 B 同时持有锁 → 互斥被打破
论点二:Redlock 没有解决根本问题——它只保证锁服务的一致性,不保证存储的一致性
Martin 认为 fencing token 才是正确解法,Redlock 在锁服务层面做再多工作,也无法阻止 GC 停顿的客户端在锁过期后继续写入:
即使 Redlock 完美工作,以下场景仍然发生:
1. 客户端 A 通过 Redlock 获取锁
2. 客户端 A 发生 GC 停顿 60 秒
3. 锁过期,客户端 B 获取锁
4. 客户端 A 醒来,继续写存储 → 数据错乱
论点三:Redlock 的收益不值得其复杂度
如果目的是效率优化(避免重复工作),单节点 Redis 锁就够了,偶尔的锁丢失不会导致数据错误。如果目的是正确性(保证数据一致性),Redlock 也不够,需要 fencing token 或共识算法。
6.2 antirez 的回应
antirez 的回应核心要点:
回应一:时钟跳跃是极端情况
长时间运行的系统中,时钟跳跃确实是已知问题。但可以通过以下方式缓解:
- 使用单调时钟(
CLOCK_MONOTONIC)而非墙上时钟来做过期判断 - 配置 NTP 使用 slewing 模式而非 stepping 模式
- 监控时钟偏移
回应二:GC 停顿是另一个问题
GC 停顿不是 Redlock 要解决的问题——任何锁方案在客户端进程暂停后都无法保证安全性。antirez 认为应该在应用层通过 fencing token 或超时检测来处理,而不是在锁服务层。
回应三:实践检验
Redis 的 Sentinel 和 Cluster 方案被大量公司在生产环境使用,Redlock 的实现在实践中表现良好。分布式系统理论很重要,但不能因此否定工程上可行的方案。
6.3 社区共识
经过多年讨论,社区形成了以下共识:
| 观点 | 认可度 |
|---|---|
| Redlock 对时钟依赖是真实风险,但实践中概率低 | 高 |
| 如果追求绝对正确性,应该用 ZooKeeper/etcd(共识算法) | 高 |
| 如果追求效率优化,单节点 Redis 锁 + 合理超时就够了 | 高 |
| Fencing token 是解决互斥问题的最佳补充方案 | 高 |
| Redlock 在某些场景下是合理的折中 | 中 |
七、生产实践:分布式锁选型指南
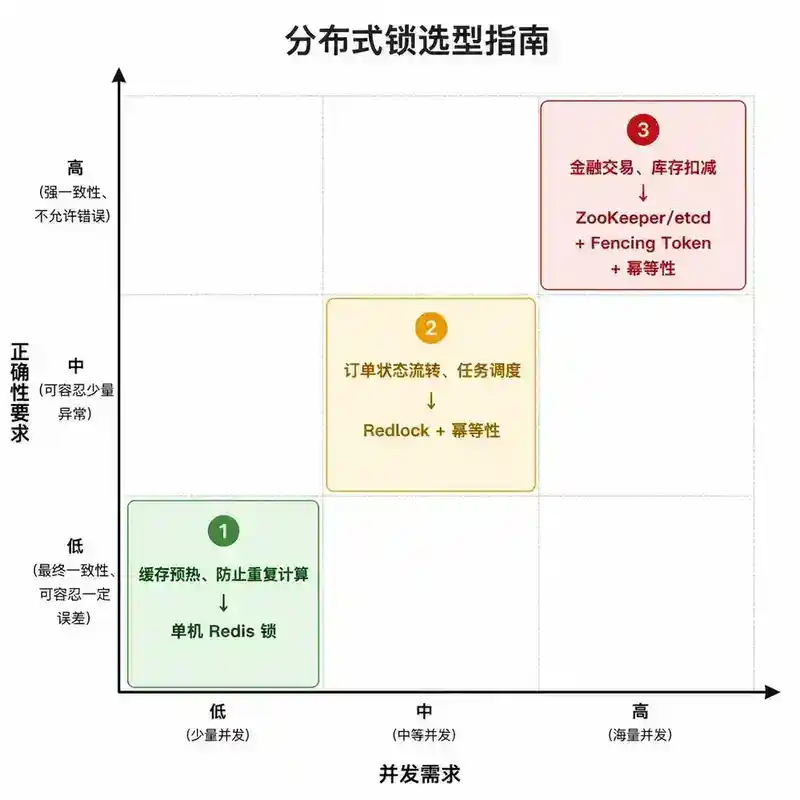
7.1 场景分级
正确性要求
    ↑
    │  ┌──────────────────────────────┐
    │  │ 金融交易、库存扣减           │
    │  │ → ZooKeeper / etcd          │
    │  │ + fencing token + 幂等       │
    │  ├──────────────────────────────┤
    │  │ 订单状态流转、任务调度       │
    │  │ → Redlock + 业务幂等         │
    │  ├──────────────────────────────┤
    │  │ 缓存预热、防止重复计算       │
    │  │ → 单节点 Redis 锁            │
    │  └──────────────────────────────┘
    └──────────────────────────────────→ 并发量
7.2 常见陷阱与最佳实践
陷阱一:锁粒度太粗
// 错误:整个系统共用一把锁
lock.lock("global_order_lock");  // 所有订单操作串行化

// 正确:按业务维度细化
lock.lock("order:lock:" + orderId);  // 只锁当前订单
陷阱二:锁内执行耗时操作
// 错误:锁内调用外部 RPC
lock.lock();
try {
    rpcCall();  // 可能耗时几十秒,锁过期
    updateDB();
} finally {
    lock.unlock();
}

// 正确:将耗时操作移出锁范围
lock.lock();
try {
    updateDB();  // 只保护临界区
} finally {
    lock.unlock();
}
陷阱三:未处理锁获取失败
// 错误:无限等待
while (true) {
    if (lock.tryLock()) break;
    Thread.sleep(100);
}

// 正确:有超时和降级策略
if (!lock.tryLock(5, TimeUnit.SECONDS)) {
    throw new LockAcquireException("系统繁忙,请稍后重试");
}
陷阱四:可重入性的滥用
Redisson 的锁默认是可重入的(基于 Redis Hash 的计数器),但可重入也意味着你需要小心锁的释放次数。如果 lock 了 3 次但只 unlock 了 2 次,锁不会真正释放。
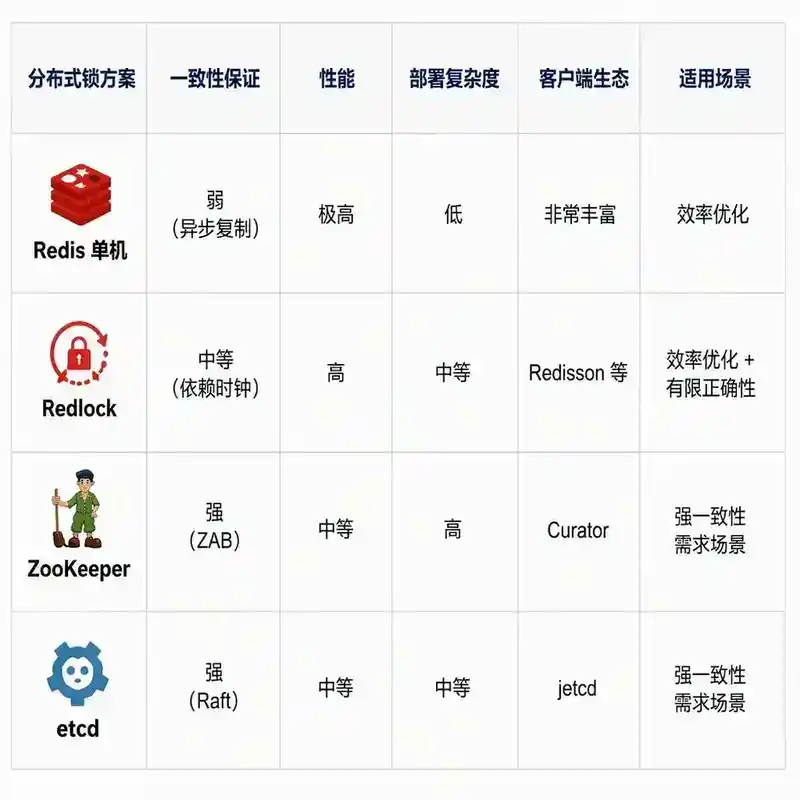
7.3 与其他方案对比
| 特性 | Redis 单节点 | Redlock | ZooKeeper | etcd |
|---|---|---|---|---|
| 一致性保证 | 弱(异步复制) | 中(依赖时钟) | 强(ZAB) | 强(Raft) |
| 性能 | 极高 | 高 | 中 | 中 |
| 部署复杂度 | 低 | 中 | 高 | 中 |
| 客户端生态 | 极其丰富 | Redisson 等 | Curator | jetcd |
| 适用场景 | 效率优化 | 效率+有限正确性 | 强正确性要求 | 强正确性要求 |
八、面试追问
以下问题从面试官视角设计,考察对分布式锁的深度理解,而非简单记忆。
Q1:Redisson 的 Watchdog 机制中,续期间隔为什么是 lockWatchdogTimeout / 3?换成 /2 或 /4 会有什么问题?
A1:续期间隔为什么是 lockWatchdogTimeout / 3?
Redisson 默认 lockWatchdogTimeout = 30000ms,续期间隔为 10000ms(即 /3)。这个 1/3 的比值是可靠性、性能、网络容错三者的折中:
- /2(15s):如果第一次续期请求因网络抖动失败,等到 15s 后第二次续期时,锁只剩 15s 有效期。如果再失败一次,锁就过期了。容错窗口太小。
- /3(10s):允许连续失败 2 次续期请求(共 20s 内重试),锁仍有 10s 余量。这是「3 次机会」策略——在 30s 窗口内给你 3 次续期机会(初始加锁 + 2 次续期)。
- /4(7.5s):续期太频繁,增加了 Redis 的无效负载和网络开销,但容错性提升不明显。
核心公式:续期间隔 = TTL / N,其中 N 是在 TTL 内允许的续期尝试次数。N=3 是工程上的 sweet spot——既不是 N=2 的「一次失败就危险」,也不是 N=5 的「过度续期浪费资源」。
延伸:如果业务高峰期的网络延迟 P99 是 2s,那么续期间隔不应小于 3×P99=6s(防止续期请求排队)。Redisson 的 10s 间隔在大多数场景下足够安全。
Q2:你在 Redlock 算法中向 5 个 Redis 节点依次请求锁,如果第 3 个节点网络超时,你应该继续请求第 4、5 个节点,还是立即失败?为什么?
A2:第 3 个节点超时,继续还是立即失败?
答案:继续请求第 4、5 个节点,但不要无脑重试。
原因分两层:
第一层(数学):5 个节点需要 ≥3 个成功。如果前 3 个中已有 2 个成功,第 3 个超时,你仍有希望在第 4、5 个节点拿到第 3 票。如果前 3 个中已有 2 个失败,第 3 个超时,你最多只能拿 2 票——此时应立即失败,不用浪费时间请求第 4、5 个节点。
第二层(工程):继续请求的关键约束是总耗时。Redlock 的有效期 = 初始 TTL - 获取耗时。如果前 3 个节点已经花了 8s,TTL=10s,此时即使拿到第 4、5 个节点,有效期只剩 2s——锁实际上没意义。所以应设置一个超时上限(如 TTL × 0.8),超过后直接失败。
// 正确的实现
long deadline = System.currentTimeMillis() + ttlMillis * 0.8;
int needed = (nodes.size() / 2) + 1;
int acquired = 0;
int remaining = nodes.size();

for (RedisNode node : nodes) {
    if (acquired >= needed) break;           // 已拿到多数,成功
    if (acquired + remaining < needed) break; // 剩余节点不够,失败
    if (System.currentTimeMillis() > deadline) break; // 超时,失败

    if (node.tryLock(lockKey, clientId, ttlMillis)) {
        acquired++;
    }
    remaining--;
}
面试官视角的加分点:能说出「动态判断剩余票数是否够」的候选人,说明理解了多数派投票的本质,而不是死记算法步骤。
Q3:假设你有一个分布式任务调度系统,需要保证同一任务不会被多个 Worker 同时执行。你会选择 Redis 分布式锁还是数据库乐观锁?说出你的判断依据。
A3:分布式任务调度选 Redis 锁还是数据库乐观锁?
这道题没有标准答案,考的是场景分析能力。我期待候选人按以下维度拆解:
| 维度 | Redis 分布式锁 | 数据库乐观锁(version) |
|---|---|---|
| 任务粒度 | 粗粒度(任务级锁) | 细粒度(数据行级锁) |
| 并发量 | 高(内存操作) | 中低(磁盘 I/O) |
| 持有时间 | 短(秒级) | 可长(分钟级) |
| 一致性 | 弱(锁可能丢失) | 强(事务 ACID) |
| 额外依赖 | 需要 Redis 集群 | 复用已有 DB |
我的判断逻辑:
如果任务调度系统已经在用数据库记录任务状态(task_id、status、worker_id、version),那么数据库乐观锁是更自然的选择——不需要引入新组件,且任务状态和锁在同一个事务中更新,一致性天然保证:
UPDATE task SET status='RUNNING', worker_id=?, version=version+1
WHERE task_id=? AND version=? AND status='PENDING';
如果任务调度高频触发(每秒数千次),且任务状态不需要持久化,Redis 锁更合适。但此时需要额外处理 Redis 锁丢失导致的重复执行——在任务入口加业务幂等(如基于 task_id + 业务时间戳去重)。
关键判断依据:你的系统是否已经有了任务状态表。如果有,数据库乐观锁的额外成本为零;如果没有,引入 Redis 锁的代价低于新建一张表。
Q4:Fencing Token 要求存储系统配合验证。如果存储系统是 MySQL,你如何在不修改 MySQL 内核的情况下实现 fencing token 验证?
A4:Fencing Token 在 MySQL 中如何实现?
在不修改 MySQL 内核的前提下,有 3 种方案:
方案一:应用层乐观锁 + fencing token(推荐)
-- 每条数据记录增加 fencing_token 字段
UPDATE orders SET status='PAID', fencing_token=?
WHERE order_id=? AND fencing_token < ?;
如果 affected_rows = 0,说明令牌已被更大的覆盖,拒绝写入。应用层收到 0 后需要感知到「锁已被抢占」并放弃后续操作。
方案二:SELECT ... FOR UPDATE + 令牌表
-- 独立的令牌表
CREATE TABLE fencing_tokens (
    resource_id VARCHAR(128) PRIMARY KEY,
    max_token   BIGINT NOT NULL
);

-- 写入时:
START TRANSACTION;
SELECT max_token FROM fencing_tokens WHERE resource_id=? FOR UPDATE;
-- 如果传入的 token <= max_token,ROLLBACK 并拒绝
-- 否则 UPDATE fencing_tokens SET max_token=? WHERE resource_id=?;
-- 执行业务写入
COMMIT;
优点是不需要修改业务表结构,缺点是引入了额外的锁竞争(FOR UPDATE 在热点资源上会成为瓶颈)。
方案三:Redis + MySQL 混合(实用主义)
用 Redis 的 INCR 生成 fencing token(性能高),MySQL 中只做最终校验。这是大多数公司在「不完美但够用」和「完美但复杂」之间选择的折中:
long token = redis.incr("fencing:" + orderId);
boolean ok = orderDao.updateWithFencing(orderId, newStatus, token);
if (!ok) {
    // 锁已被抢占,放弃写入
    throw new LockPreemptedException();
}
面试官视角:这道题考察的是「在约束条件下设计方案」的能力。如果候选人直接说「做不到」,说明缺乏工程思维;如果能说出 2 种以上方案并分析优劣,说明有架构能力。
Q5:有人说"Redis 分布式锁在 Kubernetes 环境下更不可靠",你如何理解这个观点?Pod 漂移、网络分区会带来哪些额外风险?
A5:Redis 分布式锁在 K8s 环境下为什么更不可靠?
这个问题考察的是对容器化环境特有故障模式的理解。K8s 引入了以下额外风险:
风险一:Pod 漂移导致的「幽灵锁」
Pod 从 Node-A 漂移到 Node-B 时,旧 Pod 被 SIGTERM,但如果优雅关闭(graceful shutdown)超时(默认 30s),Pod 会被 SIGKILL 强杀。问题在于:Watchdog 续期线程可能先于业务线程被杀死,但业务线程仍在执行。此时锁已过期,新 Pod 获取锁,但旧 Pod 的业务逻辑还在跑。
风险二:网络分区的「假主」问题
K8s 网络插件(如 Calico、Flannel)偶发的网络分区,可能导致 Pod 与 Redis 失联但 Pod 本身未死。Watchdog 续期失败 → 锁过期 → 另一个 Pod 获取锁 → 原 Pod 网络恢复后继续执行 → 双写。
风险三:资源限流导致的「软停顿」
K8s 的 CPU throttle 机制(CFS quota)可能导致 Pod 在配额用完后被限流,Watchdog 续期线程得不到 CPU 时间,锁过期。这与 JVM GC 停顿类似,但更难排查——从应用日志看一切正常,只是 CPU 被限流了。
缓解措施:
- 设置
**terminationGracePeriodSeconds**足够长(如 60s),在 preStop hook 中主动释放锁 - 使用 Redlock 而非单节点 Redis 锁,降低网络分区影响
- 监控 CPU throttle 指标(
container_cpu_cfs_throttled_seconds_total),设置告警 - 业务层幂等永远是最后一道防线——不管锁机制如何,写入操作本身必须幂等
面试官视角:能说出「CFS throttle 导致 Watchdog 失效」的候选人,说明真正在 K8s 生产环境踩过坑,而不是纸上谈兵。
Q6:如果你的系统已经在用 ZooKeeper 做服务发现,为什么还要额外引入 Redis 做分布式锁?反过来,如果已经在用 Redis 做缓存,引入 ZooKeeper 做锁合理吗?
A6:已有 ZooKeeper 为什么还要 Redis 做锁?反之合理吗?
场景一:已有 ZK 做服务发现,仍引入 Redis 做锁
合理。理由:
- ZK 的锁性能远低于 Redis:ZK 的临时顺序节点 + Watch 机制涉及多次 RPC 和磁盘 fsync,单次加锁延迟在 10-50ms 量级;Redis 的 SET NX 是纯内存操作,延迟在 0.1-1ms 量级
- ZK 不适合高并发锁场景:大量 Watch 触发时 ZK 会有「羊群效应」(herd effect),所有等待者同时被唤醒,造成瞬时压力
- 职责分离:服务发现是低频、高一致性场景;分布式锁是高频、可容忍弱一致性场景。用同一组件服务两种不同 SLO 是危险的
场景二:已有 Redis 做缓存,引入 ZK 做锁
取决于业务场景:
- 如果锁的正确性要求极高(如金融交易),引入 ZK 是合理的。Redis 的主从异步复制确实可能导致锁丢失,ZK 的 ZAB 协议提供线性一致性保证
- 如果只是防止重复计算,引入 ZK 是过度设计。Redis 单节点锁 + 合理超时足够
- 成本考量:引入 ZK 意味着需要维护 3-5 个节点的 ZK 集群,而 Redis 集群大概率已经存在。运维成本增加 vs 锁安全性提升,需要权衡
核心原则:不要用高一致性组件做高吞吐的事,也不要用高吞吐组件做强一致性的事。 选型不是「哪个更好」,而是「哪个更适合当前场景的 tradeoff」。
Q7:试设计一个"有进度保证"的分布式锁——即持有锁的客户端如果执行了超过 80% 的工作后被抢占,系统能感知到进度并让新持有者从中断点继续,而非从头开始。
A7:设计有进度保证的分布式锁
这是一个开放设计题,考察系统设计能力。以下是一个可行的方案:
核心思路:在锁的值中携带进度信息,利用 Redis 的原子性保证进度可见性。
方案设计:
锁值结构(JSON):
{
  "clientId": "worker-3",
  "startedAt": 1700000000,
  "progress": 0.85,
  "checkpoint": "step-17",
  "checkpointData": "..."
}
工作流程:
- 获取锁时:检查锁是否已存在。如果存在且
progress > 0.8,说明前一个持有者完成了大部分工作——读取其checkpoint和checkpointData,从断点继续 - 执行过程中:定期更新锁的 progress 和 checkpoint(通过 Lua 脚本原子更新)
- 锁被抢占时:新持有者通过锁值中的 progress 判断是否可以从断点继续
-- 核心 Lua 脚本:获取锁并检查进度
local current = redis.call('GET', KEYS[1])
if current == false then
    redis.call('SET', KEYS[1], ARGV[1], 'PX', ARGV[2])
    return {1, 0, ''}
end

local data = cjson.decode(current)
if data.progress > 0.8 then
    redis.call('SET', KEYS[1], ARGV[1], 'PX', ARGV[2])
    return {1, data.progress, data.checkpoint}
end

return {0, 0, ''}
关键设计决策:
- 进度阈值:80% 是经验值——太低则断点恢复的收益不如重新执行,太高则大概率已完成无需恢复
- checkpoint 粒度:太细则更新开销大,太粗则恢复收益小。建议按业务步骤(如订单处理的「验库存」「扣库存」「创建订单」)划分
- checkpointData 大小:Redis 的 value 不宜过大(建议 < 10KB),只存储恢复所需的最小上下文
面试官视角:候选人如果能进一步讨论「checkpoint 数据的一致性保证」(如何确保 checkpoint 和实际执行进度一致)和「部分执行的幂等处理」(从断点恢复后,断点之前的操作被重复执行怎么办),说明有深度系统设计能力。
延伸阅读:
• Martin Kleppmann: "How to do distributed locking" (2016)
• antirez: "Is Redlock safe?" (2016)
• Redisson 官方文档: Distributed locks and synchronizers
• 《数据密集型应用系统设计》第 8 章:分布式系统的挑战
• Redis 官方文档: Distributed locks with Redis