阅读时间:约 45 分钟 适用读者:高级 Java 工程师、技术专家、架构师 前置知识:Redis 基础、HTTP 协议、分布式系统基础
目录
- 引言:从一次秒杀故障说起
- 缓存层次模型:为什么是"多级"
- 第一级:本地缓存
- 第二级:分布式缓存
- 第三级:CDN 边缘缓存
- 多级缓存协同与数据流动
- 缓存一致性:核心难题
- 失效传播:从源头到边缘
- 实战:构建一个多级缓存系统
- 总结
- 面试官提问
1. 引言:从一次秒杀故障说起
2018 年双十一,某电商平台商品详情页在零点秒杀瞬间响应时间从 50ms 飙升到 5s,数据库连接池耗尽。事后复盘发现:只有一层 Redis 缓存,热点商品击穿了缓存层,直接打到 MySQL。
这个问题暴露了单层缓存的脆弱性。解决思路是在 Redis 前面再加一层本地缓存(Caffeine),在 Redis 前面再加一层 CDN——这就形成了多级缓存架构。
多级缓存的本质是用空间换时间,用冗余换可用性,用近端换延迟。但多级缓存带来了一个核心难题:当数据发生变化时,如何让所有层级的缓存保持一致? 这就是本文要深入探讨的问题。
2. 缓存层次模型:为什么是"多级"
2.1 计算机体系结构中的缓存层次
多级缓存的思想并非互联网架构首创。在 CPU 设计中,L1/L2/L3 Cache 就是典型的多级缓存:
CPU 寄存器 (0.3ns)
  → L1 Cache (1ns, 32KB)
    → L2 Cache (4ns, 256KB)
      → L3 Cache (12ns, 8MB)
        → 主内存 (100ns, GB级)
          → SSD/磁盘 (100μs~10ms, TB级)
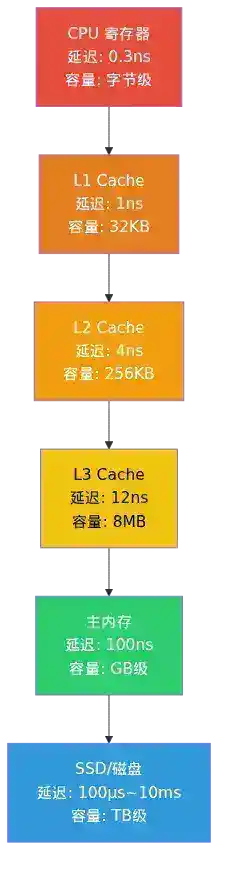
每一层离 CPU 越近,容量越小、速度越快、成本越高。互联网架构的多级缓存遵循同样的金字塔模型。
2.2 互联网架构的缓存金字塔
          ┌──────────────┐
          │   CDN 缓存    │  ← 边缘节点,离用户最近(10ms)
          ├──────────────┤
          │  反向代理缓存  │  ← Nginx/Varnish(1~5ms)
          ├──────────────┤
          │  本地缓存     │  ← Caffeine/Guava(μs级)
          ├──────────────┤
          │  分布式缓存   │  ← Redis Cluster(1ms)
          ├──────────────┤
          │  数据库       │  ← MySQL(10~100ms)
          └──────────────┘
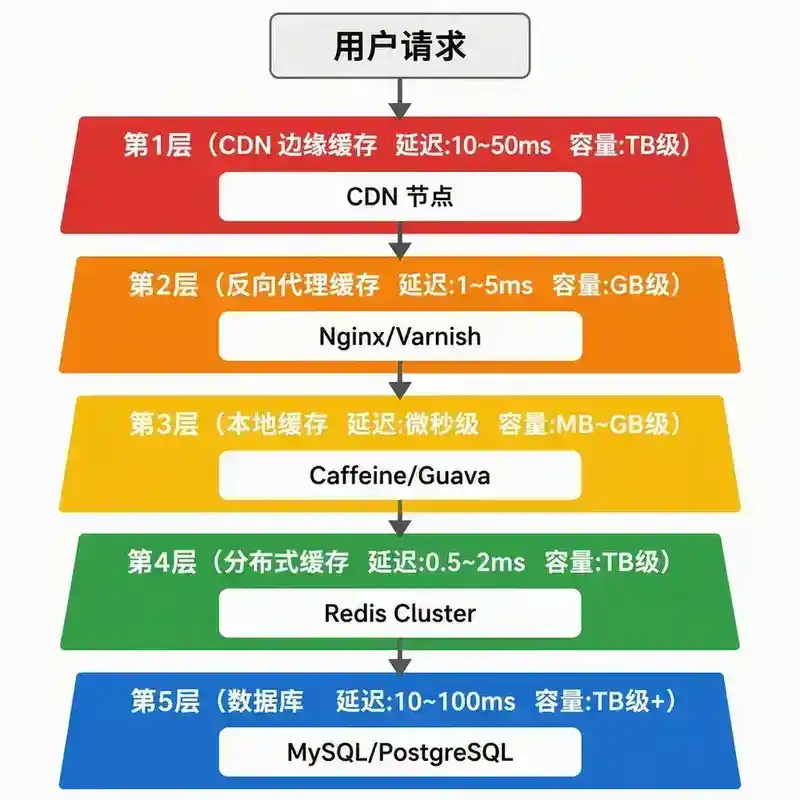
关键指标对比:
| 缓存层 | 典型延迟 | 容量 | 数据一致性 | 失效传播延迟 |
|---|---|---|---|---|
| CDN | 10~50ms | TB级 | 最终一致 | 秒~分钟级 |
| 反向代理 | 1~5ms | GB级 | 最终一致 | 毫秒~秒级 |
| 本地缓存 | 微秒级 | MB~GB级 | 弱一致 | 毫秒级 |
| 分布式缓存 | 0.5~2ms | TB级 | 可配置 | 实时 |
2.3 为什么需要多级?(核心动机)
单层 Redis 的问题:
- 网络开销:每次缓存访问都是一次网络往返(RTT 0.1~1ms),高并发下网络成为瓶颈
- 热点压力:单个热点 Key 会把 Redis 单节点打满
- 故障影响面:Redis 挂了,所有请求直接穿透到数据库
- 长尾延迟:即使 Redis P99 只有 2ms,每秒 10 万次请求的累积延迟也不可忽视
多级缓存的价值:
- 本地缓存:将热点数据缓存到 JVM 堆内,访问延迟从 1ms 降到 1μs,提升 1000 倍
- CDN:将静态/半静态内容推到离用户最近的边缘节点,减少回源流量
- 分层抗压:每一层拦截一部分流量,越靠近用户拦截越多
3. 第一级:本地缓存
3.1 本地缓存的本质
本地缓存是运行在应用进程内存中的缓存。它和应用程序共享同一个 JVM 堆,因此访问延迟极低(微秒级),但受限于单机内存容量。
核心优势:
- 零网络开销,纯内存访问
- 无序列化/反序列化开销(存对象引用)
- 极高的吞吐量(百万 QPS/核)
核心劣势:
- 各节点缓存独立,数据不一致
- 容量受限于堆内存
- 应用重启丢失全部缓存
3.2 主流实现:Caffeine vs Guava Cache vs Ehcache
Caffeine(推荐)
Caffeine 是目前 Java 生态性能最好的本地缓存库,基于 W-TinyLFU 淘汰算法。
Cache<String, Product> cache = Caffeine.newBuilder()
    .maximumSize(10_000)               // 最大条目数
    .expireAfterWrite(5, TimeUnit.MINUTES)  // 写入后过期
    .expireAfterAccess(1, TimeUnit.MINUTES) // 访问后过期
    .recordStats()                     // 开启统计
    .build();

Product product = cache.get("product:1001", key -> {
    // 缓存未命中,从数据库加载
    return productDao.findById(1001);
});
W-TinyLFU 算法原理:
Caffeine 使用 Window TinyLFU,结合了 LRU 和 LFU 的优点:
写入 → Window Cache (1% 容量,LRU)
         ↓ 晋升
       Main Cache (99% 容量,SLRU)
         ↓ 淘汰判断
       TinyLFU 过滤器 (Count-Min Sketch)
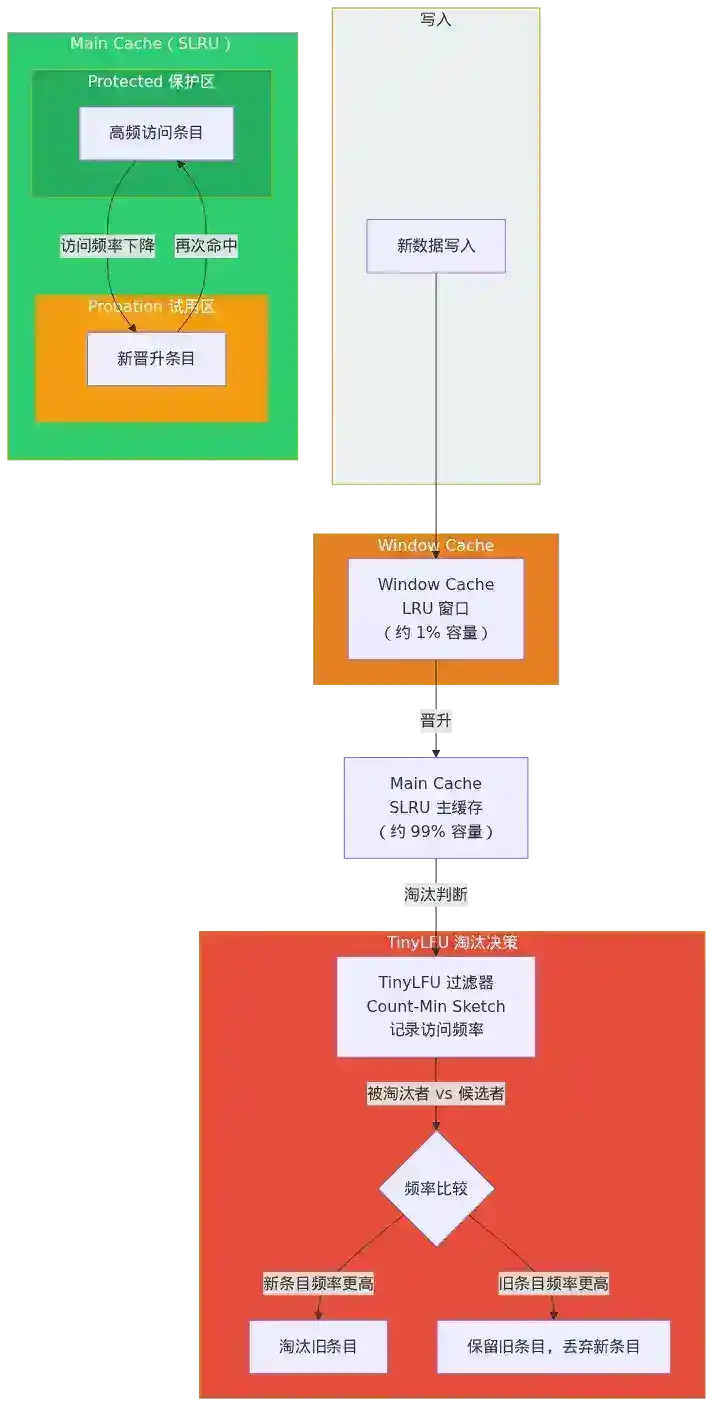
- Window Cache:新条目先进入小的 LRU 窗口,给它一个"证明自己"的机会
- Main Cache:使用 SLRU(Segmented LRU),分为 Probation(试用)和 Protected(保护)两个区域
- TinyLFU:使用 Count-Min Sketch 记录访问频率,决定是否淘汰
这种设计解决了传统 LRU"一次突发访问就把高频数据挤出"的问题,也解决了传统 LFU"历史高频数据占着位置不走"的问题。
Guava Cache
Guava Cache 是 Google Guava 库提供的本地缓存,采用 LRU 淘汰算法,功能较为基础:
LoadingCache<String, Product> cache = CacheBuilder.newBuilder()
    .maximumSize(10_000)
    .expireAfterWrite(5, TimeUnit.MINUTES)
    .build(new CacheLoader<String, Product>() {
        @Override
        public Product load(String key) {
            return productDao.findById(key);
        }
    });
Caffeine vs Guava 对比:
| 特性 | Caffeine | Guava Cache |
|---|---|---|
| 淘汰算法 | W-TinyLFU | LRU |
| 命中率 | 更高 | 基准 |
| 异步加载 | 原生支持 CompletableFuture | 仅同步 |
| 自动刷新 | 支持(基于时间) | 支持 |
| 统计信息 | 丰富 | 基础 |
| 驱逐监听 | 支持 | 支持 |
| 活跃维护 | GitHub 活跃 | 维护模式 |
Ehcache
Ehcache 支持堆内、堆外(off-heap)和磁盘三级存储,更适合需要大容量缓存的场景:
CacheManager cacheManager = CacheManagerBuilder.newCacheManagerBuilder()
    .withCache("productCache",
        CacheConfigurationBuilder.newCacheConfigurationBuilder(
            String.class, Product.class,
            ResourcePoolsBuilder.newResourcePoolsBuilder()
                .heap(1000, EntryUnit.ENTRIES)     // 堆内 1000 条
                .offheap(10, MemoryUnit.MB)         // 堆外 10MB
                .disk(100, MemoryUnit.MB, true)     // 磁盘 100MB
        )
        .withExpiry(ExpiryPolicyBuilder.timeToLiveExpiration(Duration.ofMinutes(5)))
    ).build(true);
3.3 本地缓存的失效问题
本地缓存最大的挑战是多节点一致性。当数据更新时,如何让所有应用节点的本地缓存同时失效?
方案一:主动通知(广播失效)
数据更新 → 发送 MQ 消息 → 所有节点消费 → 删除本地缓存
- 优点:实时性好
- 缺点:需要消息中间件,消息丢失风险
方案二:TTL 被动过期
数据更新 → 不主动通知 → 等 TTL 自然过期
- 优点:实现简单,无额外组件
- 缺点:一致性窗口 = TTL 时长
方案三:版本号校验
Product product = localCache.get(key);
if (product == null || product.getVersion() < redis.getVersion(key)) {
    product = productDao.findById(id);
    localCache.put(key, product);
}
- 优点:兼顾性能和一致性
- 缺点:仍需访问 Redis 获取版本号
4. 第二级:分布式缓存
4.1 Redis 集群架构
分布式缓存的核心是 Redis。在生产环境中,Redis 通常以集群方式部署。
Redis Cluster 架构:
┌──────────────────────────────────────────────────┐
│                   Redis Cluster                   │
│  ┌─────────┐  ┌─────────┐  ┌─────────┐          │
│  │ Master 1│  │ Master 2│  │ Master 3│          │
│  │Slot 0-5K│  │Slot 5K-10K│ │Slot 10K-16K│        │
│  └────┬────┘  └────┬────┘  └────┬────┘          │
│       │            │            │                 │
│  ┌────┴────┐  ┌────┴────┐  ┌────┴────┐          │
│  │ Slave 1 │  │ Slave 2 │  │ Slave 3 │          │
│  └─────────┘  └─────────┘  └─────────┘          │
└──────────────────────────────────────────────────┘
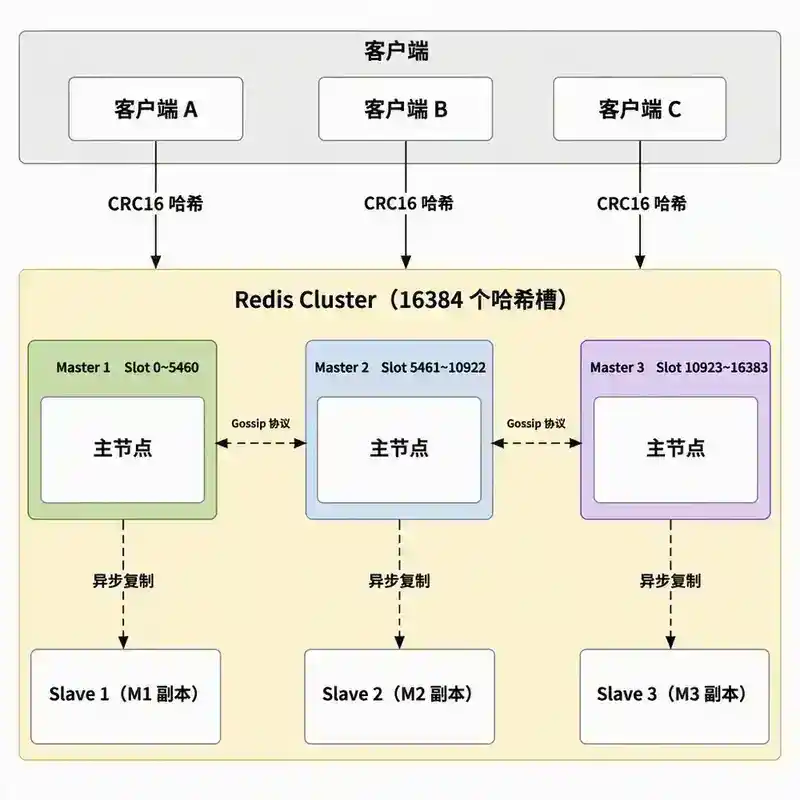
- 16384 个哈希槽:CRC16(key) % 16384 确定槽位
- Gossip 协议:节点间通过 Gossip 协议交换状态
- 自动故障转移:Master 宕机,Slave 自动提升
4.2 分布式缓存的一致性挑战
在分布式缓存中,一致性问题的根源在于多个数据副本:
客户端 A → 更新 Redis Master → 异步复制到 Slave
客户端 B → 在 Slave 同步完成前读取 → 读到旧数据
Redis 的一致性策略:
| 策略 | 一致性 | 可用性 | 适用场景 |
|---|---|---|---|
| WAIT 0(默认) | 弱 | 高 | 一般缓存 |
| WAIT 1 REPLICAS 1 | 中等 | 中 | 需保证一定一致性 |
| WAIT N REPLICAS N/2+1 | 强 | 低 | 关键数据 |
| Redlock(分布式锁) | 强 | 低 | 分布式锁场景 |
4.3 缓存与数据库双写一致性
这是分布式缓存中最经典的难题。常见策略:
Cache Aside(旁路缓存)——最常用:
读:先读缓存 → 命中返回 → 未命中读 DB → 写缓存 → 返回
写:更新 DB → 删除缓存(不是更新缓存!)
为什么是删除缓存而不是更新缓存?
- 更新缓存可能产生并发写问题:A 先更新 DB,B 后更新 DB,但 B 先更新缓存,A 后更新缓存 → 缓存是 A 的旧值
- 删除缓存是幂等操作
- 很多缓存值需要经过复杂计算,写完 DB 后不一定有条件立即计算新缓存值
延迟双删:
public void updateProduct(Product product) {
    // 第一步:先删除缓存
    redis.delete("product:" + product.getId());

    // 第二步:更新数据库
    productDao.update(product);

    // 第三步:延迟 N 毫秒后再删一次
    scheduler.schedule(() -> {
        redis.delete("product:" + product.getId());
    }, 500, TimeUnit.MILLISECONDS);
}
延迟双删解决的是:在"先删缓存→更新 DB"的窗口期内,另一个请求可能读到旧 DB 数据并写入缓存,导致缓存中永远是旧数据。
订阅 Binlog 方案(最高级):
应用更新 DB → MySQL 生成 binlog → Canal 监听 binlog → 解析 → 删除/更新 Redis
这种方案解耦了应用层和缓存层的更新逻辑,保证最终一致性。
5. 第三级:CDN 边缘缓存
5.1 CDN 工作原理
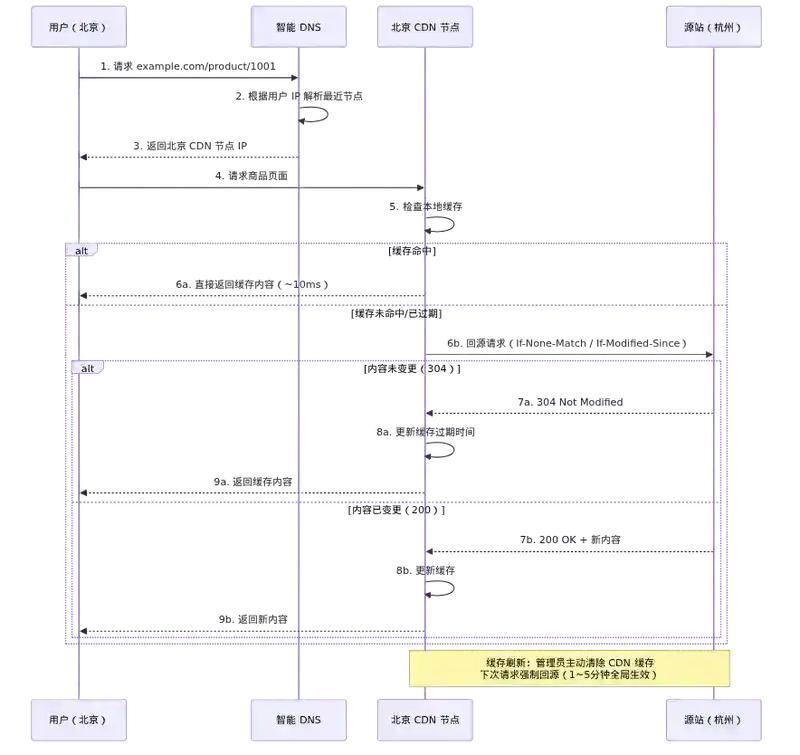
CDN(Content Delivery Network)将内容分发到全球各地的边缘节点,用户请求被智能 DNS 解析到最近的节点。
用户(北京)→ DNS 解析 → 北京 CDN 节点 → 命中/未命中
                              ↓ 未命中
                         回源到源站(杭州)
5.2 CDN 缓存策略
HTTP 缓存头控制:
Cache-Control: max-age=3600        # 缓存 1 小时
Cache-Control: s-maxage=600        # CDN 缓存 10 分钟(覆盖 max-age)
Cache-Control: no-cache            # 可缓存但必须验证
Cache-Control: no-store            # 完全不缓存
Cache-Control: public              # 可被 CDN 和浏览器缓存
Cache-Control: private             # 仅浏览器缓存
ETag 和 Last-Modified:
请求 → CDN 有缓存(已过期)→ 带 If-None-Match/If-Modified-Since 回源
     → 源站返回 304 Not Modified → CDN 继续使用缓存
     → 源站返回 200 + 新内容 → CDN 更新缓存
5.3 CDN 缓存刷新
CDN 缓存刷新是实现多级缓存一致的"最后一公里"。
URL 刷新:
POST /cdn/refresh
{"urls": ["https://example.com/product/1001.html"]}
目录刷新:
POST /cdn/refresh
{"dirs": ["https://example.com/products/"]}
刷新成本:
- URL 刷新:通常免费,每天有限额(如 2000 条/天)
- 目录刷新:通常免费,每天有限额(如 100 条/天)
- 刷新延迟:1~5 分钟(依赖 CDN 厂商)
预热 vs 刷新:
- 刷新:清除缓存,下次请求回源
- 预热:主动将内容推送到边缘节点,避免首次访问时的回源延迟
6. 多级缓存协同与数据流动
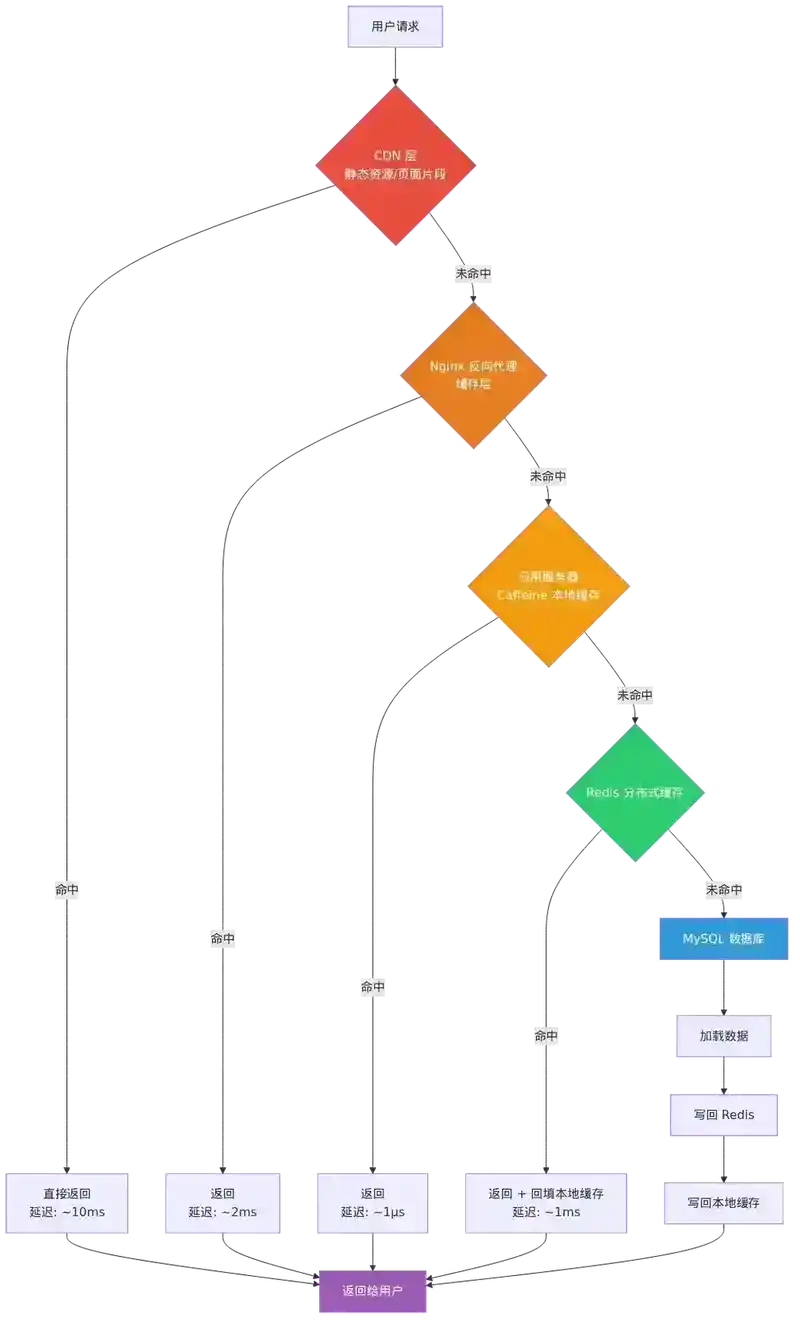
6.1 典型的多级缓存数据流
用户请求
  ↓
CDN 层(静态资源/页面片段)
  ├── 命中 → 直接返回(10ms)
  └── 未命中 → 回源到 Nginx
                ↓
          Nginx 反向代理缓存层
            ├── 命中 → 返回(2ms)
            └── 未命中 → 转发到应用服务器
                          ↓
                    应用服务器本地缓存(Caffeine)
                      ├── 命中 → 返回(1μs)
                      └── 未命中 → 查询 Redis
                                    ↓
                              Redis 分布式缓存
                                ├── 命中 → 返回(1ms)+ 写回本地缓存
                                └── 未命中 → 查询 MySQL
                                              ↓
                                        加载数据 → 写回 Redis → 写回本地缓存 → 返回
6.2 缓存回填策略
同步回填(默认):
未命中 → 查 DB → 写缓存 → 返回
缺点:第一个请求承担全部延迟。
异步回填:
未命中 → 返回旧值(如有)→ 异步查 DB → 写缓存
缺点:需要容忍短暂的数据不一致。
半异步回填(Caffeine refreshAfterWrite):
LoadingCache<String, Product> cache = Caffeine.newBuilder()
    .refreshAfterWrite(4, TimeUnit.MINUTES)  // 4 分钟后异步刷新
    .build(key -> productDao.findById(key));
当缓存过期但未到刷新时间时,返回旧值并异步加载新值,避免缓存击穿。
6.3 热点数据发现与预热
热点发现:
- 基于访问频率统计(滑动窗口计数)
- 基于 Redis 的 LFU 淘汰日志
- 基于监控系统(Prometheus + Grafana)
热点预热:
// 应用启动时预热热点数据
@PostConstruct
public void warmUp() {
    List<String> hotKeys = hotKeyDetector.getTopK(1000);
    for (String key : hotKeys) {
        String value = redis.get(key);
        if (value != null) {
            localCache.put(key, value);
        }
    }
}
7. 缓存一致性:核心难题
7.1 一致性模型
在多级缓存架构中,我们面对的是最终一致性问题。根据 CAP 理论,我们选择了 AP(可用性 + 分区容错),牺牲了强一致性。
一致性级别:
| 级别 | 描述 | 不一致窗口 | 典型场景 |
|---|---|---|---|
| 强一致 | 写入后所有读看到新值 | 0 | 金融交易 |
| 顺序一致 | 所有进程看到的操作顺序一致 | 极小 | 分布式锁 |
| 因果一致 | 有因果关系的操作有序 | 小 | 社交动态 |
| 最终一致 | 最终会一致,但可能延迟 | 秒~分钟 | 商品信息 |
| 弱一致 | 不保证一致性 | 很大 | 日志、统计 |
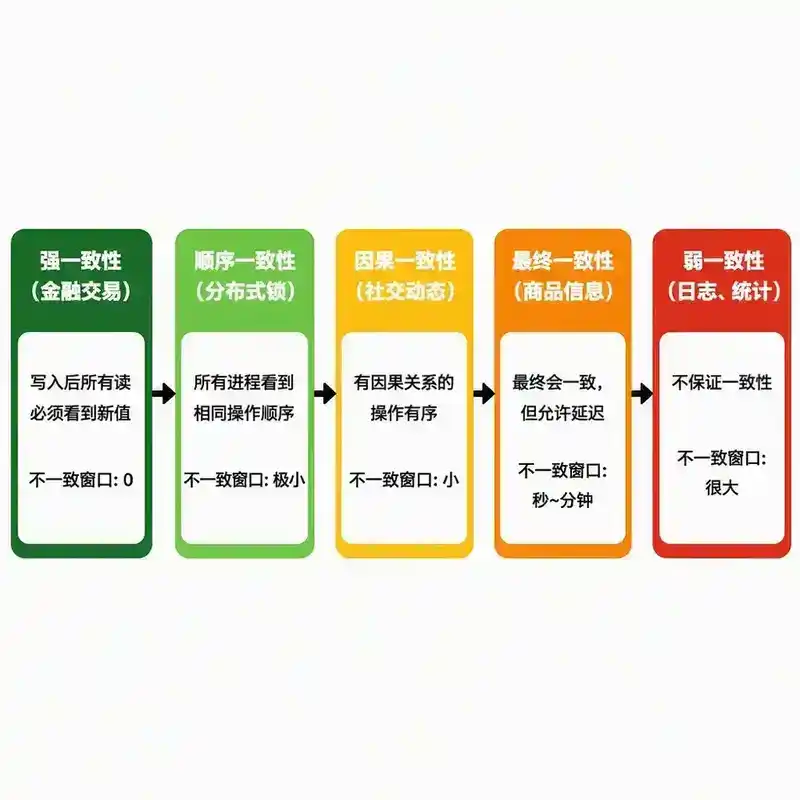
在多级缓存中,我们通常接受最终一致性,不一致窗口取决于 TTL 和失效传播延迟。
7.2 多级缓存一致性的特殊挑战
挑战一:更新传播延迟叠加
DB 更新 (t0)
  → Redis 删除 (t0 + 1ms)
    → 本地缓存 TTL 过期 (t0 + 5min)
      → CDN 刷新 (t0 + 1~5min)
        → 浏览器缓存过期 (t0 + 1h)
最坏情况下,用户可能在更新后 1 小时才看到新数据。
挑战二:不同层级的缓存粒度不同
CDN:缓存整个页面 HTML(粗粒度)
Nginx:缓存页面片段(中粒度)
本地缓存:缓存 Java 对象(细粒度)
Redis:缓存数据库行或聚合数据(中粒度)
一个商品的标题修改,可能需要:
- 清除 Redis 中该商品的缓存
- 清除本地缓存中该商品对象
- 清除 CDN 中该商品详情页
- 但不需要清除 CDN 中其他页面
挑战三:并发更新导致的写入冲突
时间线:
T1: Node A 更新 DB(version=2),删除 Redis
T2: Node B 更新 DB(version=3),删除 Redis
T3: Node A 的本地缓存过期,从 DB 读到 version=3,写入 Redis → 正确
T4: Node C 的本地缓存过期,从 DB 读到 version=3,写入 Redis → 正确
问题:如果 T3 和 T4 之间没有版本号校验,可能写入旧值。
7.3 一致性解决方案矩阵
                    ┌─────────────────────────────────────┐
                    │          一致性策略选择矩阵           │
                    ├──────────────┬──────────┬───────────┤
                    │   策略        │ 一致性   │ 复杂度    │
                    ├──────────────┼──────────┼───────────┤
                    │ TTL 过期      │ ★☆☆☆☆   │ ★☆☆☆☆    │
                    │ 主动失效      │ ★★★☆☆   │ ★★★☆☆    │
                    │ 版本号校验    │ ★★★★☆   │ ★★★☆☆    │
                    │ Binlog 订阅   │ ★★★★☆   │ ★★★★☆    │
                    │ 分布式事务    │ ★★★★★   │ ★★★★★    │
                    └──────────────┴──────────┴───────────┘
推荐组合策略:
本地缓存:TTL(5~10min)+ 主动失效(MQ 广播)
Redis:Cache Aside + 延迟双删 + Binlog 订阅(最终一致)
CDN:URL 刷新 + 版本化 URL(/app.v2.js 而非 /app.js)
8. 失效传播:从源头到边缘
8.1 失效传播链路
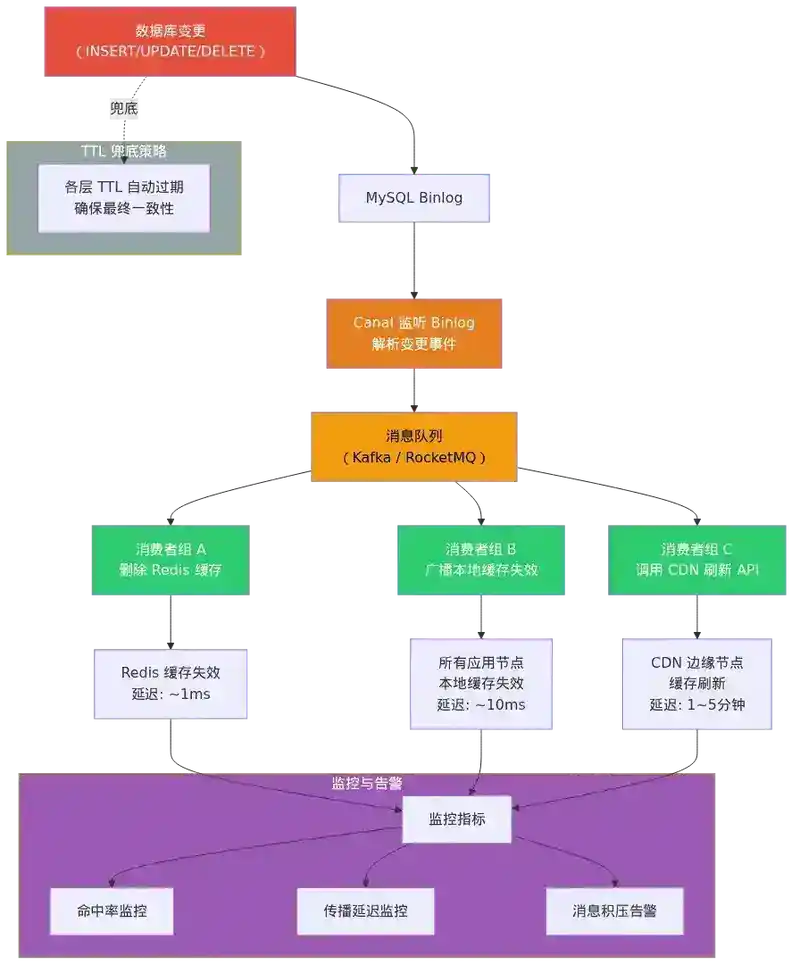
当数据发生变化时,失效信号需要从数据库层逐层传播到最外层:
数据变更(DB)
  ↓
Canal 监听 binlog
  ↓
失效消息发送到 MQ(Kafka/RocketMQ)
  ↓
┌─────────────────────────────────────┐
│  消费者组 A:删除 Redis 缓存         │
│  消费者组 B:广播本地缓存失效事件     │
│  消费者组 C:调用 CDN 刷新 API       │
└─────────────────────────────────────┘
8.2 失效消息的可靠性
关键问题:消息丢失怎么办?
- TTL 兜底:即使消息丢失,TTL 过期后缓存也会失效
- 消息重试:消费失败时重试,达到最大次数后进入死信队列
- 幂等性:删除缓存是幂等操作,重复消费无副作用
8.3 版本化 URL:CDN 缓存失效的最优解
对于 CDN 缓存,最好的失效策略不是"刷新",而是版本化 URL:
旧方案:/product.js → 更新后刷新 CDN → 等待生效(1~5min)
新方案:/product.v123.js → 更新后发布 /product.v124.js → 零等待
版本化 URL 的优势:
- 零延迟生效:新旧版本同时存在,新请求自然拿到新版本
- 无刷新成本:不需要调用 CDN 刷新 API
- 支持回滚:旧版本仍然可用
- 不可变缓存:可以设置极长的 max-age
8.4 失效传播的监控
监控指标:
├── 缓存命中率(按层级):CDN 命中率、Redis 命中率、本地缓存命中率
├── 失效传播延迟:从 DB 更新到各层缓存生效的时间差
├── 失效消息积压:MQ 消费者 lag
├── 缓存穿透率:到达 DB 的请求比例
└── 不一致检测:采样对比缓存值 vs DB 值
9. 实战:构建一个多级缓存系统
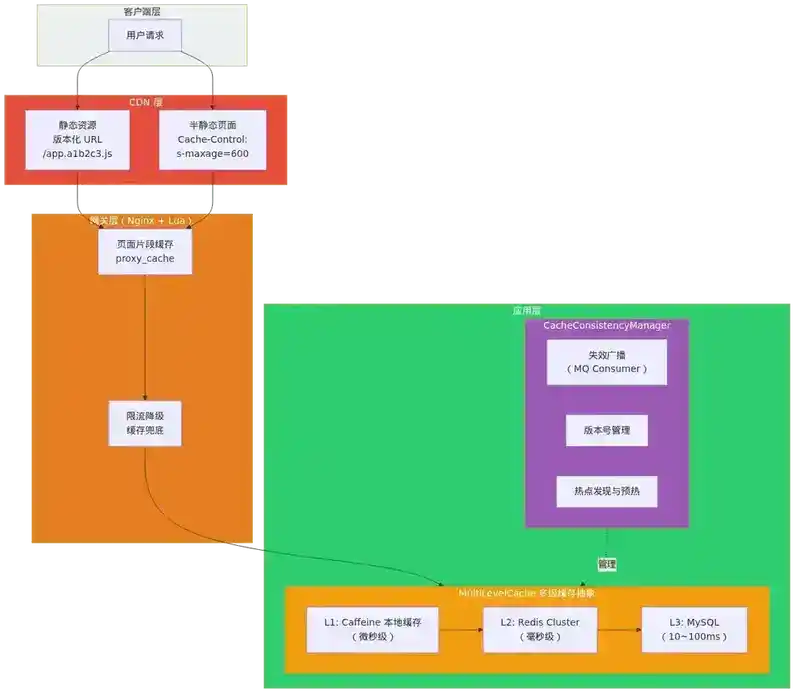
9.1 架构设计
┌──────────────────────────────────────────────────────────┐
│                      客户端请求                            │
└───────────────────────┬──────────────────────────────────┘
                        ↓
┌──────────────────────────────────────────────────────────┐
│  CDN 层                                                  │
│  - 静态资源:版本化 URL(/app.a1b2c3.js)                 │
│  - 半静态页面:Cache-Control: s-maxage=600               │
└───────────────────────┬──────────────────────────────────┘
                        ↓
┌──────────────────────────────────────────────────────────┐
│  网关层(Nginx + Lua)                                    │
│  - 页面片段缓存:proxy_cache                             │
│  - 限流降级:缓存兜底                                     │
└───────────────────────┬──────────────────────────────────┘
                        ↓
┌──────────────────────────────────────────────────────────┐
│  应用层                                                  │
│  ┌────────────────────────────────────────────┐          │
│  │  MultiLevelCache(多级缓存抽象)            │          │
│  │  ┌──────────┐  ┌──────────┐  ┌──────────┐ │          │
│  │  │ L1: 本地  │  │ L2: Redis│  │ L3: DB   │ │          │
│  │  │ Caffeine │→ │ Cluster  │→ │  MySQL   │ │          │
│  │  └──────────┘  └──────────┘  └──────────┘ │          │
│  └────────────────────────────────────────────┘          │
│  ┌────────────────────────────────────────────┐          │
│  │  CacheConsistencyManager(一致性管理)      │          │
│  │  - 失效广播(MQ Consumer)                  │          │
│  │  - 版本号管理                               │          │
│  │  - 热点发现与预热                           │          │
│  └────────────────────────────────────────────┘          │
└──────────────────────────────────────────────────────────┘
9.2 核心代码实现
MultiLevelCache 抽象:
public class MultiLevelCache<K, V> {

    private final Cache<K, V> localCache;      // L1: Caffeine
    private final RedisTemplate<String, V> redis;  // L2: Redis
    private final CacheLoader<K, V> dbLoader;  // L3: DB

    public V get(K key) {
        // L1: 本地缓存
        V value = localCache.getIfPresent(key);
        if (value != null) {
            metrics.recordHit("L1");
            return value;
        }

        // L2: Redis
        String redisKey = buildRedisKey(key);
        value = redis.opsForValue().get(redisKey);
        if (value != null) {
            metrics.recordHit("L2");
            localCache.put(key, value);  // 回填 L1
            return value;
        }

        // L3: Database
        metrics.recordHit("L3");
        value = dbLoader.load(key);
        if (value != null) {
            redis.opsForValue().set(redisKey, value,
                Duration.ofMinutes(30));  // 回填 L2
            localCache.put(key, value);   // 回填 L1
        }
        return value;
    }

    public void evict(K key) {
        localCache.invalidate(key);
        redis.delete(buildRedisKey(key));
    }
}
失效广播消费者:
@RocketMQMessageListener(topic = "cache-invalidation", consumerGroup = "cache-invalidation-group")
public class CacheInvalidationConsumer implements RocketMQListener<InvalidationMessage> {

    @Override
    public void onMessage(InvalidationMessage msg) {
        String cacheKey = msg.getCacheKey();
        InvalidationScope scope = msg.getScope();

        switch (scope) {
            case LOCAL_ONLY:
                localCache.invalidate(cacheKey);
                break;
            case REDIS_ONLY:
                redis.delete(cacheKey);
                break;
            case ALL:
                localCache.invalidate(cacheKey);
                redis.delete(cacheKey);
                break;
        }
    }
}
9.3 监控与告警
@Component
public class CacheMetrics {

    private final MeterRegistry registry;

    // 各层命中率
    private final Counter l1Hits, l2Hits, l3Hits, l1Misses, l2Misses, l3Misses;

    // 失效传播延迟
    private final Timer invalidationPropagationLatency;

    public void recordHit(String level) {
        switch (level) {
            case "L1": l1Hits.increment(); break;
            case "L2": l2Hits.increment(); break;
            case "L3": l3Hits.increment(); break;
        }
    }

    @Scheduled(fixedRate = 60000)
    public void reportMetrics() {
        double l1Rate = l1Hits.count() / (l1Hits.count() + l1Misses.count());
        double l2Rate = l2Hits.count() / (l2Hits.count() + l2Misses.count());

        log.info("Cache hit rates - L1: {:.2%}, L2: {:.2%}", l1Rate, l2Rate);

        // 告警:L1 命中率低于 80%
        if (l1Rate < 0.8) {
            alertService.send("L1 缓存命中率异常: {:.2%}", l1Rate);
        }
    }
}
10. 总结
核心要点回顾
- 多级缓存的本质:用空间换时间,用冗余换可用性,用近端换延迟
- 三层缓存架构:本地缓存(Caffeine,微秒级)→ 分布式缓存(Redis,毫秒级)→ CDN(十毫秒级)
- 一致性是最大挑战:多级缓存天然有数据不一致窗口,需要接受最终一致性
- 失效传播策略:TTL 被动过期 + 主动失效广播 + 版本号校验 + Binlog 订阅
- CDN 最佳实践:版本化 URL 是最优的 CDN 缓存失效策略
- 监控必不可少:各层命中率、失效传播延迟、穿透率是关键指标
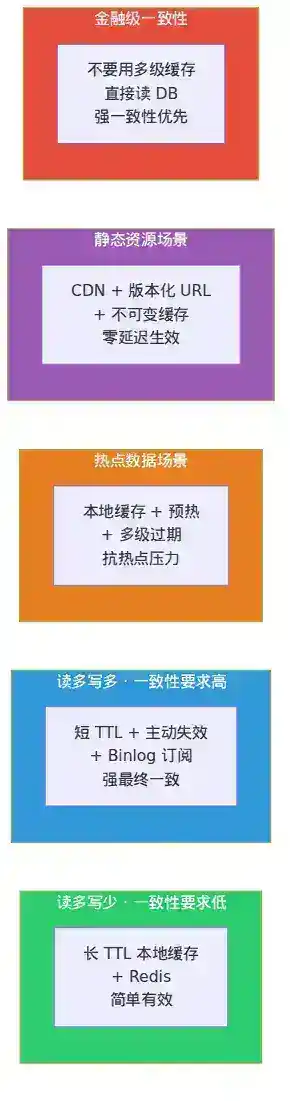
架构决策指南
| 场景 | 推荐方案 |
|---|---|
| 读多写少、一致性要求低 | 长 TTL 本地缓存 + Redis |
| 读多写多、一致性要求高 | 短 TTL + 主动失效 + Binlog 订阅 |
| 热点数据 | 本地缓存 + 预热 + 多级过期 |
| 静态资源 | CDN + 版本化 URL |
| 金融级一致性 | 不要用多级缓存,直接读 DB |
11. 面试官提问
以下问题从面试官视角设计,考察对多级缓存架构的深度理解。
Q1:你的系统使用了 Caffeine(本地缓存)+ Redis(分布式缓存)两级缓存。某天运营修改了一个商品的价格,用户反馈 5 分钟后才看到新价格。请分析可能的原因,并给出改进方案。
Q1 参考答案:
5 分钟的延迟大概率是本地缓存 TTL 恰好设为 5 分钟,加上没有主动失效机制。改进方案分三层:
- 缩短 TTL:将本地缓存 TTL 从 5 分钟降到 30 秒,但会增加 Redis 压力,需要评估
- 主动失效(推荐):运营修改商品后,通过 MQ 发送 CacheInvalidation 消息,所有节点消费后删除本地缓存。配合 TTL(如 10 分钟)作为兜底
- 版本号校验:Redis 中维护
product:{id}:version,本地缓存读取时比对版本号,不一致则重新加载
最佳实践组合:短 TTL(1~2 分钟)+ 主动失效广播 + 版本号兜底。这样即使消息丢失,最多 2 分钟内也能看到新价格。
Q2:假设你有一个电商首页,QPS 10 万,其中 80% 的流量集中在 100 个热点商品。如果只使用 Redis Cluster(3 主 3 从),会有哪些风险?引入本地缓存后如何设计热点数据的发现和预热机制?
Q2 参考答案:
仅用 Redis Cluster 的风险:
- 热点 Key 打爆单分片:100 个热点商品的 Key 经过哈希可能落在同一个 Slot,导致单个 Master 节点 CPU 飙升
- 网络带宽瓶颈:10 万 QPS × 80% = 8 万 QPS 打在 Redis 上,单节点网卡可能成为瓶颈
- 单线程阻塞:高并发下 Redis 单线程模型可能因 big key 或慢查询阻塞其他请求
引入本地缓存后的设计:
- 热点发现:基于滑动窗口计数器(如 Caffeine 的 frequency sketch),统计每个 Key 的访问频率,超过阈值(如 1000 QPS)标记为热点
- 多级过期:热点数据本地缓存 TTL 设为 30 秒~1 分钟,非热点数据直接走 Redis
- 预热机制:应用启动时从 Redis 加载 Top-K 热点 Key 到本地缓存,避免冷启动击穿
- 动态调整:热点 Key 变化时,通过 MQ 广播"热点变更"事件,通知节点调整本地缓存策略
预期效果:本地缓存可拦截 90%+ 的热点请求,Redis 实际 QPS 降到 8000 以下。
Q3:你的多级缓存系统中,失效消息通过 Kafka 广播。某天 Kafka 集群故障 30 分钟,期间发生了大量数据更新。Kafka 恢复后,你如何保证缓存数据最终一致?需要考虑哪些边界情况?
Q3 参考答案:
Kafka 恢复后的最终一致性保证策略:
- TTL 兜底:所有缓存都有 TTL(如 10 分钟),Kafka 恢复后,过期的缓存自然被新数据替换
- 全量对账:Kafka 恢复后,触发一次全量缓存对账任务——扫描 DB 中近 30 分钟有变更的数据,对比 Redis 中的版本号,不一致的主动删除重建
- 增量追赶:Kafka 消费者从上次提交的 offset 继续消费,追赶积压的失效消息(注意幂等——删除缓存是幂等操作)
- 边界情况:
- 如果 Kafka 30 分钟内积压了 1000 万条消息,全量追赶可能耗时较长,需要限流避免打爆 Redis
- 如果某条数据在故障期间被修改了多次,Kafka 消息中可能有多条针对同一 Key 的失效消息,幂等处理即可
- 如果 TTL 在这 30 分钟内已过期,但用户读到了旧数据(因为回源时 DB 已被更新),需要确保写入时更新了版本号
核心原则:消息丢失不可怕,TTL 兜底 + 对账机制保证最终一致。
Q4:CDN 缓存刷新通常需要 1~5 分钟才能全球生效。你在发布一个前端页面时,如何保证用户立即看到新版本?请对比"CDN 刷新"和"版本化 URL"两种方案的优劣,并说明版本化 URL 在生产环境中的落地细节(包括构建流程、部署策略、旧版本清理)。
Q4 参考答案:
| 维度 | CDN 刷新 | 版本化 URL |
|---|---|---|
| 生效延迟 | 1~5 分钟 | 0 秒(即时) |
| 操作成本 | 需调用 API,有配额限制 | 构建时自动生成,无额外成本 |
| 回滚能力 | 刷新后旧版本丢失 | 旧版本文件仍存在,可直接回滚 |
| 缓存效率 | 短 TTL,频繁回源 | 长 TTL(甚至永久),Cache-Control: immutable |
| HTTP 缓存 | 需协商缓存(304) | 强缓存(200 from cache) |
| 复杂度 | 简单 | 需构建工具支持 |
版本化 URL 落地细节:
- 构建流程:Webpack/Vite 配置
output.filename: '[name].[contenthash].js',文件内容哈希作为版本号 - HTML 引用更新:构建时自动生成带哈希的 manifest.json,服务端渲染时注入正确的资源 URL
- 部署策略:先部署静态资源到 CDN(新版本文件),再部署 HTML 到源站(引用新版本)。因为新旧版本文件共存,无时序依赖
- 旧版本清理:保留最近 N 个版本(如 3 个),定期清理更早的版本。通过 CDN 的 Object Lifecycle 策略自动过期
Q5:你在设计一个"缓存穿透保护"时,发现布隆过滤器放在本地缓存层和 Redis 层各有优劣。请分析两种方案在一致性、内存占用、更新延迟方面的差异,并给出你的选择理由。
Q5 参考答案:
| 维度 | 本地缓存层布隆过滤器 | Redis 层布隆过滤器 |
|---|---|---|
| 一致性 | 各节点独立,更新需广播,不一致窗口大 | 集中管理,更新即时生效 |
| 内存占用 | 每节点一份,1000 节点 = 1000× 开销 | 一份,Redis 内存成本 |
| 更新延迟 | 需 MQ 广播,0~500ms | 直接更新 Redis,1ms |
| 可用性 | 不依赖 Redis,Redis 挂了也能防护 | 依赖 Redis 可用性 |
| 穿透防护效果 | 优秀(本地直接拦截) | 好(需一次网络调用) |
我的选择:Redis 层布隆过滤器 + 本地缓存层可选。
理由:布隆过滤器的一致性要求较高——如果布隆过滤器说"不存在"但实际数据已写入,会导致请求被错误拦截(假阳性误判)。集中管理的 Redis 布隆过滤器可以保证更新后立即生效。本地缓存层可以加一层轻量级的"负缓存"(缓存"不存在"的结果,TTL 很短如 1 分钟),作为 Redis 布隆过滤器不可用时的兜底。
Q6:假设你的系统有 1000 个应用节点,每个节点都有本地缓存。当一条数据更新后,你通过 MQ 广播失效消息。消息到达不同节点的时间有 0~500ms 的差异。在这个窗口期内,用户可能先请求到"已失效"的节点(看到新数据),然后刷新页面请求到"未失效"的节点(看到旧数据)。这种"时间旅行"体验如何解决?是否可以接受?
Q6 参考答案:
这种"时间旅行"体验在分布式系统中称为 Monotonic Read(单调读)不一致。解决方案:
- 可以接受的情况:对于商品信息、文章内容等非关键数据,500ms 的不一致窗口完全可以接受。用户刷新页面后看到旧数据,再刷新一次就能看到新数据,体验影响很小
- 需要解决的情况:对于订单状态、库存数量等关键数据,可以使用以下方案:
- 会话粘性(Session Stickiness):通过 Cookie/Header 将同一用户的请求路由到同一节点(但牺牲了负载均衡)
- 客户端版本号:响应中带上数据版本号,客户端下次请求时带上
If-None-Match,服务端发现版本不一致时返回最新数据 - 读己之写(Read-Your-Writes):对于用户自己修改的数据,写操作完成后直接从 DB 读取(不走缓存),保证用户始终看到自己的最新修改
- 根本性的权衡:这是 CAP 理论中 AP 系统的必然代价。如果业务要求强一致性,应该对这部分数据放弃多级缓存,直接读 DB
面试官追问:如果这个"时间旅行"发生在金融交易场景呢?——答案:金融场景不接受这种不一致,应该使用数据库行锁 + 版本号乐观锁,而不是多级缓存。
下一篇预告:146|消息队列核心概念与选型:Kafka、RocketMQ、RabbitMQ 对比