阅读时间:约 40-50 分钟 | 难度:中高级 | 适用场景:Redis 缓存治理、高并发系统设计、面试准备
一、从一次生产事故说起
2024 年双十一大促,某电商平台的 Redis 集群突然出现严重倾斜:某个分片的 CPU 使用率飙到 95%,而其他分片只有 30%。与此同时,客户端出现大量超时,订单服务开始降级。排查后发现,罪魁祸首是一个商品的库存缓存 Key——它在秒杀期间的 QPS 超过了 50 万,直接把对应的 Redis 节点打挂。
这不是孤立事件。在 Redis 运维中,**热 Key(Hot Key)和大 Key(Big Key)**是两类最隐蔽也最具破坏力的问题。它们不像内存溢出那样立刻报错,而是以"请求变慢""节点不均""偶尔超时"的形式逐步侵蚀系统稳定性。
本文将带你从原理到实践,全面拆解这两个问题。
二、热 Key 与大 Key 的定义与边界
2.1 什么是热 Key?
热 Key 是指单位时间内被访问频率远超其他 Key 的 Key。 判断标准不是绝对的,而是相对于集群整体 QPS 的偏离程度。
| 场景 | 判断基准 |
|---|---|
| 一般业务 | 单个 Key 的 QPS 超过集群平均 QPS 的 10 倍 |
| 高并发系统 | 单个 Key QPS 超过 1 万,或超过分片承载能力的 50% |
| 极端场景(秒杀/热点事件) | 单个 Key QPS 超过 10 万 |
典型的热 Key 场景:
- 秒杀商品的库存缓存
- 明星/热门内容的详情缓存
- 全局配置项(被所有服务频繁读取)
- 计数器 Key(如点赞数、阅读数)
2.2 什么是大 Key?
大 Key 是指单个 Key 的 Value 占用内存过大,或单个 Key 内元素数量过多的 Key。 这里要区分 Redis 不同数据结构:
| 数据结构 | 大 Key 判定标准 | 风险等级 |
|---|---|---|
| String | Value 大小 > 10KB | ⚠️ 中等 |
| String | Value 大小 > 10MB | 🔴 严重 |
| Hash/Set/ZSet/List | 元素数量 > 5000 | ⚠️ 中等 |
| Hash/Set/ZSet/List | 元素数量 > 50000 | 🔴 严重 |
注意:阿里云 Redis 官方建议 String 类型控制在 10KB 以内,集合类型元素控制在 5000 以内。这不是硬限制,但超过这些阈值,命令的执行延迟会显著上升。
典型的大 Key 场景:
- 用户会话数据(Hash,存储了所有历史行为)
- 排行榜(ZSet,千万级元素)
- 消息队列积压(List,百万级消息)
- 全量缓存数据(String,把整个数据库表序列化存入)
2.3 热 Key ≠ 大 Key
一个 Key 可以同时是热 Key 和大 Key,也可以只满足其一。例如:
- 一个只有 100 字节的库存计数器,QPS 50 万 → 纯热 Key
- 一个 100MB 的冷数据备份,每小时只访问一次 → 纯大 Key
- 一个 5MB 的热门商品详情,QPS 2 万 → 热 Key + 大 Key
这两种问题的危害机制和解决思路完全不同,需要分开讨论。
三、热 Key 深度解析
3.1 热 Key 的危害
热 Key 的破坏力来自 Redis 的单线程模型(指命令执行线程)和集群的数据分片机制:
3.1.1 单节点过载
在 Redis Cluster 中,每个 Key 通过 CRC16 哈希映射到固定的 16384 个哈希槽(slot),每个槽只属于一个节点。热 Key 的所有请求都会落到同一个节点,导致该节点 CPU 被打满,而其他节点空闲。
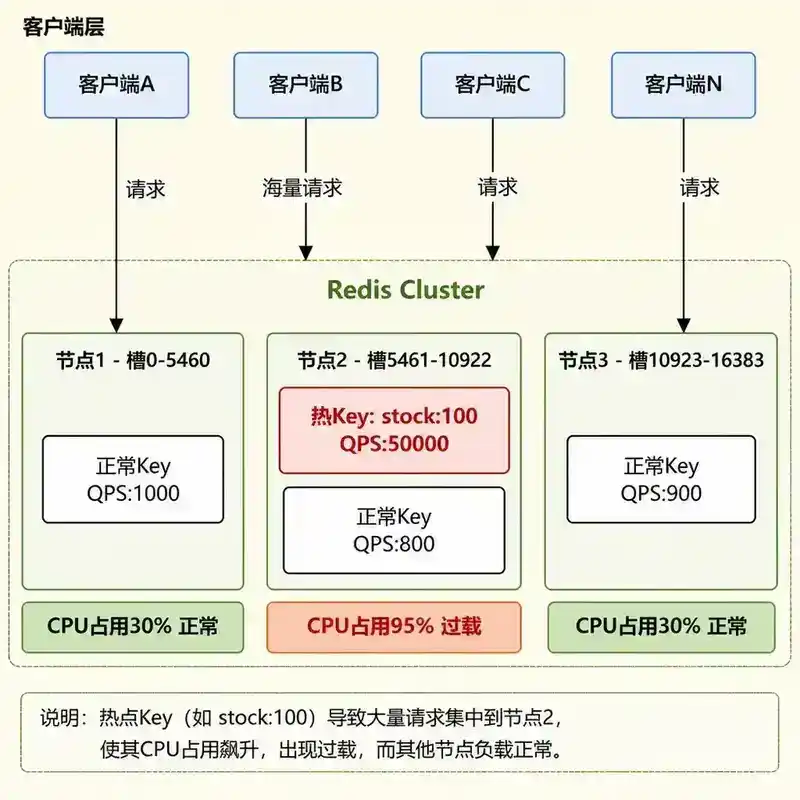
3.1.2 请求排队与雪崩
Redis 虽然是单线程执行命令,但 I/O 多线程(Redis 6.0+)和事件循环意味着:当热 Key 请求堆积时,其他 Key 的请求也会被阻塞在队列中,导致整个节点的响应延迟飙升。如果该节点是 Sentinel 的主节点,还会引发不必要的故障转移。
3.1.3 带宽打满
即使 Redis 单次操作很快,海量请求的入站/出站流量也可能把网卡带宽占满。对于 1Gbps 的网卡,如果每个请求+响应 1KB,50 万 QPS 就需要约 4Gbps 的带宽,远超物理极限。
3.1.4 客户端连锁超时
当 Redis 响应变慢,客户端连接池中的连接被耗尽,新的请求无法获取连接,触发超时。如果业务层没有做好降级,超时会沿着调用链向上传播,最终拖垮整个服务。
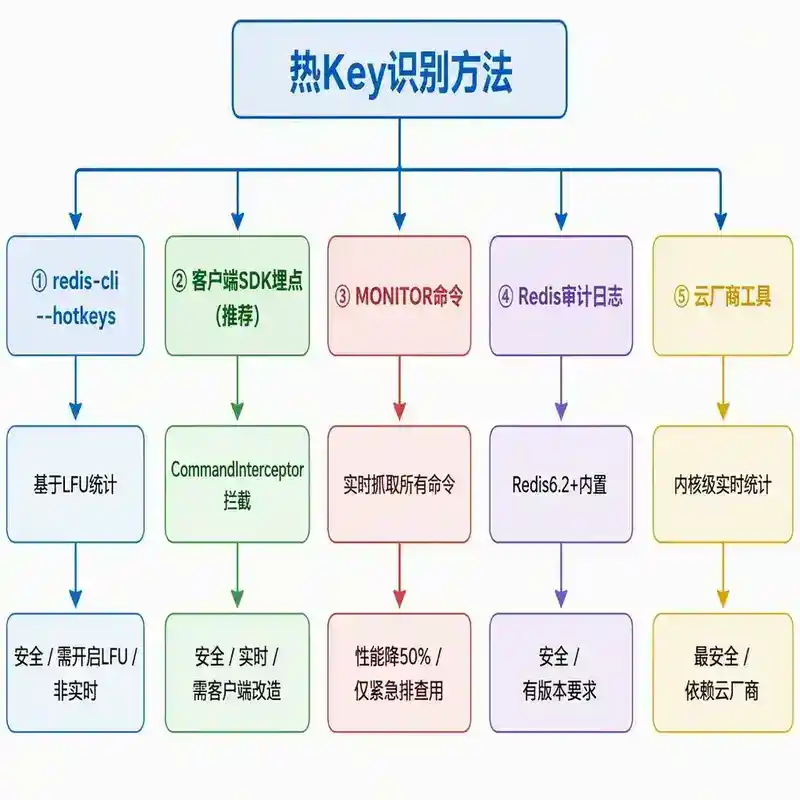
3.2 热 Key 的识别方法
3.2.1 Redis CLI 实时监控
# 使用 redis-cli 的 --hotkeys 参数(需要 Redis 4.0+)
redis-cli --hotkeys -a your_password

# 输出示例:
# Hot Keys found:
# [mykey1] has 12345 requests in 1 second
# [mykey2] has 9876 requests in 1 second
--hotkeys 基于 Redis 内置的 LFU(Least Frequently Used)统计信息,需要先开启 LFU 淘汰策略或设置 maxmemory-policy 为 allkeys-lfu 或 volatile-lfu。
3.2.2 MONITOR 命令(谨慎使用)
redis-cli MONITOR | grep "GET\|HGET" | awk '{print $4}' | sort | uniq -c | sort -nr | head -20
注意:MONITOR 命令会显著降低 Redis 性能(约 50%),生产环境慎用,只能在低峰期或有紧急排查需求时使用。
3.2.3 客户端 SDK 埋点(推荐)
在客户端侧统计每个 Key 的访问频率是最安全、最准确的方式:
// 使用 Jedis/Lettuce 的拦截器统计热 Key
public class HotKeyInterceptor implements CommandInterceptor {
    private ConcurrentHashMap<String, AtomicLong> keyCounter = new ConcurrentHashMap<>();
    private ScheduledExecutorService scheduler = Executors.newSingleThreadScheduledExecutor();

    public HotKeyInterceptor() {
        // 每秒上报统计
        scheduler.scheduleAtFixedRate(() -> {
            keyCounter.forEach((key, count) -> {
                if (count.get() > 1000) { // 阈值
                    log.warn("Hot key detected: {}, QPS: {}", key, count.get());
                }
            });
            keyCounter.clear();
        }, 1, 1, TimeUnit.SECONDS);
    }
}
3.2.4 Redis 审计日志
Redis 6.2+ 支持审计日志,可以记录慢查询和访问模式:
CONFIG SET audit-log-enabled yes
CONFIG SET audit-log-max-age 3600
3.2.5 云厂商工具
阿里云 Redis 提供"热 Key 分析"功能,基于内核级别的实时统计,无需客户端改造。腾讯云、华为云也有类似能力。
3.3 热 Key 解决方案
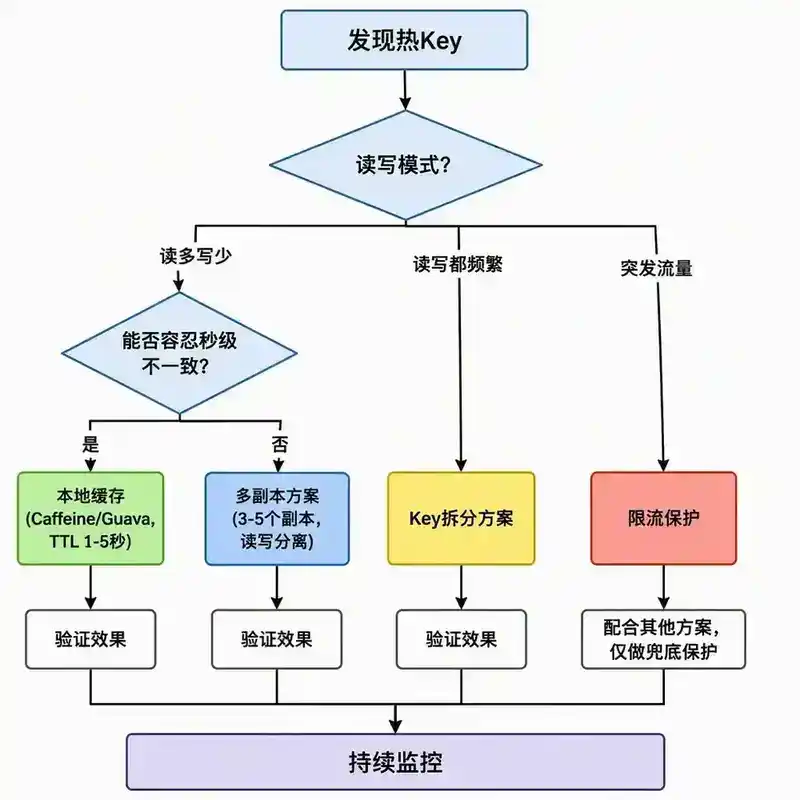
3.3.1 本地缓存(多级缓存)
核心思路:将热 Key 的数据缓存在应用进程的本地内存中,减少对 Redis 的访问。
// 使用 Caffeine 实现两级缓存
public class TwoLevelCache {
    private Cache<String, Object> localCache = Caffeine.newBuilder()
        .maximumSize(1000)
        .expireAfterWrite(3, TimeUnit.SECONDS)  // 本地缓存过期时间短
        .build();

    private RedisTemplate<String, Object> redis;

    public Object get(String key) {
        // 一级缓存:本地
        Object value = localCache.getIfPresent(key);
        if (value != null) return value;

        // 二级缓存:Redis
        value = redis.opsForValue().get(key);
        if (value != null) {
            localCache.put(key, value);
        }
        return value;
    }
}
关键设计点:
- 本地缓存过期时间要短(1-5 秒),以确保数据一致性
- 本地缓存大小要有限制,防止 OOM
- 对于极高一致性要求的场景(如库存),本地缓存不适用
3.3.2 读写分离 + 多副本
核心思路:为热 Key 创建多个只读副本,分散读请求到不同的 Redis 从节点。
public class HotKeyReplicator {
    // key_副本序号 作为实际 Key
    private static final int REPLICA_COUNT = 10;

    public Object get(String key) {
        // 随机选择副本
        int replicaIndex = ThreadLocalRandom.current().nextInt(REPLICA_COUNT);
        String replicaKey = key + "_rep_" + replicaIndex;
        return redis.get(replicaKey);
    }

    public void set(String key, Object value) {
        // 写操作:更新所有副本
        for (int i = 0; i < REPLICA_COUNT; i++) {
            redis.set(key + "_rep_" + i, value, 10, TimeUnit.SECONDS);
        }
    }
}
注意事项:
- 副本数不是越多越好,需要权衡内存开销和负载均衡效果
- 写操作需要同步更新所有副本,写多读少的场景不适用
- 副本数据一致性是最终一致,存在短暂的不一致窗口
3.3.3 热 Key 拆分
核心思路:将一个热 Key 拆分为多个子 Key,将请求分散到不同的哈希槽和节点。
以秒杀库存为例:
// 将 total_stock 拆分为 N 个分片
public class StockSplitter {
    private static final int SEGMENT_COUNT = 20;

    public Long deduct(String productId, String userId) {
        // 按用户 ID 哈希路由到不同的库存分片
        int segmentIndex = Math.abs(userId.hashCode()) % SEGMENT_COUNT;
        String segmentKey = "stock:" + productId + ":" + segmentIndex;

        // 使用 Lua 脚本保证原子性扣减
        String script = "local stock = redis.call('get', KEYS[1]) " +
                        "if stock and tonumber(stock) > 0 then " +
                        "    return redis.call('decr', KEYS[1]) " +
                        "else return -1 end";
        return redis.eval(script, List.of(segmentKey));
    }
}
设计要点:
- 分片键的选择要保证请求均匀分布(用 userId、requestId 等)
- 库存类场景需要额外逻辑汇总各分片库存
- 分片数需要提前规划,动态调整分片数比较复杂
3.3.4 请求限流
核心思路:在 Redis 前加一层限流,防止热 Key 请求压垮 Redis。
// 使用令牌桶 + Redis 实现分布式限流
public class HotKeyRateLimiter {
    public boolean isAllowed(String key, int maxQps) {
        String luaScript =
            "local key = KEYS[1] " +
            "local limit = tonumber(ARGV[1]) " +
            "local current = redis.call('get', key) " +
            "if current and tonumber(current) >= limit then " +
            "    return 0 " +
            "else " +
            "    redis.call('incr', key) " +
            "    redis.call('expire', key, 1) " +
            "    return 1 " +
            "end";
        return redis.eval(luaScript, List.of("rate_limit:" + key), String.valueOf(maxQps)) == 1L;
    }
}
注意:限流是治标不治本的手段,只能保护 Redis 不被击垮,不能解决热 Key 本身的问题。需要配合其他方案(如本地缓存、拆分)一起使用。
3.3.5 方案对比
| 方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 本地缓存 | 读多写少,可容忍秒级不一致 | 效果最好,几乎零延迟 | 一致性弱,内存占用 |
| 多副本 | 读多写少 | 实施简单,Redis 原生支持 | 内存翻倍,写放大 |
| Key 拆分 | 写操作频繁(如库存) | 彻底解决热点 | 实现复杂,需要业务配合 |
| 限流 | 突发流量保护 | 兜底保护 | 牺牲可用性,影响用户体验 |
四、大 Key 深度解析
4.1 大 Key 的危害
大 Key 的破坏力与热 Key 不同,主要体现在阻塞操作和资源消耗上。
4.1.1 网络带宽被单次操作耗尽
一个大 Key 的 Value 如果是 100MB,一次 GET 操作就需要传输 100MB 数据。如果网卡带宽是 1Gbps,仅这一个请求就占用约 0.8 秒的带宽,在此期间其他请求的响应时间会显著增加。
4.1.2 删除操作阻塞 Redis
在 Redis 4.0 之前,DEL 命令删除大 Key 是同步阻塞的:
# 删除一个 500 万元素的 Set
DEL big_set_key
# 这个操作可能阻塞 Redis 主线程 1-2 秒!
Redis 是单线程执行命令,删除一个大 Key 时,所有其他客户端请求都会排队等待。
4.1.3 内存分配与碎片
大 Key 的频繁修改会导致严重的内存碎片。例如,一个 top 100 排行榜 ZSet 如果实时更新,每次增删元素都会在内存中留下空洞。Redis 使用 jemalloc 内存分配器,虽然已经做了很多优化,但极端情况下内存碎片率(mem_fragmentation_ratio)可能超过 2.0。
4.1.4 主从复制中断
Redis 的主从复制是全量 + 增量模式。如果一个节点上存在大量的大 Key,全量同步(RDB 传输)会非常慢。更严重的是,如果大 Key 频繁更新,复制缓冲区(replication buffer)可能溢出,导致频繁的全量同步循环。
4.1.5 过期删除卡顿
Redis 的过期删除有两种策略:惰性删除和定期删除。如果一个大 Key 过期:
- 惰性删除:当有请求访问这个 Key 时,Redis 发现它过期了,同步删除,请求响应时间突然飙升
- 定期删除:Redis 定期随机抽取一批 Key 检查过期,大 Key 被选中时也会造成卡顿
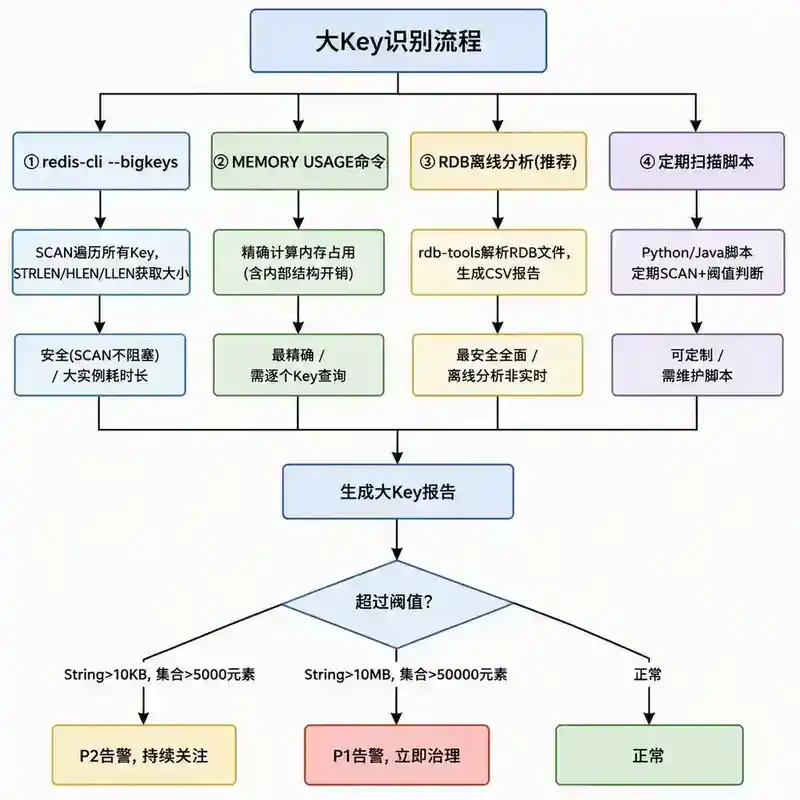
4.2 大 Key 的识别方法
4.2.1 Redis CLI --bigkeys
redis-cli --bigkeys -a your_password

# 输出示例:
# Biggest string found: "user:session:123456" has 5242880 bytes
# Biggest hash found: "product:detail:789" has 25000 fields
# Biggest list found: "msg_queue:order" has 100000 items
--bigkeys 使用 SCAN 命令遍历所有 Key,对每个 Key 使用 TYPE 判断类型,然后用 STRLEN/HLEN/LLEN 等获取大小。因为使用 SCAN,不会阻塞主线程,但全量扫描在大型实例中可能需要较长时间。
4.2.2 memory usage 命令(Redis 4.0+)
# 精确查询单个 Key 的内存占用
MEMORY USAGE mykey
# 返回:1234567(字节)

# 抽样估算
MEMORY USAGE mykey SAMPLES 1000
MEMORY USAGE 可以精确计算 Key 的实际内存占用,包括内部数据结构开销,比 STRLEN 等更准确。
4.2.3 RDB 离线分析
使用 redis-rdb-tools 对 RDB 文件进行离线分析,这是最安全、最全面的方式:
# 安装
pip install rdbtools python-lzf

# 分析 RDB 文件,生成 CSV 报告
rdb -c memory /var/redis/dump.rdb > memory_report.csv

# 按内存占用排序
sort -t',' -k4 -n memory_report.csv | tail -20
4.2.4 实时监控与告警
# 定期扫描大 Key 的脚本
def scan_big_keys(redis_client, threshold=10240):
    cursor = 0

    big_keys = [ ]

    while True:
        cursor, keys = redis_client.scan(cursor, count=1000)
        for key in keys:
            key_type = redis_client.type(key).decode()
            if key_type == 'string':
                size = redis_client.strlen(key)
            elif key_type == 'hash':
                size = redis_client.hlen(key)
            elif key_type == 'list':
                size = redis_client.llen(key)
            elif key_type == 'set':
                size = redis_client.scard(key)
            elif key_type == 'zset':
                size = redis_client.zcard(key)
            if size > threshold:
                big_keys.append((key, key_type, size))
        if cursor == 0:
            break
    return big_keys
4.3 大 Key 解决方案
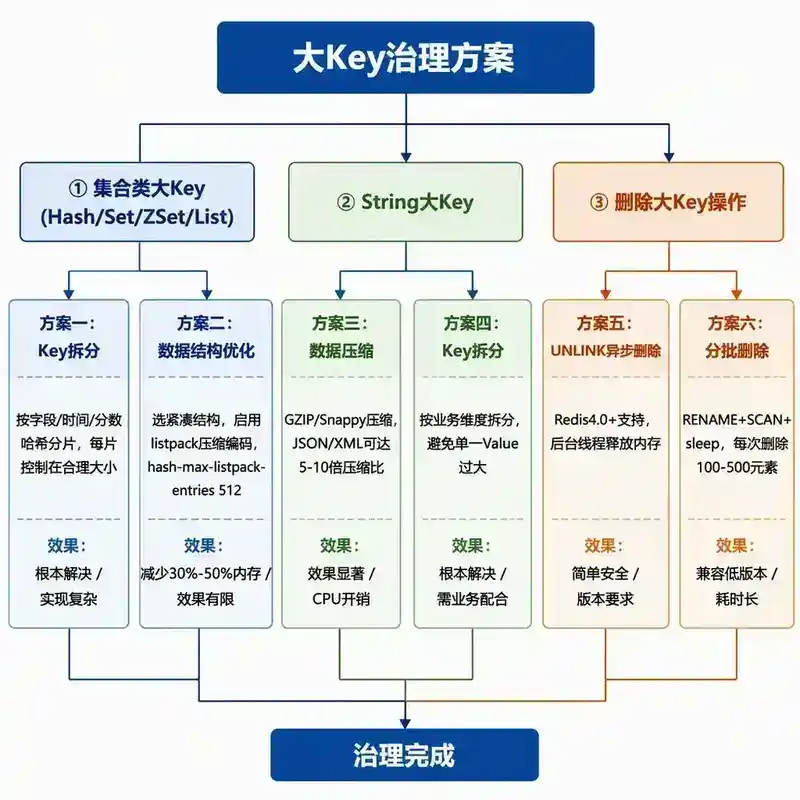
4.3.1 大 Key 拆分(治本之策)
Hash 拆分:将一个大的 Hash 按字段拆分为多个小 Hash。
// 按字段哈希拆分
public class HashSplitter {
    private static final int SHARD_COUNT = 100;

    public void hset(String key, String field, String value) {
        int shard = Math.abs(field.hashCode()) % SHARD_COUNT;
        String shardKey = key + ":" + shard;
        redis.hset(shardKey, field, value);
    }

    public String hget(String key, String field) {
        int shard = Math.abs(field.hashCode()) % SHARD_COUNT;
        String shardKey = key + ":" + shard;
        return redis.hget(shardKey, field);
    }

    // 获取所有字段需要遍历所有分片
    public Map<String, String> hgetAll(String key) {
        Map<String, String> result = new HashMap<>();
        for (int i = 0; i < SHARD_COUNT; i++) {
            result.putAll(redis.hgetAll(key + ":" + i));
        }
        return result;
    }
}
List 拆分:按时间窗口或大小分片,如 msg_queue:2024-01-01、msg_queue:2024-01-02。
ZSet 拆分:按分数段拆分,如 leaderboard:0-1000、leaderboard:1001-2000。
4.3.2 数据结构优化
选择更紧凑的数据结构:
# 存储用户 ID 列表 → 用 Set 还是 List?
# 如果不需要去重和交集操作,用 List 比 Set 内存占用更小
# Redis 的 Set 使用哈希表实现,内存开销较大
使用压缩编码:对于小 Hash,Redis 自动使用 ziplist(Redis 7.0+ 使用 listpack)编码,内存占用极低。合理控制 Hash 的字段数量和字段大小,可以让 Redis 保持在压缩编码下。
# 配置压缩编码的阈值
hash-max-listpack-entries 512
hash-max-listpack-value 64
4.3.3 渐进式删除(安全删除大 Key)
Redis 4.0+ 使用 UNLINK:
# UNLINK 是异步删除,不会阻塞主线程
UNLINK big_set_key
UNLINK 将 Key 从键空间解除绑定,实际的内存释放操作交给后台线程(lazyfree-lazy-user-del 配置项控制)。
低版本 Redis 的分批删除:
// 使用 SCAN + 分批删除(适用于 Hash/Set/ZSet)
public void batchDelete(RedisTemplate redis, String key) {
    // 1. 先重命名,防止新的写入
    String tmpKey = key + ":to_delete:" + System.currentTimeMillis();
    redis.rename(key, tmpKey);

    // 2. 分批删除
    ScanOptions options = ScanOptions.scanOptions().count(100).build();
    Cursor<Map.Entry<Object, Object>> cursor = redis.opsForHash().scan(tmpKey, options);
    while (cursor.hasNext()) {
        Map.Entry<Object, Object> entry = cursor.next();
        redis.opsForHash().delete(tmpKey, entry.getKey());
        // 每次删除后短暂休眠,让出 CPU
        Thread.sleep(10);
    }

    // 3. 最后删除空 Key
    redis.delete(tmpKey);
}
关键原则:
- 先
RENAME再删除,避免删除期间的新写入丢失 - 每次删除一小批(100-500 个元素),然后
sleep几毫秒 - 监控 Redis 的延迟指标,确保删除操作不影响正常请求
4.3.4 数据压缩
对大 String 类型的 Value,在应用层做压缩后再存入 Redis:
public class CompressedRedisTemplate {
    public void set(String key, String value) {

        byte[ ] compressed = gzipCompress(value.getBytes(StandardCharsets.UTF_8));

        redis.opsForValue().set(key, compressed);
    }

    public String get(String key) {

        byte[ ] compressed = redis.opsForValue().get(key);

        return new String(gzipDecompress(compressed), StandardCharsets.UTF_8);
    }
}
适用场景:JSON、XML 等文本数据通常能达到 5-10 倍的压缩比。但压缩/解压会消耗 CPU,需要权衡。
4.3.5 合理设置过期时间
# 避免大量 Key 在同一时间过期,加随机偏移
EXPIRE mykey 3600 + RANDOM(0, 300)
4.3.6 方案对比
| 方案 | 适用场景 | 效果 | 复杂度 |
|---|---|---|---|
| Key 拆分 | 集合类大 Key | 根本解决 | 高 |
| 数据结构优化 | 所有类型 | 减少 30-50% 内存 | 中 |
| UNLINK 异步删除 | 删除操作 | 立即见效 | 低 |
| 数据压缩 | String 大 Value | 减少 5-10 倍 | 中 |
| 过期时间打散 | 批量过期 Key | 预防为主 | 低 |
五、生产实践:一个完整的热 Key 和大 Key 治理体系
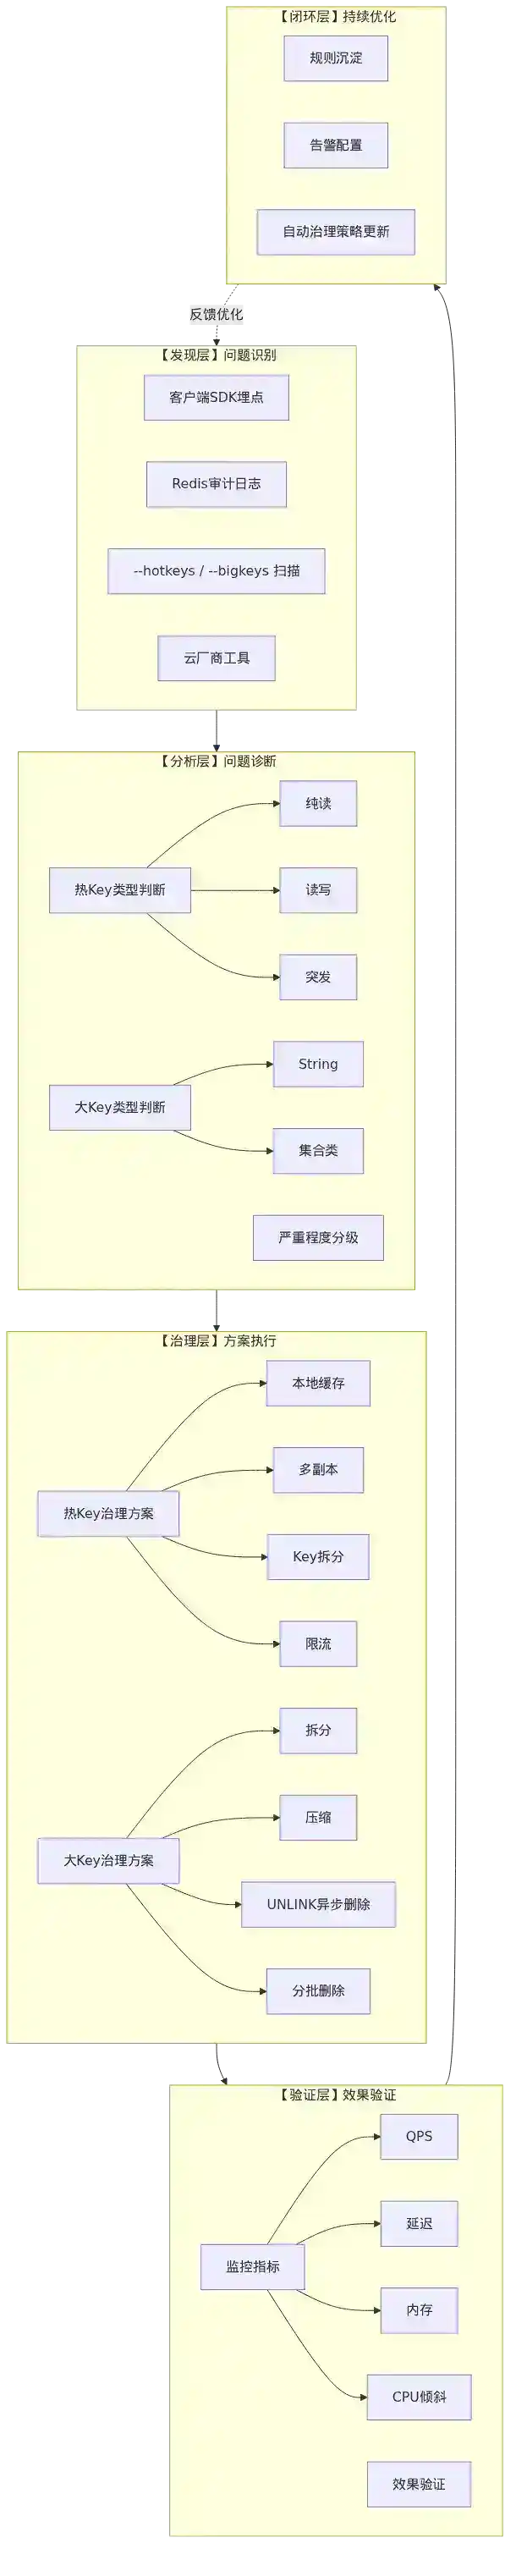
5.1 治理流程
发现 → 分析 → 治理 → 验证 → 闭环
  │      │      │      │      │
  │      │      │      │      └─ 沉淀规则,更新监控
  │      │      │      └─ 验证治理效果,确认无副作用
  │      │      └─ 选择方案,执行治理
  │      └─ 分析根因,判断类型
  └─ 通过监控、扫描发现异常 Key
5.2 自动化治理架构
// 热 Key 自动发现与治理框架
@Component
public class HotKeyGovernor {
    // 1. 发现层:基于客户端 SDK 统计
    private HotKeyDetector detector;

    // 2. 分析层:判断热 Key 类型和严重程度
    private HotKeyAnalyzer analyzer;

    // 3. 治理层:自动执行治理策略
    private HotKeyMitigator mitigator;

    // 4. 验证层:确认治理效果
    private HotKeyValidator validator;

    @Scheduled(fixedDelay = 10000)
    public void govern() {
        // 发现热 Key
        List<HotKeyReport> reports = detector.detect();
        for (HotKeyReport report : reports) {
            // 分析
            HotKeyType type = analyzer.analyze(report);

            // 治理
            switch (type) {
                case READ_ONLY:
                    // 读多写少 → 本地缓存 + 多副本
                    mitigator.applyLocalCache(report.getKey());
                    break;
                case READ_WRITE:
                    // 读写频繁 → Key 拆分
                    mitigator.splitKey(report.getKey());
                    break;
                case BURST:
                    // 突发流量 → 限流
                    mitigator.applyRateLimit(report.getKey());
                    break;
            }

            // 验证
            validator.validate(report.getKey());
        }
    }
}
5.3 监控指标
| 指标 | 阈值建议 | 告警级别 |
|---|---|---|
| 单 Key QPS | > 集群平均 QPS × 10 | P2 |
| 单 Key 大小 | String > 10KB, 集合 > 5000 元素 | P2 |
| 单 Key 大小 | String > 10MB, 集合 > 50000 元素 | P1 |
| 分片 CPU 倾斜 | 最高分片 > 最低分片 × 3 | P1 |
| 删除延迟 | UNLINK/DEL 延迟 > 100ms | P2 |
六、常见陷阱与避坑指南
6.1 热 Key 陷阱
陷阱 1:本地缓存数据不一致导致资损
某电商的优惠券服务对券库存做了本地缓存(3 秒过期),在秒杀场景下,由于本地缓存的数据不一致,导致超卖 200 张券。
避坑:对一致性要求高的数据(库存、余额),不要用本地缓存,应该用 Key 拆分方案。
陷阱 2:多副本同步写导致性能反降
某团队为热 Key 设置了 20 个副本,每次写操作需要同步更新 20 个 Key,反而导致写操作延迟从 1ms 飙升到 20ms。
避坑:副本数不宜过多(3-5 个即可),写操作可以用 Pipeline 或 Lua 脚本批量更新。
陷阱 3:限流过于激进导致功能不可用
某团队对热 Key 设置了 1000 QPS 的硬限流,结果在秒杀开始时,99% 的用户请求被拒绝,用户体验极差。
避坑:限流应该是弹性限流,配合排队、降级等机制,而不是简单粗暴的拒绝。
6.2 大 Key 陷阱
陷阱 1:KEYS 命令扫描大 Key 导致阻塞
# 绝对不要在生产环境执行!
KEYS *  # 这个命令会阻塞 Redis 主线程
避坑:使用 SCAN 代替 KEYS,或使用 --bigkeys 参数。
陷阱 2:DEL 大 Key 导致主从切换
某团队在清理过期数据时,直接 DEL 了一个 500 万元素的 Set,导致 Redis 主线程阻塞 2 秒,Sentinel 判定主节点下线,触发故障转移。
避坑:Redis 4.0+ 使用 UNLINK;低版本使用分批删除 + 重命名。
陷阱 3:大 Key 拆分后查询复杂度增加
将一个大 Hash 拆分为 100 个小 Hash 后,HGETALL 操作需要遍历 100 个 Key,网络往返次数增加 100 倍。
避坑:拆分前评估查询模式,如果确实需要全量获取,考虑用 Pipeline 批量查询,或调整拆分粒度。
七、源码视角:Redis 如何处理大 Key 删除
本节从 Redis 源码层面分析大 Key 删除的阻塞原因和优化机制,适合希望深入理解原理的读者。
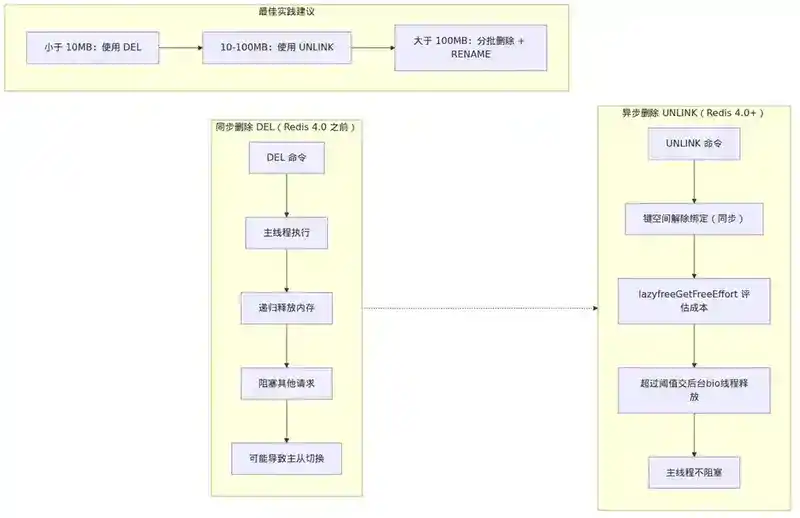
7.1 Redis 4.0 之前的同步删除
// Redis 4.0 之前,delCommand 直接调用 dbAsyncDelete 或 dbSyncDelete
// 默认是同步删除
void delCommand(client *c) {
    int deleted = 0, j;
    for (j = 1; j < c->argc; j++) {
        // 同步删除,直接释放内存
        if (dbSyncDelete(c->db, c->argv[j])) {
            // ...
            deleted++;
        }
    }
    addReplyLongLong(c, deleted);
}
dbSyncDelete 会递归释放 Key 对应的所有数据结构,如果 Key 很大的话,这个释放过程会占用主线程几百毫秒甚至几秒。
7.2 Redis 4.0+ 的 Lazy Free 机制
// Redis 4.0+ 引入 lazyfree 机制
// dbAsyncDelete 将内存释放操作交给后台线程
int dbAsyncDelete(redisDb *db, robj *key) {
    // 从键空间删除
    if (dictSize(db->expires) > 0) dictDelete(db->expires, key->ptr);
    dictEntry *de = dictUnlink(db->dict, key->ptr);
    if (de) {
        robj *val = dictGetVal(de);
        // 计算释放成本
        size_t free_effort = lazyfreeGetFreeEffort(key, val);
        // 如果释放成本 > 64 且共享计数为 1,则异步释放
        if (free_effort > LAZYFREE_THRESHOLD && val->refcount == 1) {
            // 放入后台线程队列
            atomicIncr(lazyfree_objects, 1);
            bioCreateLazyFreeJob(lazyfreeFreeObject, 1, val);
            dictSetVal(db->dict, de, NULL);
        }
    }
    // ...
}
核心逻辑:lazyfreeGetFreeEffort 估算释放成本,如果超过阈值(默认 64),且对象没有被共享(refcount == 1),则交给后台 bio 线程异步释放。
7.3 UNLINK vs DEL 的取舍
UNLINK 并不是无代价的:它只是把内存释放异步化,但 Key 从键空间删除仍然是同步的。对于超大 Key,即使只是从键空间删除(字典操作),也可能需要几毫秒。
# 最佳实践:评估后再决定
# 1. 先用 MEMORY USAGE 查看大小
MEMORY USAGE mykey
# 2. 如果 > 10MB,使用 UNLINK
UNLINK mykey
# 3. 如果 > 100MB,使用分批删除 + RENAME
八、总结
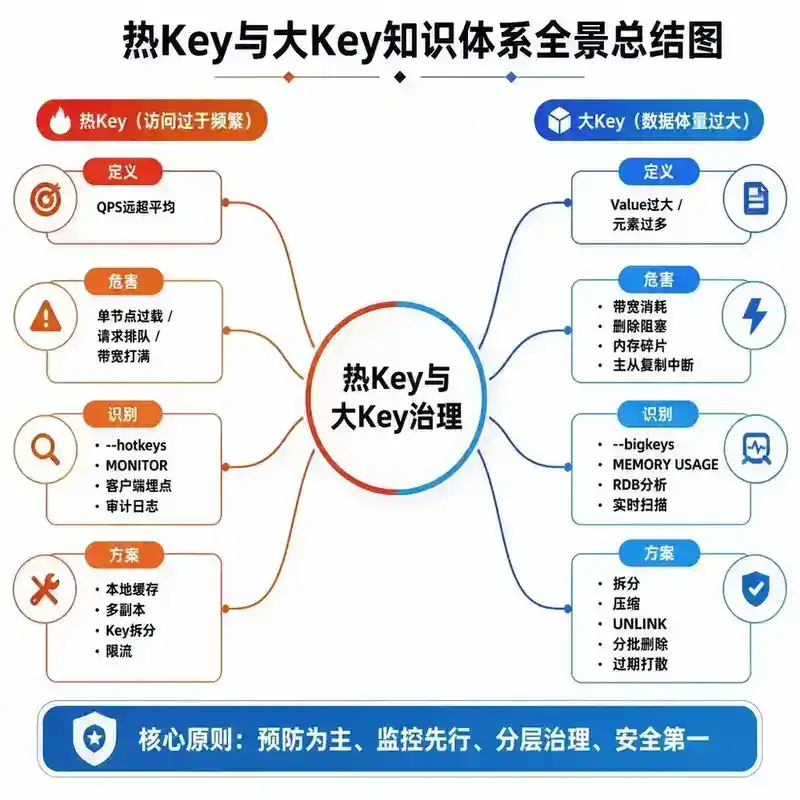
热 Key 和大 Key 是 Redis 运维中的两大核心挑战。热 Key 的根因是请求倾斜,解决思路是分散访问(本地缓存、多副本、拆分、限流);大 Key 的根因是数据聚集,解决思路是分散存储和安全删除(拆分、压缩、UNLINK、分批删除)。
核心原则:
- 预防为主:在代码设计阶段就考虑 Key 的大小和访问模式
- 监控先行:建立完善的热 Key/大 Key 监控体系,及时发现
- 分层治理:根据严重程度和业务特性,选择合适的治理方案
- 安全第一:删除大 Key 必须使用 UNLINK 或分批删除,绝不能直接 DEL
面试官视角:热 Key 与大 Key 深度追问
以下问题不是对文章内容的简单复述,而是从面试官视角考察候选人的深度理解和实战经验。
Q1:你在项目中遇到过最严重的热 Key 问题是什么?当时是如何发现和解决的?如果让你重新设计,你会做哪些改进?
这道题考察的是实战经验和反思能力。面试官想听到的不是"我用了多副本解决了",而是:
- 当时的业务场景和流量规模
- 发现问题的方式(监控、告警、用户投诉?)
- 临时止血方案和长期治理方案的区别
- 事后复盘:如果提前做哪些设计,可以避免这个问题?
Q2:热 Key 的多副本方案中,如何保证副本之间的数据一致性?如果写操作很频繁,多副本方案的"写放大"问题如何解决?
这道题考察的是方案权衡能力。副本方案天然存在一致性问题,候选人需要回答:
- 先更新 Redis 还是先更新副本?更新失败的补偿机制?
- 如果写操作 QPS 也很高,多副本会导致写放大 N 倍,这时应该考虑 Key 拆分而不是多副本
- 对一致性要求高的场景,副本方案是否还适用?边界在哪里?
Q3:一个 100MB 的 String 大 Key,有 100 个客户端同时 GET,会对 Redis 和网络产生什么影响?如何优化?
这道题考察的是对 Redis 单线程模型和网络模型的理解。关键点:
- Redis 单线程执行命令,100 个 GET 会排队执行,每个需要传输 100MB 数据
- 网卡带宽会被占满,其他请求的响应时间剧增
- 优化方向:压缩、拆分、CDN 边缘缓存
- 考察候选人对大 Key 的"读放大"问题的理解(很多人只关注写和删除,忽略了读)
Q4:Redis 6.0 引入了 I/O 多线程,这对热 Key 问题有什么影响?能解决热 Key 问题吗?
这道题考察的是对 Redis 新特性的理解深度。关键点:
- I/O 多线程只负责网络读写,不负责命令执行,命令执行仍然是单线程的
- 热 Key 的瓶颈通常不在网络 I/O,而在命令执行(CPU)和单节点集中
- 因此 I/O 多线程对热 Key 问题帮助有限,真正需要的是分散请求到不同节点
- 能答出这一点的候选人,说明真正理解了 Redis 的架构
Q5:你设计一个"热 Key 自动发现和治理系统",要考虑哪些核心模块?如何保证治理操作本身不会引入新的问题?
这道题考察的是系统设计能力。优秀回答应该包含:
- 发现模块:客户端 SDK 埋点 + Redis 服务端统计
- 分析模块:区分热 Key 类型(纯读 / 读写 / 突发),判断严重程度
- 决策模块:根据类型和严重程度自动选择治理策略
- 执行模块:灰度执行,先验证后全量
- 回滚模块:治理操作可逆,出问题能快速回滚
- 验证模块:监控治理后的效果,异常自动告警
- 安全机制:治理操作要有限流和熔断,防止治理本身造成故障
本文是"Java 技术专家与架构师面试:250 个高频考点"系列的第 141 篇。下一篇将深入探讨 Redis 过期与淘汰策略。