阅读时间:40-50 分钟 | 难度:中高级 | 前置知识:Redis 基本使用、C 语言基础
一、引言:为什么 Redis 这么快?
提到 Redis,大家的第一反应是"快"——单机 10 万 QPS 是家常便饭。大多数人的解释是"基于内存"和"单线程模型"。这当然没错,但只解释了一半。MySQL 的 Buffer Pool 也在内存里,为什么达不到 Redis 的吞吐?关键在于 Redis 对内存中数据结构的精心设计。
Redis 对外暴露的是 String、Hash、List、Set、ZSet 这些高级数据结构,但内部为每种结构准备了多套底层编码(encoding),根据数据的大小和形态自动切换。这节课我们深入剖析五种核心底层编码:SDS、dict、listpack、intset、skiplist。
学完这节课,你会发现——Redis 的"快"不是玄学,而是从字节对齐到内存布局,每一层都算到了极致。
二、SDS:Redis 的字符串基石
2.1 为什么不用 C 原生字符串?
C 语言的 char* 以 \0 结尾,获取长度需要 strlen() 遍历整个字符串——O(n) 操作。更致命的是,它不记录已分配空间,追加操作极易缓冲区溢出。Redis 作为被频繁读写的中间件,显然不能接受这些缺陷。
Redis 自己实现了 SDS(Simple Dynamic String),本质上是一个带长度和容量信息的字符数组包装器。
2.2 SDS 的内存布局
Redis 3.2 之前,SDS 结构固定:
struct sdshdr {
    int len;    // 已使用长度
    int free;   // 剩余空间

    char buf[ ]; // 柔性数组

};
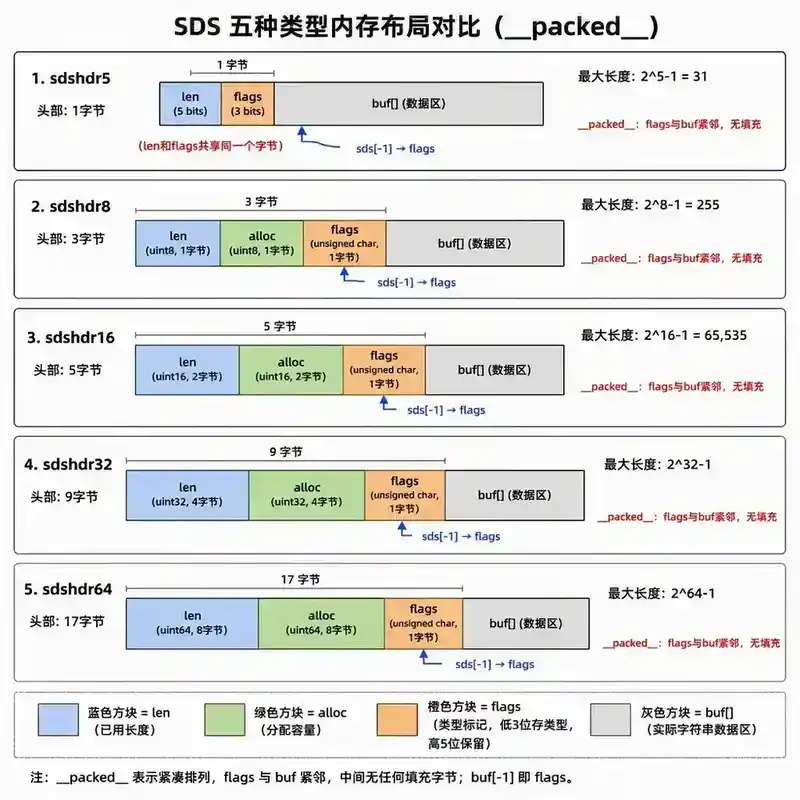
但 int 在短字符串上浪费严重。Redis 3.2 后引入了按长度分级的 SDS 类型,共 5 种:
| 类型 | 最大长度 | 头部占用 | 适用场景 |
|---|---|---|---|
| sdshdr5 | 32 字节 | 1 字节 | 极短字符串(已废弃不用) |
| sdshdr8 | 255 字节 | 3 字节 | 短 Key、简单 Value |
| sdshdr16 | 65,535 字节 | 5 字节 | 中等 Value |
| sdshdr32 | 4 GB | 9 字节 | 大 Value |
| sdshdr64 | 远超实际需求 | 17 字节 | 超大对象 |
以 sdshdr8 为例,其结构体定义:
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len;         // 已用长度
    uint8_t alloc;       // 分配总容量(不含结尾\0)
    unsigned char flags; // 低3位标记类型

    char buf[ ];          // 实际数据

};
__packed__ 关键字迫使编译器取消对齐填充,确保 flags 紧挨着 buf。这样,通过 buf[-1] 就能直接读到 flags,进而反推出 SDS 类型——这比维持一个额外的指针高效得多。
2.3 空间预分配与惰性释放
扩容策略:当 SDS 需要扩容时,如果新长度小于 1MB,分配 2 倍空间;如果超过 1MB,每次多分配 1MB。这种"预分配"避免了频繁 realloc,是 Redis 高频写入性能的关键。
缩容策略:SDS 缩短时不立即释放内存,只更新 len 字段,alloc 保持不变。新数据可以复用这些空间,无需重新分配。这在键值频繁更新的场景下效果显著。
2.4 二进制安全
C 字符串以 \0 为终止符,无法存储图片、序列化对象等二进制数据。SDS 用 len 字段准确标记数据边界,不依赖终止符——这就是"二进制安全"的真实含义。
2.5 兼容 C 字符串函数
SDS 的 buf 末尾始终保留一个 \0(不计入 len),因此可以直接传给 printf、strcmp 等 C 标准函数。这种"向后兼容"的设计让 Redis 在 C 生态中如鱼得水。
三、dict:Redis 的哈希表引擎
3.1 Redis 字典的宏观结构
Redis 的字典(dict)是 Hash 类型、全局键空间、过期键字典等核心结构的底层实现。它的设计借鉴了 Python 的 dict,但为 Redis 的特定场景做了大量优化。
核心由一个 dict 结构体管理两个 dictht(哈希表),外加一个 dictType 函数表实现多态:
struct dict {
    dictType *type;     // 类型特定函数(hash、keyCompare、keyDup等)
    dictEntry **ht_table[2]; // 两个哈希表桶数组
    unsigned long ht_used[2]; // 两个哈希表的使用中条目数
    long rehashidx;     // -1 表示不在rehash,>=0 表示rehash进度
    int16_t pauserehash; // rehash暂停计数
    signed char ht_size_exp[2]; // 指数大小:size = 1 << exp
};
pauserehash 是 Redis 7.0 引入的精妙设计:它是计数器而非布尔值,允许多个安全迭代器同时存在,互不干扰。
3.2 渐进式 Rehash
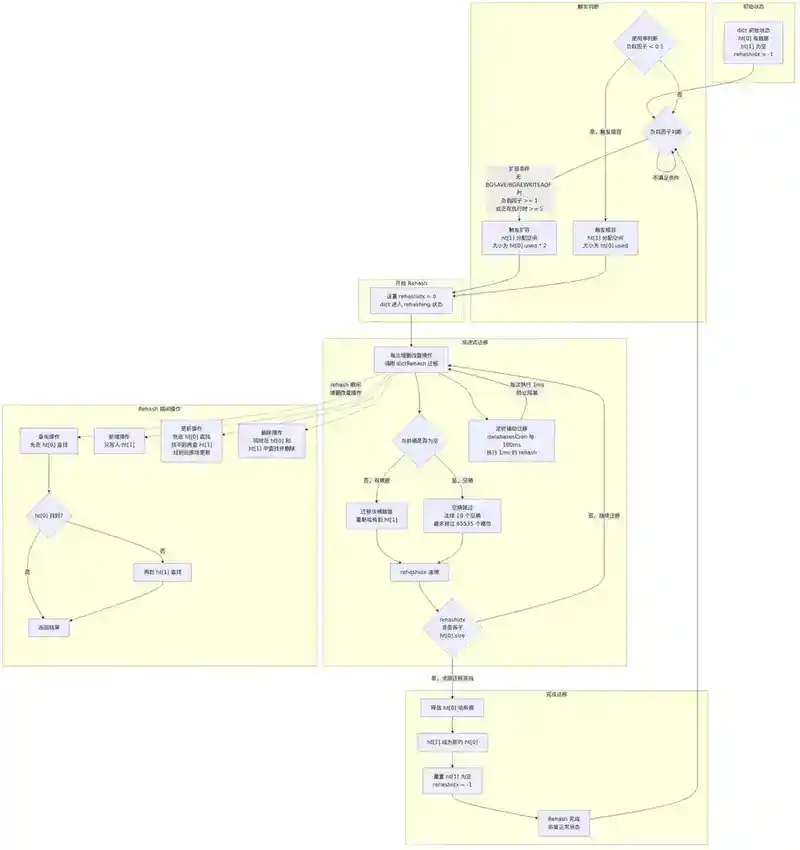
Redis 是单线程处理命令的,如果一次性迁移百万级键,会阻塞整个服务。因此 Redis 采用渐进式 rehash:
- 为
ht[1]分配空间(通常是ht[0]的 2 倍) - 将
rehashidx设为 0 - 每次对该字典的增删改查操作,顺势将
ht[0]中rehashidx位置的桶迁移到ht[1] rehashidx递增,直至所有桶迁移完毕,释放ht[0],ht[1]变成新的ht[0]
空桶迁移优化:Redis 7.4 在扫描桶时,连续遇到 10 个空桶就跳过一批(最多 65535 个槽位),大幅减少了稀疏哈希表的 rehash 开销。
定时辅助迁移:即使没有外部请求,Redis 的 databasesCron 也会每 100ms 执行 1ms 的 rehash,防止长时间无请求但 rehash 未完成的状态。
3.3 缩容策略
当 ht[0] 的使用率低于 HASHTABLE_MIN_FILL(10%)时触发缩容,新大小为 used * 2 向上取 2 的幂——保证利用率在 50% 左右。在 serverCron 中检查,避免内存浪费。
3.4 SipHash 哈希函数
Redis 使用 SipHash 1-2 作为哈希函数,而不是传统的 MurmurHash。SipHash 在保持高性能的同时具备抗哈希碰撞攻击能力——攻击者无法轻易构造大量碰撞键来拖垮服务器。这在多租户场景下尤为重要。
3.5 链式哈希与查找
Redis 的 dictEntry 使用单向链表解决哈希冲突。查找时,先通过 dictHashKey(d, key) 计算哈希值,然后定位桶,遍历链表逐一比对。Key 比对由 dictType 的 keyCompare 回调完成,比较时优先使用 CFR(Compare Fast Return,即指针相等快速返回)优化。
四、listpack:Redis 7.0 的紧凑列表
4.1 从 ziplist 到 listpack
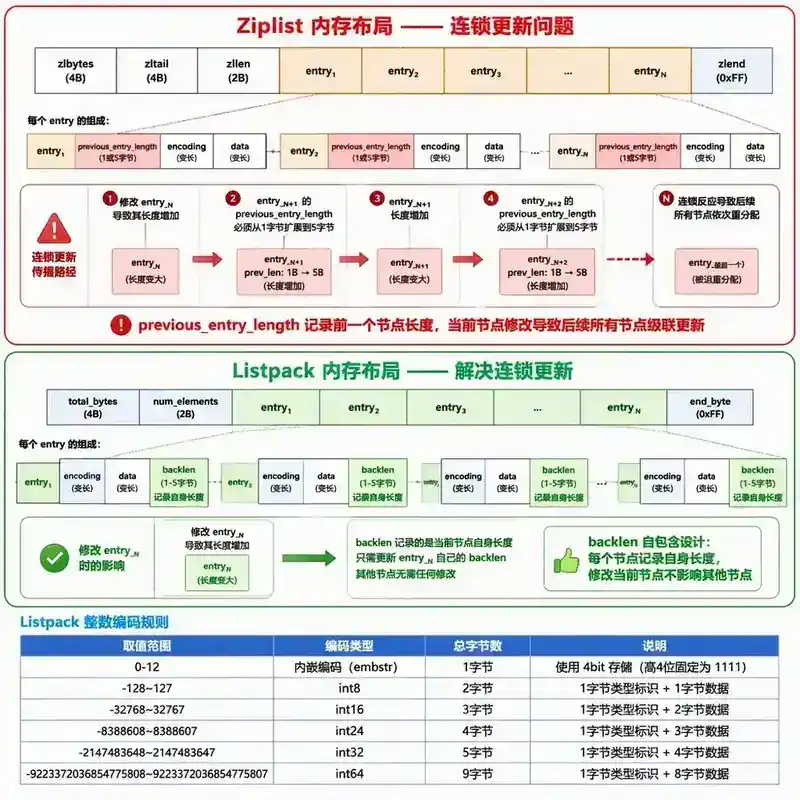
在 Redis 7.0 之前,Hash 和 ZSet 在小数据量下使用 ziplist(压缩列表)。ziplist 是一块连续内存,通过记录每个节点的 previous_entry_length 实现双向遍历。但问题在于,previous_entry_length 字段可能因中间节点更新而扩展(从 1 字节变成 5 字节),引发连锁更新(cascade update)——更新一个节点可能导致后续所有节点都需要重新分配内存,最坏 O(N²) 复杂度。
Redis 7.0 用 listpack 彻底替代了 ziplist。listpack 的核心设计是:放弃记录前驱节点长度,改为记录当前节点长度,从根本上消除连锁更新。
4.2 listpack 内存布局
<total_bytes><num_elements><entry_1><entry_2>...<entry_N><end_byte>
每个 entry 的结构:
<encoding><data><backlen>
encoding:1 字节,标记数据类型和后续字节数data:实际数据backlen:1-5 字节,记录当前节点的总长度(encoding + data + backlen 自身)
反向遍历时,从当前位置向前读取 backlen,即可知道前一个节点的起始位置。由于 backlen 是当前节点自己的属性,修改当前节点不会影响任何其他节点。
4.3 整数和字符串的紧凑编码
listpack 对整数做了极致优化:
| 值范围 | 编码方式 | 占用字节 |
|---|---|---|
| 0-12 | 直接编码在 encoding 字节中 | 1 字节 |
| -128 ~ 127 | int8 | 1+1=2 字节 |
| -32768 ~ 32767 | int16 | 1+2=3 字节 |
| -2^23 ~ 2^23-1 | int24 | 1+3=4 字节 |
| -2^31 ~ 2^31-1 | int32 | 1+4=5 字节 |
| -2^63 ~ 2^63-1 | int64 | 1+8=9 字节 |
对于字符串,listpack 也做了长度分级的编码,短字符串更省空间。
4.4 listpack 的适用场景
listpack 替代 ziplist 后,应用在以下场景:
- Hash:小哈希(field-value 对少,每个值短)→
listpack编码 - ZSet:小有序集合(成员少,分值小)→
listpack编码 - Stream:每个消费组的待确认消息列表
当数据量超过阈值(hash-max-listpack-entries 等配置),自动转为 hashtable 或 skiplist 编码。
五、intset:整数集合的精巧设计
5.1 为什么需要 intset?
Set 类型在元素全为整数且数量较少时,使用 intset 编码。intset 的核心思想是:用升级而非降级的方式管理多精度整数,用二分查找保证查询效率。
5.2 intset 结构
typedef struct intset {
    uint32_t encoding;  // INTSET_ENC_INT16/INT32/INT64
    uint32_t length;    // 元素个数

    int8_t contents[ ];  // 实际存储数组(类型由encoding决定)

} intset;
contents 虽然声明为 int8_t[ ],但实际存储类型由 encoding 决定。元素按升序排列,无重复。
5.3 升级(Upgrade)机制
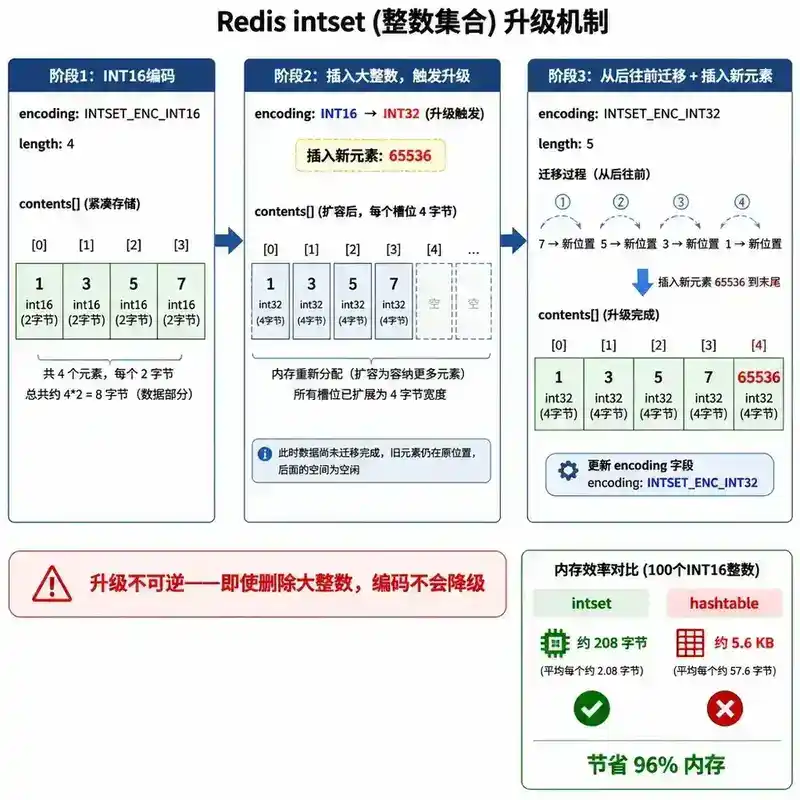
当插入一个超出当前编码范围的整数时,intset 会触发升级:
- 计算新编码(如 INT16→INT32→INT64)
- 重新分配内存
- 从后往前迁移元素(避免覆盖未读数据)
- 插入新元素
- 更新
encoding
升级是不可逆的——即使后来删除了那个大整数,编码也不会降级。原因是:降级需要扫描所有元素确认是否真的可以降级,成本高;且实际场景中升级后通常有更多大整数加入。
5.4 查找和插入
由于元素有序排列,intset 使用二分查找定位元素,O(logN)。但插入时需要移动后续元素,最坏 O(N)。这也是为什么 intset 只用于元素数量较少的 Set——当元素超过 set-max-intset-entries(默认 512),自动转为 hashtable 编码。
5.5 内存效率分析
假设存储 100 个 0-100 的整数:
- intset(INT16):8 字节头 + 100×2 字节 = 208 字节
- hashtable:每个 dictEntry 至少 24 字节(3 个指针),加上 key 和 value 对象各 16 字节,总计 100×(24+16+16) ≈ 5.6KB
intset 节省了 96% 的内存。这正是 Redis 为小数据量设计专用编码的原因。
六、skiplist:平衡概率与性能
6.1 跳表的设计哲学
ZSet 数据量大时,底层使用 skiplist(跳表) + dict 的组合。为什么是跳表而不是红黑树或 AVL?
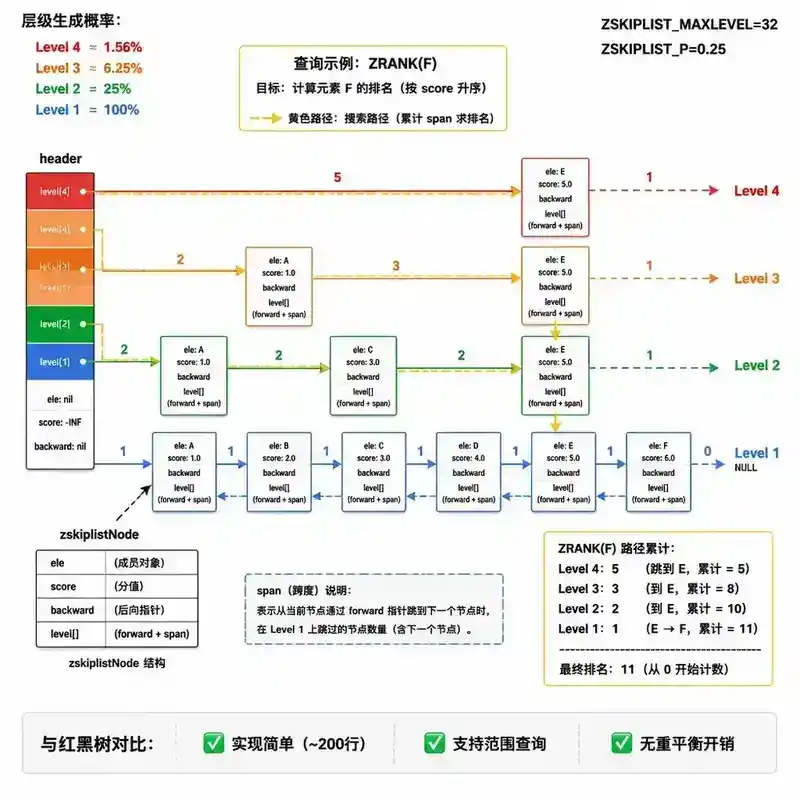
跳表是一种概率平衡的随机化数据结构。它通过给每个节点随机分配层数,实现期望 O(logN) 的查询、插入和删除。与红黑树相比:
- 实现简单(约 200 行 vs 红黑树 500+ 行)
- 支持范围查询(ZRANGE、ZRANK 等操作天然高效)
- 无锁重平衡开销
6.2 Redis 跳表结构
typedef struct zskiplistNode {
    sds ele;                           // 元素值
    double score;                      // 分值
    struct zskiplistNode *backward;    // 后退指针
    struct zskiplistLevel {
        struct zskiplistNode *forward; // 前进指针
        unsigned long span;            // 跨度(本层到下一个节点跨越的节点数)

    } level[ ];                         // 柔性数组

} zskiplistNode;

typedef struct zskiplist {
    struct zskiplistNode *header, *tail;
    unsigned long length;   // 节点总数
    int level;              // 当前最大层数
} zskiplist;
**span**字段是 Redis 跳表的独特设计。它记录了本层从当前节点到下一个节点的距离(跨越了多少个节点),这使得 ZRANK(获取排名)操作可以在 O(logN) 时间内完成——遍历路径上累加 span 即可得到排名,无需遍历整个链表。
6.3 层数随机生成
Redis 的层数生成算法:
int zslRandomLevel(void) {
    int level = 1;
    while ((random() & 0xFFFF) < (ZSKIPLIST_P * 0xFFFF))
        level += 1;
    return (level < ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL;
}
其中 ZSKIPLIST_P = 0.25,ZSKIPLIST_MAXLEVEL = 32。每层晋升概率为 25%,这意味着:
- 第 1 层:100% 的节点
- 第 2 层:约 25% 的节点
- 第 3 层:约 6.25% 的节点
- ...
- 第 32 层:约 0.25^31 ≈ 1/2^62 的节点
在 2^64 个节点中,期望层数超过 32 的概率极低。这种设计保证了跳表在任意规模下都有 O(logN) 的期望性能。
6.4 插入和删除
插入:
- 用
update[ ]数组记录每层需要更新的前驱节点 - 用
rank[ ]数组记录每层前驱节点的排名 - 随机生成新节点的层数
- 对每层执行链表插入,同时更新
span
删除:类似插入,先找到每层的前驱,然后调整指针和 span 即可。
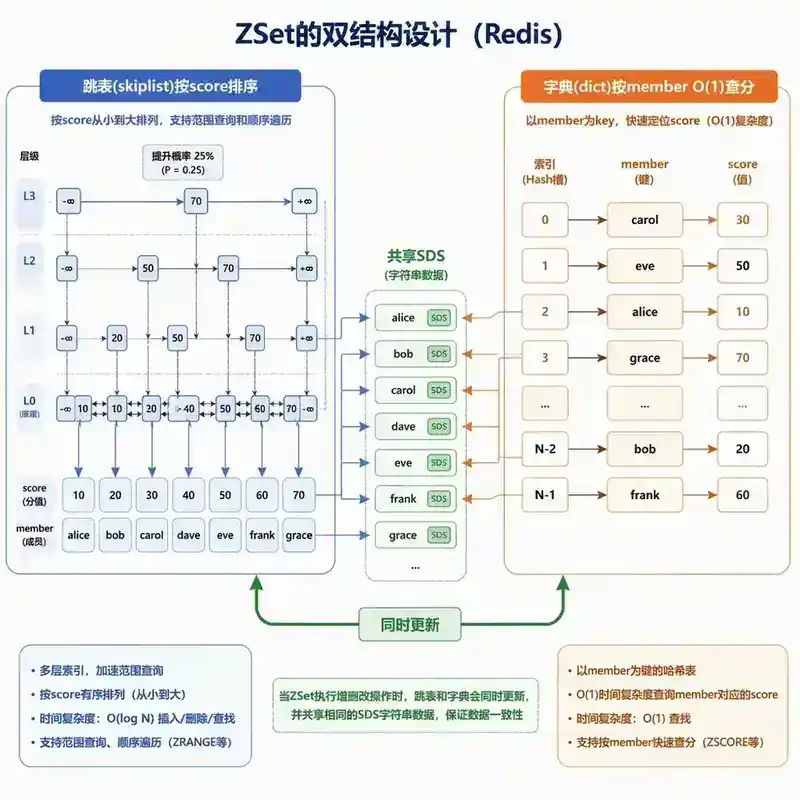
6.5 ZSet 为什么同时用 skiplist 和 dict?
ZSet 同时维护 skiplist 和 dict,各自负责不同操作:
- skiplist:范围查询(ZRANGE)、排名查询(ZRANK)、按分值排序
- dict:O(1) 按成员查找分值(ZSCORE)
两个结构指向同一份元素(SDS 字符串),不增加额外内存。这种"空间换时间"的设计,让 ZSet 在各种操作上都高效。
七、总结:五种编码的协同
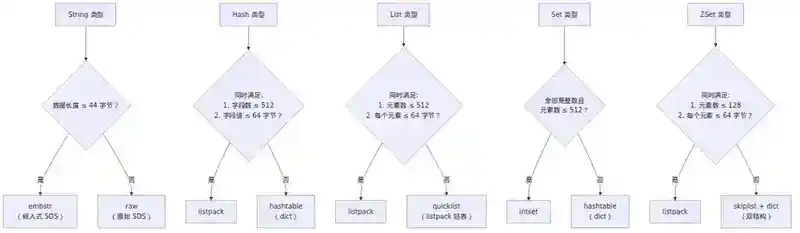
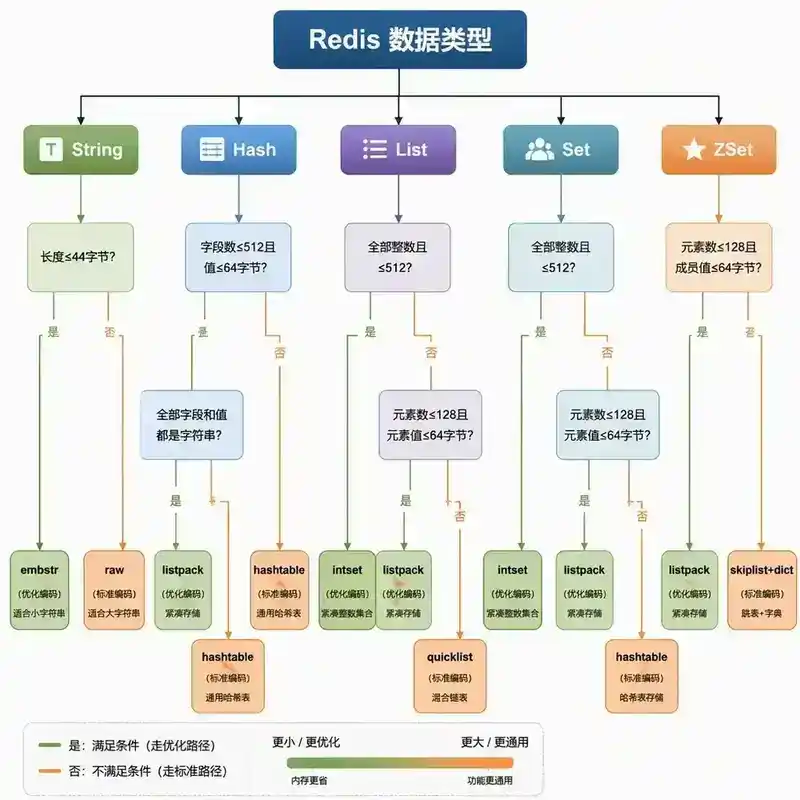
Redis 对外暴露的是 5 种高级数据结构,但内部用复杂的编码策略实现"自适应优化":
| 高级类型 | 小数据编码 | 大数据编码 | 切换阈值 |
|---|---|---|---|
| String | embstr/int | raw | 44 字节 |
| Hash | listpack | hashtable | hash-max-listpack-entries |
| List | quicklist | quicklist | 始终用 quicklist |
| Set | intset | hashtable | set-max-intset-entries |
| ZSet | listpack | skiplist+dict | zset-max-listpack-entries |
这套编码体系的核心思想是:小数据用紧凑连续内存(省空间、省缓存),大数据用复杂结构(保性能)。Redis 的快,正是来源于这种对内存和 CPU 的精确权衡。
八、面试官视角提问
以下问题从面试官角度设计,考察你对底层编码的深层理解,而非简单复述概念。
Q1:Redis 的 SDS 和 Go 的 string 在设计上有什么相似和不同?如果让你用 Go 实现一个类似 SDS 的结构,你会怎么做?
Q2:SDS 的**__packed__**属性是做什么的?如果去掉它,内存布局会有什么变化?这会影响**buf[-1]**读 flags 的正确性吗?
Q3:渐进式 rehash 期间,如果一个 key 在**ht[0]**和**ht[1]**中都可能存在,Redis 增删改查操作分别如何处理?迁移过程中如果突然断电,重启后如何恢复?
Q4:listpack 放弃了 ziplist 的"前驱节点长度"记录,转而记录"当前节点长度"。这个设计为什么能消除连锁更新?请详细推导一个连锁更新的场景,然后说明 listpack 为什么不会发生。
Q5:intset 的升级不可逆,有什么潜在问题?假设一个 Set 先存了很多 INT64 的大整数,后来全部删掉换成 INT16 的小整数,内存占用会怎样?
Q6:skiplist 的**span**字段在 ZRANK 操作中如何发挥作用?请用伪代码描述 ZRANK 基于 span 的计算过程,并分析时间复杂度。
Q7:ZSet 在"数据量小"时用 listpack,"数据量大"时用 skiplist+dict。从"内存占用"和"操作复杂度"两个维度,解释为什么不是始终用 skiplist+dict?
Q8:如果让你设计一个支持"按权重随机采样"的数据结构(类似 Redis 的 ZSet 但要支持 O(logN) 的加权随机),你会怎么设计?