阅读时间:约 45 分钟 | 难度:中高级 | 前置知识:Redis 基础数据结构、内存管理基本概念
一、问题定义:Redis 内存从哪来,到哪去
Redis 是一个内存数据库,所有数据都驻留在内存中。这带来了极致的读写性能,但也意味着内存是 Redis 最稀缺的资源。当你在 Redis 中写入一条数据:
SET user:1001:profile '{"name":"张三","level":"VIP"}' EX 3600
这条数据会在内存中占用一定空间。一小时后,它应当被删除。但如果客户端在过期前从未访问它,Redis 怎么知道它该被清理?更关键的是,如果 Redis 内存写满了怎么办? 新写入是直接失败,还是淘汰一些旧数据腾出空间?
这就是 Redis 必须解决的两大核心问题:
| 问题 | 触发条件 | 核心机制 | 配置入口 |
|---|---|---|---|
| 过期删除(Expiration) | 键设置了 TTL 且到期 | 惰性删除 + 定期删除 | EXPIRE/EXPIREAT/SETEX |
| 内存淘汰(Eviction) | 内存使用达到 maxmemory |
8 种淘汰策略(LRU/LFU/TTL/Random) | maxmemory + maxmemory-policy |
两者的关系:过期删除是"被动+主动"清理到期键;内存淘汰是"兜底"——当过期的键来不及删、内存又满了时,强制淘汰键来释放空间。两者独立工作但协同配合。
二、过期删除机制:惰性 + 定期双管齐下
2.1 过期键如何存储
Redis 中每个设置了过期时间的键,除了在 expires 字典中存储过期时间戳(毫秒级 Unix 时间戳),主字典 db->dict 中也存有一份键值对。结构如下:
db->dict      → { key → value }          // 所有键
db->expires   → { key → expire_timestamp } // 仅有过期时间的键
当执行 EXPIRE key 60 时,Redis 会在 db->expires 中写入 key → now_ms + 60000。如果键原本没有过期时间,它就是只存在于 db->dict 的持久键。
判断一个键是否过期的核心逻辑在 keyIsExpired() 函数中:
// src/db.c (简化)
int keyIsExpired(redisDb *db, robj *key) {
    mstime_t when = getExpire(db, key);
    if (when < 0) return 0;         // 没有过期时间,永不过期
    if (server.loading) return 0;    // 加载 RDB 期间不过期
    return mstime_t(server.mstime) > when;
}
2.2 惰性删除(Lazy Deletion):访问时才检查
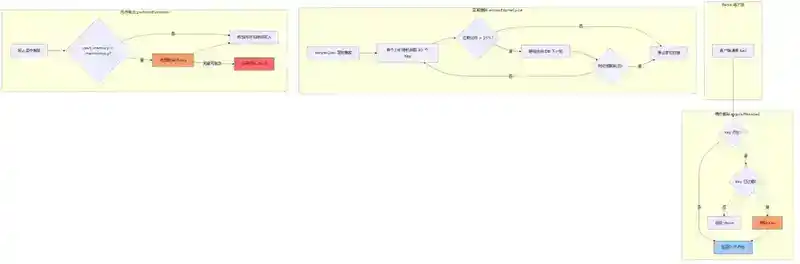
策略:每次访问一个键时,先检查它是否过期,如果过期就删除,然后返回空。
源码实现(expireIfNeeded()):
// src/db.c
int expireIfNeeded(redisDb *db, robj *key) {
    if (!keyIsExpired(db, key)) return 0;

    // 如果是从节点,不主动删除,等主节点同步 DEL 命令
    if (server.masterhost != NULL) return 1;

    // 删除过期键
    server.stat_expiredkeys++;
    propagateExpire(db, key, server.lazyfree_lazy_expire);
    // 通知 AOF / 从节点
    notifyKeyspaceEvent(NOTIFY_EXPIRED, "expired", key, db->id);

    // 根据 lazyfree 配置决定同步删除还是异步删除
    int retval = server.lazyfree_lazy_expire
        ? dbAsyncDelete(db, key)
        : dbSyncDelete(db, key);

    return retval;
}
惰性删除的优点:CPU 友好——只在访问时才做检查,不浪费 CPU 周期去扫描所有键。
惰性删除的致命缺陷:如果一个键过期后再也没有被访问,它就会永远占用内存。这就是"内存泄漏"式的过期键堆积。
2.3 定期删除(Active/Periodic Deletion):后台随机抽检
策略:Redis 内部定时任务 activeExpireCycle() 会周期性运行,从每个数据库中随机抽取一批键,检查并删除其中已过期的键。
核心流程:
- 每次运行有时间限制(默认不超过 25% 的 CPU 时间,即 1ms 中最多 250μs)
- 从每个数据库的
expires字典中随机抽取一批键(默认 20 个) - 删除其中过期的键
- 如果过期比例超过 25%,继续当前数据库的下一轮抽检
- 超时或者遍历完所有数据库后停止
关键源码逻辑(activeExpireCycle() 简化):
// src/expire.c
void activeExpireCycle(int type) {
    // 每个数据库抽检数量 = ACTIVE_EXPIRE_CYCLE_LOOKUPS_PER_LOOP (默认 20)
    // 时间限制 = 1000000 * ACTIVE_EXPIRE_CYCLE_SLOW_TIME_PERC / 100 (默认 250μs)

    do {
        num = ACTIVE_EXPIRE_CYCLE_LOOKUPS_PER_LOOP;
        while (num--) {
            // 随机取一个带过期时间的键
            de = dictGetRandomKey(db->expires);
            // 如果过期,删除
            if (activeExpireCycleTryExpire(db, de, now)) expired++;
        }
        // 如果过期比例 < 25%,停止当前数据库的扫描
        if (expired <= ACTIVE_EXPIRE_CYCLE_LOOKUPS_PER_LOOP / 4) break;
    } while (timelimit_exceeded == 0);
}
两种模式:
- SLOW 模式(
ACTIVE_EXPIRE_CYCLE_SLOW):在serverCron中调用,每次 250μs 时间预算 - FAST 模式(
ACTIVE_EXPIRE_CYCLE_FAST):在beforeSleep事件循环中调用,更短的时间预算(1ms),用于快速回收
定期删除的权衡:通过"随机采样 + 比例阈值"来控制 CPU 开销。如果过期键比例不高(< 25%),就不再继续扫描,避免浪费 CPU。这种设计在"均匀过期"场景下工作良好,但遇到"集中过期"时可能力不从心。
2.4 双策略协同示意图
2.5 集中过期问题:为什么 25% 阈值是一把双刃剑
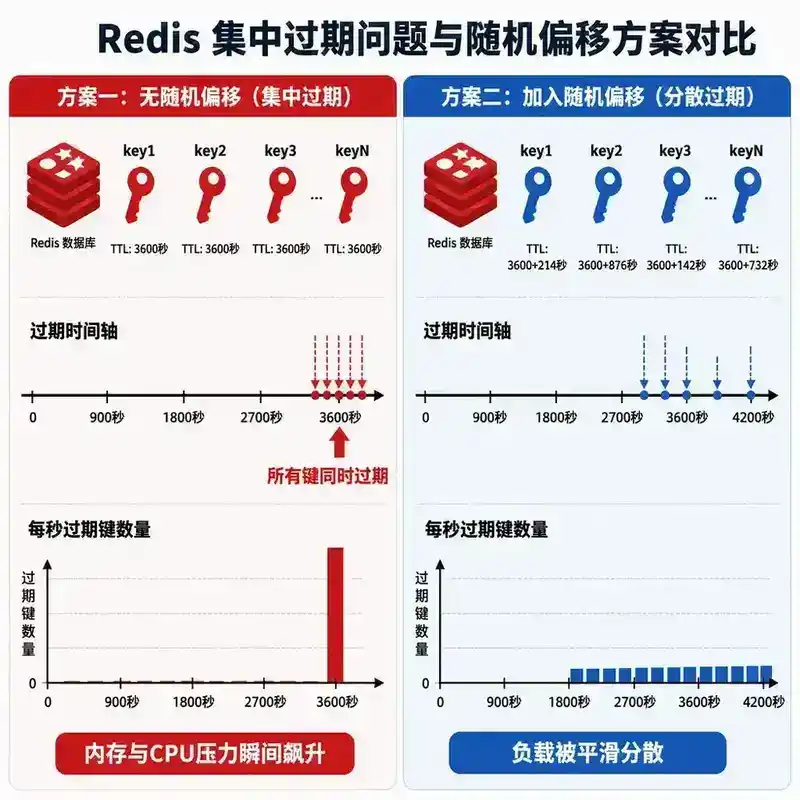
假设一个场景:你在秒杀活动开始时,一次性写入了 100 万个键,所有键的过期时间都设为 1 小时后。那么 1 小时后,这 100 万个键将同时过期。
定期删除每轮随机抽取 20 个键,如果过期比例超过 25%,继续抽检。在集中过期场景下,几乎每轮抽检的 20 个键中大部分都过期了,所以定期删除会一直运行,直到时间预算耗尽。但即使这样,清理速度也远远跟不上过期速度。
后果:大量过期键堆积在内存中,触发 maxmemory 淘汰策略,甚至导致正常的读写请求被阻塞(因为定期删除占用了事件循环时间)。
解决方案:在设置过期时间时加入随机偏移量,避免集中过期:
# 错误做法:所有键同时过期
import redis
r = redis.Redis()
for i in range(1000000):
    r.setex(f"seckill:stock:{i}", 3600, stock_value)

# 正确做法:加入随机偏移
import random
for i in range(1000000):
    ttl = 3600 + random.randint(0, 600)  # 3600~4200 秒随机分布
    r.setex(f"seckill:stock:{i}", ttl, stock_value)
三、内存淘汰机制:当 maxmemory 被触发时
3.1 maxmemory 配置
# redis.conf
maxmemory 4gb
maxmemory-policy allkeys-lru
maxmemory 定义了 Redis 能使用的最大内存上限。当内存使用达到这个阈值时,Redis 会根据 maxmemory-policy 配置的策略,淘汰一些键来释放空间。
重要:maxmemory 设为 0(默认值)表示不限制内存。在 64 位系统上,这意味着 Redis 会一直使用内存直到系统 OOM Killer 介入。生产环境必须设置 maxmemory!
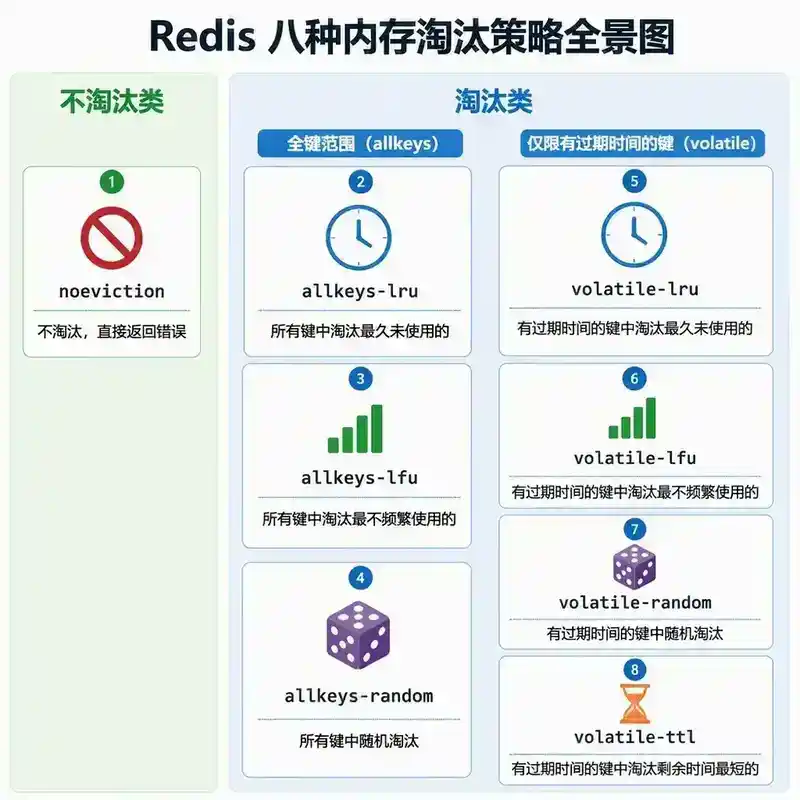
3.2 八种淘汰策略全景
| 策略 | 淘汰范围 | 淘汰依据 | 适用场景 |
|---|---|---|---|
noeviction |
— | 不淘汰,直接返回错误 | 不允许数据丢失的场景 |
allkeys-lru |
所有键 | 近似 LRU,淘汰最久未使用的 | 通用缓存场景(推荐) |
allkeys-lfu |
所有键 | 近似 LFU,淘汰最不频繁使用的 | 有冷热数据分层的缓存 |
allkeys-random |
所有键 | 随机淘汰 | 数据访问分布均匀 |
volatile-lru |
有过期时间的键 | 近似 LRU | 混合持久+缓存数据 |
volatile-lfu |
有过期时间的键 | 近似 LFU | 有过期时间的缓存 |
volatile-random |
有过期时间的键 | 随机淘汰 | — |
volatile-ttl |
有过期时间的键 | 淘汰 TTL 最短的 | 期望尽快过期的场景 |
选择建议:
- 纯缓存场景:
allkeys-lru或allkeys-lfu - 缓存 + 持久化混合:
volatile-lru(只淘汰缓存,保留持久化数据) - 不允许淘汰:
noeviction(但需要保证内存永不超限)
3.3 Redis LRU:近似的智慧
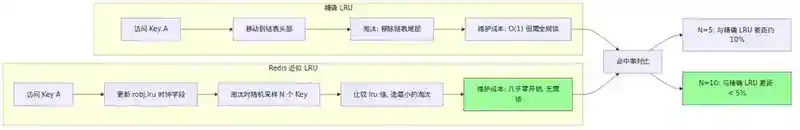
Redis 没有实现精确的 LRU(Least Recently Used),因为精确 LRU 需要维护一个双向链表,每次访问都要移动节点到链表头部,这在 Redis 的高并发场景下会带来巨大的额外开销。
Redis 的近似 LRU:每个键对象维护一个 24 位的 lru 时钟字段(robj->lru),记录该键的最后访问时间(精确到分钟)。淘汰时,随机采样 N 个键(由 maxmemory-samples 控制,默认 5),淘汰其中 lru 值最小的(即最久未访问的)。
maxmemory-samples 5 # 默认值,建议增大到 10 以获得更好的近似效果
近似 LRU 的有效性:Redis 官方文档给出的测试数据显示,当 maxmemory-samples=10 时,近似 LRU 与精确 LRU 的命中率差异已经非常小(< 5%),但性能开销远低于精确 LRU。
3.4 Redis LFU:访问频率才是关键
Redis 4.0 引入了 LFU(Least Frequently Used)淘汰策略。LRU 只看"最近有没有用",但一个键可能最近用了一次,而之前几个月都没用过——LRU 会认为它是"热点"。LFU 则看"历史上用了多少次",更接近真实的冷热数据判断。
实现:Redis 复用了 robj->lru 字段的 24 位,将其拆分为两部分:
 24 位 lru 字段
├─ 16 位:ldt (Last Decrement Time) — 上次衰减时间(分钟级时间戳)
└─  8 位:logc (Logarithmic Counter) — 对数访问计数器(0-255)
访问计数器递增逻辑:
// src/db.c
unsigned long LFUGetTimeInMinutes(void) {
    return (server.unixtime / 60) & 65535; // 16 位,约 45 天后回绕
}

uint8_t LFULogIncr(uint8_t counter) {
    if (counter == 255) return 255;           // 最大值,不再增长
    double r = (double)rand() / RAND_MAX;
    double baseval = counter - LFU_INIT_VAL;   // 初始值 5
    if (baseval < 0) baseval = 0;
    double p = 1.0 / (baseval * server.lfu_log_factor + 1);
    // lfu_log_factor 默认 10,越大则 p 越小,增长越慢
    return (r < p) ? counter + 1 : counter;
}
关键点:计数器采用对数增长——访问次数越多,计数器增长越慢。第 1 次访问增加到 1,第 100 次访问可能只增加到 10,第 100 万次访问才到 255。这样用 8 位就能表示极大的访问次数范围。
计数器衰减:LFU 不等同于"永久频率",Redis 会定期衰减计数器:
unsigned long LFUDecrAndReturn(robj *o) {
    unsigned long ldt = o->lru >> 8;          // 上次衰减时间
    unsigned long counter = o->lru & 255;      // 当前计数器
    // num_periods = 经过了多少分钟 / lfu_decay_time
    unsigned long num_periods = server.lfu_decay_time
        ? (LFUGetTimeInMinutes() - ldt) / server.lfu_decay_time
        : 0;
    if (num_periods) {
        counter = (num_periods > counter) ? 0 : counter - num_periods;
        o->lru = (LFUGetTimeInMinutes() << 8) | counter;
    }
    return counter;
}
lfu-decay-time(默认 1)控制衰减速度:每过 N 分钟,计数器减 1。设为 0 表示不衰减。
3.5 淘汰流程:从触发到执行
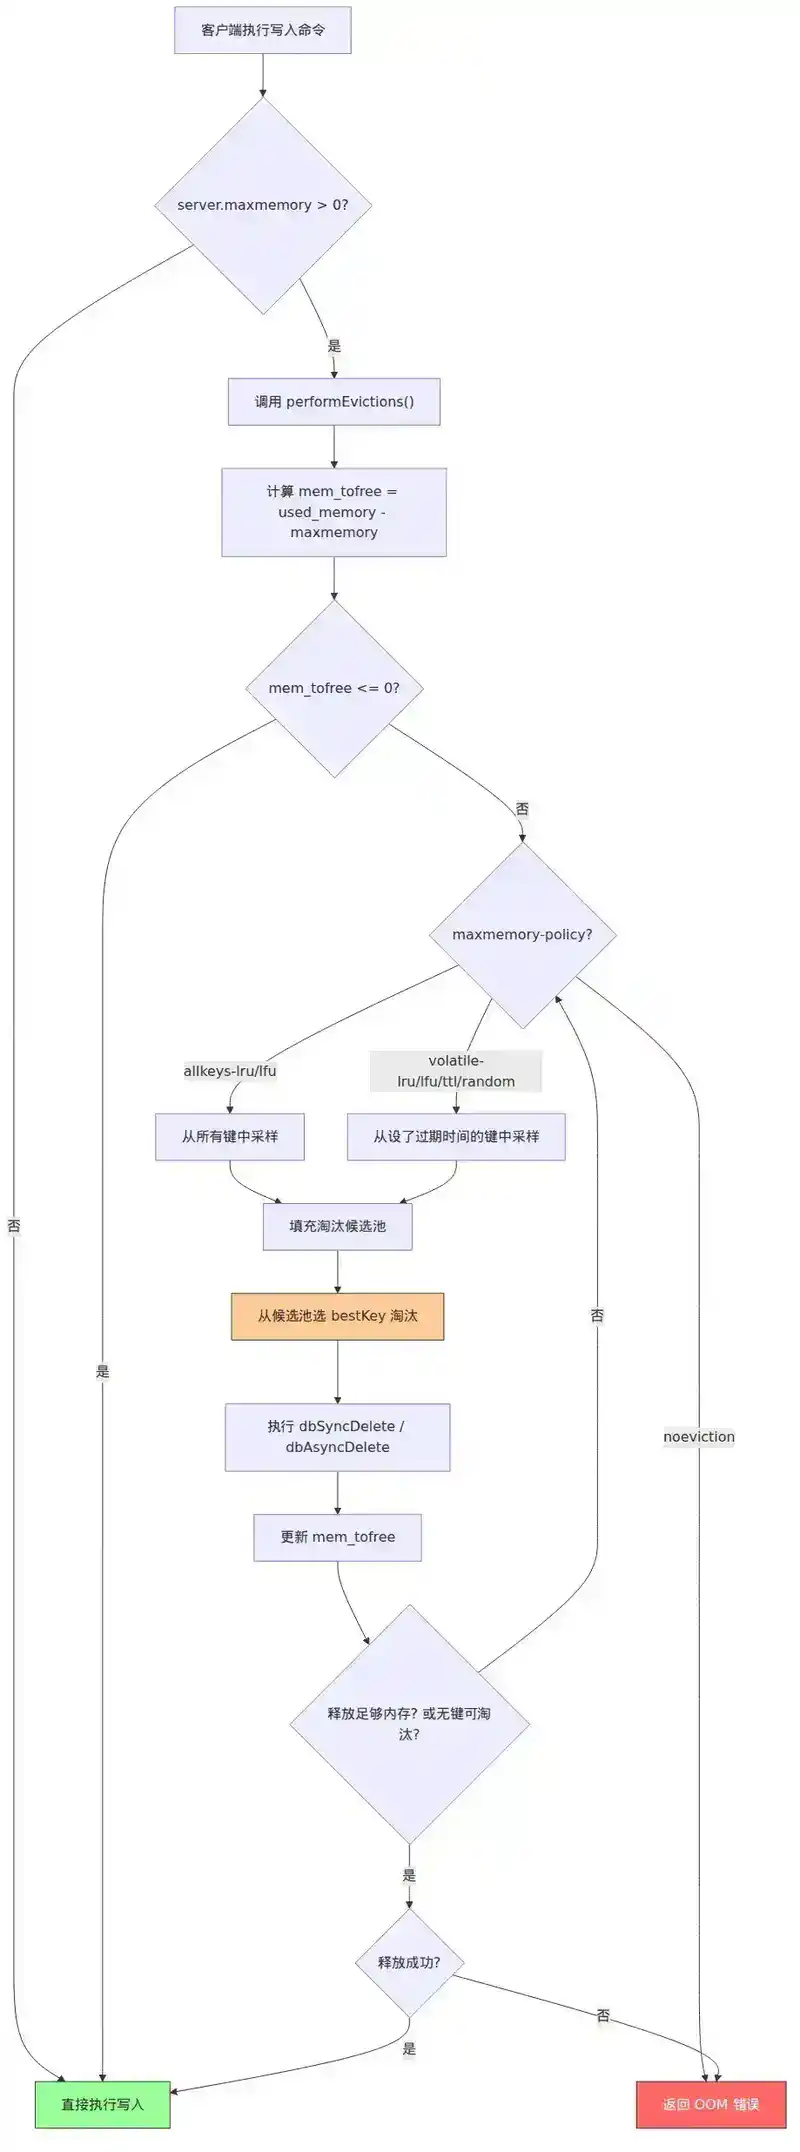
当 Redis 需要执行一个写入命令(如 SET、LPUSH 等)时,会先调用 processCommand(),其中的关键检查:
// src/server.c (简化)
int processCommand(client *c) {
    // ...
    if (server.maxmemory && !server.lua_timeout) {
        int out_of_memory = performEvictions();
        if (out_of_memory) {
            // 淘汰失败,拒绝写入
            addReplyError(c, "OOM command not allowed when used memory > 'maxmemory'");
            return C_ERR;
        }
    }
    // 继续执行命令...
}
performEvictions() 的核心流程:
- 计算需要释放的内存:
mem_tofree = used_memory - maxmemory - 如果
mem_tofree <= 0,不需要淘汰 - 根据
maxmemory-policy选择淘汰策略 - 循环淘汰键,直到释放足够内存或没有可淘汰的键
- 每次淘汰后检查释放的内存是否足够
- 如果是
noeviction策略,直接返回错误
四、源码深处:关键数据结构与函数
4.1 RedisObject 中的 LRU 字段
// src/server.h
typedef struct redisObject {
    unsigned type:4;       // 类型(string, list, hash, set, zset)
    unsigned encoding:4;   // 编码
    unsigned lru:LRU_BITS; // LRU 时钟或 LFU 数据(24 位)
    int refcount;          // 引用计数
    void *ptr;             // 指向实际数据的指针
} robj;
lru 字段是 LRU 和 LFU 共享的。当 maxmemory-policy 包含 lfu 时,它按 LFU 模式解析(高 16 位 = ldt,低 8 位 = logc);否则按 LRU 模式解析(24 位 = 访问时钟)。
4.2 LRU 时钟
// src/evict.c
unsigned int LRU_CLOCK(void) {
    unsigned int lruclock;
    // server.lruclock 由 serverCron 每 100ms 更新,分辨率约 1 秒
    // 但为了更高精度,这里直接计算
    if (1000 / server.hz <= LRU_CLOCK_RESOLUTION) {
        lruclock = server.lruclock;
    } else {
        lruclock = getLRUClock();
    }
    return lruclock;
}

// 对象被访问时更新
// src/db.c
void updateCachedTime(int update_server) {
    server.mstime = mstime();
    // 如果 LRU_CLOCK_RESOLUTION < 1000/HZ,用更粗粒度的时钟
    if (!update_server) return;
    server.lruclock = getLRUClock();
}
4.3 淘汰候选池(Eviction Pool)
Redis 不是每次淘汰都从头随机采样,而是维护一个淘汰候选池(evictionPoolEntry):
// src/evict.c
#define EVPOOL_SIZE 16
#define EVPOOL_CACHED_SDS_SIZE 255

struct evictionPoolEntry {
    unsigned long long idle;    // 空闲时间(LRU)或 255-counter(LFU)
    sds key;                    // 键名
    sds cached;                 // 缓存 SDS 名
    int dbid;                   // 数据库 ID
};

static struct evictionPoolEntry *EvictionPoolLRU;
候选池大小为 16,按 idle 值从大到小排序。每次淘汰时,用采样到的键填充候选池,然后从候选池中选 idle 最大的键淘汰。
五、生产实践:配置指南与经验法则
5.1 maxmemory 如何设定
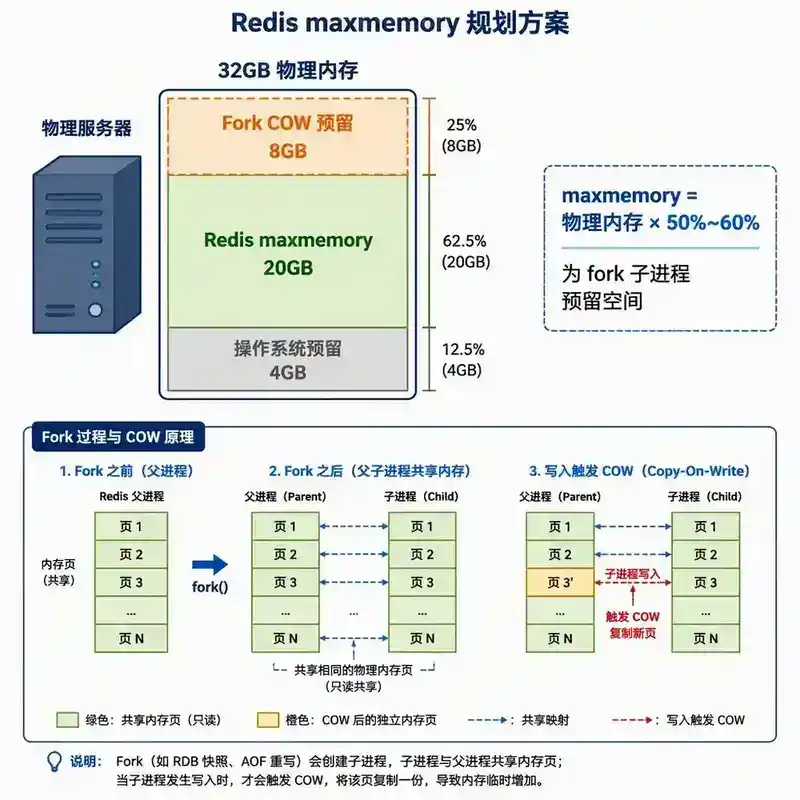
maxmemory 的设定 = 机器总内存 - 操作系统预留 - 其他进程内存 - fork 子进程开销
经验法则:
- 如果使用 RDB 持久化,预留 30%~50% 内存给 fork 时的 COW(Copy-On-Write)
- 如果使用 AOF 重写,同样需要预留 fork 内存
- 32GB 机器典型设置:
maxmemory 16gb ~ 20gb - 64GB 机器典型设置:
maxmemory 40gb ~ 48gb
关键原则:不要让 Redis 使用超过物理内存的 50%~60%,为 fork 子进程留足空间。
5.2 策略选择决策树
| 业务场景 | 推荐策略 | 理由 |
|---|---|---|
| 纯缓存,热点数据明显 | allkeys-lfu |
LFU 能更好识别真正的热点 |
| 纯缓存,数据访问均匀 | allkeys-lru |
LRU 实现简单,性能好 |
| 缓存 + 持久化数据 | volatile-lru |
只淘汰缓存,保留持久化数据 |
| 无法容忍数据丢失 | noeviction |
需要配合精确的容量规划 |
| 临时数据,希望尽快过期 | volatile-ttl |
优先淘汰即将过期的键 |
5.3 LFU 参数调优
# redis.conf
lfu-log-factor 10       # 对数增长因子,越大增长越慢,默认 10
lfu-decay-time 1        # 衰减时间,每 N 分钟计数器减 1,默认 1
lfu-log-factor 的影响(Redis 官方数据):
| 访问次数 | factor=1 | factor=10 | factor=100 |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 100 | ~100 | ~10 | ~5 |
| 1000 | ~255 | ~18 | ~9 |
| 100K | 255 | ~40 | ~20 |
| 1M | 255 | ~55 | ~28 |
| 10M | 255 | ~70 | ~36 |
选择建议:factor=10 是通用场景的好选择,能区分"热点"(几千次访问)和"超热点"(百万次访问)。
5.4 maxmemory-samples 调优
maxmemory-samples 10 # 建议从默认 5 增大到 10
增大采样数可以提高 LRU/LFU 的精确度,但会增加 CPU 开销。官方建议在 5~10 之间取值,10 已经非常接近精确算法的效果。
六、常见陷阱与故障案例
6.1 陷阱一:集中过期导致性能抖动
场景:业务代码使用 EXPIREAT 将所有缓存键的过期时间设为同一时刻(如每天凌晨 3 点)。
后果:大量键在同一时刻过期,定期删除拼命抽检但来不及清理,过期键堆积触发内存淘汰,淘汰过程又占用 CPU,导致正常请求响应变慢。
解决方案:
# 在过期时间上叠加随机偏移
import random
base_ttl = 86400  # 1 天
random_offset = random.randint(0, 3600)  # 0~1 小时随机偏移
r.setex(key, base_ttl + random_offset, value)
6.2 陷阱二:noeviction 下内存超限
场景:使用 noeviction 策略,但业务增长导致数据量超过了 maxmemory。
后果:所有写操作返回 OOM command not allowed,服务不可用。
解决方案:
- 提前监控内存使用率,设置告警阈值(如 80%)
- 评估是否需要扩容或切换到淘汰策略
- 增加
maxmemory或切换到allkeys-lru
6.3 陷阱三:从节点的过期删除
重要:Redis 从节点不会主动删除过期键。从节点等待主节点同步 DEL 命令。
这意味着:
- 在主节点上,过期键被惰性删除或定期删除清除后,主节点向从节点发送
DEL - 在从节点收到
DEL之前,客户端可能从从节点读到已过期的数据 - 这是 Redis 主从架构的已知行为,不是 Bug,而是设计取舍
解决方案:对一致性要求高的场景,读请求走主节点;或者接受短暂的不一致窗口。
6.4 故障案例一:LRU 策略下热点数据被误淘汰
现象:某电商团队使用 allkeys-lru,大促期间发现缓存命中率突然下降,数据库压力飙升。
排查:通过 INFO stats 发现 evicted_keys 在大促期间急剧增长。原因是大量新用户首次访问的临时数据(如浏览记录)被写入缓存,这些数据虽然最近被访问过,但之后不会再访问。LRU 将它们保留在内存中,而真正热门的商品数据(可能几秒前被访问过)却被淘汰了。
修复:切换到 allkeys-lfu。LFU 的计数器衰减机制能识别出"一次性访问"的低频数据,优先保留真正高频访问的热点数据。
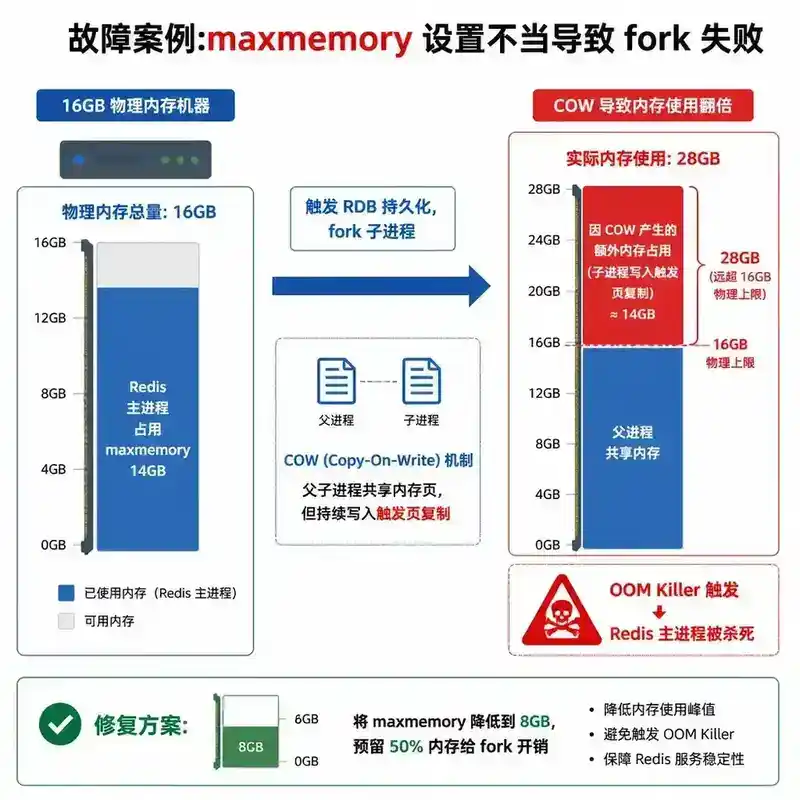
6.5 故障案例二:maxmemory 设置不当导致 fork 失败
现象:某团队在 16GB 机器上设置 maxmemory 14gb。某次 RDB 持久化时,fork 子进程导致内存使用超过 16GB,触发系统 OOM Killer,Redis 主进程被杀。
根因:fork 使用 COW 机制,父进程和子进程共享内存页。但如果父进程持续写入,就会触发页复制,内存翻倍。在 maxmemory 14gb 且写入频繁的情况下,fork 期间实际内存使用量可能达到 28GB,远超 16GB 物理内存。
修复:将 maxmemory 降低到 8GB,预留 50% 内存给 fork 开销。
七、面试追问
以下问题从面试官视角设计,考察对 Redis 过期与淘汰策略的深度理解,不限于本文内容。
Q1:Redis 的过期删除策略为什么是"惰性删除 + 定期删除"的组合,而不是单纯的定时删除?
参考答案:单纯定时删除(为每个过期键设置一个定时器)的问题是:如果同时有 100 万个键设置了过期时间,就需要 100 万个定时器。每个定时器的创建、管理和触发都有 CPU 开销,在海量键场景下根本无法承受。惰性删除 + 定期删除的组合是 CPU 和内存的折中:惰性删除保证了访问时一定能知道键是否过期(零额外 CPU 开销),定期删除则作为兜底,逐步清理那些"过期了但没人访问"的键。
Q2:如果一个键的过期时间是 100 秒,但 Redis 在设置后 50 秒时重启了(RDB 持久化),这个键的过期时间如何变化?
参考答案:RDB 文件在保存时会记录每个键的过期时间(毫秒级 Unix 时间戳)。加载 RDB 时,Redis 会检查当前时间——如果键已经过期,就不加载(主节点)或加载但标记为已过期(从节点)。如果还没过期,就恢复其剩余 TTL。所以过期时间是基于绝对时间戳的,不会因为重启而"重置"。
Q3:Redis 的 LFU 实现中,为什么计数器要采用对数增长而不是线性增长?
参考答案:8 位计数器最大值只有 255。如果用线性增长,最多只能记录 255 次访问,这完全无法区分"访问了 1000 次"和"访问了 100 万次"的热点差异。对数增长让计数器在低访问次数时增长快(精确区分低频数据),在高访问次数时增长极慢(用 8 位就能表示百万级访问),这是信息论中"有限位数编码大范围数值"的经典应用。
Q4:volatile-lru 和 allkeys-lru 的区别是什么?什么场景下 volatile-ttl 是最优选择?
参考答案:volatile-lru 只在设置了过期时间的键中淘汰,不会淘汰持久化键(没有 TTL 的键)。这适用于"部分数据是缓存,部分数据是持久化存储"的场景。allkeys-lru 在所有键中淘汰,不考虑是否设置了过期时间,适用于全部数据都是缓存的场景。volatile-ttl 优先淘汰 TTL 最短的键,适用于"期望即将过期的键先被淘汰"的场景,比如作为 Redis 分布式锁的辅助淘汰策略。
Q5:在 Redis Cluster 中,某个节点的 maxmemory 频繁触发淘汰,但其他节点还有大量空闲内存,你如何排查和解决?
参考答案:首先确认是否发生了数据倾斜(hot key 导致某个分片数据量远超其他分片)。通过 redis-cli --cluster info 和 redis-cli --bigkeys 检查键分布。如果确认是数据倾斜,需要调整分片键设计(如对 hot key 加前缀做拆分)。如果是 CRUD 操作导致的自然倾斜,考虑使用 redis-cli --cluster rebalance 做槽位迁移。最后,如果所有节点都接近满载,直接扩容加节点。
Q6:如果 Redis 的 maxmemory-policy 设为 noeviction,但内存已满,此时执行 DEL 命令能否成功?为什么?
参考答案:可以成功。noeviction 只阻止"增加内存使用"的写操作(如 SET、LPUSH、SADD 等),而 DEL 是释放内存的操作,不会触发内存检查。此外,DEL 释放的内存可能立即被后续写操作使用。但要注意,如果 DEL 之后立即执行 SET,SET 仍然可能触发 OOM,因为 performEvictions() 在每次写入前都会检查内存。
八、本文总结
| 维度 | 核心要点 |
|---|---|
| 过期删除 | 惰性删除(访问时检查)+ 定期删除(后台随机抽检,25% 阈值控制) |
| 内存淘汰 | 8 种策略,核心是 LRU 和 LFU 两种近似算法 |
| LRU 实现 | 基于 24 位时钟 + 随机采样(maxmemory-samples),近似但高效 |
| LFU 实现 | 16 位衰减时间 + 8 位对数计数器,区分冷热数据 |
| 关键配置 | maxmemory(物理内存 50%)、maxmemory-policy(allkeys-lfu)、maxmemory-samples(10) |
| 生产注意事项 | 避免集中过期、从节点不主动删除过期键、为 fork 预留足够内存 |
九、延伸阅读
- Redis 官方文档:Key Eviction
- Redis 源码
src/expire.c—activeExpireCycle()实现 - Redis 源码
src/evict.c—performEvictions()和 LRU/LFU 实现 - Redis 源码
src/db.c—expireIfNeeded()惰性删除实现 - Antirez 博客:Using Redis as an LRU cache