阅读时间:约 45 分钟 难度:中高级 前置知识:Redis 基础数据结构、RDB/AOF 持久化、TCP 网络基础
目录
- 为什么需要主从复制
- 主从复制架构概览
- 全量同步(Full Resynchronization):从零开始的数据传输
- 增量同步(Partial Resynchronization):断线重连的优雅恢复
- 复制积压缓冲区(Replication Backlog):增量同步的核心支撑
- 无盘复制(Diskless Replication):绕过磁盘的全量同步
- 复制过程深度解析:状态机与关键数据结构
- 心跳机制与复制超时
- 从节点过期键处理
- 常见问题与调优策略
- 总结
- 面试官提问
1. 为什么需要主从复制
在一个高并发的互联网系统中,单台 Redis 节点的能力是有限的。即使 Redis 以纯内存操作为主、单线程也能跑到 10 万 QPS,当流量增长到几十万甚至百万 QPS 时,单机瓶颈依然存在。此外,单点故障意味着一旦这台机器宕机,整个缓存层就不可用——这在生产环境中是不可接受的。
主从复制(Master-Slave Replication,Redis 社区后续版本中已改用 Master-Replica 称谓,但核心机制不变)是 Redis 高可用体系的基石。它解决两个核心问题:
- 读写分离:主节点负责写、从节点负责读,将读流量均衡分散到多个从节点上,线性提升系统的读吞吐量。
- 数据冗余与高可用:从节点持有主节点的完整数据副本,当主节点故障时,可以由从节点接管(配合 Sentinel 或 Cluster 自动完成故障转移)。
没有主从复制,就没有 Sentinel 的高可用,也就没有 Cluster 的分片集群。它是整个 Redis 分布式体系的起点。
2. 主从复制架构概览
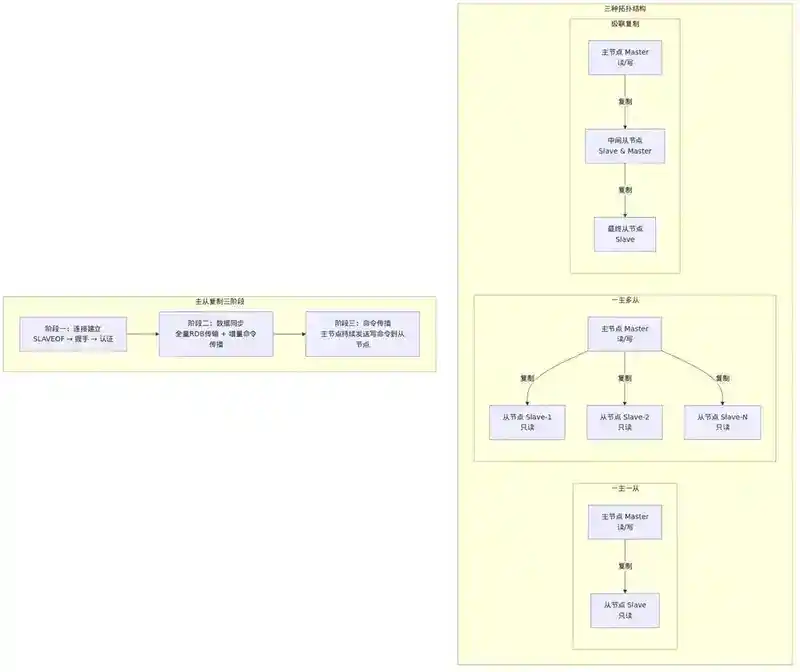
2.1 基本拓扑
最简单的拓扑是一主一从:
┌──────────┐     复制数据流      ┌──────────┐
│  Master  │ ──────────────────→ │  Slave   │
│  写+读   │                     │   只读   │
└──────────┘                     └──────────┘
生产环境中更常见的是一主多从:
             ┌──────────┐
             │  Master  │
             │  写+读   │
             └────┬─────┘
         ┌────────┼────────┐
         ▼        ▼        ▼
    ┌────────┐┌────────┐┌────────┐
    │ Slave1 ││ Slave2 ││ Slave3 │
    │  只读  ││  只读  ││  只读  │
    └────────┘└────────┘└────────┘
也可以级联(树状)复制,从节点再作为其他从节点的主节点:
    Master
      │
      ▼
   Slave-A (也是 Slave-B 的 Master)
      │
      ▼
   Slave-B
级联复制可以减轻主节点的复制输出压力,主节点只需要把数据推给少数几个直接下游节点,再由它们层叠分发。
2.2 核心配置
# 在从节点上执行,指定主节点
replicaof <master-ip> <master-port>

# 或在配置文件中
replicaof 192.168.1.100 6379

# 从节点默认只读
replica-read-only yes

# 主节点需要认证时
masterauth <password>
2.3 复制的基本流程(宏观)
一次完整的复制过程可以分为三个阶段:
- 建立连接:从节点与主节点建立 TCP 连接,发送 PING 检查连通性,必要时进行认证。
- 数据同步:从节点通过 PSYNC 命令请求数据同步。主节点根据情况决定执行全量同步还是增量同步。
- 命令传播:同步完成后,主节点持续将新的写命令发送给从节点,保持数据一致。
后文将详细展开每个阶段的内在机制。
3. 全量同步(Full Resynchronization)
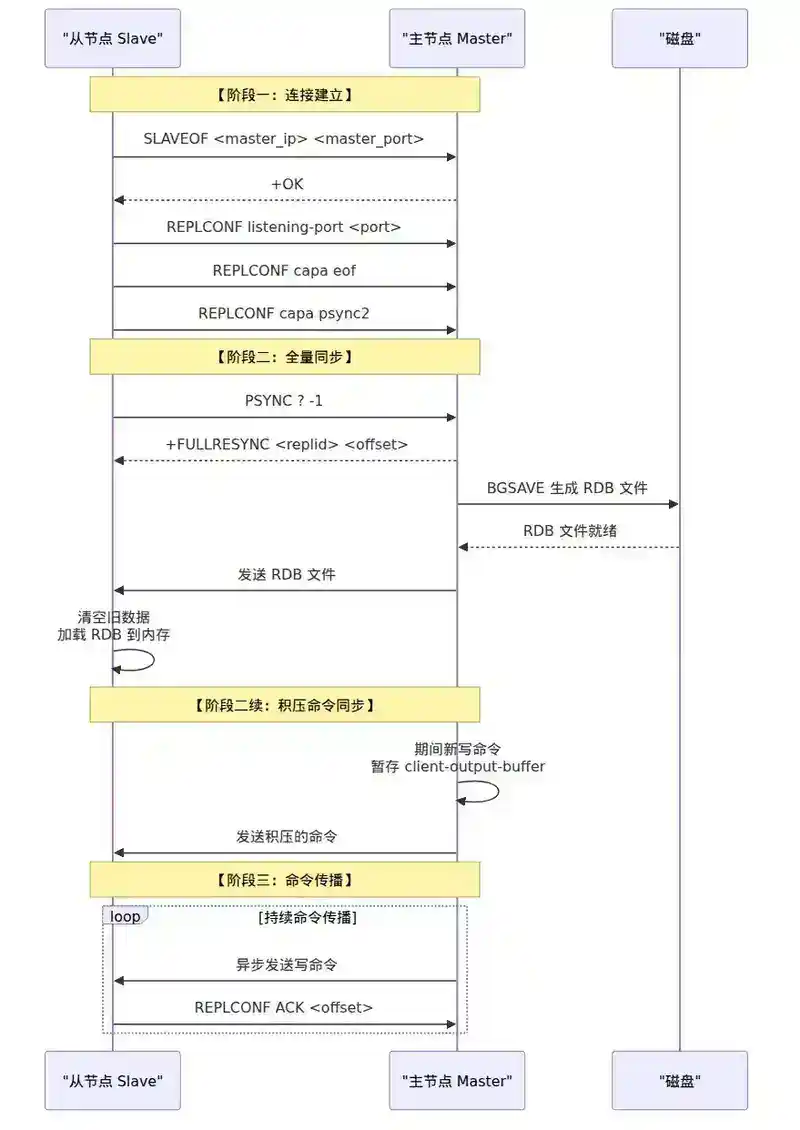
全量同步是当从节点首次连接到主节点,或者从节点落后太多无法通过增量同步恢复时,使用的一种完整的数据库传输方式。
3.1 触发条件
以下情况会触发全量同步:
- 从节点首次连接到主节点(从未复制过)。
- 从节点之前复制过,但断线时间太长,复制积压缓冲区中的数据已经被覆盖(
repl_backlog大小不够)。 - 从节点发送的
replication ID与主节点当前的replication ID不一致(主节点重启过,或发生了故障转移)。
3.2 全量同步流程(Redis 2.8+)
全量同步通过 PSYNC ? -1(首次)或 PSYNC <replid> <offset>(但 offset 不可用)触发。主节点返回 FULLRESYNC <replid> <offset> 响应,随后执行以下步骤:
从节点 (Slave)                          主节点 (Master)
    │                                        │
    │──── PSYNC ? -1 ──────────────────────→│  ① 发送 PSYNC 请求
    │                                        │
    │←── FULLRESYNC <replid> <offset> ──────│  ② 主节点回复 FULLRESYNC
    │                                        │
    │                                        │  ③ 主节点执行 BGSAVE,fork 子进程生成 RDB
    │                                        │
    │                                        │  ④ 主节点将 BGSAVE 期间的新写命令
    │                                        │     写入 client-output-buffer-limit
    │                                        │     (replication buffer)
    │                                        │
    │←── RDB 文件传输 ──────────────────────│  ⑤ 主节点将 RDB 发送给从节点
    │                                        │
    │  ⑥ 从节点清空自身旧数据,加载 RDB     │
    │                                        │
    │←── 积压的写命令 ──────────────────────│  ⑦ 主节点发送 BGSAVE 期间的写命令
    │                                        │
    │  ⑧ 从节点执行积压命令,追上主节点     │
    │                                        │
    │════════════ 进入命令传播阶段 ══════════│
3.3 关键细节
BGSAVE 与 replication buffer:
主节点收到 FULLRESYNC 请求后,会 fork 一个子进程执行 BGSAVE 生成 RDB 快照。此时主节点的主进程继续处理客户端写请求——这些在 BGSAVE 期间产生的新写命令,会被记录到一个特定的缓冲区中(称为 replication buffer 或 client output buffer,类型为 SLAVE 类型)。
在 RDB 文件生成并传输给从节点后,主节点再将缓冲区中的写命令发送给从节点,从节点执行这些命令后,数据就追上了主节点在 BGSAVE 完成那一刻的状态。
从节点清空旧数据:
从节点在加载 RDB 之前,会先清空自身所有数据库(FLUSHALL 语义),确保旧数据不会与新数据混杂。这在从节点之前持有其他主节点的数据时尤为重要。
replication buffer 的硬限制:
client-output-buffer-limit 配置了 replication buffer 的大小限制。如果 BGSAVE 太慢、RDB 传输太慢,导致积压的写命令超过了这个限制,主节点会主动断开与从节点的连接,全量同步失败。此时需要调整参数或优化网络。
# 配置语法
client-output-buffer-limit slave <hard-limit> <soft-limit> <soft-seconds>

# 默认值
client-output-buffer-limit slave 256mb 64mb 60
含义:硬限制 256MB(超过立即断开),软限制 64MB 持续超过 60 秒也断开。
3.4 全量同步的性能影响
全量同步是一个重量级操作,对主节点和从节点都有明显影响:
| 影响面 | 描述 |
|---|---|
| 主节点 CPU | fork 子进程执行 BGSAVE,会消耗 CPU 时间 |
| 主节点内存 | fork 采用 copy-on-write,写操作较多时会有额外内存开销 |
| 主节点磁盘 I/O | 传统模式下 RDB 需要写入磁盘再读取传输 |
| 主节点网络 | 全量 RDB 传输占用大量带宽 |
| 从节点 CPU/内存 | 加载 RDB 需要解析和重建所有数据结构 |
| 从节点阻塞 | 加载 RDB 期间从节点无法对外提供服务 |
4. 增量同步(Partial Resynchronization)
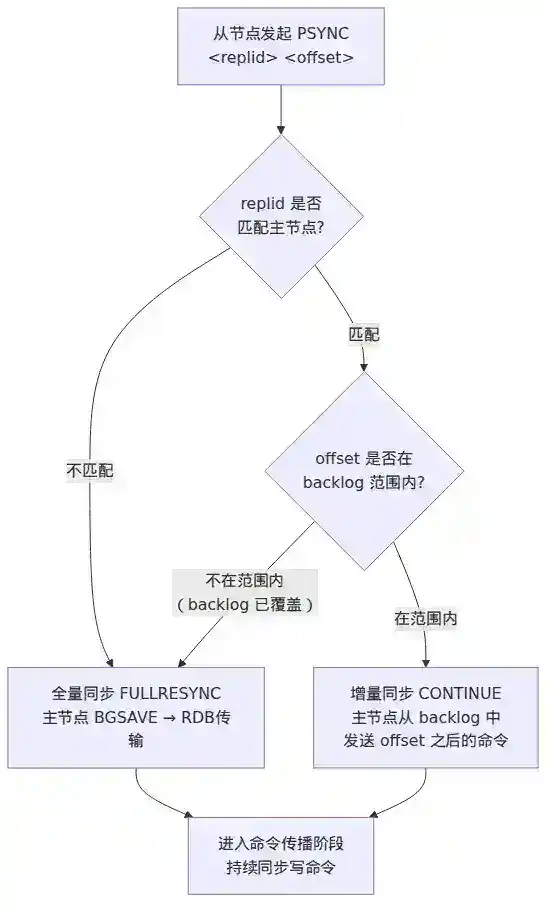
增量同步是 Redis 2.8 引入的重要特性。它解决了老版本中一旦断线就必须全量同步的痛点,允许从节点在短暂断线后只获取断线期间的增量数据,极大降低了网络抖动对复制的影响。
4.1 核心三要素
增量同步依赖三个关键信息:
- Replication ID(replid):主节点的唯一标识。每个主节点启动时生成一个 40 位十六进制随机字符串。
- Replication Offset:复制偏移量。主节点和从节点各自维护一个 offset,代表当前已处理的命令字节数。
- Replication Backlog:复制积压缓冲区。主节点维护的一个固定大小的环形缓冲区,记录最近的写命令。
4.2 增量同步的判定流程
当从节点重连时,发送 PSYNC <replid> <offset>:
从节点: PSYNC 8372b4e... 9000
主节点收到后做以下判断:
从节点发来的 replid == 我的 replid?
    ├── 否 → 返回 FULLRESYNC(全量同步)
    └── 是 → 从节点发来的 offset 是否还在 backlog 中?
                ├── 否 → 返回 FULLRESYNC(全量同步)
                └── 是 → 返回 CONTINUE(增量同步)
如果返回 CONTINUE,主节点只需要把 backlog 中 offset 之后的数据发送给从节点即可。
4.3 增量同步流程
从节点 (Slave)                          主节点 (Master)
    │                                        │
    │  (断线重连)                             │
    │                                        │
    │── PSYNC <replid> <offset> ───────────→│  ① 带着上次的 replid 和 offset
    │                                        │
    │                                        │  ② 主节点检查 replid 和 offset
    │                                        │
    │←── CONTINUE ──────────────────────────│  ③ 条件满足,增量同步
    │                                        │
    │←── backlog 中 offset 之后的命令 ──────│  ④ 发送增量数据
    │                                        │
    │══════════ 进入命令传播阶段 ════════════│
4.4 replid2 与故障转移
当 Sentinel 或 Cluster 执行故障转移时,一个从节点被提升为新的主节点。新主节点会生成一个新的 replid。但为了支持旧主节点的其他从节点做增量同步,新主节点会保留旧主节点的 replid 作为 replid2(second replication ID)。
当其他从节点带着旧 replid 向新主节点发送 PSYNC 时,新主节点发现 replid 不匹配,但匹配 replid2,且 offset 在 backlog 中——仍然可以走增量同步,而不是全量同步。
这个机制在 Redis 4.0 中引入,极大地减少了故障转移后的同步开销。
5. 复制积压缓冲区(Replication Backlog)
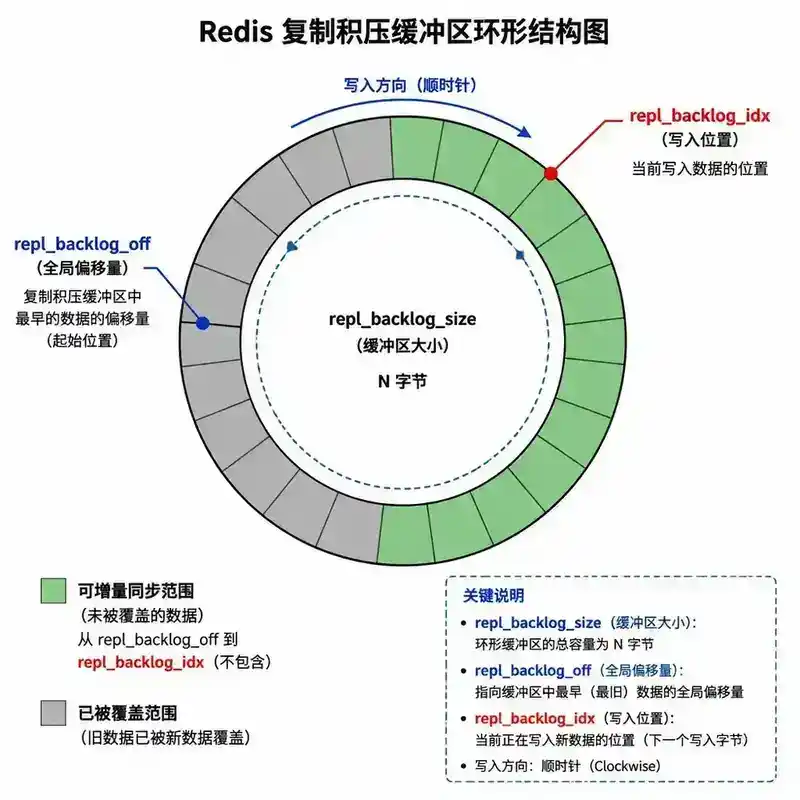
复制积压缓冲区是增量同步的物理基础。它是主节点维护的一个环形 FIFO 缓冲区,默认大小 1MB。
5.1 数据结构
repl_backlog:
┌──────────────────────────────────────────────────┐
│ offset:  0    1    2   ...  repl_backlog_size-1  │
│ data:   [cmd1][cmd2][cmd3]...[cmdN]              │
│         ↑                              ↑         │
│    repl_backlog_idx              (最新写入位置)   │
│                                                  │
│ repl_backlog_off: 主节点累计处理的总字节数       │
│   (这是一个全局递增的 offset,不是 backlog 内索引) │
└──────────────────────────────────────────────────┘
关键字段:
// Redis 源码中 repl_backlog 相关结构
typedef struct {
    char *repl_backlog;          // 环形缓冲区指针
    long long repl_backlog_size; // 缓冲区总大小(字节)
    long long repl_backlog_histlen; // 当前已有数据量
    long long repl_backlog_idx;  // 下次写入的环形索引
    long long repl_backlog_off;  // 缓冲区中第一个字节对应的全局 offset
    long long repl_backlog_time_limit; // 从节点断线后 backlog 存活时间
} replBacklog;
5.2 环形缓冲区的工作原理
backlog 是一个固定大小的环形缓冲区。写入时:
- 新数据写入
repl_backlog[repl_backlog_idx]位置 repl_backlog_idx递增- 如果
repl_backlog_idx >= repl_backlog_size,则回绕到 0 - 如果缓冲区已满,新数据会覆盖最旧的数据
repl_backlog_off会相应前移
判断增量同步是否可行:
// 伪代码
int canPartialResync(long long slave_offset) {
    // 从节点的 offset 必须在 backlog 覆盖范围内
    return slave_offset >= repl_backlog_off &&
           slave_offset < repl_backlog_off + repl_backlog_histlen;
}
5.3 配置大小
# 默认 1MB,生产环境建议调大
repl-backlog-size 64mb

# backlog 在从节点全部断开后保留的时间(秒),超时释放
repl-backlog-ttl 3600
大小估算公式:
repl-backlog-size = 主节点每秒写入量 × 预期的断线恢复时间(秒)
例如,主节点每秒写入 5MB,预期断线后 60 秒内恢复,则 backlog 至少需要 5MB × 60 = 300MB。
生产环境建议给到 64MB ~ 256MB,具体取决于写入量。过小的 backlog 会导致频繁的全量同步。
6. 无盘复制(Diskless Replication)
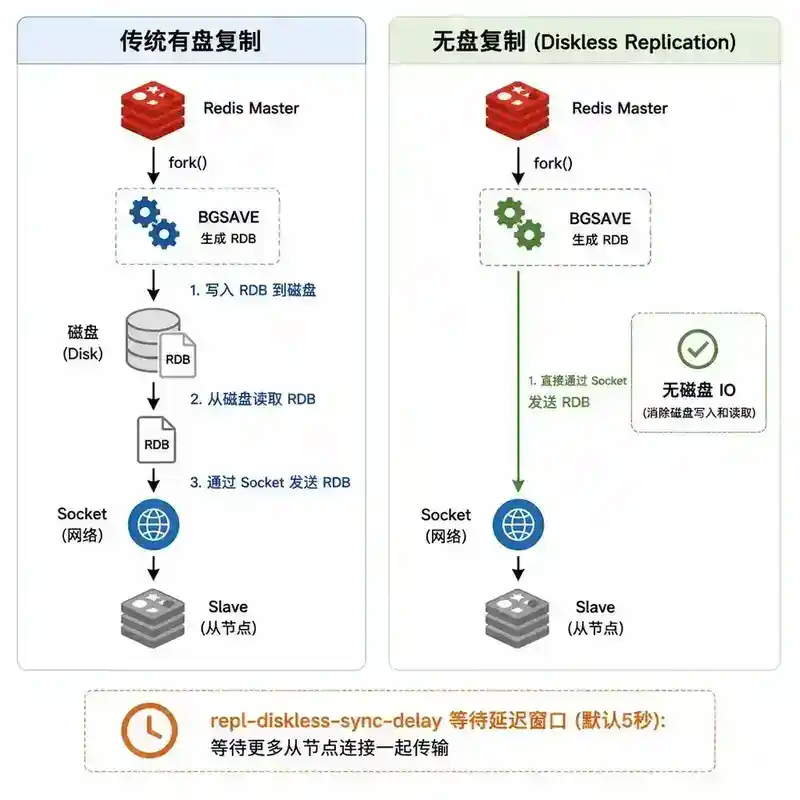
6.1 问题背景
传统全量同步在磁盘上的流程是:
主节点 fork → 子进程写 RDB 到磁盘 → 主进程读磁盘 RDB 文件 → 通过网络发送给从节点
这个流程存在两个磁盘瓶颈:
- 磁盘 I/O:RDB 先写磁盘再读磁盘,对于慢磁盘(HDD 或云盘)耗时很长。
- 磁盘空间:需要额外的磁盘空间存放 RDB 文件。
在纯内存场景下(Redis 数据全在内存中),磁盘成了一个多余的中间环节。
6.2 无盘复制的设计
无盘复制(Redis 2.8.18 引入实验性支持,后续版本持续完善)绕过磁盘,直接通过 Socket 将 RDB 数据流式发送给从节点:
主节点 fork → 子进程生成 RDB → 直接写入 Socket(不经过磁盘)→ 从节点接收并加载
传统模式: fork → RDB 写磁盘 → 读磁盘 → Socket 发送 → 从节点
无盘模式: fork → RDB 直接写入 Socket → 从节点
### 6.3 配置
# 启用无盘复制
repl-diskless-sync yes

# 第一个从节点连接后等待其他从节点的时间(秒)
# 在此期间如果有多个从节点请求全量同步,可以共享一次 RDB 生成
repl-diskless-sync-delay 5

# 无盘复制时,从节点接收 RDB 数据的最大 I/O 时间(秒)
repl-diskless-load flush-before-load  # 默认:先清空再加载
6.4 延迟等待的作用
repl-diskless-sync-delay 的设计非常巧妙。当第一个从节点请求全量同步时,主节点不是立即开始 fork,而是等待几秒。在这几秒内,如果有其他从节点也请求全量同步,它们可以共享同一次 RDB 生成和传输。
时间轴:
t=0   Slave1 请求全量同步
t=0   主节点开始等待(delayed)
t=1   Slave2 请求全量同步
t=3   Slave3 请求全量同步
t=5   等待结束,主节点 fork 子进程,生成 RDB 直接写入 Socket
t=5   三个从节点同时接收 RDB 数据
这在批量扩容或集群重启时非常有用——避免主机在短时间内 fork 多次。
6.5 无盘复制的优缺点
| 优点 | 缺点 |
|---|---|
| 省去磁盘 I/O,适合慢磁盘环境 | 网络传输失败时需要重头开始 |
| 节省磁盘空间 | 多个从节点必须同时开始(等待窗口内) |
| 全内存操作,速度更快 | 对网络稳定性要求更高 |
| 批量从节点可共享一次 fork | 调试和排查不如有盘模式直观 |
6.6 无盘加载(Diskless Load)
从节点侧也有对应的优化——无盘加载。从节点接收 RDB 数据时,可以不先写入磁盘再加载,而是直接在内存中解析:
# 从节点侧:接收 RDB 数据后直接解析,不落盘
repl-diskless-load disabled      # 禁用(默认)
repl-diskless-load on-empty-db   # 数据库为空时使用无盘加载
repl-diskless-load swapdb        # 先加载到临时内存,完成后 swap 替换当前数据库
swapdb 模式最实用:从节点在后台加载新 RDB,加载完成后瞬间替换当前数据库。这样加载期间从节点仍然可以对外提供旧数据的读服务,减少服务中断时间。
7. 复制过程深度解析:状态机与关键数据结构
7.1 从节点的复制状态机
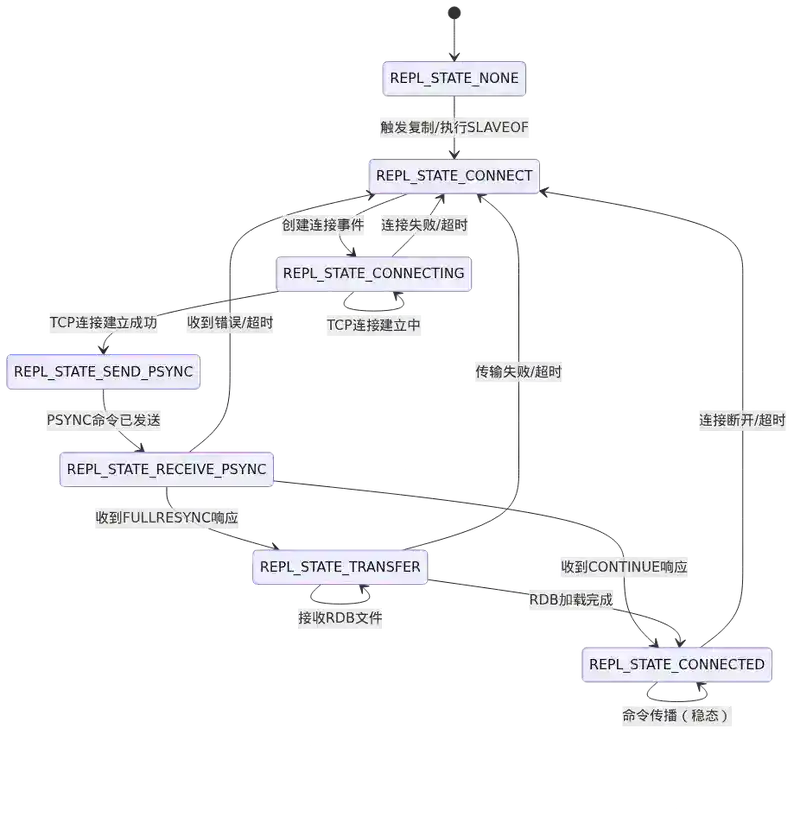
从节点的复制过程由一系列状态组成,核心状态包括:
REPL_STATE_NONE                → 初始状态,无复制
REPL_STATE_CONNECT             → 正在连接主节点
REPL_STATE_CONNECTING          → TCP 连接建立中
    ↓
REPL_STATE_SEND_HANDSHAKE      → 发送 PING(握手)
REPL_STATE_RECEIVE_AUTH        → 等待认证(如果需要)
REPL_STATE_SEND_PORT           → 发送从节点监听端口
REPL_STATE_SEND_IP             → 发送从节点 IP(如果需要)
REPL_STATE_SEND_CAPA           → 发送从节点能力(如支持 PSYNC2)
    ↓
REPL_STATE_SEND_PSYNC          → 发送 PSYNC 命令
REPL_STATE_RECEIVE_PSYNC       → 等待 PSYNC 响应
    ↓
  ┌─────────────────────────────────────────┐
  │ FULLRESYNC?  →  REPL_STATE_TRANSFER     │  接收 RDB 文件
  │ CONTINUE?    →  REPL_STATE_CONNECTED    │  直接进入命令传播
  └─────────────────────────────────────────┘
    ↓
REPL_STATE_CONNECTED            → 命令传播阶段(正常运行状态)
7.2 主节点侧的从节点管理
主节点为每个从节点维护一个 client 结构,包含:
// 每个从节点客户端的核心字段
typedef struct client {
    // ...
    long long reploff;          // 从节点的复制偏移量
    long long repl_ack_off;     // 从节点确认的偏移量(ACK)
    time_t repl_ack_time;       // 最后一次 ACK 的时间
    int replstate;              // 从节点复制状态
    char replid[CONFIG_RUN_ID_SIZE+1]; // 主节点 ID
    int slave_listening_port;   // 从节点监听端口
    // ...
} client;
主节点在命令传播阶段,每执行一个写命令,就把命令写入所有从节点的 output buffer 和 backlog。
7.3 命令传播的细节
命令传播阶段,主节点和从节点之间维持一个异步的数据流:
- 主节点执行写命令后,将命令追加到 backlog 和每个从节点的 output buffer。
- 主节点的事件循环在每次 epoll 返回时,将 output buffer 中的数据通过 Socket 发送给从节点。
- 从节点接收到数据后,解析并执行命令,更新自己的 offset。
- 从节点定期(默认每秒)发送
REPLCONF ACK <offset>告知主节点自己的复制进度。
注意:主节点不会等待从节点确认——命令传播是异步的。这意味着主从之间天然存在复制延迟。
8. 心跳机制与复制超时
8.1 PING/PONG 心跳
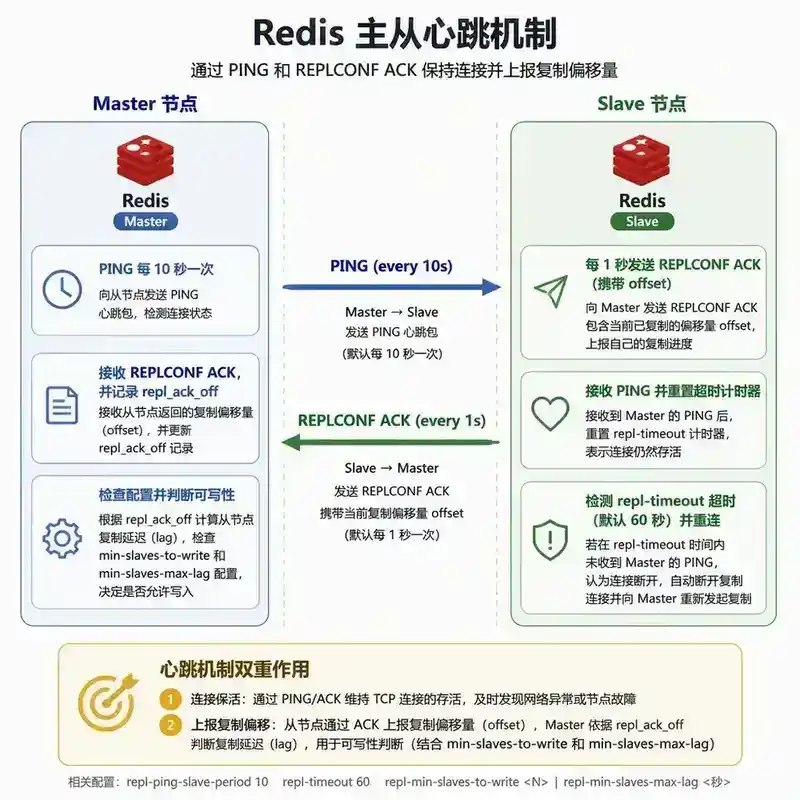
主节点默认每 10 秒向所有从节点发送 PING:
# 配置
repl-ping-replica-period 10
如果从节点超时未响应,主节点会断开连接并从从节点列表中移除。
8.2 REPLCONF ACK 心跳
从节点默认每秒向主节点发送 REPLCONF ACK <offset>:
- 检测主从连接状态:主节点通过 ACK 判断从节点是否存活。
- 辅助 min-slaves 配置:主节点可以根据 ACK 状态判断从节点连接数是否满足要求。
- 支持半同步语义:结合
min-slaves-to-write和min-slaves-max-lag,可以在从节点落后太多时拒绝写入。
# 至少要有 1 个从节点,且延迟不超过 10 秒
min-replicas-to-write 1
min-replicas-max-lag 10
8.3 复制超时
# 复制超时时间(秒),影响以下场景:
# 1. 从节点连接主节点的超时
# 2. 从节点接收 RDB 的超时
# 3. 主节点等待从节点 ACK 的超时
repl-timeout 60
9. 从节点过期键处理
Redis 的过期键删除在复制场景下有一个特殊的设计:
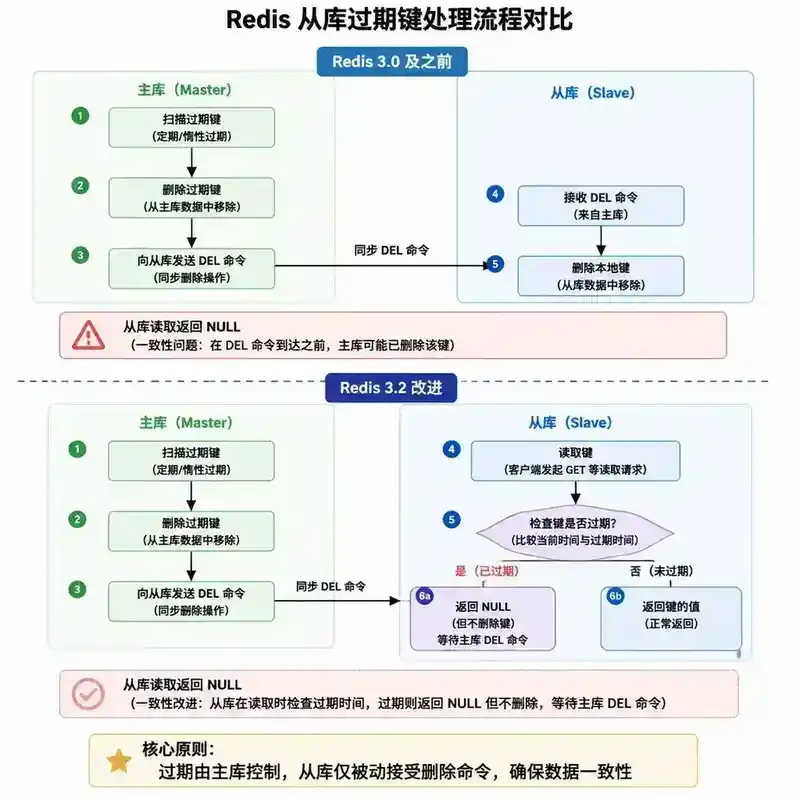
- 主节点:正常处理键过期。当键过期时,主节点会主动删除键,并向 AOF 和所有从节点发送 DEL 命令。
- 从节点:不会主动删除过期键。即使从节点读到过期键也仍然返回给客户端。只有收到主节点发来的 DEL 命令后,从节点才会删除过期键。
这样设计的原因是为了保证主从数据一致性。如果主从时钟不同步,从节点可能在自己认为键过期时删除它,而主节点还没有删除,导致数据不一致。统一由主节点控制过期键的删除时机,避免了时钟偏差带来的不一致问题。
Redis 3.2 之后,从节点在读取键时会检查键是否过期——如果过期,虽然不删除键,但会返回 NULL 给客户端。这保证了客户端不会读到过期数据,同时保持了主从一致性。
10. 常见问题与调优策略
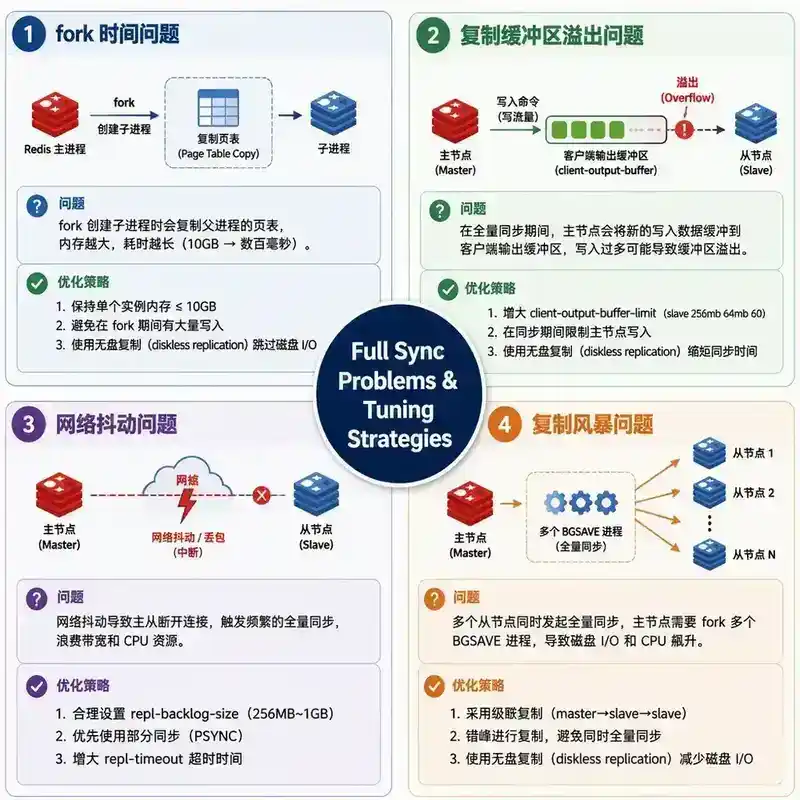
10.1 全量同步中的常见问题
问题一:主节点 fork 耗时过长导致复制中断
BGSAVE fork 时,如果主节点内存很大(几十 GB),fork 操作本身可能耗时数百毫秒甚至秒级。在此期间,主节点无法处理请求,从节点可能超时。
应对:
- 关闭 THP(Transparent Huge Pages):
echo never > /sys/kernel/mm/transparent_hugepage/enabled - 确保有足够的内存:fork 的 copy-on-write 需要额外内存
- 选择低负载时段进行全量同步
问题二:replication buffer 溢出
BGSAVE 过程中如果写流量很大,replication buffer 可能在 RDB 传输完成前就满了,导致连接断开。
应对:
- 增大
client-output-buffer-limit的 slave 限制 - 使用无盘复制减少 RDB 传输时间
- 在低峰期进行全量同步
问题三:RDB 传输期间的网络抖动
大 RDB 文件传输过程中如果网络中断,需要重头开始全量同步。
应对:
- 使用无盘复制 + 多个从节点共享一次 fork 减少重复传输
- 确保主从节点在同一机房或网络质量好的环境
10.2 复制延迟问题
现象:从节点数据落后于主节点,读取到旧数据。
原因:
- 主节点写入量过大,从节点处理不过来
- 网络带宽不足
- 从节点 CPU 繁忙
应对:
- 扩容从节点,分散读流量
- 确保主从节点网络带宽充足
- 监控
master_repl_offset和slave_repl_offset的差值
10.3 从节点数据不一致
场景:主从数据不一致,从节点多了主节点没有的键,或者相反。
原因:
- 从节点被人为写入了数据(
replica-read-only被设为 no) - 主从时钟不同步导致的过期键问题
- 网络分区导致的脑裂
应对:
- 确保
replica-read-only yes - 使用 Redis 3.2+ 版本
- 配置合理的
min-replicas-to-write
10.4 复制风暴
场景:主节点重启后,大量从节点同时请求全量同步,导致主节点 fork 多次,CPU 和内存压力剧增。
应对:
- 使用无盘复制 +
repl-diskless-sync-delay让多个从节点共享一次 RDB 生成 - 使用树状复制分散压力
- 控制从节点数量,必要时使用 Cluster 分片
10.5 调优清单
| 配置项 | 建议值 | 说明 |
|---|---|---|
| repl-backlog-size | 64MB ~ 256MB | 按写入量 × 恢复时间估算 |
| repl-timeout | 60 ~ 120 | 根据网络质量调整 |
| client-output-buffer-limit slave | 256mb 128mb 60 | 全量同步期间缓冲 |
| repl-diskless-sync | yes | 推荐开启 |
| repl-diskless-sync-delay | 5 | 等待其他从节点 |
| repl-diskless-load | swapdb | 从节点无盘加载 |
| repl-ping-replica-period | 10 | 心跳间隔 |
| min-replicas-to-write | 1 | 至少 1 个从节点 |
| min-replicas-max-lag | 10 | 从节点最大延迟 |
11. 总结
Redis 主从复制是构建高可用缓存体系的第一块基石。本文从全量同步和增量同步两条主线展开,深入剖析了复制积压缓冲区、无盘复制、心跳机制和过期键处理等核心模块。
核心要点回顾:
| 维度 | 要点 |
|---|---|
| 全量同步 | 主节点 BGSAVE 生成 RDB → 传输 → 从节点加载;积压命令在 replication buffer 中;触发条件:首次连接/offset 不在 backlog/replid 不匹配 |
| 增量同步 | 依赖 replid + offset + backlog 三要素;从节点断线重连后只同步增量数据 |
| 复制积压缓冲区 | 环形 FIFO 缓冲区,大小决定了增量同步的窗口期;按写入量 × 恢复时间估算 |
| 无盘复制 | 绕过磁盘,RDB 直接通过 Socket 传输;多个从节点可共享一次 fork |
| 心跳机制 | PING(10s)+ REPLCONF ACK(1s);辅助 min-slaves 配置实现半同步语义 |
| 过期键 | 统一由主节点控制,从节点被动接收 DEL 命令;Redis 3.2+ 从节点读时过滤过期键 |
主从复制是 Redis Sentinel 和 Cluster 的前置知识。理解它,才能理解故障转移、数据一致性和容量规划。下一篇我们将深入 Redis Sentinel 的自动故障转移机制。
12. 面试官提问
以下问题从面试官视角出发,考察候选人对 Redis 主从复制机制的深度理解和实际工程经验。建议在阅读完上文后,尝试独立回答再对照参考答案。
Q1:如果主节点在 BGSAVE 期间有大量写操作,导致 replication buffer 被写满,会发生什么?你如何设计一个方案来避免这个问题?
参考答案:
当 replication buffer 超过 client-output-buffer-limit 配置的硬限制(默认 256MB)或软限制持续超时(默认 64MB 持续 60 秒),主节点会主动断开与该从节点的连接,全量同步失败。从节点会尝试重连,重连后再次触发全量同步——如果写流量不降下来,会陷入"全量同步→buffer 溢出→断开→重连→全量同步"的死循环。
工程化解决方案(多层级):
- 第一层——参数调优:增大
client-output-buffer-limit slave的硬限制和软限制。但这不是根本解法,只是把问题推迟。 - 第二层——错峰同步:在业务低峰期执行全量同步,此时写流量小,buffer 不容易溢出。
- 第三层——无盘复制:开启
repl-diskless-sync yes,省去磁盘 I/O 时间,RDB 生成后直接通过 Socket 流式传输,缩短全量同步的总耗时,从而减少 buffer 积压。 - 第四层——从节点分批同步:配合
repl-diskless-sync-delay,让多个从节点共享一次 fork,避免主节点多次 BGSAVE 叠加压力。 - 第五层——限流:在全量同步期间,对主节点的写入做限流(业务层或网关层),降低 buffer 积压速度。这是最激进的手段,通常只在极端情况下使用。
追问:如果全量同步的 RDB 文件有 50GB,在网络传输过程中主节点挂了,从节点会发生什么?
从节点检测到连接断开后,会丢弃已接收的部分 RDB 数据,进入重连逻辑。重连成功后,从节点会重新发送 PSYNC——但由于之前处于 REPL_STATE_TRANSFER 状态,尚未进入命令传播阶段,从节点没有有效的 replid 和 offset,只能再次触发全量同步。这就是为什么大实例的全量同步风险很高,推荐使用 Cluster 分片来降低单实例数据量。
Q2:Redis 的主从复制是异步的,那么在主节点宕机的瞬间,有多少数据会丢失?你如何量化这个丢失窗口?
参考答案:
Redis 主从复制默认是异步的——主节点执行写命令后立即返回给客户端,不等待从节点确认。因此,在主节点宕机的瞬间,尚未发送给从节点的写命令会丢失。
量化丢失窗口:
丢失数据量 ≈ 主节点宕机前最后一段时间的写入量,时间窗口取决于两个因素:
- 网络延迟:主节点 output buffer 中的数据尚未到达从节点(通常毫秒级,可忽略)。
- 从节点处理延迟:从节点收到命令但尚未执行完成。从节点的
slave_repl_offset与主节点的master_repl_offset之差就是当前的复制延迟。通过INFO replication可以实时监控:
master_repl_offset:9876543210
slave0: ip=192.168.1.101,port=6379,state=online,offset=9876543210,lag=0
lag 字段表示从节点最后一次 ACK 距今的秒数,master_repl_offset - slave_offset 就是当前的复制延迟(字节数)。
实际丢失量估算:
丢失字节数 ≈ 平均写入速率(字节/秒) × 复制延迟(秒)
如果主节点写入速率是 10MB/s,复制延迟 0.5 秒,那么最多丢失约 5MB 的写命令。
降低丢失的配置:
Redis 提供了 min-replicas-to-write 和 min-replicas-max-lag 来实现类似半同步的效果:
min-replicas-to-write 1
min-replicas-max-lag 10
含义:至少要有 1 个从节点的延迟在 10 秒以内,主节点才接受写入。这不是真正的同步复制(主节点不等待从节点 ACK),而是通过拒绝写入来限制丢失窗口——如果从节点落后太多,主节点直接拒绝写入,迫使业务层感知并处理。
追问:如果业务要求绝对不丢数据,Redis 主从复制能满足吗?
不能。Redis 的主从复制是异步的,设计目标不是强一致性。如果需要绝对不丢数据,需要:
- 使用 Redis 的
WAIT命令,显式等待指定数量的从节点确认(但会增加延迟) - 业务层使用分布式事务或可靠消息机制
- 或者换用强一致性的存储系统(如 etcd、ZooKeeper)
Q3:一个从节点断线 2 分钟后重连,backlog 大小是 64MB,主节点写入速率是 50MB/s。这个从节点能走增量同步吗?如果不能,你会怎么调整?
参考答案:
计算:断线 2 分钟 = 120 秒,写入速率 50MB/s,断线期间累计写入量 = 120 × 50MB = 6GB。
Backlog 只有 64MB,远小于 6GB。从节点断线期间的写入数据早已被 backlog 的环形缓冲区覆盖,从节点的 offset 不在 backlog 的覆盖范围内,只能走全量同步。
调整方案:
- 直接方案:增大
repl-backlog-size。按公式写入速率 × 预期断线恢复时间计算,至少需要50MB × 120s = 6GB。但 6GB 的 backlog 会占用大量内存,需要权衡。 - 更实际的方案——分层治理:
- 降低断线概率:优化网络(主从部署在同一机房、使用高带宽低延迟网络)、监控连接状态。
- 缩短恢复时间:配置合理的
repl-timeout(不宜太小,否则正常抖动也会触发断线),配合监控告警,快速发现和处理断线。 - 控制写入速率上限:如果 50MB/s 是峰值,可以通过分片(Cluster)将写入分散到多个主节点,每个主节点的写入量降低,所需 backlog 也相应减小。
- 设置 backlog 上限的合理性:backlog 不是越大越好。如果断线时间超过 5 分钟,应从架构层面解决(如集群自动故障转移),而不是无限增大 backlog。通常建议 64MB~256MB,配合 Sentinel 或 Cluster 的自动故障转移机制来处理长时间断线的情况。
追问:如果这个从节点是全量同步失败后重试,而主节点内存 100GB,全量同步需要 5 分钟。在这 5 分钟内,backlog 需要多大才能保证重试后走增量同步?
5 分钟 × 50MB/s = 15GB。所以如果要保证全量同步失败后重试时走增量同步,backlog 需要 15GB——这显然不合理。更好的做法是:全量同步失败后,优先排查根因(网络、buffer 溢出、内存不足),修复后再重试,而不是靠增大 backlog 来兜底。
Q4:Sentinel 执行故障转移后,新主节点如何让旧主节点的其他从节点避免全量同步?请描述完整的流程和关键机制。
参考答案:
这是 Redis 4.0 引入的 PSYNC2 协议的核心能力。完整流程如下:
故障转移前:
- 主节点 M1 的 replid = AAA
- 从节点 S1、S2 正在复制 M1,各自持有 replid = AAA 和各自的 offset
故障转移:
- Sentinel 检测到 M1 下线,经过投票后将 S1 提升为新主节点 M2。
- S1 执行
SLAVEOF NO ONE,成为主节点。 - S1 生成新的 replid = BBB,但将旧的 replid = AAA 保存为
replid2。 - S1 的 backlog 中保留了旧 replid 下的数据(从旧 offset 开始)。
其他从节点重连:
- S2 重连到 M2(原来的 S1),发送
PSYNC AAA <S2的offset>。 - M2 发现 AAA 不等于自己的 replid(现在是 BBB),但匹配
replid2 = AAA。 - M2 检查 S2 的 offset 是否在 backlog 覆盖范围内。
- 如果在范围内 → 返回
CONTINUE,增量同步! - M2 把 backlog 中 S2 缺失的数据发送给 S2。
关键设计:
- replid2 机制:新主节点保留旧主节点的 replid,支持旧集群的从节点做增量同步。
- Backlog 的继承:新主节点被提升时,从它作为从节点时已有的 backlog 继续使用,不是重新创建。这意味着新主节点的 backlog 中包含了旧主节点复制过来的数据。
- 这个机制使得故障转移后,只有被提升为新主节点的那个从节点不需要同步,其他从节点大概率可以走增量同步。
追问:什么情况下故障转移后从节点仍然需要全量同步?
- 从节点的 offset 不在新主节点 backlog 覆盖范围内(断线时间太长或写入量太大)。
- 新主节点升级后重启过,backlog 被清空。
- 从节点之前复制的是另一个主节点(比如网络分区后误连到错误的主节点)。
Q5:Redis 7.0 引入了 Shared Replication Buffer。请解释传统方案的问题和 Shared Replication Buffer 的改进原理。
参考答案:
传统方案的问题:
在 Redis 7.0 之前,每个从节点在主节点侧都有一个独立的 output buffer。当主节点执行写命令时,命令数据会被复制到每个从节点的独立 buffer 中:
主节点写命令 → backlog(1 份)
              → Slave1 output buffer(1 份)
              → Slave2 output buffer(1 份)
              → Slave3 output buffer(1 份)
如果有 10 个从节点,主节点需要将同一份写命令数据复制 11 次(1 份 backlog + 10 份独立 buffer)。这导致:
- 内存浪费:10 个从节点各自维护一份相同的命令数据,内存消耗是 O(N)。
- CPU 开销:每条写命令需要向 N 个 buffer 拷贝数据,memcpy 开销大。
Shared Replication Buffer 的改进:
Redis 7.0 引入共享复制缓冲区,所有从节点共享同一份数据:
主节点写命令 → Shared Replication Buffer(1 份,引用计数)
               ├── Slave1 引用
               ├── Slave2 引用
               ├── Slave3 引用
               └── Backlog 引用
每个从节点只维护一个指向共享 buffer 中自己消费位置的指针。数据只存一份,通过引用计数管理生命周期——当所有从节点都消费了某段数据后,这段数据才会被释放。
带来的好处:
- 内存从 O(N) 降到 O(1),节省大量内存。
- 减少数据拷贝的 CPU 开销。
- 写入路径更短,复制吞吐量提升。
这个问题考察的是:候选人对 Redis 版本演进的关注,以及从工程角度理解"为什么这样设计"的能力。如果候选人能提到引用计数、消费位置指针、内存 O(N) vs O(1) 的分析,说明对系统设计有深入理解。
Q6:你负责设计一个 Redis 全量同步的监控和告警体系。你会监控哪些指标?告警阈值如何设定?
参考答案:
核心监控指标:
| 指标 | 来源 | 含义 | 告警阈值建议 |
|---|---|---|---|
| 复制延迟(字节) | INFO replication | master_repl_offset - slave_repl_offset | 大于 10MB 警告,大于 100MB 严重 |
| 心跳延迟(秒) | INFO replication 的 lag 字段 | 从节点心跳延迟 | 大于 5s 警告,大于 30s 严重 |
| 主从连接状态 | INFO replication 的 master_link_status | 主从连接是否正常 | down 立即告警 |
| 全量同步进行中 | INFO replication 的 master_sync_in_progress | 是否有全量同步正在进行 | 大于 0 且持续超过 5min 告警 |
| BGSAVE 进行中 | INFO persistence 的 rdb_bgsave_in_progress | 是否正在 BGSAVE | 频繁触发(1h 内超过 3 次)告警 |
| 拒绝的连接数 | INFO stats 的 rejected_connections | 拒绝的连接数 | 大于 0 告警 |
| 网络输出流量 | INFO stats 的 total_net_output_bytes | 网络输出流量 | 接近带宽上限告警 |
| 实际内存占用 | INFO memory 的 used_memory_rss | 实际内存占用 | 接近 maxmemory 告警 |
| fork 耗时 | INFO stats 的 latest_fork_usec | 最近 fork 耗时(微秒) | 大于 1s 警告,大于 5s 严重 |
告警设计原则:
- 分级告警:警告(Warning)→ 严重(Critical)→ 紧急(P0),不同级别通知不同渠道(企业微信/钉钉/电话/PagerDuty)。
- 收敛去噪:同一主节点的多个从节点同时告警应合并为一条。全量同步期间允许短暂延迟升高,不必立即告警。
- 趋势告警:不要只看瞬时值,还应监控复制延迟的增长率。如果复制延迟持续增长(如每 10 秒增加 5MB),说明从节点追不上主节点,即使当前延迟不大,也需要提前干预。
- 关联分析:复制延迟告警应关联主节点 CPU、网络流量、慢查询日志,帮助快速定位根因(是写入量过大还是从节点处理能力不足)。
追问:如果收到"复制延迟持续增长"的告警,你的排查思路是什么?
- 先看主节点:
INFO replication确认所有从节点延迟是否都在增长(如果是,说明主节点写入量过大)。 - 再看从节点:
INFO cpu确认从节点 CPU 是否打满(单线程执行命令,CPU 打满会导致命令处理变慢)。 - 检查网络:主从之间 ping 延迟、丢包率。
- 检查慢命令:
SLOWLOG GET 10看是否有慢命令导致从节点处理阻塞。 - 根据根因决定:扩容从节点?分片主节点?优化慢命令?升级网络?