一、问题定义:消息为什么会重复?
在分布式消息系统中,消息重复是一个无法回避的问题。无论你使用 Kafka、RocketMQ 还是 RabbitMQ,消息中间件本身提供的"可靠性"保证都建立在"至少一次"(at-least-once)语义之上——这意味着在特定故障场景下,同一条消息可能被消费多次。
造成重复消费的典型场景包括:
1. 生产者侧重复发送
当生产者发送消息后,在等待 Broker 确认(ACK)时网络超时,生产者无法判断消息是否已被持久化。按照"重试"策略,生产者会再次发送同一条消息。RocketMQ 和 Kafka 虽然提供了幂等生产机制,但需要显式开启,且仅覆盖生产者到 Broker 这一段。
2. 消费者侧重复消费(最核心场景)
消费者从 Broker 拉取消息、处理业务逻辑、提交 Offset 这三个步骤不是原子的。考虑以下流程:
- 消费者拉取消息并开始处理业务逻辑(如扣减库存)
- 业务处理成功,但在提交 Offset 之前,消费者进程崩溃或发生 Rebalance
- 分区被重新分配给另一个消费者,该消费者从上次提交的 Offset 开始拉取
- 刚刚处理成功的那条消息被再次拉取并处理 → 库存被扣减两次
Kafka 的 Rebalance 和 RocketMQ 的集群消费模式都存在这个问题。即使你调小 auto.commit.interval.ms,也无法完全消除这个窗口。
3. 客户端超时重试
在 RPC 调用链路中,调用方因超时发起重试,但被调用方实际已经处理了请求。如果下游操作包含消息消费,这条消息的业务逻辑会被执行两次。
4. Broker 故障转移
在 RocketMQ 主从切换或 Kafka Leader 选举时,已同步到 Follower 但尚未被消费者确认的消息可能被重复投递。
核心结论:消息重复是分布式系统的固有属性,不是 bug。 与其试图在消息中间件层面彻底消除重复(技术上接近不可能),不如在业务层面实现幂等消费——即同一条消息无论被消费多少次,产生的业务效果与消费一次完全相同。

二、幂等性的数学定义与工程理解
"幂等"(Idempotent)源于数学:一个操作 $f$ 满足 $f(f(x)) = f(x)$ ,即多次执行与一次执行结果相同。
在分布式系统中,我们将幂等扩展为:
同一个操作请求(由唯一标识符标记)被执行多次,其产生的副作用(状态变更)与执行一次完全一致。
这里有几个关键约束:
- 幂等不等于不产生任何副作用。幂等的插入操作第一次插入成功,第二次返回"已存在"但不报错——这仍然改变了系统响应,但业务状态是一致的。
- 幂等需要"请求标识"。没有标识就无法区分"这是同一条消息的重复投递"还是"用户真的发起了两次相同操作"。
- 幂等是业务层的责任。消息中间件保证 at-least-once 语义,业务层负责将 at-least-once 转化为 exactly-once 效果。
三、四种核心幂等方案
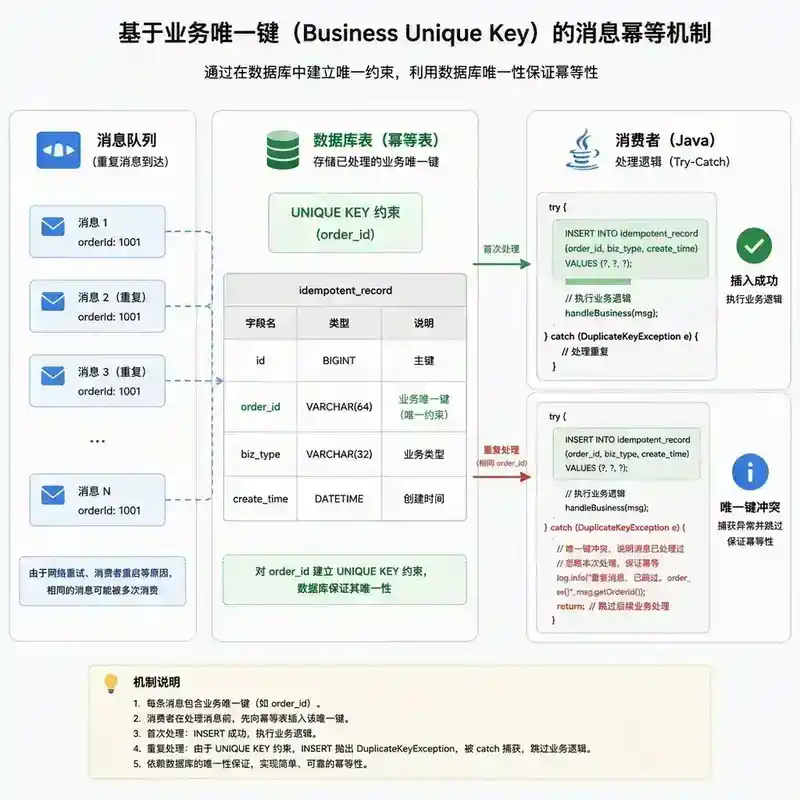
方案一:业务唯一键(Business Unique Key)
原理:利用数据库的唯一约束(UNIQUE KEY),让重复数据"写不进去"。
实现方式:
-- 订单表:order_id 作为业务唯一键
CREATE TABLE orders (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    order_id VARCHAR(64) NOT NULL,
    user_id BIGINT NOT NULL,
    amount DECIMAL(10,2) NOT NULL,
    status VARCHAR(20) NOT NULL DEFAULT 'CREATED',
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    UNIQUE KEY uk_order_id (order_id)
);
消费消息时,直接 INSERT,捕获 DuplicateKeyException:
@KafkaListener(topics = "order-topic")
public void onMessage(OrderMessage msg) {
    try {
        orderMapper.insert(new Order()
            .setOrderId(msg.getOrderId())
            .setUserId(msg.getUserId())
            .setAmount(msg.getAmount())
        );
    } catch (DuplicateKeyException e) {
        log.warn("重复消息,orderId={} 已存在,跳过", msg.getOrderId());
        // 不抛异常,确保 Offset 正常提交
    }
}
适用场景:
- 消息体本身包含天然的业务唯一标识(订单号、交易流水号、请求 ID)
- 业务操作是"创建"类(INSERT)而非"更新"类(UPDATE)
局限性:
- 如果业务操作是 UPDATE(如"给账户加 100 元"),唯一约束无法阻止重复执行
- 需要业务表本身设计了唯一键,对存量系统有改造侵入性
- 依赖数据库,纯缓存/NoSQL 场景需要额外机制
生产要点:
- 唯一键的设计要足够细粒度。例如"用户每日签到",唯一键应为
(user_id, sign_date)而非仅user_id - 捕获异常后必须正常返回(不抛异常),否则消息会一直重试
- 对于分库分表场景,唯一键必须包含分片键或使用全局唯一索引服务
方案二:去重表(Deduplication Table)
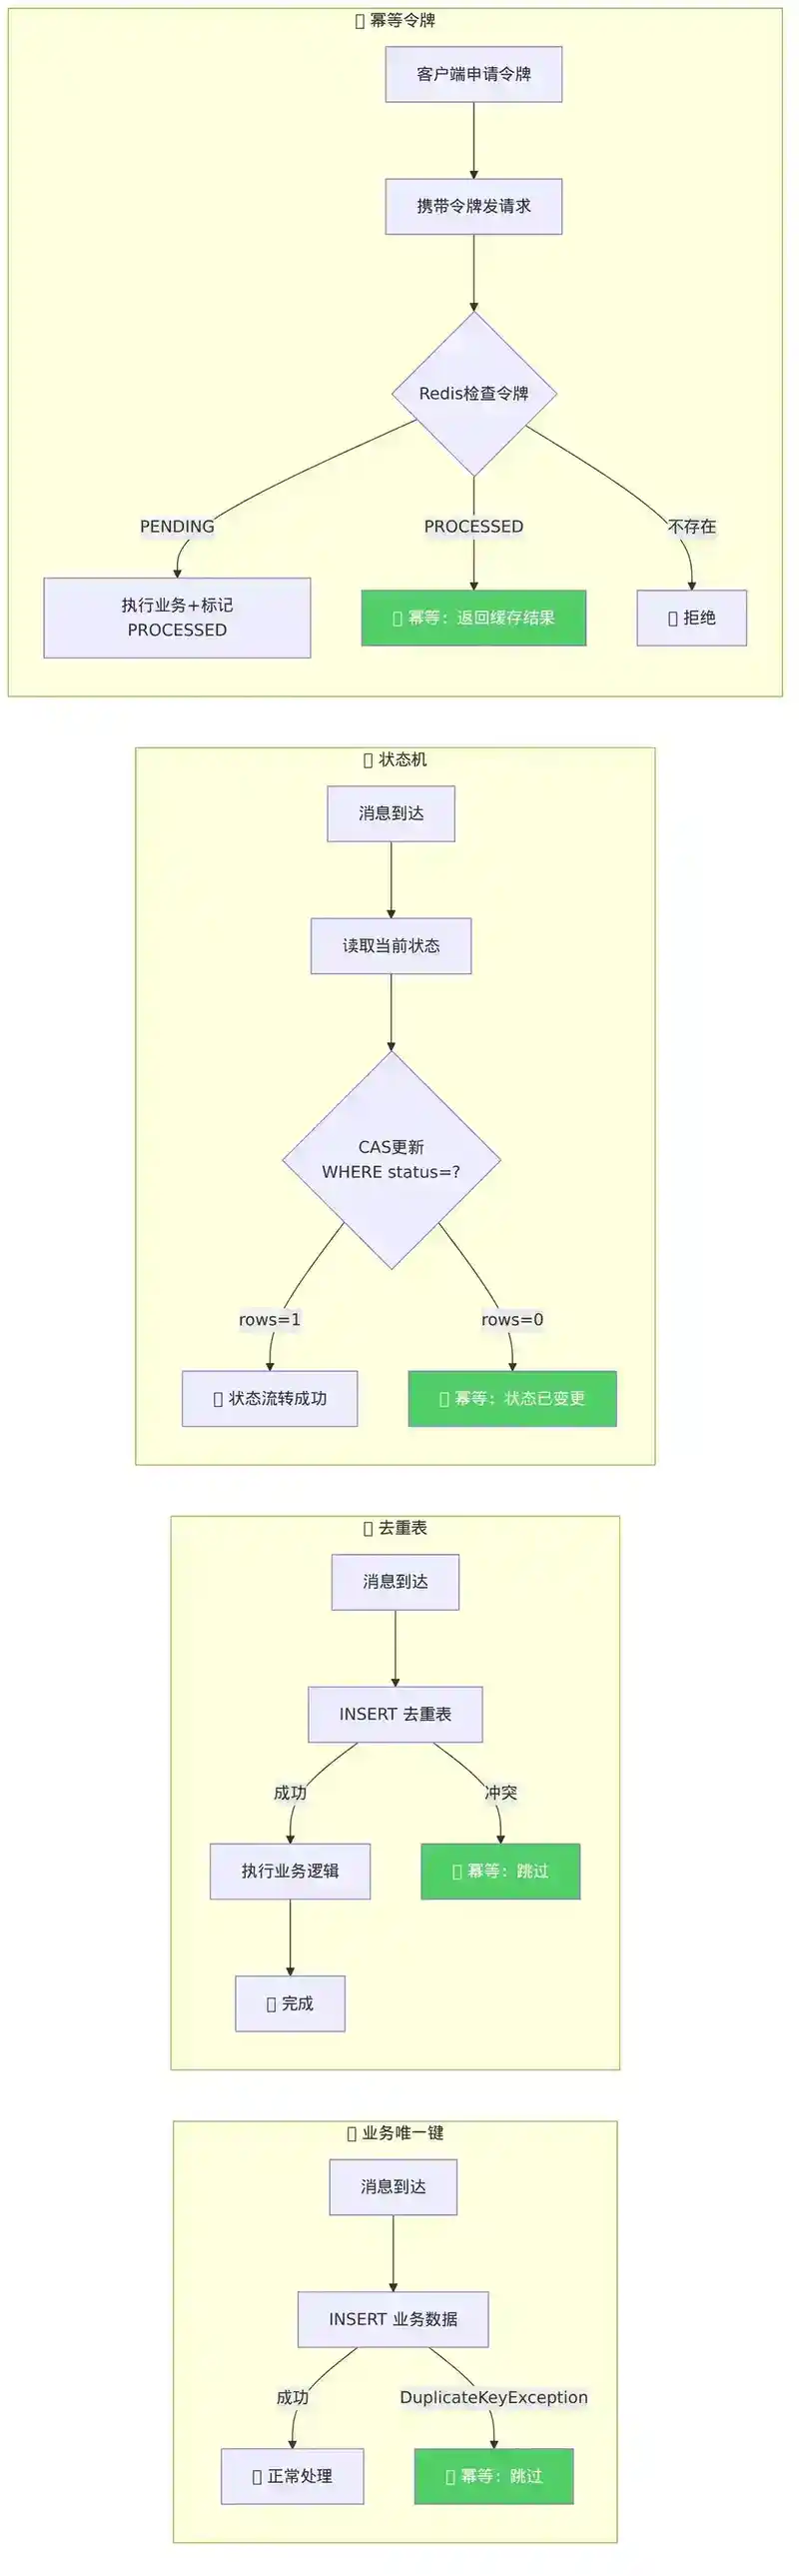
原理:引入一张独立的"消息消费记录表",在业务操作前先检查该消息是否已被处理。
实现方式:
CREATE TABLE message_consume_log (
    msg_id VARCHAR(128) NOT NULL,
    topic VARCHAR(64) NOT NULL,
    consumer_group VARCHAR(64) NOT NULL,
    consume_time DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (msg_id, consumer_group)
);
消费逻辑:
@Transactional
public void consumeWithDedup(String msgId, Consumer<Message> businessLogic) {
    // Step 1: 尝试插入消费记录(利用主键冲突做幂等判断)
    try {
        consumeLogMapper.insert(new ConsumeLog(msgId, consumerGroup));
    } catch (DuplicateKeyException e) {
        log.info("消息 {} 已消费,跳过", msgId);
        return;
    }

    // Step 2: 执行业务逻辑
    businessLogic.accept(message);
}
关键设计决策:
- 去重表与业务表放在同一个数据库:利用本地事务保证"插入消费记录"和"执行业务逻辑"的原子性。如果二者分离,就需要引入分布式事务,复杂度陡增。
- msgId 的来源:优先使用消息中间件提供的消息 ID(如 Kafka 的
topic-partition-offset组合、RocketMQ 的msgId),但要注意:Producer 重试发送时,同一条业务消息可能对应不同的中间件 ID。因此更可靠的做法是业务方在消息体中携带业务唯一标识(如bizId),用bizId作为去重键。 - 定期清理:去重表会持续增长,需要按时间分区并定期清理过期记录。清理策略取决于业务对"重复"的容忍窗口——例如认为 7 天前的消息不可能再重复,则可以清理 7 天前的记录。
-- 按日期分区,方便清理
ALTER TABLE message_consume_log
PARTITION BY RANGE (TO_DAYS(consume_time)) (
    PARTITION p20240901 VALUES LESS THAN (TO_DAYS('2024-09-02')),
    PARTITION p20240902 VALUES LESS THAN (TO_DAYS('2024-09-03'))
    -- ...
);
适用场景:
- 消息体没有天然的业务唯一键
- 业务操作是"更新"类(如余额变动、状态变更),无法用唯一约束
- 消费逻辑涉及多个表的写操作,需要一个"总开关"来保证幂等
局限性:
- 多了一次数据库写入,有性能开销
- 去重表的维护成本(清理、分区管理)
- 去重表本身也可能成为瓶颈(单表过大)
方案三:状态机(State Machine)
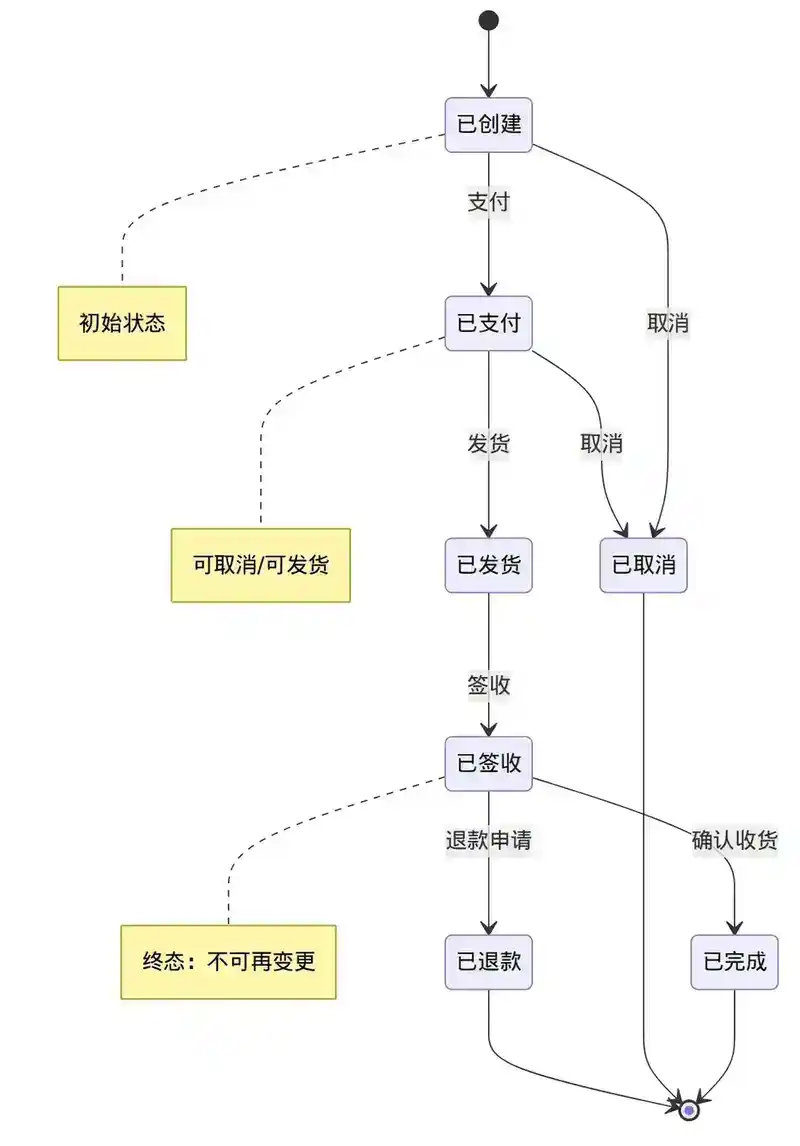
原理:将业务对象的状态流转建模为有限状态机,每个状态只能接受特定的转换。重复的消息由于状态已经变更,再次触发相同的状态转换会被拒绝。
实现方式:
以订单状态机为例:
                    ┌─→ 已取消
                    │
已创建 → 已支付 → 已发货 → 已签收 → 已完成
                    │
                    └─→ 已退款
状态转换规则:
public enum OrderStatus {
    CREATED,    // 已创建
    PAID,       // 已支付
    SHIPPED,    // 已发货
    DELIVERED,  // 已签收
    COMPLETED,  // 已完成
    CANCELLED,  // 已取消
    REFUNDED    // 已退款
}

public enum OrderEvent {
    PAY, SHIP, DELIVER, COMPLETE, CANCEL, REFUND
}

// 状态转换表
private static final Map<OrderStatus, Map<OrderEvent, OrderStatus>> TRANSITIONS = Map.of(
    CREATED, Map.of(PAY, PAID, CANCEL, CANCELLED),
    PAID,    Map.of(SHIP, SHIPPED, CANCEL, CANCELLED),
    SHIPPED, Map.of(DELIVER, DELIVERED),
    DELIVERED, Map.of(COMPLETE, COMPLETED, REFUND, REFUNDED)
);
消费时使用 CAS 更新:
public void handleEvent(String orderId, OrderEvent event) {
    OrderStatus currentStatus = orderMapper.selectStatus(orderId);
    OrderStatus targetStatus = TRANSITIONS
        .getOrDefault(currentStatus, Map.of())
        .get(event);

    if (targetStatus == null) {
        log.warn("非法状态转换: orderId={}, current={}, event={}",
                 orderId, currentStatus, event);
        return; // 幂等——重复消息触发相同转换,被拒绝
    }

    // CAS 更新:WHERE status = currentStatus
    int rows = orderMapper.updateStatus(orderId, currentStatus, targetStatus);
    if (rows == 0) {
        // 并发更新冲突或状态已变更,视为幂等
        log.warn("状态更新冲突,可能已被处理: orderId={}", orderId);
        return;
    }

    // 发布领域事件
    eventPublisher.publish(new OrderStatusChanged(orderId, currentStatus, targetStatus));
}
SQL 层面的 CAS 保证:
UPDATE orders
SET status = #{targetStatus}, updated_at = NOW()
WHERE order_id = #{orderId}
  AND status = #{currentStatus}
WHERE status = currentStatus 是关键——它保证了只有在状态"未变化"时才会执行更新。如果消息重复消费,currentStatus 已经不再是 CREATED,rows 为 0,更新被跳过。
适用场景:
- 业务对象有明确的状态流转(订单、审批流、工单、支付流水)
- 状态转换具有方向性,不可逆或可逆路径有限
- 需要较强的业务语义表达(状态本身就是业务语言)
局限性:
- 需要业务对象具备状态模型,对 CRUD 型业务不适用
- 状态机复杂时维护成本高
- 并发场景下 CAS 更新可能失败,需要配合重试或乐观锁
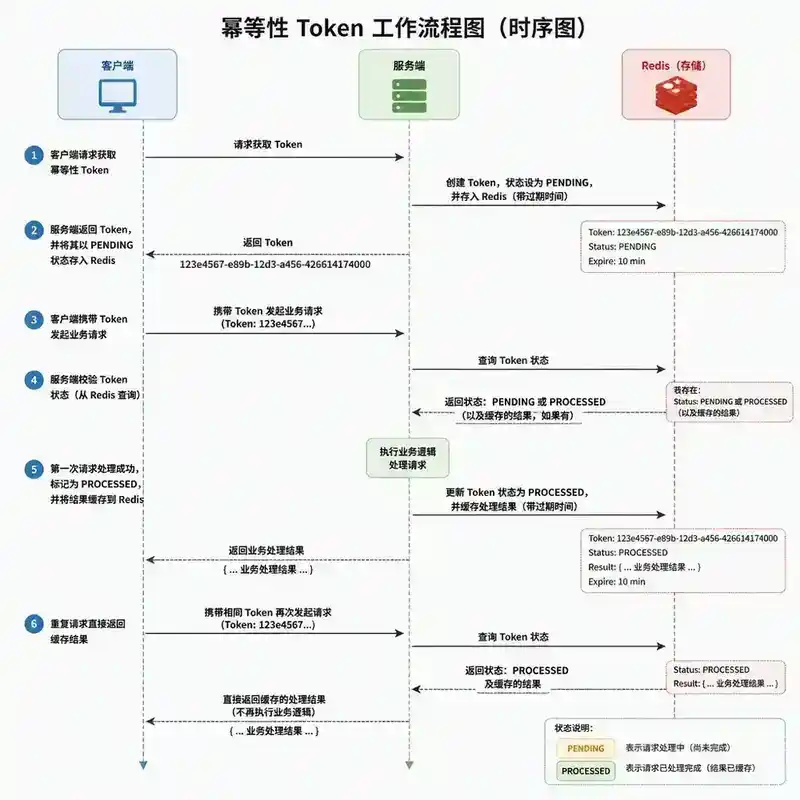
方案四:幂等令牌(Idempotency Token)
原理:客户端在发起请求前先向服务端申请一个全局唯一的"幂等令牌"(Token),服务端以该令牌为键记录请求处理结果。重复请求携带相同令牌,服务端直接返回首次处理的结果。
实现方式:
// 第一步:客户端申请幂等令牌
@PostMapping("/api/idempotency-token")
public Result<String> createToken() {
    String token = UUID.randomUUID().toString();
    redisTemplate.opsForValue().set(
        "idempotency:" + token,
        "PENDING",
        Duration.ofMinutes(30)
    );
    return Result.success(token);
}

// 第二步:客户端携带令牌执行业务操作
@PostMapping("/api/orders")
public Result<Order> createOrder(
        @RequestHeader("Idempotency-Key") String token,
        @RequestBody CreateOrderRequest request) {

    // 检查令牌状态
    String status = redisTemplate.opsForValue()
        .get("idempotency:" + token);

    if (status == null) {
        throw new BizException("幂等令牌不存在或已过期");
    }

    if ("PROCESSED".equals(status)) {
        // 返回缓存的首次处理结果
        String cachedResult = redisTemplate.opsForValue()
            .get("idempotency:result:" + token);
        return JSON.parseObject(cachedResult, Result.class);
    }

    // 原子性标记为处理中
    Boolean setSuccess = redisTemplate.opsForValue()
        .setIfAbsent("idempotency:processing:" + token, "1",
                     Duration.ofSeconds(10));
    if (!setSuccess) {
        throw new BizException("请求正在处理中,请勿重复提交");
    }

    try {
        // 执行业务逻辑
        Order order = orderService.create(request);

        // 标记处理完成,缓存结果
        redisTemplate.opsForValue().set(
            "idempotency:" + token, "PROCESSED", Duration.ofHours(1));
        redisTemplate.opsForValue().set(
            "idempotency:result:" + token, JSON.toJSONString(order),
            Duration.ofHours(1));

        return Result.success(order);
    } catch (Exception e) {
        // 处理失败,释放令牌(允许客户端重试)
        redisTemplate.delete("idempotency:" + token);
        throw e;
    } finally {
        redisTemplate.delete("idempotency:processing:" + token);
    }
}
适用场景:
- 面向外部 API 的幂等保障(支付、转账等金融操作)
- 客户端可以配合实现"请求-重试"模式
- 需要缓存处理结果供重复请求返回
局限性:
- 需要客户端配合(先申请令牌再发请求),对消息消费场景不友好
- 令牌有过期时间,过期后的重复请求无法识别
- 依赖 Redis 的可用性,Redis 故障时需要降级方案
四、方案对比与选型决策
| 维度 | 业务唯一键 | 去重表 | 状态机 | 幂等令牌 |
|---|---|---|---|---|
| 实现复杂度 | 低 | 中 | 中高 | 中 |
| 性能开销 | 极小(依赖唯一索引) | 一次额外写入 | 一次 CAS 更新 | 额外 Redis 往返 |
| 侵入性 | 需要业务表有唯一键 | 引入去重表 | 需要状态模型 | 需要客户端配合 |
| 适用操作类型 | INSERT | INSERT/UPDATE | UPDATE(有状态流转) | INSERT/UPDATE |
| 去重窗口 | 永久(数据库约束) | 可配置(清理策略) | 永久(状态不可逆) | 令牌有效期 |
| 并发安全 | 数据库锁 | 数据库锁 + 事务 | CAS 乐观锁 | Redis setIfAbsent |
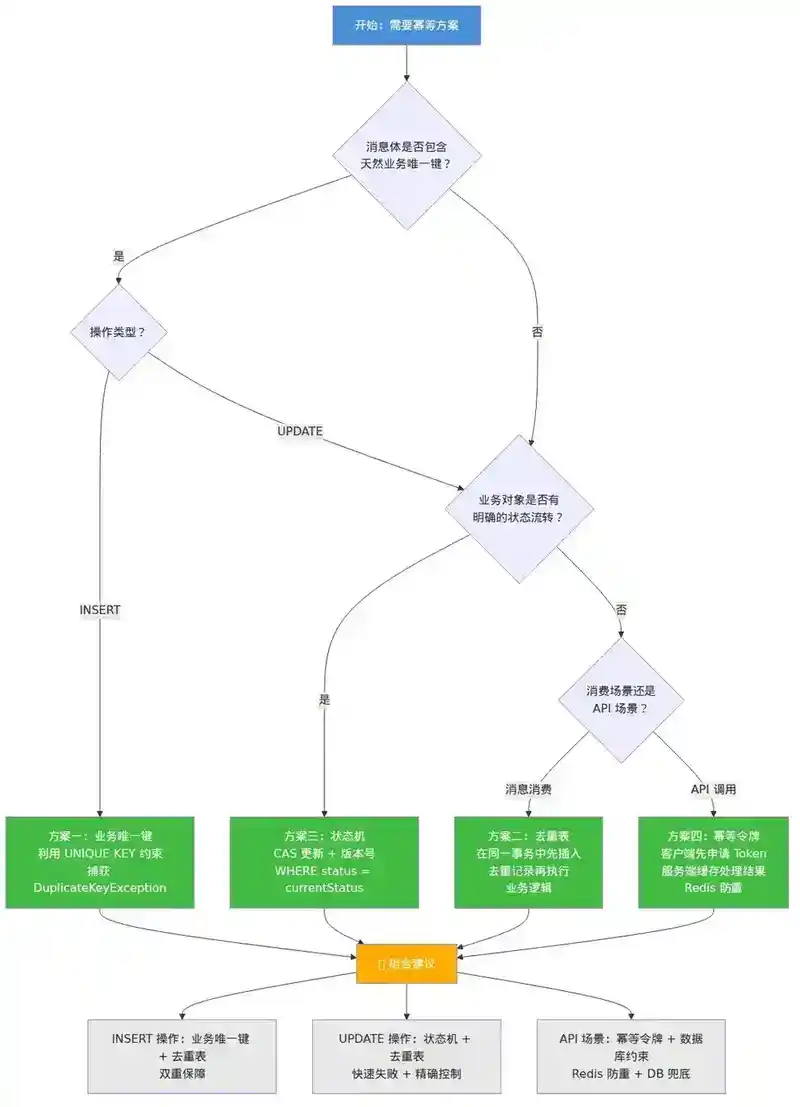
组合使用建议:
在实际生产系统中,很少有"一招鲜"的方案。常见组合:
- 业务唯一键 + 去重表:对于 INSERT 操作使用唯一键约束,对于 UPDATE 操作使用去重表。二者共用一个
bizId作为去重键。 - 状态机 + 去重表:状态机保证业务语义的正确性,去重表作为"快速失败"的第一道防线(避免无效的 CAS 操作打满数据库)。
- 幂等令牌 + 业务唯一键:幂等令牌用于 API 层的防重提交,业务唯一键作为数据库层的最后兜底。即使令牌过期或 Redis 故障,数据库约束依然能保证数据一致性。
五、生产实践与常见陷阱
陷阱 1:去重检查与业务操作不在同一事务
// 错误写法
@Transactional  // 事务 A
public void checkDedup(String msgId) {
    consumeLogMapper.insert(new ConsumeLog(msgId)); // 去重表插入
}

@Transactional  // 事务 B(不同事务!)
public void doBusiness(Message msg) {
    orderMapper.insert(order); // 业务操作
}
如果去重表插入成功,但业务操作失败,消息会被重新投递。此时去重表中已有记录,消息被当作"已处理"而跳过,导致业务操作永远丢失。
正确做法:将去重检查和业务操作放在同一个本地事务中:
@Transactional
public void consume(String msgId, Message msg) {
    consumeLogMapper.insert(new ConsumeLog(msgId)); // Step 1
    orderService.createOrder(msg);                   // Step 2
    // Step 1 和 Step 2 原子:要么都成功,要么都失败
}
陷阱 2:msgId 的唯一性边界
Kafka 的消息唯一标识是 topic-partition-offset,RocketMQ 是 msgId。但要注意:
- Kafka 的
offset在日志压缩(log compaction)或删除后可能被重用(虽然概率极低,但理论上存在) - Producer 重试会产生不同的
msgId,但业务语义上是同一条消息 - 跨集群数据同步(如 MirrorMaker)会改变 offset
最佳实践:在消息体中携带业务方生成的唯一标识(bizId),以 bizId 作为去重键,而非依赖中间件的消息 ID。
陷阱 3:去重表成为性能瓶颈
去重表的主键是 msg_id,随着消息量增长,B+Tree 索引的写入性能会下降。解决方案:
- 按时间分区:每天一个分区,定期清理历史分区
- 使用布隆过滤器前置过滤:在去重表查询前,先用布隆过滤器快速判断 msgId 是否"可能存在",过滤掉大部分新消息,减少去重表的查询压力
- 分库分表:按 msgId 哈希分片,将写入压力分散到多个实例
陷阱 4:状态机 CAS 的 ABA 问题
状态流转:A → B → A

时间线:
T1: 消费者1 读取状态 = A,准备更新到 B
T2: 消费者2 读取状态 = A,更新到 B(成功)
T3: 消费者3 读取状态 = B,更新回 A(成功)
T4: 消费者1 执行 UPDATE ... WHERE status = 'A'(成功!但此时状态已经历了 A→B→A)
解决方案:引入版本号(乐观锁):
UPDATE orders
SET status = #{targetStatus}, version = version + 1
WHERE order_id = #{orderId}
  AND status = #{currentStatus}
  AND version = #{currentVersion}
陷阱 5:忽略了"消费失败"与"重复消费"的边界
不是所有"重复消费"都应该被忽略。考虑以下场景:
- 消息 M1 到达,开始处理,但处理失败(如调用下游超时)
- 消息 M1 被重新投递,再次处理,这次成功
此时去重表中不应有 M1 的记录(因为首次处理失败了),否则 M1 将永远无法被正确处理。
正确做法:去重表的插入应放在业务逻辑成功之后(而非之前),或者使用"处理中"状态标记:
@Transactional
public void consume(String msgId, Message msg) {
    // Step 1: 插入"处理中"状态
    consumeLogMapper.insert(new ConsumeLog(msgId, "PROCESSING"));

    try {
        // Step 2: 执行业务逻辑
        businessLogic.accept(msg);
        // Step 3: 更新为"已处理"
        consumeLogMapper.updateStatus(msgId, "PROCESSED");
    } catch (Exception e) {
        // Step 4: 删除"处理中"记录,允许重试
        consumeLogMapper.delete(msgId);
        throw e;
    }
}
六、Kafka & RocketMQ 的幂等机制
Kafka 幂等生产
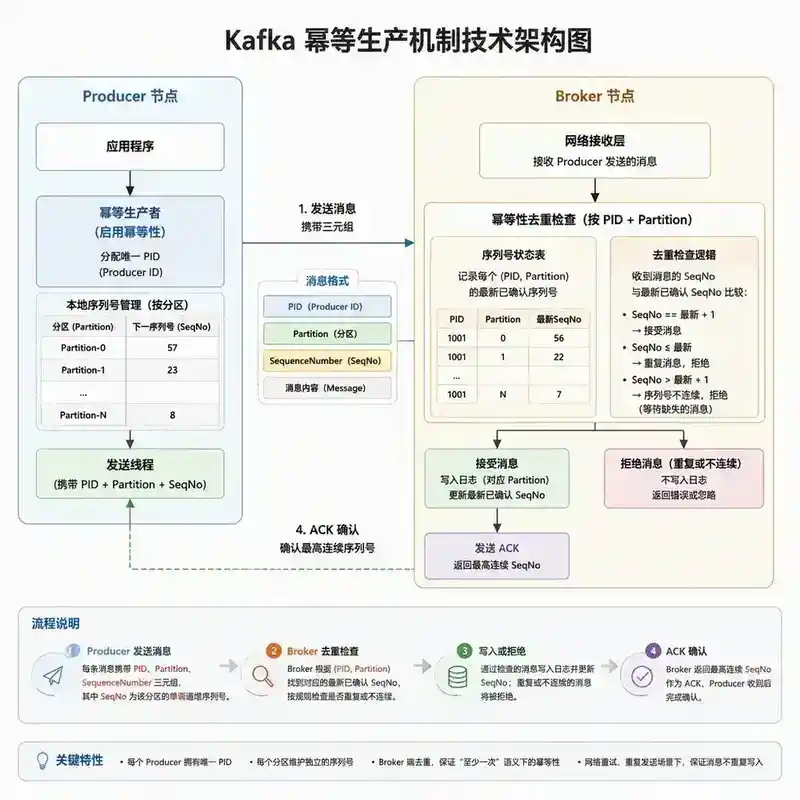
Kafka 从 0.11 版本开始支持幂等生产(enable.idempotence=true):
- Producer 被分配一个 PID(Producer ID)
- 每条消息携带
<PID, Partition, SequenceNumber> - Broker 按 SequenceNumber 去重,拒绝重复序列号的消息
局限性:仅保证单个分区内的幂等,且 PID 在 Producer 重启后会变化。跨分区、跨会话的幂等需要事务(transactional.id)。
RocketMQ 幂等消费
RocketMQ 在消费端没有内置的幂等机制。但 RocketMQ 的消息模型中,每条消息有一个全局唯一的 msgId,可以作为去重键的候选。对于事务消息,RocketMQ 保证了生产者到 Broker 的不丢失不重复,但消费端仍需业务方自行实现幂等。
七、总结
消息幂等是分布式系统的"必答题",不是"加分项"。四种核心方案的记忆口诀:
- 业务唯一键:让数据库替你挡枪(最省事,但只适用于 INSERT)
- 去重表:自己记一笔账(最通用,但多一次写入)
- 状态机:让状态流转替你判断(最优雅,但需要状态模型)
- 幂等令牌:先取号再办事(最适合 API 场景)
选择方案时,优先考虑"业务自然幂等"——如果你的业务操作本身天然具有幂等性(如"设置用户昵称为 XXX"),那就不需要任何额外机制。如果不能,则根据操作类型和数据一致性要求组合使用上述方案。
最后,记住分布式系统的铁律:消息中间件保证 at-least-once 投递,业务层负责 exactly-once 效果。
面试官提问
Q1:你说业务唯一键是最简单的方案,那如果业务操作是"给用户余额加 100 元"这种 UPDATE 操作,唯一键能解决幂等吗?如果不能,你会怎么设计?
不能。唯一键(UNIQUE KEY)只能阻止重复 INSERT,对于 UPDATE balance = balance + 100 这种累加操作,每次执行都会改变结果,唯一约束无济于事。
对于这种场景,我会组合使用去重表 + 业务流水。核心思路是:把"余额变更"从"无状态增量操作"改造为"有状态变更记录"——
- 消息体中携带
bizId(如转账流水号)和变更金额 - 消费时先在去重表中写入
bizId(利用唯一约束防重) - 在同一个事务中,插入一条
account_change_log记录(流水表),同时更新余额 - 如果去重表写入失败(DuplicateKeyException),说明已处理过,直接返回
这样就把不可逆的 UPDATE 变成了可追溯的 INSERT + CAS 模式。余额本身可以通过 SUM(account_change_log) 来推导,这也是事件溯源的思想。
Q2:如果去重表的数据量达到了 10 亿级别,msgId 的 B+Tree 索引写入性能严重下降,你会从哪些维度优化?
这是一个典型的"大表去重"问题,我会从四个维度入手:
维度一:分库分表。 按 msgId 哈希取模分散到 16 或 32 个分表,将单点写入压力均摊。需要注意:去重键的哈希分片必须与业务表的分片策略独立——去重表的分片只是为了分散写入压力,不应与业务耦合。
维度二:时间分区 + 定期清理。 按月或按天对去重表做 RANGE 分区,定期 DROP 过期分区。去重窗口通常只需要保留 7-30 天(超过这个时间窗口的消息重复概率极低),清理策略可以大幅控制表体积。
维度三:布隆过滤器前置。 在查询去重表之前,先用 Redis 布隆过滤器做一次快速判断。布隆过滤器返回"不存在"时,可以确定是新消息,直接跳过去重表查询;返回"可能存在"时,再查去重表确认。这可以将去重表的查询量降低 90% 以上。但要注意布隆过滤器不能替代去重表——它只能做"不存在"的判定,且存在误判率。
维度四:异步 + 批量写入。 如果业务容忍极短时间窗口内的重复(如 100ms 内),可以引入本地缓存(如 Caffeine)做一级去重,异步批量写入去重表。但这对一致性的要求更高,需要仔细评估业务容忍度。
Q3:你在方案中提到了 CAS 更新(**WHERE status = currentStatus**),在高并发场景下,如果多个消费者同时处理同一条消息的不同事件(如订单同时收到"支付"和"取消"),CAS 能否保证正确性?会有什么问题?
CAS 能保证"不会同时发生两个矛盾的状态转换",但不能保证"正确的那个事件被处理"。具体来说:
假设订单当前状态为 CREATED,两个消费者同时收到 PAY 和 CANCEL 事件:
- 消费者 A:
UPDATE ... SET status='PAID' WHERE status='CREATED'→ 成功(1 row affected) - 消费者 B:
UPDATE ... SET status='CANCELLED' WHERE status='CREATED'→ 失败(0 rows affected,因为状态已被 A 改为 PAID)
CAS 确保了只有一个成功,但问题在于——到底谁应该成功? 这取决于业务语义。如果"支付"和"取消"具有同等优先级,CAS 的"先到先得"可能不是正确行为。
解决方案:
- 引入事件时间戳:在消息体中携带事件发生时间,CAS 不仅比较状态,还比较时间戳,确保"先发生的事件先处理"
- 事件排序:如果使用 Kafka,将同一业务对象的事件路由到同一个 Partition,利用分区有序性保证事件按顺序处理
- 业务补偿:即使 CAS 导致"取消"被拒绝,业务层可以通过补偿机制(退款)来处理已支付订单的取消请求
Q4:你提到了"幂等令牌需要客户端配合,对消息消费场景不友好"。如果我要在消息消费场景中实现类似幂等令牌的效果——即"消费失败后能安全重试,且不重复执行业务逻辑"——你会怎么设计?
核心思路是在消息消费端实现"本地幂等令牌",不需要客户端参与:
- 消息体携带幂等键:生产者发送消息时,在消息体中携带一个全局唯一的
idempotencyKey(如UUID或业务流水号) - 消费端三段式处理:
- Phase 1 - 预占:
INSERT INTO consume_log (msg_key, status) VALUES (?, 'PROCESSING')。利用唯一约束,如果已存在则判断状态:PROCESSED 则跳过,PROCESSING 则等待或超时接管 - Phase 2 - 执行:执行业务逻辑,所有操作在同一本地事务中
- Phase 3 - 确认:
UPDATE consume_log SET status = 'PROCESSED' WHERE msg_key = ?
- Phase 1 - 预占:
- 异常处理:
- 如果 Phase 2 失败,事务回滚,consume_log 中也回滚了"预占"记录(因为 Phase 1 和 Phase 2 在同一事务中),消息可以安全重试
- 如果 Phase 2 成功但 Phase 3 前崩溃,下次重试时发现状态为 PROCESSING,通过超时机制(如 5 分钟)判断是否需要"接管"处理
这本质上就是"去重表 + 状态机"的组合模式,不过将去重检查提前到了业务逻辑之前,避免了"消费失败但去重表已记录"的陷阱。
Q5:假设你在设计一个跨国的支付系统,消息队列部署在中国的数据中心,但消费者部署在全球多个 Region。网络延迟可能导致消息重复投递的概率显著增加。在这种情况下,你会如何设计幂等方案?有哪些特殊的考量?
跨国场景下的幂等设计有几个特殊挑战:
1. 去重表的部署位置:去重表必须与业务数据库部署在同一 Region,利用本地事务保证原子性。不能跨 Region 查去重表——跨 Region 的数据库延迟通常在 100-300ms,会严重影响吞吐。如果业务数据本身是多 Region 分片的(如用户按 Region 路由),去重表也应随业务数据一起分片。
2. 全局唯一 ID 的生成:跨 Region 场景下,Snowflake 等依赖机器时钟的 ID 生成方案有风险(时钟漂移)。建议使用"Region 前缀 + 本地单调序列"的组合键,或者依赖数据库的 AUTO_INCREMENT(在单 Region 内)。
3. 去重窗口的扩大:跨国网络的不稳定性意味着消息可能延迟数分钟甚至数小时。去重窗口需要从常规的"几小时"扩大到"数天",同时去重表的存储成本会显著增加。可以考虑使用分层去重:热数据(最近 24 小时)用 Redis,温数据(24h-7d)用数据库,冷数据(7d+)用布隆过滤器。
4. 最终一致性 vs 强一致性:跨国场景天然适合最终一致性。如果支付系统要求强一致(如余额扣减),建议将"核心数据"集中在一个 Region 处理(如账户余额在单一 Region 维护),其他 Region 只做只读或异步操作。这样可以避免跨 Region 的分布式事务,幂等逻辑也简化了。
5. 监控与告警:跨国场景下,需要特别关注"重复消费率"指标,按 Region 和 Topic 维度监控。如果某个 Region 的重复消费率异常升高,可能是网络问题导致的频繁重试,需要及时排查。
延伸思考:以上五个问题覆盖了幂等设计的核心难点——从"不同操作类型的适配"到"大规模数据下的性能优化",再到"并发冲突"和"跨国部署"。如果你能深入回答这些问题,说明你对幂等性的理解已经超越了"会用"的层面,进入了"能设计"和"能权衡"的架构师层次。