阅读时间:约 40-50 分钟 难度:进阶 适用方向:分布式消息系统设计、面试准备
一、问题起源:为什么消息需要有序?
1.1 一个真实的订单场景
假设你正在开发一个电商系统,订单状态流转如下:
创建订单 → 支付 → 出库 → 发货 → 签收
这些状态变更事件通过消息队列异步通知下游系统(库存、物流、通知)。如果消息乱序到达,可能出现:
- 支付事件先于创建事件到达:库存系统收到一条"支付"消息,但数据库中根本没有这个订单。
- 发货事件先于支付事件到达:物流系统尝试发货,但订单还未付款。
这不仅仅是"代码报错"的问题——它直接导致业务数据不一致。
1.2 顺序性的三个层次
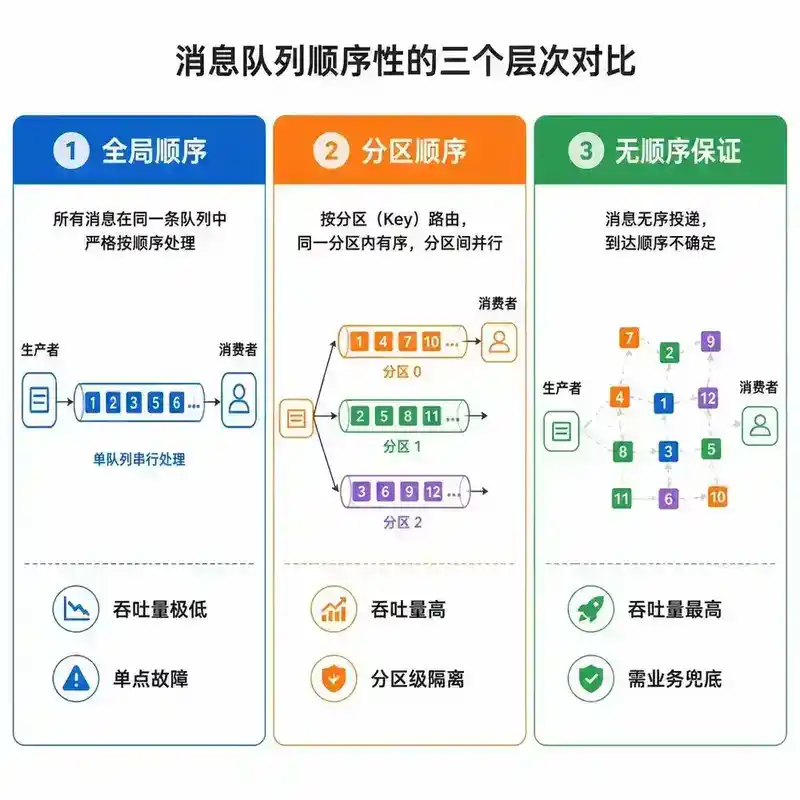
消息顺序性不是二元的"有序/无序"选择题,而是三个递进的层次:
| 层次 | 定义 | 代价 | 适用场景 |
|---|---|---|---|
| 全局顺序 | 整个 Topic/Queue 内所有消息严格有序 | 吞吐量极低,单线程消费 | 数据库 binlog 同步、全局自增 ID 生成 |
| 分区顺序 | 同一分区(Partition/Queue)内有序,分区间无序 | 吞吐量 = 分区数 × 单分区吞吐 | 订单状态流转、用户会话事件 |
| 无顺序保证 | 完全无序,依赖业务层幂等和版本号 | 吞吐量最高 | 日志采集、埋点上报、监控指标 |
大多数业务场景只需要分区顺序。全局顺序是一个"看起来很美,用起来很痛"的选择。
二、全局顺序:原理与代价
2.1 全局顺序的实现原理
全局顺序的本质是将所有消息串行化:
生产者 → [单一分区/队列] → 单一消费者
在 Kafka 中,这意味着 Topic 只有一个 Partition。在 RocketMQ 中,这意味着只有一个 MessageQueue。在 RabbitMQ 中,这意味着只有一个 Queue 绑定一个 Consumer。
为什么必须单分区? 因为多分区(或多队列)意味着消息被分散到多个物理存储单元,每个单元独立维护自己的偏移量(offset)。消费者从不同分区拉取消息时,网络延迟、处理速度差异都会导致跨分区的消息乱序。
2.2 Kafka 如何保证全局顺序
Kafka 的设计哲学很明确:全局顺序不是目标,分区顺序才是。
// Kafka 中创建全局有序 Topic 的唯一方式
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");

// 使用 AdminClient 创建只有一个分区的 Topic
AdminClient admin = AdminClient.create(props);
NewTopic topic = new NewTopic("order-global", 1, (short) 3);
admin.createTopics(Collections.singleton(topic));

// 生产者:所有消息发送到 Partition 0
ProducerRecord<String, String> record = new ProducerRecord<>("order-global", 0, key, value);
但真正的问题是消费端。Kafka 消费者组中,一个 Partition 只能被一个 Consumer 消费。这意味着全局顺序的 Topic 只能是单消费者——吞吐量上限就是一个消费者处理能力。
2.3 RocketMQ 的全局顺序实现
RocketMQ 提供了更精细的顺序消息支持。在全局顺序模式下:
// RocketMQ 全局顺序消息:所有消息发送到同一个 MessageQueue
MessageQueueSelector selector = (mqs, msg, arg) -> {
    // 始终选择第一个队列
    return mqs.get(0);
};

// 生产者发送顺序消息
producer.send(msg, selector, null);

// 消费者:使用 MessageListenerOrderly 保证顺序消费
consumer.registerMessageListener((MessageListenerOrderly) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        // 顺序处理每条消息
        processOrderly(msg);
    }
    return ConsumeOrderlyStatus.SUCCESS;
});
MessageListenerOrderly 内部使用了一个本地锁,确保同一时刻只有一个线程在处理该队列的消息。
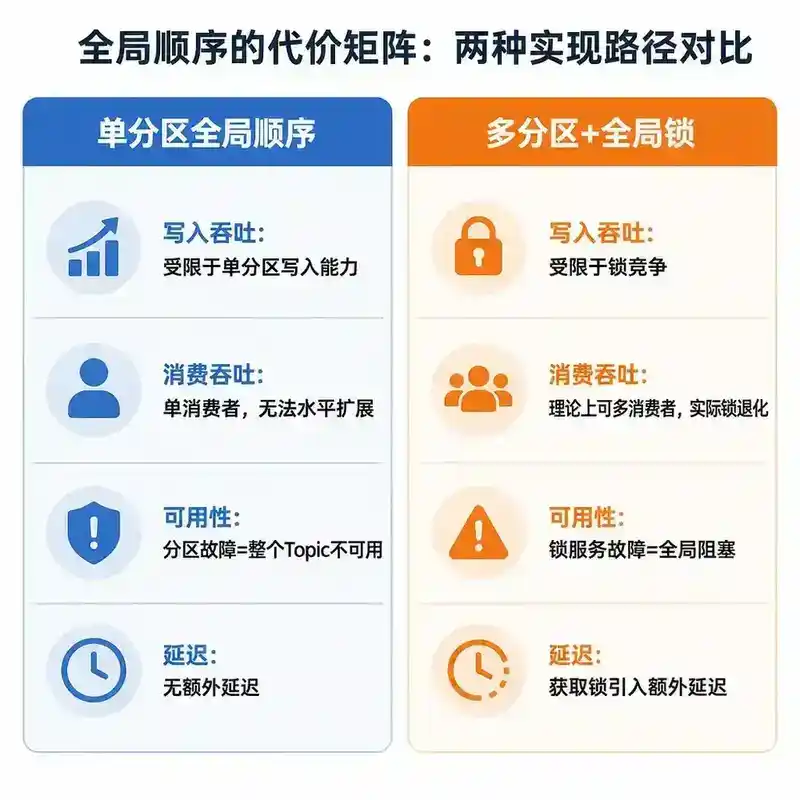
2.4 全局顺序的代价矩阵
| 维度 | 单分区全局顺序 | 多分区 + 全局锁 |
|---|---|---|
| 写入吞吐 | 受限于单分区写入能力 | 受限于锁竞争 |
| 消费吞吐 | 单消费者,无法水平扩展 | 理论上可多消费者,实际锁退化 |
| 可用性 | 分区故障 = 整个 Topic 不可用 | 锁服务故障 = 全局阻塞 |
| 延迟 | 无额外延迟 | 获取锁引入额外延迟 |
三、分区顺序:工程实践的核心
3.1 分区顺序的核心思想
分区顺序的精髓在于将需要有序的消息路由到同一个分区,不同分区之间的消息可以并行处理。
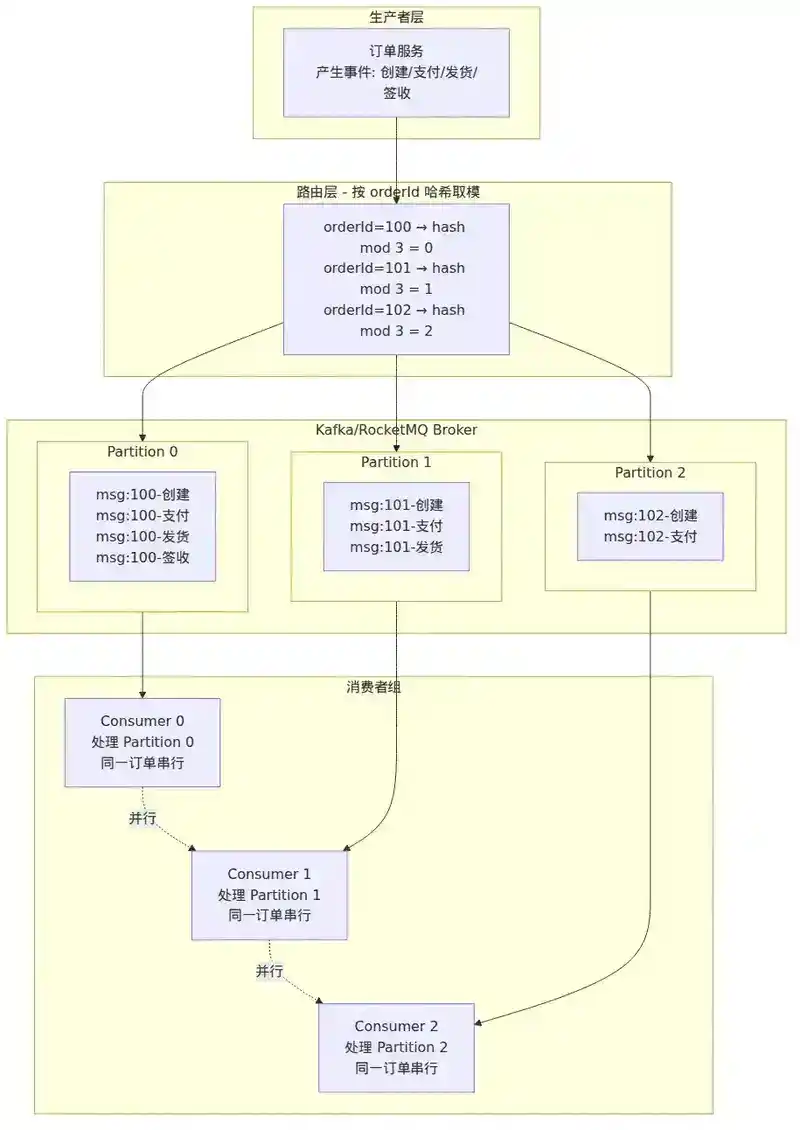
flowchart LR
    subgraph Producers["生产者"]
        P1["订单生产者"]
    end

    subgraph Topic["Topic: order-events (3 Partitions)"]
        P0["Partition 0<br/>orderId % 3 == 0"]
        P1pt["Partition 1<br/>orderId % 3 == 1"]
        P2["Partition 2<br/>orderId % 3 == 2"]
    end

    subgraph Consumers["消费者组"]
        C0["Consumer 0"]
        C1["Consumer 1"]
        C2["Consumer 2"]
    end

    P1 -->|"orderId=100 → P0"| P0
    P1 -->|"orderId=101 → P1"| P1pt
    P1 -->|"orderId=102 → P2"| P2

    P0 --> C0
    P1pt --> C1
    P2 --> C2
关键洞察:同一订单的消息(创建、支付、发货)都路由到同一个分区,它们在该分区内严格有序。不同订单的消息分布在不同分区,可以并行消费。
3.2 路由键(Routing Key)的设计
路由键是分区顺序的基石。设计路由键的核心原则是:将需要因果关系的事件路由到同一个分区。
Kafka 中的分区策略:
// Kafka 默认分区器:key.hashCode() % partitionCount
// 相同 key 的消息一定去往同一个分区
public class DefaultPartitioner implements Partitioner {
    @Override

    public int partition(String topic, Object key, byte[ ] keyBytes,


                         Object value, byte[ ] valueBytes, Cluster cluster) {

        List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);
        int numPartitions = partitions.size();
        if (keyBytes == null) {
            // 无 key 时轮询(Round-Robin),不保证顺序
            return counter.getAndIncrement() % numPartitions;
        }
        // 有 key 时 hash 取模,相同 key 进同一分区
        return Math.abs(Utils.murmur2(keyBytes)) % numPartitions;
    }
}
RocketMQ 中的 MessageQueueSelector:
// 按订单 ID 选择队列
MessageQueueSelector selector = (mqs, msg, arg) -> {
    Long orderId = (Long) arg;
    int index = (int) (orderId % mqs.size());
    return mqs.get(index);
};

// 发送时传入订单 ID 作为路由键
producer.send(msg, selector, orderId);
RabbitMQ 中的 Routing Key:
// RabbitMQ 使用一致性哈希交换器
Map<String, Object> args = new HashMap<>();
args.put("hash-header", "orderId");
channel.exchangeDeclare("order-exchange", "x-consistent-hash", true, false, args);

// 发送时设置 header
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .headers(Map.of("orderId", orderId))
    .build();
channel.basicPublish("order-exchange", "100", props, body);
3.3 路由键设计的常见陷阱
陷阱一:热点键(Hot Key)
如果某个路由键的消息量远超其他键,会导致对应分区成为热点。例如双十一期间,某个爆款商品的订单量是普通商品的 100 倍。
// 错误做法:直接用商品 ID 做路由键
// 爆款商品的所有消息都会进入同一个分区
int partition = Math.abs(skuId.hashCode()) % numPartitions;

// 正确做法:引入随机盐值分散热点
String routingKey = skuId + "_" + (random.nextInt(10)); // 10 路分散
但这会破坏同一订单的顺序性——需要权衡。更好的做法是在路由键设计时就避免使用容易产生热点的字段。
陷阱二:分区数变更导致的路由漂移
Kafka 中增加分区后,hash(key) % partitionCount 的结果会变化,导致同一 key 的消息被路由到不同分区。
扩容前:orderId=100 → hash(100) % 3 = 1 → Partition 1
扩容后:orderId=100 → hash(100) % 4 = 2 → Partition 2
这意味着扩容前产生的消息在 Partition 1,扩容后的消息在 Partition 2——两个分区内的消息各自有序,但跨分区看就乱序了。
解决方案:
- 预分配足够的分区:一次性创建远超当前需求的分区数。
- 使用一致性哈希:减少扩容时的重映射比例。
- 业务层处理:消费端按订单 ID 在内存中排序或使用版本号。
陷阱三:Key 为空时无顺序保证
// 没有指定 key 的消息使用轮询策略
producer.send(new ProducerRecord<>("topic", null, message));
// 消息 1 → Partition 0
// 消息 2 → Partition 1
// 消息 3 → Partition 2
// 完全无序
四、并发消费与顺序的取舍
4.1 并发消费的两种模式
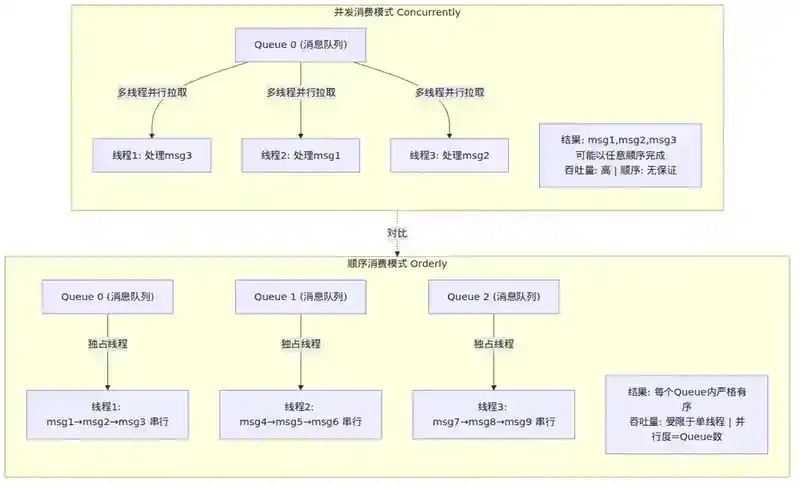
flowchart TD
    subgraph Concurrent["并发消费(Concurrently)"]
        CQ1["Queue 0"] --> CT1["线程 1"]
        CQ1 --> CT2["线程 2"]
        CQ1 --> CT3["线程 3"]
    end

    subgraph Orderly["顺序消费(Orderly)"]
        OQ1["Queue 0"] --> OT1["线程 1(独占)"]
        OQ2["Queue 1"] --> OT2["线程 2(独占)"]
        OQ3["Queue 2"] --> OT3["线程 3(独占)"]
    end
RocketMQ 的两种消费模式:
// 方式一:并发消费(MessageListenerConcurrently)
// 一个 Queue 的消息可以被多个线程并行消费
// 不保证顺序,但吞吐量高
consumer.registerMessageListener((MessageListenerConcurrently) (msgs, context) -> {
    // 可以在这里用线程池并行处理
    return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
});

// 方式二:顺序消费(MessageListenerOrderly)
// 一个 Queue 的消息被单个线程串行消费
// 保证顺序,但该 Queue 的吞吐量受限于单线程
consumer.registerMessageListener((MessageListenerOrderly) (msgs, context) -> {
    // 串行处理,处理完一条才能处理下一条
    return ConsumeOrderlyStatus.SUCCESS;
});
4.2 理解"消费并行度"的真正含义
许多人误以为"消息顺序性"与"消费并行度"是完全对立的——要顺序就不能并行,要并行就不能顺序。实际上:
并行度的单位是分区,不是消息。
如果你的 Topic 有 16 个分区,每个订单的消息路由到固定分区,那么:
- 同一订单的消息在分区内串行(保证顺序)
- 不同订单的消息在不同分区并行(保证吞吐)
- 最高并行度 = 分区数,而不是消费者数
// 关键约束:消费者数 ≤ 分区数
// Kafka 消费者组中,多余的消费者会处于空闲状态
// 所以并行度上限 = min(消费者数, 分区数)
4.3 顺序消费的性能瓶颈
在 RocketMQ 的顺序消费模式下,每个 MessageQueue 由一个线程独占处理。这意味着:
// 顺序消费的伪代码
public class OrderlyConsumeService {
    // 每个 Queue 绑定一个线程
    private final Map<MessageQueue, Thread> queueThreadMap = new HashMap<>();

    public void consume(MessageQueue mq, List<MessageExt> msgs) {
        Thread worker = queueThreadMap.get(mq);
        synchronized (worker) {
            for (MessageExt msg : msgs) {
                // 处理消息——此时该 Queue 的其他消息必须等待
                handleMessage(msg);
            }
        }
    }
}
性能瓶颈在哪里?
- 慢消息阻塞队列:如果某条消息的处理耗时 10 秒,该队列后续的所有消息都要等待 10 秒。
- 锁竞争:虽然是每个队列一把锁,但同一队列的消息量足够大时,锁会成为瓶颈。
- 无法利用多核:一个队列只有一个线程,即使你有 64 核 CPU,单个队列也只能用 1 核。
4.4 取舍策略:什么场景选择什么模式
| 场景 | 推荐模式 | 理由 |
|---|---|---|
| 订单状态流转 | 分区顺序 | 同一订单必须有序,不同订单可以并行 |
| 数据库 binlog 同步 | 全局顺序(单分区) | 必须按事务提交顺序重放 |
| 日志采集 | 无顺序 + 时间戳排序 | 写入时带时间戳,消费端按时间戳重新排序 |
| 实时推荐计算 | 无顺序 + 版本号 | 用版本号判断新旧,不是顺序 |
| 账户余额变更 | 分区顺序(按账户 ID) | 同一账户操作必须有序,不同账户可以并行 |
| IM 消息 | 分区顺序(按会话 ID) | 同一会话消息有序,不同会话并行 |
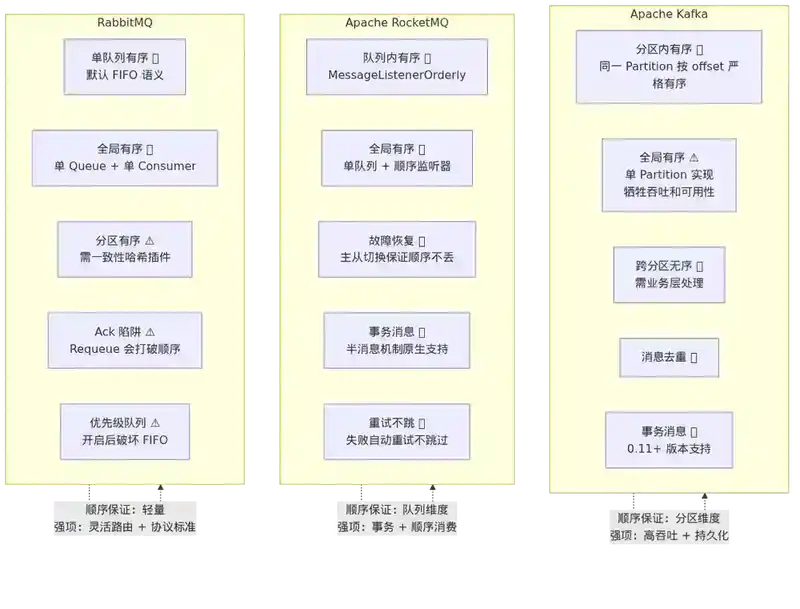
五、主流消息队列的顺序保证对比
5.1 Kafka
| 维度 | 能力 |
|---|---|
| 分区内顺序 | ✅ 原生保证(同一 Partition 内按 offset 有序) |
| 全局顺序 | ⚠️ 可以通过单 Partition 实现,但牺牲吞吐和可用性 |
| 跨分区顺序 | ❌ 不保证,需要业务层处理 |
| 消息去重 | ❌ 不保证,At-Least-Once 语义下有重复 |
| 事务消息 | ✅ 支持(0.11+),保证"读己之写" |
Kafka 顺序保证的底层机制:生产者发送消息时,可以指定 key。相同 key 的消息通过 Murmur2 哈希映射到同一个 Partition。Partition 内部是一个只追加(append-only)的日志,消息按写入顺序分配递增的 offset。消费者按 offset 顺序拉取消息——这就是分区内顺序的根本保证。
5.2 RocketMQ
| 维度 | 能力 |
|---|---|
| 队列内顺序 | ✅ MessageListenerOrderly 原生支持 |
| 全局顺序 | ✅ 单队列 + MessageListenerOrderly |
| 顺序消息的故障恢复 | ✅ Broker 主从切换时保证顺序不丢 |
| 事务消息 | ✅ 原生支持(半消息机制) |
| 顺序消费失败重试 | ✅ 自动重试,不会跳过消息 |
RocketMQ 区别于 Kafka 的关键点:RocketMQ 的 MessageQueue 是逻辑概念,多个 Broker 可以共同管理一个 Topic 的队列。顺序消费时,Consumer 会向 Broker 申请队列锁,防止 rebalance 期间其他 Consumer 接管该队列。
5.3 RabbitMQ
| 维度 | 能力 |
|---|---|
| 单队列内顺序 | ✅ 默认保证(FIFO) |
| 全局顺序 | ✅ 单 Queue + 单 Consumer |
| 分区顺序 | ⚠️ 需使用 Consistent-Hash Exchange 插件 |
| 消费者确认 | ⚠️ 手动 Ack 时如果拒绝消息并 requeue,会打破顺序 |
| 优先级队列 | ⚠️ 开启后破坏 FIFO 语义 |
RabbitMQ 的陷阱:
// 危险:manual ack + requeue 会破坏顺序
channel.basicConsume("order-queue", false, (consumerTag, delivery) -> {
    try {
        processMessage(delivery);
        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
    } catch (Exception e) {
        // requeue=true 会把消息放回队列头部
        // 如果后面的消息已经被处理了,就会乱序
        channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
    }
}, consumerTag -> {});
六、工程师的实操建议
6.1 不要过度设计顺序保证
YAGNI 原则同样适用于消息顺序性。 绝大多数业务场景不需要严格的全局顺序。在动手设计之前,先问自己三个问题:
- 如果消息乱序到达,业务逻辑是否真的会出错? 很多场景下,业务逻辑本身就有幂等性和状态机保护。
- 能否通过业务层补偿来代替基础架构的顺序保证? 比如用版本号、时间戳、状态机来容忍乱序。
- 顺序保证的代价(吞吐量、可用性、复杂度)是否值得? 通常全局顺序的代价是吞吐量下降 90% 以上。
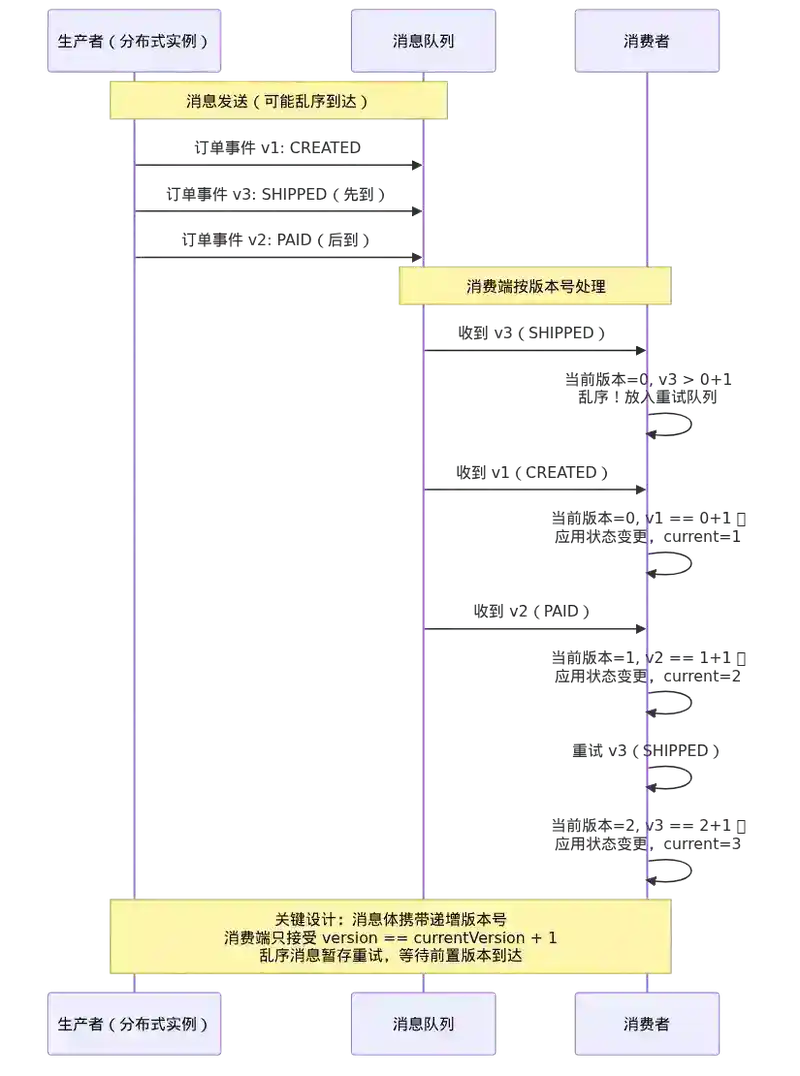
6.2 版本号 > 顺序
在绝大多数场景下,与其依赖消息队列的顺序保证,不如在消息体中携带版本号。
// 消息体设计
public class OrderEvent {
    private String orderId;
    private String eventType;   // CREATED, PAID, SHIPPED, DELIVERED
    private long version;       // 递增版本号
    private long timestamp;     // 事件时间

    // 消费端处理
    public void handle(OrderEvent event) {
        Order current = orderRepository.findById(event.getOrderId());
        // 忽略旧版本消息
        if (current.getVersion() >= event.getVersion()) {
            return;
        }
        // 应用状态变更
        current.apply(event);
        orderRepository.save(current);
    }
}
这样即使消息乱序到达,"发货"消息先于"支付"消息,消费端也会因为版本号不连续而忽略或重试。
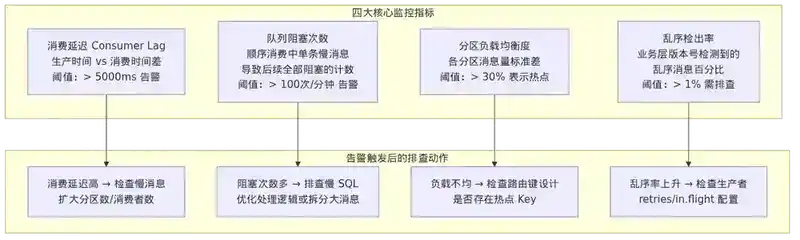
6.3 监控顺序消费的健康状况
// 关键监控指标
public class OrderingMetrics {
    // 1. 消息延迟(从生产到消费的时间差)
    // 如果某个队列的延迟突然飙升,说明该队列有慢消息
    private long consumerLag;

    // 2. 队列消费阻塞次数
    // 顺序消费中,一条消息处理慢会导致后续消息全部阻塞
    private long blockedCount;

    // 3. 热点分区检测
    // 某个分区的消息量远超其他分区
    private double partitionLoadStdDev;

    // 4. 乱序检出率
    // 业务层检测到的乱序消息比例
    private double outOfOrderRate;
}
七、总结
消息顺序性是一个经典的分布式系统权衡问题。核心要点:
- 只保证需要的顺序层次:全局顺序代价巨大,分区顺序是大多数场景的最佳选择。
- 路由键是分区顺序的核心:将需要因果关系的事件路由到同一个分区。
- 并发度由分区数决定:要保证顺序,就在分区内串行;要提升吞吐,就增加分区数。
- 版本号是乱序的最终兜底:基础架构只能保证"尽力而为",业务层必须有乱序容忍能力。
- 了解你使用的消息队列的顺序模型:Kafka、RocketMQ、RabbitMQ 各有不同的顺序保证机制和陷阱。
面试官提问
以下问题从面试官视角出发,考察对消息顺序性的深度理解。建议在完成文章阅读后,尝试独立回答。
Q1:你说 Kafka 同一个 Partition 内消息有序,但如果生产者设置了 max.in.flight.requests.per.connection > 1 且 enable.idempotence=false,消息还能保证分区内有序吗?为什么?
Q2:假设你有一个订单系统,每天产生 1000 万条订单消息,每条消息处理需要 50ms,你如何设计消息队列来保证同一订单的消息有序,同时满足整体吞吐量要求?
Q3:RocketMQ 的顺序消费在 Broker 主从切换时,如何保证消息不丢且顺序不乱?请描述具体的流程。
Q4:你的系统使用了 Kafka 的消息顺序保证。某天你发现某个消费者的处理延迟突然飙升到 10 秒,而其他消费者正常。排查后发现该消费者负责的 Partition 中有几条消息处理特别慢。在不改变分区分配的前提下,你有什么缓解方案?
Q5:现在有一个需求:A 系统产生的事件必须按产生顺序被 B 系统消费,但 A 系统是分布式部署的 100 个实例,每个实例产生的事件之间也有顺序依赖。你如何设计这个消息方案?
Q6:比较 Kafka 的幂等生产者(idempotent producer)和事务生产者(transactional producer)在顺序保证上的区别。幂等生产者能替代分区内顺序保证吗?