阅读时间:约 40-50 分钟 | 难度:★★★★☆ | 前置知识:消息队列基础概念、Kafka 基本架构
一、为什么需要理解 RocketMQ 架构?
RocketMQ 是阿里巴巴开源、现已捐献给 Apache 基金会的分布式消息中间件。它支撑了历年双十一的万亿级消息流转,在金融级可靠性、低延迟、海量堆积等场景下经过长期验证。
与 Kafka 的"面向日志"设计不同,RocketMQ 选择了面向消息的设计路线,这带来了架构上一系列独特的取舍。理解这些取舍,是技术选型和故障排查的前提。
本文核心问题:RocketMQ 如何用 NameServer 替代 ZooKeeper?为什么 CommitLog 是全局唯一的?ConsumeQueue 如何实现高性能消费?
二、RocketMQ 总体架构
2.1 四大核心角色
RocketMQ 的部署架构包含四个核心角色:
| 角色 | 职责 | 特点 |
|---|---|---|
| NameServer | 路由注册中心 | 无状态、几乎无压力、集群间不通信 |
| Broker | 消息存储与转发 | 有状态、主从复制、支持水平扩展 |
| Producer | 消息生产 | 与 NameServer 交互获取路由 |
| Consumer | 消息消费 | 支持 Pull/Push 两种模式 |
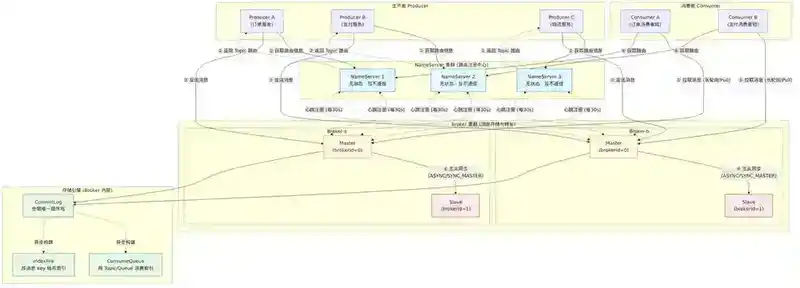
图1:RocketMQ 总体架构图——四大核心角色(NameServer、Broker、Producer、Consumer)及其交互关系
2.2 与 Kafka 架构的关键差异
| 维度 | Kafka | RocketMQ |
|---|---|---|
| 注册中心 | ZooKeeper / KRaft | NameServer(自研) |
| 存储模型 | 分区独立存储 | 全局 CommitLog + 消费队列 |
| 消息模型 | 日志流(Log) | 消息(Message) |
| 消费模式 | 仅 Pull | Pull + Push(长轮询) |
| 事务消息 | 事务 API | 原生半消息机制 |
| 延迟消息 | 需自行实现 | 原生支持 18 个延迟级别 |
| 顺序消息 | 分区内有序 | 队列内有序(MessageQueue) |
| Tag 过滤 | 无原生支持 | 原生 Tag 过滤 |
三、NameServer:轻量级路由注册中心
3.1 设计理念
NameServer 是 RocketMQ 最精妙的设计之一。它选择了**"AP 优于 CP"**的路线:追求可用性和分区容错,牺牲强一致性。
为什么不直接用 ZooKeeper?
- 减少外部依赖:ZooKeeper 本身是一个分布式系统,需要额外运维。RocketMQ 希望"自包含"
- 性能考虑:ZooKeeper 基于 ZAB 协议,写操作需要过半节点确认,在高频路由变更场景下存在延迟
- 故障隔离:如果 ZooKeeper 集群出问题,Kafka 元数据管理完全不可用。NameServer 之间互不依赖,单点故障不影响其他节点
3.2 核心工作机制
NameServer 的工作流程极其简单:
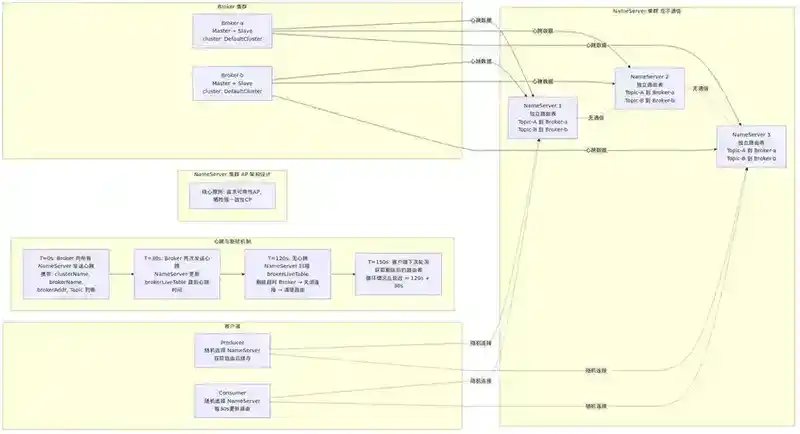
图2:NameServer 注册与心跳机制——Broker 向所有 NameServer 注册,NameServer 之间不通信的 AP 架构
关键特性:
- NameServer 之间不通信:每个 NameServer 独立维护一份完整的路由表
- Broker 向所有 NameServer 注册:每个 Broker 启动时,向配置的所有 NameServer 发送心跳注册
- 客户端随机连接:Producer/Consumer 随机选择一个 NameServer 获取路由信息
- 最终一致性:Broker 心跳间隔 30 秒,NameServer 120 秒无心跳则剔除。这意味着路由变更有最长 120 秒的延迟
3.3 路由信息结构
NameServer 维护的路由表包含:
// 简化的路由数据结构
class RouteInfoManager {
    // Topic → Queue 列表
    HashMap<String, List<QueueData>> topicQueueTable;
    // Broker 信息
    HashMap<String, BrokerData> brokerAddrTable;
    // 集群信息
    HashMap<String, Set<String>> clusterAddrTable;
    // Broker 存活状态
    HashMap<String, BrokerLiveInfo> brokerLiveTable;
}

class QueueData {
    String brokerName;
    int readQueueNums;   // 读队列数
    int writeQueueNums;  // 写队列数
    int perm;            // 权限
}

class BrokerData {
    String cluster;
    String brokerName;
    HashMap<Long, String> brokerAddrs; // brokerId → 地址
}
3.4 为什么 NameServer 不通信反而是优点?
这是面试高频问题。核心逻辑:
- CAP 理论中选 AP 而不是 CP:NameServer 集群不通信意味着网络分区时,每个分区内的 NameServer 仍能独立工作,不会因为"无法达成共识"而拒绝服务
- 路由变更是低频操作:Topic 的创建/删除、Broker 的上线/下线,在生产环境中是低频事件。120 秒的最终一致延迟完全可以接受
- 简单即可靠:不需要选举、不需要日志同步、不需要处理脑裂。代码量级远小于 ZooKeeper
四、Broker:消息存储引擎
4.1 Broker 的职责
Broker 是 RocketMQ 中最复杂的组件,承担消息的接收、存储、投递和复制:
- 接收 Producer 的消息,写入 CommitLog
- 构建 ConsumeQueue 和 IndexFile 索引
- 响应 Consumer 的拉取请求
- 处理主从复制(Master-Slave)
- 管理消息过期与删除
4.2 Broker 的部署模式
主从复制模式:
| 模式 | 写入延迟 | 可靠性 | 适用场景 |
|---|---|---|---|
| ASYNC_MASTER | 低 | 可能丢失少量消息 | 高吞吐、可容忍少量丢失 |
| SYNC_MASTER | 中 | 不丢消息 | 金融、支付等可靠性优先 |
刷盘模式:
| 模式 | 实现 | 延迟 | 可靠性 |
|---|---|---|---|
| ASYNC_FLUSH | 异步刷盘,后台线程定期 fsync | 低 | 宕机可能丢失未刷盘消息 |
| SYNC_FLUSH | 同步刷盘,每条消息立即 fsync | 高 | 不丢消息 |
五、CommitLog:全局唯一的消息存储
5.1 设计理念
这是 RocketMQ 与 Kafka 最大、最本质的差异。
Kafka 模式:每个 Partition 独立存储,每个 Partition 是一个独立的文件/目录
RocketMQ 模式:所有 Topic 的消息都写入同一个 CommitLog 文件(一个 Broker 一个 CommitLog)
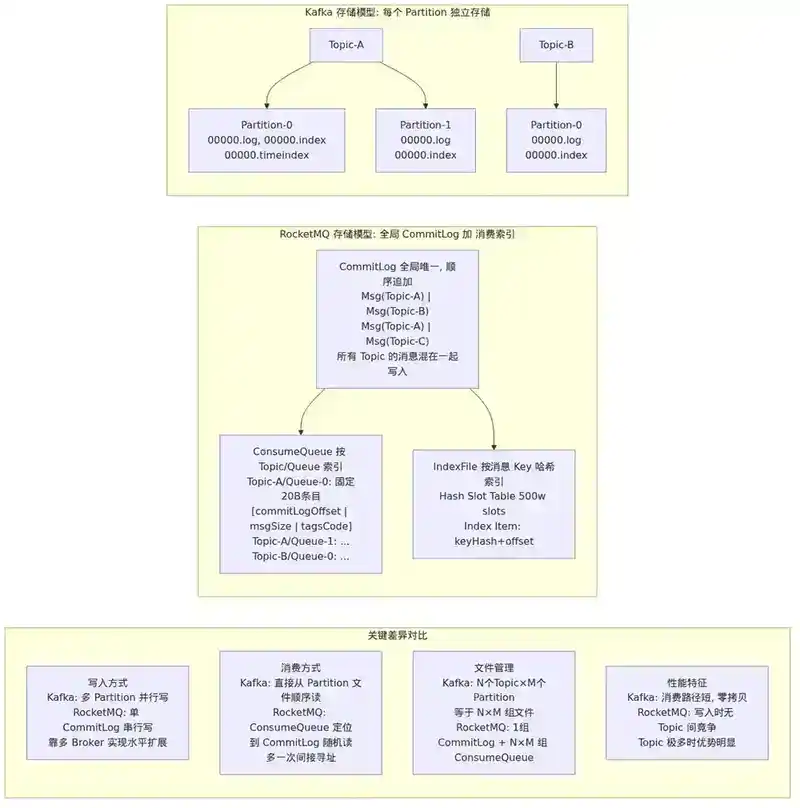
图3:CommitLog 与 ConsumeQueue 存储模型对比——全局顺序写 vs 消费索引,以及 Kafka 分区存储对比
5.2 为什么选择全局 CommitLog?
优点:
- 顺序写 I/O 最大化:所有消息都追加到同一个文件,磁盘顺序写性能极高(可达 600MB/s+)。Kafka 的 Partition 独立存储也是顺序写,但 RocketMQ 的全局 CommitLog 在 Topic 极多时优势更明显
- 简化数据管理:不需要为每个 Topic/Queue 管理独立的文件生命周期。一个 Broker 只需管理一组 CommitLog 文件
- 减少随机读:CommitLog 写入是纯顺序的,落盘效率更高
缺点:
- 消费需要额外索引:因为所有 Topic 的消息混在一起,消费者无法直接从 CommitLog 定位目标消息。这就引出了 ConsumeQueue
- CommitLog 是单点写入:每个 Broker 只有一个 CommitLog 写入点,不像 Kafka 可以多个 Partition 并行写入(但 RocketMQ 通过多个 Broker 水平扩展来弥补)
5.3 CommitLog 文件结构
~/store/commitlog/
├── 00000000000000000000          # 第一个文件,1GB
├── 00000000001073741824          # 第二个文件,1GB
├── 00000000002147483648          # 第三个文件,1GB
└── ...
每个 CommitLog 文件默认 1GB,文件名是其起始物理偏移量。这种设计让"根据物理偏移量定位消息"的时间复杂度为 O(1):直接计算文件名并定位。
单条消息的存储格式:
单条消息包含:totalSize、magicCode、bodyCRC、queueId、flag、queueOffset、physicalOffset、sysFlag、bornTimestamp、bornHost、storeTimestamp、storeHost、reconsumeTimes、preparedTransactionOffset、bodyLength、body、topic、properties 等字段。
5.4 消息写入流程
// 简化版 CommitLog 写入流程
public PutMessageResult putMessage(MessageExtBrokerInner msg) {
    // 1. 设置存储时间
    msg.setStoreTimestamp(System.currentTimeMillis());

    // 2. 获取写入锁(CommitLog 全局锁)
    this.putMessageLock.lock();
    try {
        // 3. 获取最后一个 MappedFile(内存映射文件)
        MappedFile mappedFile = this.mappedFileQueue.getLastMappedFile();

        // 4. 计算消息在 CommitLog 中的物理偏移量
        long startOffset = mappedFile.getFileFromOffset() + mappedFile.getWrotePosition();

        // 5. 追加写入(顺序写)
        boolean result = mappedFile.appendMessage(msg);

        // 6. 构造 ConsumeQueue 和 Index 条目
        // (异步处理,不阻塞写入)
        this.dispatcherService.putRequest(msg);

        return new PutMessageResult(PutMessageStatus.PUT_OK, result);
    } finally {
        this.putMessageLock.unlock();
    }
}
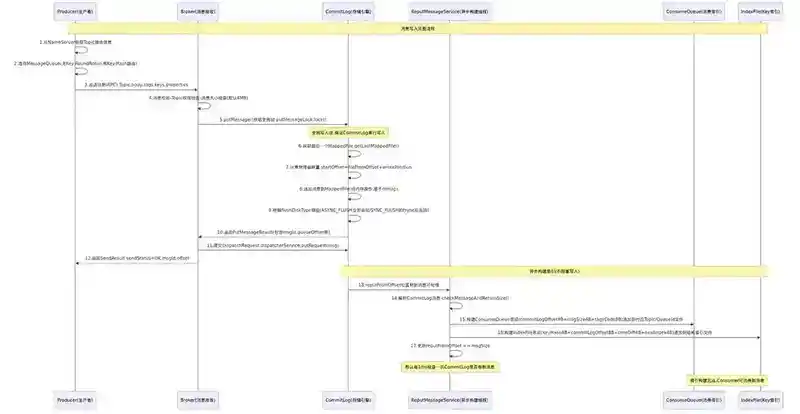
图4:消息写入流程时序图——Producer → Broker → CommitLog → ReputMessageService → ConsumeQueue
关键点:
putMessageLock是全局锁,保证 CommitLog 写入的串行化- 写入是纯内存操作(MappedFile 基于 mmap),不需要同步等待磁盘 I/O
- ConsumeQueue 和 Index 的构建是异步的,不阻塞写入路径
六、ConsumeQueue:消费索引
6.1 为什么需要 ConsumeQueue?
CommitLog 中混杂了所有 Topic 的所有消息。消费者说"我要消费 Topic-A 的消息",Broker 不能扫描整个 CommitLog。
ConsumeQueue 就是解决这个问题的索引结构——每个 MessageQueue 对应一个 ConsumeQueue 文件。
6.2 ConsumeQueue 结构
~/store/consumequeue/
├── Topic-A/
│   ├── 0/
│   │   ├── 00000000000000000000    # ConsumeQueue 文件
│   │   └── 00000000000006000000
│   ├── 1/
│   │   └── 00000000000000000000
│   └── 2/
│       └── 00000000000000000000
├── Topic-B/
│   └── 0/
│       └── 00000000000000000000
└── ...
每条 ConsumeQueue 条目固定 20 字节:
每条 ConsumeQueue 条目固定 20 字节:commitLogOffset(8B) + msgSize(4B) + tagsCode(8B)
固定 20 字节的设计意味着:
- 按偏移量定位消息是 O(1) 操作:
position = offset * 20 - ConsumeQueue 文件很小,可以全部加载到 PageCache
6.3 消费流程
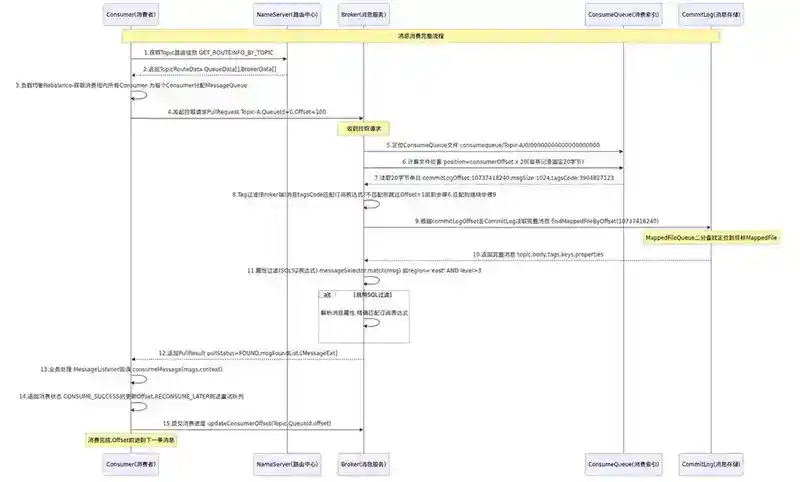
图5:消费流程——Consumer 从 ConsumeQueue 定位 → CommitLog 读取 → Tag 过滤 → 返回消息
性能分析:
- 定位 ConsumeQueue 条目:O(1),因为条目固定 20 字节
- 定位 CommitLog 消息:O(1),因为 MappedFileQueue 内部使用二分查找
- 读 CommitLog:随机读(因为不同 Topic 的消息在 CommitLog 中交错存储)
6.4 ConsumeQueue 的构建
ConsumeQueue 的构建是异步的,由 DefaultMessageStore.ReputMessageService 线程负责:
// ReputMessageService 核心逻辑
class ReputMessageService extends ServiceThread {
    public void run() {
        while (!this.isStopped()) {
            // 1. 从 CommitLog 的 dispatch 位置开始
            SelectMappedBufferResult result =
                commitLog.getData(reputFromOffset);

            // 2. 解析消息
            DispatchRequest dispatchRequest =
                commitLog.checkMessageAndReturnSize(result);

            // 3. 构建 ConsumeQueue 条目
            this.dispatcherList.forEach(dispatcher ->
                dispatcher.dispatch(dispatchRequest));

            // 4. 更新 reputFromOffset
            reputFromOffset += dispatchRequest.getMsgSize();
        }
    }
}
ReputMessageService 的延迟:默认每 1ms 检查一次 CommitLog 是否有新消息。在极端写入压力下,ConsumeQueue 的构建可能落后于 CommitLog,但通常落后不超过 1ms。
七、IndexFile:按 Key 查询消息
7.1 设计目的
ConsumeQueue 解决的是"按 Topic + Queue 消费"的问题,但业务上经常需要"按消息 Key 查询某条消息"(例如:查询某个订单号的消息)。
IndexFile 就是为此设计的——提供 消息 Key → CommitLog Offset 的映射。
7.2 索引文件结构
~/store/index/
└── 20260904123456789    # 文件名 = 时间戳
IndexFile 分三部分:
详见下方 IndexFile 结构示意图。
查询流程:
- 对消息 Key 做哈希 → 定位 Hash Slot
- 从 Slot 中获取最新的 Index Item 位置
- 遍历哈希冲突链表,找到匹配的 keyHash
- 根据 commitLogOffset 读取消息
八、消息存储的内存映射(MappedFile)
8.1 mmap 原理
RocketMQ 使用 Java 的 MappedByteBuffer(底层是操作系统的 mmap)来实现文件读写:
// MappedFile 核心创建逻辑
public class MappedFile {
    private FileChannel fileChannel;
    private MappedByteBuffer mappedByteBuffer;

    public void init(String fileName, int fileSize) {
        this.fileChannel = new RandomAccessFile(fileName, "rw").getChannel();
        this.mappedByteBuffer =
            this.fileChannel.map(MapMode.READ_WRITE, 0, fileSize);
    }
}
mmap 的优势:
- 零拷贝:数据直接从 PageCache 传输到 Socket Buffer,不需要 CPU 拷贝
- 减少系统调用:读写 MappedByteBuffer 就像操作内存,不需要 read/write 系统调用
- PageCache 自动管理:热点数据自动留在 PageCache 中,冷数据自动淘汰
8.2 MappedFileQueue 管理
public class MappedFileQueue {
    // 按物理偏移量排序的文件列表
    private final CopyOnWriteArrayList<MappedFile> mappedFiles;

    // 根据偏移量查找 MappedFile(二分查找)
    public MappedFile findMappedFileByOffset(long offset) {
        MappedFile firstFile = this.mappedFiles.get(0);
        MappedFile lastFile = this.mappedFiles.get(this.mappedFiles.size() - 1);

        // 偏移量在文件区间内
        int index = (int) ((offset / this.mappedFileSize) -
                   (firstFile.getFileFromOffset() / this.mappedFileSize));

        MappedFile targetFile = this.mappedFiles.get(index);
        if (targetFile != null && offset >= targetFile.getFileFromOffset()
            && offset < targetFile.getFileFromOffset() + this.mappedFileSize) {
            return targetFile;
        }
        // Fallback to binary search
        // ...
    }
}
九、Producer 与 Consumer 的交互
9.1 Producer 发送流程
延迟故障容错(LatencyFaultTolerance): Producer 记录每个 Broker 的最近发送延迟,延迟高的 Broker 会被暂时回避。这避免了"向慢 Broker 持续发送加重其负担"的恶性循环。
9.2 Consumer 消费模式
RocketMQ 支持两种消费模式:
| 模式 | 特点 | 实现 |
|---|---|---|
| 集群消费(Clustering) | 每条消息只被消费组内一个消费者消费 | 默认模式 |
| 广播消费(Broadcasting) | 每条消息被消费组内所有消费者消费 | 每个消费者独立维护 Offset |
消费方式:
// Push 模式(底层是长轮询 Pull)
consumer.registerMessageListener((MessageListenerConcurrently) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        // 处理消息
        processMessage(msg);
    }
    return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
});

// Pull 模式(手动拉取)
consumer.fetchSubscribeMessageQueues("Topic-A");
PullResult result = consumer.pull(messageQueue, "*", offset, maxNums);
Push 模式的本质:RocketMQ 的 Push 模式实际上是长轮询(Long Polling)。Consumer 向 Broker 发起拉取请求,如果没有新消息,Broker 会 hold 住请求 15 秒(可通过 longPollingEnable 配置)。15 秒内有新消息到达立即返回,否则返回空。
十、消息可靠性机制
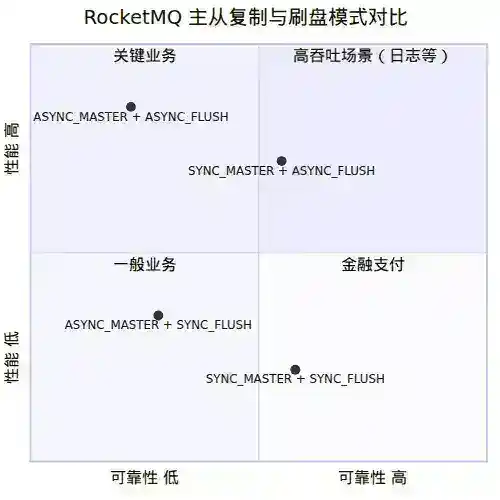
图6:主从复制与刷盘模式对比——SYNC_MASTER/ASYNC_MASTER + SYNC_FLUSH/ASYNC_FLUSH 四种组合的可靠性 vs 性能对比
10.1 同步刷盘 vs 异步刷盘
同步刷盘配置:
# broker.conf
flushDiskType=SYNC_FLUSH
性能对比:
- 异步刷盘:TPS 可达 10 万+/秒
- 同步刷盘:TPS 约 1000-5000/秒(取决于磁盘性能)
10.2 主从复制
同步复制(SYNC_MASTER):
- Master 写入后等待 Slave 确认
- 优点:Master 宕机不丢消息
- 缺点:增加写入延迟
异步复制(ASYNC_MASTER):
- Master 写入后立即返回,Slave 异步复制
- 优点:低延迟
- 缺点:Master 宕机可能丢失少量消息
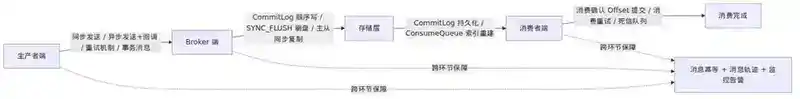
图7:消息可靠性保障全景图——从生产者发送到消费者消费的完整链路,标注各环节的可靠性机制
十一、消息过滤机制
11.1 Tag 过滤
RocketMQ 原生支持 Tag 过滤,这是相比 Kafka 的一大优势:
// 生产者:给消息打 Tag
Message msg = new Message("Topic-A", "Tag-Payment", "OrderPaid", body);
producer.send(msg);

// 消费者:只消费特定 Tag
consumer.subscribe("Topic-A", "Tag-Payment || Tag-Refund");
Tag 过滤的实现:在 ConsumeQueue 条目中存储了 tagsCode(8 字节),Broker 在拉取消息时先通过 ConsumeQueue 的 tagsCode 过滤,再读取 CommitLog。这避免了读取不匹配的消息体。
11.2 SQL 属性过滤
// 生产者设置属性
Message msg = new Message("Topic-A", "Tag-A", body);
msg.putUserProperty("region", "east");
msg.putUserProperty("level", "5");

// 消费者按 SQL 表达式过滤
consumer.subscribe("Topic-A", MessageSelector.bySql("region = 'east' AND level > 3"));
SQL 过滤需要先读取消息体中的属性,因此在 Broker 端需要解析消息,有一定的性能开销。RocketMQ 通过 BloomFilter 优化了 SQL 过滤的性能。
十二、实战:RocketMQ 核心配置
# broker.conf 关键配置

# 集群名称
brokerClusterName=DefaultCluster
# Broker 名称(同一组主从的 Broker 名称相同)
brokerName=broker-a
# Broker ID (0=Master, 非0=Slave)
brokerId=0

# NameServer 地址
namesrvAddr=192.168.1.1:9876;192.168.1.2:9876

# 存储路径
storePathRootDir=/data/rocketmq/store
storePathCommitLog=/data/rocketmq/store/commitlog
storePathConsumeQueue=/data/rocketmq/store/consumequeue

# CommitLog 文件大小(默认 1GB)
mapedFileSizeCommitLog=1073741824
# ConsumeQueue 文件大小
mapedFileSizeConsumeQueue=300000

# 刷盘模式
flushDiskType=ASYNC_FLUSH
# 主从复制模式
brokerRole=ASYNC_MASTER

# 消息保存时间(小时)
fileReservedTime=72

# 是否开启自动创建 Topic
autoCreateTopicEnable=true
十三、RocketMQ vs Kafka 选型指南
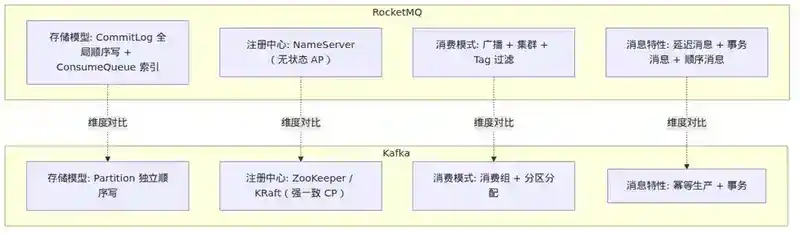
图8:RocketMQ vs Kafka 架构差异对比——存储模型、注册中心、消费模式、消息特性四个维度的并排对比
| 场景 | 推荐 | 理由 |
|---|---|---|
| 海量日志收集、流计算 | Kafka | Kafka 的日志模型更适合流式处理,生态更完善 |
| 金融级可靠消息、事务消息 | RocketMQ | 原生事务消息、同步刷盘/同步复制 |
| 延迟消息、定时消息 | RocketMQ | 原生支持 18 个延迟级别 |
| Tag/属性过滤消费 | RocketMQ | 原生 Tag 过滤,Kafka 需要自行实现 |
| 减少运维依赖 | RocketMQ | NameServer 自包含,无需 ZooKeeper |
| 大数据生态集成 | Kafka | Kafka Connect、KSQL、与 Spark/Flink 深度集成 |
| 阿里云/国内云环境 | RocketMQ | 阿里云商业版支持,中文社区活跃 |
总结
RocketMQ 的架构设计体现了"面向消息"的独特理念:
- NameServer:AP 优先,极致简单,去 ZooKeeper 依赖
- CommitLog:全局顺序写,最大化磁盘 I/O 效率
- ConsumeQueue:固定 20 字节条目,O(1) 定位,Tag 过滤
- IndexFile:哈希索引,支持按 Key 查询
- MappedFile:mmap 零拷贝,PageCache 友好
核心取舍:全局 CommitLog 带来了极致的写入性能,但代价是消费时需要额外的 ConsumeQueue 索引和一次随机读。这个 trade-off 在"写多读少"的消息场景下非常合理。
面试官视角:高频追问
Q1:NameServer 之间不通信,那 Broker 挂了消费者怎么感知?
点击展开参考答案
核心机制:消费者通过两种方式感知 Broker 变更:
- 定时更新路由:消费者每隔 30 秒从 NameServer 拉取最新的路由信息。如果 Broker 已下线,NameServer 会在 120 秒无心跳后剔除该 Broker,消费者在下一次路由更新时就能感知。
- Broker 主动通知(RocketMQ 4.5+):Broker 下线时,如果配置了
notifyConsumerIdsChangedEnable=true,Broker 会主动通知消费者。
最大延迟:最坏情况下,从 Broker 宕机到消费者感知,延迟为 120 秒(NameServer 剔除)+ 30 秒(消费者轮询)= 150 秒。
面试官追问:这 150 秒内消息怎么办? 答:依赖主从切换。如果 Master 宕机,Consumer 可以自动切换到 Slave 消费(需要配置 whichBrokerWhenConsumeSlowly)。但 Slave 的数据可能落后于 Master,因此需要权衡可靠性和延迟。
Q2:为什么 RocketMQ 的 CommitLog 是全局唯一的,而 Kafka 是每个 Partition 独立存储?
点击展开参考答案
设计目标的差异:
- RocketMQ 面向消息:设计目标是"消息队列",重点是消息的可靠投递。全局 CommitLog 让所有消息顺序写入一个文件,最大化磁盘顺序写能力。在 Topic 数量极多(数百甚至数千)时,全局 CommitLog 避免了大量小文件的随机 I/O。
- Kafka 面向日志流:设计目标是"分布式日志",每个 Partition 是独立的日志流,方便流处理框架按 Partition 并行消费。每个 Partition 独立存储也方便数据迁移和分区再分配。
实战考量:
- 如果 Topic 数少、Partition 数多:Kafka 的独立存储模型更优(并行写入)
- 如果 Topic 数极多(比如每个业务一个 Topic):RocketMQ 的全局 CommitLog 避免了文件句柄爆炸
- RocketMQ 的全局 CommitLog 在消费时需要 ConsumeQueue 间接定位,多了一次随机读;Kafka 直接从 Partition 文件顺序读,消费路径更短
Q3:RocketMQ 的 ConsumeQueue 条目为什么是固定 20 字节?
点击展开参考答案
固定大小的设计意图:
- O(1) 定位:因为每条记录固定 20 字节,要查找第 N 条记录,文件偏移量就是
N * 20。不需要任何索引结构,直接 seek 即可。 - PageCache 友好:一个 ConsumeQueue 文件默认包含 30 万条记录(config:
mapedFileSizeConsumeQueue),仅占 6MB。整个文件可以轻松缓存到 PageCache 中,消费时不需要磁盘 I/O。 - 极简设计:20 字节包含三个字段:commitLogOffset(8 字节)、msgSize(4 字节)、tagsCode(8 字节)。恰好覆盖消费和 Tag 过滤两个核心需求,没有冗余。
面试官追问:如果 tagsCode 哈希冲突怎么办? 答:tagsCode 是 Tag 字符串的 hashCode,确实可能冲突。如果冲突,Broker 在读取 CommitLog 中的完整消息后,会用消息的原始 Tag 字符串做精确匹配,过滤掉冲突的消息。所以 Tag 过滤是"过滤大部分,精确匹配兜底"的两阶段策略。
Q4:一个 RocketMQ Broker 挂了,怎么保证消息不丢?
点击展开参考答案
多层保障机制:
- 主从复制:配置 SYNC_MASTER + SYNC_FLUSH,Master 写入后必须等 Slave 确认 + 磁盘 fsync 才返回成功。这是最强的可靠性保证,但性能代价大。
- 生产者重试:如果发送失败,Producer 默认重试 2 次。如果 Master 宕机,Producer 可以自动切换到其他 Broker。
- 消费者切换:如果 Master 宕机,Consumer 可以切换到 Slave 继续消费。Slave 上可能有少量消息未同步(取决于复制模式),这部分消息等 Master 恢复后可以继续消费。
- DLedger(RocketMQ 4.7+):基于 Raft 协议的多副本机制,自动选举 Leader,实现自动故障转移,不再依赖手动主从切换。
面试官追问:ASYNC_MASTER 模式下 Master 宕机,最多丢多少消息? 答:取决于 Slave 的复制延迟。默认 Slave 每 1 秒拉取一次 CommitLog 增量,如果 Master 在两次拉取之间宕机,最多丢失 1 秒的消息量。高峰期可能丢失上万条消息。
Q5:RocketMQ 如何保证消息顺序?
点击展开参考答案
核心原则:同一 MessageQueue 内的消息天然有序。
生产端:发送消息时,相同业务 Key(如订单 ID)的消息通过 SelectMessageQueueByHash 策略路由到同一个 MessageQueue。
// 顺序消息发送
Message msg = new Message("OrderTopic", "Tag", "Order-12345", body);
SendResult result = producer.send(msg,
    new SelectMessageQueueByHash(), "Order-12345");
消费端:使用 MessageListenerOrderly 而非 MessageListenerConcurrently。RocketMQ 对每个 MessageQueue 加分布式锁,保证同一时刻只有一个消费者线程消费该队列。
consumer.registerMessageListener((MessageListenerOrderly) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        processMessage(msg);
    }
    return ConsumeOrderlyStatus.SUCCESS;
});
代价:顺序消费牺牲了并行度。同一个 MessageQueue 的消息只能串行处理,如果一条消息处理慢,会阻塞该队列后续所有消息。因此 RocketMQ 也支持通过增加 MessageQueue 数量来提升并行度(但需要配合业务 Key 路由)。
本文是「Java 技术专家与架构师面试:250 个高频考点总览」系列的第 153 篇。下一篇将探讨 RocketMQ 顺序/延迟/事务消息的实现机制。