一、引子:从"同步调用地狱"说起
想象一个电商下单场景:用户点击"提交订单"后,系统需要扣库存、创建订单、发短信、记录日志、更新推荐模型、触发风控审核……如果用传统的同步 RPC 调用链,OrderService.createOrder() 得依次调用六七个下游服务。任何一个下游慢 200ms,整个请求就慢 200ms。任何一个下游挂了,整个下单就失败了。
更糟的是,这种紧耦合让系统像一堵砖墙——想拆掉一块砖(比如把短信从阿里云换到腾讯云),得把整面墙都拆了重砌。
事件驱动架构(Event-Driven Architecture,EDA) 就是解决这个问题的。核心思想只有一句话:服务之间不再直接调用,而是通过发布和订阅事件来协作。订单服务只做一件事——创建订单,然后发布一个 OrderCreated 事件。至于谁关心这个事件,订单服务完全不知道,也不需要知道。
这听起来简单,但真正落地时,你会遇到一连串问题:事件怎么设计?用什么传输?怎么保证数据一致性?状态丢了怎么恢复?本文从领域事件、事件总线、事件溯源、最终一致性四个维度,把 EDA 从概念到落地讲透。
二、核心概念:事件、命令、消息——别再混用了
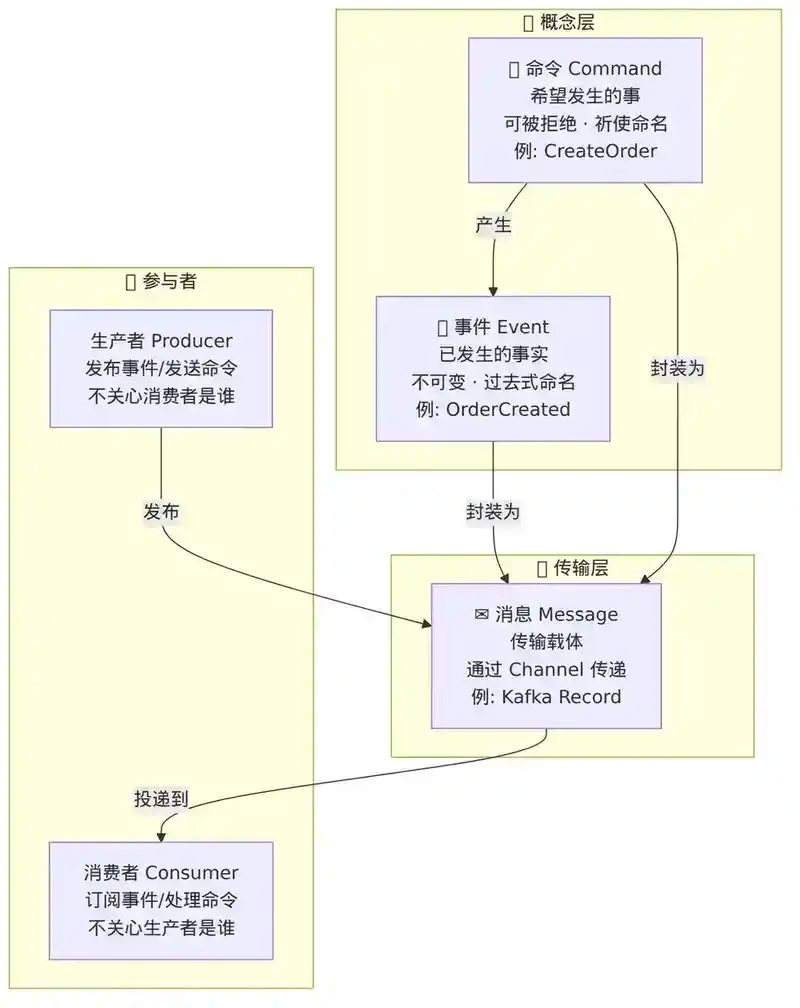
很多工程师把"事件"、"命令"、"消息"混为一谈,在落地方案里随口说"发个消息通知一下"。这三个概念在 EDA 中有严格区分,混淆了会导致架构设计偏差。
2.1 事件(Event)
事件是对"已经发生的事实"的不可变记录。关键词:已经发生、不可变。
OrderCreated { orderId: "12345", userId: "u_789", amount: 299.00, createdAt: "2026-09-05T10:30:00Z" }
这个事件表达了"订单已经创建了"这个事实。它用过去式命名(OrderCreated),不是 CreateOrder。你不能"拒绝"一个事件——事实已经发生了,你只能决定「对这件事做什么」。
2.2 命令(Command)
命令是对"希望发生的事"的请求。关键词:希望发生、可以被拒绝。
CreateOrderCommand { userId: "u_789", items: [...], couponId: "c_456" }
命令命名用祈使语气(CreateOrder)。命令可以被验证、被拒绝——"余额不足,订单创建失败"就是一个合法的命令处理结果。
2.3 消息(Message)
消息是传输载体。事件和命令都是消息的具体类型。消息通过某种通道(Channel)从生产者传递到消费者。Kafka 里的 Record、RabbitMQ 里的 Message、Pulsar 里的 Message——这些都是消息层面的概念。
| 维度 | 命令 | 事件 |
|---|---|---|
| 语义 | 请求做某事 | 通知某事已发生 |
| 命名 | 祈使语气(CreateOrder) | 过去式(OrderCreated) |
| 可否拒绝 | 可以 | 不可以(事实不可改变) |
| 耦合度 | 发送者知道接收者 | 发送者不关心接收者 |
| 典型场景 | 用户操作入口 | 跨服务协作 |
一个经典的错误:把事件当成命令用。"我发一个 UpdateInventory 事件,库存服务收到后扣库存"——这不是事件,这是命令。正确的做法是:库存服务订阅 OrderCreated 事件,自己决定要扣库存,然后发布 InventoryDeducted 事件。
三、领域事件:让业务语言进入代码
3.1 领域事件的定义
领域事件(Domain Event) 是领域驱动设计(DDD)中的一个核心战术模式,由 Eric Evans 在《领域驱动设计》中提出。它描述的是领域专家关心的、在业务上有意义的状态变化。
不是所有的数据变更都是领域事件:
- ❌
UserTableRowUpdated——这是数据库层面的变化,不是业务语言 - ✅
OrderShipped——这是业务语言,物流专家能理解
领域事件让代码和业务对话使用同一套语言。当产品经理说"用户下单后我们要发优惠券",对应的代码就是:CouponService 订阅 OrderPlaced 事件。
3.2 领域事件的设计原则
原则一:事件名表达业务意图
✅ OrderPlaced, PaymentReceived, ShipmentDelivered
❌ OrderStatusChanged, DataUpdated, RecordSaved
事件名应该让非技术人员也能大致理解发生了什么。
原则二:事件携带足够但不冗余的信息
一个 OrderPlaced 事件需要包含什么?能回答"谁、什么时间、买了什么、付了多少钱"就够了。不要把整个订单对象序列化进去——消费方需要更多信息时,应该通过 ID 回查。
{
  "eventId": "evt_abc123",
  "eventType": "OrderPlaced",
  "occurredAt": "2026-09-05T10:30:00Z",
  "aggregateId": "order_12345",
  "aggregateType": "Order",
  "version": 1,
  "payload": {
    "userId": "u_789",
    "totalAmount": 299.00,
    "items": [
      { "skuId": "sku_001", "quantity": 2, "unitPrice": 99.00 }
    ],
    "shippingAddress": "浙江省杭州市..."
  }
}
原则三:事件是不可变的
一旦发布,事件不能修改。如果发现事件内容有误,不是去改原事件,而是发布一个补偿事件(如 OrderCorrected)。
原则四:事件 ID 唯一且可追溯
每个事件需要全局唯一的 ID,用于去重和链路追踪。eventId 通常用 UUID 或雪花算法生成。
3.3 领域事件 vs 集成事件
这是一个容易混淆的点。在微服务架构中,事件有两种作用域:
| 维度 | 领域事件 | 集成事件 |
|---|---|---|
| 作用域 | 同一个限界上下文内 | 跨限界上下文 |
| 目的 | 解耦领域内的组件 | 解耦不同微服务 |
| 消费者 | 同一个上下文的其他聚合/领域服务 | 其他微服务 |
| 格式 | 可以使用领域对象 | 应该是纯 DTO,不依赖领域模型 |
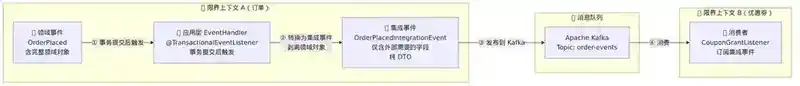
实际项目中,领域事件产生后,通常由应用层将其转换为集成事件发布到消息队列:
领域层产生 OrderPlaced 领域事件
  → 应用层 EventHandler 收到
    → 转换为 OrderPlacedIntegrationEvent(只包含外部需要的字段)
      → 发布到 Kafka
3.4 Spring 中的领域事件实现
Spring 从 4.2 开始提供了 ApplicationEventPublisher,可以方便地实现进程内领域事件:
// 1. 定义事件
public class OrderPlacedEvent extends ApplicationEvent {
    private final String orderId;
    private final BigDecimal amount;
    // constructor, getters...
}

// 2. 发布事件
@Service
public class OrderService {
    @Autowired
    private ApplicationEventPublisher publisher;

    @Transactional
    public void placeOrder(PlaceOrderCommand cmd) {
        Order order = Order.create(cmd);
        orderRepository.save(order);
        // 在事务提交后发布,保证事件与数据一致
        publisher.publishEvent(new OrderPlacedEvent(this, order.getId(), order.getAmount()));
    }
}

// 3. 订阅事件
@Component
public class CouponGrantListener {
    @EventListener
    @TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)  // 事务提交后执行
public void onOrderPlaced(OrderPlacedEvent event) { // 发放优惠券 } }
`@TransactionalEventListener` 是 Spring 4.2+ 提供的利器。默认在事务提交后执行(`AFTER_COMMIT`),如果事务回滚,事件不会触发。这解决了"事件发出去了但数据没落库"的经典问题。

**但要注意**:`ApplicationEventPublisher` 是进程内的,无法跨服务。跨服务需要事件总线。

---

## 四、事件总线:事件的"高速公路"

### 4.1 事件总线的职责

事件总线(Event Bus)是 EDA 的中枢神经,负责事件的接收、路由和分发。它的核心职责:

1. **解耦生产者和消费者**:生产者不知道消费者是谁,消费者也不知道事件从哪来
2. **可靠投递**:保证事件不丢失、不重复
3. **顺序保证**:同一实体的事件保证顺序
4. **可扩展**:消费者可以动态增减,不影响生产者

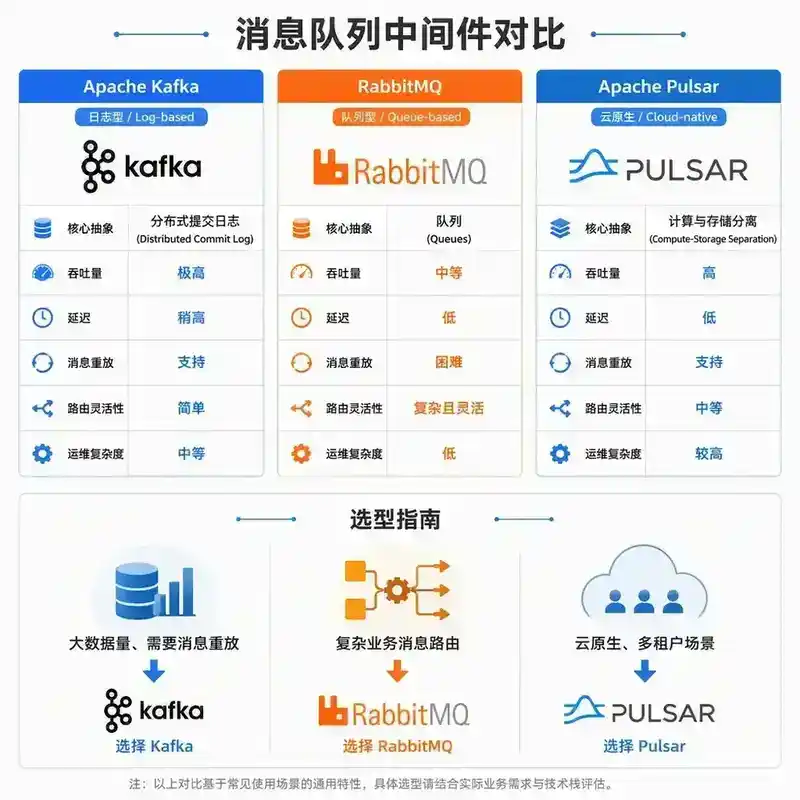
### 4.2 消息队列选型:Kafka、RabbitMQ、Pulsar 怎么选?

这是面试高频问题。三者都是事件总线的常见实现,但设计哲学完全不同。

**Apache Kafka:日志型,海量事件首选**

Kafka 的核心抽象是**分布式提交日志**(Distributed Commit Log)。消息写入后不删除(按时间或大小淘汰),消费者通过 offset 自由回溯。
Kafka 的存储模型: Partition 0: [msg0, msg1, msg2, msg3, msg4, msg5, ...] ↑ consumer offset = 2(已消费到 msg2)
- **优势**:超高吞吐(百万级/秒)、消息持久化、支持回溯重放、天然有序(partition 内)
- **劣势**:消息一条不能丢的设计导致延迟略高、消费者管理复杂、不支持优先级
- **适合场景**:日志收集、流处理、事件溯源、用户行为追踪

**RabbitMQ:队列型,灵活路由首选**

RabbitMQ 的核心抽象是**队列**(Queue)。消息被消费后确认(ACK)即删除。支持复杂的 Exchange 路由规则。

- **优势**:AMQP 标准协议成熟、路由灵活(direct/topic/fanout/headers)、延迟低、管理界面友好
- **劣势**:吞吐量不如 Kafka、消息回溯困难、集群扩展相对复杂
- **适合场景**:业务消息、任务分发、RPC 调用、需要复杂路由的场景

**Apache Pulsar:云原生,下一代选择**

Pulsar 的设计是**计算与存储分离**:BookKeeper 负责存储,Broker 是无状态的。这解决了 Kafka 的痛点——扩缩容时不需要大量数据搬迁。

- **优势**:计算存储分离、多租户原生支持、支持 Queue 和 Stream 两种消费模式、Geo-Replication
- **劣势**:生态不如 Kafka 成熟、运维复杂度高、社区规模较小
- **适合场景**:云原生环境、需要多租户隔离、需要跨地域复制

**选型口诀**:

- 数据量大、需要回溯重放 → Kafka
- 业务消息、路由复杂、低延迟 → RabbitMQ
- 云原生、多租户、未来扩展性 → Pulsar
- 团队小、运维能力有限 → 云厂商托管服务(阿里云 RocketMQ / AWS SQS+SNS)

### 4.3 事件总线的关键设计问题

**(1)消息可靠性:at-least-once vs at-most-once vs exactly-once**

CAP 理论告诉我们,在网络分区的情况下,这三者只能满足一个。实际工程中:

- **at-least-once**(至少一次):最常用。消息可能重复,消费者必须幂等
- **at-most-once**(最多一次):允许丢消息,适合监控指标等可容忍丢失的场景
- **exactly-once**(精确一次):Kafka 在流处理层面支持(通过事务+幂等生产者),但代价是性能下降

**(2)消费者幂等**

既然 at-least-once 是常态,消费者必须幂等。常见策略:
// 方案一:数据库唯一约束
// 用 eventId 作为唯一键,重复插入直接忽略
INSERT INTO event_received (event_id, event_type, payload) VALUES (?, ?, ?)
ON DUPLICATE KEY UPDATE id = id;  // MySQL 的 no-op 写法

// 方案二:Redis 去重
String key = "event:processed:" + eventId;
Boolean success = redis.setIfAbsent(key, "1", Duration.ofHours(24));
if (Boolean.FALSE.equals(success)) return; // 已处理过

// 方案三:业务层面的幂等
// 扣库存时,先查是否已扣过
if (inventoryDeducted(orderId)) return;
(3)顺序保证
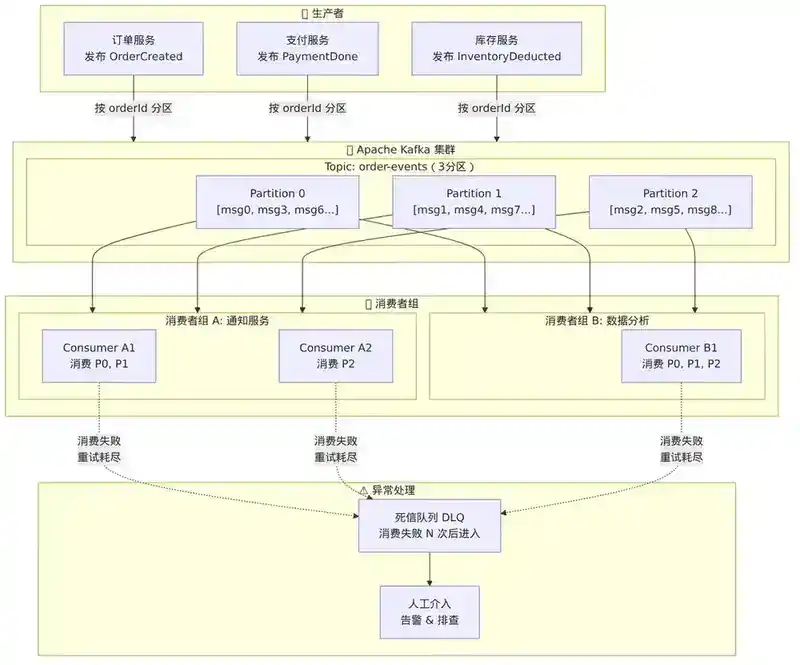
Kafka 中,同一 partition 内的消息严格有序。关键是把需要有序的事件路由到同一个 partition:
// 同一个 orderId 的事件发到同一个 partition,保证顺序
producer.send(new ProducerRecord<>("order-events",
    orderId,  // key —— 相同 key 进同一 partition
    event));
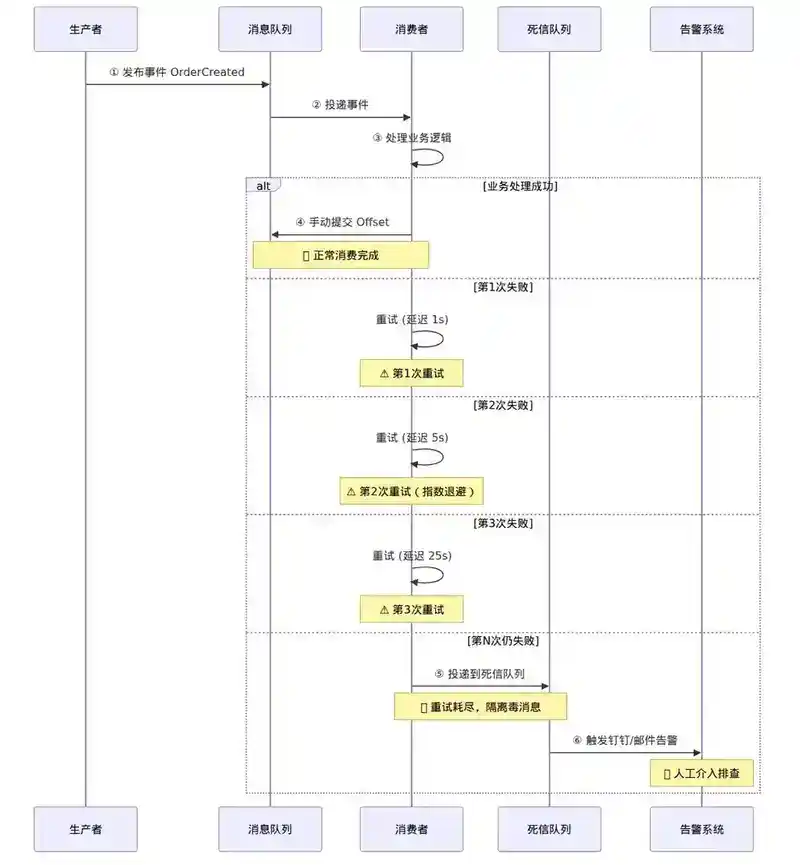
(4)死信队列(DLQ)
消费失败的消息不能无限重试——否则会阻塞整个队列。引入死信队列:
正常处理流程:事件 → 消费者 → 成功
失败处理流程:事件 → 消费者 → 失败 → 重试 N 次 → 仍失败 → 死信队列 → 人工介入
五、事件溯源:状态是事件的投影
5.1 什么是事件溯源
事件溯源(Event Sourcing) 是一种数据持久化范式:不存储当前状态,而是存储引起状态变化的所有事件序列。当前状态通过重放事件计算得出。
传统 CRUD 模式:
数据库存储:orders 表
| id | status | amount | user_id |
|----|--------|--------|---------|
| 1  | SHIPPED| 299.00 | 789     |
事件溯源模式:
事件存储:
[OrderCreated(1, 299.00, 789)]
[OrderPaid(1, 299.00)]
[OrderShipped(1, "SF123456")]
要获取订单当前状态,不是 SELECT * FROM orders WHERE id=1,而是读取该订单的所有事件并按顺序重放:
public Order getOrder(String orderId) {
    List<Event> events = eventStore.load(orderId);
    Order order = new Order();  // 空对象
    for (Event event : events) {
        order.apply(event);  // 重放每个事件,重建当前状态
    }
    return order;
}
这听起来反直觉——为什么要舍近求远?因为事件溯源提供了传统 CRUD 无法提供的能力:
- 完整审计日志:谁在什么时间做了什么,不可篡改
- 时间旅行:可以查询任意时间点的状态
- 调试利器:可以重现任何 bug 发生时的完整状态变化过程
- 业务洞察:分析事件序列可以发现业务模式(比如:"用户从加购物车到下单平均需要多久?")
5.2 事件存储
事件存储是事件溯源的核心基础设施。它本质上是一个只追加(append-only)的事件日志。
事件存储 = 事件流 + 聚合 ID + 版本号

每条记录:
{
  eventId: "evt_001",
  aggregateId: "order_123",   // 属于哪个聚合
  aggregateVersion: 4,        // 聚合的版本号(乐观锁)
  eventType: "OrderPaid",
  payload: { ... },
  occurredAt: "2026-09-05T10:30:00Z"
}
aggregateVersion 是实现乐观锁的关键。当写入新事件时,必须验证版本号是否连续:
-- 如果 version 不连续,说明有并发写入,应拒绝
INSERT INTO events (aggregate_id, version, event_type, payload) SELECT ?, ?, ?, ? WHERE NOT EXISTS ( SELECT 1 FROM events WHERE aggregate_id = ? AND version = ? );
### 5.3 CQRS:命令查询职责分离

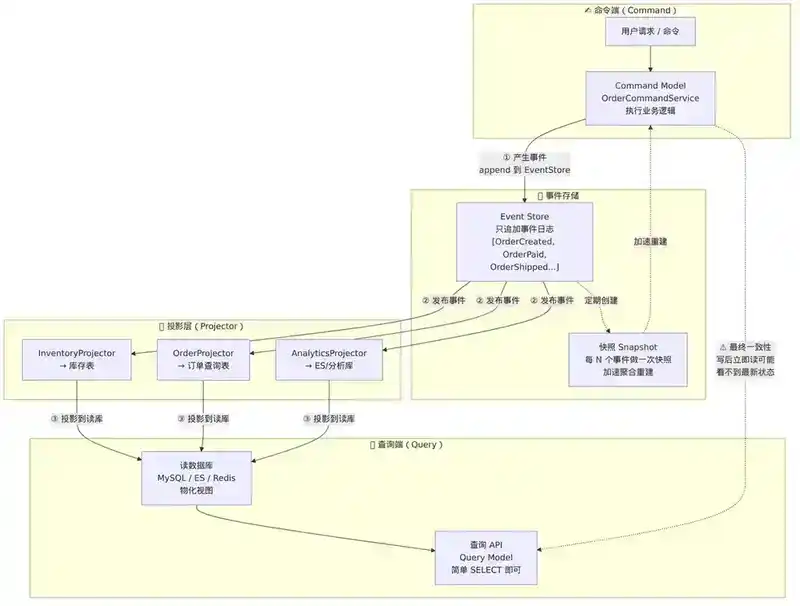
事件溯源天然催生 CQRS(Command Query Responsibility Segregation)。原因很简单:事件溯源在"写"方面很强大,但"查"很痛苦——查一个订单的状态要重放几百个事件,显然不可接受。
传统模式: ┌──────────┐ │ 单体应用 │ ← 同一个模型同时处理读写 └──────────┘
CQRS 模式: 写请求 → ┌──────────┐ → 事件存储 │ Command │ │ Model │ └──────────┘ ↓ (事件) ┌──────────┐ │ Projector│ → 读数据库(MySQL/ES/Redis) └──────────┘ ↑ 读请求 → ┌──────────┐ │ Query │ │ Model │ └──────────┘
Command Model 处理写操作,产生事件。Projector 监听事件,将最新状态投影到读数据库。Query Model 从读数据库直接查询,无需重放事件。

**CQRS 的代价**:写和读之间存在延迟(最终一致性)。用户刚下的订单,可能在查询列表时还没出现。这是设计上必须接受的 trade-off。

### 5.4 快照:不要让事件无限增长

一个活跃的订单聚合可能产生成百上千个事件。每次重建状态时重放所有事件会越来越慢。

**快照(Snapshot)** 是解决方案:定期将聚合的当前状态序列化保存,重建时从最近的快照开始,只重放快照之后的事件。
public Order loadOrder(String orderId) {
    // 1. 加载最近的快照
    Snapshot snapshot = snapshotStore.loadLatest(orderId);

    // 2. 从快照恢复基础状态
    Order order = snapshot != null
        ? snapshot.restore()
        : new Order();
    long fromVersion = snapshot != null ? snapshot.getVersion() + 1 : 1;

    // 3. 只重放快照之后的事件
    List<Event> events = eventStore.load(orderId, fromVersion);
    for (Event event : events) {
        order.apply(event);
    }
    return order;
}
快照策略通常是"每 N 个事件做一次快照"(N=50 或 100),或者"距上次快照超过 T 时间"。
5.5 事件溯源不是银弹
事件溯源不适合所有场景:
- ❌ 状态变化频繁但查询也很频繁的简单 CRUD 场景(杀鸡用牛刀)
- ❌ 没有审计需求且数据结构简单的场景
- ❌ 团队对事件溯源和 CQRS 没有经验
适合的场景:
- ✅ 金融交易系统(每笔交易必须可审计)
- ✅ 订单/物流系统(状态变化本身就是业务价值)
- ✅ 供应链追踪(溯源能力是核心需求)
- ✅ 版本控制系统(Git 本身就是事件溯源)
六、最终一致性:EDA 下的数据一致性之道
6.1 CAP 之下,没有完美的一致
事件驱动架构天然是分布式的。一旦引入分布式,CAP 定理就绕不开:网络分区(P)发生时,一致性(C)和可用性(A)只能二选一。
在 EDA 中,大多数场景选择 AP(保证可用性和分区容错,接受最终一致性):
- 用户下单后,库存可能还没扣完
- 支付成功后,订单状态可能还是"待支付"
- 但这些不一致是暂时的,系统最终会达到一致状态
这就是最终一致性(Eventual Consistency):如果没有新的更新,系统最终会收敛到一致状态。
6.2 Saga 模式:分布式事务的替代方案
传统分布式事务(2PC / XA)在微服务中几乎不可用——锁等待、单点故障、性能差。Saga 模式是 EDA 中实现最终一致性的核心技术。
Saga 的核心思想:把一个长事务拆成多个本地事务,每个本地事务完成后发布事件触发下一个。如果某个步骤失败,执行补偿操作回滚。
正向流程:
  Order Service     → Payment Service  → Inventory Service → Shipping Service
  [创建订单]         → [扣款]           → [扣库存]          → [发货]
  发布 OrderCreated  发布 PaymentDone   发布 InventoryDone  发布 ShipmentCreated

补偿流程(假设库存不足):
  Inventory Service 扣库存失败
    → 发布 InventoryFailed
      → Payment Service 退款(补偿)
        → 发布 PaymentRefunded
          → Order Service 取消订单(补偿)
            → 发布 OrderCancelled
Saga 有两种实现方式:
编排式 Saga(Orchestration):有一个 Saga 管理器负责协调所有步骤。
Saga Orchestrator
  │
  ├─ Step 1: 调用 Order Service 创建订单
  ├─ Step 2: 调用 Payment Service 扣款
  ├─ Step 3: 调用 Inventory Service 扣库存
  └─ Step 4: 调用 Shipping Service 发货
      │
      └─ 失败时:按逆序调用补偿
- 优点:流程清晰,容易追踪
- 缺点:编排器成为核心依赖,容易变成"上帝对象"
编排式 Saga(Choreography):没有中心协调器,每个服务自己决定下一步。
Order Service 发布 OrderCreated
  → Payment Service 监听到,扣款,发布 PaymentDone
    → Inventory Service 监听到,扣库存,发布 InventoryDone
      → Shipping Service 监听到,发货
- 优点:松耦合,无中心节点
- 缺点:流程分散,理解困难,难以监控
实践中通常混合使用:简单流程用 Choreography,复杂流程的关键监督用 Orchestration。
6.3 补偿机制的设计原则
Saga 的补偿不是简单的"Undo"——很多操作是无法真正撤销的。比如发了短信,无法"收回短信"。补偿是从业务层面抵消前序操作的影响。
补偿设计原则:
- 补偿是业务操作:不是技术回滚,而是业务抵消(退款、取消、作废)
- 补偿必须幂等:补偿操作可能被重复执行
- 补偿可能也需要补偿:极端情况下,补偿也可能失败,需要重试或人工介入
@Service
public class OrderSagaHandler {

    @EventListener
    public void onPaymentFailed(PaymentFailedEvent event) {
        // 补偿:取消订单
        Order order = orderRepo.findById(event.getOrderId());
        order.cancel("支付失败,自动取消");
        orderRepo.save(order);

        // 发布补偿完成事件
        publisher.publishEvent(new OrderCancelledEvent(order.getId()));
    }

    @EventListener
    public void onInventoryFailed(InventoryFailedEvent event) {
        // 补偿第一步:退款
paymentService.refund(event.getOrderId()); // 退款成功后,PaymentService 会发布 PaymentRefunded // 然后订单服务再取消订单 } }
### 6.4 处理最终一致性中的"读己之写"

在最终一致性架构下,用户写了一个操作后立即查询,可能看不到刚刚写入的结果。这是 EDA 中常见的体验问题。

解决方案:

1. **读自己的写(Read Your Own Writes)**:对于用户自己的数据,直接从主库读取
2. **版本号/时间戳**:客户端带上自己看到的最新版本号,服务端只在版本更新时返回
3. **业务上接受延迟**:如"订单处理中,请稍后刷新"

---

## 七、实战:一个完整的 EDA 落地方案

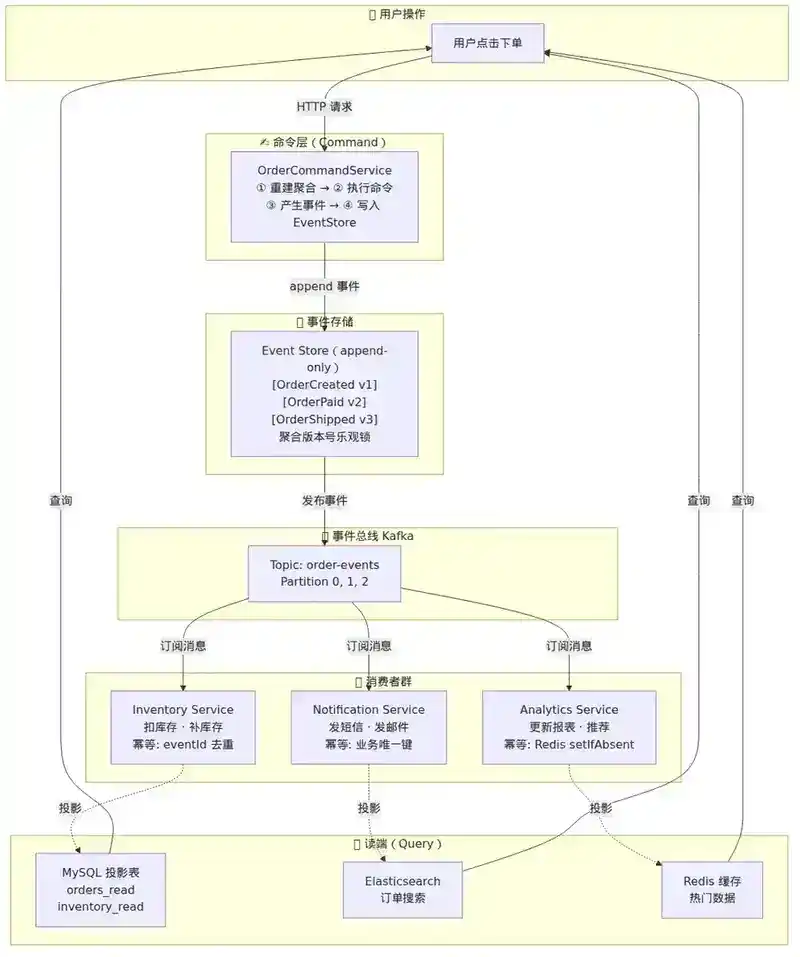
以一个简化的电商系统为例,展示 EDA 的完整落地架构。

### 系统组件
┌──────────────┐ ┌──────────────┐ ┌──────────────┐ │ Order │ │ Inventory │ │ Notification│ │ Service │ │ Service │ │ Service │ └──────┬───────┘ └──────┬───────┘ └──────┬───────┘ │ │ │ └──────────────────┼───────────────────┘ │ ┌────────▼────────┐ │ Kafka Cluster │ │ (事件总线) │ └────────┬────────┘ │ ┌────────▼────────┐ │ Event Store │ │ (事件溯源存储) │ └────────┬────────┘ │ ┌────────▼────────┐ │ Read Database │ │ (投影/物化视图) │ └─────────────────┘
### 关键代码骨架

**事件定义**:
// 事件基类
@MappedSuperclass
public abstract class DomainEvent {
    private String eventId = UUID.randomUUID().toString();
    private String aggregateId;
    private long aggregateVersion;
    private Instant occurredAt = Instant.now();
    // getters...
}

// 具体事件
public class OrderPlaced extends DomainEvent {
    private String userId;
    private BigDecimal totalAmount;
    private List<OrderItem> items;
    // constructor, getters...
}
事件发布:
@Service
public class OrderCommandService {
    private final EventStore eventStore;
    private final KafkaTemplate<String, DomainEvent> kafka;

    @Transactional
    public void placeOrder(PlaceOrderCommand cmd) {
        // 1. 从事件存储重建聚合
        Order order = eventStore.load(cmd.getOrderId(), Order.class);

        // 2. 执行命令,产生事件
        List<DomainEvent> newEvents = order.place(cmd);

        // 3. 写事件存储(原子操作)
        eventStore.append(cmd.getOrderId(), newEvents, order.getVersion());

        // 4. 发事件到 Kafka
        newEvents.forEach(e -> kafka.send("order-events", e.getAggregateId(), e));
    }
}
事件消费:
@Component
public class InventoryProjector {

    @KafkaListener(topics = "order-events")
    public void handleOrderEvent(DomainEvent event) {
        if (event instanceof OrderPlaced placed) {
            // 扣库存
            inventoryService.deduct(placed.getItems());
        } else if (event instanceof OrderCancelled cancelled) {
            // 补库存(补偿)
            inventoryService.restore(cancelled.getItems());
        }
    }
}
面试官视角:EDA 高频追问
Q1:你说"事件是不可变的",但如果下游消费者发现事件里的数据是错的怎么办?
这是 EDA 落地中最常见的问题之一。记住一个铁律:不要修改已发布的事件,而是发布补偿事件。
具体做法:假设订单服务发布了 OrderCreated(orderId=123, amount=199.00),但实际应该是 299.00。正确的处理方式是:1)发布 OrderCorrected(orderId=123, correctedAmount=299.00, reason="价格录入错误");2)所有下游消费者必须同时订阅 OrderCreated 和 OrderCorrected,并实现"收到修正事件后重新计算"的逻辑。
追问: 如果错误事件已经触发了不可逆的副作用(比如发了一条错误的扣款短信),怎么办?答案是分层补偿:1)数据层通过补偿事件修正;2)业务层通过发送更正短信来抵消;3)必要时人工介入。没有完美的自动补偿,有些副作用只能通过业务手段消除。
Q2:你在项目中用了 Kafka 做事件总线,但 Kafka 的消费是 pull 模式,RabbitMQ 是 push 模式。EDA 场景下,push vs pull 对系统设计有什么影响?
这个问题考察的是对消息模型和反压控制的理解深度。
Push 模式(RabbitMQ): Broker 主动推送给消费者。优点是延迟低,消息一到就推送。致命问题是消费者过载——如果消费者处理速度跟不上推送速度,消息会在消费者端的 buffer 中堆积,最终 OOM。RabbitMQ 用 prefetch count 来控制(限制未确认消息数量),但本质上是在 push 基础上加了流量控制。
Pull 模式(Kafka): 消费者按自己的节奏主动拉取。优点是完全由消费者控制处理速度,天然支持反压。代价是增加了延迟(poll 间隔),但可以通过长轮询(long polling)缓解。更重要的是,pull 模式天然支持消息回溯——消费者可以重置 offset 重新消费历史消息,这是 RabbitMQ 做不到的。
EDA 场景下的选择: 如果事件处理链路复杂、下游处理能力不确定、需要回溯重放能力,pull 模式更合适。如果延迟敏感、路由规则复杂(如按 topic 层级匹配),push 模式更合适。
Q3:事件溯源 + CQRS 模式下,读模型(Projection)的数据和写模型(Event Store)存在延迟。用户刚下单就在订单列表页看不到这条订单,你怎么处理?
这是 CQRS 的经典"读己之写"问题。面试官想看你是否理解最终一致性的代价,以及是否有实际的工程手段来处理。
分层回答:
- 最低要求——UI 层面的安抚: 在关键操作后(如提交订单),跳转到"订单详情页"而非"订单列表页"。详情页可以直接从写模型(Event Store)读取最新状态,绕过投影延迟。同时显示"订单处理中,状态可能稍有延迟"的提示。
- 进阶方案——追自己的写(Read Your Own Writes): 客户端在请求头带上自己看到的最新
eventId或version。服务端在查询时检查投影是否已更新到该版本,如果未更新,降级到从 Event Store 直接读取。 - 架构层面——选择合适的一致性边界: 不是所有数据都需要 CQRS。用户自己创建的订单用"写后读主库"(不经过投影),其他人的订单走投影。这本质上是把一致性边界画在用户维度上。
- 监控投影延迟: 对投影延迟设置告警(如 P99 延迟超过 2 秒),这比任何兜底方案都重要——如果投影本身是健康的,延迟通常只有几十毫秒,用户根本感知不到。
Q4:Saga 模式中,Choreography(协同式)和 Orchestration(编排式)你怎么选?什么情况下你会主动选择"更复杂"的那一个?
面试官在这个问题上想听到的是场景驱动的权衡,而不是"协同式好"或"编排式好"的简单结论。
我选择 Choreography(协同式)的场景: 1)参与者不超过 3-4 个,流程简单;2)每个步骤失败率低,补偿逻辑简单;3)团队对 EDA 有经验,理解"事件即契约"的约束。好处是解耦彻底,没有单点瓶颈。
我选择 Orchestration(编排式)的场景: 1)流程超过 4 步,或存在复杂的条件分支和并行执行;2)需要集中管控和可视化(比如"订单创建进度"需要在 UI 上展示);3)补偿逻辑复杂,需要编排器统一管理回滚顺序;4)团队对 EDA 不熟悉,编排式更容易理解和调试。
在大型项目中,我倾向于混合模式: 主流程用编排式(有 Saga Orchestrator),但每个步骤内部的服务间通信用协同式(事件驱动)。这样既保留了流程的可见性,又避免了编排器成为天级耦合点。
Q5:事件溯源听起来很美,但在电商场景下,一个热门商品可能有上千万条库存变更事件。重放所有事件来重建状态可能需要几分钟,这怎么解决?
这个问题考察的是事件溯源在高频写入场景下的性能边界和工程优化手段。
核心策略是快照 + 增量:
- 定期快照(Snapshot): 每 N 个事件(如每 100 个)或每 T 时间(如每 5 分钟)对聚合做一次快照。读取时从最近的快照开始,只重放快照之后的少量事件。快照可以存在 Redis 或专门的快照表中。
- 业务层面的聚合拆分: 不是每个可以独立变化的实体都要塞进同一个聚合。电商场景下,商品库存可以用一个专门的
StockAggregate,而不是放在ProductAggregate里。聚合粒度越细,每个聚合的事件数越少。 - 不追求"纯"事件溯源: 对于库存这种高频变更但不需要审计的场景,不要用事件溯源——直接用 Redis 原子扣减才是正确选择。事件溯源适合的状态变化是"数量少但每次变化都有业务意义"(如订单状态),而不是"纯数值的频繁变更"(如库存数量、浏览量)。
- 事件归档: 对于超过一定时间窗口的事件(如 90 天前的订单),可以合并归档——只保留一个"最终状态快照"和关键业务事件,删除中间状态变更事件。
Q6:多个服务订阅同一个事件,但消费速度不同——快的服务已经处理完了,慢的服务还在处理 10 分钟前的事件。如果这时候快的服务产生了新事件,会不会导致因果顺序颠倒?
这是 EDA 中一个容易被忽视但非常棘手的问题——跨服务的事件因果顺序。
首先,Kafka 只保证同一 partition 内的顺序,不保证跨 partition 的全局顺序。当多个服务消费同一事件并产生新事件时,新事件可能落在不同的 partition 中,导致因果倒置。
解决方案:
- 关键路径上用同一个 partition key: 确保同一实体(如订单)的所有相关事件都路由到同一个 partition,这样 Kafka 保证 partition 内的顺序。但这治标不治本——跨实体的因果仍然无法保证。
- 因果向量时钟(Vector Clock): 每个事件携带它依赖的因果上下文。消费方在收到事件时,检查所有前置事件是否已到达,未到达则暂存等待。这增加了复杂度,但在需要严格因果顺序的场景(如金融交易)中不可替代。
- 业务上接受不确定性: 在很多场景下,事件的因果顺序并不产生实际影响。比如"用户下单"和"用户修改地址"几乎同时发生,哪个先处理对最终结果没有本质差异。不要为了理论上的完美顺序而过度设计。
- 使用事件时间而非处理时间: 在事件中携带
occurredAt时间戳,消费方按事件时间排序而非消息到达时间。这需要一个时间窗口来容忍乱序,超出窗口的事件视为异常。
Q7:假设你要说服团队从同步调用迁移到事件驱动架构,你会怎么论证 ROI?你会先从哪里开始?
这是架构师面试中常见的"软技能"问题,考察的是技术之外的推动力和风险意识。
我的论证逻辑:
- 从痛点出发,不画饼: 列出当前同步调用链的 3 个具体问题——"上周三支付服务挂了导致订单服务一起不可用,影响 GMV 约 50 万"比"我们需要解耦"有力得多。
- 不追求"全面 EDA": 明确告诉团队,我们不是要重写整个系统。只对跨服务协作中最脆弱的 1-2 个链路引入事件驱动。比如"下单 -> 发短信"和"下单 -> 更新推荐模型"——这两个链路即使失败也不影响核心业务,是事件驱动最安全的入口。
- 渐进式迁移,不搞大爆炸: 第一步,在现有同步调用旁新增一个事件发布(双写);第二步,新消费者订阅事件,但保留同步调用作为降级;第三步,验证稳定后,去掉同步调用。每一步都有回退路径。
- 先非核心,后核心: 从"发短信""发推送""更新 ES 索引"这些非核心链路切入。这些链路失败不影响核心业务,即使事件丢失也有兜底。等团队积累了足够的 EDA 运维经验后,再逐步扩展到核心链路。
- 成本透明: 引入 Kafka 集群的运维成本、事件变更的兼容性管理成本、分布式追踪的额外投入——这些都要提前说清楚,而不是事后发现。
Q8:你提到事件溯源可以做"时间旅行"查询任意时间点的状态。但实际系统中,有些事件触发了外部 API 调用(比如发短信、调支付接口),你重放事件时难道要重新发短信、重新扣款吗?
这个问题直击事件溯源最核心的工程难题——副作用(Side Effect)与事件重放的冲突。如果回答不清楚,说明你只理解了事件溯源的理论,没有真正在生产环境落地过。
解决思路:把副作用也建模为事件。
- 事件溯源中的事件分两类: 一是状态变更事件(
OrderPlaced),二是副作用事件(SmsSent)。重放状态变更事件来重建聚合状态是正确的,但重放副作用事件不应该再次执行副作用。 - 在聚合的 apply 方法中,只更新状态,不执行副作用: 副作用由独立的
EventHandler处理,且EventHandler只处理一次(通过幂等检测)。 - 代码层面的隔离: 聚合的
apply()方法只做纯函数的状态转换,不发起任何外部调用。副作用统一由Saga/ProcessManager在事件持久化后处理。这样即使重放,也只重放状态变更,不会触发副作用。 - 终极方案——事件溯源时间旅行只在测试和调试中使用: 生产环境中,状态通过投影(Projection)实时维护,不需要重放。只有在需要"调试一个历史 bug"或"分析某个时间点的业务状态"时,才在隔离环境中重放事件,且外部 API 调用被 mock 掉。