阅读时间:约 40-45 分钟 难度:中等偏深 前置知识:分布式系统基础概念、消息队列基本认知
一、引言:为什么 Kafka 长这样?
Kafka 最初由 LinkedIn 开发,2011 年开源,如今已成为 Apache 顶级项目,是事实上的流处理平台标准。理解 Kafka 架构,不是背几个名词——而是理解它为什么这样设计,每个组件解决了什么问题。
Kafka 的核心设计目标只有三个:
- 高吞吐:单机轻松支撑数十万 QPS,支撑 LinkedIn 每天处理数万亿条消息
- 持久化:消息落盘,不丢数据,即使消费者宕机也能从任意位置重新消费
- 水平扩展:增加机器就能线性提升吞吐和容量
本文从 Broker 到 KRaft,逐层拆解 Kafka 架构。
二、总览:一张图看懂 Kafka 集群
先把全景图放在这里,后续每一节都会回到这张图来理解各组件的角色。
文章配图
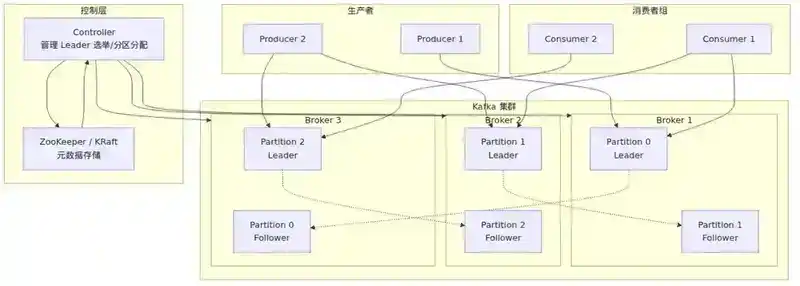
三、Broker:集群的"服务器节点"
3.1 什么是 Broker?
一个 Kafka Broker 就是一个 Kafka 服务进程。在生产环境中,一台物理机或一个容器通常运行一个 Broker 实例。多个 Broker 组成一个 Kafka 集群。
Broker 的核心职责:
- 接收 Producer 发来的消息,写入磁盘
- 响应 Consumer 的拉取请求,返回消息
- 参与集群协调(Controller 选举、分区 Leader 选举、ISR 维护)
- 与 ZooKeeper(或 KRaft 元数据仲裁层)保持心跳
3.2 Broker 的标识
每个 Broker 在集群中有一个唯一的整数 ID(broker.id),由配置文件指定。这个 ID 是 Broker 的"身份证号"——即使 IP 地址变了,只要 ID 不变,集群就认得它。
# server.properties
broker.id=0
listeners=PLAINTEXT://192.168.1.10:9092
log.dirs=/data/kafka-logs
3.3 Broker 的数据存储
Broker 最核心的工作是存储消息。Kafka 的存储设计极为精巧,这也是它高吞吐的根基:
- 顺序写磁盘:消息以追加(append-only)方式写入日志文件,避免随机 I/O
- 分段日志(Log Segment):每个 Partition 的日志被切分成多个 Segment 文件,便于清理和检索
- 索引文件:
.index(偏移量索引)和.timeindex(时间戳索引),支持快速定位
/data/kafka-logs/
  └── my-topic-0/           # Partition 0 的目录
      ├── 00000000000000000000.log       # 日志段
      ├── 00000000000000000000.index     # 偏移量索引
      ├── 00000000000000000000.timeindex # 时间戳索引
      └── leader-epoch-checkpoint       # Leader Epoch 检查点
3.4 Broker 的无状态设计
一个关键设计理念:Broker 不维护 Consumer 的消费状态。Offset 由 Consumer 自己管理(提交到内部 Topic __consumer_offsets 或外部存储)。这意味着 Broker 重启或替换后,Consumer 可以从原 Offset 继续消费,完全不受影响。
四、Topic:消息的"逻辑分类"
4.1 什么是 Topic?
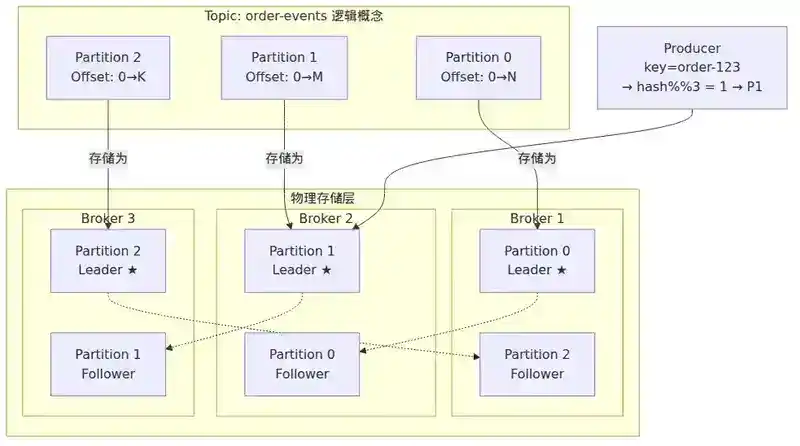
Topic 是 Kafka 中消息的逻辑分类。类比关系型数据库:Topic 就像"表"。Producer 向某个 Topic 发消息,Consumer 从某个 Topic 订阅消息。
一条消息的完整路径是:Topic → Partition → Offset
4.2 Topic 是逻辑概念,Partition 是物理概念
这是最容易混淆的地方:Topic 本身不存储任何数据。Topic 只是一个名字,用于将消息路由到对应的 Partition。数据实际存储在 Partition 中。
这就像"数据库"不存数据,数据存在"表空间"里一样——Topic 是一个命名空间。
4.3 Topic 的创建与元数据
创建 Topic 时需要指定:
- Partition 数量:决定并行度上限
- Replication Factor(副本因子):决定数据冗余度
# 创建 Topic:3 个分区,2 个副本(1 Leader + 1 Follower)
kafka-topics.sh --create \
  --topic order-events \
  --partitions 3 \
  --replication-factor 2 \
  --bootstrap-server localhost:9092
文章配图
五、Partition:Kafka 可扩展性的核心
5.1 为什么需要 Partition?
如果一个 Topic 的所有消息都存在一个文件里,会发生什么?
- 单文件会变得巨大,IO 成为瓶颈
- 只能被一个 Consumer 线程消费,无法并行
- 单机磁盘容量有限
Partition 解决了这三个问题:
- 每个 Partition 是一个独立的日志文件,分散到不同 Broker 的不同磁盘
- 多个 Consumer 可以并行消费不同 Partition
- 数据可以分布到整个集群
5.2 Partition 的本质:有序、不可变的日志
一个 Partition 就是一个有序的、不可变的、只追加的消息序列。每条消息在 Partition 内有一个唯一的递增序号——Offset。
Partition 0:
+----+----+----+----+----+----+
|  0 |  1 |  2 |  3 |  4 |  5 | ... → 时间
+----+----+----+----+----+----+
  ↑                         ↑
 最早                      最新
关键特性:
- 消息不可变:写入后不能修改,不能删除(只能按时间或大小清理)
- Offset 递增:保证 Partition 内的严格顺序
- 跨 Partition 无序:Partition 0 和 Partition 1 之间没有顺序保证
5.3 Partition 数量:不是越多越好
Partition 数量的选择是一个重要的设计决策:
| Partition 数量 | 优点 | 缺点 |
|---|---|---|
| 多 | 并行度高,吞吐大 | 文件句柄多,内存开销大,Leader 选举慢 |
| 少 | 管理开销小,恢复快 | 并行度受限,单 Partition 可能成为瓶颈 |
经验法则:
- Partition 数 ≈ max(期望吞吐 / 单 Partition 吞吐, Consumer 并行度)
- 单个 Broker 上 Partition 数不建议超过 4000(取决于硬件)
- 总 Partition 数 = Topic 数 × 平均 Partition 数 × 副本因子
5.4 消息路由到 Partition
Producer 发送消息时,需要决定消息进入哪个 Partition:
// 默认:key 的 hash 取模
int partition = Math.abs(key.hashCode()) % numPartitions;

// 指定 Partition
producer.send(new ProducerRecord<>("topic", partition, key, value));

// 不指定 key:轮询(Round-Robin)
producer.send(new ProducerRecord<>("topic", value));
有 key 的消息保证同一 key 的消息始终进入同一 Partition,从而保证该 key 的消息顺序。
六、Replica:数据的"保险丝"
6.1 副本机制概述
Kafka 的副本机制是数据可靠性的基石。每个 Partition 可以有 N 个副本(1 个 Leader + N-1 个 Follower),分布在不同的 Broker 上。
Partition 0:
  Broker 1: Leader (读写)
  Broker 2: Follower (同步)
  Broker 3: Follower (同步)
核心原则:所有读写都走 Leader。Follower 只负责从 Leader 同步数据,不对外提供服务。
6.2 Leader 与 Follower
- Leader:负责该 Partition 的所有读写请求。Producer 只向 Leader 写入,Consumer 只从 Leader 读取。
- Follower:从 Leader 被动拉取消息,保持数据同步。Follower 的存在只为容灾,不承担读负载。
为什么不让 Follower 分担读请求?
- 简化一致性模型:只有一个数据源,不需要处理读写分离的一致性窗口
- 避免"读到自己写的"问题:如果读 Follower 可能读到旧数据
- Kafka 的定位是高吞吐流处理,不是低延迟 KV 存储
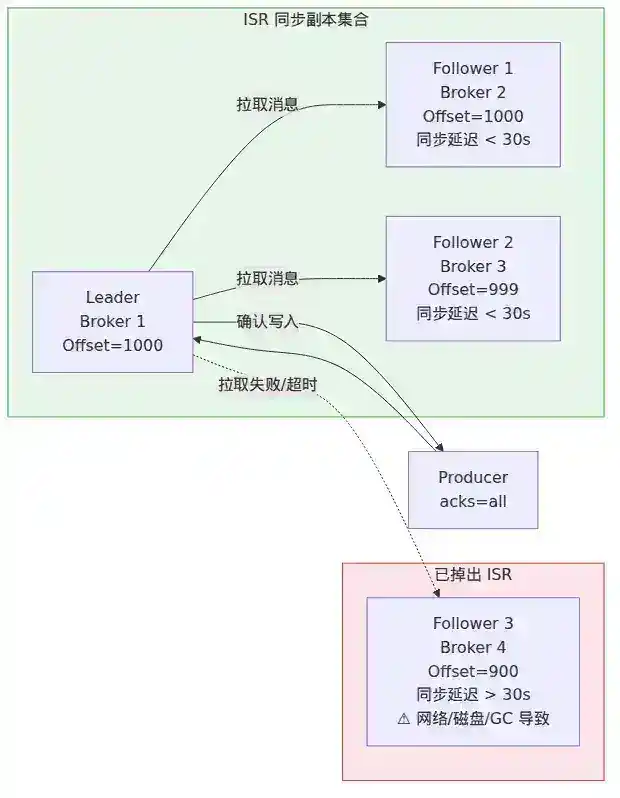
6.3 ISR(In-Sync Replicas)
ISR 是 Kafka 副本机制中最重要的概念。ISR 是一组与 Leader 保持同步的副本集合。
ISR = [Leader 所在 Broker] + [追上 Leader 的 Follower]
Follower 满足以下条件才能留在 ISR 中:
- 与 ZooKeeper 保持活跃会话(心跳不超时)
- 在
replica.lag.time.max.ms(默认 30s)内追上 Leader 的最新消息
文章配图
6.4 acks 参数与副本的关系
Producer 的 acks 参数直接影响副本间的数据一致性:
| acks | 含义 | 延迟 | 可靠性 |
|---|---|---|---|
| 0 | 不等待确认 | 最低 | 可能丢消息 |
| 1 | Leader 写入成功即确认 | 低 | Leader 宕机可能丢 |
| -1 / all | 所有 ISR 副本写入成功 | 较高 | 最高可靠性 |
// 最高可靠性配置
props.put("acks", "all");                    // 等待所有 ISR 确认
props.put("min.insync.replicas", 2);         // 至少 2 个副本在 ISR 中
props.put("retries", Integer.MAX_VALUE);     // 无限重试
props.put("enable.idempotence", true);       // 开启幂等
min.insync.replicas 是一个关键安全参数:如果 ISR 中的副本数小于这个值,Producer 写入会被拒绝,防止数据可靠性降级。
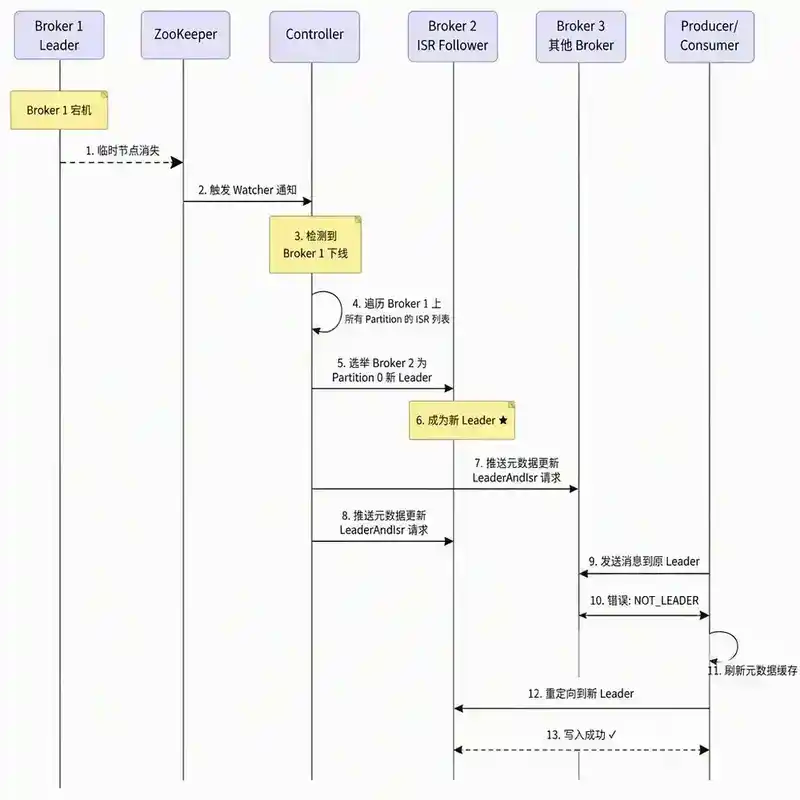
6.5 Leader 选举
当 Leader 宕机时,Controller 需要从 ISR 中选出一个新 Leader:
- Controller 检测到 Broker 下线(ZooKeeper 临时节点消失 / KRaft 心跳超时)
- 从该 Partition 的 ISR 中选出一个存活的 Follower
- 将新 Leader 信息通知给所有相关 Broker
- Producer 和 Consumer 重定向到新 Leader
为什么从 ISR 中选? 因为 ISR 中的副本与 Leader 数据一致,选它做新 Leader 不会丢数据。
文章配图
七、Controller:集群的"大脑"
7.1 Controller 是什么?
Controller 是 Kafka 集群中一个特殊的 Broker,负责集群级别的管理操作。整个集群在任意时刻只有一个 Controller。
Controller 的职责:
- 分区 Leader 选举:当 Broker 宕机时,为受影响的分区选举新 Leader
- 分区分配:新 Topic 创建时,将 Partition 分配到 Broker
- 副本管理:维护 ISR 列表,处理 Follower 的加入和退出
- 集群元数据管理:Topic 的增删改,Partition 的扩缩容
- Broker 上下线管理:监听 Broker 的加入和退出
7.2 Controller 选举
Controller 选举通过 ZooKeeper 实现:
- 所有 Broker 启动时,尝试在 ZooKeeper 的
/controller路径创建临时节点 - 第一个创建成功的 Broker 成为 Controller
- 其他 Broker 在
/controller上注册 Watcher - 当 Controller 宕机,临时节点被 ZooKeeper 删除,所有 Watcher 被触发
- 存活的 Broker 重新竞争创建
/controller节点
// 伪代码:Controller 选举
if (zkClient.createEphemeral("/controller", brokerId)) {
    becomeController();  // 我成功了,我是 Controller
} else {
    watchController();   // 别人是 Controller,我等着
}
7.3 Controller 的故障切换
Controller 宕机后的影响:
- 选出一个新 Controller(通常 1-2 秒)
- 新 Controller 从 ZooKeeper 读取最新的集群元数据
- 处理宕机 Controller 所负责的 Partition 的 Leader 选举
- 向所有 Broker 同步新的元数据
这段时间内,已有 Leader 的 Partition 读写不受影响,只有需要 Leader 选举的 Partition 会短暂不可用。
7.4 Controller 的局限性
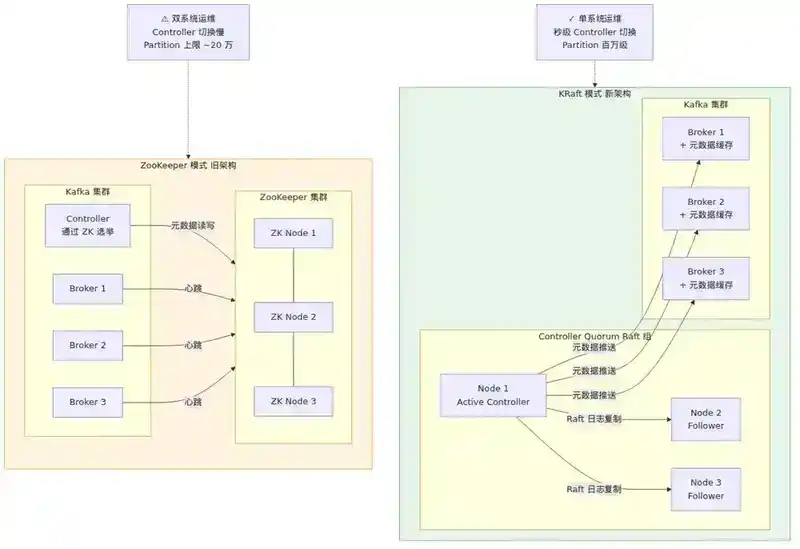
ZooKeeper 时代的 Controller 有一个痛点:元数据加载慢。当 Controller 切换时,新 Controller 需要从 ZooKeeper 全量加载所有 Topic/Partition 的元数据,集群规模大时(比如 10 万+ Partition),这个过程可能需要几十秒甚至几分钟。
这正是 KRaft 想要解决的核心问题之一。
八、KRaft:去 ZooKeeper 化的新时代
8.1 为什么需要 KRaft?
Kafka 从诞生起就依赖 ZooKeeper 存储元数据。但随着集群规模增长,ZooKeeper 成为瓶颈:
| 问题 | 说明 |
|---|---|
| 元数据瓶颈 | 所有 Broker 的元数据变更都要经过 ZooKeeper |
| 双系统运维 | 需要同时运维 Kafka 和 ZooKeeper 两套系统 |
| Controller 切换慢 | 全量元数据加载耗时长 |
| 元数据一致性 | Kafka 和 ZooKeeper 的状态可能不一致 |
| 扩展限制 | Partition 数量受 ZooKeeper 节点数限制(建议 < 20 万) |
KRaft(Kafka Raft) 是 Kafka 从 2.8 版本开始引入的自管理元数据模式,在 3.3.1 版本标记为生产可用(Production Ready),在 4.0 版本中 ZooKeeper 模式被完全移除。
8.2 KRaft 的核心设计
KRaft 基于 Raft 共识协议,用 Kafka 自己的日志机制来管理元数据:
KRaft 架构:
┌──────────────────────────────────┐
│  Controller Quorum (Raft 组)     │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │ Node 1 │ │ Node 2  │ │ Node 3  │ │
│  │(Leader) │ │(Follower)│ │(Follower)│ │
│  └─────────┘ └─────────┘ └─────────┘ │
│         ↓ 元数据日志复制              │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │Broker 1 │ │Broker 2 │ │Broker 3 │ │
│  └─────────┘ └─────────┘ └─────────┘ │
└──────────────────────────────────┘
关键概念:
- Controller Quorum:3 或 5 个节点组成的 Raft 组,负责元数据的共识存储
- 元数据日志:一个特殊的 Kafka 内部 Topic(
__cluster_metadata),以 Raft 协议复制 - Active Controller:Raft 组的 Leader,相当于旧架构中的 Controller
- Metadata Version:类似 Raft 的 term,防止脑裂
8.3 KRaft 相比 ZooKeeper 的优势
| 维度 | ZooKeeper 模式 | KRaft 模式 |
|---|---|---|
| 部署复杂度 | 需部署 ZooKeeper 集群 | 仅需 Kafka,自带元数据仲裁 |
| 元数据一致性 | 可能不一致 | 强一致(Raft 协议) |
| Controller 切换 | 需全量加载,慢 | 元数据日志已同步,秒级切换 |
| Partition 上限 | ~20 万 | 百万级 |
| 运维复杂度 | 高(两套系统) | 低(一套系统) |
| 恢复时间 | 分钟级 | 秒级 |
8.4 KRaft 的迁移路径
从 ZooKeeper 迁移到 KRaft 的典型路径:
- 原地升级:Kafka 2.8+ 支持 KRaft 模式,可与 ZooKeeper 模式并存(过渡期)
- 滚动迁移:逐个 Broker 从 ZooKeeper 模式切换到 KRaft 模式
- 最终切换:所有 Broker 切换到 KRaft,关闭 ZooKeeper 集群
文章配图
九、各组件协同工作:从消息生产到消费
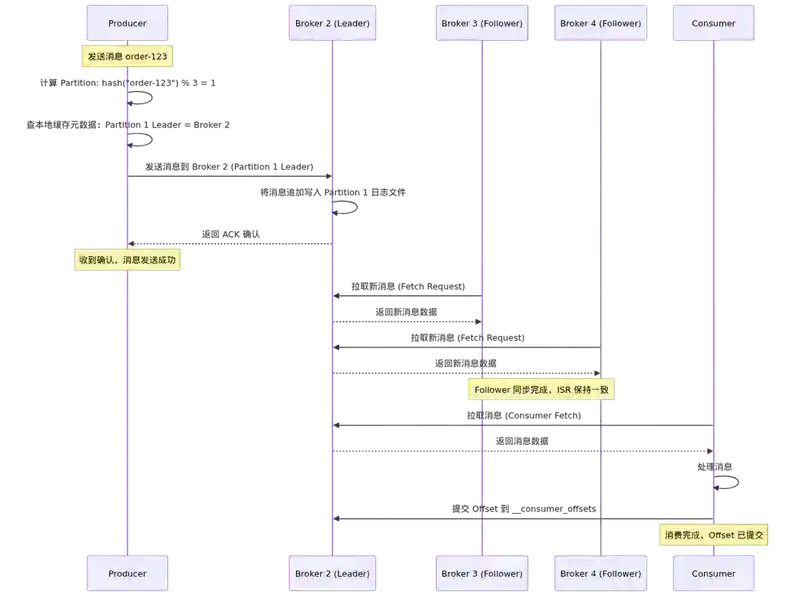
9.1 一条消息的完整旅程
让我们跟踪一条消息从诞生到被消费的完整路径:
1. Producer 发送消息到 Topic "order-events",key="order-123"
2. Producer 计算 Partition:hash("order-123") % 3 = 1 → Partition 1
3. Producer 从本地缓存的元数据中查找 Partition 1 的 Leader(Broker 2)
4. Producer 将消息发送到 Broker 2
5. Broker 2(Leader)将消息写入 Partition 1 的日志文件
6. Broker 2 返回确认给 Producer
7. Broker 3 和 Broker 4(Follower)从 Broker 2 拉取新消息
8. Consumer Group 中的某个 Consumer 从 Broker 2 拉取 Partition 1 的消息
9. Consumer 处理消息后提交 Offset 到 __consumer_offsets
文章配图
9.2 元数据的传播路径
Kafka 集群中,元数据的传播是异步的,不是瞬间完成的:
- Controller → Broker:Controller 通过直接的 RPC 连接,将元数据变更推送给所有 Broker
- Broker → Producer/Consumer:Producer/Consumer 定期从任意 Broker 拉取元数据(
metadata.max.age.ms,默认 5 分钟),或收到错误后强制刷新
这意味着元数据变更后,Producer/Consumer 可能短暂地持有过期的元数据,导致请求发送到错误的 Broker。Kafka 通过重试 + 刷新元数据的机制来处理这种情况。
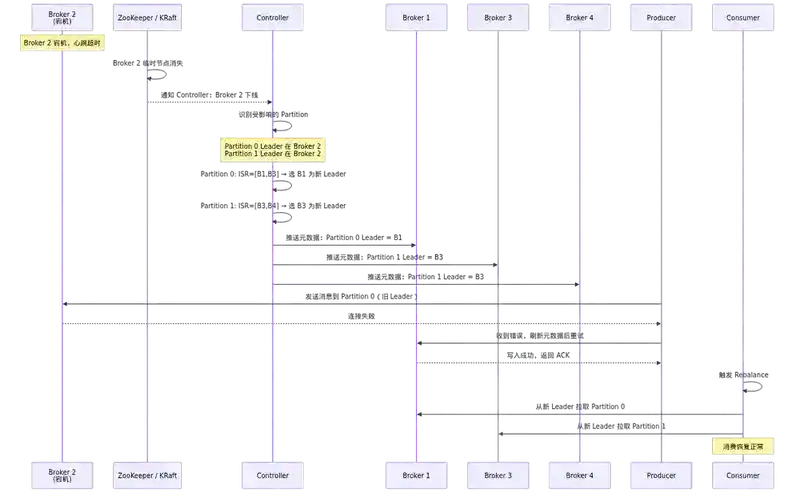
9.3 故障场景下的协作
场景:Broker 宕机
1. Broker 2(多个 Partition 的 Leader)宕机
2. Controller 通过 ZooKeeper 检测到 Broker 2 下线
3. Controller 为 Broker 2 上的所有 Partition 选举新 Leader
    - Partition 0: 从 ISR [Broker 1, Broker 3] 中选 Broker 1
    - Partition 1: 从 ISR [Broker 3, Broker 4] 中选 Broker 3
4. Controller 将新 Leader 信息推送给所有 Broker
5. Producer 收到 NOT_LEADER_FOR_PARTITION 错误后刷新元数据
6. Consumer 触发 Rebalance,重新分配 Partition
7. 系统恢复正常
文章配图
十、关键设计权衡与常见误区
10.1 Partition 数 vs 吞吐
误区:"Partition 越多,吞吐越大"
事实:Partition 数增加带来的收益是边际递减的。当 Partition 数超过某个阈值后:
- 每个 Partition 的 Leader 选举变慢
- 文件句柄和内存占用线性增长
- Producer 的批量发送效率降低(每个 Partition 的消息不够"攒批")
10.2 副本数 vs 延迟
误区:"副本越多越安全"
事实:acks=all 时,副本数越多,写入延迟越高(需要等待更多 Follower 确认)。对于大多数场景,副本因子=3 是性价比最高的选择。
10.3 Controller 不是瓶颈
误区:"Controller 是性能瓶颈"
事实:Controller 只处理元数据变更(Leader 选举、Topic 创建等),不参与数据平面的读写。在稳定运行的集群中,Controller 的负载很低。只有在大量 Broker 频繁上下线或大量 Partition 迁移时,Controller 才会成为瓶颈。
十一、总结
Kafka 架构的核心思想可以归结为分层解耦:
| 层次 | 组件 | 解决的问题 |
|---|---|---|
| 逻辑层 | Topic | 消息分类,面向业务 |
| 分片层 | Partition | 水平扩展,并行处理 |
| 存储层 | Broker + 日志段 | 持久化,高吞吐 I/O |
| 容错层 | Replica + ISR | 数据冗余,高可用 |
| 控制层 | Controller / KRaft | 集群协调,元数据管理 |
理解这些组件的分工与协作,是深入掌握 Kafka 的基石。下一篇我们将深入 Kafka 的高吞吐机制——顺序写、零拷贝、页缓存和批处理。
十二、面试官提问
以下问题从面试官视角设计,考察候选人对 Kafka 架构的深层理解,而非简单复述概念。
Q1:一个 Topic 有 10 个 Partition、3 个副本,部署在 5 个 Broker 上。请画出 Leader 分布的最优方案,并说明为什么这样分配。
Q2:说出**acks=all**和**min.insync.replicas=1**组合的实际效果,以及为什么这是一个"危险的配置"。
Q3:如果 Controller 选举出新 Leader 后,原来的 Leader 又恢复了(网络分区恢复),会发生什么?Kafka 如何防止脑裂?
Q4:在 KRaft 模式下,Controller Quorum 有 3 个节点,其中 1 个宕机。此时还能正常选举 Leader 吗?为什么必须用奇数个节点?
Q5:Producer 设置了**acks=all**,但发送消息时只返回了**RECORD_ERROR**。排查后发现 ISR 中只有 Leader 自己。请分析可能的原因,并给出解决方案。
Q6:为什么 Kafka 设计成 Consumer 从 Leader 读而不是从 Follower 读?如果让你设计一个支持 Follower 读的 Kafka 变体,你会做哪些改动?
Q7:一个集群有 10000 个 Partition,Controller 切换需要 30 秒。在新 Controller 加载元数据期间,正在运行的 Producer 和 Consumer 会受影响吗?为什么?
参考答案
A1:Leader 分布最优方案
最优方案是让每个 Broker 承担相同数量的 Leader,即每个 Broker 恰好承担 2 个 Leader(10 个 Partition × 1 Leader / 5 Broker = 2)。
         Broker 1  Broker 2  Broker 3  Broker 4  Broker 5
P0:      Leader    Follower  Follower
P1:      Follower  Leader    Follower
P2:      Follower  Follower  Leader
P3:                Leader    Follower  Follower
P4:                Follower  Leader    Follower
P5:                Follower  Follower  Leader
P6:                          Leader    Follower  Follower
P7:                          Follower  Leader    Follower
P8:                          Follower  Follower  Leader
P9:      Follower                      Leader    Follower
分配原则:Kafka 使用轮询(Round-Robin)分配策略,将 Partition 的 Leader 尽量均匀分布。这样做的核心原因:只有 Leader 负责读写,均匀分布意味着负载均衡,避免某个 Broker 成为热点。同时,同一 Partition 的副本必须在不同 Broker 上(否则副本没有容灾意义)。
A2:**acks=all**+**min.insync.replicas=1**的危险性
这个组合下的实际效果:Producer 等待所有 ISR 副本确认,但 ISR 的最小数量是 1。这意味着只要 Leader 在 ISR 中(它永远在),写入就能成功——即使所有 Follower 都掉线。
危险场景:所有 Follower 因网络抖动或 GC 暂停被踢出 ISR,此时 ISR = [Leader]。Producer 继续写入成功,Consume 也正常。如果此时 Leader 宕机,由于没有 Follower 在 ISR 中,该 Partition 将不可用(no ISR member available for leader election),且最后一批写入 ISR 只有 Leader 的数据全部丢失。
正确配置:min.insync.replicas 至少设为 2,典型配置为 replication-factor=3, min.insync.replicas=2, acks=all。这样即使一个 Follower 掉线,写入仍能继续;只有当两个副本都掉线时才会拒绝写入,确保数据不会丢。
A3:原 Leader 恢复后的脑裂防护
当原 Leader(Broker A)因网络分区被隔离,Controller 选举了 Broker B 为新 Leader。网络分区恢复后,Broker A 重新连回集群。
Kafka 的防护机制——Leader Epoch(纪元):
- 每个 Partition 有一个 Leader Epoch(单调递增的整数),每次 Leader 变更时 Epoch 加 1
- 新 Leader(Broker B)的 Epoch 比旧 Leader(Broker A)大
- Broker A 恢复后,发现自己不是 Leader 了(通过 Controller 的元数据通知),自动降级为 Follower
- Broker A 向新 Leader 发起 Truncate(截断):将自己的日志截断到与新 Leader 一致的 Offset,丢弃在分区期间"自以为是 Leader"时写入的脏数据
关键点:Kafka 不依赖 ZooKeeper 来防止脑裂,而是用 Leader Epoch + Controller 单一权威 来保证。旧 Leader 不会尝试继续写入,而是立刻降级,这避免了"双写"问题。
A4:KRaft 3 节点宕机 1 个的情况
可以正常选举。Raft 共识协议要求**多数派(majority)**存活才能选举 Leader。3 个节点中 1 个宕机,还剩 2 个,2 > 3/2 = 1.5,仍然满足多数派要求。
为什么必须用奇数个节点?
以 3 节点和 4 节点对比:
| 节点数 | 容忍故障数 | 多数派阈值 |
|---|---|---|
| 3 | 1 | 2 |
| 4 | 1 | 3 |
4 节点和 3 节点的容错能力相同(都是 1 个),但 4 节点多了一台机器的成本和运维复杂度。奇数节点以最低成本获得最大容错能力。生产环境推荐 3 或 5 个 Controller Quorum 节点。
A5:ISR 中只有 Leader 的排查与解决
acks=all 但 ISR 中只有 Leader 自己,说明所有 Follower 都掉出了 ISR。
可能原因:
- Follower 所在 Broker 宕机:最常见,直接检查 Broker 存活状态
- Follower 同步滞后:Follower 跟不上 Leader 的写入速度,在
replica.lag.time.max.ms(默认 30s)内未能追上,被踢出 ISR - 网络问题:Follower 所在 Broker 与 Leader 之间的网络延迟过高或丢包
- 磁盘 I/O 瓶颈:Follower 磁盘写入慢,导致同步落后
- GC 暂停:Follower Broker 发生长时间 GC,导致无法及时拉取消息
排查步骤:
- 检查
kafka-topics.sh --describe --topic <topic>查看 ISR 状态 - 检查 Follower Broker 的日志,搜索
Shrinking ISR关键字 - 检查 Broker 之间的网络延迟和丢包率
- 检查 Follower Broker 的磁盘 I/O 和 GC 日志
解决方案:
- 增大
replica.lag.time.max.ms(如从 30s 调到 60s),给 Follower 更多追赶时间 - 优化 Follower Broker 的硬件(SSD、更多内存)
- 确保
min.insync.replicas >= 2,当 ISR 缩容到 1 时拒绝写入保护数据
A6:为什么不从 Follower 读?
Kafka 的设计权衡:
- 一致性简化:只有 Leader 一个数据源,不存在"读 Follower 可能读到旧数据"的一致性问题。如果支持 Follower 读,需要处理 Read-your-writes 一致性,复杂度大幅增加
- Kafka 的定位:Kafka 是高吞吐流处理平台,不是低延迟 KV 存储。Consumer 是批量拉取(pull model),对延迟不敏感,Leader 读不会成为瓶颈
- 分区级别并行:读的并行度通过增加 Partition 数来实现,而不是通过 Follower 分担读请求
- 顺序保证:Kafka 保证 Partition 内的消息顺序,如果某个 Consumer 从 Follower 读到滞后数据,会破坏顺序消费的语义
如果设计支持 Follower 读的变体,需要做的改动:
- 引入水位线(High Watermark)同步:Consumer 需要知道 Follower 的同步进度,只读已提交的 Offset
- 引入一致性级别:类似数据库的 Read Concern,允许 Consumer 选择"强一致读 Leader"或"最终一致读 Follower"
- 元数据增强:Consumer 需要知道每个副本的同步状态,以决定从哪个副本读
- 引入滞后容忍阈值:如果 Follower 落后太多,自动切回 Leader 读
这本质上是 KIP-392(Consumer 从 Follower 读) 讨论的方向,但 Kafka 社区最终认为收益有限而复杂度太高,没有采纳。
A7:Controller 切换期间的影响分析
对 Producer 的影响:基本不受影响。Producer 写入的是 Partition Leader,而 Leader 是数据平面的概念。Controller 切换只影响控制平面。只要 Partition 的 Leader 还在,Producer 就能正常写入。只有那些原 Controller 宕机导致 Leader 也需要重新选举的 Partition,Producer 才会短暂收到 NOT_LEADER_FOR_PARTITION 错误,通过重试+刷新元数据自动恢复。
对 Consumer 的影响:基本不受影响。Consumer 从 Leader 拉取数据,与 Producer 同理。但如果 Controller 切换触发了 Rebalance(比如 Consumer Group Coordinator 恰好在新旧 Controller 切换时也变了),Consumer 会短暂停顿后重新分配分区。
真正受影响的操作:在 Controller 加载元数据的 30 秒内,以下操作会被阻塞:
- 创建/删除 Topic
- 增加 Partition
- 任何需要 Controller 介入的元数据变更
为什么数据平面不受影响:Kafka 架构的精妙之处在于数据平面与控制平面的分离。元数据缓存在每个 Broker 本地,Producer/Consumer 也缓存了元数据,不需要每次都向 Controller 查询。Controller 只负责在元数据变更时推送更新。