一、消费者组:为什么需要它?
Kafka 的设计哲学里有一条极其重要的原则:消费端横向扩展不靠增加单个消费者的处理能力,而是靠增加消费者数量。但单纯增加消费者实例会带来一个致命问题——多个消费者同时消费同一个分区,消息顺序无法保证,重复消费也难以避免。
消费者组(Consumer Group)正是为解决这个问题而生的。
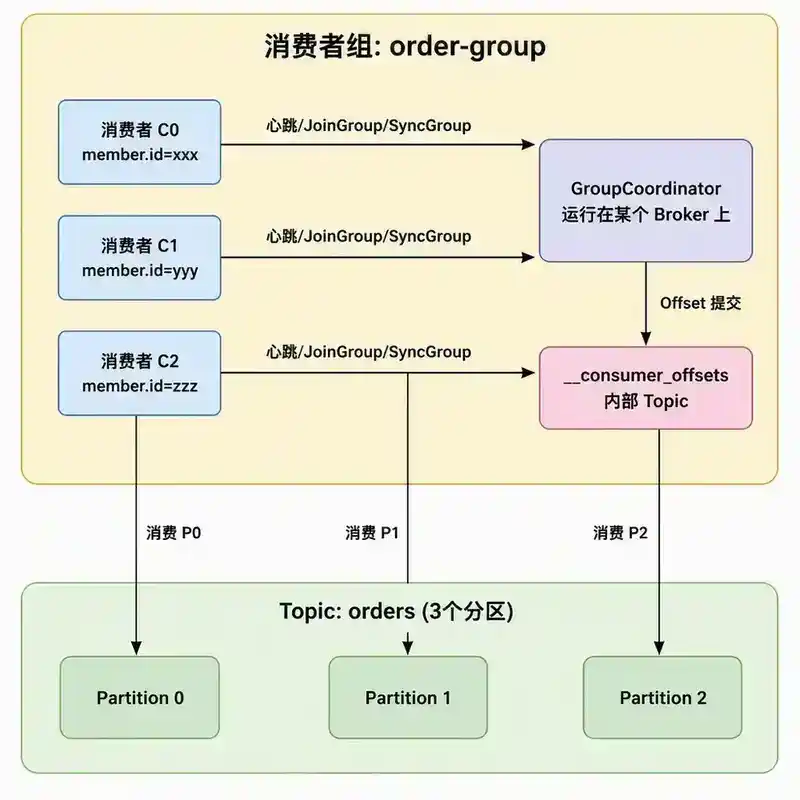
一个消费者组内的所有消费者共同消费一个或多个主题。最核心的约束是:同一个分区在同一个消费者组内,只能被一个消费者实例消费。这意味着:
- 如果你想并发消费,方式不是让多个消费者抢同一个分区,而是增加分区数,让每个消费者独自分担若干分区。
- 消费者组内的消费者数量不能超过主题的总分区数,多余的消费者会处于空闲状态。
用一句话概括:消费者组是 Kafka 消费端水平扩展和容错的基本单元。
消费者组的两种消费模式
| 模式 | 配置 | 行为 |
|---|---|---|
| 队列模式(点对点) | 所有消费者属于同一个 Group | 每条消息只被组内一个消费者处理 |
| 发布/订阅模式 | 每个消费者属于不同 Group | 每条消息被所有 Group 各自消费一次 |
同一个 Topic 可以被多个消费者组同时订阅,各组独立维护自己的消费进度(Offset)。这是 Kafka 相比传统消息队列的一个显著优势——一份数据,多路消费,互不干扰。
二、分区分配:谁消费哪个分区?
当消费者组内的消费者数量发生变化(加入或退出),或者 Topic 的分区数发生变化时,Kafka 需要重新决定"哪个消费者负责消费哪些分区"。这个决策由**分区分配策略(PartitionAssignor)**来完成。
Kafka 社区提供了四种内置分配策略,下面逐一解析。
2.1 RangeAssignor(范围分配)
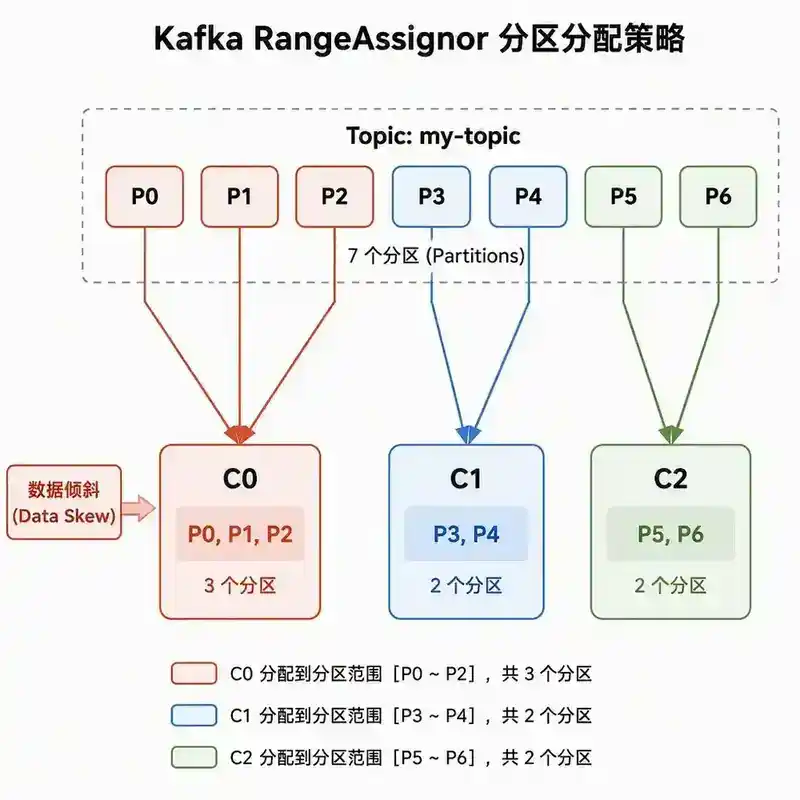
原理:按主题维度,对每个主题的分区排序后,按范围均分给消费者。
示例:Topic-A 有 7 个分区(P0-P6),消费者组有 3 个消费者(C0, C1, C2)

分配结果:
C0 → P0, P1, P2 (⌈7/3⌉ = 3 个分区)
C1 → P3, P4 (2 个分区)
C2 → P5, P6 (2 个分区)
缺点:当订阅了多个主题时,前面的消费者可能被分配到更多分区,导致数据倾斜。这是 Kafka 默认分配策略,也是使用最广泛的——但并不意味着它是最好的。
2.2 RoundRobinAssignor(轮询分配)
原理:将所有主题的所有分区展开成一个列表,按轮询方式依次分配给消费者。
示例:Topic-A (P0-P2) 和 Topic-B (P0-P2),消费者 C0, C1

分配结果:
C0 → A-P0, A-P2, B-P1
C1 → A-P1, B-P0, B-P2
优点:分配均匀,最大差值不超过 1。
缺点:当消费者组发生 Rebalance 时,轮询分配会导致大量分区被重新分配,即使只是新增了一个消费者。
2.3 StickyAssignor(粘性分配)
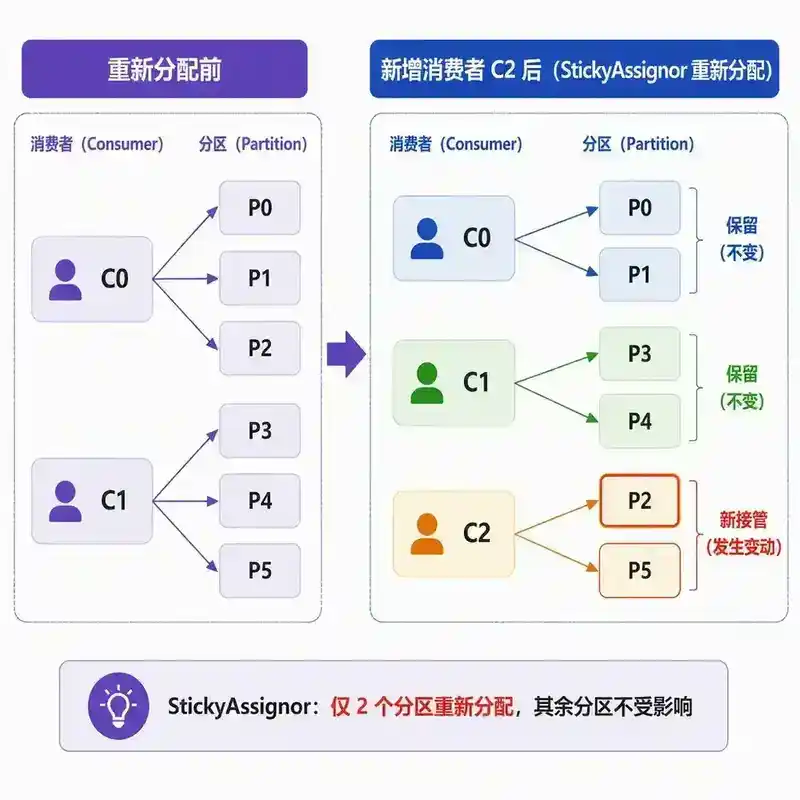
原理:在保证分配均匀的前提下,尽可能保持原有的分配关系不变。这是 Kafka 0.11 引入的改进。
核心价值:Rebalance 时,只有被重新分配的分区需要暂停消费和恢复,其他分区不受影响。
假设原有分配:
C0 → P0, P1, P2
C1 → P3, P4, P5

新增 C2 后,Sticky 策略:
C0 → P0, P1 (保留了 P0, P1)
C1 → P3, P4 (保留了 P3, P4)
C2 → P2, P5 (接管了 P2, P5)
对比 RoundRobin 可能把全部 6 个分区都打乱重分,Sticky 只动了 2 个分区。这就是"粘性"的含义。
2.4 CooperativeStickyAssignor(协作式粘性分配)
原理:在 StickyAssignor 的基础上,引入渐进式 Rebalance。这是 Kafka 2.4 引入的重大改进,也是目前推荐的生产环境首选。
传统 Rebalance 的问题在于"Stop-The-World":Rebalance 期间,整个消费者组的所有消费者都停止消费。CooperativeStickyAssignor 的做法是:
- 第一轮 Rebalance:只撤销那些需要被重新分配的分区,其余分区继续正常消费
- 第二轮 Rebalance:将撤销的分区重新分配给目标消费者
这样,大部分分区在 Rebalance 过程中不受影响,大幅降低了消费延迟。
分配策略选型建议
| 策略 | 适用场景 | 推荐度 |
|---|---|---|
| Range | 简单场景,每个消费者订阅相同主题 | ⭐⭐ |
| RoundRobin | 要求严格均匀分配 | ⭐⭐ |
| Sticky | 对 Rebalance 开销敏感 | ⭐⭐⭐ |
| CooperativeSticky | 生产环境通用推荐 | ⭐⭐⭐⭐⭐ |
三、Offset:消费进度的"书签"
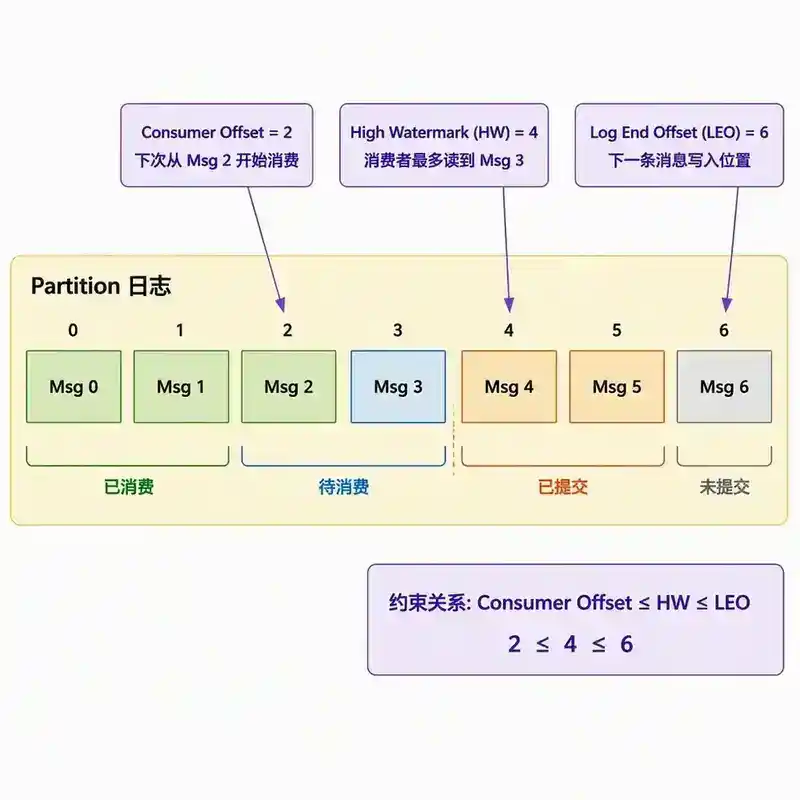
Offset 是 Kafka 消费者最核心的元数据之一。它记录了消费者"读到了哪里",是消费进度的"书签"。
3.1 三种 Offset
| Offset 类型 | 位置 | 说明 |
|---|---|---|
| LEO(Log End Offset) | Broker 端 | 分区下一条消息将被写入的位置 |
| HW(High Watermark) | Broker 端 | 已提交(ISR 全部同步)的消息偏移量,消费者最多读到 HW-1 |
| Consumer Offset | Consumer 端 | 消费者当前消费到的位置,下次从该位置继续消费 |
关键关系:Consumer Offset ≤ HW ≤ LEO
3.2 Offset 提交机制
自动提交(enable.auto.commit=true):
- 由
auto.commit.interval.ms控制提交频率(默认 5 秒) - 简单,但可能导致重复消费(提交前崩溃)或消息丢失(提交后处理失败)
手动提交(enable.auto.commit=false):
- 同步提交
commitSync():阻塞直到 Broker 确认,可靠性高,吞吐量低 - 异步提交
commitAsync():非阻塞,吞吐量高,但不保证提交成功 - 推荐组合:正常流程用异步提交,关闭时用同步提交兜底
// 推荐提交模式
try {
 while (true) {
 ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
 processRecords(records);
 consumer.commitAsync(); // 异步提交,不阻塞
 }
} catch (Exception e) {
 // 处理异常
} finally {
 try {
 consumer.commitSync(); // 最后同步提交,确保不丢 offset
 } finally {
 consumer.close();
 }
}
3.3 __consumer_offsets 内部主题
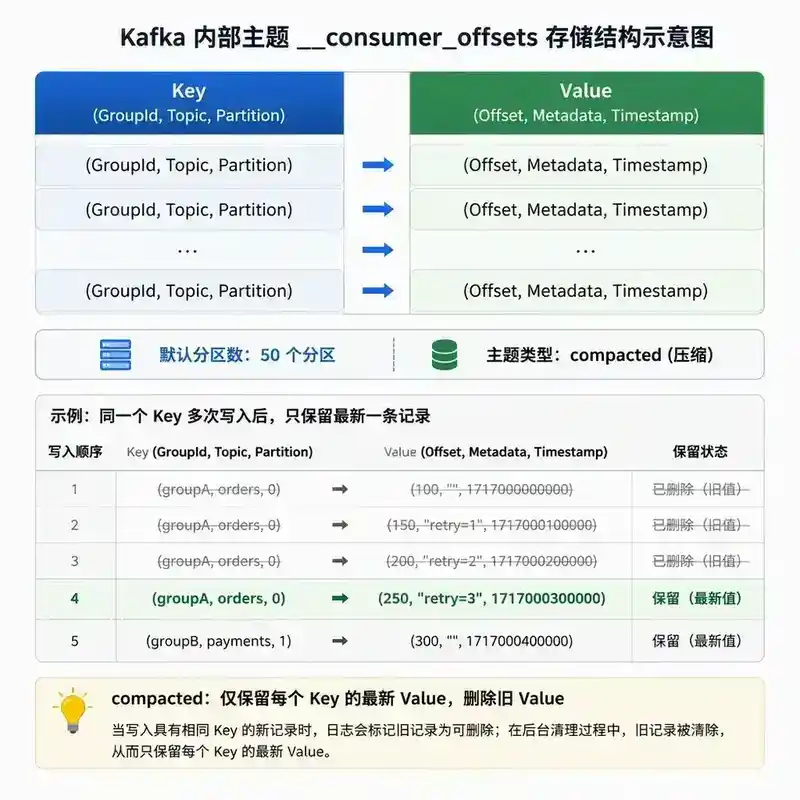
消费者提交的 Offset 存储在 Kafka 内置的 __consumer_offsets 主题中(默认 50 个分区)。这个主题是**压缩类型(compacted)**的,只保留每个 Key 的最新值。
Key 格式:(GroupId, Topic, Partition) → Value:(Offset, Metadata, Timestamp)
为什么 Kafka 把 Offset 存在自己的 Topic 里而不是 ZooKeeper 里?
- ZooKeeper 不适合高频写入(消费者每 5 秒提交一次 Offset)
- 利用 Kafka 自身的日志结构,天然支持顺序写入和高吞吐
- 简化架构,减少外部依赖
3.4 Offset 重置策略
当消费者组的 Offset 信息过期(offsets.retention.minutes 默认 7 天)或被删除时,auto.offset.reset 决定如何定位:
- earliest:从分区最早的消息开始消费
- latest:从分区最新的消息开始消费(跳过历史数据)
- none:找不到 Offset 时直接抛出异常
四、Rebalance:消费者组的"地震"
4.1 什么是 Rebalance?
Rebalance 是一组协议交互,让消费者组内的所有消费者就"谁消费哪些分区"达成一致。每次 Rebalance 期间,消费者组内的所有消费者暂时停止消费(Stop-The-World),直到新的分配方案确定。
4.2 触发条件
| 触发条件 | 说明 |
|---|---|
| 消费者加入 | 新消费者加入消费者组 |
| 消费者退出 | 主动关闭、崩溃、长时间未发送心跳 |
| 主题分区数变化 | 新增分区(很少见,但会触发) |
| 订阅的主题变化 | 消费者通过正则订阅匹配到新主题 |
max.poll.interval.ms 超时 |
两次 poll 间隔超过阈值,消费者被踢出组 |
4.3 Rebalance 协议流程
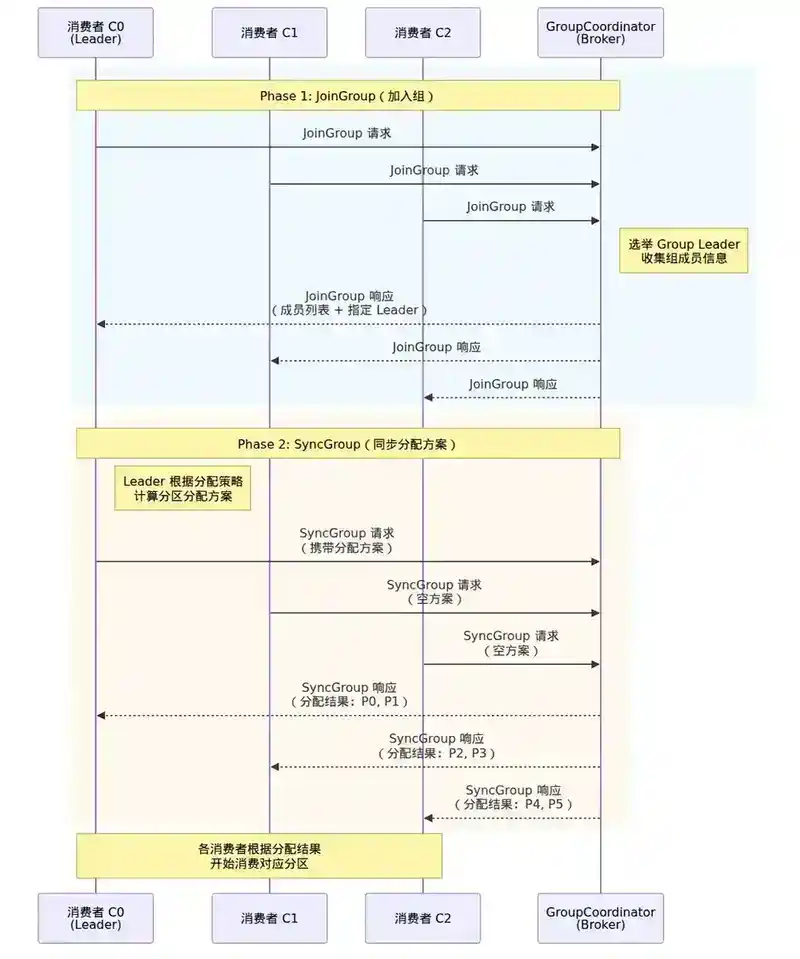
Rebalance 分为两个阶段,协调者是 GroupCoordinator(运行在某个 Broker 节点上):
Phase 1:JoinGroup(加入组)
- 每个消费者向 GroupCoordinator 发送
JoinGroup请求 - GroupCoordinator 选择一个消费者作为 Group Leader
- GroupCoordinator 将组成员列表和订阅信息发给 Group Leader
Phase 2:SyncGroup(同步分配方案)
- Group Leader 根据分区分配策略计算分配方案
- Group Leader 将分配方案通过
SyncGroup请求发给 GroupCoordinator - GroupCoordinator 将分配结果分发给各消费者
- 各消费者根据分配结果开始消费
4.4 Rebalance 的代价
Rebalance 是整个消费者组架构中最"昂贵"的操作:
- Stop-The-World:全组停止消费,延迟增加
- 重新分配分区:分区可能被分配给不同消费者,需要重新建立连接
- 重新定位 Offset:消费者需要从 Broker 拉取最新的提交 Offset
- GC 暂停风险:大量分区的重分配可能导致短暂的内存压力
如果一个消费者组频繁发生 Rebalance(比如每分钟一次),整个消费链路几乎不可用。
4.5 Rebalance 优化
核心原则:减少不必要的 Rebalance 次数,降低每次 Rebalance 的影响范围。
| 优化手段 | 配置项 | 说明 |
|---|---|---|
| 调大心跳间隔 | session.timeout.ms |
避免因短暂网络抖动触发 Rebalance |
| 调大 poll 间隔 | max.poll.interval.ms |
避免处理耗时过长被踢出 |
| 使用 CooperativeSticky | partition.assignment.strategy |
渐进式 Rebalance,减少影响范围 |
| 消费者优雅关闭 | 发送 LeaveGroup 请求 | 触发立即 Rebalance,避免等待超时 |
| 固定消费者实例 | group.instance.id |
静态成员,见下文 |
4.6 常见 Rebalance 问题排查
问题一:消费者不断加入又退出
可能原因:max.poll.interval.ms 设置过小,消息处理时间超过阈值。解决:增大 max.poll.interval.ms 或减小 max.poll.records。
问题二:Rebalance 后消费延迟飙升
可能原因:Rebalance 期间全组停止消费,积压了大量消息。解决:使用 CooperativeStickyAssignor 减少 Stop-The-World 时间。
问题三:频繁 Rebalance 但不知道为什么
排查思路:
- 检查消费者日志中的
(Re-)joining group关键字 - 确认
session.timeout.ms和max.poll.interval.ms配置是否合理 - 检查是否有 Full GC 导致心跳超时
- 使用
kafka-consumer-groups.sh --describe查看消费者组状态
五、静态成员:让消费者"持久化"身份
5.1 静态成员解决了什么问题?
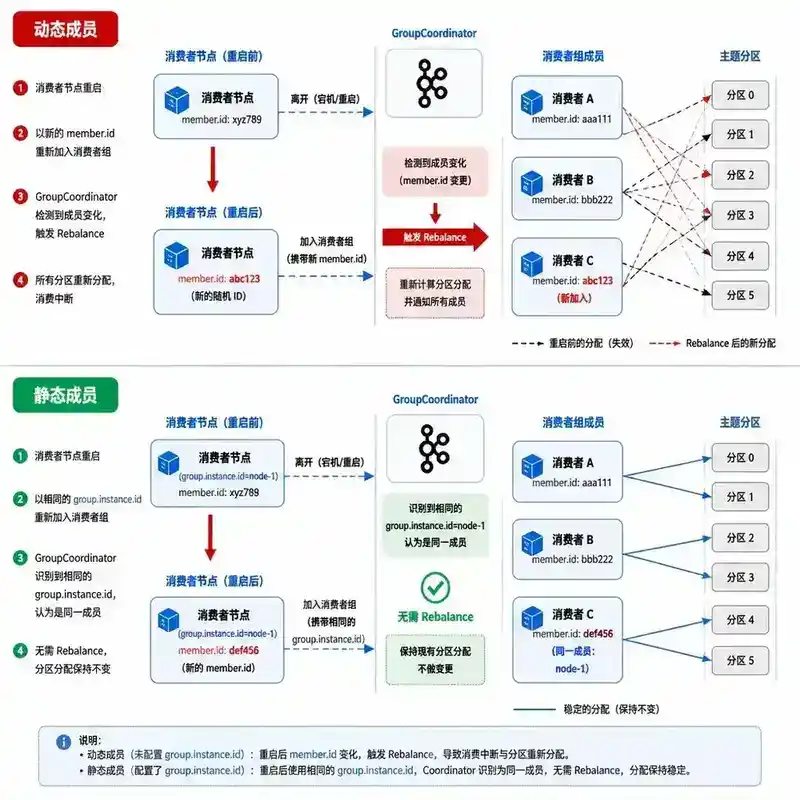
在动态成员模型下,消费者每次加入组都会获得一个新的 member.id。即使是同一个消费者实例重启后重新加入,也会被当作一个新成员,触发一次完整的 Rebalance。
静态成员(Static Membership) 是 Kafka 2.3 引入的特性,允许消费者在重新加入组时保持原有的分区分配,无需触发 Rebalance。
5.2 工作原理
消费者通过 group.instance.id 标识自己的持久化身份:
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");
props.put("group.id", "order-consumer-group");
props.put("group.instance.id", "order-consumer-node-1"); // 静态成员标识
props.put("session.timeout.ms", 30000);
当消费者重启后重新加入组时,GroupCoordinator 识别出 group.instance.id 是之前见过的成员,在 session.timeout.ms 内不会将其视为"退出",而是等待其重新加入并恢复原有分区分配。
5.3 静态成员的关键参数
| 参数 | 说明 |
|---|---|
group.instance.id |
消费者的唯一标识,非空即启用静态成员 |
session.timeout.ms |
超过此时间无心跳,GroupCoordinator 才认为消费者真正退出 |
重要:静态成员模式下,消费者临时断开后,GroupCoordinator 会等待 session.timeout.ms 而不是立即触发 Rebalance。如果消费者在超时前恢复,不会发生 Rebalance。
5.4 静态成员 vs 动态成员
| 维度 | 动态成员 | 静态成员 |
|---|---|---|
| 身份标识 | 每次加入获得新 member.id | 持久化 group.instance.id |
| 重启后行为 | 触发 Rebalance | 不触发 Rebalance(超时前) |
| 滚动升级 | 每次重启都 Rebalance | 无 Rebalance |
| 配置复杂度 | 低 | 需要分配唯一 instance.id |
| 适用场景 | 弹性伸缩场景 | 固定集群、滚动升级 |
5.5 静态成员的限制
- 每个 instance.id 在组内必须唯一,否则后加入的消费者会被拒绝
- 如果消费者真的永久下线(超过
session.timeout.ms),仍然会触发 Rebalance - 静态成员模式下,消费者主动
LeaveGroup仍然会触发 Rebalance - 需要 Kafka Broker 版本 ≥ 2.3
六、实践与调优
6.1 消费者配置最佳实践
# 基础配置
bootstrap.servers=broker1:9092,broker2:9092,broker3:9092
group.id=order-service-consumers

# 分区分配策略
partition.assignment.strategy=org.apache.kafka.clients.consumer.CooperativeStickyAssignor

# Offset 管理
enable.auto.commit=false # 手动提交,精确控制
auto.offset.reset=earliest # 或 latest,根据业务语义选择

# 拉取控制
max.poll.records=500 # 单次拉取上限,避免 poll 间隔超时
fetch.min.bytes=1048576 # 1MB,减少网络往返
fetch.max.wait.ms=500 # 最多等 500ms 凑够 fetch.min.bytes

# 心跳与会话
session.timeout.ms=30000 # 30s,心跳超时
heartbeat.interval.ms=10000 # 10s,心跳间隔(建议为 session.timeout 的 1/3)
max.poll.interval.ms=300000 # 5min,处理超时

# 静态成员(固定实例场景)
group.instance.id=consumer-node-1
6.2 消费积压处理
消费积压是最常见的生产问题,排查思路:
- 确认积压原因:消费速度 < 生产速度?还是消费完全停止?
- 检查消费者组状态:
kafka-consumer-groups.sh --describe --group <group_id> - 临时扩容:增加消费者实例数量(前提是分区数足够)
- 紧急处理:如果积压严重,可以临时调大
max.poll.records和fetch.min.bytes - 长期方案:增加分区数、优化消费逻辑、使用多线程消费
6.3 消费者组监控指标
| 指标 | 含义 | 告警阈值 |
|---|---|---|
records-lag-max |
消费者组最大滞后量 | > 10000 |
records-consumed-rate |
消费速率 | 低于基线 50% |
rebalance-rate |
Rebalance 频率 | > 0(任何 Rebalance 都值得关注) |
commit-rate |
Offset 提交速率 | 异常下降 |
fetch-rate |
拉取速率 | 异常下降 |
6.4 多线程消费模型
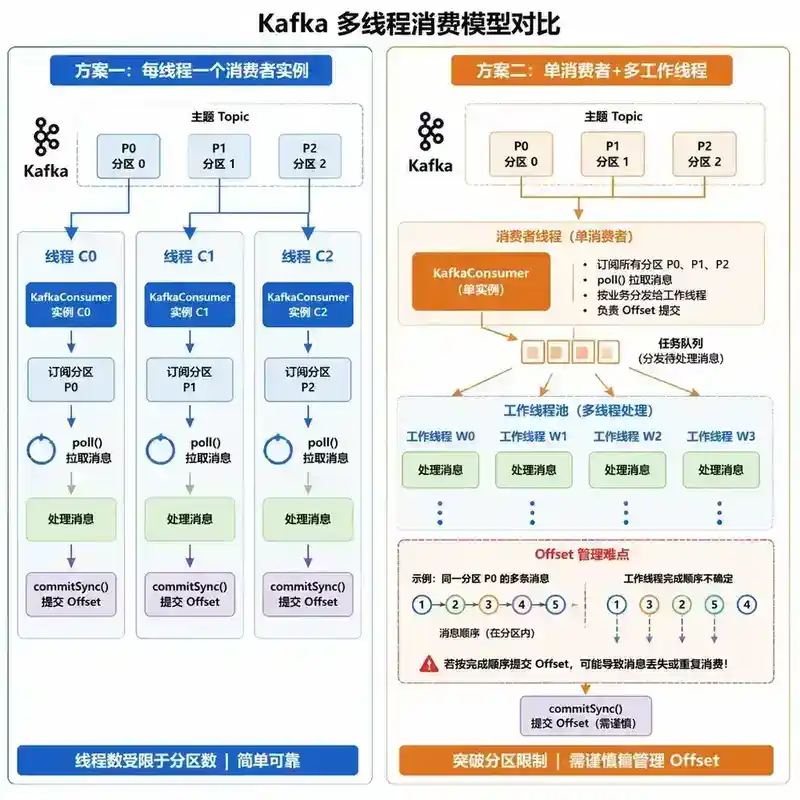
Kafka 消费者不是线程安全的,单消费者实例应在单线程中操作。实现多线程消费有两种方式:
方案一:每个线程一个消费者实例
- 每个线程持有独立的 Consumer 实例
- 简单,与 Kafka 消费者模型天然匹配
- 线程数受限于分区数
方案二:单消费者 + 多工作线程
- 一个消费者线程拉取消息,分发给多个工作线程处理
- 可以突破分区数的限制
- 难点在于 Offset 管理——多线程处理的完成顺序不确定,提交 Offset 需要谨慎
// 方案二示例:解耦拉取和处理
ExecutorService executor = Executors.newFixedThreadPool(10);

while (true) {
 ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
 for (ConsumerRecord<String, String> record : records) {
 executor.submit(() -> {
 processRecord(record);
 // 注意:不能在这里直接提交 offset
 });
 }
 // 需要实现 Offset 追踪机制,确保按序提交
}
七、面试问答
以下问题从面试官视角设计,考察候选人对 Kafka 消费者组的深入理解和实际经验。
Q1:为什么 Kafka 消费者组内消费者数量不能超过分区数?如果超过了会怎样?
答:Kafka 的核心约束是:同一个分区在同一消费者组内只能被一个消费者实例消费。这不是技术限制,而是语义保证——如果允许两个消费者同时消费一个分区,消息顺序就无法保证(除非引入额外的协调机制)。
如果消费者数量超过分区数,多余的消费者会处于空闲状态(idle),不消费任何消息。它们会定期发送心跳保持组内成员身份,但不会收到任何分区分配。Kafka 不会报错,也不会报异常——它只是不分配分区给多余的消费者。
更深一层:这个约束也意味着消费者的并发度上限由分区数决定。如果你的业务需要 100 个消费者并发处理,你必须至少创建 100 个分区。分区数是 Kafka 并发度的"天花板"。
Q2:一个消费者组订阅了 3 个 Topic,各有 10 个分区,组内有 5 个消费者。分别用 RangeAssignor 和 RoundRobinAssignor 分配,结果有什么不同?哪种会出现数据倾斜?
答:
RangeAssignor——按主题维度分配:
对每个 Topic 的 10 个分区,5 个消费者每人分 2 个分区(10/5=2,恰好整除)。最终每个消费者分配到 3×2=6 个分区。三个 Topic 的分配完全一致,因为每个 Topic 的分区数和消费者数相同。这种情况下恰好均匀,不会倾斜。
但如果分区数无法整除,比如 7 个分区、3 个消费者,则 C0 分配到 3 个分区(⌈7/3⌉),C1 和 C2 各 2 个。订阅 3 个 Topic 时,C0 累计 9 个分区,C1 和 C2 各 6 个——C0 比 C1/C2 多 50% 的负载,这就是数据倾斜。
RoundRobinAssignor——全局轮询:
将 3 个 Topic 共 30 个分区展开成一个列表,轮询分配给 5 个消费者。每个消费者恰好 6 个分区(30/5=6),分配均匀。在 7 分区 3 消费者场景下,RoundRobin 的结果是 7/7/6,也比 Range(9/6/6)更均匀。
结论:RangeAssignor 在多 Topic 订阅且分区数不均匀时容易出现数据倾斜,根源在于它按主题维度独立分配,无法跨主题均衡。RoundRobin 和 Sticky 策略在全局均衡性上更好。
Q3:Rebalance 过程中消费者组会经历什么状态?如果你在监控中看到消费延迟每 5 分钟出现一个尖峰,可能是什么原因?
答:
消费者组在 Rebalance 过程中经历的状态转换:
- Stable:正常消费状态,所有消费者按分配方案消费各自分区
- PreparingRebalance:检测到组成员变化,GroupCoordinator 通知所有消费者准备 Rebalance
- CompletingRebalance(AwaitingSync):消费者已提交 JoinGroup,等待 Group Leader 计算分配方案并同步
- 回到 Stable:分配方案生效,恢复消费
每 5 分钟出现消费延迟尖峰,最可能的原因是 auto.commit.interval.ms=300000(默认 5 分钟)配合自动提交 Offset 导致的。虽然 Offset 提交本身不会阻塞消费,但频繁的 Offset 提交可能引起 Broker 端压力。更常见的根因是:
max.poll.interval.ms=300000(5 分钟),消息处理时间接近阈值,偶尔超时触发 Rebalance- 周期性 GC 暂停导致心跳超时,触发 Rebalance(可以通过
-XX:+PrintGCApplicationStoppedTime确认) - 消费者组内某个消费者定期重启(如健康检查失败后 K8s 重启 Pod),每次重启触发一次 Rebalance
排查方法:在消费者日志中 grep (Re-)joining group 和 Successfully joined group,看时间间隔是否与延迟尖峰吻合。
Q4:静态成员(Static Membership)和动态成员的本质区别是什么?在 Kubernetes 环境下使用静态成员需要注意什么?
答:
本质区别在于身份持久化。动态成员每次加入组都获得新的 member.id,GroupCoordinator 无法区分"重启"和"新成员加入"——两者都会触发 Rebalance。静态成员通过 group.instance.id 提供持久化身份,GroupCoordinator 在 session.timeout.ms 内保留该成员的分区分配,不会触发 Rebalance。
Kubernetes 环境下的注意事项:
**group.instance.id**必须与 Pod 生命周期绑定。推荐使用 StatefulSet 的 Pod 名称(如kafka-consumer-0),因为 StatefulSet 保证 Pod 名称稳定。如果使用 Deployment,Pod 名称在重启后变化,不能用 IP 做 instance.id。**session.timeout.ms**要大于 Pod 重启时间。K8s Pod 从终止到新 Pod Ready 通常需要 10-30 秒,session.timeout.ms至少设为 30-60 秒,否则等不到新 Pod 启动就会被判定为真正退出。- 滚动更新时尤其有价值。不用静态成员时,更新 10 个 Pod 会触发 10 次 Rebalance。使用静态成员且
session.timeout.ms足够大,可以做到零 Rebalance 滚动更新。 - 注意 StatefulSet 缩容。缩容时被删除的 Pod 的
instance.id不会再出现,GroupCoordinator 会在session.timeout.ms后触发 Rebalance——这是预期行为,但需要运维知晓有延迟。
Q5:CooperativeStickyAssignor 是如何实现"渐进式 Rebalance"的?它和传统的 StickyAssignor 在协议层面有什么不同?
答:
协议层面的核心区别:传统 StickyAssignor 使用 Eager Protocol(急切协议),Consumer 在 Rebalance 开始时立即撤销所有分区,然后重新分配。CooperativeStickyAssignor 使用 Cooperative Protocol(协作协议),Consumer 只撤销需要移交的分区,其他分区继续消费。
实现机制:
- 传统 StickyAssignor 在 JoinGroup 阶段,消费者调用
onPartitionsRevoked()撤销所有分区,停止消费,然后等待 SyncGroup 重新分配。 - CooperativeStickyAssignor 将 Rebalance 拆为两轮:
- 第一轮:Group Leader 计算哪些分区需要被移走(比如新增消费者后需要从现有消费者那里匀出一些分区),这些分区通过
onPartitionsRevoked()撤销。其余分区正常消费,不受影响。 - 第二轮:需要被移走的分区通过
onPartitionsAssigned()分配给目标消费者。
- 第一轮:Group Leader 计算哪些分区需要被移走(比如新增消费者后需要从现有消费者那里匀出一些分区),这些分区通过
- 在协议层面,这对应了 Consumer 端的两个回调:
onPartitionsRevoked():撤销部分分区,而不是全部onPartitionsAssigned():接收新分配的分区
关键价值:在 Sticky 策略下,即使只有 1/100 的分区需要重新分配,也要停止全部 100 个分区的消费。Cooperative 策略下,只有那 1 个分区短暂停止消费,其余 99 个分区不受影响。
Q6:如果消息处理需要 5 分钟,但**max.poll.interval.ms**只有 3 分钟,你会怎么处理?给出至少两种方案并对比优劣。
答:
方案一:增大**max.poll.interval.ms**
将 max.poll.interval.ms 设为 6-10 分钟(留有余量)。这是最直接的方案。
- 优点:改动最小,只需调整配置
- 缺点:如果消费者真的崩溃,Coordinator 需要等更久才能发现并触发 Rebalance;不能解决处理慢的根本问题
方案二:减小**max.poll.records**
将 max.poll.records 从默认 500 减小到 50 或更少,保证 poll 返回的消息在 3 分钟内能处理完。
- 优点:不改动 poll 间隔,消费者崩溃检测更快
- 缺点:增加了 poll 调用频率,增加了网络开销;如果单条消息处理就需要 5 分钟,此方案无效
方案三:异步处理 + 快速提交 Offset
poll 拉取消息后立即提交 Offset,然后将消息放入内部队列异步处理。这是"至少一次"语义的变体。
- 优点:poll 间隔极短,不会触发 Rebalance
- 缺点:如果处理失败,消息已经提交 Offset,导致消息丢失;需要额外实现失败重试和死信队列
方案四:多线程消费(单 Consumer + 多 Worker)
消费者线程只负责 poll 和提交 Offset,工作线程池处理消息。处理完一批后统一提交 Offset。
- 优点:可以并行处理,减少单批处理时间
- 缺点:Offset 管理复杂,需要追踪每批消息的处理完成状态;乱序提交可能导致重复消费
推荐组合:方案二 + 方案三。减小 max.poll.records 控制单次拉取量,同时用异步处理解耦。如果单条消息处理确实需要 5 分钟(如调用外部慢服务),考虑异步化处理逻辑,而不是让消费者线程同步等待。
Q7:**enable.auto.commit=true**和**enable.auto.commit=false**,在异常场景下分别会导致什么后果?你如何设计一个"至少一次"和"精确一次"的消费语义?
答:
自动提交(enable.auto.commit=true)异常场景:
- 消费者崩溃:如果消息已被 poll 返回但尚未处理完,消费者崩溃了。由于 Offset 已在上一次自动提交周期提交,消息丢失——最多一次(at-most-once)语义。
- 处理失败:消息处理失败但 Offset 已经自动提交,无法重试——消息丢失。
手动提交(enable.auto.commit=false)异常场景:
- 消费者崩溃:如果消息处理完但 Offset 尚未提交,消费者崩溃。重启后从上一次提交的 Offset 继续消费,消息被重复处理——至少一次(at-least-once)语义。
- 提交失败:异步提交失败,消息可能被重复消费。
设计"至少一次"语义:
- 禁用自动提交(
enable.auto.commit=false) - 消息处理完成后手动提交 Offset
- 业务逻辑实现幂等(去重),容忍重复消费
- 关闭时同步提交兜底
设计"精确一次"语义:
Kafka 提供 isolation.level=read_committed + 事务的精确一次方案:
- 生产者端:使用事务写入(
transactional.id),保证跨分区原子写入 - 消费者端:
isolation.level=read_committed,只读取已提交事务的消息 - 消费-转换-生产:将 Offset 提交和结果写入放在同一个事务中,保证原子性
// 精确一次:消费-转换-生产模式
producer.initTransactions();
while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
    producer.beginTransaction();
    for (ConsumerRecord<String, String> record : records) {
        ProducerRecord<String, String> output = transform(record);
        producer.send(output);
    }
    // 将 Offset 提交和结果写入放在同一个事务
    producer.sendOffsetsToTransaction(offsets, consumer.groupMetadata());
    producer.commitTransaction();
}
Q8:**__consumer_offsets**主题是 compacted 类型的,为什么 Kafka 选择 compacted 而不是 delete?如果 Offset 数据被 compact 掉了会怎样?
答:
为什么用 compacted?
__consumer_offsets 的 Key 是 (GroupId, Topic, Partition),Value 是 (Offset, Metadata, Timestamp)。对于每个 (Group, Topic, Partition) 组合,我们只需要最新的 Offset 值,历史值没有意义。Compacted 策略正好满足这个需求:保留每个 Key 的最新 Value,删除旧 Value。
如果用 delete 策略(按时间或大小删除),同一 Key 的所有 Value 可能被一并删除,消费者组将丢失所有 Offset 信息,无法恢复消费进度。
Offset 被 compact 掉会怎样?
正常情况不会——compacted 只会删除同一 Key 的旧 Value,保留最新 Value。但如果消费者组长时间不活跃(超过 offsets.retention.minutes,默认 7 天),Kafka 会删除该消费者组的全部 Offset 信息(即使是最新的 Value)。此时消费者重启后,auto.offset.reset 决定行为:
earliest:从头消费,大量重复消费latest:跳过历史数据,丢失中间消息none:直接抛出异常
生产实践:对于长期不活跃的消费者组(如离线分析任务),提交的 Offset 可能被清理。建议在任务启动前手动指定起始 Offset(seek()),或使用 earliest 策略并配合业务幂等去重。
本文是 Java 技术专家/架构师面试 250 个高频考点系列的第 150 篇。