阅读时间:约 45 分钟 | 难度:进阶 | 分类:消息队列与事件驱动
一、引言:消息丢了,谁之过?
2024 年某电商大促期间,订单系统通过 Kafka 异步通知下游履约系统。大促结束后,运营团队发现约 0.03% 的订单状态停留在"已支付"但从未进入履约流程。排查后发现:Kafka Producer 使用了默认配置,而 Broker 恰好在那个时间窗口发生了 Leader 切换,部分已发送但未确认的消息随着旧 Leader 的宕机而丢失。
这不是 Kafka 的 Bug,而是对 Producer 可靠性机制理解不足导致的生产事故。Kafka 为 Producer 提供了从"尽力而为"到"精确一次"的五层可靠性保障,但每一层都有代价和边界条件。
本文聚焦于 Kafka Producer 端(不是 Broker 端,也不是 Consumer 端)的可靠性机制,从 acks 确认机制、重试策略、幂等生产、事务到顺序性保证,逐一剖析其原理、配置和权衡。
二、acks:三种确认策略的深度解析
Producer 配置参数 acks(acknowledgments)控制一条消息在什么条件下被视为"发送成功"。这是 Producer 可靠性的第一道防线,也是最基础的配置。
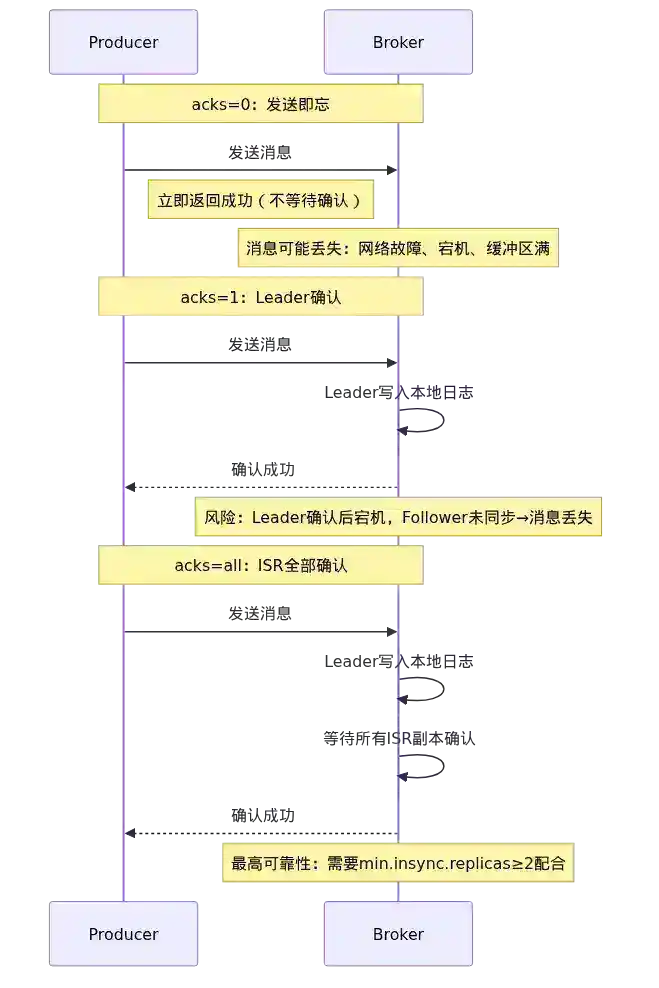
图1:acks 三种确认策略对比*— acks=0 发送即忘、acks=1 Leader确认、acks=all ISR全部确认*
2.1 acks=0:发送即忘
Producer 发送消息 → 不等待任何确认 → 立即返回成功
原理:Producer 把消息交给网络层后立即认为成功,不等待 Broker 的任何响应。消息甚至可能还没到达 Broker 的 Socket 缓冲区。
吞吐量:最高,因为没有任何等待开销。
可靠性:最低。消息可能在以下任何环节丢失:
- 网络传输失败(Producer 不知道)
- Broker 接收缓冲区满,消息被丢弃
- Broker 在写入磁盘前宕机
- Topic 不存在(Kafka 2.4 之前不会自动创建)
唯一适用场景:对数据丢失完全容忍的指标上报、日志采集等场景。即使在日志场景,也建议至少使用 acks=1。
2.2 acks=1:Leader 确认
Producer 发送消息 → Leader Partition 写入本地日志 → 返回确认 → 成功
原理:Leader 副本将消息写入本地日志后立即返回确认,不等待 Follower 同步。这是 Kafka 的默认配置。
可靠性:中等。如果 Leader 在确认后、Follower 同步前宕机,且新 Leader 是从未同步该消息的 Follower 中选举出来的,消息会丢失。
具体故障场景:
- Producer 发送消息 M 到 Leader A
- Leader A 写入本地日志,返回 ack 给 Producer
- Leader A 宕机,此时 Follower B 尚未同步 M
- Controller 选举 Follower B 为新 Leader
- 消息 M 永久丢失(Producer 以为发送成功,不会再重试)
为什么 Kafka 默认 acks=1 而不是 all? 这是吞吐和可靠性的折中。acks=1 只需要等待一次本地写盘,而 acks=all 需要等待所有 ISR 副本确认,延迟增加一个网络往返时间(RTT)。
2.3 acks=all(或 acks=-1):ISR 全部确认
Producer 发送消息 → Leader 写入本地日志 → 等待所有 ISR 副本确认 → 返回确认 → 成功
原理:Leader 等待所有 ISR(In-Sync Replicas)副本都确认收到消息后才返回成功。这是 Kafka 提供的最高可靠性级别。
关键参数**min.insync.replicas**:控制 ISR 中至少要有多少个副本确认。注意这个参数是 Broker/Topic 级别的,不是 Producer 级别的。
- 如果
replication.factor=3, min.insync.replicas=2,则 Leader 只需要等待至少 2 个 ISR 副本(包括 Leader 自己)确认即可。 - 如果 ISR 数量低于
min.insync.replicas,Leader 会拒绝写入,抛出NotEnoughReplicasException。
正确配置示例:
# Broker 端(Topic 级别)
replication.factor = 3
min.insync.replicas = 2   # 至少 2 个副本确认

# Producer 端
acks = all                 # 等所有 ISR 确认
这样即使一个 Broker 宕机,只要还有 2 个副本在 ISR 中,写入就不会失败,且不会丢失已确认的消息。
延迟代价:acks=all 的延迟 = 本地写入时间 + 最慢 Follower 的网络 RTT。通常比 acks=1 增加 1-5ms。
2.4 acks 选型决策表
| 场景 | 推荐 acks | 配套配置 |
|---|---|---|
| 指标/日志(可容忍少量丢失) | acks=1 | 默认即可 |
| 业务数据(订单/支付) | acks=all | min.insync.replicas=2, replication.factor=3 |
| 审计/金融(绝对不丢) | acks=all | min.insync.replicas=3, replication.factor=3 |
| 极限吞吐(允许丢失) | acks=0 | 不推荐生产使用 |
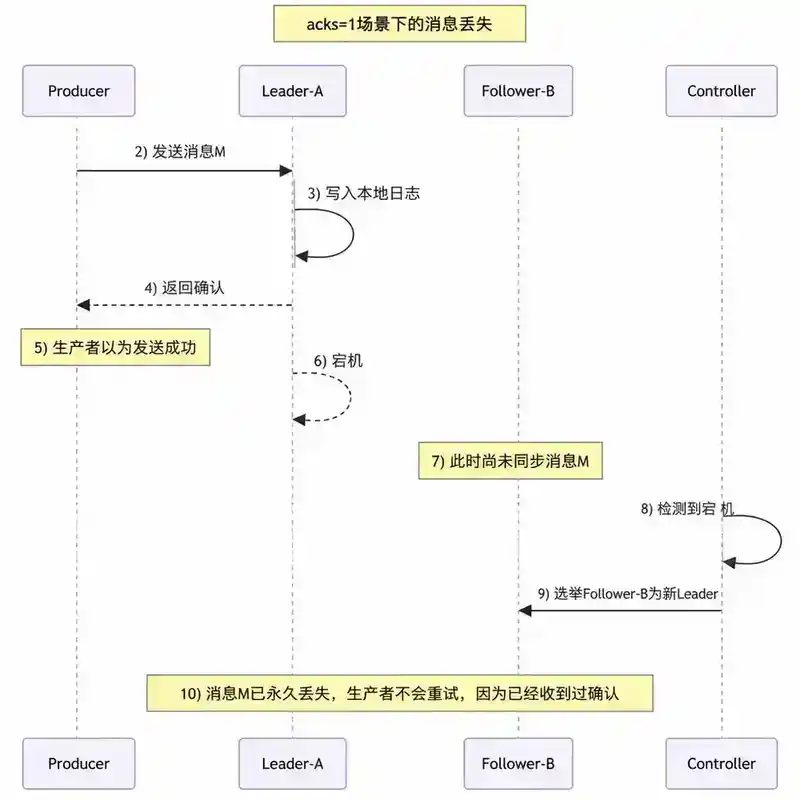
图2:acks=1 场景下的消息丢失过程*— Leader确认后宕机,Follower未同步,消息永久丢失*
三、重试机制:自动恢复与顺序性陷阱
3.1 Producer 的重试机制
当 Producer 发送消息失败(网络异常、Leader 切换、NotEnoughReplicasException 等),Kafka Producer 会自动重试。核心参数:
| 参数 | 默认值 | 说明 |
|---|---|---|
retries |
2147483647(int 最大值) | 最大重试次数 |
retry.backoff.ms |
100 | 每次重试之间的等待时间 |
delivery.timeout.ms |
120000 | 整个发送操作的总超时(含重试) |
重试触发条件:
- 网络异常(连接断开、超时)
- Leader 选举中(
NotLeaderOrFollowerException) - ISR 不足(
NotEnoughReplicasException) - 但不会重试不可恢复的错误:消息过大(
RecordTooLargeException)、序列化错误、认证失败等
3.2 重试与顺序性:max.in.flight.requests.per.connection
这是 Producer 可靠性中最容易出错的参数。默认值为 5,意味着 Producer 可以在等待前一个请求确认的同时,再发送最多 4 个请求。这在重试场景下会破坏消息顺序:
时间线(默认 max.in.flight=5):
  Batch-1 → 发送失败(网络超时)
  Batch-2 → 发送成功
  Batch-3 → 发送成功
  Batch-1 → 重试成功

Broker 日志中的顺序:Batch-2, Batch-3, Batch-1  ← 乱序!
解决方案:将 max.in.flight.requests.per.connection 设置为 1。
max.in.flight.requests.per.connection = 1
这样 Producer 在任何时刻只有一个未确认的请求,重试不会导致乱序。代价是吞吐量下降——因为失去了请求流水线化(pipelining)的能力。
Kafka 2.0+ 的改进:当 enable.idempotence=true 时,Kafka 允许 max.in.flight.requests.per.connection ≤ 5 同时保证顺序。这是因为幂等 Producer 为每个消息分配了序列号(Sequence Number),Broker 可以按序列号去重和排序。详见下一节。
3.3 重试导致的重复消息问题
即使 retries 配置正确,也可能产生重复消息。典型场景:
Producer 发送 Batch-1 → Broker 写入成功 → 网络抖动导致 ack 丢失 → Producer 重试 → Broker 再次写入 Batch-1
Broker 日志中出现了两条相同的消息。解决这个问题需要引入幂等 Producer。
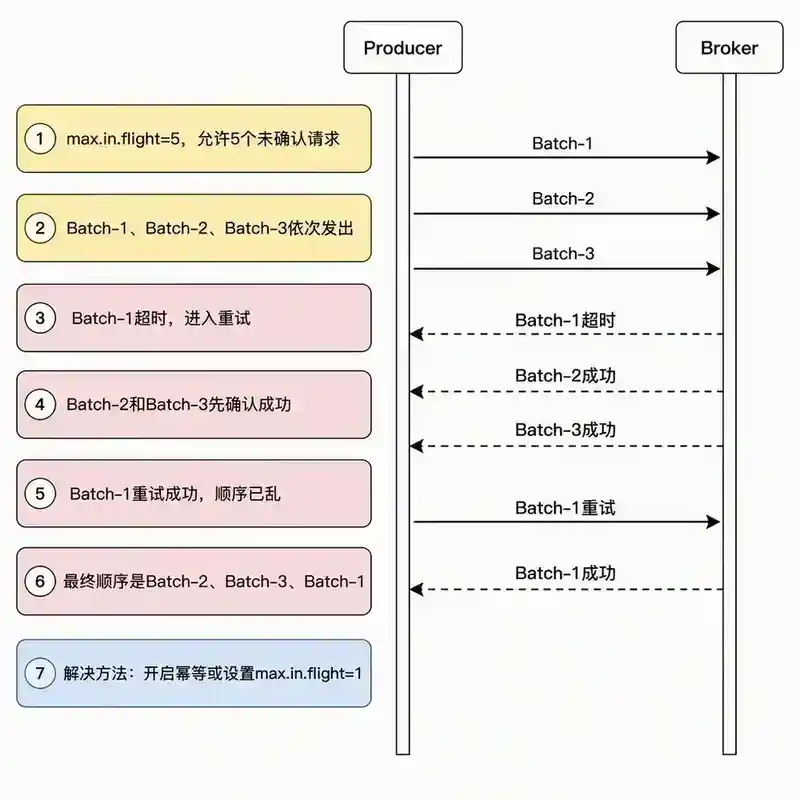
图3:max.in.flight=5 导致的消息乱序过程*— Batch-1 重试晚于 Batch-2/3 到达*
四、幂等生产:Exactly-Once 的第一步
4.1 什么是幂等 Producer
幂等 Producer 保证:即使在重试场景下,每条消息在同一个 Partition 中也只会被持久化一次。
配置方式:
enable.idempotence = true
当开启幂等后,Kafka 会自动设置:
acks = allretries = 2147483647max.in.flight.requests.per.connection ≤ 5(Kafka 2.0+)
4.2 实现原理:PID + Sequence Number
幂等 Producer 的核心是**生产者 ID(PID)+ 序列号(Sequence Number)**机制。
初始化阶段:
- Producer 启动时,向 Broker 请求一个唯一的 PID(Producer ID)
- PID 是 Broker 分配的单调递增的 64 位整数,全局唯一
- 每个
<PID, TopicPartition>组合维护一个独立的序列号,从 0 开始递增
发送阶段:
- Producer 为每个发往特定 Partition 的消息分配一个递增的 Sequence Number
- Broker 在内存中维护每个
<PID, TopicPartition>对应的最后 5 个已提交序列号 - 当收到消息
(PID=100, Partition=0, Seq=5)时:- 如果 Seq 比最后提交的 Seq 大 1 → 正常写入
- 如果 Seq ≤ 最后提交的 Seq → 判断为重复,丢弃
- 如果 Seq 比最后提交的 Seq 大超过 1 → 数据丢失,抛出
OutOfOrderSequenceException
去重窗口:Broker 只为每个 <PID, TopicPartition> 维护最近 5 个序列号。这意味着如果 Producer 重试一个很早之前的请求,去重可能失效。但在正常重试窗口内(delivery.timeout.ms 默认 120s),5 个序列号的滑动窗口足够覆盖。
4.3 幂等 Producer 的局限性
幂等 ≠ 跨会话去重。如果 Producer 重启(PID 会变化),之前发送的消息无法被新的 PID 去重。因为:
- PID 由 Broker 在 Producer 初始化时分配,Producer 重启后获得新的 PID
- Broker 的去重缓存基于
<PID, TopicPartition>,新旧 PID 互不关联
幂等 ≠ 跨 Partition 原子性。幂等 Producer 只保证单个 Partition 内的 Exactly-Once。如果需要跨多个 Partition 或跨 Topic 的原子写入,需要事务。
幂等 ≠ 跨 Topic 去重。每个 <PID, TopicPartition> 独立维护序列号,不能跨 Topic 去重。
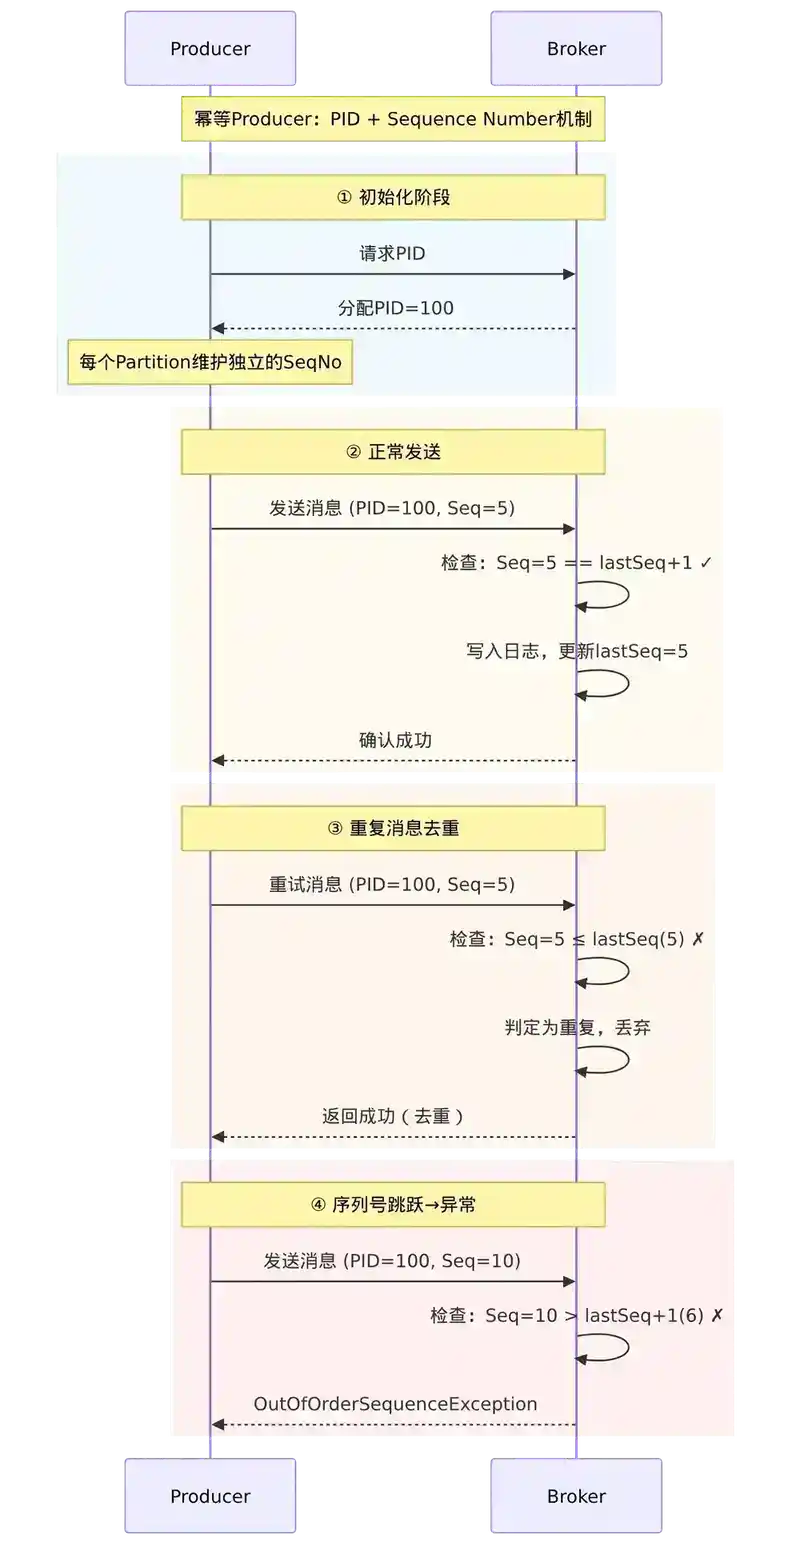
图4:幂等Producer 的 PID + Sequence Number 机制*— 初始化、正常发送、去重、异常检测四个阶段*
五、事务:跨分区跨会话的 Exactly-Once
5.1 事务解决了什么问题
假设一个"用户下单"场景,需要同时做两件事:
- 发送一条"订单创建"消息到
order-topic的 Partition-0 - 发送一条"库存扣减"消息到
inventory-topic的 Partition-3
如果第一步成功、第二步失败(比如 Broker 宕机),且没有事务,就会出现"订单已创建但库存未扣减"的不一致状态。
Kafka 事务保证:同一事务内的所有消息要么全部成功,要么全部失败。
5.2 事务的核心组件
| 组件 | 角色 |
|---|---|
| Transactional Producer | 发起事务的 Producer |
| Transaction Coordinator | 运行在 Broker 上,管理事务生命周期,分配 Transactional ID |
| Transaction Log | 内部 Topic(__transaction_state),持久化事务状态 |
| Control Message | 特殊的 Marker 消息,标记 Commit/Abort,写入用户 Topic |
5.3 事务实现流程
第一步:初始化
Properties props = new Properties();
props.put("transactional.id", "order-service-tx-01");  // 必须配置
props.put("enable.idempotence", "true");               // 事务自动开启幂等
// ... 其他配置
KafkaProducer<String, String> producer = new KafkaProducer<>(props);
producer.initTransactions();  // 注册 Transactional ID,获取 PID
关键概念:Transactional ID
- 由应用指定,全局唯一(如
order-service-tx-01) - 与 PID 的映射关系持久化在 Transaction Log 中
- Producer 重启后,用相同的 Transactional ID 可以"接续"之前未完成的事务
- 这就是事务能跨会话的根源——即使 PID 变了,Transactional ID 的映射可以恢复
第二步:事务生命周期
initTransactions()
    │
    ├── beginTransaction()
    │       │
    │       ├── send(topic-A, msg1)
    │       ├── send(topic-B, msg2)
    │       │
    │       ├── sendOffsetsToTransaction(...)  // 可选:将 Consumer Offset 也纳入事务
    │       │
    │       └── commitTransaction()  ← 或 abortTransaction()
    │
    └── close()
第三步:两阶段提交
Kafka 事务不是标准的 2PC,但有类似的提交过程:
- Pre-Commit 阶段:Producer 发送
commitTransaction()请求给 Transaction Coordinator - 写入 Prepare 状态:Transaction Coordinator 将事务状态从
ONGOING改为PREPARE_COMMIT,写入 Transaction Log - 写入 Commit Marker:Transaction Coordinator 向涉及的所有 Topic-Partition 写入 Commit Marker(Control Message)
- 写入 Complete 状态:所有 Commit Marker 写入后,将事务状态改为
COMPLETE_COMMIT,写入 Transaction Log
控制消息(Control Message):是一个特殊的 Kafka 消息,不包含业务数据,只标记事务的 Commit 或 Abort。Consumer 在隔离级别为 read_committed 时会跳过未提交事务的消息,直到看到 Commit Marker 才返回。
5.4 Consumer 端的事务隔离
props.put("isolation.level", "read_committed"); // 默认是 read_uncommitted
read_uncommitted(默认):读取所有消息,包括未提交事务的消息read_committed:只读取已提交事务的消息,过滤掉 Abort 事务的消息和未完成事务的消息
这引入了事务延迟:Consumer 需要等待 Commit Marker 到达,才能消费事务中的消息。如果 Producer 的事务持续时间长,Consumer 会看到明显的延迟。
5.5 事务的性能代价
| 代价项 | 说明 |
|---|---|
| 延迟增加 | 事务提交需要多轮网络交互(Producer → Coordinator → Transaction Log → 用户 Topic) |
| 吞吐下降 | 约 20-30% 的吞吐量下降(相比非事务 Producer) |
| Consumer 延迟 | read_committed 模式下,Consumer 等待 Commit Marker 的延迟 |
| Zombie Fencing | 旧 Producer 被 Fence 后需要重新 initTransactions() |
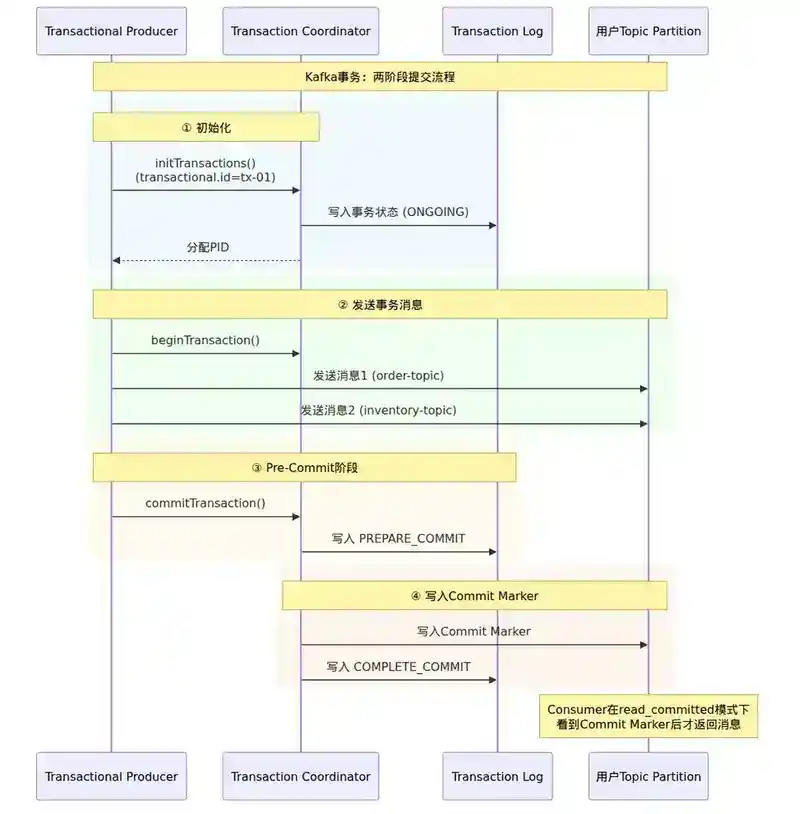
图5:Kafka 事务两阶段提交流程*— 从初始化到 Commit Marker 写入的完整生命周期*
六、顺序性保证:从分区到全局
6.1 Kafka 的顺序性模型
Kafka 只保证单个 Partition 内消息的顺序性,不保证跨 Partition 的全局顺序。
Topic "orders" 有 3 个 Partition:
  Partition-0:  msg-1, msg-3, msg-5  ← 这些消息在 Partition-0 内是有序的
  Partition-1:  msg-2, msg-4, msg-6  ← 这些消息在 Partition-1 内是有序的
  Partition-2:  msg-7, msg-8, msg-9  ← 这些消息在 Partition-2 内是有序的

但 Consumer 从所有 Partition 消费时,全局顺序不保证!
6.2 如何实现顺序性
方案一:分区键路由
// 使用订单 ID 作为 Key,相同订单的所有消息发往同一 Partition
producer.send(new ProducerRecord<>("orders", orderId, message));
通过 hash(key) % partitionCount 将相同 Key 的消息路由到同一 Partition,保证该 Key 的消息有序。
方案二:单 Partition Topic 将 Topic 的 Partition 数设置为 1,所有消息天然有序。但这种方案牺牲了并行度和水平扩展能力。
6.3 顺序性配置的完整清单
要保证消息的有序性,需要同时满足以下所有条件:
| 配置项 | 推荐值 | 原因 |
|---|---|---|
acks |
all |
防止 Leader 切换导致消息丢失 |
enable.idempotence |
true |
去重 + 序列号排序 |
max.in.flight.requests.per.connection |
≤ 5(幂等开启时)或 1(幂等关闭时) |
防止重试乱序 |
retries |
MAX_INT(默认) |
确保重试到成功 |
| 消息 Key | 始终指定 | 确保相同 Key 路由到同一 Partition |
| Partition 数 | 不变更 | 增加 Partition 会改变路由规则 |
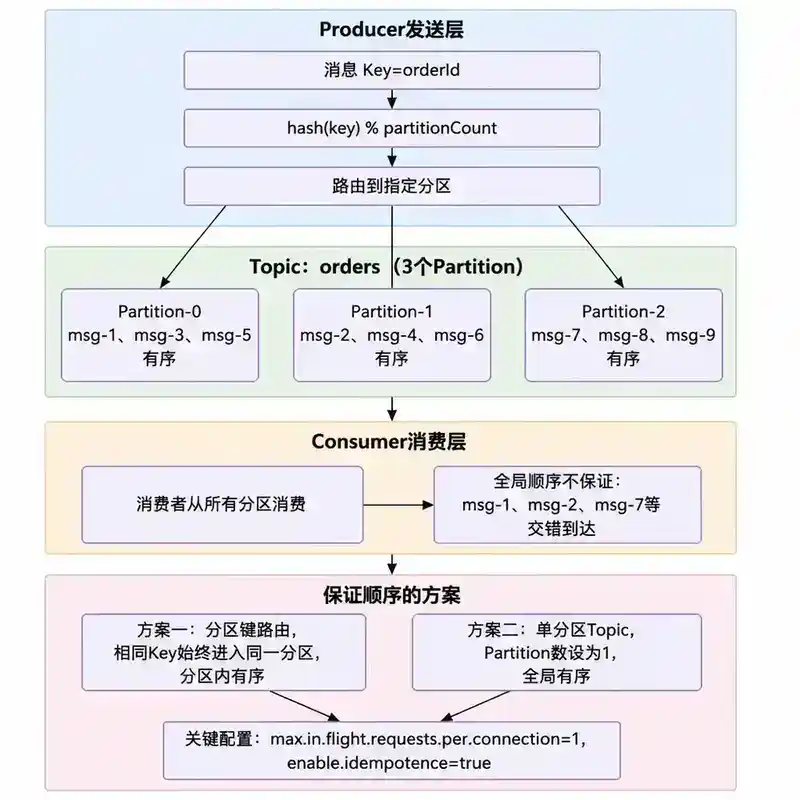
图6:Kafka 消息顺序性保证机制*— 分区键路由与单分区方案的完整链路*
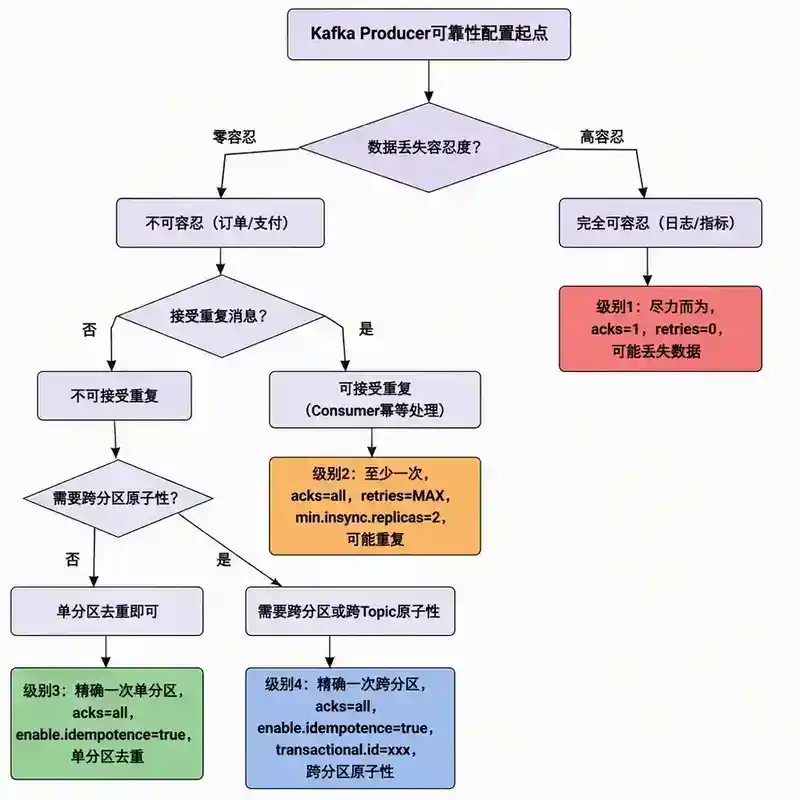
图7:Kafka Producer 可靠性配置选型决策树*— 根据数据丢失容忍度、重复容忍度、跨分区需求选择*
七、生产环境最佳实践
7.1 配置组合速查
| 可靠性级别 | 配置 | 适用场景 |
|---|---|---|
| 尽力而为 | acks=1, retries=0 | 可容忍丢失的指标/日志 |
| 至少一次 | acks=all, retries=MAX, enable.idempotence=false | 允许重复、可幂等处理的业务 |
| 精确一次(单分区) | acks=all, enable.idempotence=true | 需要去重的单分区业务 |
| 精确一次(跨分区) | acks=all, enable.idempotence=true, transactional.id=xxx | 需要跨分区/跨 Topic 原子性 |
7.2 监控指标
| 指标 | 含义 | 告警阈值 |
|---|---|---|
record-error-rate |
发送失败率 | > 0.1% |
record-retry-rate |
重试率 | > 1%(说明网络或 Broker 有问题) |
request-latency-avg |
平均请求延迟 | > 100ms |
outgoing-byte-rate |
发送吞吐 | 接近 Broker 带宽限制 |
buffer-available-bytes |
缓冲区可用空间 | < 10% 总缓冲区 |
waiting-threads |
等待线程数 | 持续 > 0 |
7.3 常见错误
错误 1:只配 acks=all,不配 min.insync.replicas
acks=all, 但 min.insync.replicas 使用默认值 1
→ ISR 只有 Leader 自己就能满足 → 等价于 acks=1
正确做法:acks=all 必须配合 min.insync.replicas ≥ 2。
错误 2:开启事务但 Consumer 使用 read_uncommitted
Producer 事务 → 消息写入 → Abort → Consumer 依然读到 Abort 的消息
正确做法:事务场景下 Consumer 必须配置 isolation.level=read_committed。
错误 3:忘记处理 Producer 回调异常
// 危险:不处理回调中的异常
producer.send(record, (metadata, exception) -> {
    // 异常被忽略
});

// 正确:记录 + 告警 + 兜底
producer.send(record, (metadata, exception) -> {
    if (exception != null) {
        log.error("Send failed", exception);
        metrics.counter("kafka.send.error").increment();
        // 可选:写入本地死信队列
    }
});
八、故障场景演练
场景 1:Leader 切换导致消息丢失
条件:acks=1, enable.idempotence=false
过程:
- Producer 发送 100 条消息到 Leader A
- Leader A 写入本地日志,返回 ack
- Leader A 在 Follower 同步前宕机
- Follower B 成为新 Leader(只有 80 条消息)
- 后 20 条消息永久丢失
修复:改用 acks=all + min.insync.replicas=2
场景 2:重试导致消息乱序
条件:acks=all, enable.idempotence=false, max.in.flight=5
过程:
- Batch-1 网络超时重试,Batch-2/3/4 发送成功
- Batch-1 重试成功
- Broker 日志顺序:Batch-2, Batch-3, Batch-4, Batch-1
修复:开启 enable.idempotence=true(Kafka 2.0+)或设置 max.in.flight=1
场景 3:事务中的 Zombie Producer
条件:事务 Producer 因 GC 暂停被误判为死亡
过程:
- Producer-A(transactional.id=tx-1)发送事务消息,触发 GC 暂停
- 超时后,Transaction Coordinator 认为 Producer-A 已死
- 新实例 Producer-B(transactional.id=tx-1)
initTransactions(),Coordinator 分配新 PID,Fence 旧 PID - Producer-A 恢复后尝试 commit,收到
ProducerFencedException - Producer-A 的事务被 Abort
这是 Kafka 事务的正确行为——旧 Producer 被 Fence 保证了数据一致性。
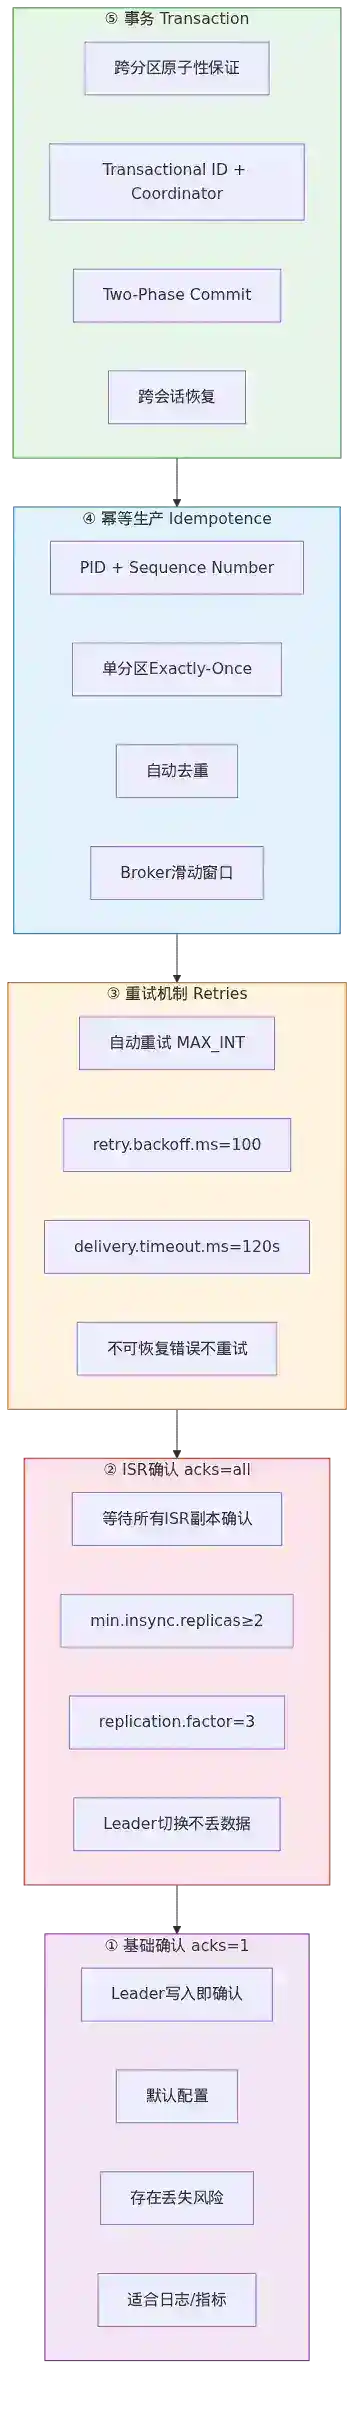
图8:Kafka Producer 五层可靠性金字塔*— 从 acks=1 到事务的逐层递进*
九、总结
Kafka Producer 的可靠性是一个逐层递增的体系:
- acks:决定消息在什么条件下算"确认",是最基础的可靠性开关
- 重试:自动恢复瞬时故障,但带来重复和乱序风险
- 幂等:消除重试导致的重复,基于 PID+Sequence Number 实现
- 事务:跨分区原子性,基于 Transactional ID + Transaction Coordinator 实现
- 顺序性:单分区有序,需要正确配置路由和 in-flight 请求数
理解这些机制不是目的,目的是在可靠性、延迟和吞吐量之间找到适合你业务的平衡点。记住:没有银弹,只有 trade-off。
十、面试官提问
以下问题从面试官视角设计,考察对 Kafka Producer 可靠性机制的深度理解和工程经验。
Q1:acks=all 和 min.insync.replicas=2,replication.factor=3。如果 ISR 中只有 2 个副本(一个 Follower 掉线),此时还能写入吗?能写入的话,可靠性如何?
Q2:开启幂等 Producer 后,broker 如果重启,PID 序列号映射会丢失,生产者还能正常工作吗?
Q3:一个事务 Producer 正在执行事务,进程被 kill -9 杀掉。没有调用 abortTransaction()。这个事务最终会怎样?Consumer 会看到什么?
Q4:如果需要保证"订单创建消息"和"库存扣减消息"的全局顺序(即所有 Consumer 看到的顺序一致),应该如何设计?
Q5:在"至少一次"语义下,Consumer 端如何实现幂等消费?什么情况下仅靠 Producer 幂等还不够?
Q6:一个业务使用 transactional.id 做跨分区事务,吞吐量从 10 万 TPS 降到 3 万 TPS,如何优化?有哪些可能的方向?
参考答案
Q1:acks=all 和 min.insync.replicas=2,replication.factor=3。如果 ISR 中只有 2 个副本(一个 Follower 掉线),此时还能写入吗?能写入的话,可靠性如何?
能写入。min.insync.replicas=2 的含义是"最少需要 2 个 ISR 副本确认",当前 ISR 恰好有 2 个(Leader + 1 个 Follower),满足条件,写入正常进行。
但可靠性已经降级:
- 原本 3 副本,任意 2 台宕机数据仍不丢;现在只剩 2 副本,再宕 1 台就只剩 Leader
- 如果此时 Leader 宕机,剩余的唯一 Follower 成为新 Leader,数据只有 1 份
- 如果这 2 台 Broker 先后宕机且磁盘损坏,数据永久丢失
关键认知:min.insync.replicas 是最小阈值而非目标值,只要 ISR 数量 ≥ 该值即可写入。生产环境应配置告警监控 ISR 收缩(UnderReplicatedPartitions 指标),及时恢复掉线副本。
Q2:开启幂等 Producer 后,broker 如果重启,PID 序列号映射会丢失,生产者还能正常工作吗?
能正常工作,但存在短暂的去重漏洞。
Broker 重启后,内存中的 <PID, TopicPartition> → 序列号映射全部丢失。Producer 继续发送消息时:
- Producer 携带自己的 PID 和当前序列号(如 Seq=42)发送消息
- Broker 发现自己没有该 PID 的状态记录,接受该消息并从 Seq=42 开始追踪
- 后续消息正常递增,去重功能恢复
潜在风险:如果 Producer 在 Broker 重启前发送了 Seq=40、41,但 Broker 在持久化 Seq=40 后重启,Seq=41 丢失。Producer 重试 Seq=41 时,Broker 会将其作为新消息接受(因为没有旧记录比对)。这会导致至多一次重复。
这是幂等 Producer 的已知局限——去重状态不跨 Broker 重启持久化。真正需要跨故障的精确一次,必须使用事务。
Q3:一个事务 Producer 正在执行事务,进程被 kill -9 杀掉。没有调用 abortTransaction()。这个事务最终会怎样?Consumer 会看到什么?
事务最终会被自动 Abort,Consumer 的行为取决于隔离级别。
详细过程:
- Producer 被 kill -9,Transaction Coordinator 感知不到(没有主动断开通知)
- Coordinator 等待
transaction.timeout.ms(默认 60 秒) - 超时后,Coordinator 将事务状态从
ONGOING改为PREPARE_ABORT,写入 Transaction Log - Coordinator 向所有涉及的分区写入 Abort Marker(Control Message)
- 事务状态最终变为
COMPLETE_ABORT
Consumer 端表现:
- read_committed(推荐):Consumer 在事务未完成期间会阻塞等待(不返回未提交事务中的消息),直到看到 Abort Marker 后跳过这些消息,最终什么也看不到——就像这些消息从未存在过
- read_uncommitted(默认):Consumer 会立即读到事务中的消息,但后续收到 Abort Marker 后也无法"撤回"已消费的消息——应用程序会看到脏数据
如果 Producer 重启后用相同的 transactional.id 调用 initTransactions(),Coordinator 会立即 Fence 旧 epoch 并 Abort 旧事务,无需等待超时。这是 Kafka 事务的 Zombie Fencing 机制。
Q4:如果需要保证"订单创建消息"和"库存扣减消息"的全局顺序(即所有 Consumer 看到的顺序一致),应该如何设计?
核心认知:Kafka 不保证跨 Topic 的全局顺序,需要从架构层面重新设计。
方案一:单 Topic 多类型事件
- 将"订单创建"和"库存扣减"作为同一个 Topic 的不同事件类型
- 使用
orderId作为分区 Key,确保同一订单的所有事件进入同一 Partition - Consumer 按事件类型分发处理逻辑
- 优点:天然有序,实现简单
- 缺点:Topic 语义混乱,Schema 管理复杂
方案二:Outbox 模式 + CDC
- 业务服务先写入数据库(订单表和库存表在同一事务中)
- 通过 Debezium 等 CDC 工具捕获数据库变更,按提交顺序写入 Kafka
- 同一个数据库事务中的变更保证顺序一致
- 优点:强一致性,业务代码无需感知 Kafka
- 缺点:引入 CDC 组件,运维复杂度增加
方案三:Kafka Streams 重排序
- 各 Topic 独立生产,Consumer 端使用 Kafka Streams 的 State Store 缓存消息
- 按业务时间戳或序号重新排序后处理
- 优点:Producer 端简单
- 缺点:引入延迟和状态存储开销,只适用于允许一定延迟的场景
面试加分项:能指出"大多数业务场景不需要全局顺序,只需要同一实体(订单)内的顺序",并论证为什么单 Partition 路由已经足够。
Q5:在"至少一次"语义下,Consumer 端如何实现幂等消费?什么情况下仅靠 Producer 幂等还不够?
Consumer 端幂等消费的核心思路:
- 唯一键去重:利用业务唯一标识(如
orderId + eventType),在处理前查询去重存储(Redis/数据库),已处理则跳过 - UPSERT 代替 INSERT:使用
INSERT ... ON DUPLICATE KEY UPDATE或MERGE,让重复写入变成幂等操作 - 乐观锁/版本号:消息携带版本号,Consumer 更新时带
WHERE version < msg.version,重复消息的条件不满足,更新 0 行 - 去重表:在同一个数据库事务中,先插入去重记录(唯一索引),再执行业务逻辑,重复消息插入去重记录时触发唯一约束冲突,回滚事务
仅靠 Producer 幂等不够的场景:
| 场景 | 为什么 Producer 幂等不够 |
|---|---|
| Producer 重启 | PID 变化,旧 PID 的去重缓存失效,可能产生重复 |
| 多 Producer 实例 | 不同 PID 独立维护序列号,无法跨实例去重 |
| Consumer 重复消费 | Producer 幂等只保证写入一次,不保证 Consumer 只处理一次。Offset 提交失败后 Rebalance 会导致重复消费 |
| 跨系统写入 | 消息写入 Kafka 是幂等的,但 Consumer 写入外部系统(如 MySQL)不是幂等的 |
| 消息被多 Consumer 消费 | 不同 Consumer Group 各自消费,Producer 幂等无法阻止 |
最终结论:Producer 幂等解决的是"Kafka 内部的重复",Consumer 幂等解决的是"业务处理的重复"。两者缺一不可,真正的端到端 Exactly-Once 需要 Producer 幂等 + Consumer 幂等 + 事务 Offset 提交三者配合。
Q6:一个业务使用 transactional.id 做跨分区事务,吞吐量从 10 万 TPS 降到 3 万 TPS,如何优化?有哪些可能的方向?
先定位瓶颈,再对症下药。 以下是系统性的排查和优化方向:
一、确认是否真的需要事务
- 如果只需要单 Partition 去重 → 幂等 Producer 足够,去掉事务
- 如果只需要跨 Partition 原子性但不跨 Topic → 评估能否合并 Topic
- 事务的主要开销来自 Transaction Coordinator 的往返和 Commit Marker 的写入
二、减少事务频率(最有效)
- 增大每个事务的消息批量:在
commitTransaction()之前累积更多send(),100 条/事务 → 1000 条/事务,事务开销被摊薄 - 使用
linger.ms和batch.size增大批次,让单次send()本身就包含更多消息
三、事务并行化
- 使用多个
transactional.id(如tx-0,tx-1, ...,tx-9),每个 ID 对应一个 Producer 实例 - 不同事务 ID 之间完全并行,互不阻塞
- 需要确保业务上不要求跨事务 ID 的原子性
四、Consumer 端排查
- 如果 Consumer 使用
read_committed,检查是否 Consumer 成为瓶颈(等待 Commit Marker 的延迟) - 考虑 Consumer 端是否可以用
read_uncommitted+ 应用层过滤 Abort 的消息
五、Broker 端调优
transaction.state.log.replication.factor:Transaction Log 的副本数,默认 3,可适当降低transaction.state.log.min.isr:Transaction Log 的最小 ISRnum.partitionsof__transaction_state:默认 50,高吞吐场景可增加
六、操作系统和网络层面
- 检查 Producer 到 Broker 的网络延迟,事务多轮往返对延迟敏感
- 确保 Producer 和 Broker 在同一可用区
回答亮点:不是直接给答案,而是展示"先 profiling、再优化"的工程思维。能说出"事务 TPS 下降 70% 是正常的,优化目标应该是缩小这个差距而非完全消除"是加分项。