目录
- 引言:一条消息的"死亡"之旅
- 基础概念:什么是死信队列
- 重试机制设计
- 退避策略:从固定到指数
- 毒消息的识别与隔离
- 人工补偿机制
- 主流消息队列的死信实现
- 生产环境最佳实践
- 常见陷阱与反模式
- 系统设计:一个健壮的消费框架
- 面试提问
1. 引言:一条消息的"死亡"之旅
假设你在凌晨三点被报警电话叫醒。生产环境 Kafka 的某个 consumer group 消费延迟飙升到 30 分钟,日志里看到同一批消息被反复重试了几百次——每次重试都因为下游支付网关返回 503 Service Unavailable 而失败。更糟的是,这批消息卡在队列头部,后面的正常消息全部被阻塞。
这就是没有设计好重试与死信队列机制的典型灾难现场。
在分布式消息系统中,消息消费失败是常态而非例外。下游服务抖动、数据格式变更、业务规则校验失败、网络超时——这些都会导致消息无法被正常消费。如果处理不当,轻则消费积压,重则整个消费链路瘫痪。
死信队列(Dead Letter Queue, DLQ) 和 重试设计 就是为解决这些问题而生的一套组合拳。它们解决的核心问题是:
当一条消息无法被正常消费时,如何在"不阻塞正常消息"和"不丢失失败消息"之间取得平衡?
本文将从基础概念出发,深入退避算法、毒消息隔离、人工补偿等核心设计,并结合 RocketMQ、Kafka、RabbitMQ 的具体实现,帮你构建一套完整的消息可靠性消费知识体系。
2. 基础概念:什么是死信队列
2.1 定义
死信队列是一个特殊的消息队列,用于存放经过多次重试仍然无法成功消费的消息。它的核心职责是:
- 隔离:将"坏消息"从正常消费流程中剥离,避免阻塞后续消息
- 保留:不直接丢弃失败消息,保留完整的消息体、失败原因和重试历史
- 可观测:为运维人员提供失败消息的集中视图,支持查询、回放和补偿
2.2 死信产生的三种典型场景
| 场景 | 描述 | 示例 |
|---|---|---|
| 消费超时 | 消息处理时间超过消费超时阈值 | 下游 HTTP 调用超时,消费线程被 consumer.poll() 超时打断 |
| 业务异常 | 消息体不符合业务规则 | 订单金额为负数、必填字段缺失、JSON 格式错误 |
| 系统异常 | 依赖的下游服务不可用 | 数据库连接池耗尽、Redis 不可达、第三方 API 返回 5xx |
2.3 死信队列与重试队列的关系
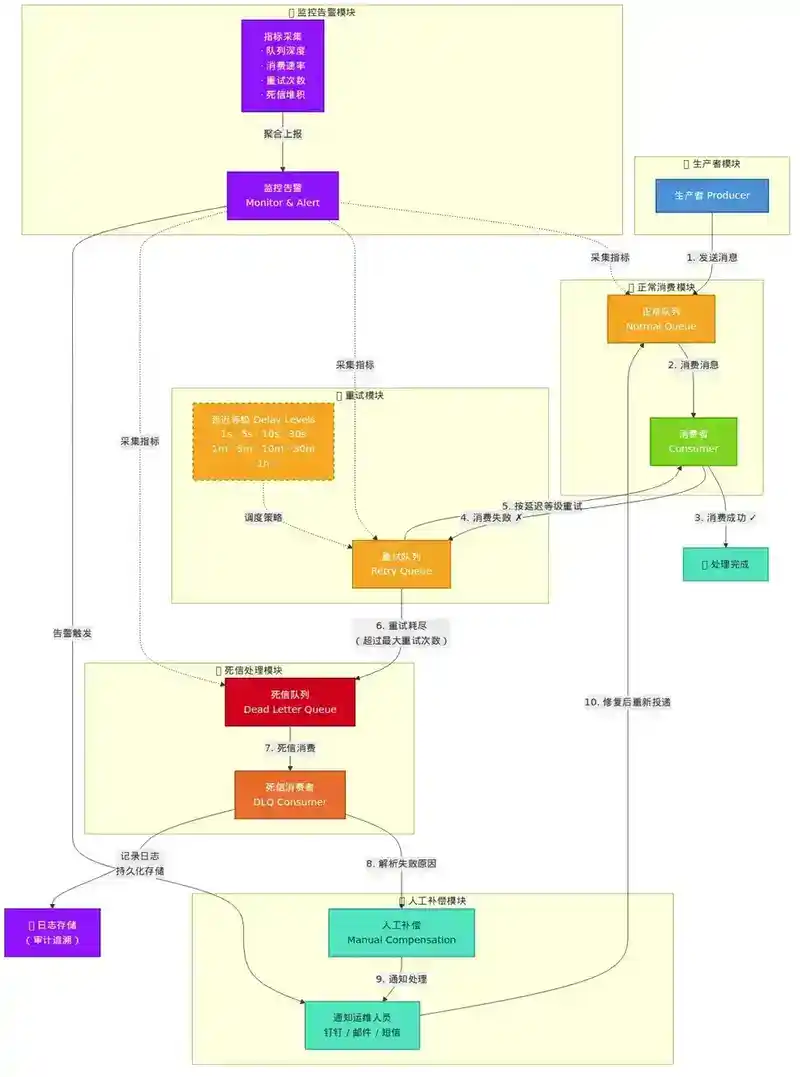
很多人会把"重试队列"和"死信队列"混为一谈。实际上,在大多数消息队列的实现中,二者是同一个机制的不同阶段:
正常队列 → [消费失败] → 重试队列(延迟消费)→ [重试 N 次仍失败] → 死信队列
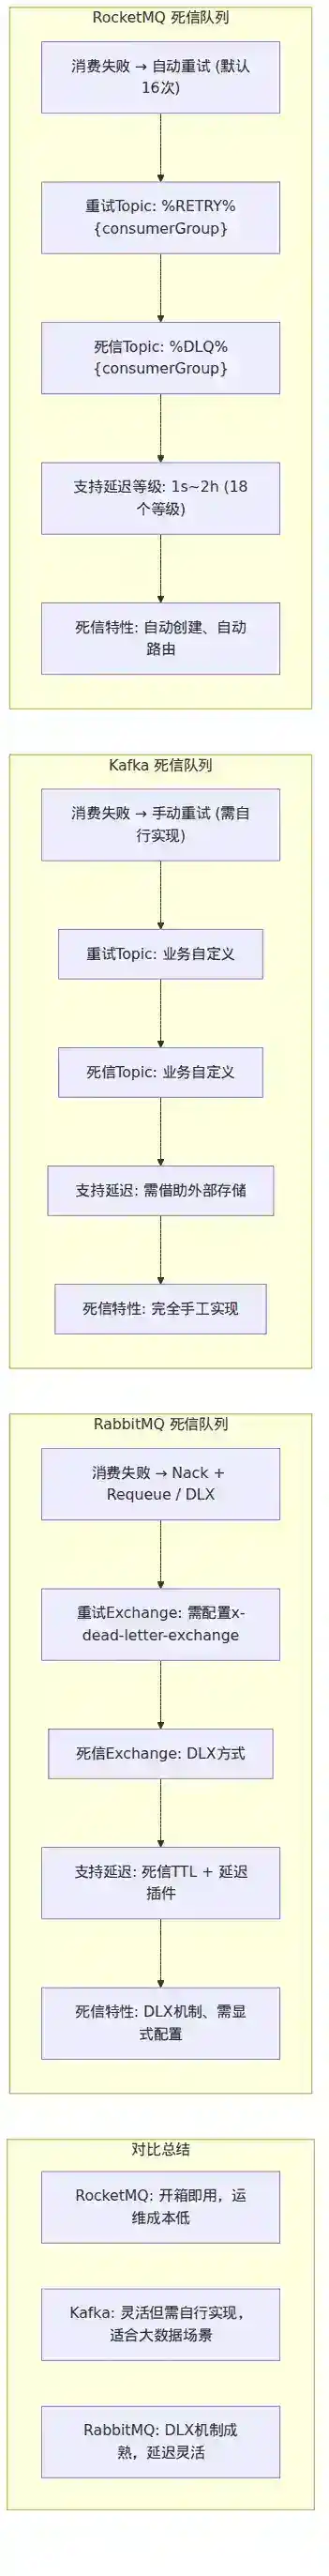
以 RocketMQ 为例,每个 Consumer Group 都有一个对应的 %RETRY% 队列和一个 %DLQ% 队列。消息在重试队列中按延迟等级逐级等待,达到最大重试次数后转入死信队列。
图1:死信队列整体架构
3. 重试机制设计
3.1 重试的本质
重试不是"再试一次"那么简单。重试的本质是用时间换成功率——在允许的窗口内,给下游服务恢复的时间。但时间不是无限的,每一秒的延迟都在消耗用户体验和系统资源。
设计重试机制时,需要回答三个核心问题:
- 重试多少次?(最大重试次数)
- 每次重试间隔多久?(退避策略)
- 重试失败后怎么办?(死信处理)
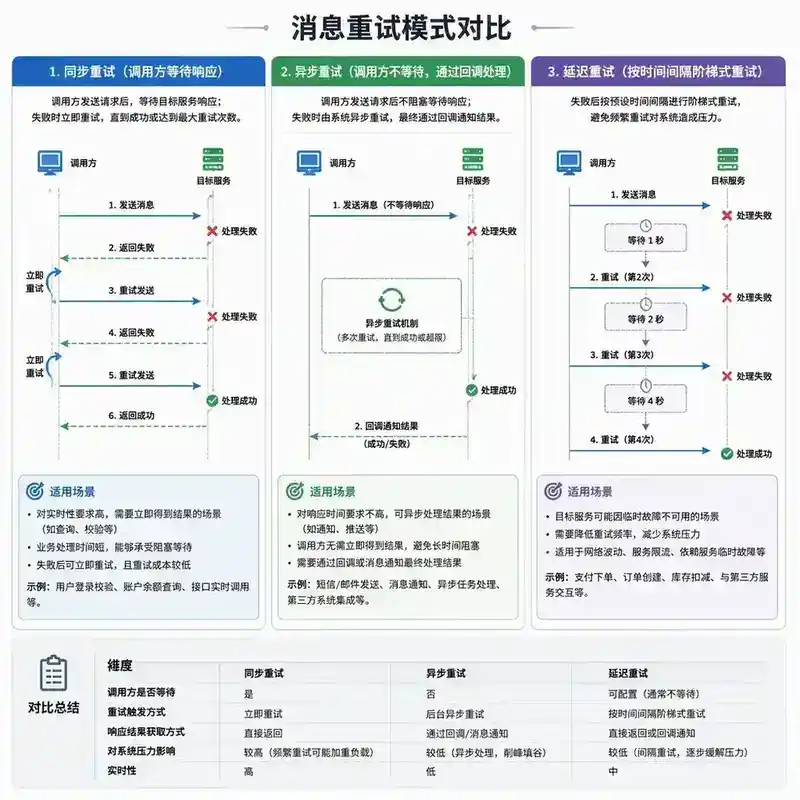
3.2 重试的三种模式
模式一:同步重试(消费端内重试)
消费端在 consumer.poll() 返回消息后,在同一个线程内直接重试:
// 反模式:消费端直接 while 循环重试
public void consume(Message msg) {
    int retries = 0;
    while (retries < MAX_RETRIES) {
        try {
            process(msg);
            return; // 成功,退出
        } catch (Exception e) {
            retries++;
            Thread.sleep(1000); // 阻塞线程,阻塞整个分区消费!
        }
    }
    // 超过最大重试次数,发送到死信队列
    sendToDLQ(msg);
}
问题:这种模式会阻塞当前分区的后续消息消费。在 Kafka 这种单个分区只能被一个消费者线程处理的情况下,一条坏消息会让整个分区停止消费。
模式二:异步重试(重试 Topic)
将失败消息发送到一个独立的"重试 Topic",由专门的消费者处理重试:
业务 Topic → 消费失败 → 重试 Topic → 延迟消费 → 成功 → ACK
                                         ↓ 失败
                                       死信 Topic
优势:不阻塞正常消息消费,重试逻辑与业务逻辑解耦。
模式三:延迟队列重试
利用消息队列自身的延迟消息能力,将重试消息按延迟等级投递:
// RocketMQ 的延迟消息重试
// 消息消费失败后,RocketMQ 自动将消息发送到 %RETRY% 队列
// 延迟等级逐级递增:10s, 30s, 1m, 2m, 3m, 4m, 5m, 6m, 7m, 8m, 9m, 10m, 20m, 30m, 1h, 2h
3.3 最大重试次数的设定
没有"正确"的重试次数,只有"合适"的。选择取决于业务场景:
| 业务场景 | 建议重试次数 | 理由 |
|---|---|---|
| 支付回调 | 10-15 次 | 涉及资金,容忍度高,延迟等级可覆盖 2 小时 |
| 订单状态同步 | 3-5 次 | 最终一致性可通过定时对账补偿 |
| 短信/推送通知 | 2-3 次 | 超过 3 次用户可能已收到重复消息 |
| 日志/埋点 | 1-2 次 | 数据可接受少量丢失,重试成本高 |
| 实时推荐计算 | 0-1 次 | 时效性要求极高,失败直接丢弃 |
核心原则:重试次数 × 最大退避间隔 < 业务可接受的最终一致性延迟窗口。
图2:消息重试机制全景图——三种模式对比
4. 退避策略:从固定到指数
4.1 为什么需要退避
如果 1000 条消息同时失败,全部无间隔地同时重试,会发生什么?——下游服务刚被压垮,又迎来一波新的流量洪峰,相当于"鞭尸"。
退避(Backoff) 的核心思想是:每次重试之间插入一段等待时间,且等待时间随重试次数递增,给下游服务喘息和恢复的机会。
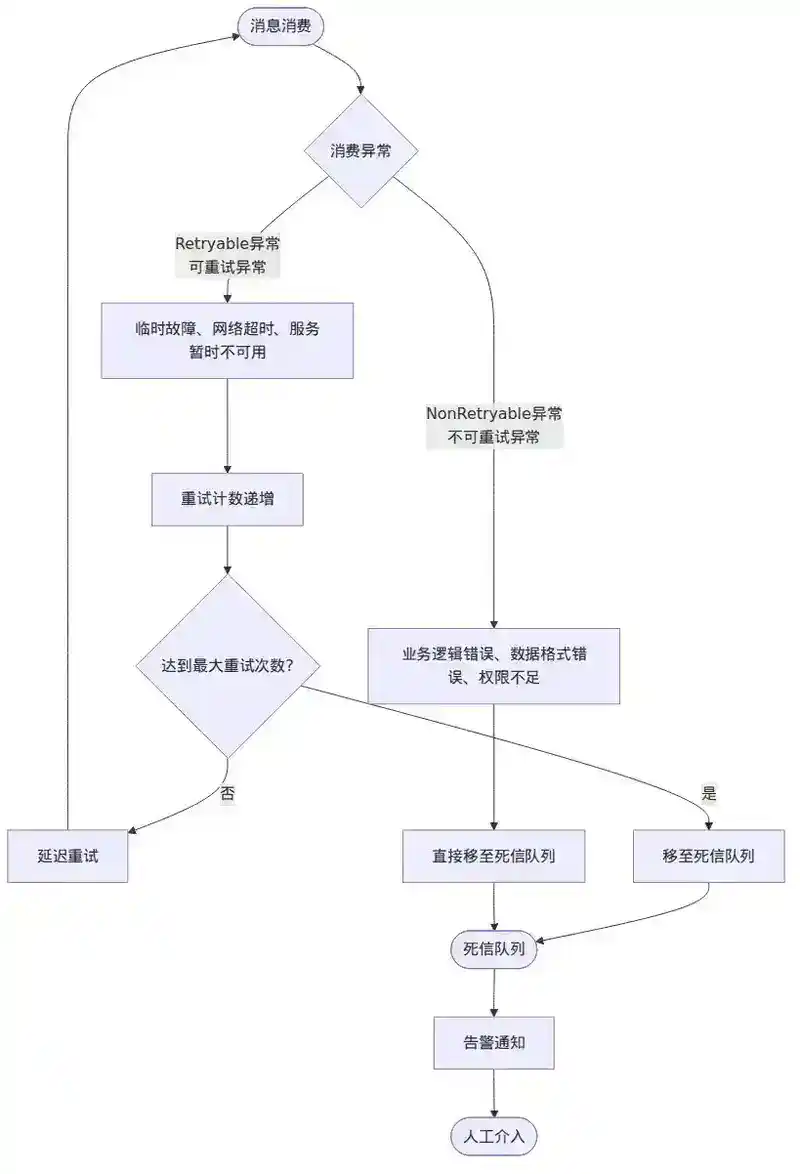
4.2 四种退避策略对比
策略一:固定退避(Fixed Backoff)
间隔:1s, 1s, 1s, 1s, 1s ...
适用场景:已知下游服务恢复时间固定(如缓存预热),且并发量可控。
问题:无法应对恢复时间不确定的场景。如果下游需要 30 秒恢复,前 30 次重试全部是浪费。
策略二:线性退避(Linear Backoff)
间隔:1s, 2s, 3s, 4s, 5s ...
公式:delay = baseDelay * retryCount
适用场景:对恢复时间有粗略估计,但不想等待太久的场景。
策略三:指数退避(Exponential Backoff)
间隔:1s, 2s, 4s, 8s, 16s, 32s ...
公式:delay = baseDelay * 2^(retryCount - 1)
适用场景:下游恢复时间不确定,需要在"快速重试"和"保护下游"之间平衡——这是生产环境最常用的策略。
带抖动的指数退避(Exponential Backoff with Jitter):
纯指数退避有一个问题:如果多个消费者同时失败,它们的重试时间点会"对齐"(thundering herd 问题)。加入随机抖动可以打散重试时间:
public long calculateDelay(int retryCount, long baseDelayMs) {
    long exponentialDelay = baseDelayMs * (1L << (retryCount - 1));
    long maxDelay = Math.min(exponentialDelay, MAX_BACKOFF_MS);
    // 加入 0~25% 的随机抖动
    long jitter = (long) (maxDelay * 0.25 * Math.random());
    return maxDelay + jitter;
}
策略四:多项式退避(Polynomial Backoff)
间隔:1s, 4s, 9s, 16s, 25s ...
公式:delay = baseDelay * retryCount^2
适用场景:需要比指数退避更"激进"的增长曲线,但比指数退避更平滑。
图3:四种退避策略增长曲线对比
4.3 退避上限与截断
无论哪种退避策略,都必须设置最大退避间隔(如 10 分钟)。否则,在指数退避下,第 10 次重试的间隔将达到 512 秒,第 15 次将超过 4.5 小时——这显然不合理。
// 推荐的退避实现
public class RetryPolicy {
    private static final long BASE_DELAY_MS = 1000;
    private static final long MAX_DELAY_MS = 600_000; // 10分钟上限
    private static final double JITTER_FACTOR = 0.25;

    public static long getDelay(int retryCount) {
        long exponential = BASE_DELAY_MS * (1L << Math.min(retryCount - 1, 10));
        long capped = Math.min(exponential, MAX_DELAY_MS);
        long jitter = (long) (capped * JITTER_FACTOR * ThreadLocalRandom.current().nextDouble());
        return capped + jitter;
    }
}
5. 毒消息的识别与隔离
5.1 什么是毒消息(Poison Message)
毒消息是指无论重试多少次都必然失败的消息。它的典型特征:
- 数据格式错误:JSON 解析失败、Protobuf schema 不匹配、字段类型错误
- 业务逻辑不可达:引用了一个已删除的订单、用户 ID 不存在
- 幂等性冲突:重复消费导致唯一约束冲突
关键区别:
| 类型 | 重试能成功? | 处理策略 |
|---|---|---|
| 临时故障消息 | ✅ 可能在重试后成功 | 退避重试,最终投递到正常队列 |
| 毒消息 | ❌ 永远不可能成功 | 尽快识别并隔离,避免浪费重试资源 |
5.2 如何识别毒消息
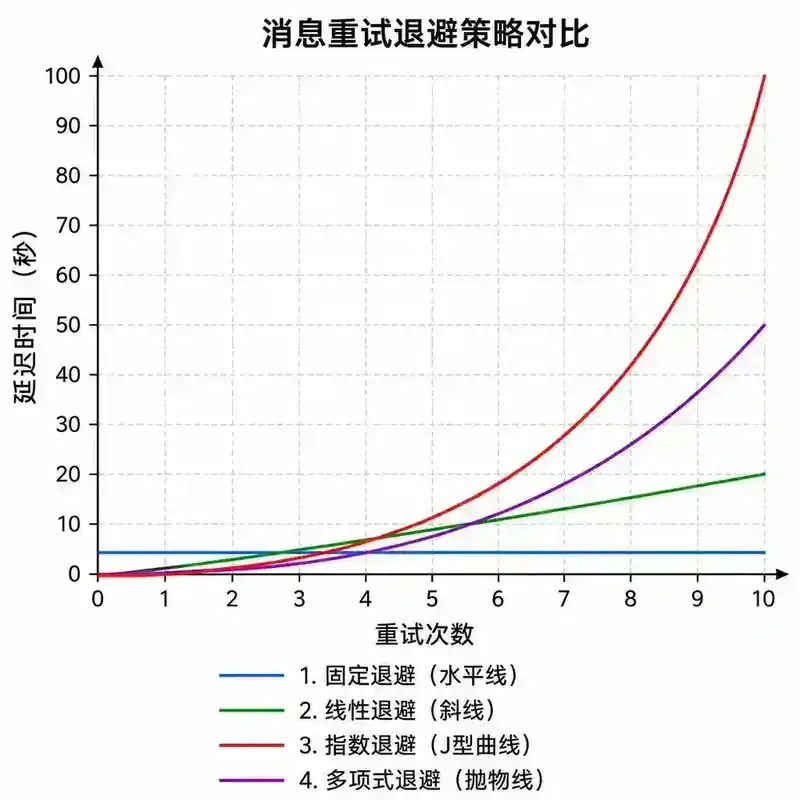
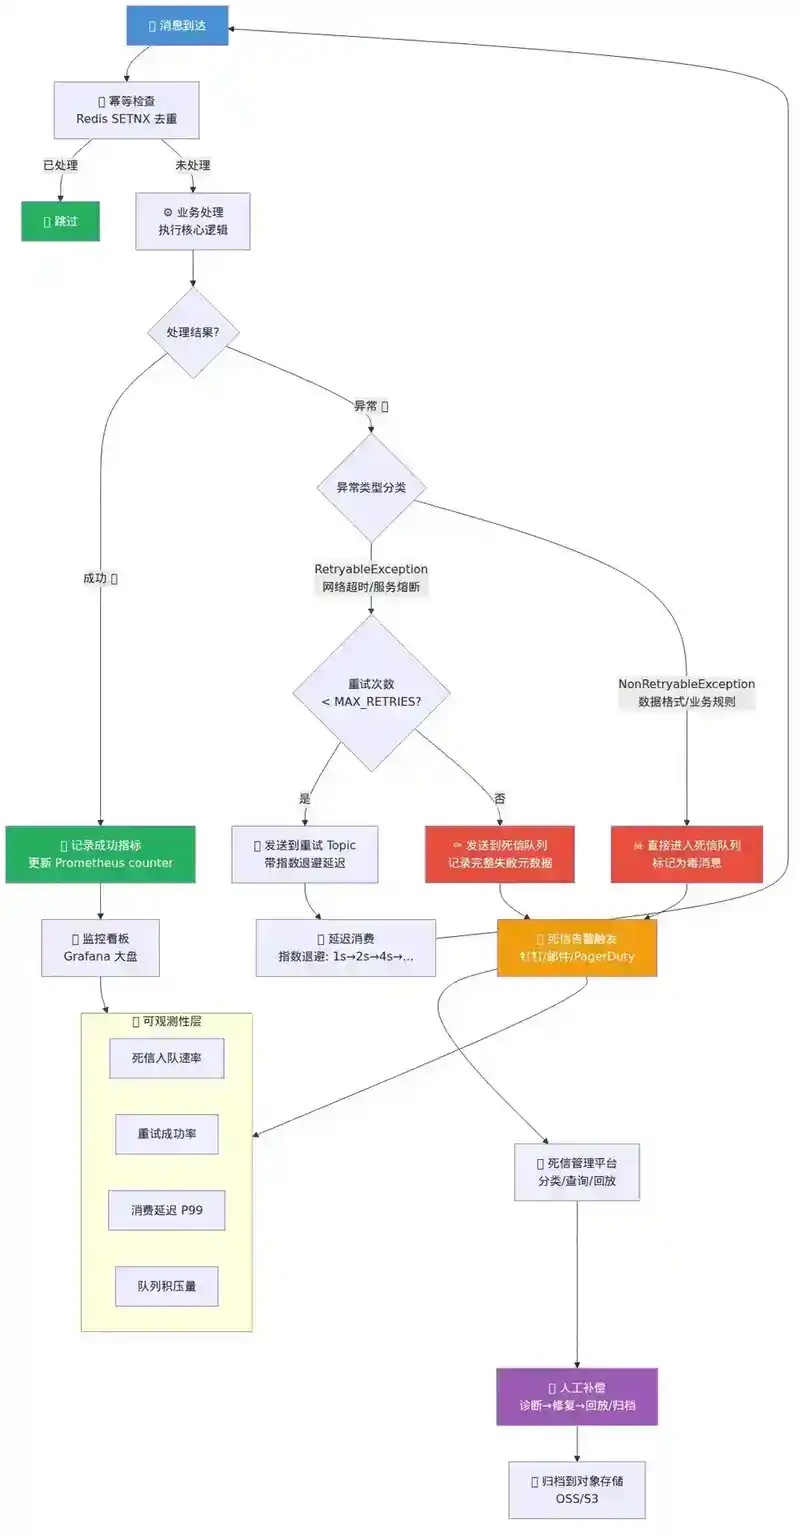
方法一:异常分类
消费端按异常类型区分:
public void consume(Message msg) {
    try {
        process(msg);
    } catch (RetryableException e) {
        // 临时故障,适合重试:网络超时、服务熔断、数据库死锁
        throw e; // 触发重试
    } catch (NonRetryableException e) {
        // 毒消息,不应重试:数据格式错误、业务规则不满足
        sendToDLQ(msg, e); // 直接进入死信队列
    }
}
方法二:重试次数阈值
无法区分异常类型时,通过重试次数判断。如果一条消息重试了 N 次仍然失败,大概率是毒消息:
// 在消息头中记录重试次数
int retryCount = msg.getHeader("RETRY_COUNT", 0);
if (retryCount >= MAX_RETRIES) {
    sendToDLQ(msg); // 达到上限,判定为毒消息
}
方法三:失败原因指纹
对失败原因做哈希,同类失败聚合统计。如果同一原因在短时间内大量出现,可能是数据批量问题,需要告警而非重试:
String failureFingerprint = DigestUtils.md5Hex(exception.getClass().getName() + ":" + exception.getMessage());
// 在 Redis 中计数,超过阈值触发告警
图4:毒消息识别与隔离流程
5.3 死信队列的隔离设计
死信队列不是简单的"失败消息垃圾桶"。一个好的死信队列设计应该:
- 保留原始消息体:不做任何修改,确保可以原样回放
- 记录失败元数据:重试次数、每次失败原因、原始 Topic/Queue、消费时间戳
- 支持查询与过滤:按失败原因、时间范围、消息 Key 检索
- 设置独立告警:死信队列有消息入队时自动触发通知
6. 人工补偿机制
6.1 为什么需要人工补偿
自动重试和死信隔离只能解决"不出事故",不能解决"出了事故怎么办"。当一条支付消息进入死信队列,自动系统无法判断应该"退款"还是"重试扣款"——这个决策需要人工介入。
人工补偿机制的三个核心能力:
- 发现:及时感知死信消息的产生
- 诊断:快速定位失败原因
- 修复:提供回放、跳过或手动补偿的手段
6.2 告警与通知
死信队列的告警设计需要分层:
| 告警级别 | 触发条件 | 响应要求 |
|---|---|---|
| P0 紧急 | 30 分钟内死信消息 > 100 条,且涉及资金/订单 | 立即响应,15 分钟内处理 |
| P1 严重 | 1 小时内死信消息 > 50 条 | 30 分钟内响应 |
| P2 一般 | 任意死信消息产生 | 工作时间处理 |
关键实践:告警信息中必须包含死信队列的直达链接,让值班人员一键跳转到死信消息列表,而不是在多个系统间跳转。
6.3 死信回放(DLQ Replay)
死信回放是将死信队列中的消息重新投递到原始 Topic,让修复后的消费端重新消费:
// 死信回放的伪代码
public void replayDLQ(String dlqTopic, List<String> messageIds) {
    List<Message> messages = fetchFromDLQ(dlqTopic, messageIds);
    for (Message msg : messages) {
        // 保留原始消息的 Key 和 Headers,确保分区路由一致
        ProducerRecord record = new ProducerRecord(
            originalTopic,
            msg.getKey(),        // 保持分区一致
            msg.getBody()
        );
        record.headers().add("REPLAY", "true".getBytes());
        record.headers().add("ORIGINAL_DLQ_TIME", String.valueOf(msg.getDlqTime()).getBytes());
        producer.send(record);
    }
}
回放策略:
- 单条回放:运维平台提供单条死信消息的手动回放按钮
- 批量回放:按失败原因、时间范围筛选后批量回放
- 条件回放:先回放到一个灰度环境验证,确认消费正常后再切换到生产环境
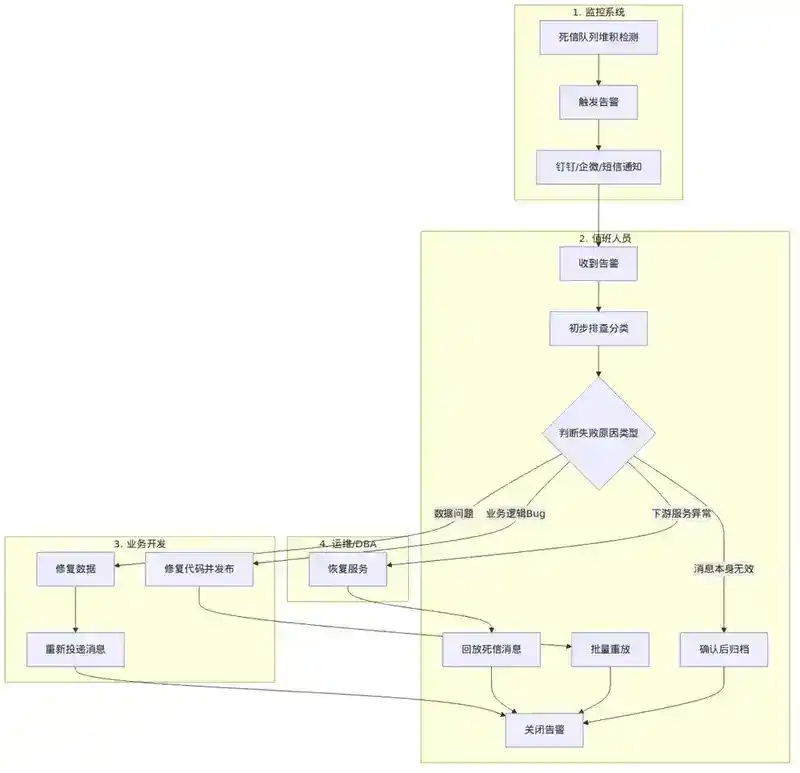
6.4 补偿流程设计
一个完整的死信处理 SOP:
1. 死信告警触发
2. 值班人员进入死信管理平台
3. 按失败原因分类查看死信消息
4. 判断失败原因:
   ├── 下游服务已恢复 → 批量回放
   ├── 数据格式问题 → 修复数据后回放
   ├── 业务逻辑变更 → 修复消费端代码后回放
   └── 确认可丢弃 → 标记为"已处理"并归档
5. 记录处理结果,关闭告警
图5:人工补偿完整流程
7. 主流消息队列的死信实现
7.1 RocketMQ
RocketMQ 的死信机制是内置的,无需额外配置:
重试机制:
- 消费失败后,消息自动发送到
%RETRY%{consumerGroup}队列 - 重试延迟等级:
1s, 5s, 10s, 30s, 1m, 2m, 3m, 4m, 5m, 6m, 7m, 8m, 9m, 10m, 20m, 30m, 1h, 2h - 默认最大重试次数:16 次
死信队列:
- 超过最大重试次数后,消息进入
%DLQ%{consumerGroup}队列 - 死信消息保留原始消息体,不会过期删除
关键代码:
// RocketMQ 消费端配置
DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("order-consumer-group");
consumer.setMaxReconsumeTimes(16); // 最大重试次数

consumer.registerMessageListener((MessageListenerConcurrently) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        try {
            process(msg);
            return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
        } catch (RetryableException e) {
            // 返回 RECONSUME_LATER,RocketMQ 自动将消息发到重试队列
            context.setDelayLevelWhenNextConsume(computeDelayLevel(msg.getReconsumeTimes()));
            return ConsumeConcurrentlyStatus.RECONSUME_LATER;
        } catch (NonRetryableException e) {
            // 毒消息:手动发送到死信队列,然后返回成功避免重复重试
            sendToDLQ(msg, e);
            return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
        }
    }
    return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
});
7.2 Kafka
Kafka 本身没有内置的死信队列机制,需要自行实现:
方案一:消费端捕获 + 单独 DLQ Topic
// Kafka 消费者中的死信处理
@KafkaListener(topics = "order-topic")
public void consume(ConsumerRecord<String, String> record) {
    try {
        orderService.process(record.value());
    } catch (RetryableException e) {
        // 发送到重试 Topic
        kafkaTemplate.send("order-topic-retry", record.key(), record.value());
    } catch (NonRetryableException e) {
        // 发送到 DLQ Topic
        DLQMessage dlqMsg = DLQMessage.builder()
            .originalTopic(record.topic())
            .originalKey(record.key())
            .originalValue(record.value())
            .failureReason(e.getMessage())
            .retryCount(getRetryCount(record))
            .timestamp(System.currentTimeMillis())
            .build();
        kafkaTemplate.send("order-topic-dlq", record.key(), JSON.toJSONString(dlqMsg));
    }
}
方案二:使用 Kafka Connect 的 Error Handling
Kafka Connect 支持 errors.deadletterqueue.topic.name 配置,自动将失败记录写入死信 Topic。
方案三:Spring Kafka 的 DeadLetterPublishingRecoverer
@Bean
public DeadLetterPublishingRecoverer recoverer(KafkaTemplate<String, String> template) {
    return new DeadLetterPublishingRecoverer(template,
        (record, exception) -> new TopicPartition(
            record.topic() + ".DLQ", record.partition()));
}
7.3 RabbitMQ
RabbitMQ 通过 死信交换机(Dead Letter Exchange, DLX) 实现死信队列:
消息成为死信的条件:
- 消息被消费者
basic.reject或basic.nack,且requeue=false - 消息在队列中的 TTL 过期
- 队列达到最大长度
配置方式:
// 声明死信交换机
@Bean
public DirectExchange dlxExchange() {
    return new DirectExchange("order-dlx");
}

@Bean
public Queue dlqQueue() {
    return QueueBuilder.durable("order-dlq").build();
}

@Bean
public Binding dlqBinding() {
    return BindingBuilder.bind(dlqQueue()).to(dlxExchange()).with("order-dlq");
}

// 业务队列绑定死信交换机
@Bean
public Queue orderQueue() {
    return QueueBuilder.durable("order-queue")
        .withArgument("x-dead-letter-exchange", "order-dlx")     // 死信交换机
        .withArgument("x-dead-letter-routing-key", "order-dlq")  // 死信路由键
        .withArgument("x-message-ttl", 60000)                     // 消息 TTL(可选)
        .build();
}
图6:RocketMQ、Kafka、RabbitMQ 三种死信实现对比
8. 生产环境最佳实践
8.1 重试幂等性保障
这是死信队列设计中最容易被忽视的致命问题。如果消费端不是幂等的,重试可能导致重复扣款、重复发货。
// 幂等性保障:基于消息唯一键去重
public void consume(Message msg) {
    String idempotentKey = msg.getTopic() + ":" + msg.getKey() + ":" + msg.getOffset();
    // Redis SETNX 实现分布式去重
    boolean acquired = redisTemplate.opsForValue()
        .setIfAbsent("idempotent:" + idempotentKey, "1", Duration.ofHours(24));
    if (!acquired) {
        log.warn("Duplicate message detected, skip: {}", idempotentKey);
        return; // 已处理过,跳过
    }
    try {
        process(msg);
    } finally {
        // 处理成功后不需要删除 Redis Key,让 TTL 自动过期即可
        // 如果处理失败,删除 Redis Key 以允许重试
        if (processingFailed) {
            redisTemplate.delete("idempotent:" + idempotentKey);
        }
    }
}
8.2 死信队列的监控指标
需要监控的核心指标:
| 指标 | 告警阈值 | 说明 |
|---|---|---|
| 死信入队速率 | > 10 条/分钟 | 可能表示消费端代码 Bug 或下游故障 |
| 死信队列积压量 | > 1000 条 | 需要人工介入处理 |
| 重试成功率 | < 90% | 重试机制效率低,或存在大量毒消息 |
| 重试平均延迟 | > 10 秒 | 退避策略过于激进 |
| 单条消息最大重试次数 | 接近上限 | 需关注是否即将进入死信 |
8.3 消费端超时与重试的协调
消费端的处理超时必须小于消息队列的消费超时,否则会出现"消息还在处理中,但 Broker 认为已超时并重新投递"的情况:
// 消费端处理超时 < Broker 的消费超时
consumer.setMaxPollIntervalMs(300_000); // Broker 端:5 分钟
// 业务处理必须在 4 分钟内完成
Future<?> future = executor.submit(() -> process(msg));
try {
    future.get(240, TimeUnit.SECONDS); // 业务超时:4 分钟
} catch (TimeoutException e) {
    future.cancel(true);
    throw new RetryableException("Processing timeout");
}
8.4 死信消息的归档与清理
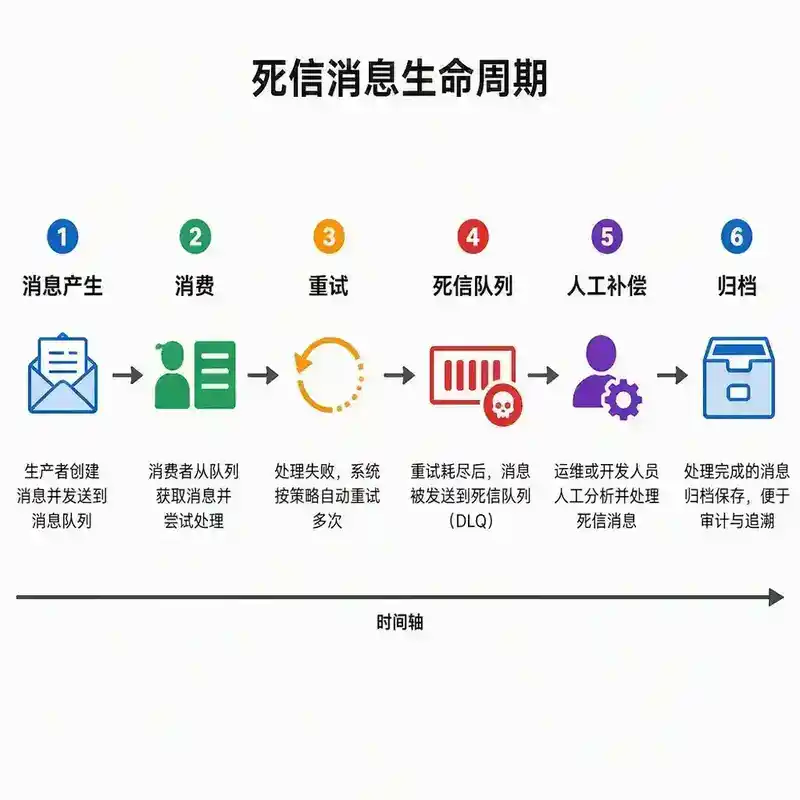
死信消息不能无限堆积。建议策略:
- 热数据(7 天内):保留在死信队列中,支持快速查询和回放
- 温数据(7-30 天):归档到对象存储(OSS/S3),可从管理平台查询但不可直接回放
- 冷数据(30 天以上):仅保留摘要统计,原始消息体可删除
图7:死信消息生命周期图
9. 常见陷阱与反模式
陷阱一:吞掉异常不重试
// 反模式:try-catch 后什么也不做
@KafkaListener(topics = "order-topic")
public void consume(String message) {
    try {
        process(message);
    } catch (Exception e) {
        log.error("消费失败", e); // 消息丢失!
    }
}
// 正确做法:要么重试,要么发到死信队列
陷阱二:无限重试
// 反模式:没有最大重试次数限制
while (true) {
    try {
        process(msg);
        break;
    } catch (Exception e) {
        Thread.sleep(1000);
    }
}
// 后果:毒消息永久阻塞消费线程
陷阱三:重试时修改消息体
// 反模式:在重试时修改消息,导致消息不可追溯
msg.setBody(modifyBody(msg.getBody())); // 不要这样做!
sendToRetryTopic(msg);
// 正确做法:在消息头中记录重试次数,消息体保持原样
陷阱四:死信队列不设监控
死信队列不是"垃圾箱",把消息丢进去不理就万事大吉了。没有监控的死信队列 = 定时炸弹。每一条死信消息都代表一次业务数据丢失的风险。
陷阱五:重试退避与消费超时冲突
如果退避间隔大于消费超时,消息会在等待重试时被 Broker 判定为超时并重新投递,导致消息被重复消费(且可能产生新的死信)。
10. 系统设计:一个健壮的消费框架
结合以上所有实践,设计一个生产级的消息消费框架:
@Component
public class RobustMessageConsumer {

    private static final int MAX_RETRIES = 10;
    private static final long BASE_DELAY_MS = 1000;
    private static final long MAX_DELAY_MS = 600_000;

    @KafkaListener(topics = "${app.kafka.topic}")
    public void consume(ConsumerRecord<String, String> record) {
        int retryCount = getRetryCount(record);
        String idempotentKey = buildIdempotentKey(record);

        // 第一步:幂等检查
        if (!acquireIdempotentLock(idempotentKey)) {
            log.debug("Duplicate message, skip: {}", idempotentKey);
            return;
        }

        try {
            // 第二步:业务处理
            processWithTimeout(record, 240, TimeUnit.SECONDS);
            // 成功:记录成功指标
            metrics.recordSuccess(record.topic());

        } catch (RetryableException e) {
            // 第三步:临时失败,判断是否需要重试
            releaseIdempotentLock(idempotentKey);

            if (retryCount < MAX_RETRIES) {
                long delay = calculateBackoffDelay(retryCount + 1);
                sendToRetryTopic(record, retryCount + 1, delay);
                metrics.recordRetry(record.topic());
            } else {
                sendToDLQ(record, e, retryCount);
                metrics.recordDLQ(record.topic());
            }

        } catch (NonRetryableException e) {
            // 第四步:毒消息,直接进死信
            sendToDLQ(record, e, retryCount);
            metrics.recordDLQ(record.topic());

        } catch (TimeoutException e) {
            // 第五步:超时,视为临时失败
            releaseIdempotentLock(idempotentKey);
            if (retryCount < MAX_RETRIES) {
                sendToRetryTopic(record, retryCount + 1, BASE_DELAY_MS);
            } else {
                sendToDLQ(record, e, retryCount);
            }
        }
    }

    private long calculateBackoffDelay(int retryCount) {
        long exponential = BASE_DELAY_MS * (1L << Math.min(retryCount - 1, 10));
        long capped = Math.min(exponential, MAX_DELAY_MS);
        long jitter = (long) (capped * 0.25 * ThreadLocalRandom.current().nextDouble());
        return capped + jitter;
    }
}
图8:生产级消息消费框架架构图
11. 总结
死信队列与重试设计是消息可靠性消费的基石。核心要点回顾:
- 重试用时间换成功率,但必须设置上限和退避策略
- 指数退避 + 抖动是生产环境首选,平衡了恢复速度和系统保护
- 毒消息要尽快识别并隔离,不要让重试机制浪费在不可恢复的错误上
- 死信队列不是终点,需要配套监控、告警和人工补偿流程
- 幂等性是重试机制的前提,没有幂等性的重试是危险的
12. 面试提问与参考答案
以下是面试官视角可能提出的问题及详细参考答案:
Q1:你们项目的消息队列中,一条消息从"消费失败"到"进入死信队列"的完整链路是怎样的?重试策略是什么?有没有遇到过毒消息阻塞整个消费分区的问题?
参考答案:
完整链路:消费端从 Broker 拉取消息 → 业务处理抛出异常 → 根据异常类型分类处理。如果是 RetryableException(网络超时、下游 503、数据库死锁等),RocketMQ 消费端返回 RECONSUME_LATER,Broker 将消息投递到 %RETRY%{consumerGroup} 队列,按延迟等级(1s/5s/10s/30s/1m...2h)逐级等待后重新投递。消息头中 reconsumeTimes 字段递增。当 reconsumeTimes >= maxReconsumeTimes(默认 16),Broker 将消息转入 %DLQ%{consumerGroup} 死信队列。对于 Kafka,需要自行实现:消费失败 → 判断 RetryableException → 发送到 {topic}-retry 重试 Topic(带延迟或由定时任务调度)→ 重试次数超过阈值 → 发送到 {topic}-dlq 死信 Topic。
关于毒消息阻塞:在生产环境中确实遇到过。某次上游系统变更了消息体的 JSON 字段名(orderId → order_id),消费端的反序列化代码未同步更新,导致所有消息解析失败。由于 Kafka 单分区消费是顺序的,第一条消息反复重试失败,该分区后续数千条消息全部被阻塞。解决方案是:消费端对 NonRetryableException(反序列化失败属于此类)直接发到死信队列并返回成功,不阻塞后续消息。同时建立异常分类规范,在代码层面区分可重试与不可重试异常。
Q2:如果下游服务(如支付网关)在秒杀高峰期被打垮,你设计指数退避时,**baseDelay**和**maxDelay**分别设多少?为什么?加入抖动(jitter)的目的是什么?
参考答案:
baseDelay 设为 1 秒,maxDelay 设为 5 分钟。理由:秒杀高峰期的支付网关通常在被限流/熔断后需要 30 秒到 2 分钟恢复。1 秒的 baseDelay 让第一次重试足够快,指数增长(1s, 2s, 4s, 8s, 16s, 32s, 64s, 128s, 256s, 300s)在第 9 次重试时达到 5 分钟上限。前 5 次重试在 31 秒内完成,覆盖了网关短暂恢复的场景;后续重试间隔拉长,给网关充分恢复时间。5 分钟上限确保总重试窗口可控(约 15 分钟),不会无限等待。
抖动(Jitter)的核心目的是打散重试时间,避免惊群效应(Thundering Herd)。假设 1000 个消费者实例同时失败,如果都用纯指数退避,它们会在完全相同的时刻(1s, 2s, 4s...)同时重试,瞬间形成新的流量洪峰再次击垮下游。加入 0-25% 随机抖动后,每个实例的重试时间点被分散到不同的毫秒位置,流量被平滑分散。生产环境中通常使用 delay = exponential_delay + random(0, exponential_delay * 0.25),即最多增加 25% 的随机偏移。
Q3:Kafka 没有内置的死信队列机制,你如何设计一个不丢失消息、不阻塞消费、且支持回放的死信方案?需要考虑哪些 corner case?
参考答案:
设计方案:
- Topic 设计:为每个业务 Topic 创建对应的重试 Topic(
{topic}-retry)和死信 Topic({topic}-dlq)。重试 Topic 建议设置多个分区以支持并行重试消费。 - 消息封装:死信消息使用统一的
DLQMessage结构,包含originalTopic、originalKey、originalValue(原始消息体不做修改)、originalHeaders、failureReason(异常类名+堆栈摘要)、retryCount、originalTimestamp、originalOffset、originalPartition。 - 消费端处理:使用
DeadLetterPublishingRecoverer(Spring Kafka)或自行实现。消费失败时:NonRetryableException→ 直接发 DLQ Topic;RetryableException→ 发重试 Topic,携带retry-countheader;重试消费者检查retry-count >= maxRetries→ 发 DLQ Topic。 - 回放能力:运维管理平台提供 DLQ 消息列表查询(按 Topic、时间范围、失败原因筛选),支持单条回放和批量回放。回放时读取
originalTopic、originalKey、originalValue,重新发送到原始 Topic,保留原始 Key 保证分区路由一致。
Corner Case:
- DLQ Topic 的分区故障:如果 DLQ Topic 所在的 Broker 宕机,死信消息写入失败。需要
sendToDLQ带重试机制(3 次本地重试),仍失败则落本地日志文件兜底。 - 回放造成的重复消息:回放后消费端可能重复消费同一条消息,必须依赖幂等性机制(Redis SETNX 以消息 Key+Offset 为去重键)。
- 死信消息体过大:原始消息可能包含大 JSON 体,DLQ Topic 分区按 Key 哈希可能倾斜。需要设置消息体大小上限(如 1MB),超出部分截断并在 DLQMessage 中记录截断标记。
- 重试 Topic 的消费延迟:如果重试消息堆积,可能早于正常消息被消费。需要考虑重试消息的优先级,或使用独立的消费者组处理重试。
Q4:假设你的系统每天产生 100 万条死信消息,你会如何设计死信消息的存储、查询和归档策略?如果运维人员需要从 30 天前的死信消息中找回某条特定订单的消息,你的方案能在多久内完成?
参考答案:
存储分层设计:
- 热存储(0-7 天):死信消息保留在 Kafka DLQ Topic 中,设置 7 天 retention。同时通过 Kafka Connect 或 Flink 实时同步到 Elasticsearch,建立索引(字段:
topic、failureReason、messageKey、timestamp)。运维平台查询走 ES,支持毫秒级全文搜索。 - 温存储(7-30 天):Kafka DLQ Topic 中的数据过期后,ES 中保留 30 天索引。ES 使用按月滚动的索引(
dlq-2026-09),30 天后自动关闭(close)索引以释放内存。 - 冷存储(30 天以上):ES 关闭的索引通过 snapshot 备份到对象存储(OSS/S3)。需要查询时,从 snapshot 恢复到临时 ES 集群。
- 消息体外置:死信消息体(可能较大)不存入 ES 索引文档中,而是存储在 OSS 上,ES 中只存 OSS 路径引用。查询时先走 ES 找到元数据,再按需从 OSS 拉取消息体。
查询 30 天前消息的流程:运维人员在管理平台输入订单号 → ES 查询跨索引(自动搜索所有 open 索引)→ 如果命中已关闭的索引,触发自动 restore(从 OSS snapshot 恢复到临时索引,2-5 分钟)→ 获取消息体引用 → 从 OSS 拉取消息体。整体耗时约 2-5 分钟。
如果每天 100 万条死信,假设每条消息的元数据约 500 字节,每天 ES 索引增量约 500MB,30 天约 15GB,一个 3 节点 ES 集群(每个节点 16GB 堆内存)完全可以承载。
Q5:在重试机制中,你如何保证消息的幂等性?如果消息体完全一样但属于两次不同的业务操作(比如用户连续点了两次"下单"),你的幂等方案如何区分"重复消费"和"两笔独立订单"?
参考答案:
幂等性方案的核心是幂等键的设计。幂等键必须唯一标识一次业务操作,而非消息体本身。
方案:使用 业务唯一键 作为幂等键,而非消息内容的哈希。对于订单场景,每条消息的 messageKey 应该设置为 orderId(下单时生成的订单号)。用户连续点两次"下单"会生成两个不同的 orderId,因此是两条不同的消息。
具体实现:idempotentKey = topic + ":" + messageKey + ":" + partition + ":" + offset。但更推荐的是直接用业务唯一键:idempotentKey = "order:" + orderId。这样即使消息被重试投递到不同分区,也能正确识别。
去重实现:
// 基于 Redis 的幂等去重
String idempotentKey = "idempotent:" + messageKey;
boolean firstTime = redis.setnx(idempotentKey, "1", 24, TimeUnit.HOURS);
if (!firstTime) {
    // 已处理过,可能是重复消费或重试投递
    // 进一步检查:对比处理结果
    String existingResult = redis.get("result:" + messageKey);
    if (existingResult != null) {
        return; // 确认已处理
    }
    // 如果结果不存在,说明上一次处理异常中断,需要重试
}
try {
    Result result = process(msg);
    redis.set("result:" + messageKey, JSON.toJSONString(result), 24, TimeUnit.HOURS);
} catch (Exception e) {
    redis.del(idempotentKey); // 处理失败,释放锁允许重试
    throw e;
}
区分"重复消费"和"两笔独立订单"的关键:消息的唯一标识符是业务层面的(如订单号),而不是消息队列层面的(如 offset)。两个独立的"下单"操作会产生两个不同的订单号,因此幂等键不同,系统会将其视为两次独立操作。而同一订单的重复投递具有相同的订单号,幂等键相同,系统会识别为重复并跳过。
Q6:你的死信队列告警是"有消息就告警"还是"达到阈值才告警"?如果凌晨 3 点突然涌入 1000 条死信消息,你的告警系统会怎么做?值班人员需要哪些信息才能快速判断是否需要立即起床处理?
参考答案:
告警策略采用分层阈值 + 智能降噪:
- P0 紧急(立即电话+短信):30 分钟内死信消息 > 100 条,且死信消息的
failureReason与资金/交易相关(通过关键 Topic 白名单识别,如order-pay、refund、account-transfer)。告警内容包含:死信消息数量、涉及的 Topic 列表、最近的失败原因 Top 5、死信管理平台直达链接。 - P1 严重(钉钉群通知):1 小时内死信消息 > 50 条,或同一
failureReason在 10 分钟内出现超过 20 次(表示可能是批量数据问题)。非工作时间不打电话,但群内 @ 值班人员。 - P2 一般(日报汇总):任意死信消息产生,工作时间处理。不触发实时通知。
凌晨 3 点涌入 1000 条死信消息的处理流程:告警系统检测到 30 分钟内死信 > 100 条 → 检查是否为资金/交易相关 Topic → 如果是,触发 P0 电话告警;如果不是,触发 P1 钉钉通知。值班人员收到告警后,通过告警信息中的直达链接进入死信管理平台,查看失败原因分布。如果所有死信消息的 failureReason 都是 PaymentGatewayTimeoutException,说明下游支付网关故障,需要联系支付团队处理,业务侧无需立即介入。如果失败原因是 NullPointerException 或 DataFormatException,说明是代码 Bug,需要立即回滚最近发布。
值班人员需要的核心信息(必须在告警中直接提供,不要让人去多个系统查):
- 死信消息数量的时间趋势图(是突然爆发还是逐步增长)
- 失败原因 Top 10 分布(饼图)
- 涉及的 Topic 列表和每条 Topic 的死信数量
- 死信管理平台直达链接(一键跳转)
- 最近一次发布的时间和变更内容摘要
- 下游依赖的健康状态(支付网关、数据库等)的快照
本文为"Java 技术专家 / 架构师面试:250 个高频考点"系列第 159 篇。
下一篇:160|事件驱动架构 EDA:领域事件、事件总线、事件溯源与最终一致性。