阅读时间:约 45 分钟 | 难度:进阶 | 分类:消息队列与事件驱动
一、引言:Kafka 为什么这么快?
在日常开发中,我们经常听到一句话:"Kafka 单机吞吐量可以达到百万 TPS。" 这不是营销话术,而是真实可达到的性能指标。在一个普通的 24 核 SSD 机器上,Kafka 可以轻松跑到 800MB/s 的写入速率和 1GB/s 的读取速率。
相比之下,一个传统的基于 B+Tree 索引的数据库,写入速率通常只能到几十 MB/s。同样是持久化到磁盘,为什么 Kafka 能比数据库快一个数量级?
答案藏在五个核心机制里:顺序写、页缓存、零拷贝、批处理和压缩。这五个机制各自承担不同的职责,又相互配合,共同构成了 Kafka 的高吞吐基石。
本文将从"为什么要这么设计"出发,逐步深入到"怎么实现的",最后给出"生产环境怎么用",帮助读者建立完整的认知链条。
二、顺序写:把随机变成顺序
2.1 磁盘的真相
很多工程师对磁盘有一个根深蒂固的印象:磁盘很慢。这个印象部分正确——磁盘的随机读写确实很慢,但顺序读写并不慢。
现代 SSD 的顺序写入速度可以达到 500MB/s 以上,即便是机械硬盘,顺序写入也能达到 100-200MB/s。真正拉低磁盘性能的是寻道时间(HDD)和随机 I/O 的队列深度问题。
一个直观的对比:
| 操作类型 | 典型延迟(SSD) | 典型吞吐 |
|---|---|---|
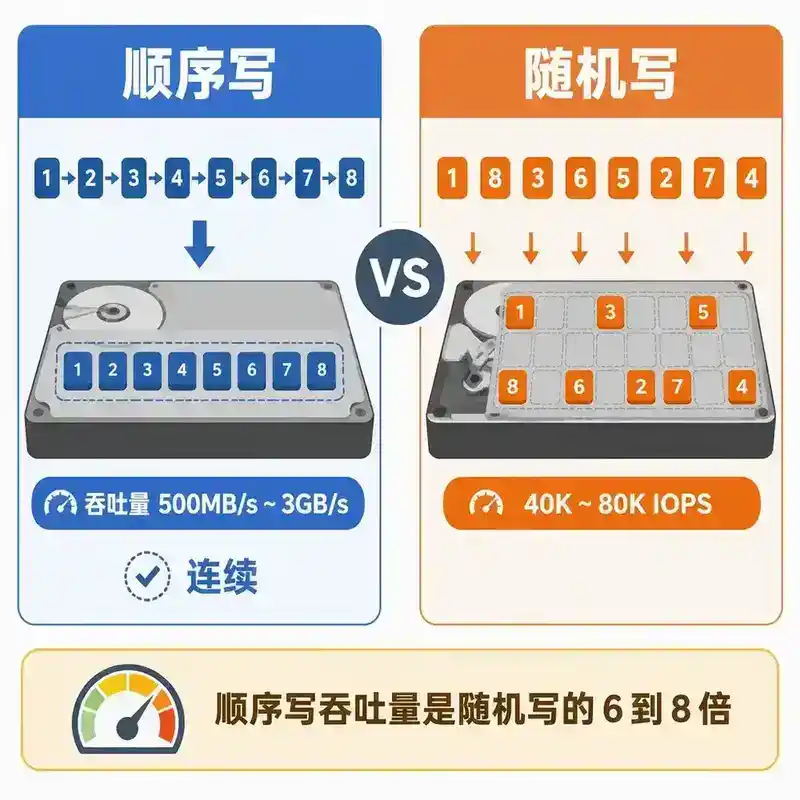
| 随机读(4KB) | ~0.1ms | ~40K IOPS ≈ 160MB/s |
| 顺序读(1MB) | 忽略不计 | ~3GB/s |
| 随机写(4KB) | ~0.05ms | ~80K IOPS ≈ 320MB/s |
| 顺序写(1MB) | 忽略不计 | ~2GB/s |
可以看到,顺序写的吞吐量是随机写的 6-8 倍。Kafka 的设计核心就是:把所有的写操作都转化为顺序写。
2.2 Kafka 如何做到顺序写
Kafka 的存储模型是 append-only log(追加写日志)。每个 Partition 在磁盘上对应一个或多个日志分段文件(Log Segment),Producer 发来的消息只能追加到当前活跃 Segment 的末尾,不能修改已经写入的消息,也不能在中间插入。
Producer → [追加到末尾] → Partition Log
                            │
                            ├── 00000000000000000000.log  (已关闭)
                            ├── 00000000000001234567.log  (已关闭)
                            └── 00000000000002345678.log  (当前活跃,追加中)
这种设计带来三个关键好处:
- 写入路径无锁竞争:因为只有一个活跃 Segment 在接收写入,且只追加不修改,不需要复杂的锁机制来协调并发写入。多个 Producer 写入同一个 Partition 时,Kafka 只需要一个简单的写锁来保证消息的顺序性。
- 操作系统预读友好:顺序写入使得 OS 的预读算法(read-ahead)可以高效地预取数据块,减少磁盘 I/O 次数。
- 清理简单:过期数据的清理只需要删除整个 Segment 文件,不需要像数据库那样逐行标记删除再整理碎片(Vacuum)。
2.3 与数据库的对比
传统数据库(如 MySQL InnoDB)使用 B+Tree 作为存储引擎。B+Tree 的写入流程是:
- 找到数据应该插入的叶子节点位置(随机读)
- 如果页已满,需要页分裂,涉及多个页的读写
- 写入 redo log(顺序写)
- 修改数据页(随机写)
- 更新索引页(随机写)
虽然 InnoDB 通过 redo log 将随机写转化为顺序写(WAL 机制),但最终数据页还是要刷盘的,随机写不可避免。Kafka 则完全避免了随机写,从源头上消除了这个瓶颈。
三、页缓存(Page Cache):依赖 OS 而不是自己管
3.1 什么是 Page Cache
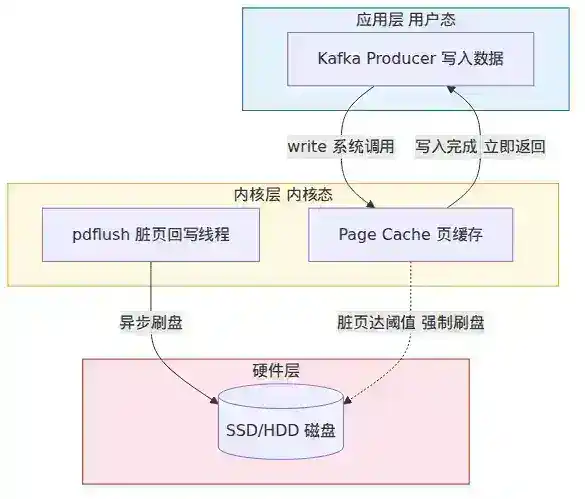
Page Cache 是 Linux 内核维护的一块内存区域,用于缓存磁盘数据。当进程读取文件时,内核会先将数据加载到 Page Cache,然后拷贝到用户态缓冲区;当进程写入文件时,数据先写入 Page Cache,内核在合适的时机(脏页回写)将数据刷到磁盘。
应用层写入
    │
    ▼
Page Cache(内核空间,内存速度)
    │  (异步刷盘,由内核 pdflush/flush 线程控制)
    ▼
磁盘(物理存储)
3.2 Kafka 的"无缓存"设计哲学
Kafka 的设计哲学是:不使用 JVM 堆内存做数据缓存,完全依赖操作系统的 Page Cache。
这是 Kafka 做的一个关键设计决策。为什么不自己管理缓存?
JVM 堆缓存的痛点:
- GC 压力:缓存大量数据在堆内存中,会导致 Full GC 时间变长,影响延迟稳定性
- 内存拷贝:数据从内核 Page Cache 到 JVM 堆,需要一次拷贝
- 容量限制:JVM 堆内存受限于
-Xmx参数,而 Page Cache 可以使用几乎所有空闲内存 - 双份缓存:JVM 堆缓存一份 + Page Cache 一份,浪费内存
使用 Page Cache 的优势:
- 数据直接从 Page Cache 发送到网络(配合零拷贝),不需要经过用户态
- Kafka 重启时,Page Cache 是冷的,但预热非常快——因为消息是顺序读写的
- 现代 Linux 内核的 Page Cache 管理非常高效,LRU 淘汰、预读、脏页回写都有成熟的算法
3.3 生产实践中的 Page Cache 调优
# 查看 Page Cache 使用情况
free -h
cat /proc/meminfo | grep -E "(Cached|Dirty|Writeback)"

# 调整脏页回写参数(更激进刷盘,减少 I/O 毛刺)
# vm.dirty_background_ratio: 当脏页达到此比例时开始后台回写
# vm.dirty_ratio: 当脏页达到此比例时阻塞写入,强制回写
sysctl -w vm.dirty_background_ratio=5
sysctl -w vm.dirty_ratio=10
一个常见的误区是给 Kafka Broker 分配过大的 JVM 堆内存。实际上,Kafka 的 JVM 堆只需要 6GB 就足够了(用于网络线程、请求处理等),剩余内存都应该留给 Page Cache。如果你有 64GB 的物理机,建议 JVM 堆设置为 6GB,剩下的 58GB 全给 Page Cache。
四、零拷贝(Zero-Copy):让数据不走 CPU
4.1 传统数据传输路径
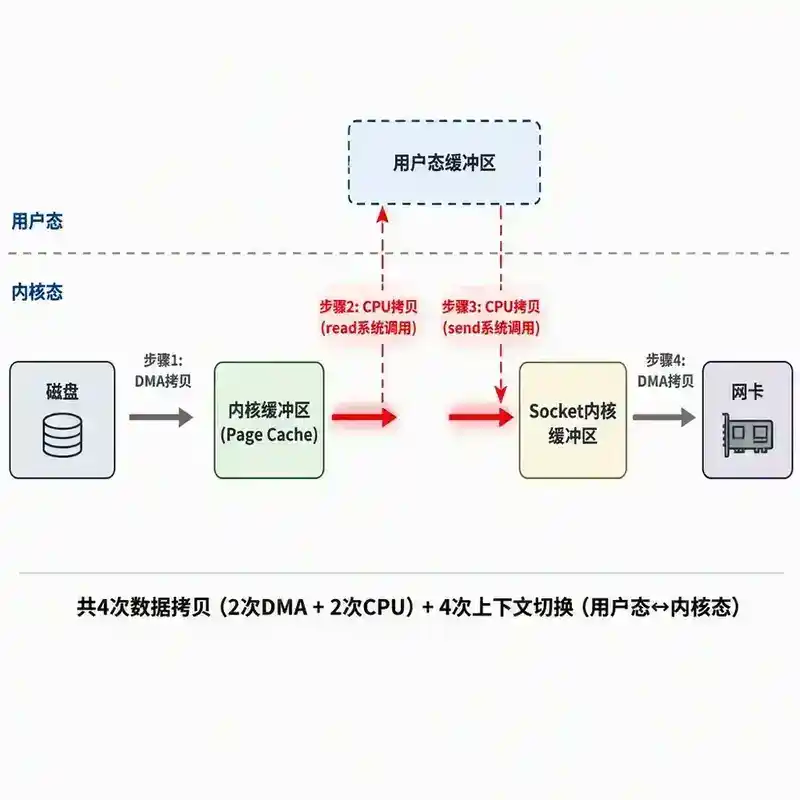
在传统的网络数据传输中,数据从磁盘到网卡需要经过 4 次拷贝和 4 次上下文切换。
以一个典型的 HTTP 文件下载为例:
磁盘 → read() → 内核缓冲区 → CPU 拷贝 → 用户态缓冲区 → CPU 拷贝 → Socket 缓冲区 → 网卡
详细步骤:
- DMA 拷贝:磁盘 → 内核 Page Cache(DMA 引擎完成,不经过 CPU)
- CPU 拷贝:内核 Page Cache → 用户态 Buffer(
read()系统调用) - CPU 拷贝:用户态 Buffer → Socket 内核缓冲区(
send()系统调用) - DMA 拷贝:Socket 内核缓冲区 → 网卡
这个过程中,步骤 2 和步骤 3 是完全多余的——数据本身不需要被用户态程序处理,只是从磁盘搬运到网卡,为什么非要经过用户态?
4.2 sendfile 系统调用
Linux 从 2.1 版本开始引入了 sendfile() 系统调用,专门优化"文件 → 网络"的数据传输路径:
sendfile(out_fd, in_fd, offset, count)
    │
    ▼
磁盘 → DMA → Page Cache → DMA → 网卡
使用 sendfile 后,数据路径变为:
- DMA 拷贝:磁盘 → Page Cache
- CPU 拷贝:Page Cache → Socket 缓冲区(少量元数据)
- DMA 拷贝:Socket 缓冲区 → 网卡
从 4 次拷贝减少到 3 次,但最关键的是消除了用户态和内核态之间的上下文切换——原来需要 4 次(read 进入内核 → read 返回 → send 进入内核 → send 返回),现在只需要 2 次(sendfile 进入内核 → sendfile 返回)。
4.3 sendfile + SG-DMA:真正的零拷贝
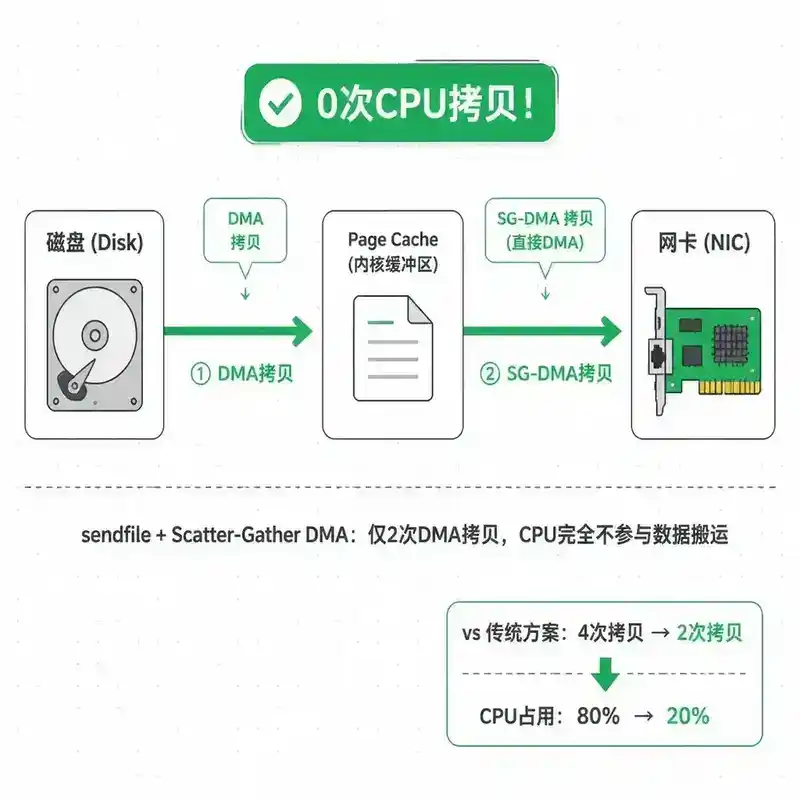
Linux 2.4 内核进一步优化,支持 Scatter-Gather DMA。在这种模式下,sendfile 不再需要将 Page Cache 的数据拷贝到 Socket 缓冲区,而是直接将 Page Cache 中的文件描述符和偏移量传递给 Socket 缓冲区,DMA 引擎直接从 Page Cache 读取数据发送到网卡:
sendfile + SG-DMA:
磁盘 → DMA → Page Cache → DMA (SG) → 网卡
只有 2 次 DMA 拷贝,0 次 CPU 拷贝! 这才是真正的"零拷贝"——CPU 完全不参与数据的搬运,数据从磁盘到网卡全部由 DMA 引擎完成。
4.4 Kafka 如何使用零拷贝
Kafka Consumer 拉取消息时,数据路径如下:
// Kafka 内部使用 FileChannel.transferTo() 实现零拷贝
// 该方法底层调用 sendfile64()
public long transferTo(long position, long count, WritableByteChannel target) {
    // 直接在内核态将 Page Cache 的数据发送到 Socket
    return transferTo0(position, count, target);
}
关键配置:
# Kafka Broker 端
# 控制 sendfile 传输的最大字节数
socket.send.buffer.bytes=102400

# 确保使用零拷贝(默认开启)
# 不需要额外配置,Kafka 默认使用 FileChannel.transferTo
零拷贝对吞吐量的提升是巨大的。在没有零拷贝的情况下,Consumer 消费消息需要:
- 从 Page Cache 拷贝到 JVM 堆(CPU 拷贝)
- 从 JVM 堆拷贝到 Socket 缓冲区(CPU 拷贝)
这两步 CPU 拷贝会消耗大量的 CPU 时间并占用内存带宽。在 1Gbps 网络下,零拷贝可以将 CPU 利用率从 ~80% 降低到 ~20%,吞吐量提升 3-4 倍。
五、批处理:减少每次 I/O 的固定开销
5.1 为什么要批处理
每次 I/O 操作都有固定的开销:系统调用、网络往返、磁盘寻址等。如果一次只发送一条消息,这个固定开销会被放大到不可接受的程度。
类比:搬家时,如果每次只搬一件小物品,来回跑 100 次,大部分时间都花在路上了。更好的做法是每次尽可能多搬一些。
Kafka 的批处理体现在两个层面:Producer 端和Broker 端。
5.2 Producer 端批处理
Producer 发送消息时,不是立即发送,而是将消息暂存在内存缓冲区中,当满足条件时批量发送:
Properties props = new Properties();
// 批次大小:达到 16KB 就发送(默认 16KB)
props.put("batch.size", 16384);
// 等待时间:最多等 10ms 就要发送(默认 0ms,即不等待)
props.put("linger.ms", 10);
// 缓冲区大小:总共最多缓存 32MB(默认 32MB)
props.put("buffer.memory", 33554432);
// 压缩类型
props.put("compression.type", "lz4");
**batch.size** 控制每个批次的最大字节数。当累积到 batch.size 大小时,Producer 立即发送。注意:这是按 Partition 维度的批处理,发送到不同 Partition 的消息不会合并。
**linger.ms** 控制等待时间。如果消息量不大,可能永远达不到 batch.size,此时 linger.ms 保证消息不会无限等待,最多等待 linger.ms 毫秒后发送。
**buffer.memory** 是 Producer 的总缓冲区。如果 Producer 发送速度跟不上消息产生速度,缓冲区会满,此时 send() 方法会阻塞(最多阻塞 max.block.ms)。
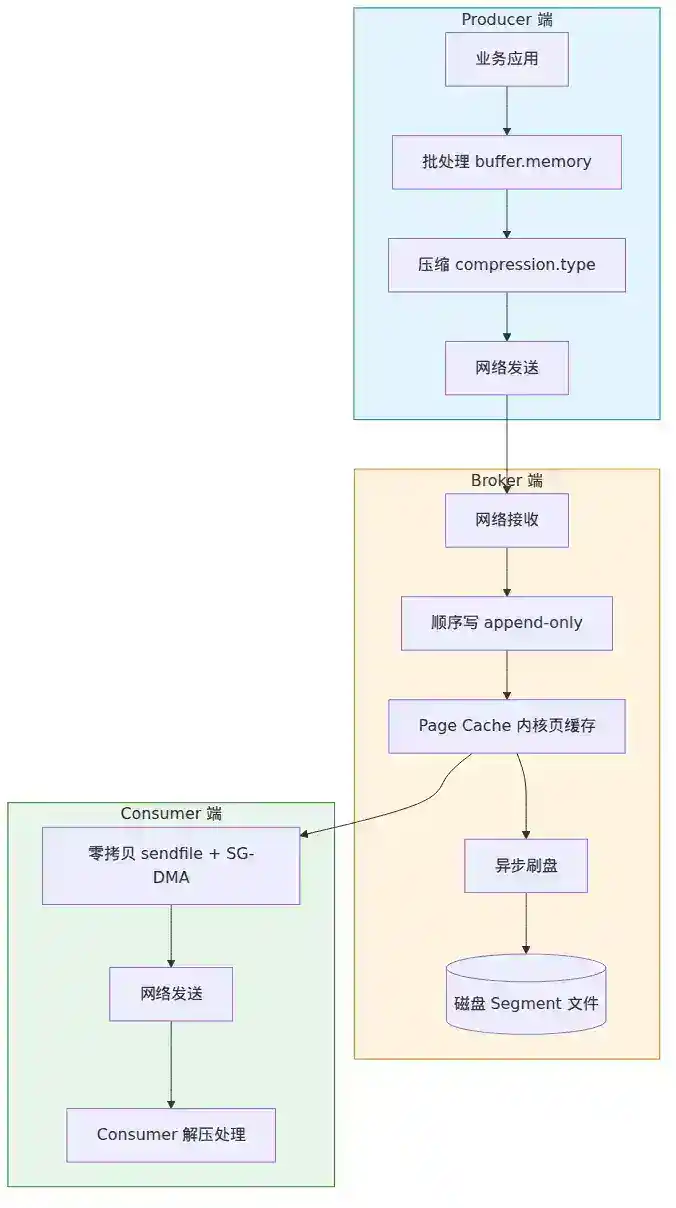
5.3 Broker 端批处理
Broker 端的批处理主要体现在:
- 写入批处理:Producer 发送来的批次,Broker 直接整体追加到日志文件中,不做拆解。一个批次内的消息使用相同的 Offset 映射和 Timestamp。
- 读取批处理:Consumer 拉取消息时,可以指定
fetch.min.bytes和fetch.max.wait.ms,Broker 在积累到足够数据或等待足够时间后才返回响应。
# Consumer 端
# 最少拉取 1 字节数据就返回(默认 1)
fetch.min.bytes=1
# 最多等待 500ms(默认 500ms)
fetch.max.wait.ms=500
# 单次拉取最大字节数(默认 50MB)
fetch.max.bytes=52428800
5.4 批处理与延迟的权衡
批处理本质上是用延迟换吞吐。批量越大,吞吐越高,但延迟也越高。
| 配置 | 高吞吐偏向 | 低延迟偏向 |
|---|---|---|
batch.size |
64KB ~ 1MB | 512B ~ 16KB |
linger.ms |
50ms ~ 200ms | 0ms ~ 5ms |
fetch.min.bytes |
1MB ~ 10MB | 1B |
fetch.max.wait.ms |
200ms ~ 500ms | 10ms ~ 100ms |
实际生产中,需要根据业务场景在延迟和吞吐之间做取舍。对于日志收集、数据同步等场景,可以牺牲一些延迟换取更高的吞吐;对于实时推荐、风控等场景,低延迟是首要目标。
六、压缩:用计算换带宽
6.1 压缩的必要性
在网络传输中,带宽是稀缺资源。压缩可以显著减少传输的数据量,但也需要消耗 CPU 进行压缩和解压缩。Kafka 支持多种压缩算法,常见的包括:
| 算法 | 压缩率 | 速度 | 适用场景 |
|---|---|---|---|
| none | 1x | 最快 | 不压缩 |
| gzip | 最高(~5-7x) | 最慢 | 带宽敏感,CPU 不敏感 |
| snappy | 中等(~2-3x) | 较快 | 均衡选择 |
| lz4 | 中等(~2-3x) | 最快 | 低延迟 + 高压缩率 |
| zstd | 高(~4-5x) | 快 | 新一代推荐 |
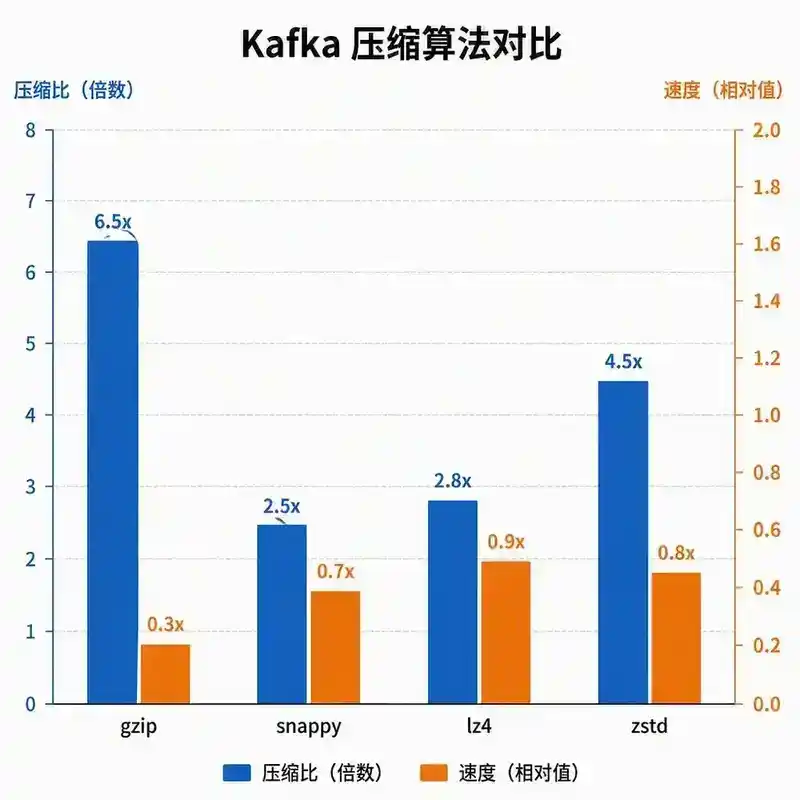
6.2 Kafka 的压缩策略
Kafka 的压缩策略非常灵活,可以在不同层面设置:
# 1. Producer 端压缩(推荐)
compression.type=lz4

# 2. Broker 端压缩(全局默认)
compression.type=producer  # 默认:保留 Producer 的压缩方式

# 3. Topic 级别压缩
# 创建 Topic 时指定
compression.type=zstd
推荐做法:在 Producer 端设置压缩。Broker 端保持默认的 producer(即保留 Producer 原始压缩的批次),这样 Broker 就不需要解压缩再重新压缩,节省 CPU。
6.3 压缩与批处理的协同效应
压缩和批处理是天然的好搭档。批处理将多条消息合并成一个批次,压缩算法可以在这个更大的数据块上获得更好的压缩率。因为压缩算法通常依赖数据中的重复模式,更大的数据块意味着更多的重复模式可以被发现。
单条消息(1KB) → gzip 压缩 → 大约 800B(压缩率低,因为数据量太小)
批量消息(16KB)→ gzip 压缩 → 大约 3KB(压缩率 5x+,因为压缩算法可以找到更多重复模式)
这就是为什么 Kafka 的压缩效果通常比想象中好的原因——批处理 + 压缩的组合拳放大了各自的优势。
6.4 生产环境压缩配置建议
# 推荐配置(兼顾性能和压缩率)
compression.type=lz4
batch.size=65536        # 64KB,给压缩更大的数据块
linger.ms=10            # 等待 10ms 积累更多消息

# 如果带宽是瓶颈,CPU 有富余
compression.type=zstd
compression.level=3     # zstd 的压缩级别,级别越高压缩率越高但越慢

# 如果 CPU 是瓶颈
compression.type=snappy  # 或者 lz4,二者 CPU 开销都较小
一个真实案例:某电商平台在双十一期间,将 Kafka 的压缩算法从 snappy 改为 zstd,配合 batch.size=128KB,网络带宽使用量降低了 40%,同时 CPU 使用率仅增加了 5%。
七、五机制协同全景图
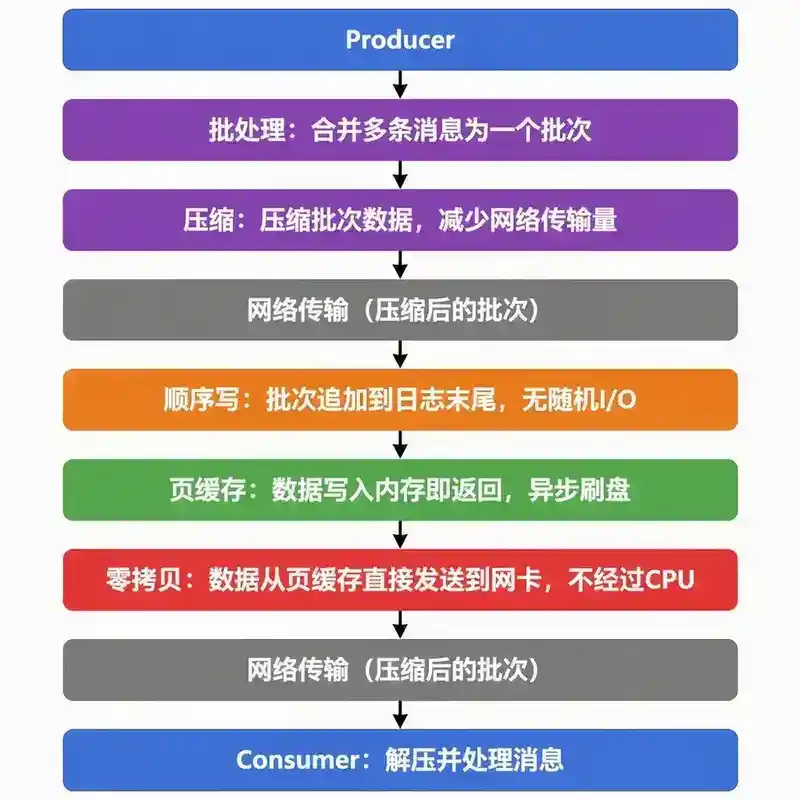
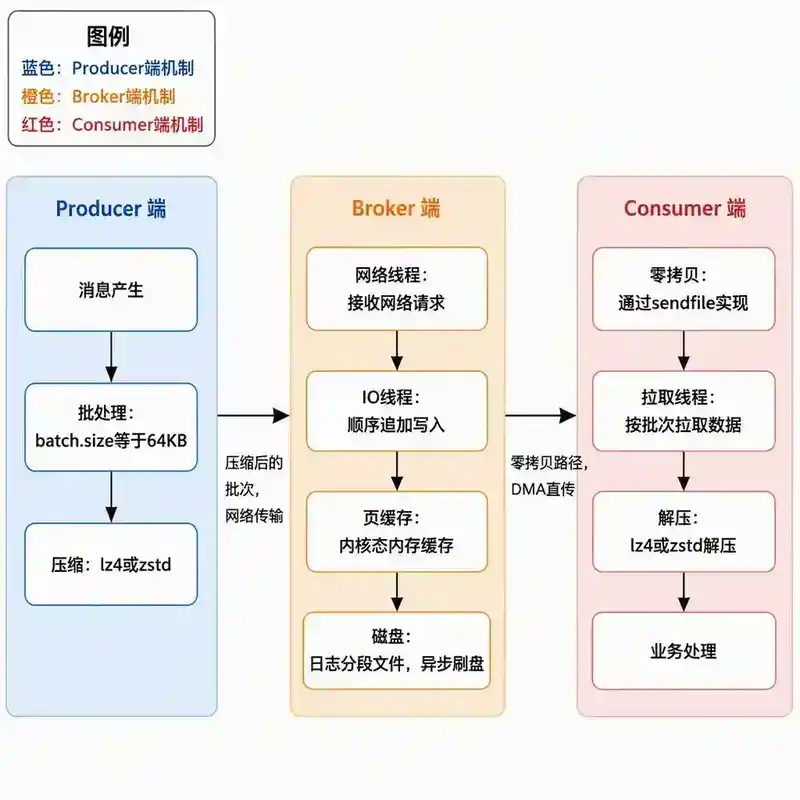
前面我们分别讲了五个机制,现在把它们串联起来,看看一条消息从 Producer 到 Consumer 的完整旅程中,每个机制在哪个环节发挥作用:
Producer 端
    │
    ├── 批处理(batch.size + linger.ms)
    │      多条消息合并为一个批次
    │
    ├── 压缩(compression.type)
    │      批次数据压缩,减少网络传输量
    │
    ▼
网络传输(压缩后的批次)
    │
    ▼
Broker 端
    │
    ├── 顺序写(append-only log)
    │      批次直接追加到 Segment 末尾,无随机 I/O
    │
    ├── 页缓存(Page Cache)
    │      数据写入内存即返回,异步刷盘
    │
    ▼
Consumer 端
    │
    ├── 零拷贝(sendfile + SG-DMA)
    │      数据从 Page Cache 直接 DMA 到网卡,不经过 CPU
    │
    ▼
网络传输(压缩后的批次)
    │
    ▼
Consumer 解压 + 处理
各个机制的分工总结:
| 机制 | 解决的问题 | 起作用的环节 | 性能提升量级 |
|---|---|---|---|
| 顺序写 | 磁盘随机 I/O 瓶颈 | Broker 写入 | 6-8x |
| 页缓存 | 用户态/内核态数据拷贝 + JVM GC | Broker 读写 | 2-3x |
| 零拷贝 | CPU 拷贝 + 上下文切换 | Broker → Consumer | 3-4x |
| 批处理 | 每次 I/O 的固定开销 | Producer → Broker + Consumer | 5-10x |
| 压缩 | 网络带宽 | Producer → Broker and Broker → Consumer | 2-5x |
八、常见误区与陷阱
8.1 误区一:Page Cache 就是全部,不需要关注磁盘
错误:有了 Page Cache,磁盘性能不重要了。
真相:Page Cache 只是缓存,最终数据还是要刷盘的。如果磁盘写入速度跟不上消息产生速度,脏页会不断积累,最终触发操作系统强制刷盘,导致写入阻塞。在流量尖峰时,磁盘性能仍然是瓶颈。
建议:生产环境建议使用 SSD,并且监控 vm.dirty_ratio 和磁盘 I/O 利用率。
8.2 误区二:零拷贝在任何情况下都生效
错误:只要用了 Kafka,读取消息就是零拷贝。
真相:零拷贝只在 Consumer 读取未压缩的消息时生效。如果 Consumer 拉取的是压缩数据(Producer 端压缩),Broker 需要先解压缩再发送,此时零拷贝不生效。
建议:如果你的场景中 Consumer 端对延迟非常敏感,可以考虑在 Broker 端设置 compression.type=producer(默认),让 Broker 不解压直接转发压缩批次,Consumer 端解压。这样虽然 Broker 端不经过零拷贝路径,但整体吞吐更高。
8.3 误区三:batch.size 越大越好
错误:batch.size 设置得越大,吞吐越高。
真相:batch.size 过大会导致消息延迟增加,且如果 Producer 流量不大,缓冲区永远填不满,就一直等待 linger.ms 到期。此外,过大的批次会增加 Broker 端的内存压力。
建议:从默认的 16KB 开始,逐步调大并以实际压测数据为准。一般 64KB ~ 256KB 是比较合理的范围。
8.4 误区四:压缩算法 gzip 压缩率最高,应该一直用
错误:gzip 压缩率最高,选它总没错。
真相:gzip 虽然压缩率高,但 CPU 开销也最大,且压缩和解压速度慢。对于高吞吐场景,CPU 往往是瓶颈,gzip 的压缩/解压开销可能拖慢整个 pipeline。Zstd 在压缩率接近 gzip 的同时,速度远快于 gzip,是当前的最佳选择。
九、生产环境调优检查清单
9.1 Broker 端检查
- [ ] JVM 堆内存不超过 8GB,剩余内存留给 Page Cache
- [ ] 使用 SSD 存储,监控磁盘 I/O 利用率
- [ ] num.io.threads 设置为 CPU 核数
- [ ] num.network.threads 设置为 CPU 核数
- [ ] log.flush.interval.messages 和 log.flush.interval.ms 保持默认(不强制刷盘)
- [ ] 调整脏页回写参数 vm.dirty_background_ratio=5,vm.dirty_ratio=10
9.2 Producer 端检查
- [ ] compression.type=lz4 或 zstd
- [ ] batch.size 根据流量调整(64KB ~ 256KB)
- [ ] linger.ms 根据延迟要求调整(5ms ~ 50ms)
- [ ] buffer.memory 足够大,避免阻塞
- [ ] 监控 record-error-rate 和 request-latency-avg
9.3 Consumer 端检查
- [ ] fetch.min.bytes 适当增大(如 10KB),减少小请求
- [ ] fetch.max.wait.ms 根据延迟要求调整
- [ ] Consumer 处理能力要跟上拉取速度,避免 max.poll.interval.ms 超时导致 Rebalance
十、总结
Kafka 的高吞吐不是单一技术的胜利,而是五个机制协同作用的结果:
- 顺序写从根源上消除了磁盘随机 I/O 瓶颈,让 Kafka 的写入速度接近磁盘硬件极限
- 页缓存避免了 JVM 堆缓存的双重拷贝和 GC 压力,让数据尽量在内核态流转
- 零拷贝消除了 CPU 在数据搬运中的参与,让数据从磁盘到网卡全由 DMA 引擎完成
- 批处理摊薄了每次 I/O 的固定开销,在吞吐和延迟之间灵活权衡
- 压缩用计算换取带宽,与批处理配合实现超高的传输效率
这五个机制环环相扣,各自独立又相互加强。理解它们,不仅有助于用好 Kafka,也能帮助我们在设计其他高性能系统时找到合适的优化思路。
面试官视角:问题与思考
以下是面试官在考察 Kafka 高吞吐机制时可能提出的问题,建议读者先尝试独立回答,再查看参考答案。
Q1:Kafka 为什么使用顺序写而不是像数据库那样用 B+Tree 索引?如果让你设计一个支持随机读取的消息队列,你会怎么设计存储层?
考察点:对存储引擎设计取舍的理解,能否在"只追加"和"可修改"之间做架构权衡。
参考答案:Kafka 选择顺序写是因为它的使用场景是消息队列——消息只需要按时间顺序消费,不需要随机读取某条特定消息。顺序写 + 追加模型天然适合这个场景,性能最优。
如果设计一个支持随机读取的消息队列,核心矛盾在于"写入性能"和"读取灵活性"的取舍。可以考虑:
- 存储层使用 LSM-Tree(Log-Structured Merge Tree),写入时先追加到活跃 Segment,后台异步 Compaction 时构建索引
- 在追加日志的基础上,异步构建稀疏索引(类似 Kafka 的 Index 文件),支持按 Offset 和时间戳定位
- 对于需要按 Key 查找的场景,在内存中维护一个 HashMap 索引(类似 RocksDB 的 BlockBasedTable)
关键是:写入路径保持顺序写,索引构建放到异步路径。
Q2:零拷贝在 Kafka 中具体是怎么实现的?如果 Consumer 端启用了 SSL 加密传输,零拷贝还能生效吗?为什么?
考察点:对零拷贝底层原理的理解,以及能否分析实际场景中的失效条件。
参考答案:Kafka 通过 FileChannel.transferTo() → sendfile64() 系统调用实现零拷贝。数据路径是:磁盘 → DMA → Page Cache → DMA(SG-DMA)→ 网卡。
当启用 SSL/TLS 时,零拷贝不能生效。原因是 SSL 需要在 CPU 中对数据进行加密,这意味着数据必须从 Page Cache 拷贝到用户态进行加密处理,然后再发送到 Socket 缓冲区。此时数据路径变为:磁盘 → DMA → Page Cache → CPU 拷贝 → 用户态(加密)→ CPU 拷贝 → Socket 缓冲区 → DMA → 网卡。
这就是安全性和性能的经典权衡:SSL 提供了传输安全,但牺牲了零拷贝的性能优势。
Q3:Kafka 依赖操作系统的 Page Cache 而不是自己管理缓存,这种设计有什么优缺点?什么场景下 Page Cache 会成为瓶颈?
考察点:对"依赖 OS"和"自己管理"两种设计哲学的理解,以及能否分析 Page Cache 的局限性。
参考答案:
优点:
- 避免 JVM GC 压力——大堆内存会导致 GC 停顿
- 避免双重缓存——JVM 堆 + Page Cache 各一份,浪费内存
- 充分利用 OS 的成熟算法——LRU、预读、脏页回写
- 重启后缓存预热快——顺序读使得 Page Cache 很快恢复热度
缺点:
- 无法精细控制缓存策略——什么时候淘汰、淘汰哪些,由 OS 决定
- 跨进程缓存污染——其他进程的 I/O 可能挤占 Kafka 的 Page Cache
- 冷启动时性能差——新启动的 Broker 需要从磁盘读取数据,延迟高
Page Cache 成为瓶颈的场景:
- 流量突增,数据量超过可用内存,Page Cache 频繁换入换出(Thrashing)
- 多个 Topic 的 Consumer 消费速度差异大,慢 Consumer 导致历史数据回读,将热数据挤出去
- 机器上运行了其他 I/O 密集型进程,竞争 Page Cache
Q4:如果你有一个 Kafka 集群,Producer 的 TPS 是 50 万,Consumer 的 TPS 也是 50 万,但 Consumer 延迟很高(P99 超过 500ms),你从哪些维度排查和优化?
考察点:系统性排查问题的方法论,以及能否将高吞吐机制的知识应用到实际故障诊断中。
参考答案:从 Producer → Broker → Consumer 三个维度排查:
Producer 端:
- 检查
linger.ms是否过大——增大批处理会提高吞吐但增加延迟 - 检查
batch.size是否过大,导致某个 Partition 的批次等待时间过长
Broker 端:
- 检查是否启用了 SSL(导致零拷贝失效)
- 检查
compression.type配置——如果 Producer 端压缩了,Broker 端解压需要 CPU - 检查磁盘 I/O——如果 Page Cache 命中率低,Consumer 需要从磁盘读取
- 检查
fetch.min.bytes和fetch.max.wait.ms配置
Consumer 端:
- 检查
fetch.min.bytes是否过大,导致 Consumer 等待数据积累 - 检查 Consumer 处理逻辑是否有阻塞——如果处理耗时超过
max.poll.interval.ms,会触发 Rebalance - 检查 Consumer 数量和 Partition 数量是否匹配——如果 Consumer 多于 Partition,多余的 Consumer 闲置
横向对比:吞吐 50 万 TPS 对于 Kafka 来说不算高,P99 延迟 500ms 说明系统存在明显的瓶颈点。最可能的原因是 Consumer 端的处理逻辑中有阻塞操作(如数据库写入、外部 API 调用),或者是 Consumer 配置不当导致拉取频率过低。
Q5:假设你有一个 Kafka 集群,30 个 Broker,单机 32 核 CPU、128GB 内存、4 块 NVMe SSD(RAID 0)。你如何估算这个集群的写入吞吐上限?写出你的估算过程和关键假设。
考察点:能否将理论知识与实际硬件参数结合,进行容量估算。
参考答案:
关键假设:
- 每条消息平均大小:1KB
- 压缩算法:lz4,压缩率 ~2.5x
- 副本因子:3
- 网络:25Gbps 网卡
计算过程:
单机磁盘写入能力:
- 4 块 NVMe SSD RAID 0,顺序写入约 3GB/s × 4 = 12GB/s(理论值)
- 实际保守估计:8GB/s(考虑 RAID 开销和实际负载)
Page Cache 命中率:
- 假设 80% 的 Consumer 读取命中 Page Cache
- 80% × 128GB = 102GB 的热数据
单机网络能力:
- 25Gbps ≈ 3.1GB/s
- 写入流量:副本因子 3,每 1B 原始数据产生 3B 写入流量
- 如果单机写入 1GB/s 原始数据,网络写入 = 3GB/s(作为 Leader 写入 1GB/s + 作为 Follower 接收 2GB/s)
单机写入吞吐上限:
- 网络瓶颈:3.1GB/s ÷ 3 = 约 1GB/s(原始数据)
- 磁盘瓶颈:8GB/s ÷ 3 = 约 2.6GB/s(原始数据)
- 取最小值:1GB/s
集群总吞吐:
- 30 台 × 1GB/s = 30GB/s
- 消息大小 1KB,TPS = 30GB/s ÷ 1KB = 3000 万 TPS
注意:这是理论上限。实际中需要考虑:
- 流量不均衡(热点 Partition)
- Follower 拉取和 ISR 缩扩
- Consumer 拉取消耗的带宽
- 实际保守估计:理论值的 50% ~ 70%,即 1500 万 ~ 2100 万 TPS
本文是 Kafka 高吞吐机制的完整讲解,属于"10 消息队列与事件驱动"分类的第 148 号考点。下一篇文章将讲解 Kafka 生产者可靠性(acks、重试、幂等生产、事务和顺序性)。