阅读时间:约 45 分钟 适用读者:高级 Java 工程师、技术专家、架构师 前置知识:Java 并发编程、分布式系统基础、网络编程基础
目录
- 引言:一个没有消息队列的电商系统
- 消息队列是什么:生产者、消费者、Broker 的基本模型
- 核心价值一:解耦——让系统从"紧耦合"中解放
- 核心价值二:削峰填谷——用时间换空间
- 核心价值三:异步处理——让快的更快,慢的慢慢来
- 消息队列引入的复杂度:没有免费午餐
- 消息队列的典型使用模式
- 什么时候不该用消息队列
- 实战:从一个订单系统看消息队列的引入决策
- 总结
- 面试官提问
1. 引言:一个没有消息队列的电商系统
1.1 一个下订单的"简单"需求
假设你在做一个电商系统,用户下单后需要完成以下操作:
- 扣减库存
- 创建订单记录
- 发送下单成功短信
- 发送下单成功邮件
- 给用户增加积分
- 写入操作日志
- 触发推荐系统的用户画像更新
最直观的写法:
@Transactional
public Order placeOrder(OrderRequest request) {
    // 1. 扣减库存
    inventoryService.deduct(request.getSkuId(), request.getQuantity());
    // 2. 创建订单
    Order order = orderDao.insert(request);
    // 3. 发短信
    smsService.send(request.getPhone(), "下单成功!");
    // 4. 发邮件
    emailService.send(request.getEmail(), "Order Confirmed", template);
    // 5. 加积分
    pointsService.addPoints(request.getUserId(), 100);
    // 6. 写日志
    auditLogService.log("ORDER_PLACED", order.getId());
    // 7. 更新用户画像
    recommendationService.updateProfile(request.getUserId());
    return order;
}
这段代码看起来没问题,但让我们看看它实际发生了什么。
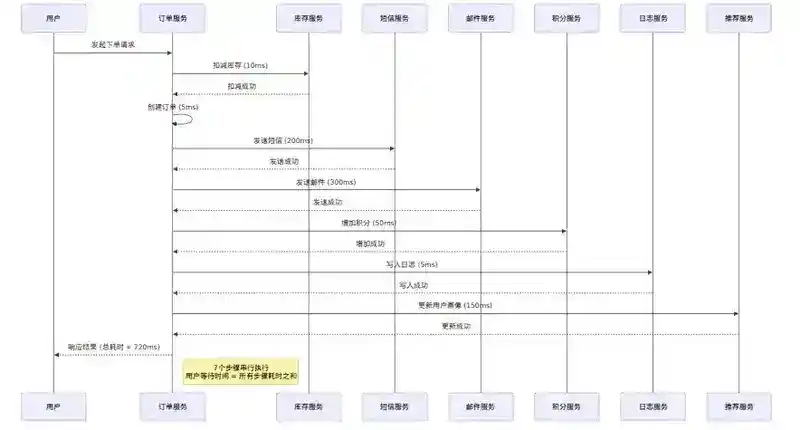
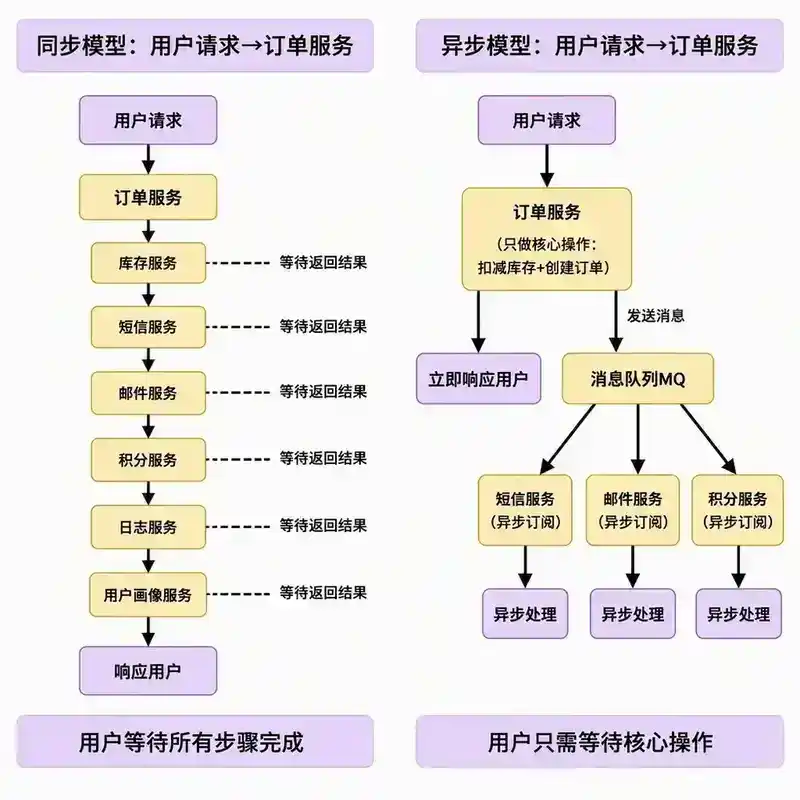
[图1:下单接口的同步调用链路图——7 个步骤串行执行,用户等待总时间 = 所有步骤耗时之和]
1.2 三个逐渐浮现的问题
问题一:响应时间失控
| 步骤 | 耗时 |
|---|---|
| 扣减库存 | 10ms |
| 创建订单 | 5ms |
| 发短信(调用运营商 API) | 200ms |
| 发邮件(SMTP) | 300ms |
| 加积分 | 50ms |
| 写日志 | 5ms |
| 更新用户画像 | 150ms |
| 总计 | ≈720ms |
用户点完"下单"按钮后要等将近 1 秒才能看到结果。如果短信服务商 API 抖动到 2 秒,用户等待时间就是 2.5 秒——这在秒杀场景下是不可接受的。
问题二:故障传播
短信服务挂了 → smsService.send() 抛异常 → 事务回滚 → 订单创建失败
用户明明只是想买个东西,短信服务挂了就买不了?这不合理。短信、邮件、积分这些是"锦上添花"的操作,不应该成为订单创建的前置条件。
问题三:系统耦合爆炸
订单服务 直接依赖:
├── 库存服务
├── 短信服务
├── 邮件服务
├── 积分服务
├── 日志服务
└── 推荐服务
每增加一个新功能(比如"下单后给用户发优惠券"),就要改订单服务的代码。订单服务成了一个"大泥球",任何下游服务的变更都可能导致订单服务不可用。
1.3 消息队列的解法
引入消息队列后,订单服务只做一件事:创建订单,然后发一条消息。
@Transactional
public Order placeOrder(OrderRequest request) {
    inventoryService.deduct(request.getSkuId(), request.getQuantity());
    Order order = orderDao.insert(request);
    // 只发一条消息,剩下的不管
    mqProducer.send(new OrderPlacedEvent(order));
    return order;
}
响应时间从 720ms 降到 15ms(库存扣减 + 订单创建)。短信、邮件、积分等服务各自订阅消息,独立处理。
这背后的核心思想就是消息队列的三大价值:解耦、削峰、异步。本文将从这三个维度深入剖析消息队列的核心价值,同时也正视它引入的复杂度——因为"没有银弹"是分布式系统最重要的认知。
2. 消息队列是什么:生产者、消费者、Broker 的基本模型
2.1 核心角色
消息队列(Message Queue)是一个异步通信中间件,其核心模型由三个角色组成:
生产者(Producer)──→  Broker(消息代理)──→  消费者(Consumer)
     发送消息           存储和路由消息           接收和处理消息
[图2:消息队列基本模型三要素——Producer、Broker、Consumer 及消息流向]
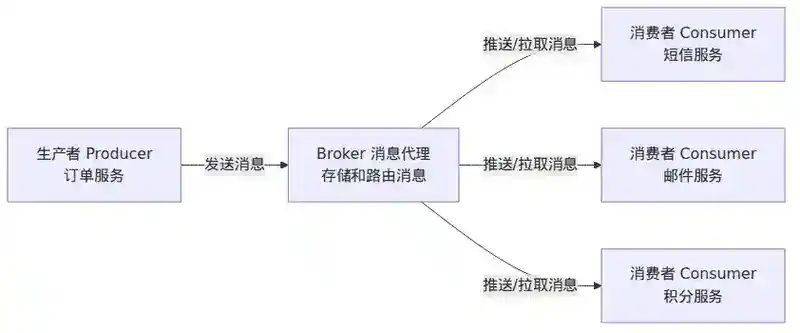
生产者(Producer):产生消息的一方。在上面的例子中,订单服务就是生产者。它只负责把消息发出去,不关心谁消费、怎么消费。
Broker(消息代理):消息队列的核心服务。负责接收消息、持久化存储、路由分发。Broker 是生产者和消费者之间的"中间人",它解耦了二者。
消费者(Consumer):消费消息的一方。短信服务、邮件服务、积分服务都是消费者。它们从 Broker 拉取(或由 Broker 推送)消息,然后执行自己的业务逻辑。
2.2 两种通信模型:队列模型 vs 发布订阅模型
消息队列有两种基本通信模型:
队列模型(Point-to-Point):
Producer → Queue → Consumer
           (一条消息只被一个消费者消费一次)
- 一条消息只会被一个消费者消费
- 消费成功后消息从队列中删除
- 多个消费者可以并行消费同一个队列中的不同消息
- 典型代表:RabbitMQ 的 Work Queue、RocketMQ 的集群消费
发布订阅模型(Publish-Subscribe):
Producer → Topic → Subscriber A
                  → Subscriber B
                  → Subscriber C
           (一条消息被所有订阅者消费)
- 一条消息会被所有订阅者消费
- 每个订阅者独立维护自己的消费进度
- 典型代表:Kafka 的 Consumer Group、RocketMQ 的广播消费
2.3 Topic、Queue、Partition 的概念区分
不同消息队列对"消息的逻辑容器"有不同的命名,但核心思想相通:
| 概念 | Kafka | RocketMQ | RabbitMQ |
|---|---|---|---|
| 消息的逻辑容器 | Topic | Topic | Exchange + Queue |
| 物理分区 | Partition | MessageQueue | Queue(无内置分区) |
| 消费组 | Consumer Group | Consumer Group | 无原生支持(通过 Queue 绑定模拟) |
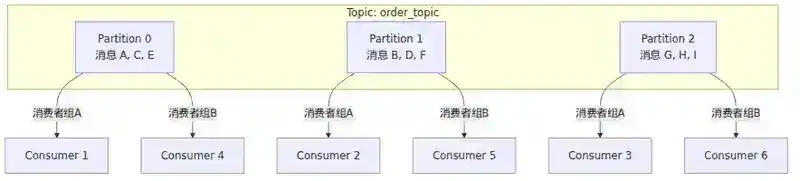
Topic:消息的逻辑分类,类似"频道"。用户下单是 order_topic,用户注册是 user_topic。
Partition / MessageQueue:Topic 的物理分区。一个 Topic 可以有多个 Partition,分布在不同的 Broker 节点上,实现水平扩展和并行处理。这是 Kafka 和 RocketMQ 实现高吞吐量的关键。
[图3:Topic 与 Partition 的关系——一个 Topic 包含多个 Partition,每个 Partition 是一个有序的消息队列]
2.4 消息队列的基本语义
消息投递语义是所有消息队列的核心设计约束:
| 语义 | 含义 | 实现方式 |
|---|---|---|
| 至多一次(At-most-once) | 消息可能丢失,但不会重复 | 发完即忘,无确认机制 |
| 至少一次(At-least-once) | 消息不会丢失,但可能重复 | 消费确认 + 重试机制 |
| 恰好一次(Exactly-once) | 消息不丢不重,精确一次 | 事务 + 幂等(极其复杂) |
大多数消息队列默认提供"至少一次"语义,这也是工程实践中最常用的折中——保证消息不丢,但需要消费者自己处理重复。
3. 核心价值一:解耦——让系统从"紧耦合"中解放
3.1 什么是耦合
在软件工程中,耦合(Coupling)衡量的是模块之间的依赖程度。紧耦合系统的问题:
修改模块 A → 需要同时修改模块 B、C、D
模块 B 挂了 → 模块 A 也受影响
团队 B 开发慢 → 团队 A 被阻塞
消息队列通过引入一个中间层,将直接依赖变成间接依赖,将同步调用变成异步通知。
3.2 解耦的三个维度
维度一:代码解耦
没有 MQ:
订单服务 import 短信服务的 Client
订单服务 import 邮件服务的 Client
订单服务 import 积分服务的 Client
订单服务 import 日志服务的 Client
...(每加一个下游,订单服务就要加一个依赖)

有 MQ:
订单服务只 import 消息队列的 Client
(所有下游服务独立订阅消息,订单服务不需要知道它们的存在)
新增一个"下单后发优惠券"的功能,不需要改订单服务一行代码。优惠券服务只需要订阅 order_topic 即可。
维度二:团队解耦
没有 MQ:
订单团队(5 人)做功能时,需要等短信团队(3 人)对齐接口
→ 短信团队排期到下个月 → 订单团队被阻塞

有 MQ:
订单团队定义好消息格式 {"orderId": "xxx", "userId": "yyy", "amount": 99.00}
→ 发到 order_topic
→ 短信团队自己订阅,自己解析,自己开发
→ 两个团队并行开发,互不阻塞
维度三:故障隔离
没有 MQ:
短信服务挂了 → 短信 SDK 调用失败 → 订单服务拿不到返回 → 创建订单失败

有 MQ:
短信服务挂了 → 短信消费者拉取消息失败 → 消息留在 Broker
→ 订单服务完全不受影响,继续正常创建订单
→ 短信服务恢复后,从 Broker 读取积压消息,继续处理
这是一个质的飞跃:下游服务的故障不再影响上游服务的可用性。
3.3 解耦的代价:接口契约
解耦不是"无约束"。需要定义清晰的消息格式作为生产者和消费者之间的契约:
{
  "eventId": "uuid-xxx",
  "eventType": "ORDER_PLACED",
  "timestamp": "2026-09-04T10:00:00Z",
  "data": {
    "orderId": "12345",
    "userId": "67890",
    "amount": 99.00,
    "skuId": "SKU-001",
    "quantity": 2
  }
}
消息格式就是解耦后的"接口"。它需要:
- 向前兼容:新增字段不能破坏老消费者的解析
- 版本管理:重大变更时使用新的 eventType(如
ORDER_PLACED_V2) - Schema Registry:在 Kafka 等系统中,可以用 Schema Registry 管理消息格式的演进
4. 核心价值二:削峰填谷——用时间换空间
4.1 流量峰谷问题
互联网系统的流量通常是"峰谷分明"的:
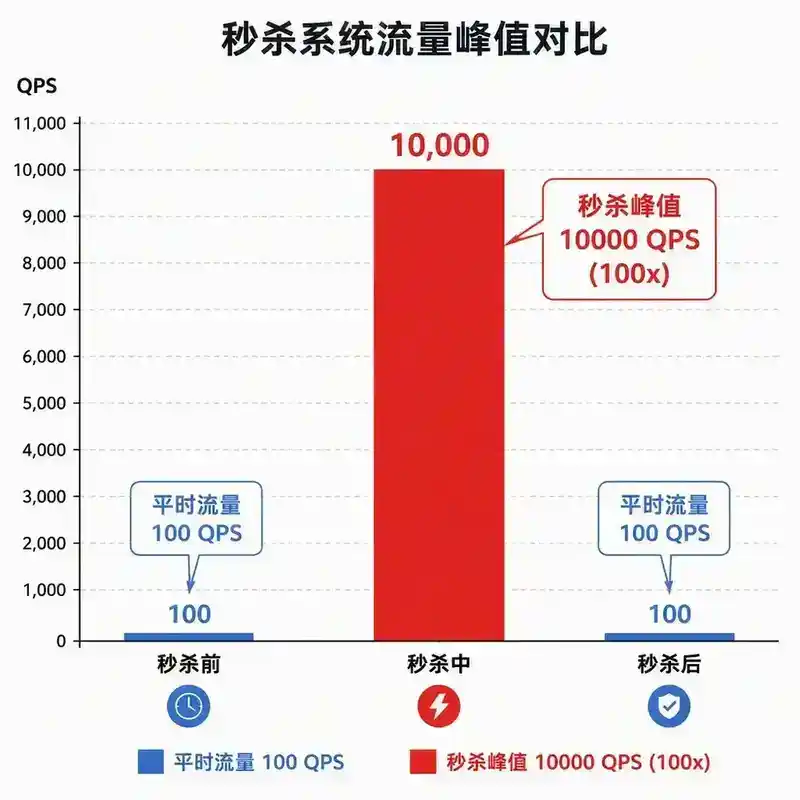
秒杀场景:
  平时:100 QPS
  秒杀开始:10000 QPS(100 倍)
  秒杀结束:100 QPS

如果不做削峰:
  数据库需要按 10000 QPS 配置 → 平时 99% 的资源闲置
  按 100 QPS 配置 → 秒杀时直接打挂
[图4:流量峰谷对比图——秒杀时瞬时流量是平时的 100 倍,系统需要应对这种极端情况]
4.2 削峰填谷的原理
消息队列充当"蓄水池":
          ┌─────────────────────────┐
          │      10000 QPS 流量      │
          │  ↓  ↓  ↓  ↓  ↓  ↓  ↓   │
          │  ┌─────────────────┐    │
          │  │   消息队列(蓄水池) │    │
          │  │  消息堆积 100 万条  │    │
          │  └────────┬────────┘    │
          │           ↓  ↓  ↓       │
          │      1000 QPS 消费      │
          └─────────────────────────┘
- 流量洪峰到来时,消息写入 Broker 的速度远大于消费速度 → 消息在 Broker 中堆积
- 流量洪峰过去后,消费者继续以稳定的速度处理堆积的消息
- 数据库始终以 1000 QPS 的稳定速率运行,不会被打挂
"填谷":消费者在流量低谷时继续处理堆积消息,不会闲置。
4.3 削峰的关键参数
积压能力:Broker 能存储多少消息?
Kafka:磁盘可以存 TB 级别的消息(消息持久化到磁盘,可配置保留时间)
RocketMQ:磁盘存储,同样支持海量消息堆积
RabbitMQ:默认内存存储,大量堆积会耗尽内存,需要配置 Lazy Queue
消费速率:消费者处理一条消息需要多长时间?
消费速率 = 消费者实例数 × 单实例并发度 / 单条消息处理时间

例如:
- 10 个消费者实例
- 每个实例 20 个线程
- 每条消息处理 50ms
→ 消费速率 = 10 × 20 / 0.05 = 4000 条/秒
积压时间:高峰期消息堆积需要多久才能消化完?
积压时间 = 堆积消息量 / (消费速率 - 生产速率)

例如:
- 秒杀 10 分钟,每秒产生 10000 条,共 600 万条
- 消费速率 1000 条/秒,秒杀结束后生产速率降为 100 条/秒
- 积压时间 = 600 万 / (1000 - 100) ≈ 6667 秒 ≈ 1.85 小时
4.4 削峰不是银弹
消息积压的风险:
- 消费延迟:用户下单后 2 小时才收到短信,体验很差
- 磁盘写满:如果消费速率长期低于生产速率,Broker 磁盘会被写满
- 消息过期:Broker 通常有消息保留期限,超期消息会被删除
应对策略:
- 设置消息积压告警:当 Lag 超过阈值时告警
- 紧急扩容消费者:增加消费者实例数,临时提升消费速率
- 降级处理:高峰期跳过非核心消费(如用户画像更新),优先保证核心消费(如短信通知)
- 限流:在生产者端做限流,防止消息队列本身被打挂
5. 核心价值三:异步处理——让快的更快,慢的慢慢来
5.1 同步 vs 异步
同步模型:调用方等待被调用方完成,拿到结果后再继续。
用户请求 → 订单服务 → 库存服务 → 返回结果 → 订单服务 → 短信服务 → 返回结果 → ... → 响应用户
异步模型:调用方不等待结果,立即返回,被调用方在后台处理。
用户请求 → 订单服务(核心操作)→ 立即响应用户
                ↓
          发消息到 MQ
                ↓
      短信服务(异步处理)
      邮件服务(异步处理)
      积分服务(异步处理)
5.2 异步处理的两个层次
层次一:请求-响应解耦
用户请求不需要等待所有处理完成。核心操作(创建订单)完成后立即返回,非核心操作(通知、日志)异步处理。
层次二:事件驱动编排
更进一步的异步——将业务流程拆分为多个事件驱动的步骤:
OrderCreated → PaymentRequested → PaymentConfirmed → InventoryDeducted → ShipmentPrepared
每个步骤消费一个事件,处理后产生下一个事件。这是**事件驱动架构(EDA)**的基础。
[图5:同步 vs 异步处理对比——同步模型下用户等待所有步骤完成,异步模型下用户只需等待核心操作]
5.3 异步处理的设计原则
原则一:区分核心流程和非核心流程
核心流程(必须同步完成):
├── 库存扣减
└── 订单创建

非核心流程(可以异步处理):
├── 发送短信
├── 发送邮件
├── 增加积分
├── 写入日志
└── 更新用户画像
原则二:非核心流程失败不影响核心流程
核心流程成功 = 订单创建成功 = 返回用户"下单成功"
非核心流程失败 = 消息重试,或进入死信队列,人工处理
原则三:用户感知的"最终完成"
下单成功后,用户可以在"订单详情"页看到处理进度:
订单状态:已下单 → 已支付 → 已发货 → 已完成
通知状态:短信已发送 ✓ | 邮件已发送 ✓
前端通过轮询或 WebSocket 获取这些异步处理的状态。
6. 消息队列引入的复杂度:没有免费午餐
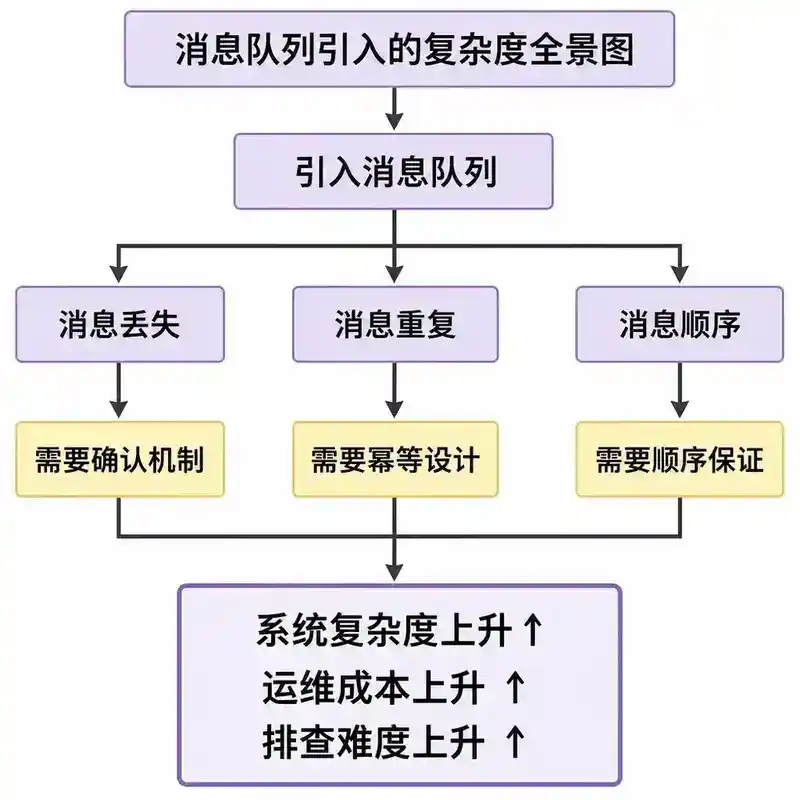
6.1 复杂度的全景图
消息队列解决了问题,但引入了新的问题。你必须清楚地认识到这些代价:
            ┌─────────────────┐
            │   引入消息队列    │
            └────────┬────────┘
                     │
    ┌────────────────┼────────────────┐
    ↓                ↓                ↓
 消息丢失          消息重复          消息顺序
    ↓                ↓                ↓
 需要确认机制      需要幂等设计      需要顺序保证
    ↓                ↓                ↓
    └────────────────┼────────────────┘
                     ↓
              系统复杂度 ↑↑↑
              运维成本 ↑↑↑
              排查难度 ↑↑↑
[图6:消息队列引入的复杂度全景图——MQ 解决了同步耦合问题,但引入了消息丢失、重复、顺序、积压等一系列新挑战]
6.2 消息丢失
消息可能在三个环节丢失:
生产阶段:Producer → Broker(网络抖动,消息没发出去)
存储阶段:Broker 内存(Broker 宕机,内存消息丢失)
消费阶段:Broker → Consumer(消费者挂了,消息没确认就被删了)
应对:
- 生产阶段:使用同步发送 + 确认回调(
acks=allin Kafka) - 存储阶段:多副本机制(Kafka 的 Replication,RocketMQ 的同步刷盘)
- 消费阶段:消费完成后手动确认,不要自动确认
6.3 消息重复
"至少一次"语义下,消息重复是不可避免的:
场景 1:Producer 发送消息,Broker 收到了,但 ACK 网络丢包
       → Producer 重发 → 同一条消息在 Broker 中出现两次

场景 2:Consumer 消费消息,处理完了,但在 ACK 之前宕机
       → Consumer 重启 → 重新消费同一条消息
应对:消费者做幂等处理。这是消息队列使用中最重要的一条原则。
// 幂等消费:利用数据库唯一约束
@Transactional
public void consume(OrderMessage msg) {
    // 以消息 ID 作为幂等键
    if (idempotentDao.exists(msg.getMessageId())) {
        return; // 已经处理过,跳过
    }
    // 处理业务逻辑
    processOrder(msg);
    // 记录幂等键
    idempotentDao.insert(msg.getMessageId());
}
6.4 消息顺序
消息队列中的顺序是一个复杂的问题:
Producer 按顺序发送:A → B → C
Partition 1:A → C(B 可能去了其他分区)
Consumer 并行消费:先拿到 C,后拿到 A
应对:
- 需要全局顺序 → 使用单 Partition(牺牲吞吐量)
- 需要局部顺序 → 同一业务 ID 的消息路由到同一 Partition(如 orderId 做 key)
- 消费者端:单线程消费一个 Partition,保证处理顺序
6.5 分布式事务
消息队列和数据库之间的双写一致性是分布式事务的经典问题:
场景:创建订单(写数据库) + 发消息(写 MQ)

问题:数据库写入成功,但消息发送失败 → 数据不一致
问题:消息发送成功,但数据库写入失败 → 数据不一致
应对方案:
- 事务消息(RocketMQ 原生支持):先发半消息 → 执行本地事务 → 根据结果提交或回滚
- 本地消息表:将消息写入数据库的同一事务中,然后异步发送
- Outbox 模式:
INSERT INTO outbox与业务操作在同一事务,CDC 监听 outbox 表发送消息
6.6 运维复杂度
新增的运维负担:
需要部署和维护的组件:
├── 消息队列集群(至少 3 个节点)
├── 监控系统(Lag、吞吐量、磁盘使用率)
├── 死信队列处理
├── 消息积压应急脚本
└── 消息格式版本管理
新增的故障场景:
- Broker 宕机 → 消息堆积 → 消费者空转
- 磁盘写满 → Broker 拒绝写入 → 生产者报错
- 网络分区 → 脑裂 → 数据不一致
7. 消息队列的典型使用模式
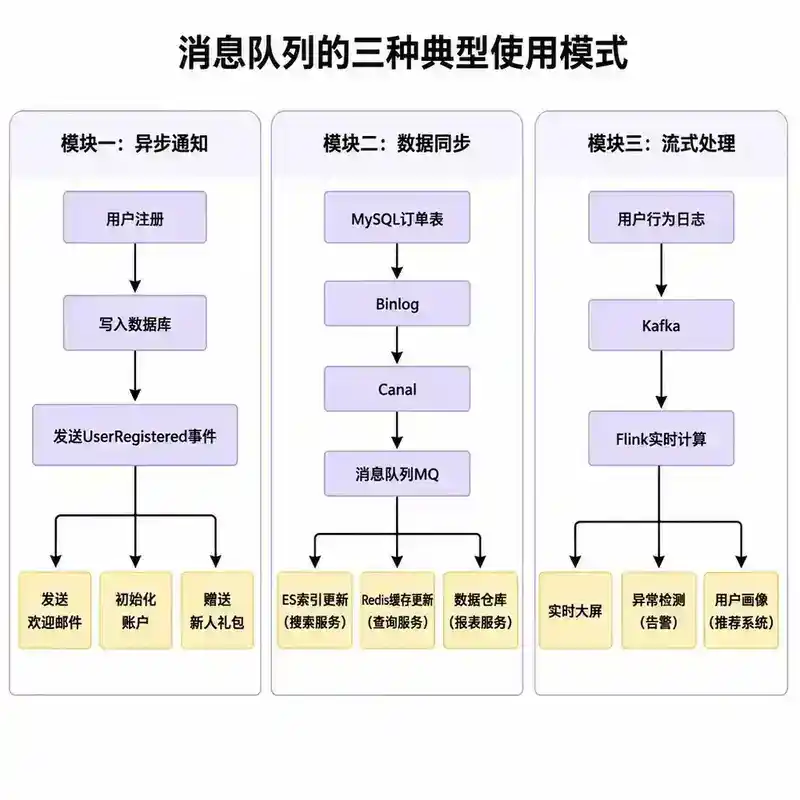
7.1 模式一:异步通知
最常见的模式。上游完成核心操作后,发消息通知下游。
用户注册 → 写入数据库 → 发送 UserRegistered 事件
                            ↓
               ┌────────────┼────────────┐
               ↓            ↓            ↓
          发送欢迎邮件   初始化账户    赠送新人礼包
7.2 模式二:数据同步
通过消息队列实现异构系统之间的数据同步。
MySQL 订单表 → Binlog → Canal → MQ → ES 索引更新 → 搜索服务
                                  → Redis 缓存更新 → 查询服务
                                  → 数据仓库 → 报表服务
7.3 模式三:流式处理
消息队列作为流式处理的数据管道。
用户行为日志 → Kafka → Flink 实时计算 → 实时大屏
                               → 异常检测 → 告警
                               → 用户画像 → 推荐系统
[图7:消息队列的三种典型使用模式——异步通知、数据同步、流式处理]
7.4 模式四:命令查询职责分离(CQRS)
写操作发命令消息,读操作从专门的读模型查询。
Command(写):POST /orders → OrderCommand → MQ → OrderCommandHandler → DB
Query(读):  GET /orders/123 → OrderQueryHandler → ReadModel(ES/Redis)
7.5 模式五:事件溯源(Event Sourcing)
不存储当前状态,而是存储所有状态变更事件。当前状态 = 事件流的折叠结果。
账户余额 = 初始余额 + 所有充值事件 - 所有扣款事件
8. 什么时候不该用消息队列
8.1 决策框架
引入消息队列之前,问自己三个问题:
问题一:这个调用真的需要异步吗?
如果被调用方返回结果对调用方后续逻辑至关重要 → 同步调用更合适
如果只是"通知"性质的 → 可以考虑异步
问题二:消息丢失的后果可以接受吗?
如果消息丢失会导致严重的业务问题(如资金丢失) → 需要额外的保障机制
如果消息丢失只是"少发了一条通知" → 可以接受
问题三:团队有运维消息队列的能力吗?
如果团队只有 3 个人,已经负责了 5 个系统 → 引入 MQ 是给自己找麻烦
如果公司有专门的中间件团队 → 可以考虑
8.2 不适合用消息队列的场景
| 场景 | 原因 | 替代方案 |
|---|---|---|
| 强一致性要求 | MQ 天然是异步的,无法保证同步一致性 | 分布式事务框架(Seata) |
| 低延迟要求(< 1ms) | MQ 引入至少 1-5ms 的延迟 | 直接 RPC 调用 |
| 简单的单体应用 | 过度设计,增加不必要的复杂度 | 直接用 Spring Event 或线程池 |
| 团队没有 MQ 经验 | 运维成本大于收益 | 先做技术储备,再引入 |
| 数据量极小 | 不需要削峰 | 直接同步处理 |
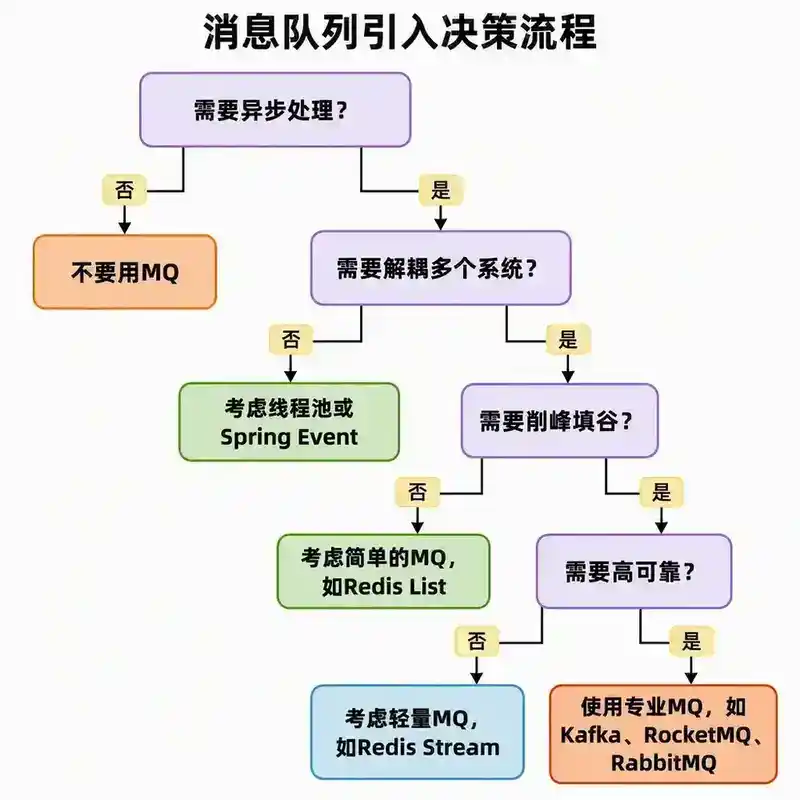
8.3 一个判断流程图
需要异步处理?
├── 否 → 不要用 MQ
└── 是 → 需要解耦多个系统?
    ├── 否 → 考虑线程池 / Spring Event
    └── 是 → 需要削峰填谷?
        ├── 否 → 考虑简单的 MQ(如 Redis List)
        └── 是 → 需要高可靠?
            ├── 否 → 考虑轻量 MQ(如 Redis Stream)
            └── 是 → 使用专业 MQ(Kafka / RocketMQ / RabbitMQ)
[图8:消息队列引入决策流程图——从需求出发,判断是否需要以及需要什么级别的 MQ]
9. 实战:从一个订单系统看消息队列的引入决策
9.1 场景描述
某电商平台订单系统现状:
当前架构:
- 订单服务(单体 Spring Boot 应用)
- 每日订单量:10 万
- 峰值 QPS:500
- 下单接口平均响应时间:200ms

业务需求:
- 即将上线"双十一大促",预计峰值 QPS 5000
- 需要新增"下单后推荐相似商品"功能
- 需要对接第三方风控系统
9.2 分阶段引入消息队列
第一阶段:异步化非核心流程
目标:将下单接口响应时间从 200ms 降到 50ms。
// 改造前:同步处理所有逻辑
@Transactional
public Order placeOrder(OrderRequest req) {
    Order order = orderDao.insert(req);          // 5ms
    inventoryService.deduct(req);                 // 10ms
    couponService.use(req.getCouponId());         // 15ms
    smsService.send(req.getPhone());              // 80ms
    emailService.send(req.getEmail());             // 80ms
    auditLog.write("ORDER_PLACED");               // 10ms
    return order;  // 总耗时 ≈ 200ms
}

// 改造后:核心同步,非核心异步
@Transactional
public Order placeOrder(OrderRequest req) {
    Order order = orderDao.insert(req);          // 5ms
    inventoryService.deduct(req);                 // 10ms
    couponService.use(req.getCouponId());         // 15ms
    // 发消息,以下操作异步处理
    mqProducer.send(new OrderPlacedEvent(order));  // 2ms
    return order;  // 总耗时 ≈ 32ms
}
第二阶段:引入削峰能力
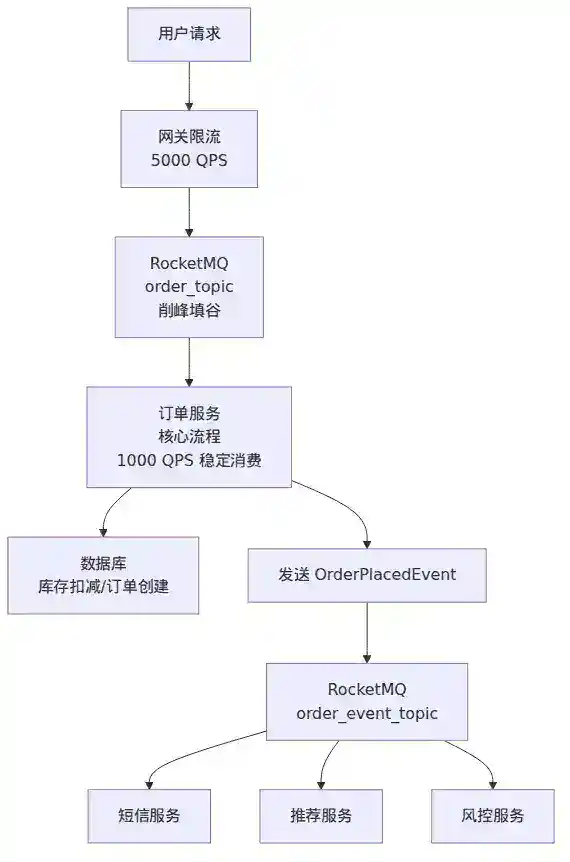
大促期间,5000 QPS 的流量直接打到数据库是扛不住的。在订单服务前加一层 MQ:
用户请求 → 网关限流(5000 QPS)→ MQ → 订单服务(1000 QPS 稳定消费)→ 数据库
这样数据库始终以 1000 QPS 的速率运行,不会因为瞬时流量而崩溃。
第三阶段:事件驱动的新功能接入
新增"推荐服务"和"风控服务"时,只需要订阅 order_topic:
// 推荐服务:完全独立部署,不依赖订单服务
@RocketMQMessageListener(topic = "order_topic", consumerGroup = "recommendation")
public class RecommendationConsumer implements RocketMQListener<OrderPlacedEvent> {
    @Override
    public void onMessage(OrderPlacedEvent event) {
        // 根据订单信息更新用户画像,推荐相似商品
        recommendationService.updateProfile(event.getUserId(), event.getItems());
    }
}

// 风控服务:同样独立部署
@RocketMQMessageListener(topic = "order_topic", consumerGroup = "risk_control")
public class RiskControlConsumer implements RocketMQListener<OrderPlacedEvent> {
    @Override
    public void onMessage(OrderPlacedEvent event) {
        // 异步风控检查,高风险订单标记为"待审核"
        riskControlService.check(event.getOrderId());
    }
}
9.3 改造后的架构
                      ┌──────────────────┐
                      │   网关(限流)     │
                      └────────┬─────────┘
                               ↓ 5000 QPS
                      ┌──────────────────┐
                      │   RocketMQ        │
                      │   order_topic     │
                      └────────┬─────────┘
                               ↓ 1000 QPS
                      ┌──────────────────┐
                      │   订单服务        │
                      │   (核心流程)      │
                      └────────┬─────────┘
                               ↓ 发送 OrderPlacedEvent
                      ┌──────────────────┐
                      │   RocketMQ        │
                      │   order_event_topic│
                      └──┬──────┬──────┬─┘
                         ↓      ↓      ↓
                   短信服务  推荐服务  风控服务
[图9:订单系统改造后的架构图——网关层限流 → MQ 削峰 → 订单服务稳定消费 → 事件驱动下游服务]
9.4 关键指标对比
| 指标 | 改造前 | 改造后 | 提升 |
|---|---|---|---|
| 下单接口 P99 延迟 | 200ms | 35ms | 82% ↓ |
| 峰值可承载 QPS | 500 | 5000 | 10 倍 |
| 新增功能对接时间 | 2 周(改订单服务) | 2 天(独立开发) | 85% ↓ |
| 下游故障影响 | 订单服务不可用 | 订单服务不受影响 | 质的提升 |
| 运维组件数 | 1 | 3(新增 MQ 集群 + 监控) | 复杂度 ↑ |
10. 总结
10.1 核心要点回顾
- 消息队列的三大核心价值:解耦(降低系统间依赖)、削峰填谷(用时间换空间,保护后端服务)、异步处理(提升响应速度,实现事件驱动)
- 消息队列的基本模型:Producer → Broker → Consumer,分为队列模型和发布订阅模型
- 解耦的本质:将直接依赖变成间接依赖,将同步调用变成异步通知,实现代码解耦、团队解耦和故障隔离
- 削峰的原理:用 MQ 作为"蓄水池",将瞬时高流量转换为稳定的低流量,保护后端服务
- 异步处理的原则:区分核心流程和非核心流程,核心同步、非核心异步,非核心失败不影响核心
- 消息队列的代价:消息丢失、消息重复、消息顺序、分布式事务、运维复杂度——这些都是必须正视的挑战
- 不是所有场景都适合 MQ:强一致性要求、低延迟要求、简单单体应用、团队能力不足时,引入 MQ 是过度设计
10.2 决策速查表
| 场景 | 是否引入 MQ | 推荐方案 |
|---|---|---|
| 单体应用,内部模块间异步调用 | 不一定 | 先考虑 Spring Event / 线程池 |
| 多个独立服务,需要解耦通知 | 是 | RocketMQ / Kafka |
| 秒杀/大促,需要削峰 | 是 | RocketMQ(事务消息) / Kafka |
| 实时流式处理 | 是 | Kafka(流处理生态) |
| 需要强一致性 | 否 | 分布式事务框架 |
| 需要低延迟同步响应 | 否 | 直接 RPC |
| 简单任务队列 | 不一定 | Redis List / Redis Stream |
10.3 一句话总结
消息队列用"解耦"解决系统间依赖问题,用"削峰"解决流量冲击问题,用"异步"解决响应延迟问题——但它的代价是引入了消息可靠性、幂等、顺序、事务等一系列新的复杂度。没有银弹,只有权衡。
11. 面试官提问
以下问题从面试官视角设计,考察对消息队列核心价值的深度理解,而非单纯记忆概念。
Q1:你说消息队列可以"解耦",但解耦后生产者和消费者之间通过消息格式约定契约。如果消息格式需要变更(比如增加一个必填字段),如何在不解耦的前提下平滑升级?请描述你的方案,并说明 Schema Registry 在其中的作用。
Q2:一个秒杀系统,峰值 QPS 10000,后端数据库只能承受 1000 QPS。你用了消息队列削峰,但秒杀持续了 30 分钟,消息堆积了 1000 万条。按照 1000 QPS 的消费速率,需要近 3 小时才能消化完。用户下单后 3 小时才收到短信,这显然不可接受。你会怎么优化?
Q3:你的系统使用消息队列做异步处理,订单创建后发消息通知下游。但某天你发现数据库里有订单记录,但短信没发、积分没加。排查后发现是消息发送时网络超时,Producer 重试机制也没有生效。请设计一个"绝对不丢消息"的方案,并讨论其代价。
Q4:你提到"消息重复消费需要消费者做幂等"。但幂等说起来简单,做起来有很多细节。如果一个订单消息被重复消费了两次,第一次消费时库存扣减成功,第二次消费时库存已经不足了,这个幂等怎么处理?请给出至少两种方案并对比优劣。
Q5:团队里一个初级工程师问你:"我们为什么要用 Kafka?用 Redis 的 List 做消息队列不是更简单吗?"你会怎么回答?请从解耦、削峰、异步三个维度对比 Redis List 和专业消息队列的差异。
Q6:假设你正在设计一个新系统,CTO 要求"全部异步化,所有服务间通信都通过消息队列"。你会支持还是反对这个决定?请给出你的分析框架,并说明什么情况下应该用 MQ、什么情况下应该用同步 RPC、什么情况下两者混合。
下一篇预告:147|Kafka 架构原理:Broker、Topic、Partition、Replica、Controller/KRaft
面试官提问 · 参考答案
以下答案从面试官期望的深度出发,展示对消息队列的工程化理解。
Q1 参考答案:消息格式平滑升级方案
核心思路:生产者和消费者都要做兼容性设计,但方向不同。
生产者侧——向前兼容(Forward Compatibility):
新增字段必须是"可选"的,不能破坏老消费者的解析。具体做法:
- 新增字段设默认值:新字段在消息 Schema 中声明
default值。老消费者不解析该字段,但不影响已有逻辑。 - 不要修改已有字段的类型:比如不能把
amount从int改成string。如果确实需要改,新建一个字段(如amount_v2),老字段保留一段时间。 - 不要删除已有字段:老消费者可能还在依赖它。采用"软删除"——标记为
deprecated,等所有消费者都升级后再真正删除。
消费者侧——向后兼容(Backward Compatibility):
消费者应该宽容地解析消息——只取自己需要的字段,忽略不认识的字段。这叫做"宽容读取"(Tolerant Reader)模式。
Schema Registry 的作用:
Schema Registry(如 Confluent Schema Registry)是消息格式的"版本管理中心",它提供:
- 兼容性检查:当 Producer 注册新版本 Schema 时,Registry 自动检查是否兼容。如果新版本删除了一个消费者还在用的字段,注册会被拒绝。
- 版本演进策略:支持
BACKWARD、FORWARD、FULL三种兼容模式。消息队列场景通常选FULL(即同时兼容新老版本)。 - Schema 即文档:所有消费者可以从 Registry 查看当前消息格式,不需要翻代码或问人。
- 序列化优化:Kafka 配合 Avro 时,消息体里不传 Schema,只传 Schema ID,消费者从 Registry 拉取 Schema 来反序列化——节省带宽。
平滑升级的实际步骤:
阶段一:Producer 注册新 Schema(FULL 兼容模式)
→ Registry 检查通过
阶段二:升级所有 Consumer 到能解析新 Schema 的版本
→ 此时新字段对 Consumer 可见,但 Producer 还没开始发新字段
阶段三:升级 Producer 开始发送新字段
→ Consumer 已经准备好了,平滑过渡
阶段四:确认所有 Consumer 不再需要老字段,从 Schema 中删除
关键原则:永远先升级消费者,再升级生产者。消费者先具备"理解新消息"的能力,生产者再开始"发新消息"。
Q2 参考答案:消息积压的多层优化方案
这是一个典型的"削峰填谷时消息积压过深"的问题。需要从多个层次同时优化:
第一层:消费端扩容(立竿见影)
方案:增加 Consumer 实例数量
原理:RocketMQ 中,同一个 Consumer Group 下,一个 MessageQueue
      同一时间只能被一个 Consumer 消费。但如果有 16 个 MessageQueue,
      可以部署 16 个 Consumer 实例并行消费。
限制:Consumer 数 ≤ MessageQueue 数(多了也没用)
第二层:优先级分离(业务分级)
并非所有消息都需要"秒级"送达。把消息按优先级拆分:
秒杀订单消息 → 拆分为:
  Priority 1(高优):订单状态变更通知(用户需要立即看到"已支付")
  Priority 2(中优):短信、邮件通知(用户可接受 1-2 分钟延迟)
  Priority 3(低优):积分、推荐画像更新(10 分钟延迟也可接受)
高优消息用独立 Topic 和独立 Consumer Group,确保核心体验不受影响。
第三层:消费者逻辑优化(减少单条处理时间)
优化前:
  SMS 消费者:拉消息 → 查数据库校验订单 → 调短信 API → 写日志 → 确认消费
  耗时:200ms/条

优化后:
  - 批量拉取消息(一次拉 100 条,而非逐条)
  - 短信 API 改为异步批量发送(一次请求发 100 条短信)
  - 日志改为异步写入
  - 去掉不必要的 DB 校验(消息在发送时已验证)
  耗时:2ms/条(100 倍提升)
第四层:降级策略(兜底)
如果积压实在太深(如超过 100 万条):
  → 低优消息(积分、推荐)直接跳过,避免占消费资源
  → 跳过的消息通过"离线批处理"(如每小时跑一次批处理任务)补数据
  → 效果:让高优消息快速出队,低优消息用批处理保底
第五层:架构层面——消息"延迟容忍度"设计
在设计阶段就应该考虑:不同消息能容忍多长时间的延迟?将这作为系统设计的一部分,而非事后补救。
Q3 参考答案:绝对不丢消息的方案设计
问题分析:消息丢失通常发生在三个环节——发送端、Broker、消费端。需要逐一保障。
方案一:事务消息(RocketMQ 原生支持)
这是最经典的"先写本地事务,再发消息"模式:
// RocketMQ 事务消息
TransactionMQProducer producer = new TransactionMQProducer("order_group");
producer.setTransactionListener(new TransactionListener() {
    @Override
    public LocalTransactionState executeLocalTransaction(Message msg, Object arg) {
        try {
            // 1. 执行本地事务:创建订单
            orderDao.insert(order);
            return LocalTransactionState.COMMIT_MESSAGE;  // 提交消息
        } catch (Exception e) {
            return LocalTransactionState.ROLLBACK_MESSAGE; // 回滚消息
        }
    }

    @Override
    public LocalTransactionState checkLocalTransaction(MessageExt msg) {
        // 2. 事务回查:Broker 没收到确认时,主动问 Producer 事务状态
        String orderId = msg.getKeys();
        Order order = orderDao.findById(orderId);
        return order != null ? COMMIT_MESSAGE : ROLLBACK_MESSAGE;
    }
});
流程:
- Producer 发送"半消息"(Half Message)到 Broker
- Broker 确认收到半消息后,回 ACK 给 Producer
- Producer 执行本地事务(创建订单)
- 本地事务提交成功 → 通知 Broker 消息可投递;失败 → 回滚消息
- 如果 Broker 长时间没收到确认(网络超时),主动回查 Producer 的事务状态
方案二:本地消息表 + 定时任务(通用方案,不依赖 MQ 特性)
┌──────────────┐     ┌──────────────────┐     ┌──────────────┐
│  订单服务     │────→│  本地消息表       │────→│  定时任务     │
│  (本地事务)   │     │  (同库同事务)     │     │  (扫描发送)   │
└──────────────┘     └──────────────────┘     └──────┬───────┘
                                                     │
                                              ┌──────▼───────┐
                                              │  RocketMQ     │
                                              └──────────────┘
@Transactional
public void createOrder(Order order) {
    // 同一个本地事务中:
    orderDao.insert(order);                      // 1. 创建订单
    messageDao.insert(new OutboxMessage(         // 2. 写入本地消息表
        "order_topic", order.toEventJson(), "PENDING"
    ));
}

// 定时任务:每秒扫描 PENDING 消息
@Scheduled(fixedDelay = 1000)
public void sendPendingMessages() {
    List<OutboxMessage> messages = messageDao.findByStatus("PENDING");
    for (OutboxMessage msg : messages) {
        try {
            mqProducer.send(msg.toMQMessage());
            messageDao.updateStatus(msg.getId(), "SENT");  // 标记已发送
        } catch (Exception e) {
            // 发送失败,下次定时任务重试
        }
    }
}
方案三:双写 + 对账(最终兜底)
即使以上方案都做了,极端情况下仍可能丢消息(如 Broker 磁盘损坏)。最终兜底方案是:
定时任务(如每小时):
  扫描今天创建的订单 → 查消息消费记录 → 发现缺少消息的订单 →
  补发消息或触发告警人工介入
代价讨论:
| 方案 | 优点 | 代价 |
|---|---|---|
| 事务消息 | 原子性最强,RocketMQ 原生支持 | 依赖 RocketMQ,增加 Broker 回查负载 |
| 本地消息表 | 通用性强,不依赖 MQ 特性 | 数据库写入压力增大,定时扫描有延迟 |
| 双写+对账 | 最终保底 | 只能事后修复,无法实时保证 |
总结:绝对不丢消息需要"发送端保障 + Broker 持久化 + 消费端确认 + 对账兜底"四层防护。光靠 Producer 重试是不够的。
Q4 参考答案:幂等消费的两种方案
问题本质:消息重复消费时,业务操作需要保证"执行一次和执行多次的结果相同"。
方案一:业务唯一键去重(推荐)
@RocketMQMessageListener(topic = "order_topic", consumerGroup = "inventory")
public class InventoryConsumer implements RocketMQListener<OrderPlacedEvent> {

    @Autowired
    private InventoryService inventoryService;
    @Autowired
    private DedupService dedupService;

    @Override
    public void onMessage(OrderPlacedEvent event) {
        String dedupKey = "dedup:inventory:" + event.getOrderId();

        // 1. Redis 去重:SET NX(原子操作,只有不存在时才设置成功)
        boolean isNew = dedupService.tryLock(dedupKey, 3600); // 1 小时过期
        if (!isNew) {
            log.info("重复消息,跳过: orderId={}", event.getOrderId());
            return;  // 已处理过,直接返回
        }

        try {
            // 2. 执行业务逻辑:扣减库存
            inventoryService.deduct(event.getSkuId(), event.getQuantity());
        } catch (InsufficientStockException e) {
            // 库存不足可能是"已经扣减过"导致的
            // 查询当前库存状态,确认是否为重复消费
            int currentStock = inventoryService.getStock(event.getSkuId());
            int expectedAfterDeduct = currentStock + event.getQuantity();
            // 如果当前库存 + 本次扣减量 = 上次扣减前的库存,说明是重复消费
            log.warn("库存不足,可能是重复消费: orderId={}, currentStock={}",
                     event.getOrderId(), currentStock);
            // 已经扣减过了,算成功
        }
    }
}
关键点:
- 去重 Key 用业务唯一标识(如
orderId + consumerName),而非消息 ID - 去重标记设置合理的过期时间(如 1 小时),避免 Redis 内存无限增长
- 去重标记的写入和业务操作之间如果失败,需要处理"标记已写入但业务未执行"的情况
方案二:数据库唯一约束(最强保障)
@RocketMQMessageListener(topic = "order_topic", consumerGroup = "inventory")
public class InventoryConsumer implements RocketMQListener<OrderPlacedEvent> {

    @Override
    public void onMessage(OrderPlacedEvent event) {
        try {
            // 利用数据库唯一约束实现幂等
            // 插入一条"消费记录",如果已存在则抛 DuplicateKeyException
            consumeRecordDao.insert(new ConsumeRecord(
                event.getOrderId(), "inventory_consumer", "PROCESSING"
            ));
        } catch (DuplicateKeyException e) {
            log.info("重复消费,跳过: orderId={}", event.getOrderId());
            return;
        }

        // 执行业务
        inventoryService.deduct(event.getSkuId(), event.getQuantity());

        // 更新消费记录状态
        consumeRecordDao.updateStatus(event.getOrderId(), "DONE");
    }
}
对比:
| 维度 | Redis 去重 | 数据库唯一约束 |
|---|---|---|
| 性能 | 高(内存操作) | 中(需要一次 DB 写入) |
| 可靠性 | 中(Redis 可能丢数据) | 高(DB 持久化) |
| 实现复杂度 | 低 | 中(需要建表) |
| 过期清理 | 需手动设 TTL | 可定时清理历史记录 |
| 适用场景 | 高吞吐量、对幂等要求不极端 | 金融、交易等强一致性场景 |
最佳实践:两者结合——Redis 做快速去重(第一道防线),数据库唯一约束做兜底(第二道防线)。
Q5 参考答案:Redis List vs 专业消息队列
从三个维度对比:
解耦维度:
| 能力 | Redis List | Kafka/RocketMQ |
|---|---|---|
| 发布订阅 | 需用 Pub/Sub(无持久化,消息即发即忘) | 原生支持,消息持久化 |
| 多消费者组 | 不支持(一条消息被一个消费者弹出后即消失) | 原生 Consumer Group,独立消费进度 |
| 消息回溯 | 不支持 | 支持按时间/Offset 回溯 |
| 消息路由 | 需自己实现 | 支持 Tag、Key 路由 |
削峰维度:
| 能力 | Redis List | Kafka/RocketMQ |
|---|---|---|
| 消息持久化 | RDB/AOF(不是为消息队列设计) | 磁盘顺序写,专为高吞吐优化 |
| 堆积能力 | 受内存限制(64GB 服务器只能存 64GB 消息) | 受磁盘限制(可存 TB 级消息) |
| 消费速率控制 | 需自己实现流控 | 原生支持消费限流 |
异步维度:
| 能力 | Redis List | Kafka/RocketMQ |
|---|---|---|
| 消费确认 | 无(BRPOP 弹出即删除) | 支持 ACK 机制,消费失败可重试 |
| 死信队列 | 无 | 原生支持,重试 N 次后进入死信 |
| 消息顺序 | 单 List 内有序 | Partition 内有序 |
| 事务消息 | 无 | RocketMQ 原生支持 |
| 延迟消息 | 需用 ZSET 模拟 | RocketMQ 原生支持 18 个延迟级别 |
一句话总结:Redis List 适合"轻量级任务队列"(如几千条消息的异步任务),专业消息队列适合"企业级消息系统"(如百万级吞吐、消息不丢、支持回溯、多消费者组)。Redis 是"能用",Kafka/RocketMQ 是"好用且可靠"。
对初级工程师:你可以说——"Redis List 就像用 Excel 记账,个人用没问题;Kafka 就像银行的账务系统,当你的业务规模和数据可靠性要求达到一定程度时,专业工具是必须的。"
Q6 参考答案:全部异步化的分析框架
我会反对"全部异步化"。
分析框架——用"三个问题"判断通信方式:
问题一:调用方是否需要立即拿到结果?
需要 → 同步 RPC
  例:用户登录 → 必须立即返回"登录成功"或"密码错误"
  例:支付确认 → 必须立即返回"支付成功"或"余额不足"

不需要 → 消息队列
  例:下单后发短信 → 用户不需要等短信发完才看到"下单成功"
  例:用户行为日志 → 异步记录即可
问题二:调用方是否依赖被调用方的执行结果来做下一步决策?
依赖 → 同步 RPC
  例:创建订单前需要查库存 → 库存不足则拒绝下单
  例:下单前需要风控校验 → 风控拒绝则订单不创建

不依赖 → 消息队列
  例:创建订单后通知推荐系统 → 推荐系统是否成功不影响订单
问题三:被调用方故障时,调用方是否还能继续工作?
不能 → 同步 RPC(或至少需要同步确认)
  例:支付服务故障 → 不能接受订单(钱收不到)

能 → 消息队列
  例:短信服务故障 → 订单仍然可以创建
推荐的混合架构:
用户请求
  │
  ▼
网关
  │
  ▼
订单服务(核心流程)
  ├── 同步调用:库存服务(必须拿到结果)
  ├── 同步调用:风控服务(必须拿到结果)
  ├── 同步调用:支付服务(必须拿到结果)
  │
  └── 异步发送:OrderPlacedEvent
       ├──→ 短信服务(允许延迟)
       ├──→ 邮件服务(允许延迟)
       ├──→ 积分服务(允许延迟)
       └──→ 推荐服务(允许延迟)
设计原则:
- 核心链路同步,扩展链路异步——区分"必须成功"和"最好成功"
- 同步调用要有超时和熔断——防止下游服务拖垮上游
- 异步消息要有兜底——消息丢了要知道,有对账机制
- 不要为了异步而异步——如果一个调用天然是同步的(如登录),强行异步只会增加复杂度
CTO 可能想解决的问题:减少服务间耦合、提升系统吞吐量。但"全部异步化"是过度反应——正确的做法是"在合适的场景用合适的工具"。
以上为面试官提问的参考答案。面试中,比"正确答案"更重要的是展示你的思考过程、trade-off 分析能力和工程实践经验。