阅读时间:约 45 分钟 难度:中高级 适用岗位:Java 高级工程师、架构师、中间件工程师
一、问题定义:消息到底丢在哪里?
在分布式消息系统中,一条消息从生产者发出到消费者处理完成,要跨越网络、磁盘、内存等多个边界。任何一环的疏漏,都可能导致消息永久丢失。
真实案例:某电商平台大促期间,订单创建后发送消息到下游履约系统。高峰期过后,运营发现约 0.3% 的订单未流转到仓库。排查发现:Kafka 生产者使用了 acks=0(不等待 Broker 确认),Broker 在 Leader 宕机时部分未刷盘的消息丢失,且消费者先提交 offset 再处理业务逻辑,处理失败的消息也被跳过了。
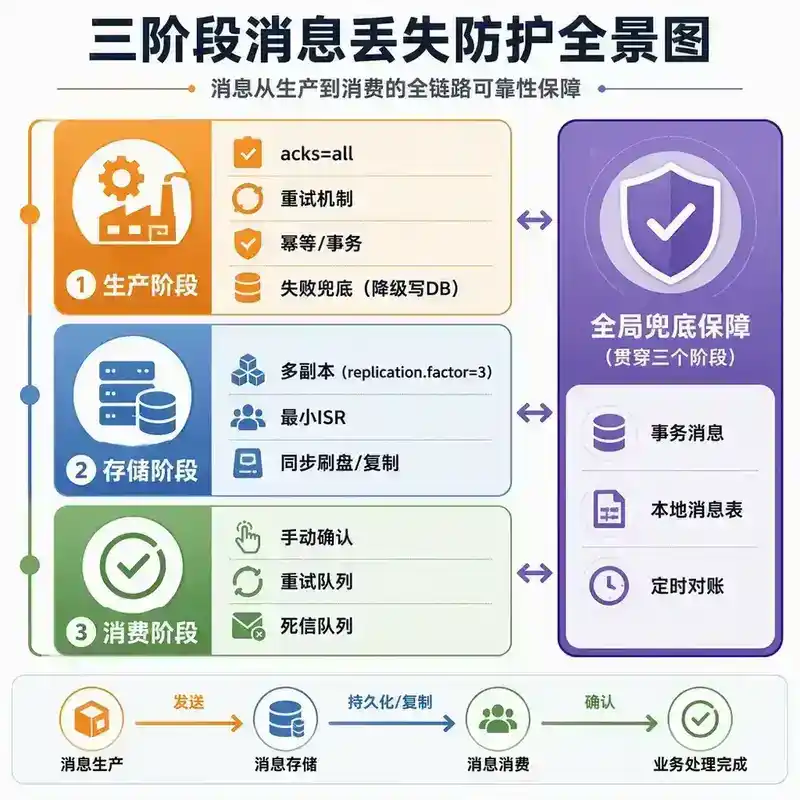
消息丢失的根因可以归纳为三个阶段的"坑":
| 阶段 | 典型丢失场景 | 核心矛盾 |
|---|---|---|
| 生产阶段 | 网络超时、序列化失败、Broker 宕机 | 生产者"以为发成功了"但实际没发出去 |
| 存储阶段 | Broker 宕机、磁盘损坏、副本未同步 | 消息"存在 Broker 上"但宕机后没了 |
| 消费阶段 | 消费者宕机、offset 提交过早、业务处理失败 | 消息"被消费了"但实际没处理 |
本文将从这三个阶段分别展开,覆盖 Kafka、RocketMQ、RabbitMQ 三大主流消息队列的防护机制,并给出生产环境可落地的代码实践。
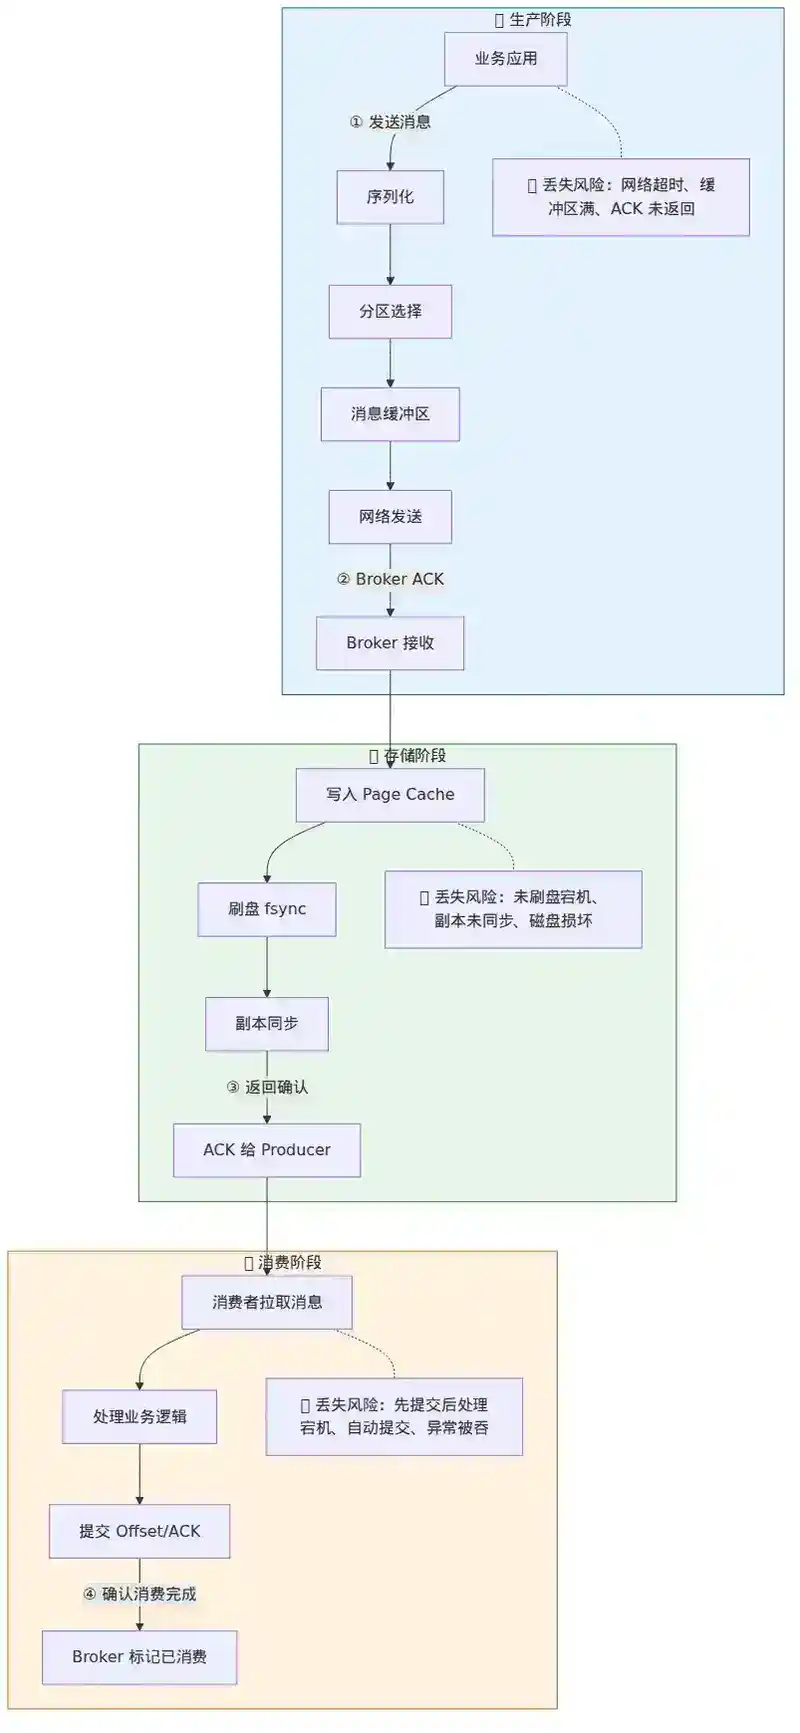
二、生产阶段:消息如何可靠送达 Broker?
2.1 发送流程拆解
一条消息从生产者到 Broker,通常经历以下步骤:
生产者应用
  → 序列化(Key/Value Serializer)
  → 分区选择(Partitioner)
  → 消息累加器(RecordAccumulator / 缓冲区)
  → 网络发送(Sender 线程)
  → Broker 接收
  → Broker 返回 ACK
丢失发生在哪里?
- 序列化失败:消息根本没发出去(通常抛异常,可感知)
- 网络超时:生产者发了,但 Broker 没收到,或 ACK 没返回
- 缓冲区满:生产者内存缓冲区满,新消息被丢弃(Kafka
buffer.memory) - Broker 返回 ACK 前宕机:Leader 宕机,未同步到副本
2.2 Kafka 生产者的可靠性配置
Kafka 生产者有三个关键配置直接影响消息可靠性:
①**acks**(确认机制)
| acks 值 | 含义 | 可靠性 | 性能 |
|---|---|---|---|
acks=0 |
不等待任何确认 | 最低,消息可能丢失 | 最高 |
acks=1 |
Leader 写入即确认 | 中等,Leader 宕机未同步时丢失 | 中等 |
acks=all(或 -1) |
所有 ISR 副本确认 | 最高 | 较低 |
生产推荐:**acks=all**,配合 min.insync.replicas ≥ 2 使用。
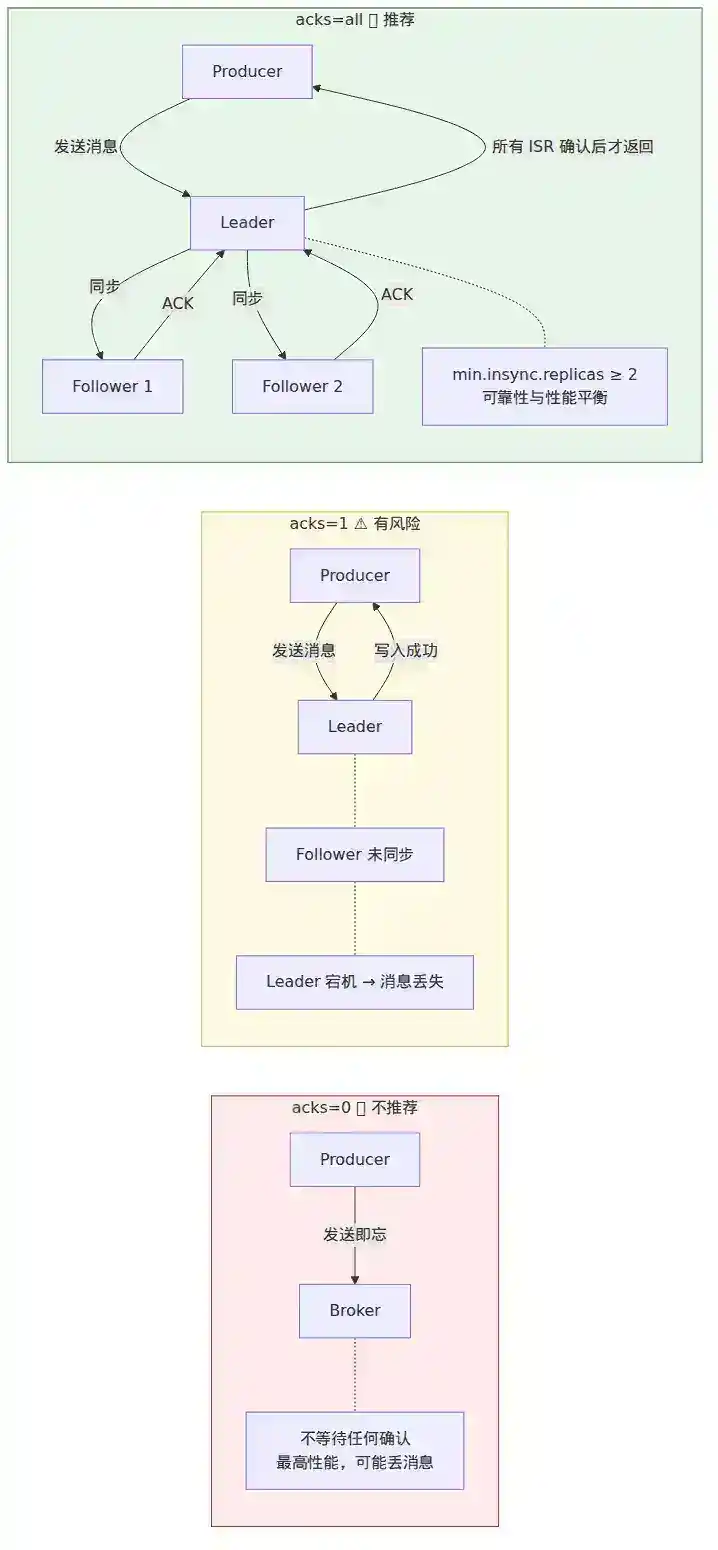
②**retries**与**retry.backoff.ms**
Properties props = new Properties();
props.put("acks", "all");
props.put("retries", Integer.MAX_VALUE);  // 无限重试(Kafka ≥ 2.0 推荐)
props.put("retry.backoff.ms", 100);       // 重试间隔 100ms
props.put("max.in.flight.requests.per.connection", 5);  // 注意顺序性问题
关键陷阱:重试可能导致消息乱序。如果 max.in.flight.requests.per.connection > 1(默认 5),且 retries > 0,则批次 1 失败重试时批次 2 可能已成功写入,导致顺序颠倒。解决方案:
- 如果严格要求顺序:设置
max.in.flight.requests.per.connection=1(性能下降) - Kafka 0.11+ 引入幂等生产:
enable.idempotence=true,此时即使max.in.flight.requests.per.connection ≤ 5,也能保证顺序和精确一次
③**enable.idempotence**(幂等生产)
props.put("enable.idempotence", true);
原理:Broker 为每个 Producer 分配 PID(Producer ID),每条消息带序列号(Sequence Number)。Broker 检查序列号,丢弃重复消息。但这只保证单分区内的幂等,跨分区和跨会话不保证。
④ 事务生产(精确一次语义)
producer.initTransactions();
try {
    producer.beginTransaction();
    producer.send(record1);
    producer.send(record2);
    producer.commitTransaction();
} catch (Exception e) {
    producer.abortTransaction();
}
事务生产保证跨分区、跨会话的原子写入。代价是性能下降约 30%。
2.3 生产者的发送回调与异常处理
同步发送(阻塞等待结果):
try {
    RecordMetadata metadata = producer.send(record).get(5000, TimeUnit.MILLISECONDS);
    log.info("消息发送成功: topic={}, partition={}, offset={}",
             metadata.topic(), metadata.partition(), metadata.offset());
} catch (TimeoutException e) {
    // 网络超时:重试或写入本地死信表
    saveToLocalDeadLetterTable(record);
} catch (Exception e) {
    // 其他异常:记录并告警
    log.error("消息发送失败", e);
    alertToOncall();
}
异步发送(推荐,生产环境主流):
producer.send(record, (metadata, exception) -> {
    if (exception != null) {
        // 发送失败:降级方案
        log.error("消息发送失败: key={}", record.key(), exception);
        fallbackToDatabase(record);  // 降级写入数据库
    } else {
        log.debug("消息发送成功: offset={}", metadata.offset());
    }
});
生产环境最佳实践——发送失败兜底:
public class ReliableMessageSender {
    private final KafkaProducer<String, String> producer;
    private final DeadLetterDao deadLetterDao;

    public void sendWithFallback(String topic, String key, String message) {
        ProducerRecord<String, String> record =
            new ProducerRecord<>(topic, key, message);

        producer.send(record, (metadata, exception) -> {
            if (exception != null) {
                // 1. 写入本地死信表(同一事务保证原子性)
                deadLetterDao.insert(topic, key, message, exception.getMessage());
                // 2. 触发告警
                metrics.counter("mq.send.failure").increment();
                // 3. 定时任务扫描死信表,重试发送
            }
        });
    }
}
2.4 RocketMQ 生产者的可靠性
RocketMQ 提供同步、异步、单向三种发送方式:
// 同步发送——等待 Broker 确认(推荐用于关键业务)
SendResult result = producer.send(msg);
// 返回 SendStatus: SEND_OK / FLUSH_DISK_TIMEOUT / FLUSH_SLAVE_TIMEOUT / SLAVE_NOT_AVAILABLE

// 带重试的同步发送
producer.setRetryTimesWhenSendFailed(3);          // 同步发送失败重试 3 次
producer.setRetryTimesWhenSendAsyncFailed(3);     // 异步发送失败重试 3 次
RocketMQ 的可靠性机制:
- 同步刷盘(
flushDiskType=SYNC_FLUSH):消息写入磁盘后才返回成功,性能低但可靠 - 同步复制(
brokerRole=SYNC_MASTER):等待 Slave 同步后才返回成功 - 发送失败自动重试(默认 2 次)
2.5 RabbitMQ 生产者的可靠性
RabbitMQ 的可靠性核心是 Publisher Confirm 机制:
// 开启 Publisher Confirm
channel.confirmSelect();

// 方式一:逐条确认(性能差)
channel.basicPublish(exchange, routingKey, null, body);
if (channel.waitForConfirms(5000)) {
    // 发送成功
} else {
    // 发送失败,重试
}

// 方式二:批量确认(推荐)
channel.addConfirmListener(new ConfirmListener() {
    @Override
    public void handleAck(long deliveryTag, boolean multiple) {
        // 成功确认
    }
    @Override
    public void handleNack(long deliveryTag, boolean multiple) {
        // 失败:重试或告警
    }
});
RabbitMQ 的额外保障:
- Mandatory 标志:消息无法路由到任何队列时,返回给生产者(而非丢弃)
- 消息持久化:
deliveryMode=2,消息写入磁盘 - 队列持久化:
durable=true,Broker 重启后队列不丢失
三、存储阶段:Broker 如何保证消息不丢?
3.1 消息在 Broker 上的生命周期
Producer → Broker 接收
  → 写入 Page Cache(操作系统页缓存)
  → 刷盘(fsync / flush)到磁盘
  → 复制到副本(Replica / Slave)
  → 返回 ACK 给 Producer
丢失发生在哪里?
- 只写 Page Cache 未刷盘,宕机后丢失
- Leader 宕机,Follower 未完全同步,新 Leader 缺少消息
- 磁盘损坏
3.2 Kafka 的存储可靠性
① 副本机制
Topic: orders (3 partitions, 3 replicas)
Partition 0: Leader=Broker1, ISR=[Broker1, Broker2, Broker3]
Partition 1: Leader=Broker2, ISR=[Broker2, Broker3, Broker1]
Partition 2: Leader=Broker3, ISR=[Broker3, Broker1, Broker2]
关键配置:
# 每个 Topic 的副本数
default.replication.factor=3

# 最小 ISR 数量(acks=all 时,必须至少这么多副本确认才返回成功)
min.insync.replicas=2

# 落后多少毫秒被踢出 ISR
replica.lag.time.max.ms=30000
**min.insync.replicas=2**+**acks=all** 的含义:至少 2 个副本(含 Leader)确认写入,才算成功。如果可用的 ISR 少于 2,生产者会收到 NOT_ENOUGH_REPLICAS 异常,宁可不可用也不丢消息。
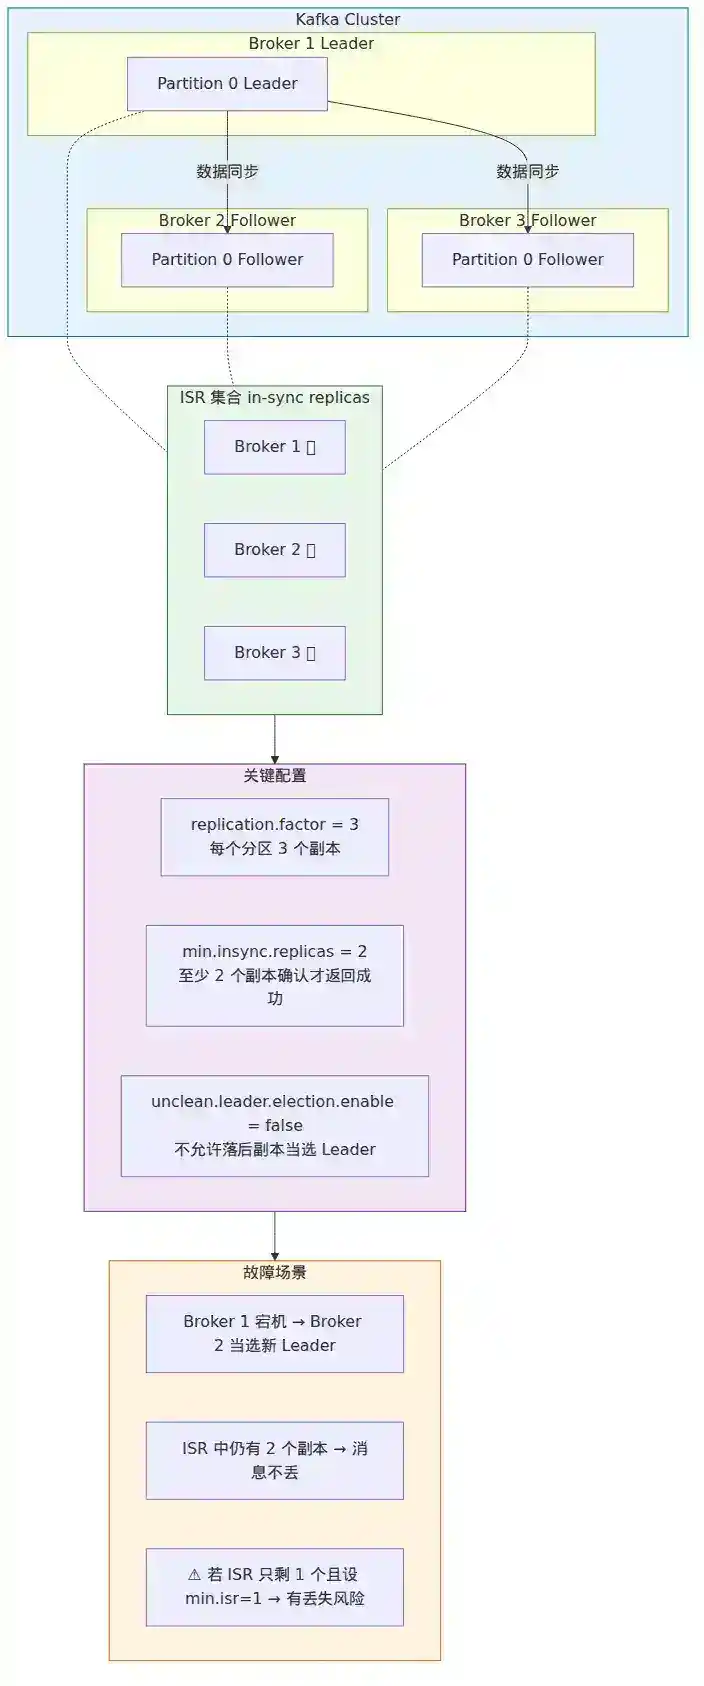
② 刷盘策略
Kafka 依赖操作系统页缓存,不主动 fsync:
# 刷盘策略(通常不修改,交给 OS 管理)
log.flush.interval.messages=10000   # 每 10000 条消息刷一次盘
log.flush.interval.ms=1000          # 每 1000ms 刷一次盘
为什么不主动 fsync? Kafka 的设计哲学是依赖多副本而不是单机刷盘保证可靠性。只要 ISR 中有副本存活,即使一台机器宕机未刷盘,消息也不会丢。主动 fsync 会严重影响吞吐。
③ 不完全的 Leader 选举(Unclean Leader Election)
# 默认 false:不允许非 ISR 副本成为 Leader
unclean.leader.election.enable=false
如果设为 true,当 ISR 全部宕机,会选择落后最多的副本当 Leader,导致消息丢失。生产环境必须设为 false。
3.3 RocketMQ 的存储可靠性
RocketMQ 的存储设计更倾向"单机可靠":
// Broker 配置
flushDiskType=SYNC_FLUSH    // 同步刷盘(默认 ASYNC_FLUSH)
brokerRole=SYNC_MASTER      // 同步复制(默认 ASYNC_MASTER)
同步刷盘 vs 异步刷盘:
| 配置 | 流程 | 可靠性 | 延迟 |
|---|---|---|---|
ASYNC_FLUSH |
写 Page Cache 即返回 | 宕机丢失未刷盘消息 | 低 |
SYNC_FLUSH |
等待 fsync 完成 | 不丢消息 | 高(约 +10ms) |
同步复制 vs 异步复制:
| 配置 | 流程 | 可靠性 |
|---|---|---|
ASYNC_MASTER |
Master 写成功即返回 | Slave 落后时可能丢失 |
SYNC_MASTER |
等待 Slave 确认 | Master 宕机不丢消息 |
生产环境推荐:关键业务使用**SYNC_FLUSH + SYNC_MASTER**,但需要评估性能影响。
RocketMQ 的 DLedger(Raft 协议): RocketMQ 4.5+ 引入 DLedger,基于 Raft 协议实现自动故障转移,CommitLog 通过 Raft 日志复制,保证强一致性。
3.4 RabbitMQ 的存储可靠性
RabbitMQ 的核心是 队列持久化 + 消息持久化:
// 声明持久化队列
boolean durable = true;
channel.queueDeclare("orders", durable, false, false, null);

// 发送持久化消息
AMQP.BasicProperties props = new AMQP.BasicProperties.Builder()
    .deliveryMode(2)  // 2 = 持久化
    .build();
channel.basicPublish("", "orders", props, body);
注意:deliveryMode=2 只保证消息写入磁盘,但 RabbitMQ 默认是异步刷盘——消息可能暂存在操作系统的 Page Cache 中,宕机后丢失。要完全保证不丢,需要配合:
- Mirror Queue(镜像队列):消息同步到多个节点(RabbitMQ 3.x,已废弃)
- Quorum Queue(仲裁队列):基于 Raft 协议,RabbitMQ 3.8+,推荐
// 声明仲裁队列(RabbitMQ 3.8+)
Map<String, Object> args = new HashMap<>();
args.put("x-queue-type", "quorum");
channel.queueDeclare("orders", true, false, false, args);
四、消费阶段:消息如何被可靠处理?
4.1 消费阶段丢失的典型场景
Broker → 消费者拉取消息
  → 消费者处理业务逻辑(写数据库、调用 RPC...)
  → 消费者提交 Offset(告知 Broker 已消费)
丢失发生在哪里?
- 先提交 Offset 再处理:提交后消费者宕机,消息未处理但 Offset 已推进 → Kafka 认为已消费,消息丢失
- 自动提交 Offset:
enable.auto.commit=true,到时间就提交,不管业务是否成功 - 异常被吞掉:
try-catch后仍然提交 Offset - Rebalance 时未提交:消费者被踢出组,Offset 未提交,新消费者从旧 Offset 开始 → 重复消费(不是丢失,但可能引发其他问题)
4.2 Kafka 消费者的可靠消费模式
核心原则:先处理,后提交。
// ❌ 错误模式:自动提交
props.put("enable.auto.commit", "true");  // 危险!
props.put("auto.commit.interval.ms", "1000");

// ✅ 正确模式:手动提交,先处理后提交
props.put("enable.auto.commit", "false");

while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
    for (ConsumerRecord<String, String> record : records) {
        try {
            // 1. 处理业务逻辑
            processBusiness(record);
            // 2. 处理成功后提交 Offset
            consumer.commitSync(Collections.singletonMap(
                new TopicPartition(record.topic(), record.partition()),
                new OffsetAndMetadata(record.offset() + 1)
            ));
        } catch (Exception e) {
            log.error("消息处理失败: offset={}", record.offset(), e);
            // 3. 不提交 Offset,消息会被重新消费
            // 或者发送到死信队列
            sendToDeadLetterQueue(record);
            // 仍然提交 Offset 避免阻塞
            consumer.commitSync();
        }
    }
}
精细化控制——逐条提交 vs 批量提交:
// 批量提交(推荐,性能好)
consumer.poll(...);
records.forEach(r -> processBusiness(r));
consumer.commitSync();  // 批量提交当前批次

// 分区级别提交(更精细)
for (TopicPartition partition : records.partitions()) {
    List<ConsumerRecord<String, String>> partitionRecords = records.records(partition);
    long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset();
    consumer.commitSync(Collections.singletonMap(
        partition, new OffsetAndMetadata(lastOffset + 1)
    ));
}
4.3 消费失败的处理策略
策略一:重试 + 死信队列
public class RetryableConsumer {
    private static final int MAX_RETRIES = 3;

    public void consume(ConsumerRecord<String, String> record) {
        int retries = 0;
        while (retries <= MAX_RETRIES) {
            try {
                processBusiness(record);
                consumer.commitSync();
                return;  // 成功,退出
            } catch (RetryableException e) {
                retries++;
                if (retries > MAX_RETRIES) {
                    // 超过重试次数,发送到死信队列
                    sendToDeadLetterTopic(record);
                    consumer.commitSync();  // 死信队列写入成功,提交 Offset
                    alertToOncall(record);  // 人工介入
                    return;
                }
                // 指数退避
                Thread.sleep((long) Math.pow(2, retries) * 1000);
            } catch (NonRetryableException e) {
                // 不可重试的异常(如数据格式错误),直接死信
                sendToDeadLetterTopic(record);
                consumer.commitSync();
                return;
            }
        }
    }
}
策略二:本地消息表 + 定时补偿
消费失败时将消息写入本地数据库,定时任务扫描重试:
@Service
public class MessageConsumer {

    @Transactional
    public void consume(ConsumerRecord<String, String> record) {
        try {
            // 业务处理
            orderService.createOrder(parseOrder(record.value()));
            // 成功:提交 Offset
            consumer.commitSync();
        } catch (Exception e) {
            // 失败:写入本地消息表(同一事务)
            localMessageDao.insert(
                record.topic(), record.partition(), record.offset(),
                record.value(), "FAILED", 0
            );
            // 仍然提交 Offset,避免阻塞(消息已持久化到本地)
            consumer.commitSync();
        }
    }
}

// 定时补偿任务
@Scheduled(fixedDelay = 60000)
public void retryFailedMessages() {
    List<LocalMessage> failed = localMessageDao.findFailed(MAX_RETRIES);
    for (LocalMessage msg : failed) {
        try {
            orderService.createOrder(parseOrder(msg.getBody()));
            localMessageDao.markSuccess(msg.getId());
        } catch (Exception e) {
            localMessageDao.incrementRetry(msg.getId());
            if (msg.getRetryCount() >= MAX_RETRIES) {
                alertToOncall(msg);
            }
        }
    }
}
4.4 RocketMQ 消费可靠性
RocketMQ 消费模式分为两种:
集群消费(CLUSTERING,默认)— 每条消息只被组内一个消费者处理:
consumer.registerMessageListener((MessageListenerConcurrently) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        try {
            processBusiness(msg);
        } catch (Exception e) {
            // 返回 RECONSUME_LATER,消息会进入重试队列
            return ConsumeConcurrentlyStatus.RECONSUME_LATER;
        }
    }
    return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
});
RocketMQ 的消费重试机制:
- 消费失败返回
RECONSUME_LATER,消息进入重试 Topic(%RETRY%{consumerGroup}) - 默认重试 16 次,间隔递增(10s, 30s, 1m, 2m, 3m, 4m, 5m, 6m, 7m, 8m, 9m, 10m, 20m, 30m, 1h, 2h)
- 超过 16 次进入死信队列(
%DLQ%{consumerGroup})
4.5 RabbitMQ 消费可靠性
RabbitMQ 使用 手动 ACK 保证消费可靠性:
// 关闭自动 ACK
boolean autoAck = false;
channel.basicConsume("orders", autoAck, (consumerTag, delivery) -> {
    try {
        processBusiness(delivery.getBody());
        // 业务处理成功后手动 ACK
        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
    } catch (Exception e) {
        // 拒绝消息,requeue=true 重新入队
        channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
    }
}, consumerTag -> {});
注意:basicNack 的 requeue=true 会将消息重新放回队列头部,如果持续失败可能导致死循环。建议:
- 记录重试次数(通过消息头传递)
- 超过上限后
requeue=false或发送到死信队列
五、端到端的消息可靠性方案
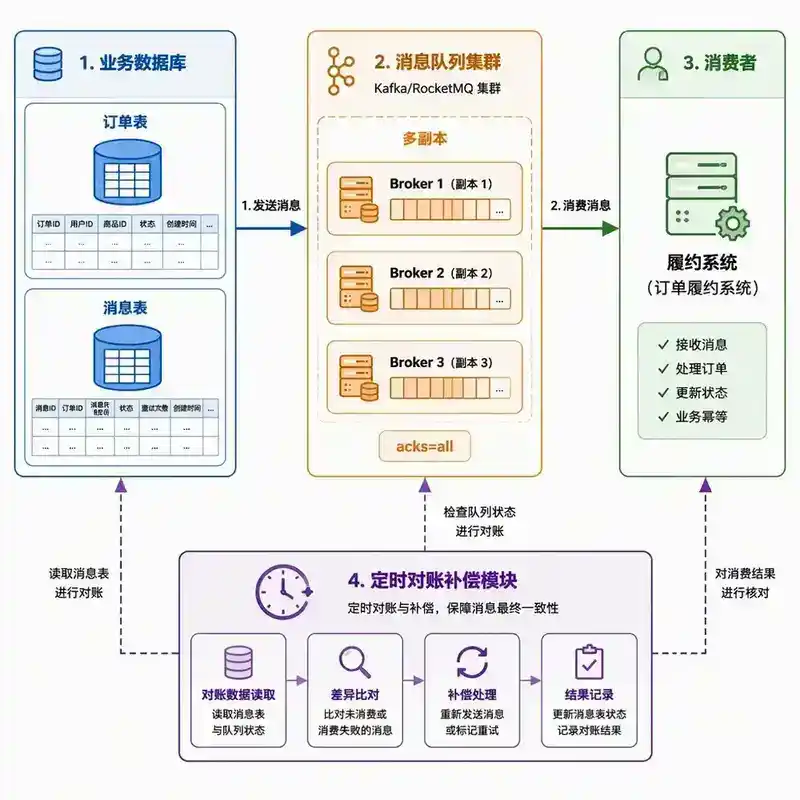
5.1 可靠消息的完整链路
┌──────────┐    ┌──────────────────┐    ┌──────────┐
│  业务DB   │    │    消息队列       │    │  消费者   │
│           │    │                  │    │           │
│ 订单表    │───▶│  Topic: orders   │───▶│ 履约系统   │
│ 消息表    │    │  (3副本,acks=all) │    │           │
└──────────┘    └──────────────────┘    └──────────┘
       │                                        │
       │            ┌──────────┐                │
       └───────────▶│  定时对账  │◀───────────────┘
                    │  (补偿)   │
                    └──────────┘
5.2 事务消息(RocketMQ)
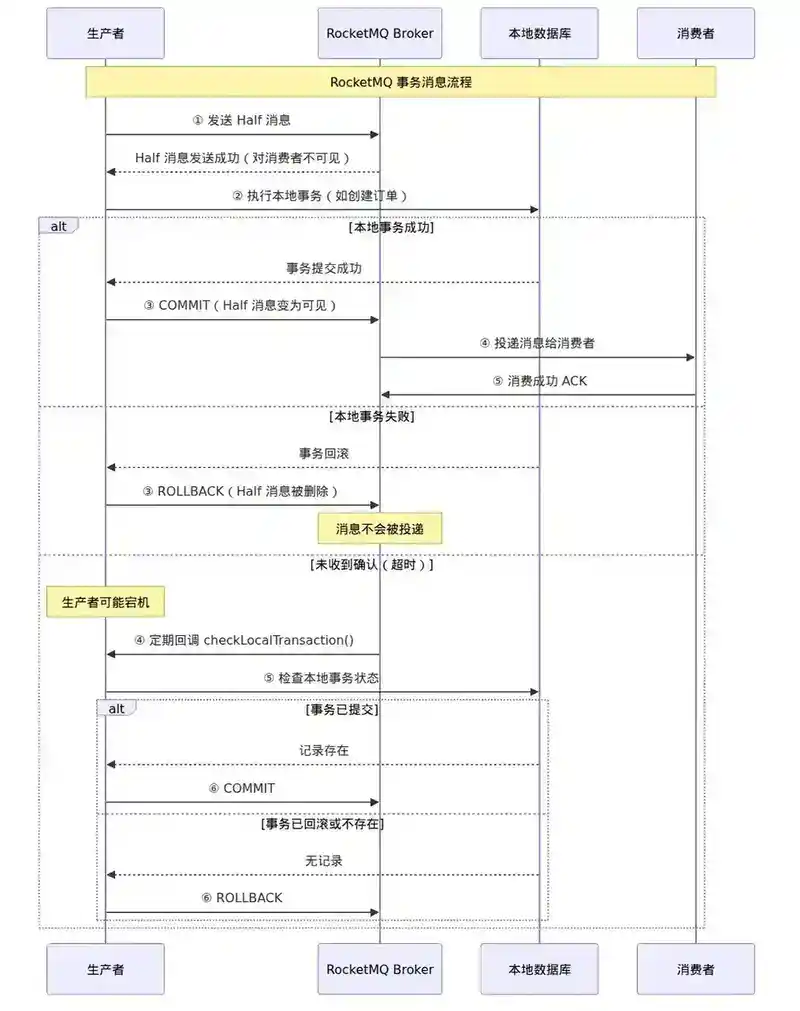
RocketMQ 的事务消息是解决"本地事务和消息发送原子性"的经典方案:
TransactionMQProducer producer = new TransactionMQProducer("tx-producer-group");
producer.setTransactionListener(new TransactionListener() {
    @Override
    public LocalTransactionState executeLocalTransaction(Message msg, Object arg) {
        try {
            // 执行本地事务(如创建订单)
            orderService.createOrder((Order) arg);
            return LocalTransactionState.COMMIT_MESSAGE;
        } catch (Exception e) {
            return LocalTransactionState.ROLLBACK_MESSAGE;
        }
    }

    @Override
    public LocalTransactionState checkLocalTransaction(MessageExt msg) {
        // 回调检查本地事务状态(事务未决时)
        String orderId = msg.getKeys();
        Order order = orderService.getById(orderId);
        if (order != null) {
            return LocalTransactionState.COMMIT_MESSAGE;
        }
        return LocalTransactionState.ROLLBACK_MESSAGE;
    }
});

// 发送事务消息
Message msg = new Message("orders", order.toBytes());
producer.sendMessageInTransaction(msg, order);
流程:
- 生产者发送 Half 消息(对消费者不可见)
- 执行本地事务
- 根据本地事务结果提交或回滚 Half 消息
- 如果未收到确认,Broker 回调
checkLocalTransaction检查状态
5.3 本地消息表 + 定时补偿
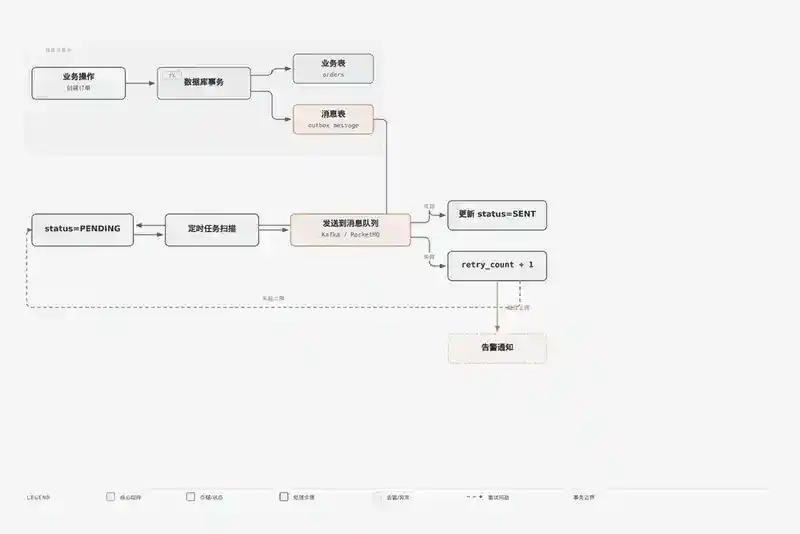
不依赖消息队列的事务功能,而是通过本地数据库保证原子性:
-- 业务表
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    status VARCHAR(20),
    created_at TIMESTAMP
);

-- 本地消息表
CREATE TABLE outbox_message (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    business_id BIGINT NOT NULL,
    business_type VARCHAR(50) NOT NULL,
    topic VARCHAR(100) NOT NULL,
    message_body TEXT NOT NULL,
    status ENUM('PENDING', 'SENT', 'FAILED') DEFAULT 'PENDING',
    retry_count INT DEFAULT 0,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_status (status, created_at)
);
@Service
public class OrderService {

    @Transactional
    public void createOrder(Order order) {
        // 1. 业务操作
        orderDao.insert(order);

        // 2. 同一事务写入消息表
        OutboxMessage msg = new OutboxMessage();
        msg.setBusinessId(order.getId());
        msg.setBusinessType("ORDER");
        msg.setTopic("orders");
        msg.setMessageBody(JSON.toJSONString(order));
        outboxMessageDao.insert(msg);
    }
}

// 定时任务:扫描并发送未发送的消息
@Scheduled(fixedDelay = 5000)
public void sendPendingMessages() {
    List<OutboxMessage> pending = outboxMessageDao.findByStatus("PENDING", 100);
    for (OutboxMessage msg : pending) {
        try {
            producer.send(toProducerRecord(msg));
            outboxMessageDao.updateStatus(msg.getId(), "SENT");
        } catch (Exception e) {
            outboxMessageDao.incrementRetry(msg.getId());
        }
    }
}
5.4 对账与补偿体系
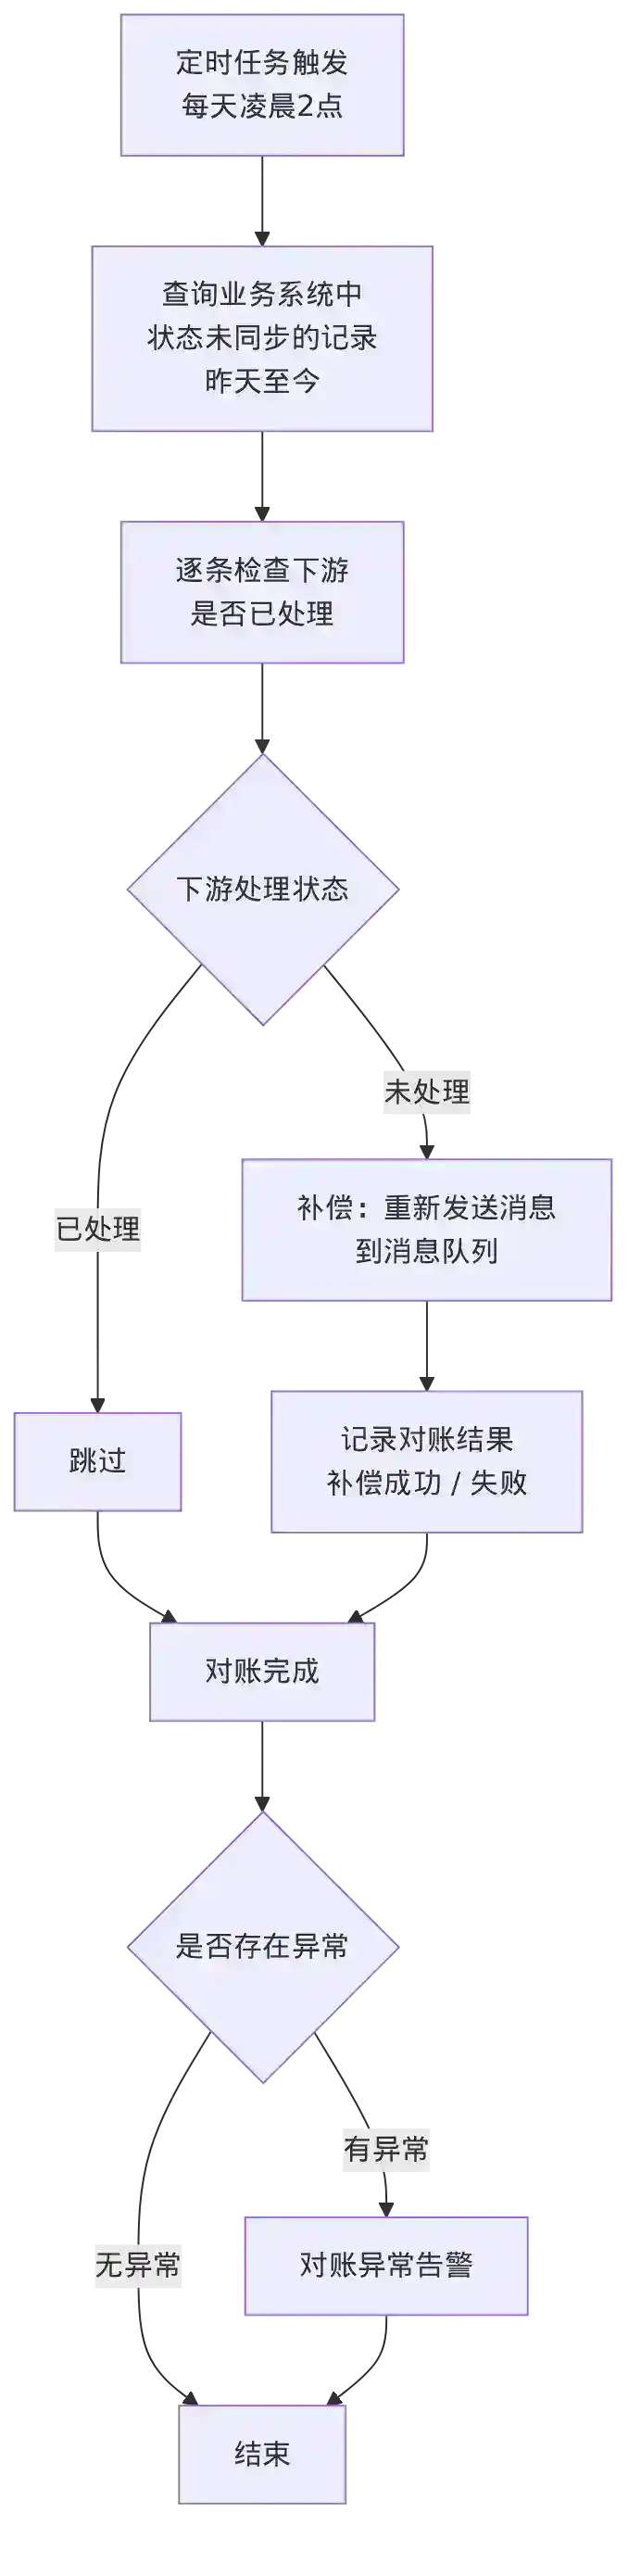
即使所有机制都做了,仍然可能因为极端情况丢失消息。最终的兜底是对账:
@Component
public class MessageReconciliation {

    @Scheduled(cron = "0 0 2 * * ?")  // 每天凌晨 2 点
    public void reconcile() {
        // 1. 查询业务系统中状态未同步的记录
        List<Order> unsynced = orderDao.findUnsynced(
            LocalDateTime.now().minusDays(1),  // 昨天
            LocalDateTime.now()
        );

        for (Order order : unsynced) {
            // 2. 检查下游是否已处理
            if (!fulfillmentService.existsByOrderId(order.getId())) {
                // 3. 补偿:重新发送消息
                producer.send(toProducerRecord(order));
            }
        }
    }
}
六、总结:三个阶段的防护清单
| 阶段 | 防护措施 | Kafka | RocketMQ | RabbitMQ |
|---|---|---|---|---|
| 生产 | 同步确认 | acks=all |
同步发送 | Publisher Confirm |
| 生产 | 重试机制 | retries=MAX |
retryTimesWhenSendFailed |
应用层重试 |
| 生产 | 幂等/事务 | enable.idempotence / 事务 |
事务消息 | - |
| 生产 | 失败兜底 | 降级写 DB / 死信表 | 降级写 DB | 降级写 DB |
| 存储 | 多副本 | replication.factor=3 |
DLedger (Raft) | Quorum Queue |
| 存储 | 最小 ISR | min.insync.replicas≥2 |
SYNC_MASTER |
仲裁节点 |
| 存储 | 同步刷盘 | 依赖副本(非单机) | SYNC_FLUSH |
持久化消息 |
| 消费 | 手动确认 | 手动提交 Offset | CONSUME_SUCCESS |
手动 ACK |
| 消费 | 重试队列 | 应用层实现 | RECONSUME_LATER |
basicNack |
| 消费 | 死信队列 | 应用层实现 | %DLQ% |
DLX |
| 全局 | 事务消息 | Kafka 事务 | RocketMQ 事务消息 | - |
| 全局 | 本地消息表 | ✓ | ✓ | ✓ |
| 全局 | 定时对账 | ✓ | ✓ | ✓ |
核心原则:
- 生产阶段:宁可重试,不可漏发。发送失败必须落盘(死信表)或告警
- 存储阶段:多副本 + 最小 ISR > 单机刷盘。不要依赖单机可靠性
- 消费阶段:先处理、后提交。消费失败不提交,重试超限进死信
- 全局兜底:对账,对账,还是对账。没有 100% 可靠的消息系统,只有持续对账的补偿机制
面试官提问
以下问题从面试官视角出发,考察对消息可靠性原理的深度理解和工程判断力。建议先独立思考,再对照参考答案。
Q1:你说生产环境配置了**acks=all**和**min.insync.replicas=2**,但某天监控显示生产者发送超时大量报错。你排查后发现 ISR 只剩 Leader 一个副本了。为什么 ISR 会缩到只剩 Leader?你如何在不丢消息的前提下恢复服务?
点击查看参考答案
ISR 收缩的原因:
- Follower 副本所在 Broker 宕机或网络分区,导致
replica.lag.time.max.ms(默认 30s)内未同步,被踢出 ISR - Follower 副本所在 Broker 磁盘 I/O 故障,导致同步落后超过阈值
- 突发流量导致 Follower 消费跟不上 Leader 的写入速度
不丢消息恢复方案:
- 立即排查 Follower 异常原因——是 Broker 宕机则重启,是网络分区则修复网络,是磁盘 I/O 瓶颈则扩容
- 等待 Follower 重新追平并加入 ISR——此时
min.insync.replicas=2重新满足,生产者恢复正常 - 如果 Follower 短期无法恢复,考虑临时调整
min.insync.replicas=1让生产者恢复(这会丢失 ISR ≥ 2 的保护,需评估风险),同时紧急修复 Follower - 根本原则:宁可短时间不可用,也不丢消息。如果业务允许降级,可以临时降低
min.insync.replicas,但必须同步开启补偿机制(如写本地死信表)
关键判断:面试官想看到的不是"加机器"这种表面答案,而是你理解 min.insync.replicas 与 acks=all 的联动关系,以及能在"可用性"和"可靠性"之间做有意识的权衡决策。
Q2:你用了 Kafka 的幂等生产(**enable.idempotence=true**),但上线后发现消息还是出现了重复。分析一下可能的原因。
点击查看参考答案
幂等生产只在单分区 + 单 Producer 会话内有效。以下场景会失效:
- Producer 重启:重启后分配新的 PID(Producer ID),Broker 用 (PID, 序列号) 去重。新 PID 下序列号从 0 开始,无法识别旧 PID 已发送的消息,导致重复
- 跨分区:幂等性基于
(PID, TopicPartition, SequenceNumber),不同分区独立维护序列号。如果消息因重试被发到不同分区(如默认分区器对 key 为 null 的消息做轮询),两个分区各自认为该序列号是"新消息" - 事务未开启:幂等生产只保证单分区内不重复,不保证跨分区、跨 Topic 的原子性。如果 Producer 发了 Topic A 和 Topic B,A 成功 B 失败重试,对 A 来说就是重复
**max.in.flight.requests.per.connection**配置不当:Kafka 0.11 之前,幂等生产要求该值 ≤ 5(0.11+ 配合幂等可到 5),但如果没有开启幂等,该值 > 1 且retries > 0时,重试可能导致乱序和重复
追问:如果业务需要跨分区、跨会话的精确一次,应该怎么做?
→ 答案:使用 Kafka 事务(initTransactions + beginTransaction + commitTransaction),或在上游业务层做去重(如唯一业务键 + 数据库去重表)。
Q3:线上消费延迟持续增大,你发现消费者处理逻辑中有一次 RPC 调用超时,导致消息反复重试。你如何设计消费重试机制,既保证不丢消息,又避免消费积压雪崩?
点击查看参考答案
核心矛盾:重试保证不丢消息,但重试本身占用了消费能力,导致积压恶化。
设计方案:
- 区分可重试异常和不可重试异常:
- 不可重试:数据格式错误、业务校验失败 → 直接进死信队列,不重试
- 可重试:RPC 超时、数据库连接失败、临时网络抖动 → 重试
- 指数退避 + 最大重试次数:
delay = min(2^retryCount * baseDelay, maxDelay),超过上限进死信队列 - 重试消息与正常消息隔离:RocketMQ 的做法——消费失败的消息进入
%RETRY%Topic,由独立的消费者线程处理,不影响正常消息的消费速度 - 限流 + 熔断:如果下游 RPC 持续超时,熔断器打开后直接降级处理(写本地死信表),避免无效重试耗尽资源
- 监控告警:对死信队列消息量、消费延迟、重试率设置告警,及时人工介入
关键点:面试官想听到的是"分层处理"思想——不是所有失败都重试,不是所有重试都等时长,不是所有异常都消耗同等资源。你的设计应该体现对系统容量的认知。
Q4:请你设计一个"订单创建 → 发送消息 → 下游履约"的端到端可靠方案。要求:订单创建成功消息必达,不允许消息丢失,但允许极少量重复(下游做幂等)。你不需要实现代码,画出架构并说明关键决策。
点击查看参考答案
推荐方案:本地消息表 + 定时补偿 + 下游幂等
订单服务 DB                         消息队列                       履约服务
┌─────────────────┐            ┌──────────────┐            ┌──────────────┐
│  orders 表       │            │ Topic: orders │            │ 消费 + 幂等   │
│  outbox_message  │──定时扫描──▶│ (acks=all,    │──消费者──▶│ 去重表/唯一键 │
│  (同一事务)       │            │  min.isr=2)   │            │              │
└─────────────────┘            └──────────────┘            └──────────────┘
关键决策:
- 为什么用本地消息表而不是事务消息? 事务消息要求消息队列支持(如 RocketMQ 事务消息),但本地消息表不依赖消息队列特性,对 Kafka/RabbitMQ/RocketMQ 都适用。缺点是多了定时扫描的延迟。
- 为什么允许重复? 网络超时导致生产者重试,但 Broker 可能已收到前一条消息(ACK 丢失),这时消息会重复。完全消除重复的代价是分布式事务(2PC/TCC),性能开销太大。让下游做幂等是更务实的选择。
- 定时扫描的频率和批量大小怎么定? 扫描频率 5-10 秒,批量 100 条。频率不能太高(避免数据库压力),不能太低(延迟过大)。批量大小要配合生产者吞吐量。
- 对账怎么做? 每天凌晨跑一次全量对账——对比订单服务的订单状态和履约服务的是否已处理,发现漏网之鱼补偿发送。
追问:如果订单量极大(每秒万级),本地消息表会成为瓶颈吗? → 答案:会。可以分库分表(按订单 ID 哈希),或改用 CDC(Change Data Capture)方案——监听订单表的 binlog 变化,直接发送到消息队列。Debezium + Kafka Connect 是常见选型。
Q5:RocketMQ 事务消息的回查机制(**checkLocalTransaction**)在什么情况下会被触发?如果回查逻辑写错了会有什么后果?
点击查看参考答案
回查触发条件:
- Producer 发送 Half 消息后,执行本地事务前宕机或网络中断,Broker 未收到 Commit/Rollback 指令
- Producer 执行了本地事务并返回了
UNKNOW状态 - Producer 的本地事务执行时间超过了 Broker 的等待超时时间
回查逻辑写错的后果:
- 回查永远返回 COMMIT:本地事务实际已回滚,但消息被提交,消费者看到了"不该看到"的消息 → 数据不一致
- 回查永远返回 ROLLBACK:本地事务实际已提交,但消息被回滚,消费者漏掉了消息 → 业务断链
- 回查抛异常/超时:Broker 会重试回查(默认 15 次),期间消息处于"半消息"状态,消费者不可见。如果回查始终失败,消息最终可能被丢弃
正确做法:
- 回查逻辑必须幂等(可能被多次调用)
- 回查必须查询权威数据源(数据库),不能依赖内存状态
- 回查必须有超时保护和失败兜底(如告警)
- 回查逻辑应该简单可靠——只做一件事:查数据库确认事务状态
关键判断:面试官在考察你对分布式事务"不确定性窗口"的理解。事务消息不是银弹,它只是把"不确定性"从消息发送延迟到了回查阶段,回查逻辑的正确性才是关键。
Q6:你在 Kafka 消费端使用了手动提交 Offset,但某次 Rebalance 后,发现大量消息被重复消费了。分析 Rebalance 导致重复消费的原因,以及如何减少重复消费的范围。
点击查看参考答案
Rebalance 导致重复消费的典型流程:
- 消费者 A 拉取了 offset 100-200 的消息
- 消费者 A 处理了 offset 100-150,还未来得及提交
- 触发 Rebalance(心跳超时 / 新消费者加入 / 消费者主动离开)
- 消费者 A 被踢出消费组,分区被分配给消费者 B
- 消费者 B 从上次提交的 offset(100)开始消费,100-150 被重复处理
减少重复消费范围的方法:
- 减小
**max.poll.records**(默认 500):每次拉取更少的消息,降低重复窗口 - 增大
**max.poll.interval.ms**:处理时间上限,避免因处理慢触发 Rebalance - 增大
**session.timeout.ms**和**heartbeat.interval.ms**:减少因 GC 停顿或网络抖动导致的误判 Rebalance - 提高提交频率:每处理一小批就提交一次,而不是等整个批次处理完再提交(代价是提交开销增加)
- 使用静态组成员(
group.instance.id):消费者重启后不触发 Rebalance - 业务层幂等:不管重复多少次,最终结果一致(最根本的解决办法)
关键点:面试官想听到的是"Rebalance 是无法完全避免的,所以重复消费也无法完全避免,最终要依赖业务幂等"。这个认知比具体配置更重要。
思考题:如果你负责设计一个金融交易系统的消息中间件,要求"消息零丢失 + 精确一次语义",你会选择哪种消息队列?为什么?在架构上需要做哪些额外的保障?(提示:没有标准答案,可以从 Kafka + 事务、RocketMQ + DLedger、Pulsar 等角度展开,重点考察你对不同方案的 trade-off 理解。)
本文是「Java 技术专家 / 架构师面试:250 个高频考点」系列的第 157 篇。