阅读时间:约 45 分钟 | 难度:★★★★☆ | 前置知识:Kafka 基础架构、生产者/消费者模型
1. 问题缘起:为什么消息语义是个"问题"?
在分布式系统中,故障是常态,不是异常。一条消息从生产到消费,经历的网络链路、Broker 节点、磁盘 I/O 都可能在任何时刻失败。Kafka 作为分布式消息中间件,其核心价值之一是"可靠地传递消息"——但"可靠"这个词在不同场景下含义完全不同。
想象一个电商订单系统:当用户支付成功,订单服务向 Kafka 发送一条"支付完成"消息。库存服务消费这条消息,扣减库存。
- 如果消息丢了 → 用户付了钱,库存没扣,超卖。
- 如果消息重复消费了 → 库存扣了两次,少卖。
- 如果恰好处理一次 → 一切完美。
这三种情况分别对应 Kafka 的三种消息语义:至多一次(At-Most-Once)、至少一次(At-Least-Once)、恰好一次(Exactly-Once)。
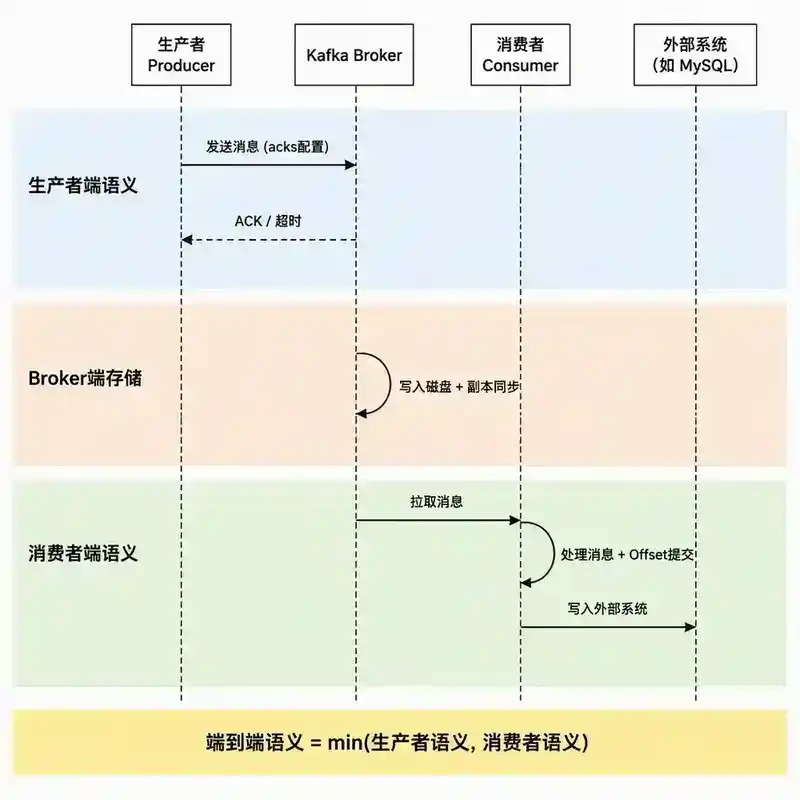
但在深入技术细节之前,有一个关键认知需要先建立:消息语义是一个"端到端"问题,不是 Kafka 单方面能保证的。 它涉及生产者、Broker 集群、消费者三个环节,任何一个环节的语义降级都会导致整体语义降级。
图1:Kafka 消息传递端到端链路示意(mermaid)
2. 消息语义的三层模型
2.1 语义定义
| 语义 | 定义 | 通俗理解 |
|---|---|---|
| 至多一次 (At-Most-Once) | 消息可能丢失,但绝不重复 | "发了就行,丢不丢不管" |
| 至少一次 (At-Least-Once) | 消息绝不丢失,但可能重复 | "必须送到,多送几次也行" |
| 恰好一次 (Exactly-Once) | 消息既不丢失也不重复 | "正好一次,不多不少" |
2.2 为什么不能天然做到恰好一次?
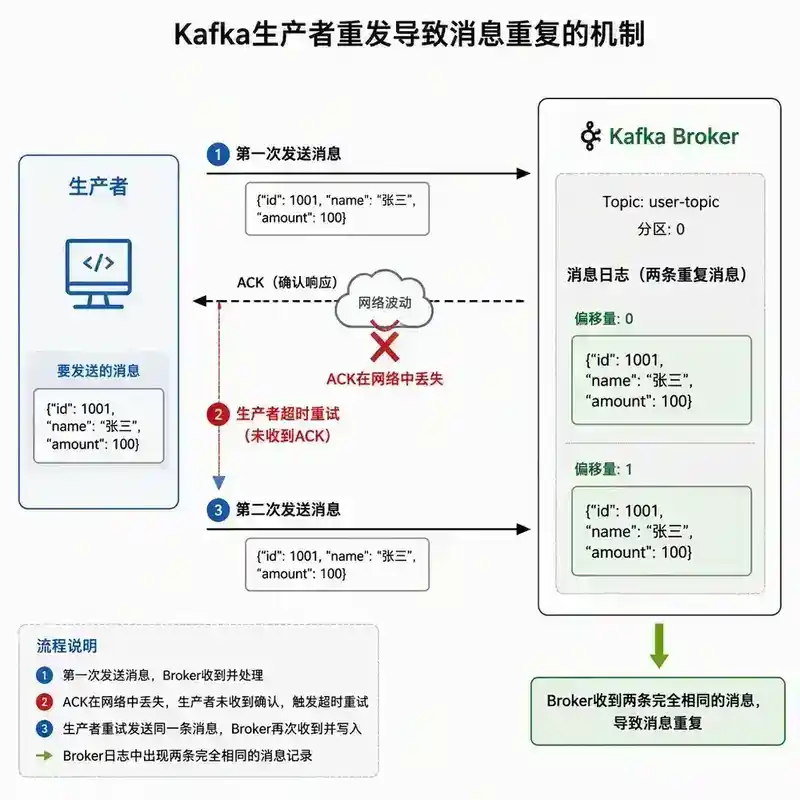
从分布式系统理论来看,消息传递系统本质上是一个不可靠网络上的两节点通信问题。发送方发送一条消息后,如果收不到确认(ACK),它面临两难选择:
- 重发 → 可能导致重复(至少一次)
- 不重发 → 可能导致丢失(至多一次)
这是一个经典的"两将军问题"变体——在没有无限可靠的通信渠道的情况下,没有任何协议能保证恰好一次传递。所有的"恰好一次"实现,本质上都是"至少一次"加上幂等性,或者通过事务机制来消除重复。
图2:生产者重发导致重复的示意(generate-image)
3. 生产者端:acks 参数与语义选择
Kafka 生产者的消息语义主要由 acks 参数控制,配合 retries、enable.idempotence 等参数。
3.1 acks=0:至多一次
生产者发送消息后不等待任何确认,直接认为成功。
发送流程:Producer → (消息写入缓冲区) → 立即返回成功
优点:延迟最低,吞吐量最高。 缺点:消息可能在网络传输中丢失,也可能在 Broker 写入磁盘前宕机丢失。
适用场景:日志采集、监控指标等可容忍少量丢失的数据。
3.2 acks=1:可能丢失,可能重复
生产者发送消息后,等待 Leader 副本写入本地日志后返回确认,不等 Follower 同步。
发送流程:Producer → Leader Broker → 写入本地日志 → ACK → Producer
丢失场景:Leader 写入成功后、Follower 同步完成前,Leader 宕机。新 Leader 没有这条消息,消息丢失。
重复场景:如果开启了 retries,Leader 写入成功但 ACK 因网络问题未到达 Producer,Producer 重试会导致消息重复。
3.3 acks=all(或 acks=-1):至少一次
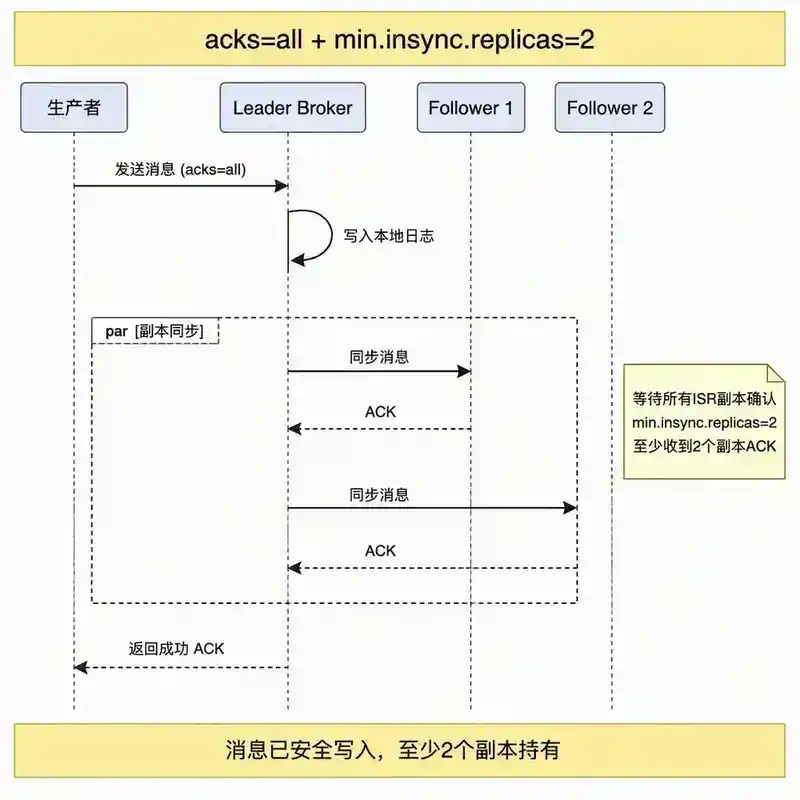
生产者发送消息后,等待消息被所有 ISR(In-Sync Replicas) 中的所有副本确认后才返回成功。配合 min.insync.replicas 参数控制最少同步副本数。
发送流程:Producer → Leader → 写入本地日志 → 等待所有 ISR 副本同步 → 全部 ACK → Leader ACK → Producer
为什么是"至少一次"? acks=all 保证了消息不会丢失(只要至少有一个副本存活),但如果开启了 retries,仍然可能因 ACK 丢失导致重复。
参数组合建议:
acks=all+min.insync.replicas=2+replication.factor=3:容忍 1 个 Broker 宕机不丢消息。- 如果
min.insync.replicas=1,那么 acks=all 退化为 acks=1。
图3:acks=all 的写入确认流程(mermaid 时序图)
3.4 enable.idempotence:生产者幂等
幂等生产者是 Kafka 实现"恰好一次"语义的第一块拼图。启用 enable.idempotence=true 后,Kafka 为每个生产者分配一个 Producer ID (PID),并为每条消息分配一个单调递增的序列号(Sequence Number)。
Broker 端会维护每个 <PID, TopicPartition> 的最近 5 个序列号。当收到重复序列号的消息时,Broker 直接丢弃,但返回成功——这样生产者认为发送成功,而实际不会产生重复。
幂等生产者流程:
1. Producer 初始化时向 Broker 申请 PID
2. 每条消息携带 <PID, Epoch, SeqNum>
3. Broker 检查 SeqNum:
   - 如果 SeqNum 比上次大 1 → 正常写入
   - 如果 SeqNum 比上次小或相等 → 丢弃(重复消息)
   - 如果 SeqNum 比上次大超过 1 → 抛出 OutOfOrderSequenceException(数据丢失)
幂等生产者的限制:
- 仅保证单个分区内的幂等,跨分区不保证。
- 仅保证单次生产者会话内的幂等,生产者重启后 PID 变化,之前的重复检测失效。
- 不能解决多分区写入的部分失败问题。
4. 消费者端:Offset 提交与语义
消费者端的语义取决于何时提交 Offset 以及如何处理消息。
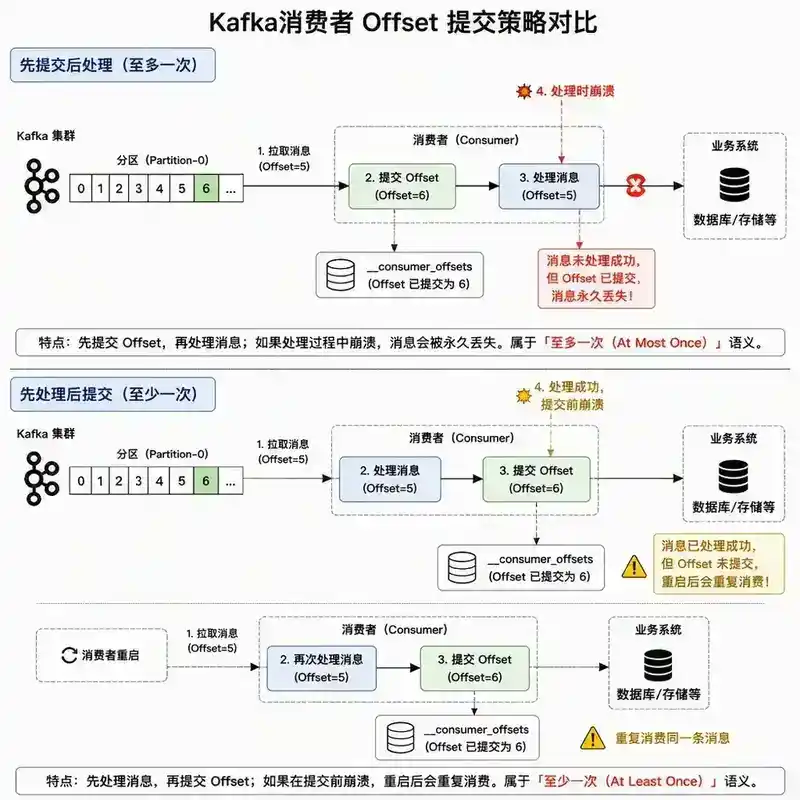
4.1 先提交后处理 → 至多一次
流程:拉取消息 → 提交 Offset → 处理消息
如果处理消息时消费者崩溃,Offset 已经提交,重启后从新位置开始消费,已拉取但未处理的消息永久丢失。
这就是典型的"至多一次"消费语义。
4.2 先处理后提交 → 至少一次
流程:拉取消息 → 处理消息 → 提交 Offset
如果处理成功后、提交 Offset 前消费者崩溃,重启后会重新消费并处理同一条消息,造成重复消费。
这是 Kafka 默认的消费语义,也是大多数业务场景的实际选择。
4.3 消费者如何实现"恰好一次"?
消费者端实现恰好一次,核心思路是消费幂等化:
- 业务幂等:在处理逻辑中通过唯一键去重(如数据库唯一约束、Redis SETNX)。
- 事务型消费:将消息处理和 Offset 提交放在同一个事务中,确保原子性。
图4:消费者先提交 vs 先处理 Offset 的对比(generate-image)
5. Kafka 事务:跨分区的恰好一次
5.1 为什么需要事务?
幂等生产者解决了单个分区的重复问题,但在以下场景中不够:
- 跨分区写入:一条业务消息需要写入多个 Topic/Partition,部分写入成功、部分失败。
- 消费-转换-生产:消费者读取消息,经过转换后写入另一个 Topic,要求"读"和"写"原子化。
Kafka 在 0.11 版本引入了事务机制,支持跨分区的原子写入。
5.2 事务核心概念
| 概念 | 说明 |
|---|---|
| Transactional Producer | 事务生产者,需要配置 transactional.id |
| Transaction Coordinator | 事务协调器,负责管理事务状态 |
| Transaction Log | 内部 Topic __transaction_state,持久化事务状态 |
| Control Message | 事务提交/中止时写入的标记消息,不影响 Offset 计数 |
| Read Committed | 消费者隔离级别,只读取已提交事务的消息 |
5.3 事务 API 使用
// 1. 初始化事务生产者
Properties props = new Properties();
props.put("transactional.id", "order-tx-001");  // 必须配置
props.put("enable.idempotence", true);           // 事务自动开启幂等
props.put("acks", "all");                        // 事务要求 acks=all

KafkaProducer<String, String> producer = new KafkaProducer<>(props);
producer.initTransactions();

// 2. 在事务中发送消息
producer.beginTransaction();
try {
    producer.send(new ProducerRecord<>("topic-A", "msg1"));
    producer.send(new ProducerRecord<>("topic-B", "msg2"));
    producer.commitTransaction();
} catch (Exception e) {
    producer.abortTransaction();
}
5.4 事务的工作原理
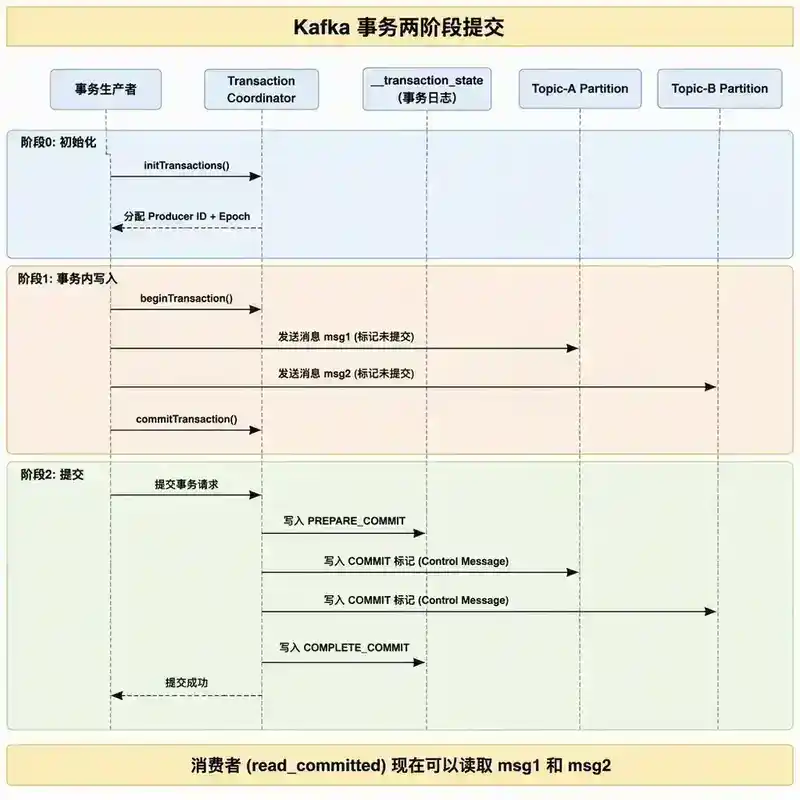
两阶段提交(简化版):
- BeginTransaction:Producer 向 Transaction Coordinator 注册事务。
- 发送消息:消息正常写入各 Topic 的 Partition,但标记为"未提交"状态。
- CommitTransaction:
- Producer 向 Transaction Coordinator 发送提交请求。
- Coordinator 在
__transaction_state中写入 PREPARE_COMMIT。 - Coordinator 向涉及的每个 Partition 写入 COMMIT 标记(Control Message)。
- Coordinator 在
__transaction_state中写入 COMPLETE_COMMIT。
消费者隔离级别:
read_uncommitted(默认):读取所有消息,包括未提交的事务消息。read_committed:只读取已提交事务的消息,未提交和已中止的消息被过滤。
图5:Kafka 事务两阶段提交流程(mermaid 时序图)
5.5 事务的性能代价
事务不是免费的:
- 每条事务消息增加约 20-30% 的延迟。
- Transaction Coordinator 成为瓶颈点(可扩展但有限)。
- 事务日志
__transaction_state的写入和复制增加集群负载。 read_committed消费者需要缓冲未提交消息,增加内存开销。
适用场景:金融交易、订单状态流转、库存扣减等对一致性要求极高的场景。
6. 端到端恰好一次:生产→消费的全链路
6.1 端到端恰好一次的完整配置
Producer                          Broker                        Consumer
[幂等+事务]  ──→  [acks=all + 事务支持]  ──→  [read_committed + 消费幂等]
完整配置清单:
| 环节 | 配置 | 作用 |
|---|---|---|
| Producer | enable.idempotence=true |
单分区幂等 |
| Producer | transactional.id=xxx |
开启事务 |
| Producer | acks=all |
保证写入不丢 |
| Broker | transaction.state.log.replication.factor=3 |
事务日志可靠性 |
| Broker | transaction.state.log.min.isr=2 |
事务日志持久性 |
| Consumer | isolation.level=read_committed |
只读已提交消息 |
| Consumer | enable.auto.commit=false |
手动控制 Offset |
| Consumer | 业务幂等处理 | 防止重复消费 |
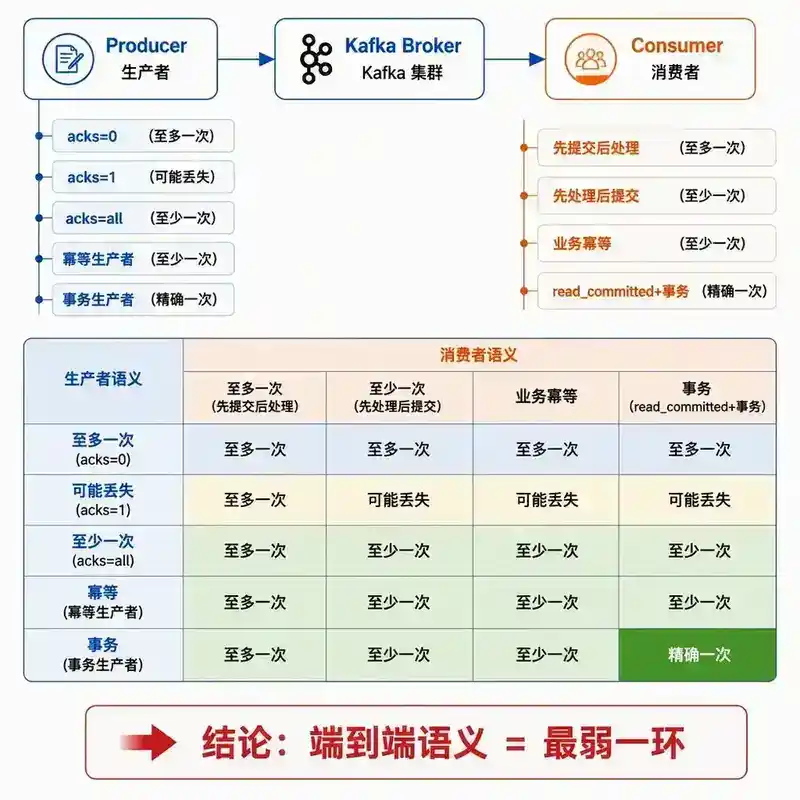
6.2 端到端语义矩阵
| Producer 语义 | Consumer 语义 | 端到端语义 |
|---|---|---|
| 至多一次 | 至多一次 | 至多一次 |
| 至多一次 | 至少一次 | 至多一次(丢消息) |
| 至少一次 | 至多一次 | 至多一次(丢消息) |
| 至少一次 | 至少一次 | 至少一次(可能重复) |
| 至少一次 | 幂等消费 | 恰好一次 |
| 事务 | read_committed + 幂等 | 恰好一次 |
关键结论:端到端语义取决于最弱的一环。即使 Producer 配置了事务,如果 Consumer 使用 read_uncommitted 且不处理幂等,最终仍是至少一次。
图6:端到端语义矩阵与链路示意(generate-image)
7. 生产实践与常见陷阱
7.1 陷阱一:幂等生产者的序列号溢出
幂等生产者每个 <PID, TopicPartition> 的序列号是 int32 类型。当单分区发送超过 2^31 条消息时,序列号溢出会触发 OutOfOrderSequenceException,生产者会阻塞。
解决:定期重启生产者(获取新 PID),或使用事务替代幂等(事务无序列号上限)。
7.2 陷阱二:事务超时
Kafka 事务有超时时间(默认 15 分钟,由 transaction.timeout.ms 控制)。如果事务处理时间过长,Broker 会自动中止事务,导致所有写入回滚。
解决:合理设置超时时间,避免在事务中执行耗时操作(如调用外部服务)。
7.3 陷阱三:read_committed 的延迟
read_committed 消费者必须等待事务提交后才能消费消息。如果上游事务处理较慢,下游消费者会出现延迟。最坏情况下,一个未提交的长事务会阻塞所有后续消费者。
解决:监控事务耗时,设置合理的超时,考虑使用 read_uncommitted + 业务幂等替代。
7.4 陷阱四:跨系统幂等
Kafka 事务只能保证 Kafka 内部的原子性。如果消费逻辑中涉及外部系统(如数据库、Redis),需要使用分布式事务或最终一致性方案。
错误做法:
  beginTransaction()
  consume from kafka
  write to MySQL        // ← 不在 Kafka 事务范围内!
  commitTransaction()
正确做法:
- 方案 A:使用 Outbox 模式,将 MySQL 写入和 Kafka 发送合并为一个本地事务。
- 方案 B:接受最终一致性,消费端通过唯一键实现幂等。
7.5 陷阱五:事务 ID 与僵尸生产者
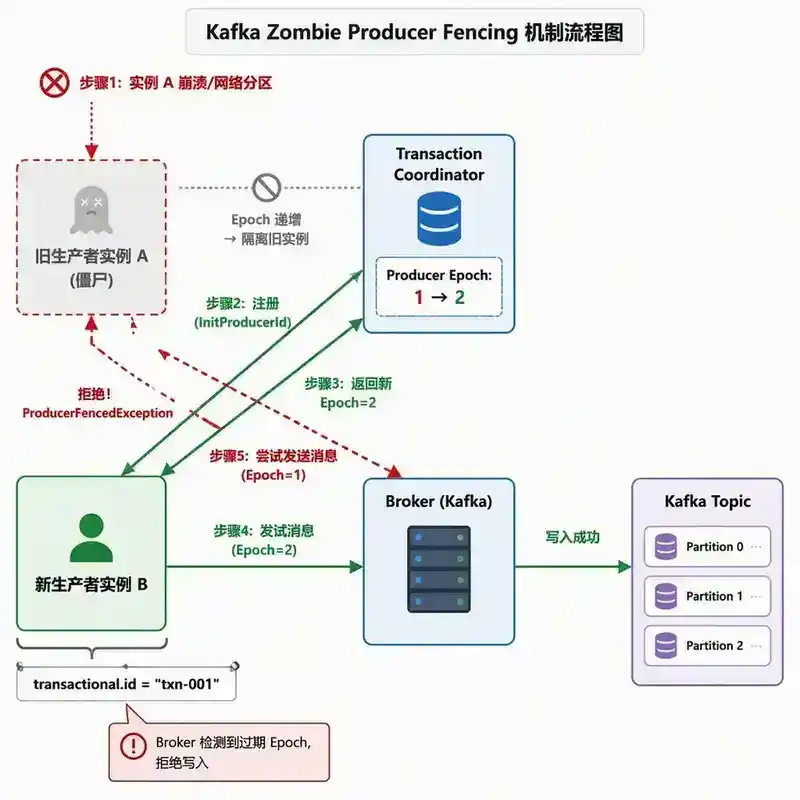
同一个 transactional.id 不能同时被两个生产者实例使用。如果旧实例未正常关闭,新实例启动后,Kafka 会通过 Producer Epoch 机制"隔离"(fence)旧实例,防止僵尸生产者写入脏数据。
图7:僵尸生产者隔离机制(generate-image)
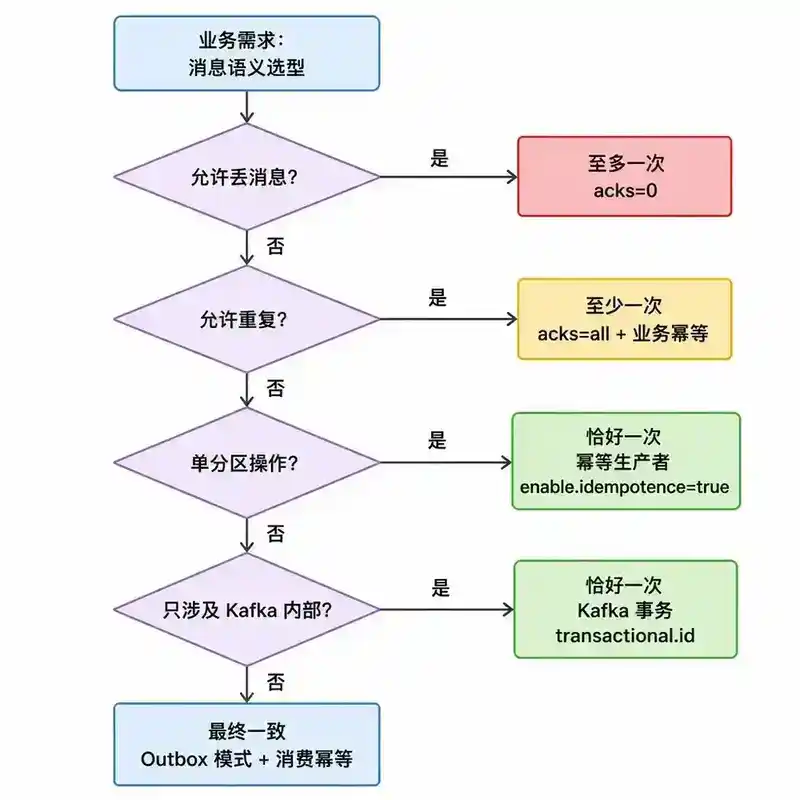
8. 语义选择决策树
业务需求分析
├── 允许丢消息? ── 是 ──→ acks=0, 至多一次
│   └── 否
│       ├── 允许重复? ── 是 ──→ acks=all + 业务幂等, 至少一次
│       │   └── 否
│       │       ├── 单分区操作? ── 是 ──→ 幂等生产者
│       │       │   └── 否
│       │       │       ├── 只在 Kafka 内部? ── 是 ──→ Kafka 事务
│       │       │       └── 涉及外部系统? ──→ 最终一致性 + 幂等
图8:消息语义选择决策树(mermaid flowchart)
9. 总结
| 维度 | 至多一次 | 至少一次 | 恰好一次 |
|---|---|---|---|
| 核心机制 | 无确认 | 确认+重试 | 幂等+事务 |
| 消息丢失 | 可能 | 不会 | 不会 |
| 消息重复 | 不会 | 可能 | 不会 |
| 性能开销 | 最低 | 中等 | 最高 |
| 实现复杂度 | 简单 | 中等 | 高 |
| 典型场景 | 日志、指标 | 大多数业务 | 金融、交易 |
最终建议:对于大多数业务场景,至少一次 + 消费者幂等 是最佳平衡点。Kafka 事务虽然强大,但引入的性能和运维成本不可忽视。在选择"恰好一次"之前,先问自己:重复消费真的不可接受吗? 在许多场景下,一个幂等键的成本远低于一套完整的事务机制。
面试官视角:提问与回答
(以下问题不计入 40 分钟阅读时间,建议在理解全文后尝试回答)
Q1:Kafka 的幂等生产者和事务有什么区别?分别在什么场景下使用?
Q2:acks=all 配合 min.insync.replicas=1 和 replication.factor=3,消息会丢失吗?为什么?
Q3:一条消息在 Kafka 中从生产到消费,经历哪些"可能丢失"的环节?如何逐一防护?
Q4:消费端已经实现了业务幂等(如数据库唯一键去重),为什么还需要考虑 Producer 端的幂等?
Q5:Kafka 事务中,如果 Consumer 在 read_committed 模式下,遇到一个长事务迟迟未提交,会有什么后果?如何解决?
Q6:设计一个"端到端恰好一次"的下单系统,涉及 Kafka 和 MySQL。请画出架构图,并说明每个环节的语义保证。
本文是"Java 技术专家 / 架构师面试:250 个高频考点总览"第 151 号知识点的详细讲解。
面试官视角:回答参考
Q1:Kafka 的幂等生产者和事务有什么区别?分别在什么场景下使用?
回答参考:
两者解决的是不同维度的问题,不能互相替代。
| 维度 | 幂等生产者 | 事务生产者 |
|---|---|---|
| 粒度 | 单个分区 (TopicPartition) | 跨分区、跨 Topic |
| 去重范围 | 单次生产者会话内 | 事务边界内,会话重启后仍有效 |
| 实现机制 | PID + Sequence Number | Transaction Coordinator + Control Message |
| 原子性保证 | 不保证,多分区写入部分失败无法回滚 | 保证,事务内所有写入要么全部成功要么全部失败 |
| 消费端影响 | 无,对消费者透明 | 消费者需配置 read_committed 隔离级别 |
| 性能开销 | 极低(仅增加 SeqNum 检查) | 较高(增加事务协调和日志写入) |
| 配置 | 仅 enable.idempotence=true |
需额外配置 transactional.id |
场景选择:
- 幂等生产者:单分区写入去重,如用户行为日志写入、单 Topic 事件流。绝大多数场景,开启幂等就足够了——它几乎没有性能损失,为什么不开启?
- 事务生产者:跨分区写入需要原子性,如订单创建后同时写入"订单 Topic"和"通知 Topic";或者 consume-transform-produce 模式,如从原始数据 Topic 消费、聚合后写入结果 Topic,要求不丢不重。
一个常见的错误认知是"事务比幂等更高级,应该直接上事务"。实际上,事务引入了 Transaction Coordinator 单点、事务日志复制、消费者阻塞等额外复杂度。能用幂等解决的,不要上事务。
Q2:acks=all 配合 min.insync.replicas=1 和 replication.factor=3,消息会丢失吗?为什么?
回答参考:
会丢失。 这是一个经典的配置陷阱。
min.insync.replicas=1 的含义是:Leader 写入本地日志后,只要还有 1 个 ISR 副本(包括 Leader 自己) 确认,就返回成功。因为有 3 个副本(replication.factor=3),但只需要 1 个确认,所以:
- 场景:Leader 写入成功,但两个 Follower 都还没来得及同步。此时 Leader 给 Producer 返回 ACK(因为 min.insync.replicas=1 已满足)。
- 紧接着 Leader 宕机。由于两个 Follower 都没有这条消息,新 Leader 自然也没有。
- 消息丢失。
这本质上是因为 min.insync.replicas=1 让 acks=all 退化成了 acks=1。正确的配置应该是:
acks=all
min.insync.replicas=2
replication.factor=3
这样,Leader 必须等待至少 1 个 Follower 同步完成才能返回 ACK。即使 Leader 宕机,至少还有一个 Follower 保有消息,可以被选为新 Leader。
面试加分点:可以进一步讨论 ISR 收缩机制——如果 Follower 落后太多被踢出 ISR,只剩下 Leader 自己,此时 min.insync.replicas=2 无法满足,Producer 会收到 NOT_ENOUGH_REPLICAS 异常,宁可不可用,也不丢消息。这是 Kafka 的一致性优先设计选择。
Q3:一条消息在 Kafka 中从生产到消费,经历哪些"可能丢失"的环节?如何逐一防护?
回答参考:
从端到端视角,消息丢失可能发生在以下 5 个环节:
| 环节 | 丢失场景 | 防护措施 |
|---|---|---|
| ① Producer 发送 | 网络丢包,消息未到达 Broker | 配置 retries > 0,开启重试机制 |
| ② Broker 接收 | OS Page Cache 未刷盘,Broker 宕机 | acks=all + min.insync.replicas >= 2,依赖多副本而非同步刷盘 |
| ③ Leader → Follower 同步 | Leader 写入后、Follower 同步前 Leader 宕机 | min.insync.replicas >= 2,确保至少一个 Follower 已同步 |
| ④ 磁盘故障 | 所有副本所在磁盘同时损坏 | 多机房/多 AZ 部署,增加副本数 |
| ⑤ Consumer 消费 | 先提交 Offset 后处理消息,消费者崩溃 | 先处理后提交,或使用事务性消费 |
深入分析 Broker 接收环节:
Kafka 的写入是异步刷盘的——消息写入 OS 的 Page Cache 后即返回,由操作系统决定何时刷入磁盘。如果 Broker 在刷盘前宕机,Page Cache 中的消息全部丢失。Kafka 的设计哲学是:依赖多副本复制来实现持久性,而不是依赖同步刷盘。 同步刷盘(flush.messages=1)会严重降低吞吐量(从几十万 TPS 降至几千 TPS),且只是把"丢失"从"Broker 宕机"变成了"磁盘损坏"——问题的本质没变。
所以正确的防护策略是:多副本 + 跨机架/跨可用区部署,而非逐条刷盘。
Q4:消费端已经实现了业务幂等(如数据库唯一键去重),为什么还需要考虑 Producer 端的幂等?
回答参考:
这是一个工程思维问题,考察候选人对"纵深防御"的理解。
1. 重复消息的代价不止在消费端
即使消费端能去重,重复消息仍然消耗了网络带宽、Broker 存储、消费者处理资源。如果每秒有数万条重复消息,消费端的去重开销(查数据库、Redis 检查)本身就是不必要的浪费。在源头消除重复,比在下游过滤重复更高效。
2. 消费端幂等只能去重,不能回滚
如果 Producer 跨分区写入,部分分区写入成功但部分失败,消费端幂等无法解决"部分写入"的问题——它只能保证每条消息的处理结果幂等,但无法让已成功的写入"撤销"。事务可以在 Producer 端回滚,保证要么全写入、要么全不写入。
3. 消费端幂等可能被绕过
如果消费端有多个消费者组,或者消息被不同的下游系统消费(如一个写入 MySQL、一个更新 Redis),每个消费端都需要独立实现幂等。Producer 端的幂等是一次性的,对所有下游生效。
4. 面试中的高阶回答
可以引用"纵深防御"(Defense in Depth)原则:在分布式系统中,没有单点防护是绝对可靠的。Producer 端幂等是第一道防线,Broker 端去重(幂等生产者)是第二道,Consumer 端幂等是第三道。每一道防线都有其失效边界(如 Producer 重启后 PID 变化),所以需要多层防护。
Q5:Kafka 事务中,如果 Consumer 在 read_committed 模式下,遇到一个长事务迟迟未提交,会有什么后果?如何解决?
回答参考:
后果:
Kafka 的 read_committed 消费者按 Offset 顺序消费消息。当事务未提交时,其消息在 Partition 中处于"未提交"状态。由于 Kafka 保证分区内消息顺序性,read_committed 消费者会:
- 消费到第一条未提交事务消息时,暂停消费,等待该事务提交或中止。
- 该事务之后的所有消息(无论是否属于同一事务、是否已提交)都被阻塞,无法被消费。
- 如果事务一直不提交(如生产者崩溃、代码死循环),消费者会永久阻塞在这个 Offset 上,导致下游业务完全停滞。
本质上,一个未提交的长事务形成了一个"逻辑水坝",阻塞了整条消息流。
解决方案:
- 设置合理的事务超时(
transaction.timeout.ms,默认 15 分钟):Broker 会在超时后自动中止事务,释放阻塞。需要根据业务最长处理时间设置,不宜过长。 - Producer 端监控:监控事务耗时(从 beginTransaction 到 commitTransaction 的时长),设置告警。如果事务时间超过预期,主动排查。
- Consumer 端兜底:Consumer 可以设置
max.poll.interval.ms,如果被阻塞超过此时间,触发 Rebalance,将分区分配给其他消费者。但这只是转移问题,如果事务仍不提交,新消费者也会被阻塞。 - 架构层面:对于"可能长事务"的场景,考虑不使用
read_committed,改用read_uncommitted+ 消费端业务幂等。业务幂等虽然不能回滚已写入的内容,但至少不会阻塞消费流。 - 监控事务日志:关注
__transaction_stateTopic 的写入情况,发现异常状态的事务及时处理。
Q6:设计一个"端到端恰好一次"的下单系统,涉及 Kafka 和 MySQL。请画出架构图,并说明每个环节的语义保证。
回答参考:
这是一个典型的系统设计题,考察候选人对"恰好一次"边界的理解。
核心判断:Kafka 事务只能保证 Kafka 内部的原子性,不能跨系统保证。 因此,涉及 MySQL 时,需要用到 Outbox 模式 或 最终一致性方案。
方案:Outbox 模式(推荐)
┌─────────────────────────────────────────────────────────────────┐
│                        订单服务 (Order Service)                   │
│                                                                 │
│  ① 接收下单请求                                                  │
│     ↓                                                           │
│  ② 在同一 MySQL 本地事务中:                                      │
│     ├── INSERT INTO orders (order_id, status, ...)              │
│     └── INSERT INTO outbox (id, topic, payload, status)         │
│     ↓                                                           │
│  ③ Debezium/Kafka Connect 监听 outbox 表 CDC                    │
│     ↓                                                           │
│  ④ 发送到 Kafka (Topic: order-events)                           │
│     Producer: enable.idempotence=true, acks=all                 │
│     ↓                                                           │
│  ⑤ Kafka Broker: replication.factor=3, min.insync.replicas=2   │
│     ↓                                                           │
│  ⑥ 库存服务消费 order-events                                    │
│     Consumer: isolation.level=read_committed                    │
│     ↓                                                           │
│  ⑦ 幂等消费:                                                    │
│     INSERT INTO inventory_deductions (order_id, ...)            │
│     ON DUPLICATE KEY UPDATE ... (使用 order_id 唯一键去重)      │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
各环节语义保证:
| 环节 | 语义 | 保证机制 |
|---|---|---|
| ①→② 订单写入 + Outbox | 恰好一次 | MySQL 本地事务原子性:订单和 Outbox 同时写入或同时回滚 |
| ②→③ CDC 读取 Outbox | 至少一次 | Debezium 保证至少一次投递,可能有重复 |
| ③→④ 发送到 Kafka | 至少一次 | acks=all + retries,保证不丢;幂等生产者去重 |
| ④→⑤ Kafka 存储 | 至少一次 | 多副本 + ISR 机制保证持久性 |
| ⑤→⑥ 消费消息 | 恰好一次 | read_committed 过滤未提交消息 |
| ⑥→⑦ 库存扣减 | 恰好一次 | MySQL 唯一键 order_id 实现幂等写入 |
为什么不用 Kafka 事务直接保证?
因为 Kafka 事务不能跨系统。如果写成:
producer.beginTransaction();
// 消费 Kafka 消息
// 写入 MySQL  ← 不在 Kafka 事务范围!
producer.commitTransaction();
MySQL 写入与 Kafka 事务提交之间没有原子性保证。如果 MySQL 写入成功但 Kafka 事务提交失败(或反之),就会出现不一致。
Outbox 模式的核心思想:将"Kafka 写入"这个操作,转化为"数据库表写入"这个操作,利用 MySQL 本地事务的原子性来保证一致性。Debezium 作为"可靠的信使",将 Outbox 表中的数据搬运到 Kafka,保证至少一次投递。
面试加分点:可以讨论 Outbox 模式的变体——轮询 Outbox 表(Polling Publisher)和事务日志追踪(Transaction Log Tailing,即 Debezium 的方式),对比两者的延迟和可靠性。还可以讨论如果下游消费失败,如何通过 Outbox 表的状态字段实现重试和死信队列。
以上为面试官视角的参考答案。实际面试中,面试官更关注候选人的思考过程而非死记硬背——能讲清楚"为什么"比"是什么"更重要。