阅读时间:约 45 分钟 | 难度:进阶 | 前置知识:RocketMQ 基础架构(NameServer/Broker/CommitLog/ConsumeQueue)
一、开篇:为什么需要"特殊消息"
普通消息投递到 Broker 后,消费者按什么顺序拉取、什么时候能被消费、消费失败后如何回滚——这些行为对于大多数场景已经足够。但真实业务中,有三种需求会突破"普通消息"的能力边界:
- 顺序消息:订单的创建→支付→发货→完成,必须按序处理。如果"发货"先于"支付"到达,业务逻辑会直接崩溃。
- 延迟消息:下单 30 分钟未支付自动关单。你不能让一个线程 sleep 30 分钟,也不能写一个每分钟扫全表的定时任务。
- 事务消息:下单同时扣库存。如果扣库存成功但下单消息没发出去,或者消息发出去了但本地事务回滚了——数据就不一致了。
这三种消息类型本质上是在 RocketMQ 的基础消息模型之上,增加了对时间维度和一致性维度的约束。下面逐一拆解它们的实现机制、使用约束和生产陷阱。
二、顺序消息
2.1 问题定义
先明确"顺序"到底指什么。RocketMQ 保证的是分区有序(Partition Orderly),而非全局有序(Global Orderly)。全局有序需要把所有消息发到同一个队列,吞吐量会退化到单机水平,生产环境几乎不可接受。
分区有序的含义是:同一笔业务(如同一订单 ID)的所有消息,按发送顺序被同一个消费者线程消费。
2.2 实现机制
顺序消息的实现涉及生产端和消费端两个环节。
生产端:消息队列选择器
RocketMQ 生产者发送消息时,通过 MessageQueueSelector 将同一业务键的消息路由到固定的 MessageQueue:
// 订单 ID 作为选择键,保证同一订单的消息落入同一队列
SendResult sendResult = producer.send(msg, new MessageQueueSelector() {
    @Override
    public MessageQueue select(List<MessageQueue> mqs, Message msg, Object arg) {
        Long orderId = (Long) arg;
        int index = (int) (orderId % mqs.size());
        return mqs.get(index);
    }
}, orderId);
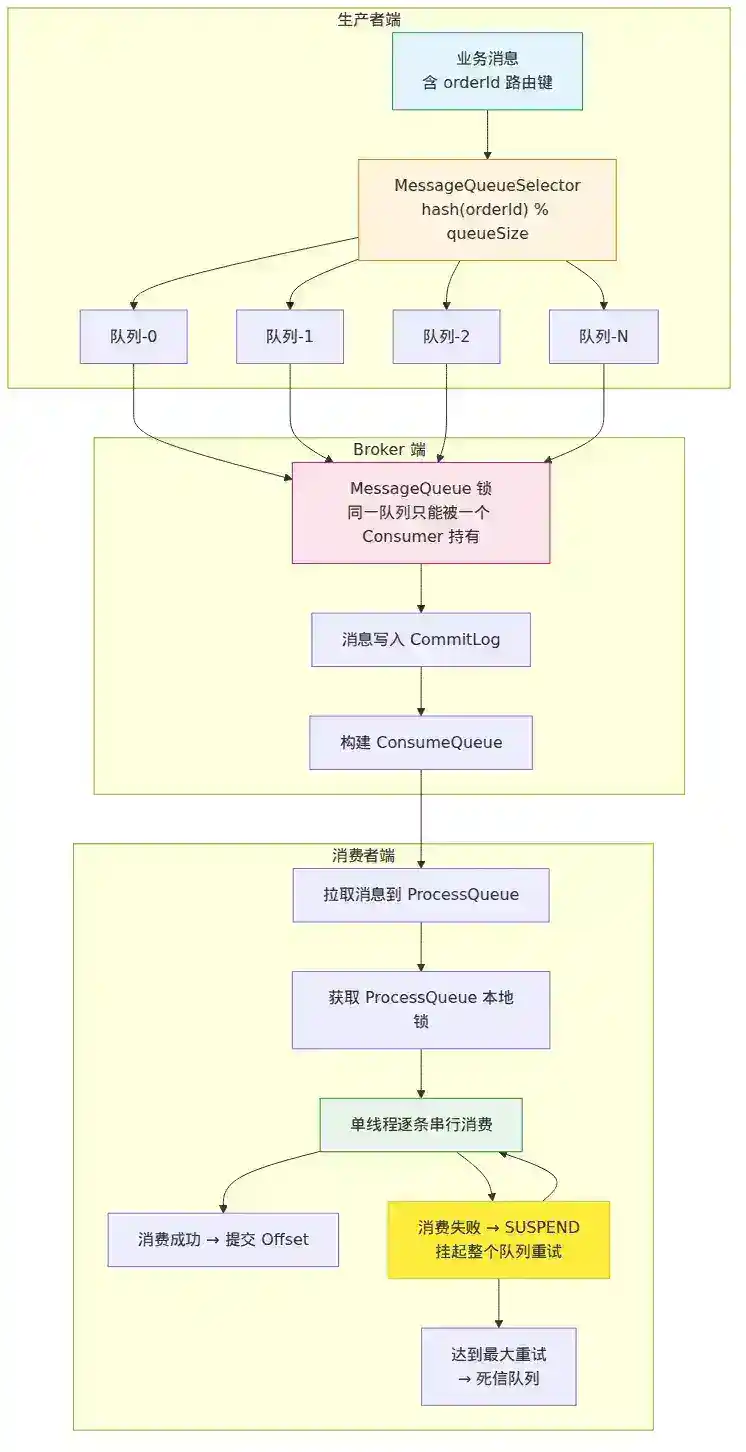
图1:顺序消息完整流程图*— Producer 通过 MessageQueueSelector 路由到固定 MessageQueue,Broker 端对 MessageQueue 加分布式锁,Consumer 端 ProcessQueue 本地锁保证单线程串行消费*
这里的关键约束是:selector 必须保证同一业务键总是映射到同一队列。如果队列数量发生变化(Broker 扩缩容),映射关系会改变,已经发到旧队列的消息和发到新队列的消息之间不再有序。这是生产环境最常见的顺序消息翻车场景。
消费端:锁机制与分段消费
消费端是顺序消息实现的核心,也是复杂度最高的部分。普通消息是并发消费——多个线程同时拉取、同时处理。顺序消息必须改为串行消费。
RocketMQ 的顺序消费依赖两个层次的锁:
第一层:Broker 端的 MessageQueue 锁
Consumer 向 Broker 申请某个 MessageQueue 的消费锁。同一时刻,一个 MessageQueue 只能被一个 Consumer 实例锁定。如果发生 Rebalance,锁会被释放,由新分配的 Consumer 重新获取。这个锁确保:即使 Consumer 集群有多个实例,同一队列的消息也不会被并发消费。
第二层:Consumer 端的本地队列锁
Consumer 内部为每个 MessageQueue 维护一个 ProcessQueue,消费时对该 ProcessQueue 加本地锁,确保同一队列的消息在当前 JVM 内串行处理。
完整的消费流程:
Consumer 拉取消息
    │
    ▼
向 Broker 申请 MessageQueue 锁
    │
    ▼
消息放入 ProcessQueue(本地有序队列)
    │
    ▼
获取 ProcessQueue 本地锁
    │
    ▼
单线程逐条消费,逐条提交 Offset
    │
    ▼
消费失败 → 挂起消费(SUSPEND_CURRENT_QUEUE_A_MOMENT)
         → 稍后重试同一条消息,不跳过
图2:顺序消费双层锁机制详解*— Broker 端 MessageQueue 分布式锁 + Consumer 端 ProcessQueue 本地锁,确保同一队列串行消费*
注意这个"消费失败不跳过"的设计:并发消费时,失败的消息可以丢回队列或进入重试 Topic,Consumer 继续消费下一条。但顺序消费不同——如果当前消息消费失败就跳过,顺序就不存在了。所以顺序消费失败时,Consumer 会挂起整个队列的消费,不断重试当前消息,直到成功或达到最大重试次数。
2.3 生产约束与常见陷阱
约束一:消费失败会阻塞整个队列
这是顺序消费最大的代价。如果某条消息因为业务逻辑问题反复失败(比如依赖的外部服务挂了),整个队列的所有消息都会被阻塞。解决方法:
- 设置合理的重试次数上限,超过上限后人工介入或转移到死信队列
- 监控每个队列的消费延迟,及时发现阻塞
约束二:不能使用异步消费
顺序消费必须同步处理。如果你在 MessageListenerOrderly 里开了异步线程去处理,消息返回 CONSUME_SUCCESS 时实际处理还没完成,顺序就乱了。
约束三:Rebalance 期间的消息重复
顺序消费不能完全避免消息重复。当 Consumer 宕机触发 Rebalance 时,新 Consumer 拿到锁后可能从上次提交的 Offset 继续消费,但最后几条消息可能已经被旧 Consumer 处理过(只是没来得及提交 Offset)。所以顺序消费仍然需要幂等处理。
约束四:吞吐量下降
N 个队列只能被 N 个 Consumer 线程并行消费(每个队列一个线程)。如果业务键分布不均匀(热点订单),会导致某些队列堆积、某些队列空闲。
2.4 代码示例:完整顺序消费
// 生产端
DefaultMQProducer producer = new DefaultMQProducer("order_producer_group");
producer.setNamesrvAddr("localhost:9876");
producer.start();

Message msg = new Message("OrderTopic", "OrderTag", "order_id_123",
    ("订单创建").getBytes(StandardCharsets.UTF_8));
producer.send(msg, (mqs, m, arg) -> {
    long orderId = (long) arg;
    return mqs.get((int) (orderId % mqs.size()));
}, 123L);

// 消费端
DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("order_consumer_group");
consumer.setNamesrvAddr("localhost:9876");
consumer.subscribe("OrderTopic", "*");
consumer.registerMessageListener((MessageListenerOrderly) (msgs, context) -> {
    for (MessageExt msg : msgs) {
        // 逐条处理,必须同步
        processOrderMsg(msg);
    }
    return ConsumeOrderlyStatus.SUCCESS;
});
consumer.start();
三、延迟消息
3.1 问题定义
延迟消息解决的是"在未来的某个时间点消费消息"的问题。典型场景:
- 下单 30 分钟未支付自动关单
- 会议开始前 15 分钟发送提醒
- 延迟重试(消费失败后不立即重试,而是等待一段时间)
3.2 实现机制
RocketMQ 的延迟消息实现非常巧妙,它不依赖任何定时调度框架,而是利用自身的存储和消费机制实现。
核心思路:延迟级别 + 内部 Topic 转换
RocketMQ 不支持任意精度的延迟时间,而是预定义了 18 个延迟级别(开源版,商业版支持任意时间):
1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h
发送延迟消息时,指定延迟级别而非具体时间:
Message msg = new Message("OrderTopic", "cancel", orderId, "".getBytes());
msg.setDelayTimeLevel(3); // 延迟级别 3 = 10s
producer.send(msg);
底层工作流程
延迟消息的处理分四步:
第一步:写入 CommitLog 时打上延迟标记
延迟消息写入 CommitLog 时,消息的 delayTimeLevel 属性被持久化。同时,原始 Topic 被替换为内部的 SCHEDULE_TOPIC_XXXX,原始 Topic 和 Queue 信息保存在消息属性中。
第二步:写入延迟 ConsumeQueue
ReputMessageService 构建 ConsumeQueue 时,延迟消息不写入原始 Topic 的 ConsumeQueue,而是写入 SCHEDULE_TOPIC_XXXX 对应的 ConsumeQueue,QueueId 就是延迟级别。
第三步:定时任务投递
Broker 内部有一个 ScheduleMessageService,为每个延迟级别启动一个定时任务(Timer),周期性扫描对应 QueueId 的 ConsumeQueue:
延迟级别 1 (1s)  → Timer 每 1s 扫描一次
延迟级别 2 (5s)  → Timer 每 5s 扫描一次
延迟级别 3 (10s) → Timer 每 10s 扫描一次
...
当某条消息的存储时间 + 延迟时间 ≤ 当前时间时,定时任务将它从 SCHEDULE_TOPIC_XXXX 中取出。
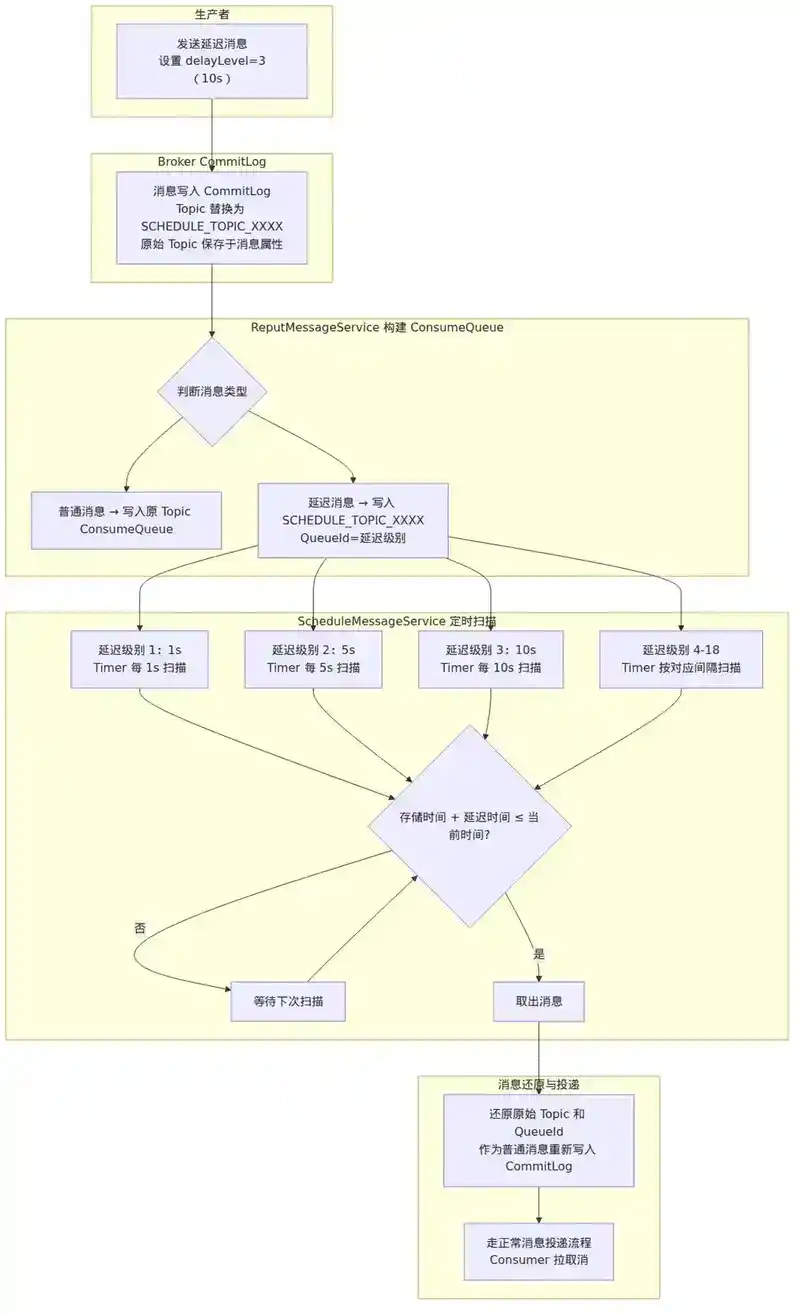
图3:延迟消息 ScheduleMessageService 定时扫描机制*— 18 个延迟级别各对应一个 Timer 线程,扫描 ConsumeQueue 判断投递时机*
第四步:还原并投递到原始 Topic
取出延迟消息后,Broker 将 Topic 和 QueueId 还原为原始值,重新写入 CommitLog(作为普通消息),然后走正常的消息投递流程。
生产者发送 delayLevel=3 (10s)
    │
    ▼
CommitLog 写入(Topic=SCHEDULE_TOPIC_XXXX,原始属性保留)
    │
    ▼
ConsumeQueue 写入(QueueId=3,即 10s 延迟级别)
    │
    ▼
ScheduleMessageService 定时扫描(~10s 后命中)
    │
    ▼
还原为原始 Topic,重新写入 CommitLog
    │
    ▼
正常投递 → 消费者消费
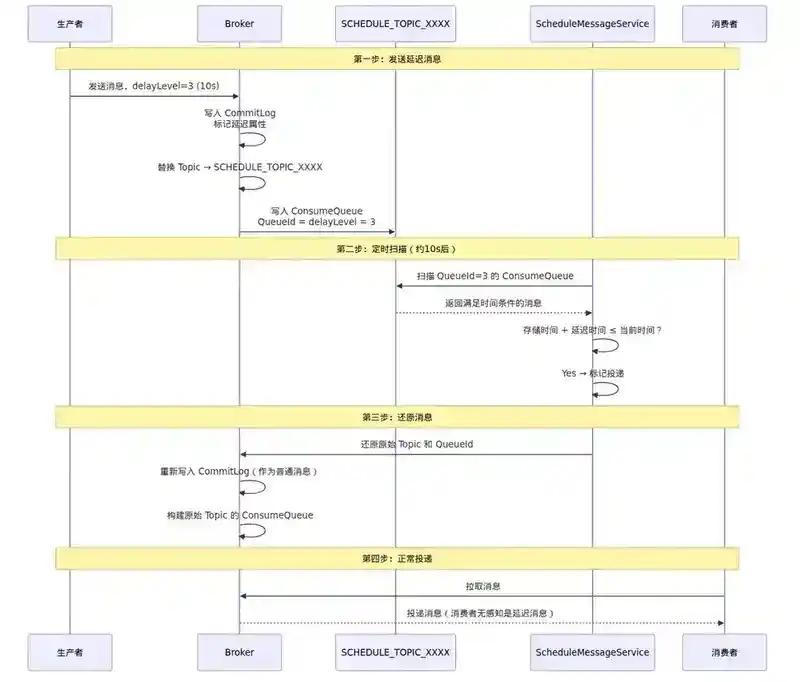
图4:延迟消息四步工作流程*— 发送延迟消息 → 写入 SCHEDULE_TOPIC_XXXX 的 ConsumeQueue → ScheduleMessageService 定时扫描 → 还原为原始 Topic 重新投递*
3.3 精度问题
延迟消息的精度受两个因素影响:
- 定时扫描间隔:Timer 不是实时的,有扫描间隔。如 10s 级别的 Timer 每 10s 扫描一次,消息可能在 10s~20s 之间被投递。级别越高,精度越差。
- CommitLog 写入延迟:还原后的消息要重新写入 CommitLog,再被 Consumer 拉取,还有额外的传输和处理延迟。
业务建议:不要依赖延迟消息做精确的时间控制。如果业务要求 30 分钟±1 秒关单,延迟消息做不到。需要精确计时的场景,建议用外部调度器(如 XXL-JOB)配合普通消息。
3.4 生产约束
- 延迟级别不可自定义(开源版):只有 18 个级别,选择有限。如果业务需要 45 秒延迟,只能选 30s 或 1m 两个级别,实际延迟时间会偏大。
- 延迟消息也有重试:如果还原后的消息消费失败,会进入重试流程,重试消息的延迟时间取决于重试级别,与原始延迟级别无关。
- 大量延迟消息堆积:如果某个延迟级别堆积了大量消息,定时扫描和批量投递可能导致瞬间流量冲击下游。
四、事务消息
4.1 问题定义
事务消息要解决的是分布式事务中的一个经典场景:本地事务与消息发送的原子性。
场景:用户下单
┌──────────────┐     ┌──────────────┐
│  订单服务      │     │  库存服务      │
│  创建订单      │────▶│  扣减库存      │
│  发送确认消息   │     │  监听消息      │
└──────────────┘     └──────────────┘
如果"创建订单"成功但"发送消息"失败,库存没扣,用户以为下单成功但实际没库存。反之,如果"发送消息"成功但"创建订单"失败(回滚了),库存扣了但订单不存在。
RocketMQ 事务消息通过两阶段提交 + 事务状态回查来解决这个问题。
4.2 实现机制
整体流程:半消息 + 事务状态回查
事务消息的完整生命周期分为三个阶段:
生产者                         Broker                      消费者
  │                              │                           │
  │  ① 发送半消息(half message)  │                           │
  │─────────────────────────────▶│                           │
  │                              │  消息写入 CommitLog        │
  │                              │  但不写入 ConsumeQueue     │
  │                              │  (消费者不可见)           │
  │  ② 执行本地事务               │                           │
  │  ┌──────────────────┐       │                           │
  │  │ 业务逻辑(如创建订单)│       │                           │
  │  └──────────────────┘       │                           │
  │                              │                           │
  │  ③ 提交事务状态               │                           │
  │  COMMIT / ROLLBACK           │                           │
  │─────────────────────────────▶│                           │
  │                              │                           │
  │                              │  COMMIT → 写入 ConsumeQueue│
  │                              │───────────────────────────▶│
  │                              │                           │  消费者可见
  │                              │  ROLLBACK → 删除半消息      │
  │                              │                           │
  │  (如果③未到达,Broker 回查)   │                           │
  │◀─────────────────────────────│                           │
  │  回查本地事务状态              │                           │
  │─────────────────────────────▶│                           │
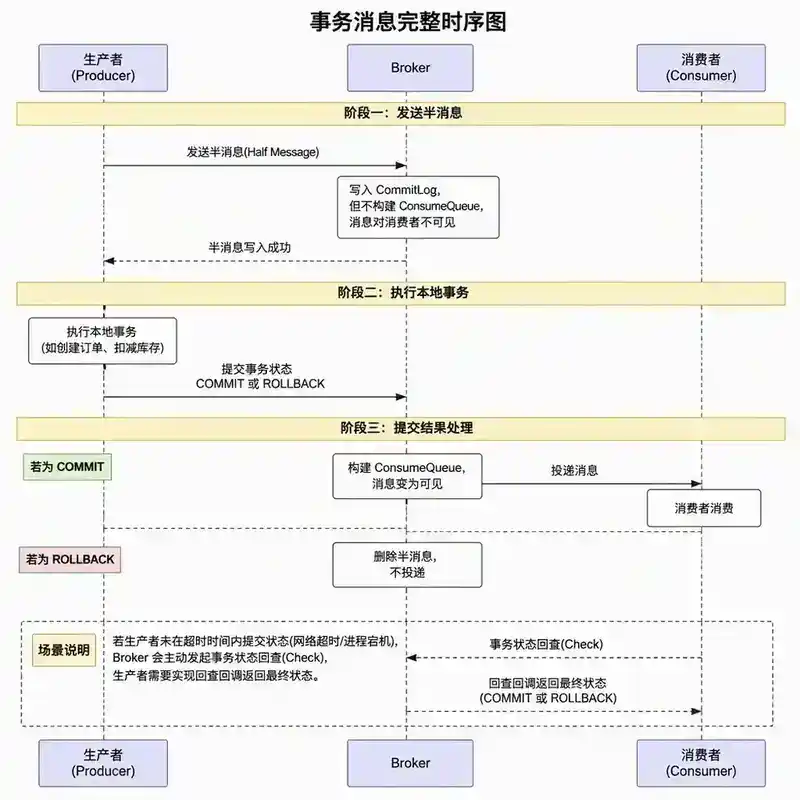
图5:事务消息完整时序图*— 半消息写入 CommitLog(不构建 ConsumeQueue)→ 执行本地事务 → COMMIT/ROLLBACK 提交事务状态 → Broker 构建 ConsumeQueue 投递或删除半消息;若超时未提交则触发事务状态回查*
第一步:发送半消息
半消息(Half Message)与普通消息的区别在于:
- 写入 CommitLog,但不构建 ConsumeQueue。没有 ConsumeQueue 索引,Consumer 无法消费到这条消息。
- 消息的
sysFlag标记为事务消息,transactionId关联到本次事务。
TransactionMQProducer producer = new TransactionMQProducer("tx_producer_group");
producer.setNamesrvAddr("localhost:9876");
producer.setTransactionListener(new TransactionListener() {
    @Override
    public LocalTransactionState executeLocalTransaction(Message msg, Object arg) {
        // 执行本地事务
        try {
            orderService.createOrder((Order) arg);
            return LocalTransactionState.COMMIT_MESSAGE;
        } catch (Exception e) {
            return LocalTransactionState.ROLLBACK_MESSAGE;
        }
    }

    @Override
    public LocalTransactionState checkLocalTransaction(MessageExt msg) {
        // 回查本地事务状态
        Order order = parseOrderFromMsg(msg);
        Order dbOrder = orderService.getById(order.getId());
        if (dbOrder != null) {
            return LocalTransactionState.COMMIT_MESSAGE;
        }
        return LocalTransactionState.ROLLBACK_MESSAGE;
    }
});
producer.start();

Message msg = new Message("OrderTopic", "create", JSON.toJSONBytes(order));
producer.sendMessageInTransaction(msg, order);
第二步:执行本地事务
executeLocalTransaction 回调中执行本地事务,返回三种状态:
COMMIT_MESSAGE:本地事务成功,通知 Broker 投递消息ROLLBACK_MESSAGE:本地事务失败,通知 Broker 删除半消息UNKNOW:本地事务状态未知(如本地事务未完成),Broker 稍后回查
第三步:事务状态回查
如果 Broker 没有收到生产者的二次确认(网络超时、生产者宕机等),或者收到 UNKNOW,Broker 会主动回调 checkLocalTransaction 查询本地事务的最终状态。
回查的核心机制:
- Broker 维护一个定时扫描任务,查找超过一定时间(默认 6 秒)未确认的事务消息
- 对每条未确认的半消息,向生产者发送回查请求
- 回查有最大次数限制(默认 15 次),超过后丢弃消息
- 回查间隔逐渐增大(如 6s → 30s → 1m → 5m...)
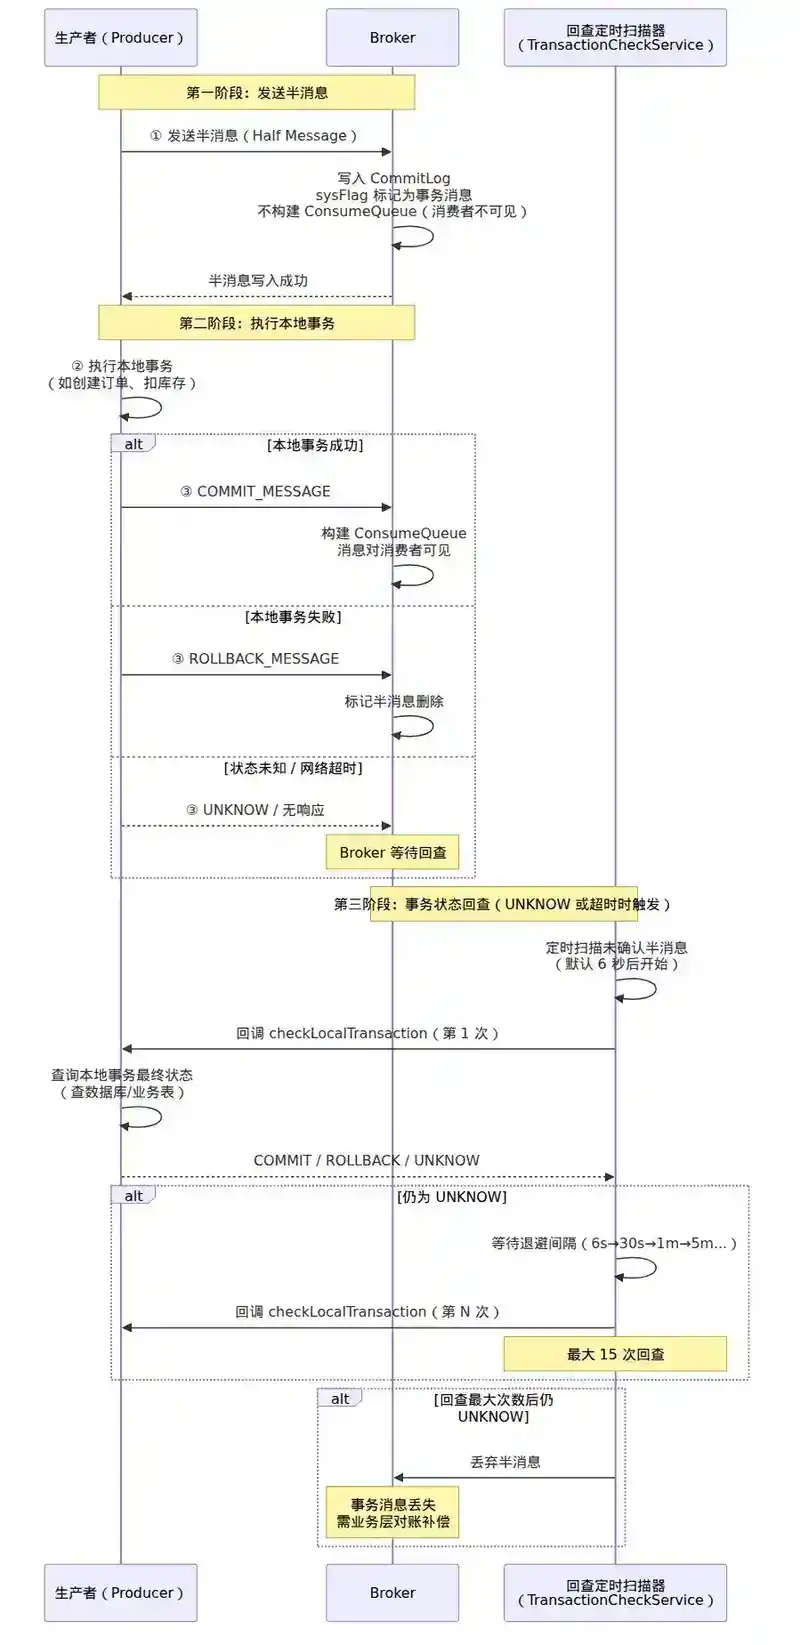
图6:事务消息回查机制详解*— Broker 定时扫描未确认半消息 → 回调 checkLocalTransaction → 指数退避重试 → 最大 15 次后丢弃*
4.3 事务消息的存储结构
半消息在 CommitLog 中有特殊标记,Broker 在 ReputMessageService 中判断:
- 普通消息 → 构建 ConsumeQueue
- 事务半消息 → 跳过,不构建 ConsumeQueue
- 事务消息回滚 → 标记删除
Broker 内部维护一个事务状态表(在内存中),记录每条半消息的事务 ID 和当前状态。Broker 重启后,通过扫描 CommitLog 重建事务状态表。
4.4 生产约束与常见陷阱
约束一:回查逻辑必须幂等
checkLocalTransaction 可能被 Broker 回调多次(网络抖动、Broker 重启等),必须保证幂等。通常做法是根据消息中的业务 ID 查询数据库获取最终状态。
约束二:回查超时与事务消息丢失
如果回查超时或达到最大次数,半消息会被丢弃。这意味着:
- 本地事务成功了,但消息没发出去 → 下游没收到通知
- 本地事务失败了,但消息也没被回滚(半消息本来就没投递)
这本质上是一种最终一致性的妥协,需要业务层通过对账补偿。
约束三:事务消息不适合高吞吐场景
事务消息的吞吐量远低于普通消息,因为每条消息都需要两阶段确认和可能的多轮回查。如果业务 QPS 很高(如每秒万级订单),事务消息会成为瓶颈。这时考虑用本地消息表 + 定时补偿的方式替代。
约束四:生产者与 Broker 的网络稳定性
事务消息强依赖生产者与 Broker 之间的网络稳定性。如果生产者在发送半消息后、提交状态前网络断开,Broker 会回查;但如果回查时生产者仍然不可达,事务消息最终会超时丢弃。
约束五:不要混用事务消息和普通消息
如果同一 Topic 下既有事务消息又有普通消息,消费端需要注意:事务消息在 COMMIT 之前对消费者不可见,不会影响普通消息的顺序。但消费端如果要区分处理,需要通过消息属性判断。
4.5 事务消息 vs 本地消息表
| 维度 | RocketMQ 事务消息 | 本地消息表 |
|---|---|---|
| 实现复杂度 | 低(SDK 内置) | 中(需要自己建表、定时扫描) |
| 消息可靠性 | 依赖回查,有超时丢弃风险 | 定时补偿,可靠性与扫描频率有关 |
| 吞吐量 | 低(两阶段+回查) | 高(普通消息发送) |
| 运维成本 | 低 | 中(需要维护扫描任务、消息表) |
| 适用场景 | 中等吞吐量、对实时性要求高 | 高吞吐量、可接受短延迟 |
五、三种消息的交叉使用
实际业务中,三种消息类型经常组合使用。一个典型的电商下单场景:
1. 用户下单 → 发送事务消息(半消息)
   ├─ 本地事务:创建订单(状态=待支付)
   └─ COMMIT → 订单创建消息投递

2. 同时发送延迟消息(delayLevel=30min)
   └─ 30分钟后检查订单状态,未支付则关单

3. 支付成功后 → 发送顺序消息(orderId 路由)
   ├─ 通知库存扣减
   ├─ 通知积分增加
   └─ 通知物流发货
这里的关键设计选择:
- 事务消息用于订单创建:保证订单记录和消息的一致性
- 延迟消息用于超时关单:不需要额外的定时任务框架
- 顺序消息用于订单后续流程:保证支付→发货的顺序性
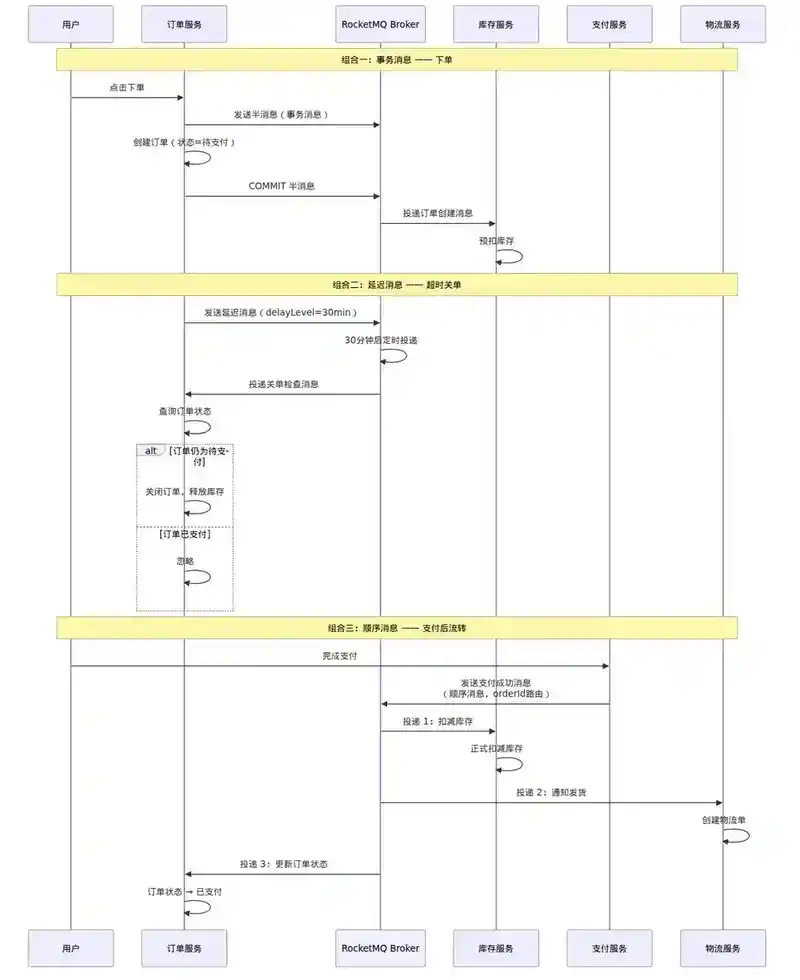
图7:电商下单场景三种消息组合使用*— 事务消息下单 → 延迟消息关单 → 顺序消息支付后流转*

图8:RocketMQ 三种特殊消息类型对比总结*— 核心机制、关键约束、适用场景、吞吐量对比*
六、总结
| 消息类型 | 核心机制 | 关键约束 | 适用场景 |
|---|---|---|---|
| 顺序消息 | 队列选择器 + Broker锁 + ProcessQueue本地锁 | 消费失败阻塞队列、吞吐量下降、仍需幂等 | 订单流转、状态机变更 |
| 延迟消息 | 延迟级别 + SCHEDULE_TOPIC + 定时扫描投递 | 精度有限、18个固定级别(开源版) | 超时关单、定时提醒 |
| 事务消息 | 半消息 + 两阶段提交 + 事务状态回查 | 回查可能超时丢弃、吞吐量低 | 订单创建、跨服务数据一致性 |
三种消息类型都在 RocketMQ 的基础消息模型之上做了扩展,理解它们的实现原理只是第一步,真正在生产中用对、用好,需要深入理解每种机制的约束条件,并在业务设计层面做好兜底。
面试官提问
以下问题从面试官视角出发,考察你对 RocketMQ 特殊消息类型的深入理解,不仅限于本文内容。
Q1:为什么 RocketMQ 不提供任意精度的延迟消息,而是用 18 个固定延迟级别?如果想要支持任意精度,你会怎么设计?
点击展开参考答案
固定延迟级别的设计原因:
- 存储结构限制:延迟消息的 QueueId = 延迟级别,ConsumeQueue 的数量是有限的。如果支持任意精度,每个延迟时间都需要一个 QueueId,ConsumeQueue 数量不可控。
- 定时扫描效率:每个延迟级别对应一个 Timer 线程,18 个级别就有 18 个 Timer。如果延迟级别是任意精度(如 1s 到 2h 任意值),Timer 数量会爆炸。
- 时间轮算法:要支持任意精度,可以用时间轮(HashedWheelTimer)替代多级别 Timer。时间轮将时间划分为多个槽,每个槽对应一个时间段,消息根据延迟时间落入对应槽中。Netty 的 HashedWheelTimer 就是典型实现,RocketMQ 商业版也采用了类似方案。
如果要设计任意精度延迟消息:
- 使用时间轮代替固定级别的 Timer
- 每个槽存储一个消息列表,定时指针推进
- 延迟时间超过时间轮一圈的消息,记录剩余圈数
- 需要考虑时间轮的持久化,防止 Broker 重启丢失
Q2:顺序消息消费时,如果某条消息处理耗时很长(比如 5 秒),会对整个队列产生什么影响?你的系统如何应对这种情况?
点击展开参考答案
影响:同一队列的后续消息全部被阻塞,因为消费是单线程串行的。如果该队列积压了 1000 条消息,每条耗时 5 秒,需要 5000 秒才能消费完。这期间如果触发 Rebalance,其他 Consumer 也无法接管这个队列(锁未释放)。
应对方案:
- 业务键拆分:不要用粗粒度的业务键。比如用
orderId而不是userId作为路由键,使热点分散。 - 异步化处理:消费线程只做轻量操作(如写入本地队列),实际处理交给后台线程池。但这会破坏严格顺序,需要业务容忍。
- 队列数扩容:增加 Topic 的写队列数量,减少每个队列的负载。
- 监控告警:对每个队列的消费延迟设置告警,及时发现阻塞。
- 降级方案:对于非关键业务,允许在积压严重时降级为并发消费。
Q3:事务消息的回查机制中,如果**checkLocalTransaction**抛异常了怎么办?Broker 会一直重试吗?
点击展开参考答案
Broker 不会区分"回查返回 UNKNOW"和"回查抛异常",两种情况都会触发重试。回查有最大次数限制(默认 15 次),超过后半消息被丢弃。
但这里有一个关键问题:如果 checkLocalTransaction 实现有 bug(比如 NPE),每次回查都抛异常,15 次重试后消息就被丢弃了,但本地事务可能已经成功。这就是"消息丢失"的典型场景。
生产建议:
checkLocalTransaction必须做好异常处理,catch 所有异常,根据业务逻辑决策返回 COMMIT 还是 ROLLBACK,不要让它抛出去- 如果无法确定状态(比如数据库挂了),返回 UNKNOW 并做好监控告警
- 设置合理的回查次数和间隔,确保在业务可容忍的时间窗口内完成确认
- 建立定时对账任务,兜底处理事务消息丢失的情况
Q4:如果要在一个 Topic 中同时支持顺序消息和普通消息,RocketMQ 能做到吗?消费端会有什么问题?
点击展开参考答案
技术上可以做到,但消费端需要分开处理。RocketMQ 的顺序消息和普通消息使用不同的 Listener:
- 普通消息:
MessageListenerConcurrently - 顺序消息:
MessageListenerOrderly
同一个 Consumer 不能同时注册两种 Listener。所以需要两个 Consumer 实例(或两个 Consumer Group),分别订阅同一个 Topic,但通过 Tag 或消息属性区分:
- 需要顺序消费的消息用特定 Tag(如
orderly) - 普通消息用另一个 Tag(如
normal)
但这样做的问题是:两个 Consumer 独立消费,不保证顺序消息和普通消息之间的时序关系。如果业务需要"同一订单的普通消息和顺序消息之间有顺序",那应该把所有消息都走顺序消费通道。
更好的做法是:不要混用。如果 Topic 内有顺序需求,全部走顺序消费;如果只是部分消息需要顺序,用不同的 Topic 隔离。
Q5:延迟消息的 ScheduleMessageService 定时扫描时,如果 Broker 重启了,扫描进度会丢失吗?
点击展开参考答案
不会丢失。延迟消息的"进度"信息存储在 CommitLog 和 ConsumeQueue 中,不是内存状态。
Broker 重启后,ScheduleMessageService 重新初始化,为每个延迟级别创建 Timer,重新扫描对应 QueueId 的 ConsumeQueue。每条消息的存储时间打在 CommitLog 中,扫描时判断 存储时间 + 延迟时间 ≤ 当前时间 来决定是否投递。
但有一个细节:如果 Broker 重启期间,某些消息的延迟时间已经过了,重启后这些消息会被立即投递(因为它们的时间条件已经满足)。这可能导致下游收到一波"过期的延迟消息"的集中冲击。因此,消费端需要对延迟消息的时效性做判断——如果消息的延迟时间 + 允许的误差范围已经超过当前时间过多,可以选择丢弃或告警。
本文是"Java 技术专家 / 架构师面试:250 个高频考点"系列的第 154 篇。