阅读时间:约 45 分钟 | 难度:中高级 | 编号:120
一、引言:隔离级别是"性能"与"一致性"的权衡
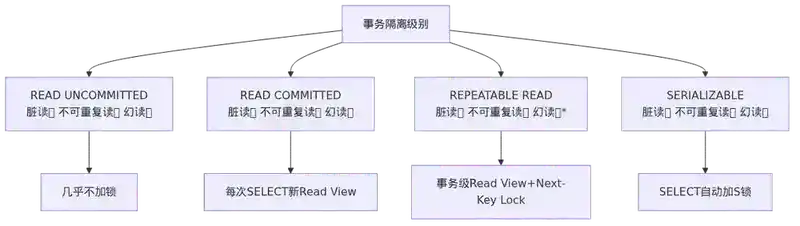
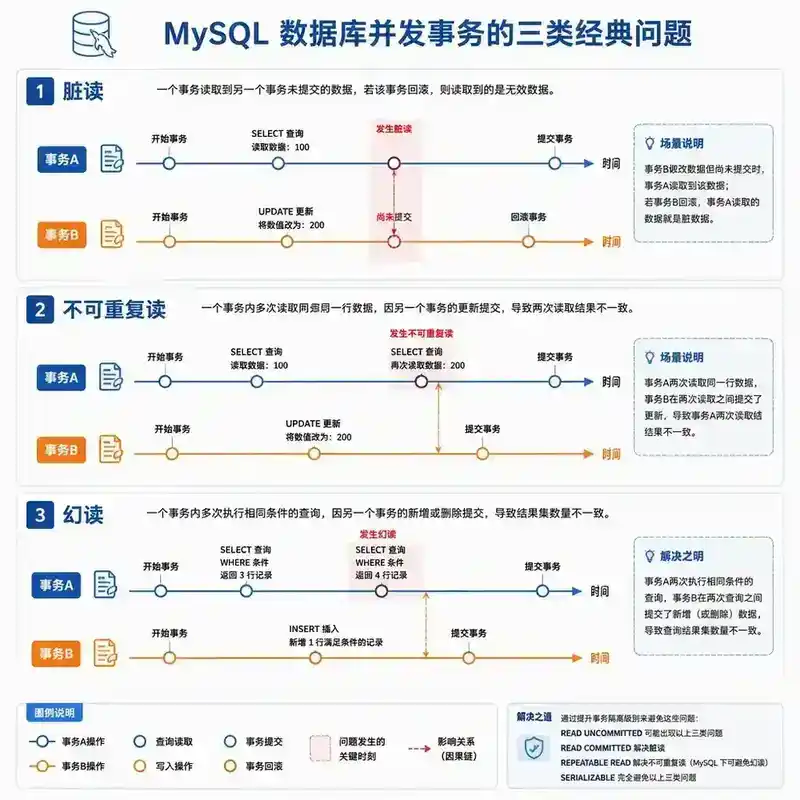
并发事务同时读写同一数据时,会产生三类经典问题:脏读、不可重复读、幻读。隔离级别定义了事务之间相互隔离的程度——隔离越强,并发性能越低;隔离越弱,数据一致性风险越高。
理解隔离级别,就是理解"你的数据库在并发场景下可能出什么问题,以及你能接受什么代价"。
二、三类并发问题
2.1 脏读(Dirty Read)
定义: 事务 A 读取到了事务 B 尚未提交的数据。
时间线:
T1: 事务 A 开始
T2: 事务 B 开始,UPDATE balance = 200 WHERE id = 1
T3: 事务 A 读取 balance = 200(事务 B 未提交!)
T4: 事务 B ROLLBACK,balance 恢复为 100
T5: 事务 A 基于 balance=200 做了错误决策
脏读的危害: 读取到"从未存在过"的数据,基于错误数据做决策。
2.2 不可重复读(Non-Repeatable Read)
定义: 事务 A 内两次读取同一行数据,结果不同(事务 B 修改并提交了)。
时间线:
T1: 事务 A 开始,读取 balance = 100
T2: 事务 B 开始,UPDATE balance = 200 WHERE id = 1,COMMIT
T3: 事务 A 再次读取 balance = 200(同一行,值变了!)
不可重复读的危害: 事务内数据不一致,前后读取矛盾。
2.3 幻读(Phantom Read)
定义: 事务 A 内两次查询同一范围,返回的行数不同(事务 B 插入了新行)。
时间线:
T1: 事务 A 开始,SELECT COUNT(*) FROM t WHERE age > 18 → 100 行
T2: 事务 B 开始,INSERT INTO t VALUES (..., age=20),COMMIT
T3: 事务 A 再次 SELECT COUNT(*) → 101 行(多了一行!)
三、四种隔离级别
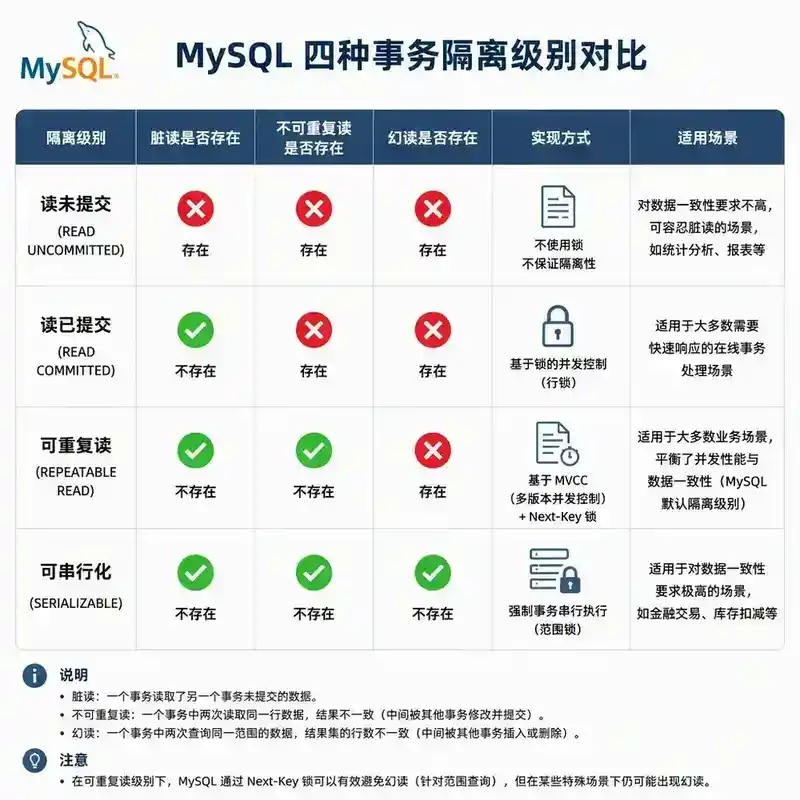
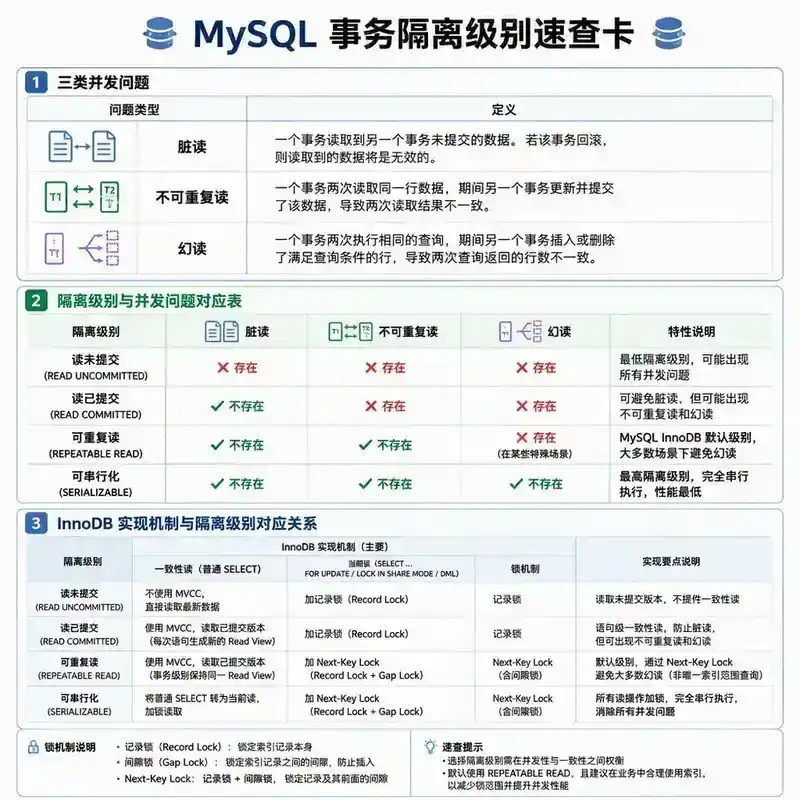
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 性能 |
|---|---|---|---|---|
| READ UNCOMMITTED | ✅ | ✅ | ✅ | 最高 |
| READ COMMITTED | ❌ | ✅ | ✅ | 高 |
| REPEATABLE READ(默认) | ❌ | ❌ | ❌* | 中 |
| SERIALIZABLE | ❌ | ❌ | ❌ | 最低 |
- InnoDB 通过 Next-Key Lock 解决了幻读。
3.1 READ UNCOMMITTED(读未提交)
最低隔离级别,几乎不加锁。事务可以读取其他事务未提交的数据。
实现: 不加锁,直接读取最新版本(即使未提交)。
使用场景: 几乎不用于生产,仅用于对一致性要求极低的场景(如日志统计)。
3.2 READ COMMITTED(读已提交)
每次读取都创建新的 Read View,只读取已提交的数据。
实现: 每次 SELECT 都获取最新快照。UPDATE/DELETE 使用记录锁。
解决了脏读,但不可重复读和幻读仍存在。
使用场景: Oracle 默认级别。适合对一致性要求不高但需要避免脏读的场景。
3.3 REPEATABLE READ(可重复读)
InnoDB 默认级别。事务内所有 SELECT 使用同一个 Read View。
实现: 事务开始时创建 Read View,整个事务期间使用同一个快照。UPDATE/DELETE 使用 Next-Key Lock(记录锁 + 间隙锁)防止幻读。
InnoDB 通过 Next-Key Lock 解决了幻读,但标准 SQL 的 REPEATABLE READ 不能完全解决幻读。
3.4 SERIALIZABLE(串行化)
最高隔离级别,事务串行执行。
实现: 所有 SELECT 自动转为 SELECT ... LOCK IN SHARE MODE。事务完全串行,并发度最低。
四、InnoDB 如何实现各隔离级别
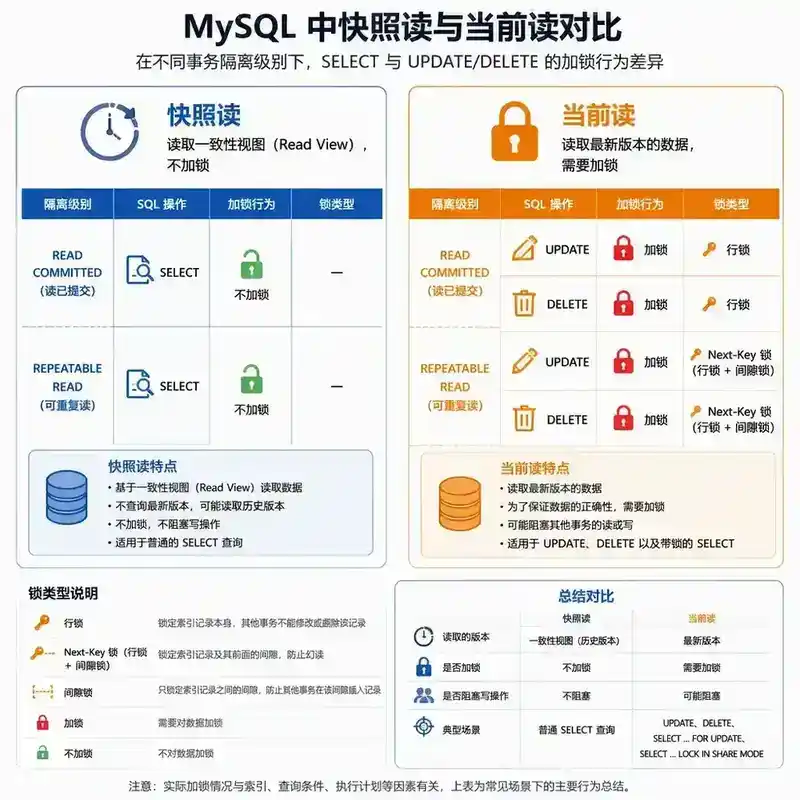
4.1 快照读 vs 当前读
| 隔离级别 | 快照读(SELECT) | 当前读(UPDATE/DELETE/SELECT...FOR UPDATE) |
|---|---|---|
| READ UNCOMMITTED | 读最新版本 | 不加锁 |
| READ COMMITTED | 每次重新创建 Read View | 记录锁 |
| REPEATABLE READ | 事务开始时的 Read View | Next-Key Lock |
| SERIALIZABLE | 自动加 S 锁 | 同 REPEATABLE READ |
4.2 Read View 的创建时机
-- REPEATABLE READ:事务中第一个 SELECT 时创建 Read View
START TRANSACTION;
SELECT * FROM t WHERE id = 1;  -- 创建 Read View
-- 后续所有 SELECT 使用同一个 Read View

-- READ COMMITTED:每个 SELECT 都创建新的 Read View
START TRANSACTION;
SELECT * FROM t WHERE id = 1;  -- 创建 Read View #1
SELECT * FROM t WHERE id = 1;  -- 创建 Read View #2
五、MVCC 在隔离级别中的应用
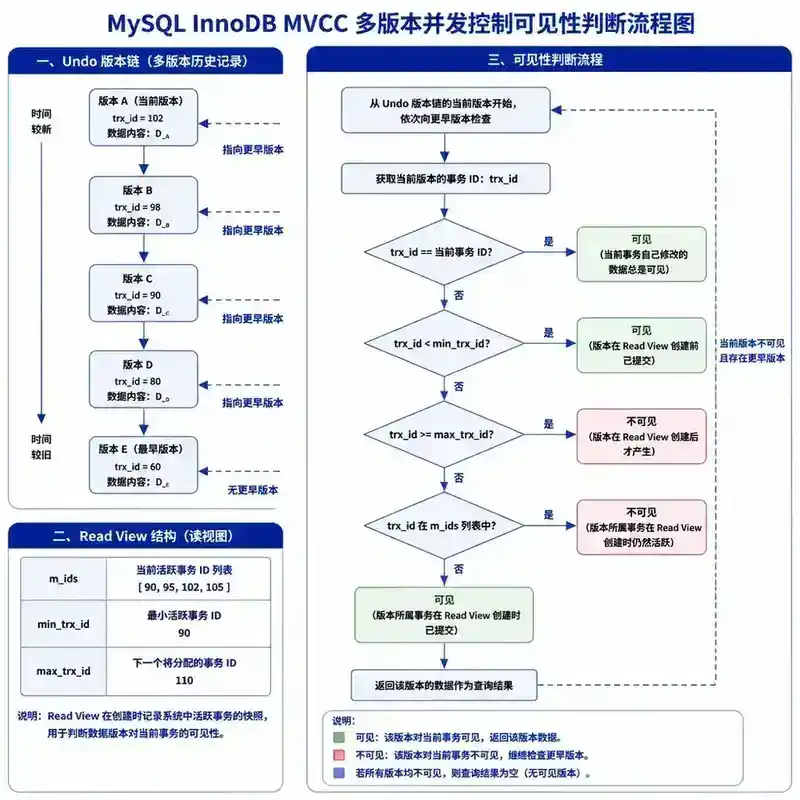
5.1 MVCC 可见性判断
Read View 包含三个关键值:
m_ids:当前活跃事务 ID 列表min_trx_id:最小活跃事务 IDmax_trx_id:下一个待分配的事务 ID
可见性规则:
- 如果行版本的事务 ID < min_trx_id → 可见(已提交)
- 如果行版本的事务 ID ≥ max_trx_id → 不可见(未来的事务)
- 如果行版本的事务 ID 在 m_ids 中 → 不可见(活跃事务未提交)
- 否则 → 可见(已提交)
5.2 Undo 版本链
行数据 → undo log (版本 3) → undo log (版本 2) → undo log (版本 1)
  ↑ 当前版本                    ↑ 历史版本
  DB_TRX_ID=103               DB_TRX_ID=101
                              通过 DB_ROLL_PTR 链接
读取历史版本的代价: 如果 undo 版本链很长,需要遍历多个版本才能找到可见版本,性能下降。
六、Next-Key Lock:InnoDB 解决幻读的武器
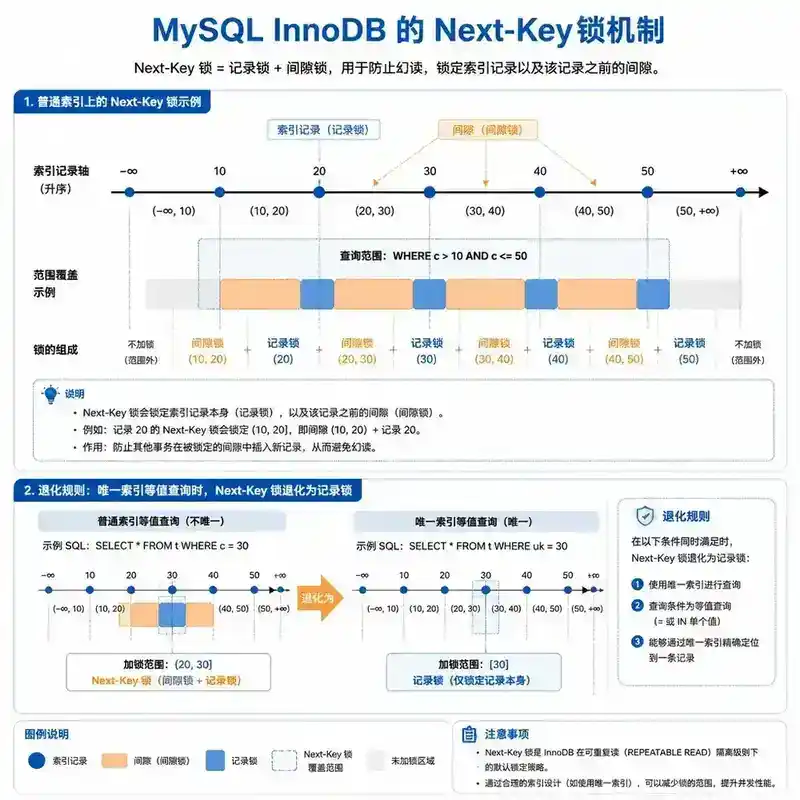
6.1 Next-Key Lock 的组成
Next-Key Lock = 记录锁(Record Lock)+ 间隙锁(Gap Lock)

索引记录: 5, 10, 15, 20, 25

SELECT * FROM t WHERE id = 10 FOR UPDATE;
→ 记录锁: id=10
→ 间隙锁: (5, 10), (10, 15)

SELECT * FROM t WHERE id BETWEEN 10 AND 20 FOR UPDATE;
→ 记录锁: id=10, 15, 20
→ 间隙锁: (5, 10), (10, 15), (15, 20), (20, 25)
6.2 间隙锁的退化
| 条件 | 锁类型 |
|---|---|
| 唯一索引等值查询,记录存在 | 退化为记录锁 |
| 唯一索引等值查询,记录不存在 | 间隙锁 |
| 非唯一索引等值查询 | Next-Key Lock |
| 范围查询(无等值) | Next-Key Lock |
七、隔离级别的实战选择
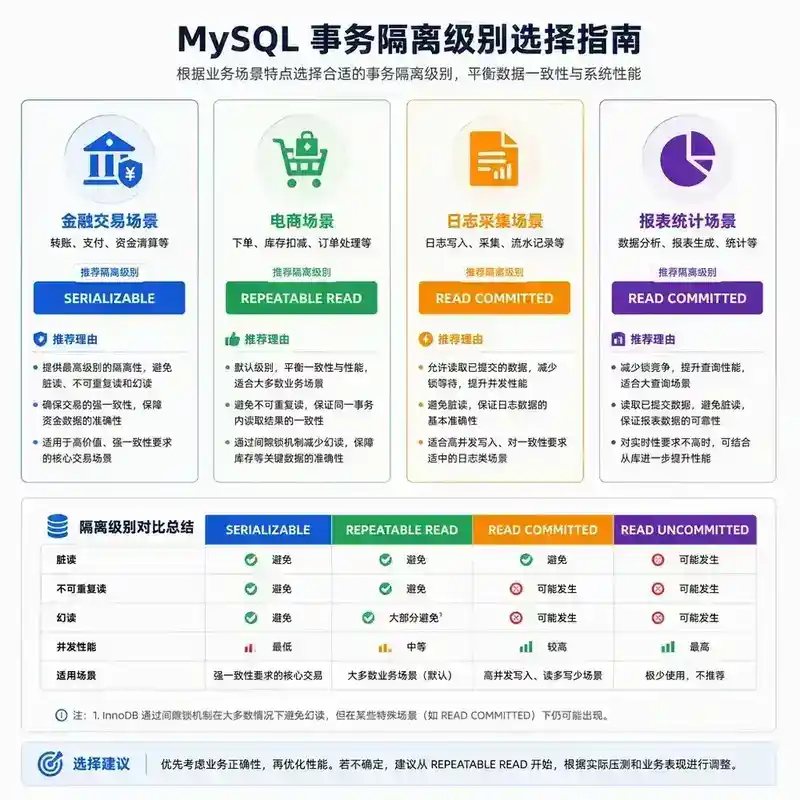
7.1 选择指南
| 场景 | 推荐级别 | 理由 |
|---|---|---|
| 金融交易 | SERIALIZABLE | 绝对一致性 |
| 电商订单 | REPEATABLE READ | 防止幻读(库存扣减) |
| 用户行为日志 | READ COMMITTED | 允许不可重复读,性能优先 |
| 报表统计 | READ COMMITTED | 每次读取最新数据 |
7.2 隔离级别切换
-- 查看当前级别
SELECT @@transaction_isolation;

-- 设置全局级别
SET GLOBAL transaction_isolation = 'READ-COMMITTED';

-- 设置会话级别
SET SESSION transaction_isolation = 'REPEATABLE-READ';
八、总结
| 问题 | 根因 | 解决方式 |
|---|---|---|
| 脏读 | 读取未提交数据 | READ COMMITTED 以上 |
| 不可重复读 | 同一行被修改 | REPEATABLE READ + MVCC |
| 幻读 | 范围内插入新行 | Next-Key Lock |
隔离级别越高,一致性越强,并发性能越低。选择隔离级别就是选择"你愿意为一致性付出多少性能代价"。
九、面试官视角提问
Q1:MySQL 的 REPEATABLE READ 解决了幻读,但 PostgreSQL 的 REPEATABLE READ 没有解决幻读。为什么会有这种差异?InnoDB 是如何做到解决幻读的?
Q2:**SELECT * FROM t WHERE id = 10 FOR UPDATE** 在唯一索引和普通索引下,加锁范围有什么不同?为什么?
Q3:**START TRANSACTION** 后执行 **SELECT**,然后另一个事务 UPDATE 并提交。在 REPEATABLE READ 和 READ COMMITTED 下,再次 SELECT 的结果分别是什么?
Q4:为什么 MySQL 的默认隔离级别是 REPEATABLE READ,而 Oracle 的默认是 READ COMMITTED?这和主从复制有什么关系?
Q5:一个事务执行 **SELECT * FROM t WHERE id > 5 FOR UPDATE**,另一个事务执行 **INSERT INTO t VALUES (3, ...)**。这个 INSERT 会被阻塞吗?为什么?
Q6:REPEATABLE READ 下,长时间运行的事务会导致什么问题?从 MVCC 和 undo log 的角度分析。
作者注:本文为系列第 120 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:MySQL 的 REPEATABLE READ 解决了幻读,但 PostgreSQL 的没有。为什么?
参考答案:
InnoDB 通过 Next-Key Lock(记录锁 + 间隙锁)解决了幻读。
当 SELECT ... FOR UPDATE 时,InnoDB 不仅锁住满足条件的行,还锁住行之间的间隙,防止其他事务在这些间隙中插入新行。
PostgreSQL 的 REPEATABLE READ: 使用 SI(Snapshot Isolation),不阻塞 INSERT。第一个提交的事务胜出,另一个事务提交时检测到冲突会回滚。这是"检测冲突"而非"阻止冲突"。
差异根源: InnoDB 使用锁来阻止幻读,PostgreSQL 使用冲突检测来回滚幻读。
Q2:,唯一索引 vs 普通索引,加锁范围有何不同?
参考答案:
唯一索引等值查询,记录存在: 退化为记录锁,只锁 id=10 这一行。因为唯一索引保证不会有重复值,不需要间隙锁。
普通索引等值查询: Next-Key Lock,锁住 (上一个值, 10] 和 (10, 下一个值)。因为普通索引允许重复,需要防止其他事务插入相同的值。
如果记录不存在(唯一索引): 使用间隙锁,锁住 (上一个值, 下一个值)。防止其他事务插入这个值。
Q3: → → 另一个事务 UPDATE 并 COMMIT → 再次 ,结果分别是什么?
参考答案:
REPEATABLE READ: 两次 SELECT 结果相同。事务第一个 SELECT 时创建 Read View,后续 SELECT 使用同一个快照,看不到其他事务的提交。
READ COMMITTED: 两次 SELECT 结果不同。每次 SELECT 都创建新的 Read View,第二次 SELECT 能看到已提交的 UPDATE。
这就是"不可重复读"的直接体现。
Q4:为什么 MySQL 默认 REPEATABLE READ,Oracle 默认 READ COMMITTED?
参考答案:
历史原因: MySQL 的 binlog 在 STATEMENT 格式下,REPEATABLE READ 才能保证主从数据一致。READ COMMITTED 下,STATEMENT 格式的 binlog 可能导致主从不一致。
MySQL 5.7+ 默认 binlog_format=ROW: 在 ROW 格式下,READ COMMITTED 也可以安全使用。但 MySQL 保持了 REPEATABLE READ 作为默认值以兼容历史。
Oracle 选择 READ COMMITTED: Oracle 的 MVCC 实现更高效(使用 UNDO 表空间),READ COMMITTED 能提供更好的并发性能。
Q5:,另一个事务 会被阻塞吗?
参考答案:
不会被阻塞。
WHERE id>5 FOR UPDATE 的锁范围是 id>5 的所有行 + 间隙锁 (5, 最大值]。id=3 在 5 的左边,不在锁范围内。
如果主键索引是 B+Tree,数据排序为 1,3,5,7,9:
- 锁住的记录:7, 9
- 锁住的间隙:(5, 7), (7, 9), (9, +∞]
- 插入 id=3:锁范围为 (1, 3),不在以上范围,不阻塞
Q6:REPEATABLE READ 下长事务会导致什么问题?
参考答案:
1. undo log 膨胀: 长事务的 Read View 阻止 purge 线程清理旧版本 undo log。其他事务修改的数据,旧版本一直保留,undo 表空间持续增长。
2. 锁长时间持有: 长事务持有的行锁、间隙锁一直不释放,阻塞其他事务。
3. 主从延迟: 长事务提交时才写 binlog,从库需要回放整个长事务,延迟增大。
排查:
SELECT trx_id, trx_started, TIMESTAMPDIFF(SECOND, trx_started, NOW()) AS seconds
FROM information_schema.innodb_trx
ORDER BY trx_started;
全文完 | 编号 120 | 分类 08 MySQL 与关系型数据库