阅读时间:约 45 分钟 | 难度:中高级 | 编号:130
一、引言:不是"谁更好",而是"谁更适合"
关系型数据库(MySQL/PostgreSQL)和 NoSQL(Redis/MongoDB/ES/HBase)不是替代关系,而是互补关系。选型的核心不是"哪个更好",而是"当前场景下哪个更合适"。
本文从四个维度——一致性、查询能力、扩展性、运维成本——系统对比关系型与 NoSQL 数据库,并给出可操作的选型决策框架。
二、关系型数据库的核心优势
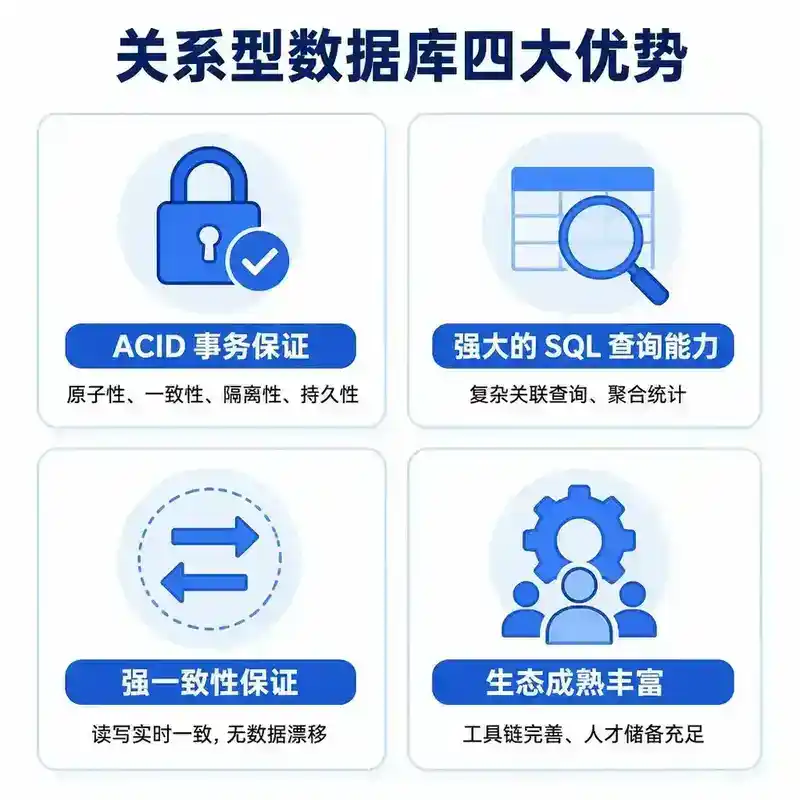
2.1 ACID 事务
关系型数据库最核心的优势是 ACID 事务。这是 NoSQL 数据库普遍不具备或弱化支持的能力。
转账场景:A 账户扣款 + B 账户加款,必须同时成功或同时失败
关系型:BEGIN → UPDATE A → UPDATE B → COMMIT(原子性保证)
NoSQL:通常需要应用层实现两阶段提交或补偿事务
2.2 SQL 查询能力
SQL 提供了强大的声明式查询能力:JOIN、子查询、窗口函数、CTE、聚合、GROUP BY、HAVING。这些在 NoSQL 中要么不支持,要么需要应用层实现。
2.3 数据一致性强
关系型数据库提供强一致性:写入后立即可以读取到最新数据。NoSQL 通常是最终一致性。
2.4 生态成熟
ORM 框架、监控工具、运维工具、DBA 人才储备——关系型数据库的生态远成熟于 NoSQL。
三、NoSQL 的核心优势
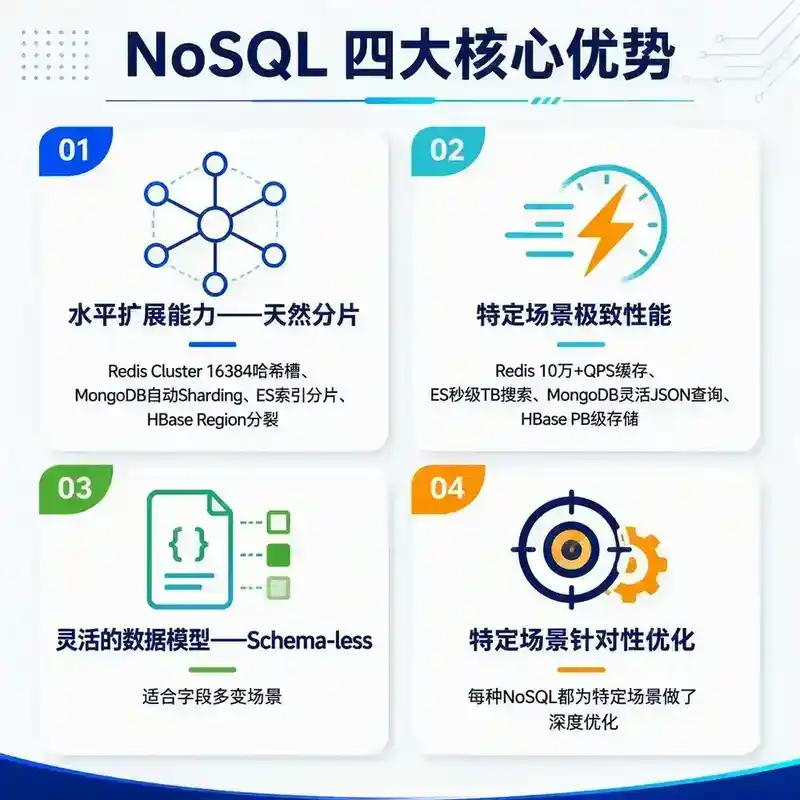
3.1 水平扩展能力
关系型数据库的扩展以"垂直扩展"(升级硬件)为主,分库分表复杂度高。NoSQL 天然支持水平扩展:
- Redis Cluster:16384 个哈希槽,自动分片
- MongoDB:自动 Sharding,基于 Shard Key 分片
- ES:索引分片,自动分布
- HBase:Region 自动分裂,基于 HDFS
3.2 特定场景的极致性能
| 数据库 | 场景 | 性能 |
|---|---|---|
| Redis | 缓存/计数器/排行榜 | 10万+ QPS |
| ES | 全文搜索/日志分析 | 秒级 TB 数据搜索 |
| MongoDB | 文档存储/JSON 查询 | 灵活 Schema |
| HBase | 海量稀疏数据 | PB 级存储 |
3.3 灵活的数据模型
NoSQL 的数据模型更灵活,特别适合 Schema 多变的场景。
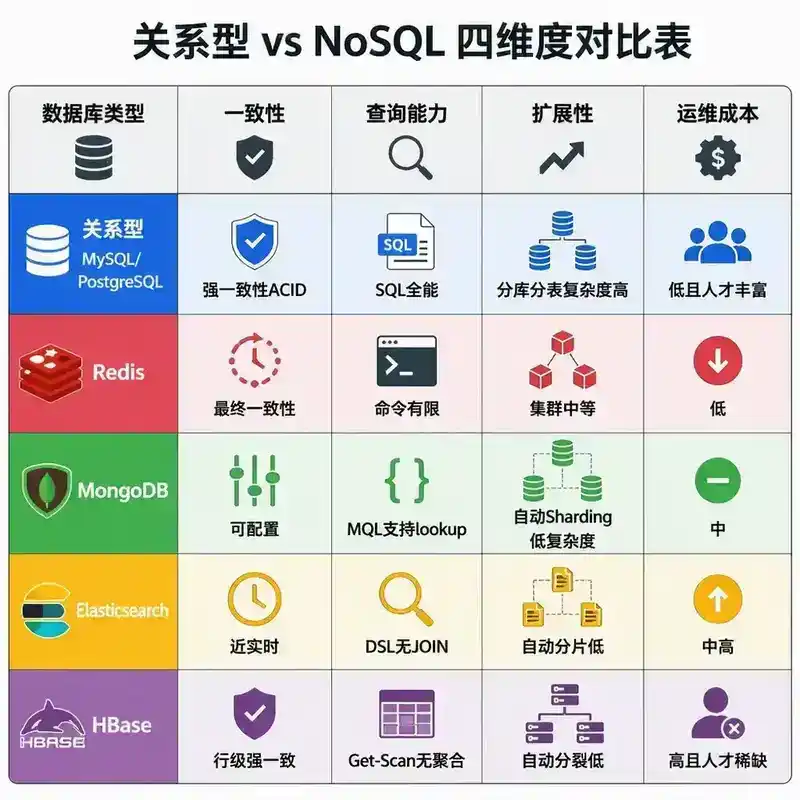
四、四维度对比
4.1 一致性
| 类型 | 一致性模型 | 典型数据库 |
|---|---|---|
| 关系型 | 强一致性(ACID) | MySQL, PostgreSQL |
| Redis | 最终一致性(Cluster) | Redis Cluster |
| MongoDB | 可配置(Write Concern) | MongoDB |
| ES | 近实时(1秒延迟) | Elasticsearch |
| HBase | 强一致性(行级) | HBase |
4.2 查询能力
| 类型 | 查询方式 | JOIN | 聚合 |
|---|---|---|---|
| 关系型 | SQL | ✅ | ✅ |
| Redis | 命令 | ❌ | 有限 |
| MongoDB | MQL | $lookup | ✅ |
| ES | DSL | ❌ | ✅ |
| HBase | Get/Scan | ❌ | ❌ |
4.3 扩展性
| 类型 | 扩展方式 | 复杂度 |
|---|---|---|
| 关系型 | 分库分表 | 高 |
| Redis | 集群 | 中 |
| MongoDB | 自动 Sharding | 低 |
| ES | 自动分片 | 低 |
| HBase | 自动分裂 | 低 |
4.4 运维成本
| 类型 | 运维复杂度 | 人才储备 |
|---|---|---|
| 关系型 | 低 | 丰富 |
| Redis | 低 | 丰富 |
| MongoDB | 中 | 中等 |
| ES | 中-高 | 中等 |
| HBase | 高 | 稀缺 |
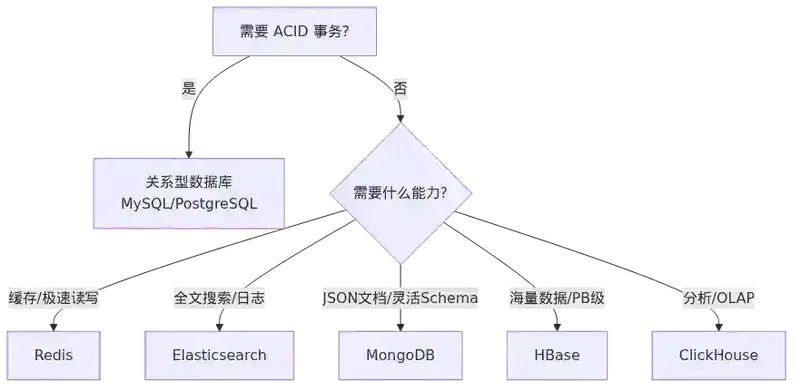
五、选型决策框架
5.1 决策流程
需要 ACID 事务?
├── 是 → 关系型数据库
└── 否 → 需要什么能力?
    ├── 缓存/极速读写 → Redis
    ├── 全文搜索 → ES
    ├── 文档存储/JSON → MongoDB
    ├── 海量数据存储 → HBase
    └── 分析/OLAP → ClickHouse
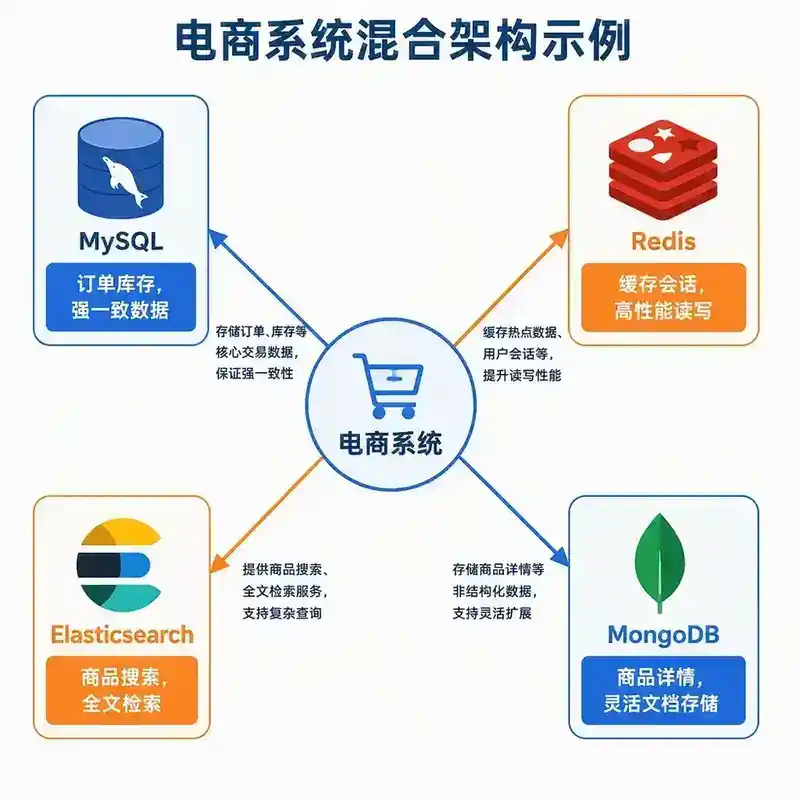
5.2 混合架构
现代系统通常不是单选,而是多数据库混合使用:
电商系统:
├── MySQL:订单、用户、库存(核心事务)
├── Redis:缓存、Session、计数器
├── ES:商品搜索、日志分析
└── MongoDB:商品详情(JSON 文档)
六、常见 NoSQL 详解
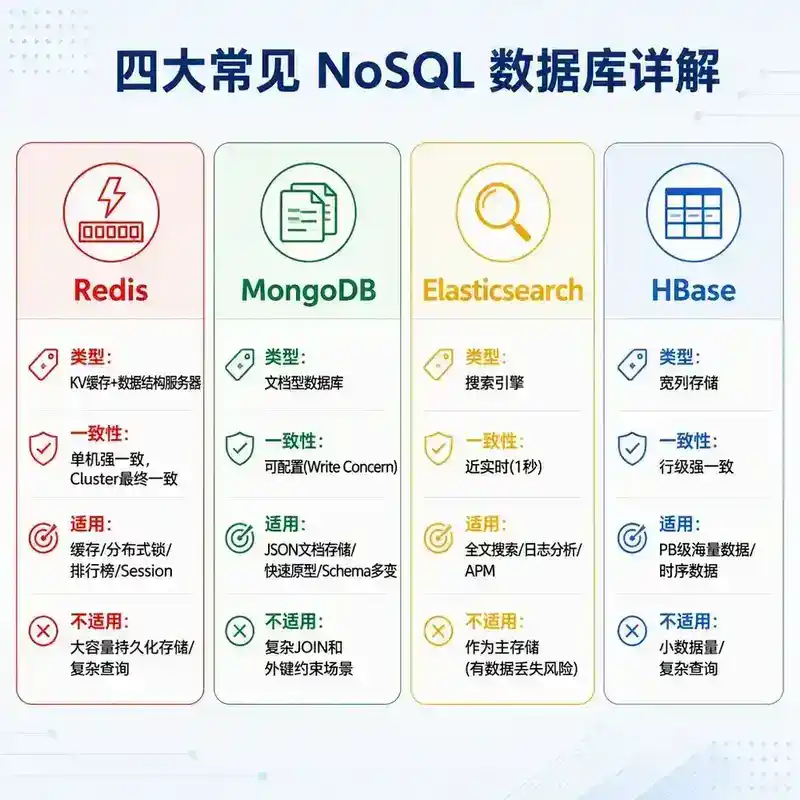
6.1 Redis
- 类型: KV 缓存 + 数据结构服务器
- 一致性: 单机强一致,Cluster 最终一致
- 适用: 缓存、分布式锁、排行榜、Session
- 不适用: 大容量持久化存储、复杂查询
6.2 MongoDB
- 类型: 文档型数据库
- 一致性: 可配置(Write Concern)
- 适用: JSON 文档存储、快速原型、Schema 多变
- 不适用: 需要复杂 JOIN 和外键约束的场景
6.3 Elasticsearch
- 类型: 搜索引擎
- 一致性: 近实时(1 秒)
- 适用: 全文搜索、日志分析、APM
- 不适用: 作为主存储(有数据丢失风险)
6.4 HBase
- 类型: 宽列存储
- 一致性: 行级强一致
- 适用: PB 级海量数据、时序数据
- 不适用: 小数据量、复杂查询
七、实战案例
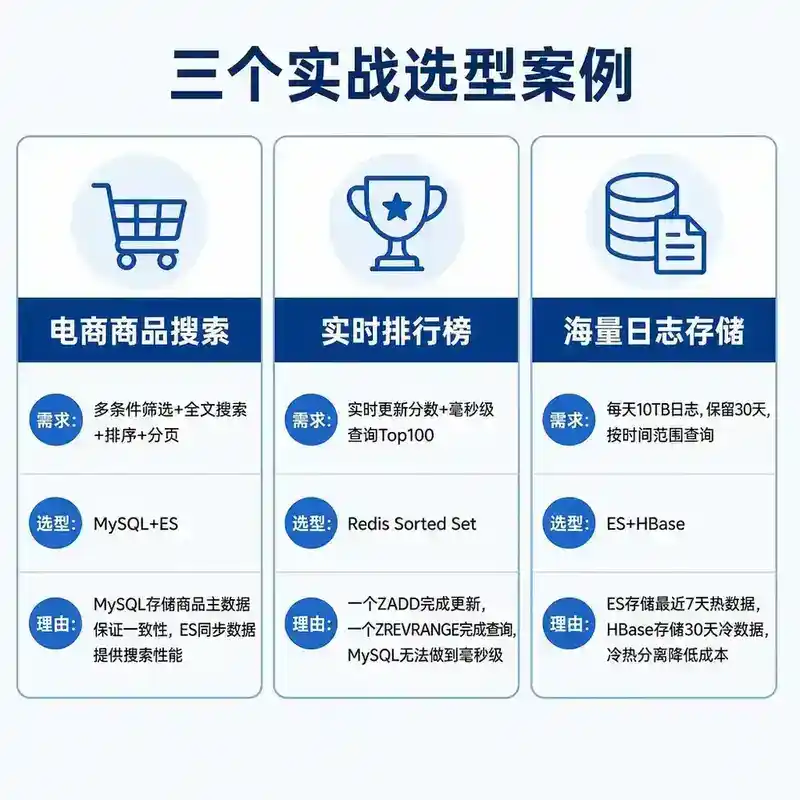
案例一:电商商品搜索
需求: 多条件筛选 + 全文搜索 + 排序 + 分页
选型:MySQL + ES。 MySQL 存储商品主数据,ES 同步商品数据提供搜索。MySQL 保证数据一致性,ES 提供搜索性能。
案例二:实时排行榜
需求: 实时更新分数,毫秒级查询 Top 100
选型:Redis Sorted Set。 一个 ZADD 完成更新,一个 ZREVRANGE 完成查询。MySQL 无法做到毫秒级。
案例三:海量日志存储
需求: 每天 10TB 日志,保留 30 天,支持按时间范围查询
选型:ES + HBase。 ES 存储最近 7 天(热数据),HBase 存储 30 天(冷数据)。
八、总结
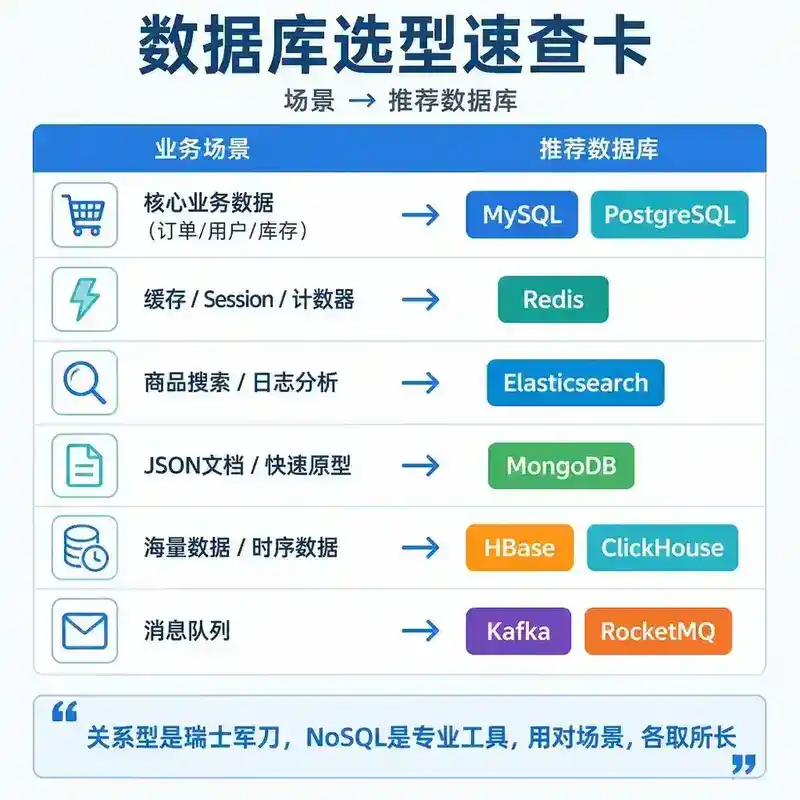
| 场景 | 推荐 |
|---|---|
| 核心业务数据(订单/用户/库存) | MySQL/PostgreSQL |
| 缓存/Session/计数器 | Redis |
| 商品搜索/日志分析 | Elasticsearch |
| JSON 文档/快速原型 | MongoDB |
| 海量数据/时序数据 | HBase/ClickHouse |
| 消息队列 | Kafka/RocketMQ |
一句话: 关系型是"瑞士军刀",NoSQL 是"专业工具"。用对场景,各取所长。
九、面试官视角提问
Q1:你说"MySQL + Redis"是最常见的组合。在什么场景下,Redis 的数据可能和 MySQL 不一致?你怎么解决?
Q2:MongoDB 支持事务了(4.0+),能否替代 MySQL 作为核心业务数据库?为什么?
Q3:ES 的"近实时"是什么意思?为什么 ES 的写入不是立即可见的?这个延迟对业务有什么影响?
Q4:一个系统使用了 MySQL + Redis + ES + MongoDB,数据一致性如何保证?如果 MySQL 写入成功但 ES 同步失败,怎么办?
Q5:HBase 的 RowKey 设计对性能影响巨大。如果 RowKey 设计不当,会导致什么问题?如何设计一个好的 RowKey?
Q6:如果让你从零设计一个支持 1000 万 QPS 的 KV 存储,你会怎么设计?参考 Redis 的哪些设计?改进哪些?
作者注:本文为系列第 130 篇,属于「08 MySQL 与关系型数据库」分类的最后一篇。下一篇将进入「09 Redis 与缓存体系」分类。