阅读时间:约 45 分钟 | 难度:中高级 | 编号:127
一、引言:单表瓶颈的终极解决方案
当单表数据量达到千万级、QPS 达到万级时,索引优化、SQL 改写、缓存等手段已经无法解决根本问题。分库分表是解决海量数据和高并发访问的终极方案。
分库分表的核心: 将数据分散到多个数据库和表中,每个节点只存储部分数据,通过路由规则定位数据所在的节点。
二、拆分维度
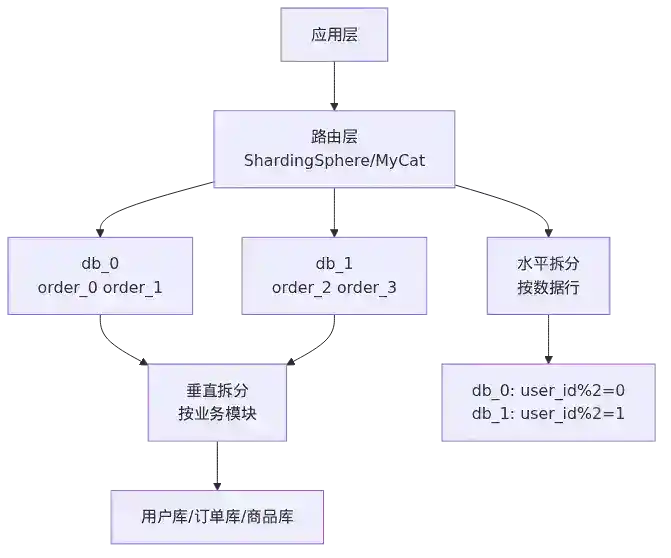
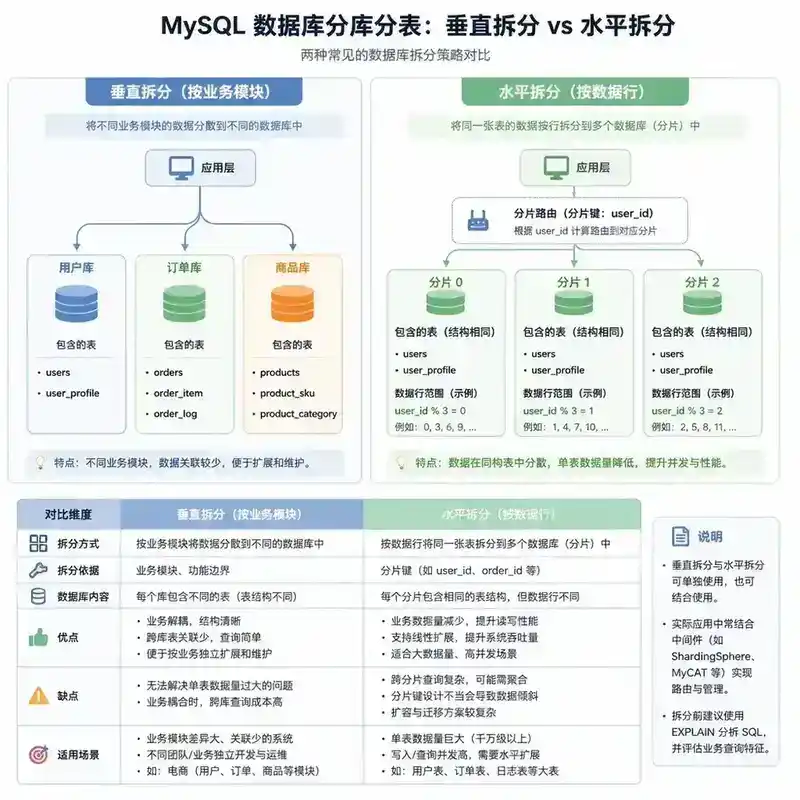
2.1 垂直拆分
垂直分库: 按业务模块拆分数据库。
电商系统:
├── 用户库 (user_db)
├── 订单库 (order_db)
├── 商品库 (product_db)
└── 支付库 (payment_db)
垂直分表: 将大表的列拆分到多个表中。
用户表:
├── user_base (id, name, phone, email)  ← 常用字段
└── user_detail (id, avatar, bio, preferences)  ← 不常用字段
2.2 水平拆分
水平分库: 按某种规则将数据分散到多个数据库中。
order_db_0  ← user_id % 2 = 0 的订单
order_db_1  ← user_id % 2 = 1 的订单
水平分表: 在同一个数据库中按规则拆分表。
order_0  ← user_id % 4 = 0
order_1  ← user_id % 4 = 1
order_2  ← user_id % 4 = 2
order_3  ← user_id % 4 = 3
三、分片算法
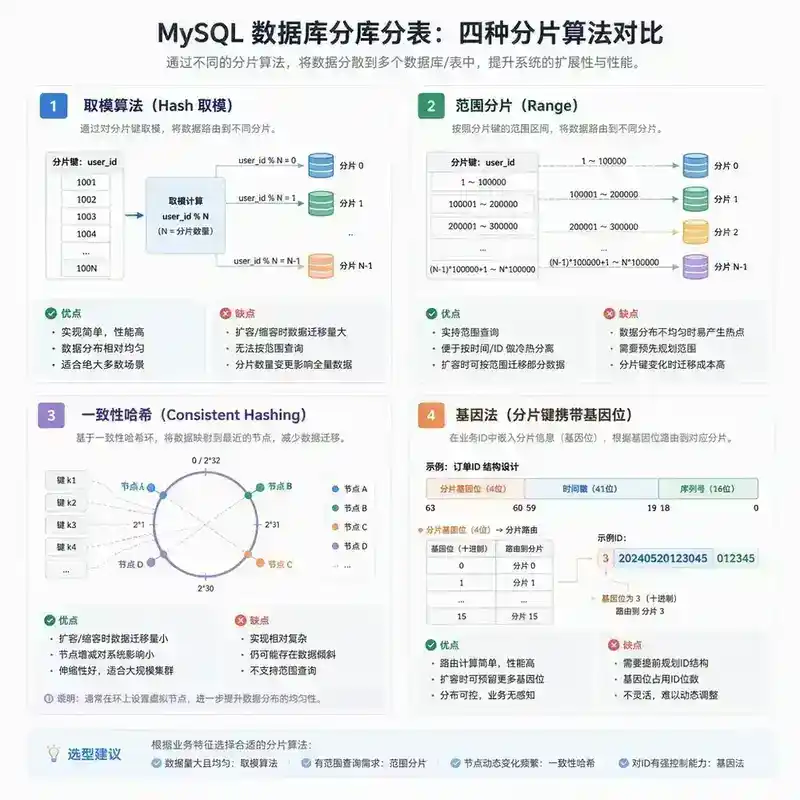
3.1 取模分片
// 按 user_id 取模
int shard = userId % shardCount;
优点: 简单,分布均匀。缺点: 扩容时需要迁移大量数据。
3.2 范围分片
// 按 user_id 范围
if (userId < 1000000) shard = 0;
else if (userId < 2000000) shard = 1;
优点: 扩容简单。缺点: 数据分布不均匀,新库热点。
3.3 一致性哈希
哈希环: 0 → 2^32-1
节点: hash(node1) → 位置 A, hash(node2) → 位置 B
数据: hash(userId) → 顺时针找到最近的节点
优点: 扩容时迁移数据量小。缺点: 实现复杂。
3.4 基因法
// 从 user_id 中提取分片信息
// order_id = 时间戳 + 分片基因(user_id % 64) + 序列号
long orderId = (timestamp << 16) | (userId % 64 << 6) | sequence;
优点: 从 order_id 中可以直接提取分片信息,不需要额外查询。
四、路由策略
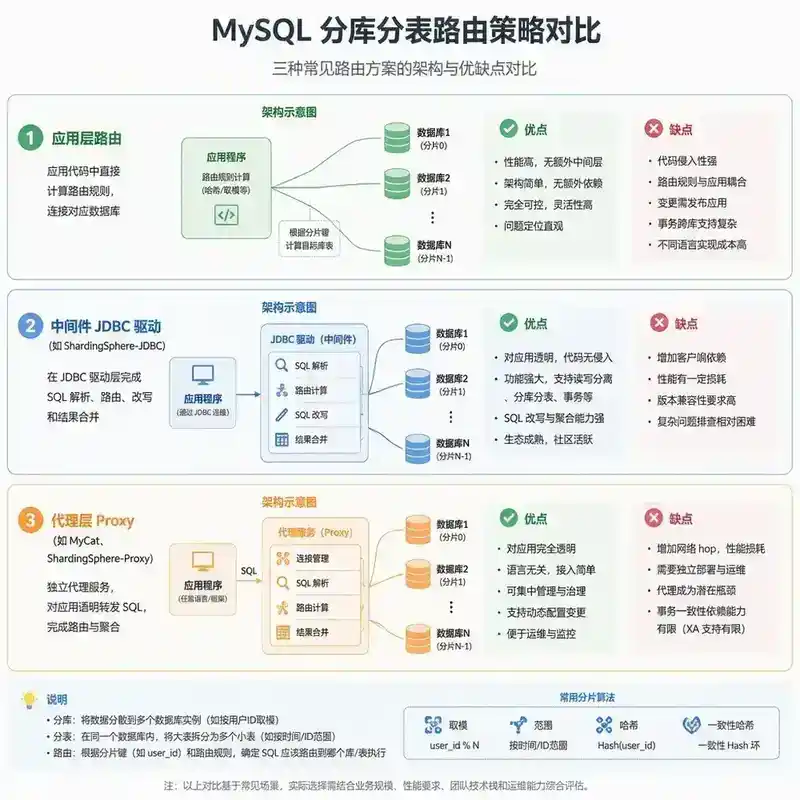
4.1 应用层路由
// 应用代码中直接计算分片
public Order getOrder(Long orderId) {
    int shard = orderId % 4;
    DataSource ds = dataSourceMap.get(shard);
    return orderMapper.selectById(ds, orderId);
}
4.2 中间件路由
使用 ShardingSphere、MyCat 等中间件,配置分片规则后自动路由。
# ShardingSphere 配置示例
sharding:
  tables:
    order:
      actualDataNodes: ds${0..1}.order_${0..3}
      databaseStrategy:
        inline:
          shardingColumn: user_id
          algorithmExpression: ds${user_id % 2}
      tableStrategy:
        inline:
          shardingColumn: user_id
          algorithmExpression: order_${user_id % 4}
4.3 代理层路由
使用 ShardingSphere-Proxy 或 MyCat 作为独立代理层,应用连接代理即可。
五、扩容策略
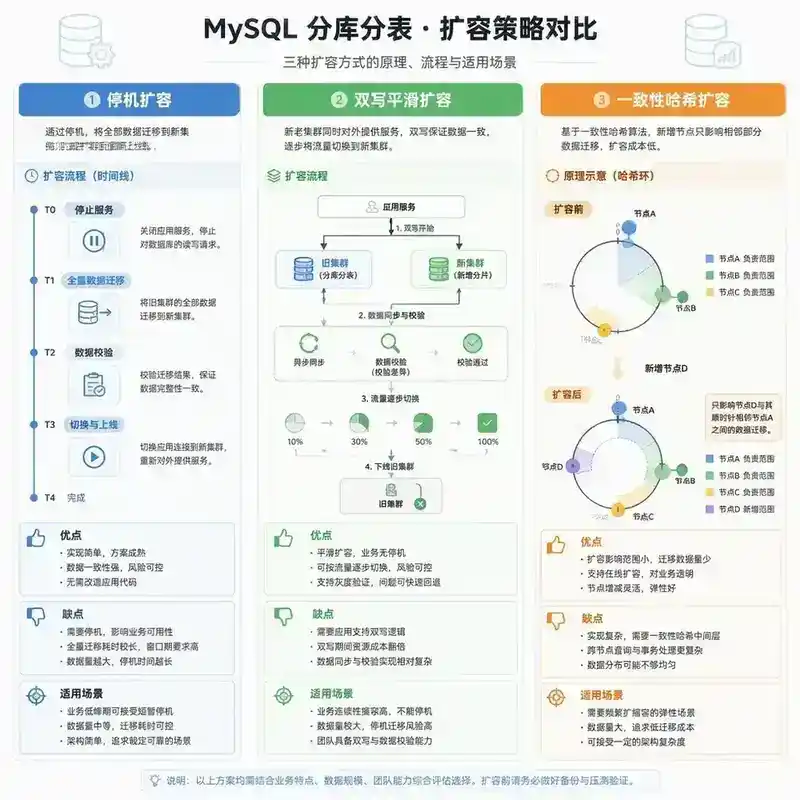
5.1 停机扩容
- 停止服务
- 重新分配数据
- 恢复服务
优点: 简单可靠。缺点: 需要停机。
5.2 平滑扩容
双写策略:
- 新数据同时写入旧库和新库
- 后台迁移历史数据到新库
- 数据一致后切换到新库
- 停止双写
一致性哈希扩容: 添加新节点时,只迁移相邻节点的部分数据,迁移量小。
六、跨库查询
6.1 问题
分库后,以下查询变得困难:
- JOIN 跨库的表
- 跨库的 COUNT、SUM 等聚合
- 跨库的 ORDER BY + LIMIT
- 跨库的事务
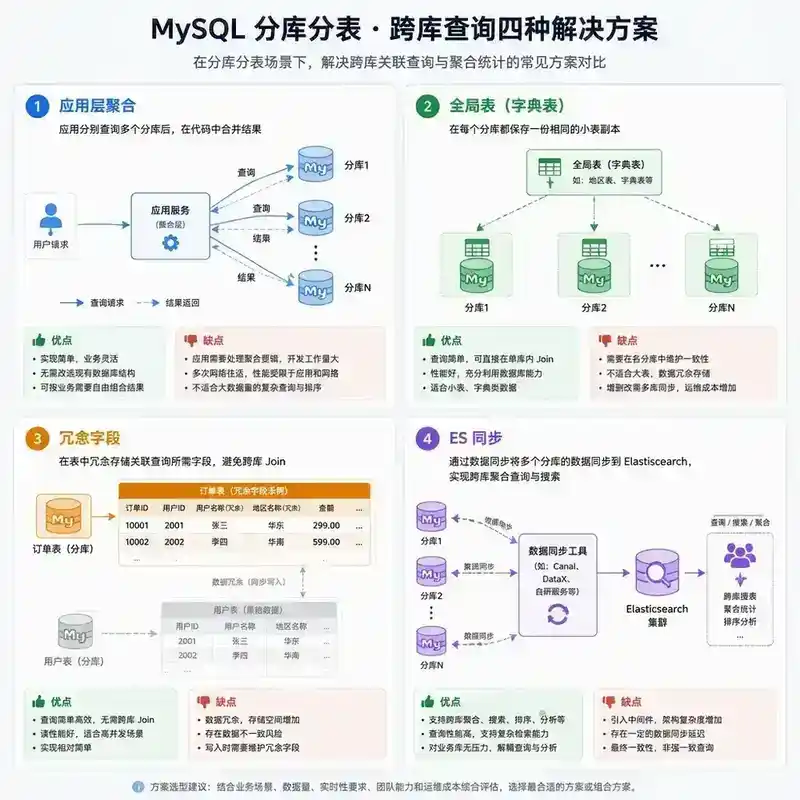
6.2 解决方案
| 方案 | 说明 | 适用场景 |
|---|---|---|
| 应用层聚合 | 分别查询各库,应用层合并结果 | 简单查询 |
| 全局表 | 每个库都有一份全量副本 | 小表、配置表 |
| 冗余字段 | 在分片表中冗余常用字段,避免 JOIN | 查询频繁的关联字段 |
| ES/HBase | 将数据同步到 ES,跨库查询走 ES | 复杂搜索 |
| 分布式事务 | Seata、Saga 等 | 强一致性需求 |
七、全局 ID 设计
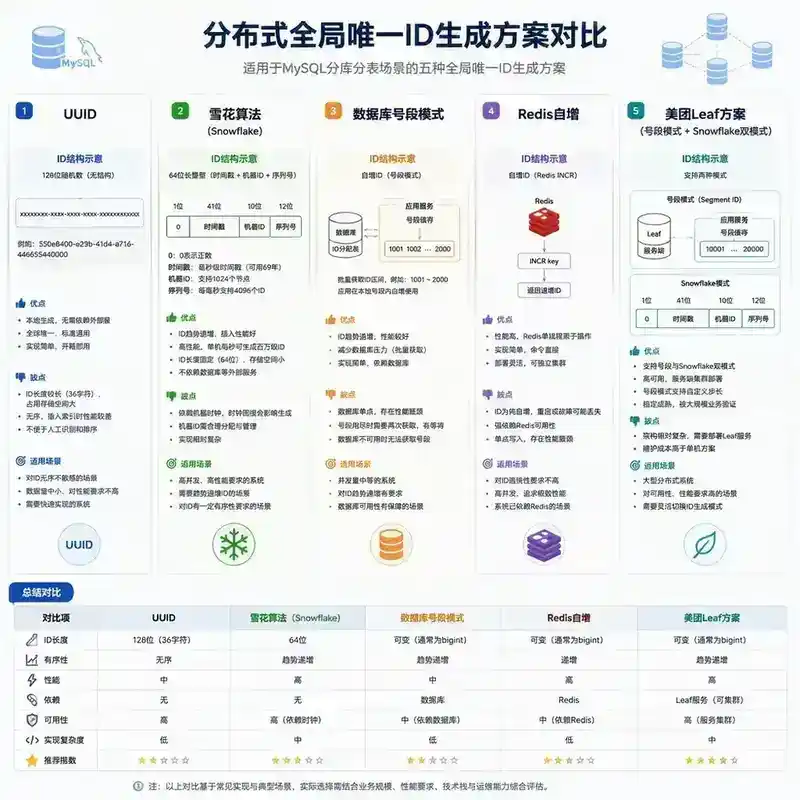
7.1 方案对比
| 方案 | 趋势递增 | 性能 | 复杂度 | 适合场景 |
|---|---|---|---|---|
| UUID | 否 | 高 | 低 | 要求不高的场景 |
| 雪花算法 | 是 | 高 | 中 | 通用场景 |
| 数据库号段 | 是 | 高 | 中 | 需要严格递增 |
| Redis 自增 | 是 | 高 | 中 | 有 Redis 的基础设施 |
| 美团 Leaf | 是 | 高 | 低 | 生产级推荐 |
7.2 雪花算法 ID 结构
┌─────┬──────────────────┬──────────┬────────────┐
│ 1bit │ 41bit 时间戳      │ 10bit 机器 │ 12bit 序列号 │
└─────┴──────────────────┴──────────┴────────────┘
八、总结
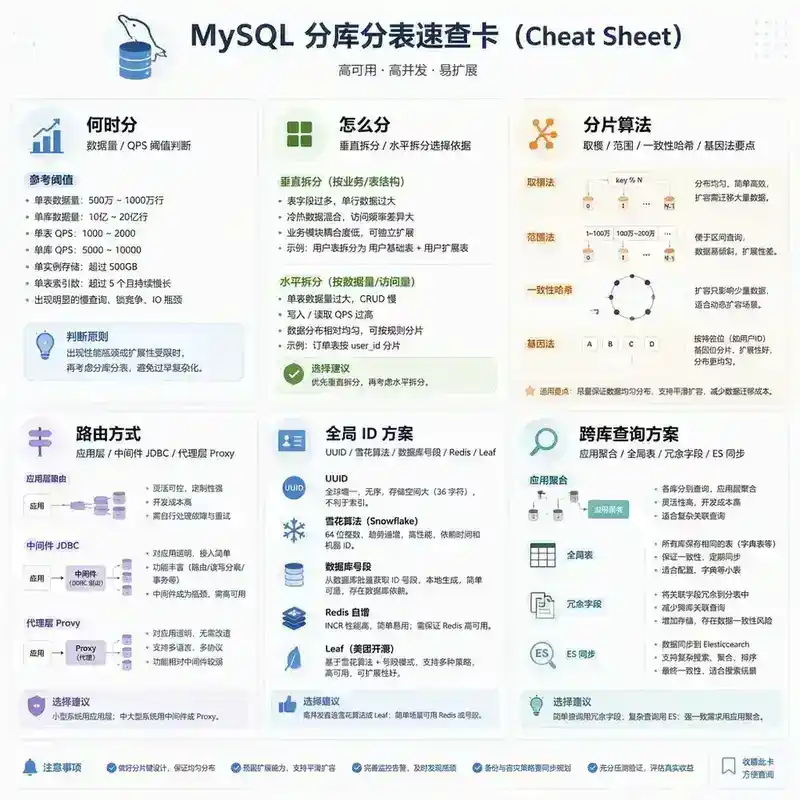
| 维度 | 关键决策 |
|---|---|
| 何时分 | 单表 > 1000 万行,或 QPS > 5000 |
| 怎么分 | 水平分库 + 水平分表,按业务键分片 |
| 分片算法 | 取模(简单)或一致性哈希(易扩容) |
| 路由 | 中间件(ShardingSphere)> 应用层路由 |
| 全局 ID | 雪花算法(推荐)或美团 Leaf |
| 跨库查询 | ES 同步 + 应用层聚合 |
九、面试官视角提问
Q1:一个订单表按**user_id**分片,但经常需要按**order_id**查询。如何设计路由策略?
Q2:取模分片(**user_id % 4**)扩容到 8 个库,需要迁移多少数据?如果使用一致性哈希呢?
Q3:分库分表后,**SELECT COUNT(*) FROM orders**怎么实现?**ORDER BY create_time DESC LIMIT 10**呢?
Q4:分库分表环境下,如何保证全局唯一 ID?雪花算法有什么缺点?时钟回拨怎么处理?
Q5:ShardingSphere 的 JDBC 模式和 Proxy 模式有什么区别?各自适合什么场景?
Q6:分库分表后,一个事务需要跨多个库更新数据。如何保证分布式事务的一致性?
作者注:本文为系列第 127 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:订单表按 分片,但经常按 查询。如何设计路由?
参考答案:
方案一:基因法。 将 user_id 的分片信息编码到 order_id 中。
// order_id = 时间戳 + 分片基因(user_id % 64) + 序列号
// 从 order_id 中提取分片基因,直接路由
int shard = (orderId >> 6) & 0x3F;  // 提取分片基因
方案二:索引表。 维护一张 order_id → user_id 的映射表。
-- 先查映射表拿到 user_id
SELECT user_id FROM order_user_mapping WHERE order_id = ?;
-- 然后用 user_id 路由到对应分片查询
方案三:广播查询。 如果 order_id 查询频率低,直接广播到所有分片。
Q2:取模分片从 4 库扩容到 8 库,需要迁移多少数据?一致性哈希呢?
参考答案:
取模分片: 需要迁移 75% 的数据。原来的 user_id % 4 变为 user_id % 8,每个旧值可能映射到不同的新库。例如 user_id % 4 = 0 的数据,在新规则下 user_id % 8 可能是 0 或 4,约一半数据需要迁移。4 个库各迁移约一半,总计约 75%。
一致性哈希: 添加 1 个节点(从 4 到 5),只需迁移约 20% 的数据。因为只有哈希环上相邻节点的数据需要重新分配,其他节点的数据不受影响。
Q3:分库分表后, 和 怎么实现?
参考答案:
COUNT: 分别查询每个分片,应用层求和。
long total = 0;
for (DataSource ds : shards) {
    total += orderMapper.count(ds);
}
ORDER BY + LIMIT: 分别查询每个分片的 TOP N,应用层归并排序取 TOP N。
// 每个分片取前 10 条
List<Order> results = new ArrayList<>();
for (DataSource ds : shards) {
    results.addAll(orderMapper.selectTop10(ds));
}
// 归并排序取前 10
results.sort(Comparator.comparing(Order::getCreateTime).reversed());
return results.subList(0, 10);
注意: 如果 N 很大(如 LIMIT 1000000, 10),性能很差。建议使用 ES 处理分页查询。
Q4:分库分表下全局唯一 ID,雪花算法的缺点?时钟回拨怎么处理?
参考答案:
雪花算法的缺点:
- 依赖机器时钟,时钟回拨会导致 ID 重复
- 趋势递增但不是严格递增,同一毫秒内可能乱序
- 需要为每个实例分配唯一的 workId
时钟回拨处理:
- 拒绝生成 ID,抛异常等待时钟恢复
- 记录上次生成 ID 的时间戳,如果回拨时间小于阈值(如 10ms),等待后重试
- 使用扩展位(seq 的额外位)作为回拨计数器
- 使用 NTP 服务同步时钟,减少回拨概率
美团 Leaf 方案: 使用数据库号段 + 双 Buffer 预加载,完全避免时钟依赖。
Q5:ShardingSphere JDBC 和 Proxy 模式的区别?
参考答案:
| 维度 | JDBC | Proxy |
|---|---|---|
| 部署 | 与应用一起部署 | 独立部署 |
| 性能 | 高(无网络开销) | 中(多一跳网络) |
| 语言限制 | 仅 Java | 多语言支持 |
| 运维 | 随应用升级 | 独立运维 |
| 资源占用 | 应用内存 | 独立资源 |
JDBC 适合: Java 技术栈,对性能要求高。Proxy 适合: 多语言环境,需要集中管理。
Q6:分库分表后跨库分布式事务如何保证一致性?
参考答案:
方案一:Seata AT 模式
- 自动生成 undo log,回滚时反向操作
- 对业务侵入小,性能中等
方案二:TCC 模式
- Try/Confirm/Cancel 三阶段
- 业务需要实现三个接口,侵入大
方案三:Saga 模式
- 长事务拆分为多个本地事务,失败时通过补偿事务回滚
- 适合长流程,最终一致
方案四:可靠消息最终一致性
- 本地事务 + 消息表,通过消息驱动后续操作
- 最终一致,性能最高
选择建议: 非金融场景推荐 Seata AT 或 Saga,金融场景需要 TCC。
全文完 | 编号 127 | 分类 08 MySQL 与关系型数据库