阅读时间:约 45 分钟 | 难度:中高级 | 编号:111
一、引言:为什么需要理解 InnoDB 的存储结构?
很多开发者对 MySQL 的认知停留在"建表、写 SQL、加索引"的层面。但当遇到以下问题时,对 InnoDB 存储结构的理解就变得至关重要:
- 为什么一张表只能存 64TB 数据?
- 为什么
VARCHAR(65535)实际存不了那么多字符? - 为什么大字段(TEXT/BLOB)会导致性能下降?
- 为什么行溢出了,查询就变慢了?
- 为什么
COUNT(*)在大表上这么慢? - 为什么 B+Tree 索引最多 4 层就能存几十亿行数据?
这些问题都指向同一个答案:InnoDB 的存储结构决定了数据如何被组织、存储和访问。理解存储结构,才能真正理解 InnoDB 的性能特征和设计约束。
本文将从物理存储的最小单元"页"出发,逐层向上构建完整的 InnoDB 存储体系:页 → 区 → 段 → 表空间。
二、InnoDB 存储结构全景
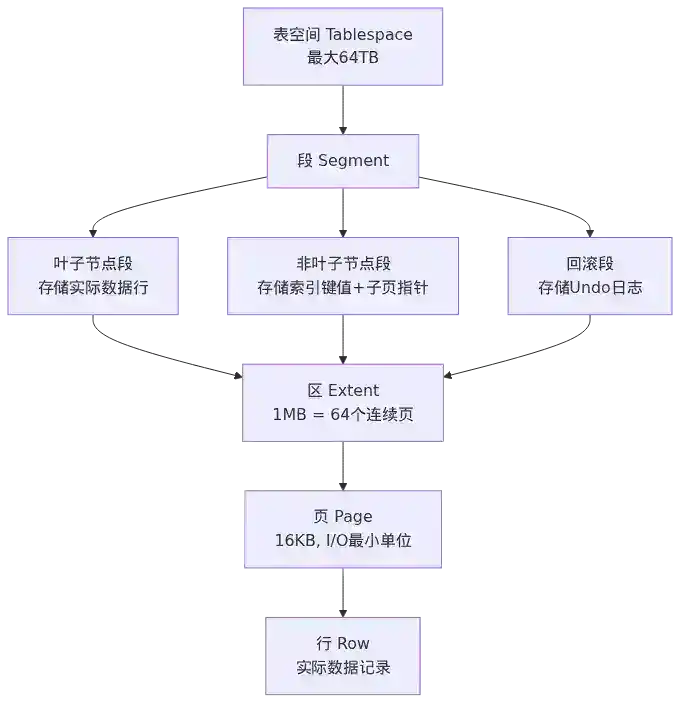
InnoDB 的存储结构是一个严格的层次体系:
表空间 (Tablespace)
  └── 段 (Segment)
        └── 区 (Extent) = 64 个连续的页
              └── 页 (Page) = 16KB(默认)
                    └── 行 (Row)
下面这张图展示了从表空间到数据行的完整层次关系:
| 层级 | 名称 | 大小 | 说明 |
|---|---|---|---|
| 1 | 表空间 (Tablespace) | 最大 64TB | 逻辑存储容器,对应一个 ibd 文件 |
| 2 | 段 (Segment) | 由区组成 | 按功能分类:数据段、索引段、回滚段等 |
| 3 | 区 (Extent) | 1MB (64 个页) | 空间分配的基本单位 |
| 4 | 页 (Page) | 16KB(默认) | I/O 操作的最小单位 |
| 5 | 行 (Row) | 可变 | 实际存储的数据记录 |
核心设计原则:
- 页是磁盘 I/O 的最小单位:每次从磁盘读取或写入数据,至少操作一个完整的页(16KB)。这就解释了为什么即使只查询一行数据,InnoDB 也会把整个 16KB 的页加载到内存。
- 区是空间分配的基本单位:当表需要扩展时,InnoDB 不是按页分配,而是按区(1MB/64 页)分配。这保证了数据在磁盘上的物理连续性,有利于顺序 I/O。
- 段是逻辑概念:段不是物理连续的,而是由多个区组成的逻辑集合。不同功能的段(数据段、索引段)在物理上可能交错分布。
三、页(Page):InnoDB 存储的最小 I/O 单元
3.1 页的基本结构
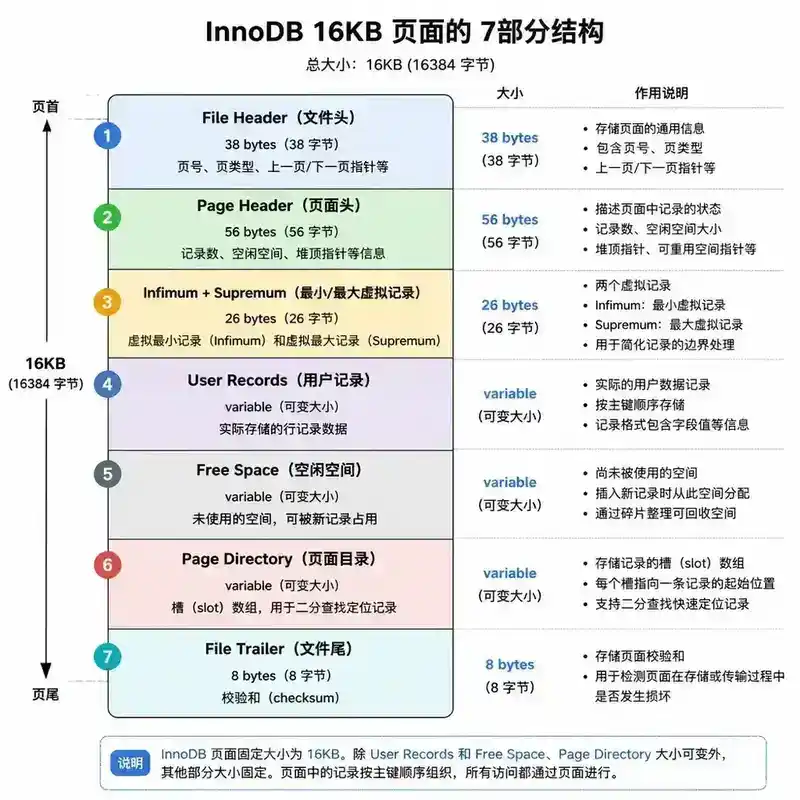
InnoDB 的页(Page)是磁盘和内存之间交互的最小单位。每个页默认 16KB,由以下 7 个部分组成:
| 部分 | 大小 | 说明 |
|---|---|---|
| File Header | 38 字节 | 页的通用信息:页号、页类型、所属表空间、前后页指针 |
| Page Header | 56 字节 | 页的专有信息:记录数、空闲空间、槽位数量等 |
| Infimum + Supremum | 26 字节 | 虚拟的最小记录和最大记录,用于记录之间的逻辑排序 |
| User Records | 可变 | 实际存储的用户数据行 |
| Free Space | 可变 | 页中尚未使用的空间 |
| Page Directory | 可变 | 页内记录的槽位(Slot)数组,用于页内二分查找 |
| File Trailer | 8 字节 | 校验和,用于保证页完整性 |
关键设计:
(1)File Header 中的 FIL_PAGE_PREV 和 FIL_PAGE_NEXT
这两个字段将同一索引级别的所有页串联成一个双向链表。这是 B+Tree 索引中叶子节点之间可以快速进行范围扫描的基础——从一个叶子页可以顺着链表直接跳到下一个叶子页,不需要回到非叶子节点。
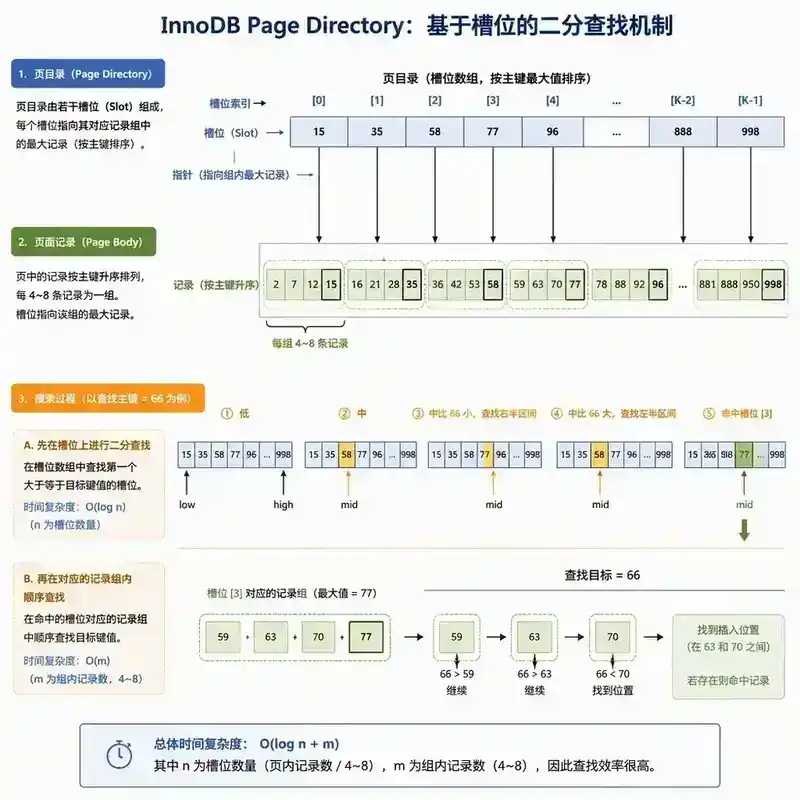
(2)Page Directory 的槽位(Slot)机制
InnoDB 在页内实现了类似"跳表"的结构。Page Directory 将页内的记录按顺序分组,每组包含 4~8 条记录,每个槽位指向组内最大记录。页内查找时,先通过二分查找定位到正确的槽位,然后在槽位对应的小组内顺序查找。
这种设计使得在 16KB 的页内查找一条记录只需要 O(log n) 的时间,而不是 O(n)。
(3)Infimum 和 Supremum
这是两条虚拟记录,分别代表页内的最小值和最大值。所有实际记录都按主键顺序插入到 Infimum 和 Supremum 之间。它们为页内记录提供了逻辑边界,简化了插入和删除操作的处理。
3.2 页的类型
InnoDB 中有多种页类型,每种服务于不同的目的:
| 页类型 | 十六进制 | 说明 |
|---|---|---|
| FIL_PAGE_INDEX | 0x45BF | B+Tree 索引页(最常见) |
| FIL_PAGE_UNDO_LOG | 0x0002 | Undo 日志页 |
| FIL_PAGE_INODE | 0x0003 | 段信息页(存储段的 inode 信息) |
| FIL_PAGE_IBUF_FREE_LIST | 0x0004 | Insert Buffer 空闲列表页 |
| FIL_PAGE_TYPE_ALLOCATED | 0x0000 | 已分配但未使用的页 |
| FIL_PAGE_TYPE_BLOB | 0x0009 | 溢出页(存储大字段溢出数据) |
| FIL_PAGE_TYPE_TRX_SYS | 0x0007 | 事务系统数据页 |
| FIL_PAGE_TYPE_FSP_HDR | 0x0008 | 表空间头部页(第一个页) |
| FIL_PAGE_TYPE_XDES | 0x000A | 区描述符页 |
| FIL_PAGE_TYPE_RTREE | 0x000B | R-Tree 索引页(空间索引) |
其中最需要关注的是 FIL_PAGE_INDEX(索引页),它是 B+Tree 索引的物理载体,占了数据库中绝大部分的页。
四、区(Extent):空间分配与物理连续性
4.1 为什么需要区?
如果按页为单位分配空间,一个 1GB 的表可能分散在磁盘的各个角落,导致严重的随机 I/O。InnoDB 通过"区"来解决这个问题:
- 一个区 = 64 个连续的页 = 1MB
- 每次分配空间时,至少分配一个区
- 64 个页在磁盘上物理连续,可以顺序读写
这种设计使得全表扫描和范围查询时,InnoDB 可以一次性读取连续的 1MB 数据,而不是零散地读取 64 次 16KB 的页。
4.2 区的分配策略
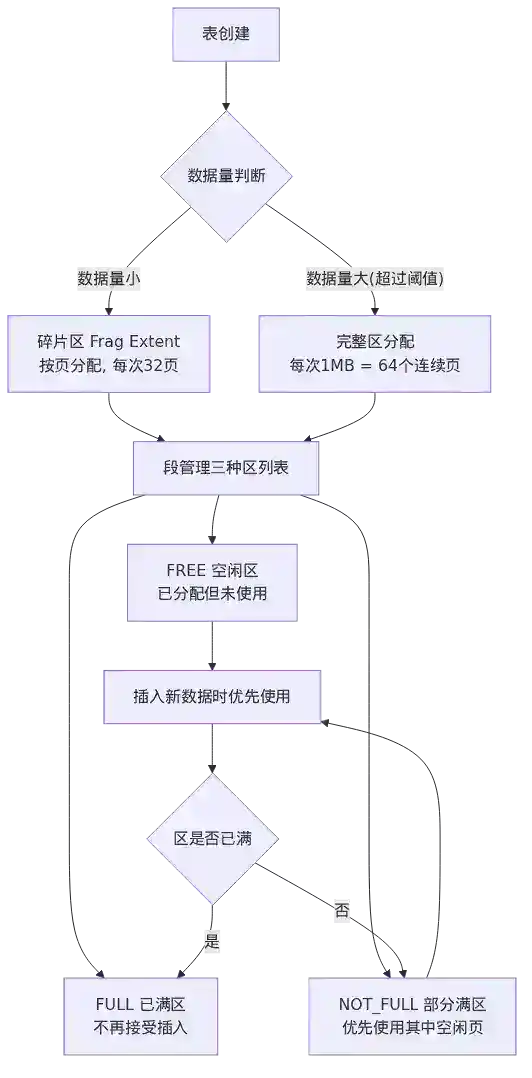
InnoDB 对区的分配有一个巧妙的优化——碎片区(Fragment Extent):
- 表初期:数据量小时,如果每次都分配 1MB 的区,会造成大量空间浪费。InnoDB 使用碎片区,从碎片区中按页分配,每次只分配 32 个页(8 个页一组,共 4 组)。
- 表增长期:当表的数据量超过一定阈值后,InnoDB 切换为按区分配,每次分配完整的 1MB 区。
碎片区 → 完整区的切换时机:当某个段(Segment)已经使用了 32 个碎片页后,后续的空间分配就改为按完整区分配。
4.3 区的管理——XDES Entry
每个区都有一个对应的 XDES(Extent Descriptor)Entry,记录区的元数据:
| 字段 | 说明 |
|---|---|
| Segment ID | 该区属于哪个段 |
| State | 区的状态:空闲、碎片区中的空闲页、属于某个段的完整区 |
| Page State Bitmap | 64 位位图,标记区中每个页是否空闲 |
所有的 XDES Entry 存储在 XDES 页(FIL_PAGE_TYPE_XDES)中,每个 XDES 页可以存储 256 个 XDES Entry。
五、段(Segment):逻辑分组
5.1 段的概念
段是逻辑概念,不是物理连续的存储区域。段由多个区组成,这些区在物理上可能分散在表空间的不同位置。
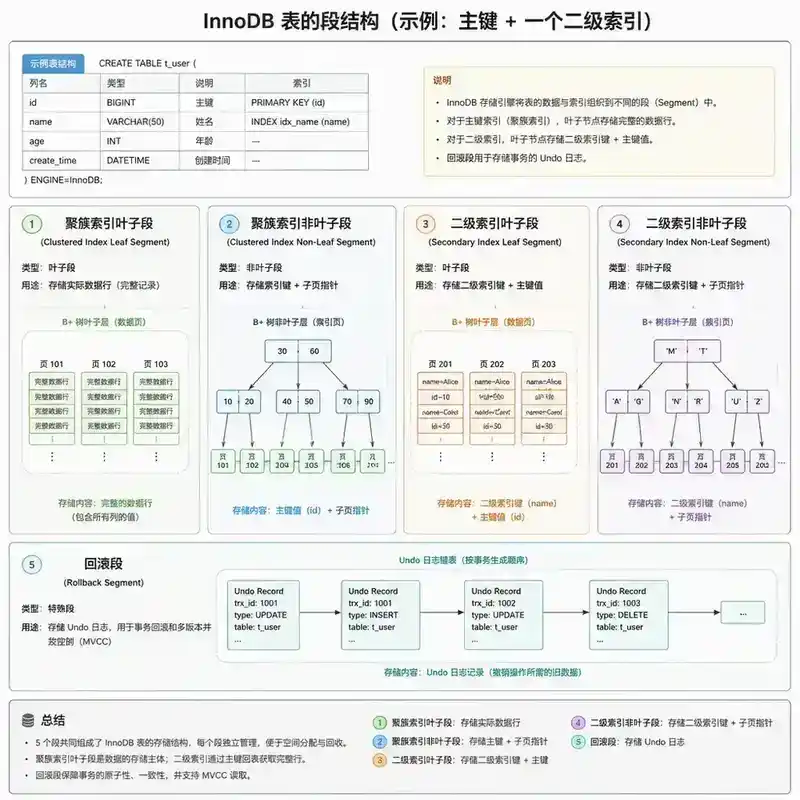
InnoDB 中,每个索引对应两个段:
| 段类型 | 说明 | 存储内容 |
|---|---|---|
| 叶子节点段(Leaf Segment) | 存储 B+Tree 叶子节点 | 实际数据行(聚簇索引)或索引键值+主键(二级索引) |
| 非叶子节点段(Non-Leaf Segment) | 存储 B+Tree 非叶子节点 | 索引键值+子页指针 |
为什么分开? 叶子节点和非叶子节点在物理上分离,有利于:
- 减少磁盘寻道:叶子节点通常比非叶子节点大得多,分开存储可以让叶子节点在物理上更连续
- 区分缓存策略:叶子节点访问频率远高于非叶子节点,可以更有针对性地配置缓存
5.2 段的 INODE 管理
每个段都有一个 INODE(Index Node)Entry,记录段的元数据:
| 字段 | 说明 |
|---|---|
| FSEG_ID | 段的唯一标识 |
| FSEG_NOT_FULL_N_USED | 不完全满的区列表(用于后续插入) |
| FSEG_FREE | 完全空闲的区列表 |
| FSEG_FULL | 已满的区列表 |
| FSEG_FRAG_ARR | 碎片页数组(32 个碎片页) |
三种区列表的设计意图:
- FREE:已分配给段但尚未使用的区,优先从这里分配新页
- NOT_FULL:部分使用的区,插入新记录时优先使用这些区中空闲的页
- FULL:已满的区,不再接受插入,除非删除记录释放空间
这种分类管理使得 InnoDB 能够高效地找到可用的空闲页,而不需要扫描所有页。
5.3 一个表有多少个段?
以最简单的表为例:
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(50),
    INDEX idx_name (name)
);
这个表有以下段:
| 段 | 用途 |
|---|---|
| 数据段(叶子节点段) | 聚簇索引的叶子节点,存储实际数据行 |
| 数据段(非叶子节点段) | 聚簇索引的非叶子节点 |
| idx_name 索引段(叶子节点段) | 二级索引 idx_name 的叶子节点 |
| idx_name 索引段(非叶子节点段) | 二级索引 idx_name 的非叶子节点 |
| 回滚段(Rollback Segment) | 存储 Undo 日志 |
总共 5 个逻辑段,加上系统表空间中的段(如 Insert Buffer 段、Double Write 段等),一个表涉及的实际段数量更多。
六、行格式(Row Format):一行数据如何存储
6.1 四种行格式概览
InnoDB 提供了四种行格式,每种有不同的存储策略:
| 行格式 | 引入版本 | 特点 |
|---|---|---|
| REDUNDANT | MySQL 4.1 之前 | 最古老,兼容性最好,已基本废弃 |
| COMPACT | MySQL 5.0 | 紧凑存储,节省空间 |
| DYNAMIC | MySQL 5.7 默认 | 类似 COMPACT,但对大字段(TEXT/BLOB)的溢出处理更灵活 |
| COMPRESSED | MySQL 5.7 | 在 DYNAMIC 基础上支持页级压缩 |
6.2 COMPACT 行格式详解
COMPACT 行格式由两部分组成:
(1)记录的额外信息
| 字段 | 大小 | 说明 |
|---|---|---|
| 变长字段长度列表 | 可变 | 记录每个 VARCHAR 等变长字段的实际长度(逆序存储) |
| NULL 值列表 | 1 字节/8 个可为 NULL 的列 | 位图标记哪些列是 NULL |
| 记录头信息 | 5 字节 | 包含删除标记、记录类型、下一记录偏移等 |
(2)记录的真实数据
| 字段 | 说明 |
|---|---|
| Row ID(DB_ROW_ID) | 6 字节,当没有主键时自动生成 |
| Transaction ID(DB_TRX_ID) | 6 字节,最近修改该行的事务 ID(MVCC 的关键) |
| Roll Pointer(DB_ROLL_PTR) | 7 字节,指向 Undo 日志中该行的上一个版本 |
| 用户数据列 | 实际的列值 |
变长字段长度列表为什么要逆序存储?
这是一个精妙的设计。记录头信息和变长字段长度列表在记录的两端,向中间靠拢。逆序存储变长字段长度,使得指针可以从记录尾部开始向前读取列长度,与从记录头部开始读取列数据的方向一致,可以更高效地定位到某一列的位置。
┌──────────────────────────────────────────────────┐
│ 变长字段长度列表(逆序) │ NULL位图 │ 记录头 │ 列1 │ 列2 │ ... │
└──────────────────────────────────────────────────┘
         ← 读取方向 ←              → 读取方向 →
6.3 DYNAMIC 行格式
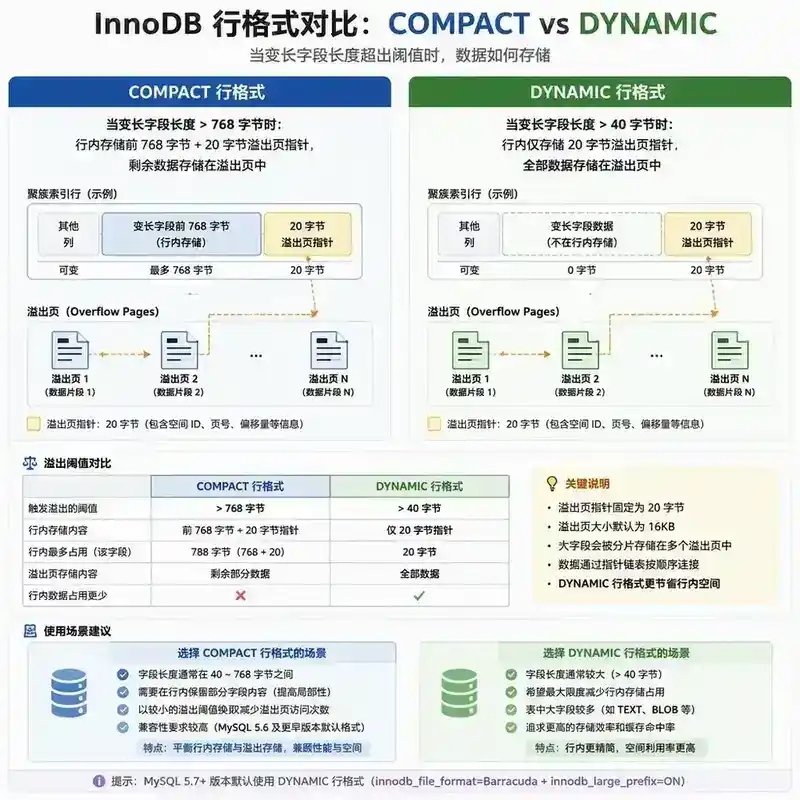
DYNAMIC 与 COMPACT 的结构几乎相同,唯一的区别在于对大字段溢出的处理:
- COMPACT:当变长字段(VARCHAR、TEXT、BLOB)超过 768 字节时,只在行内存储前 768 字节 + 20 字节的溢出页指针,其余数据存储在溢出页中。
- DYNAMIC:当变长字段超过 40 字节时,行内只存储 20 字节的溢出页指针,全部数据存储在溢出页中。
DYNAMIC 的优势:行内不存储大字段的实际数据,使得每个页可以容纳更多行,减少 I/O 次数,提高缓存效率。对于 TEXT/BLOB 字段较多的表,建议使用 DYNAMIC 格式。
6.4 COMPRESSED 行格式
COMPRESSED 在 DYNAMIC 的基础上,对整个页进行压缩(使用 zlib 算法)。压缩后,页的大小可以是 1KB、2KB、4KB 或 8KB(通过 KEY_BLOCK_SIZE 参数指定)。
注意:COMPRESSED 压缩的是整个页,而不是单行。压缩后的页在内存的 Buffer Pool 中同时存在压缩版本和未压缩版本,以平衡 CPU 解压开销和内存节省。
七、溢出页(Overflow Page):大字段去哪儿了
7.1 溢出机制
当一行数据太大,无法放入一个 16KB 的页时,InnoDB 会将部分数据溢出到额外的页中。这就是"溢出页"。
什么情况下会溢出?
一个页中至少要有两行数据(这是 InnoDB 的硬性要求)。因此,如果一行数据超过约 8KB(16KB / 2),就需要溢出。
具体来说,溢出取决于行格式和字段类型:
| 行格式 | 溢出阈值 | 行内存储 |
|---|---|---|
| REDUNDANT | 行 > 页大小/2 | 前 768 字节 + 20 字节指针 |
| COMPACT | 字段 > 768 字节 | 前 768 字节 + 20 字节指针 |
| DYNAMIC | 字段 > 40 字节 | 仅 20 字节指针 |
| COMPRESSED | 字段 > 40 字节 | 仅 20 字节指针 |
7.2 溢出页的存储结构
溢出页(FIL_PAGE_TYPE_BLOB)与普通索引页不同,它有自己独特的结构:
- 不包含 User Records 和 Page Directory
- 数据直接存储在页中
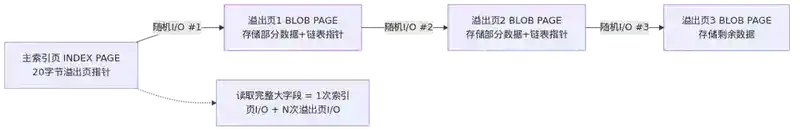
- 如果一个大字段需要多个溢出页,这些溢出页通过链表连接
溢出页链表:大字段的第一个溢出页存储了指向下一个溢出页的指针,形成链表结构。读取完整的大字段时,需要遍历整个链表。
7.3 溢出的性能影响
溢出对性能的影响是显著的:
- 额外的 I/O:读取一个包含溢出字段的行,需要读取主索引页 + 一个或多个溢出页。如果一个大字段需要 10 个溢出页,就需要 11 次随机 I/O(1 个索引页 + 10 个溢出页)。
- Buffer Pool 污染:溢出页会占用 Buffer Pool 的空间,可能挤出热点数据页。
- 无法利用索引覆盖:溢出字段无法被覆盖索引优化,因为索引中只存储了溢出页指针,不是实际数据。
最佳实践:
- 避免在频繁查询的列上使用 TEXT/BLOB
- 将大字段拆分到独立的关联表中,只在需要时 JOIN
- 对于确实需要大字段的表,使用 DYNAMIC 行格式以减少行内存储的溢出数据量
八、表空间(Tablespace):最后的容器
8.1 表空间类型
InnoDB 有三种表空间类型:
| 类型 | 说明 | 文件 |
|---|---|---|
| 系统表空间 | 存储 InnoDB 数据字典、Change Buffer、Double Write Buffer、Undo 日志 | ibdata1 |
| 独立表空间 | 每个表一个独立的 .ibd 文件 | table_name.ibd |
| 通用表空间 | 多个表共享一个表空间 | 自定义 .ibd 文件 |
| Undo 表空间 | 专门存储 Undo 日志 | undo_001, undo_002 |
| 临时表空间 | 存储临时表数据 | ibtmp1 |
8.2 独立表空间的内部结构
每个独立表空间文件(.ibd)的内部结构如下:
┌─────────────────────────────────┐
│ 文件头 (File Space Header)      │  ← 第 0 号页,包含表空间元数据
├─────────────────────────────────┤
│ 插入缓冲位图页 (Insert Buffer)  │  ← 第 1 号页
├─────────────────────────────────┤
│ INODE 页                        │  ← 第 2 号页,存储段信息
├─────────────────────────────────┤
│ 区描述符页 (XDES)               │  ← 第 3 号页开始
├─────────────────────────────────┤
│ 数据页 (INDEX 页)               │  ← 实际数据存储
├─────────────────────────────────┤
│ ...                             │
├─────────────────────────────────┤
│ 空闲页 (ALLOCATED)              │  ← 已分配但未使用的页
└─────────────────────────────────┘
第 0 号页(FSP_HDR) 是整个表空间的元数据核心,包含:
- 表空间 ID
- 表空间总大小
- 第一个区的描述符
- 文件链表信息
8.3 表空间的最大容量
InnoDB 表空间的最大容量是 64TB,这个限制来自:
- 每个页 16KB
- 页号用 4 字节无符号整数表示
- 最大页数:2^32 = 4,294,967,296
- 最大容量:4,294,967,296 × 16KB = 64TB
实际上,64TB 的限制在绝大多数场景下都不是问题。 一个 64TB 的表,即使每秒写入 100MB 数据,也需要约 7.5 天才能写满。真正需要关注的是数据量增长带来的性能退化——页分裂、索引层数增加、Buffer Pool 不够用等。
九、实战:从存储结构看性能优化
9.1 为什么 VARCHAR(65535) 实际存不了 65535 个字符?
MySQL 中 VARCHAR 的最大长度是 65535 字节。但实际可用的存储空间远小于这个值:
- 变长字段长度列表:2 字节
- NULL 值列表:1 字节/8 个 NULL 列
- 记录头:5 字节
- 隐藏列(DB_ROW_ID + DB_TRX_ID + DB_ROLL_PTR):6+6+7 = 19 字节
- 其他列占用的空间
实际可用空间 ≈ 65535 - 2 - 1 - 5 - 19 - 其他列 ≈ 65508 字节
如果使用 UTF8MB4 编码(每个字符最多 4 字节),最多能存储:65508 / 4 ≈ 16377 个字符。
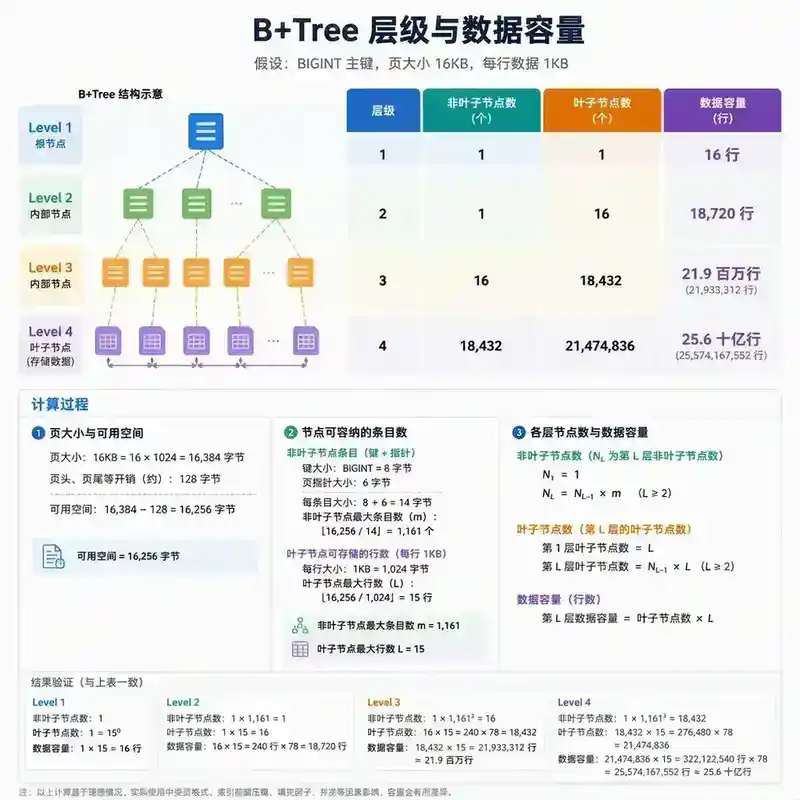
9.2 为什么 B+Tree 只有 3~4 层?
InnoDB 的 B+Tree 索引极少超过 4 层,原因在于每个页可以存储大量的索引条目:
- 假设主键是 BIGINT(8 字节),页指针 6 字节,每个非叶子页可以存储约 16KB / (8+6) ≈ 1170 个索引条目
- 假设每行数据 1KB,每个叶子页可以存储约 16 行
| 层数 | 非叶子节点 | 叶子节点 | 总行数 |
|---|---|---|---|
| 1 | 0 | 1 页 | 16 |
| 2 | 1 页 (1170 条目) | 1170 页 | 18,720 |
| 3 | 1170 页 | 1,368,900 页 | 21,902,400 |
| 4 | 1,368,900 页 | 1,601,613,000 页 | 25,625,808,000 |
3 层就可以存 2000 万行,4 层可以存 250 亿行。这就是为什么 B+Tree 是数据库索引的标准数据结构。
9.3 为什么 COUNT(*) 在大表上慢?
COUNT(*) 在没有 WHERE 条件时,InnoDB 需要遍历所有行(通过最小的二级索引来减少扫描的页数,但仍然是全扫描)。这个过程需要:
- 从磁盘读取所有索引页到 Buffer Pool
- 如果 Buffer Pool 不够大,会发生页淘汰和重新读取
- 每页 16KB,一个 10GB 的表需要读取约 655,360 个页
约 10GB 的表,COUNT(*) 需要扫描约 65 万个页,这就是慢的原因。
9.4 页分裂与页合并
页分裂(Page Split):当向一个已满的页插入新记录时,InnoDB 会:
- 分配一个新页
- 将原页中约一半的记录移动到新页
- 更新父页中的指针
- 如果父页也满了,递归向上分裂
页分裂是写入性能下降的主要原因之一。使用自增主键可以让插入总是发生在 B+Tree 的最右侧,避免页分裂。
页合并(Page Merge):当删除大量记录导致页的填充率低于 50% 时,InnoDB 会尝试将相邻的两个页合并为一个页,释放空闲页。页合并会带来短暂的性能波动。
十、总结
InnoDB 的存储结构是一个精心设计的层次体系,每一层都有其特定的设计目的:
| 层次 | 核心价值 | 关键数字 |
|---|---|---|
| 页 | I/O 最小单位,页内二分查找 | 16KB |
| 区 | 空间分配单位,保证物理连续性 | 1MB (64 页) |
| 段 | 逻辑分组,分离叶子/非叶子节点 | 按索引分 |
| 行格式 | 存储效率与溢出策略的权衡 | 4 种格式 |
| 溢出页 | 大字段的外存机制 | BLOB 页链表 |
| 表空间 | 存储容器,独立管理 | 最大 64TB |
一句话总结:理解 InnoDB 的存储结构,就是理解数据在磁盘上是如何组织的——这决定了 MySQL 的性能上限和优化空间。
十一、面试官视角提问
以下问题从面试官视角出发,考察候选人对 InnoDB 存储结构的理解深度和工程经验。不计入 40 分钟阅读时间。
Q1:InnoDB 的页大小默认是 16KB。如果改成 32KB,会有什么影响?在什么场景下应该考虑修改页大小?
Q2:你用 **SELECT * FROM big_table WHERE id BETWEEN 1 AND 1000** 查询了 1000 行数据。假设每行约 500 字节,这些数据分布在多少个页中?最少多少个页?最多多少个页?请解释你的计算过程。
Q3:一个表有一列 **TEXT** 类型的字段,存储平均 10KB 的 JSON 数据。查询时如果只 SELECT 其他列(不包含 TEXT 列),InnoDB 还会读取溢出页吗?为什么?如果会,怎么优化?
Q4:为什么 InnoDB 建议使用自增主键?如果使用 UUID 作为主键,对页分裂和存储结构有什么影响?请从页填充率、页分裂频率、B+Tree 层数三个角度分析。
Q5:你发现线上一个表的 ibd 文件有 100GB,但 **SELECT COUNT(*)** 显示只有 100 万行,平均每行才 1KB 左右,为什么 ibd 文件这么大?可能的原因有哪些?怎么排查和回收空间?
Q6:InnoDB 的 Buffer Pool 以页为单位管理内存。如果 Buffer Pool 设置为 8GB,可以缓存多少个页?如果一张热表有 200 万行,每行 1KB,能把整张表都缓存到 Buffer Pool 中吗?
作者注:本文为"Java 技术专家与架构师面试:250 个高频考点"系列第 111 篇,属于「08 MySQL 与关系型数据库」分类。
十二、面试官提问 · 参考答案
以下为第十一节中 6 道面试题的参考答案,从面试官视角评估候选人的理解深度。
Q1:InnoDB 页大小默认 16KB,改成 32KB 会有什么影响?
参考答案:
正面影响:
- B+Tree 层数可能减少:更大的页可以容纳更多索引条目。32KB 页的非叶子节点可容纳约 32KB/(8+6) ≈ 2340 个条目(16KB 是 1170)。层数减少意味着更少的磁盘 I/O。
- 顺序扫描效率提升:全表扫描时,每次 I/O 读取 32KB 而不是 16KB,吞吐量更高。
- 大行存储更友好:如果一行数据接近 8KB(16KB 页的溢出阈值),32KB 页可以避免溢出,将整行存储在单个页中。
负面影响:
- Buffer Pool 利用率下降:如果大部分行只有几百字节,32KB 的页中大量空间被浪费。Buffer Pool 以页为单位管理,大页意味着缓存效率降低。
- 页分裂代价更高:32KB 页分裂时需要移动的数据量翻倍,写入性能下降。
- 磁盘空间浪费:对于小表,每个区从 1MB 变成 2MB(64 × 32KB),空间浪费更严重。
- Redo Log 压力增大:每次页修改产生的 Redo Log 更多(因为修改的单位是 32KB)。
- 不兼容:页大小在 MySQL 初始化时设定,修改需要重新初始化数据库。
适用场景: 数据仓库类应用,以大行(含 TEXT/BLOB)和全表扫描为主的场景。不适合高并发 OLTP 场景。
面试官评分要点: 候选人能否从 Buffer Pool、B+Tree、I/O 三个维度分析,而不是只回答"大页更快"或"大页更慢"。
Q2: 查询 1000 行,分布在多少个页中?
参考答案:
最少页数:
如果 1000 行数据在物理上完全连续,且每行 500 字节,则每页可容纳约 16KB / 500B ≈ 32 行。1000 行需要 1000 / 32 ≈ 32 个页。但加上页的固定开销(File Header、Page Header 等约 200 字节),实际每页可用空间约 15.8KB,每页约 31 行。所以最少约 33 个页。
最多页数:
如果数据极端碎片化(频繁的随机插入和删除导致页分裂),每页可能只有 1~2 行。最坏情况下 1000 行分布在 1000 个页中。
实际场景:
- 使用自增主键,数据按主键顺序插入 → 接近最少页数
- 使用 UUID 主键,随机插入导致大量页分裂 → 分布在更多的页中
- 表经历过大量 DELETE 后未 OPTIMIZE → 页填充率低,分布在更多页中
关键因素:
- 主键类型(自增 vs UUID)
- 页填充率(默认页分裂时各 50%,可通过
innodb_fill_factor调整) - 是否有删除操作导致页空洞
面试官评分要点: 候选人能否给出"最少"和"最多"的计算逻辑,并关联到主键设计和页分裂的实际场景。
Q3:TEXT 字段存储 10KB JSON,只 SELECT 其他列(不包含 TEXT 列),InnoDB 会读取溢出页吗?
参考答案:
不会读取溢出页。 这是 InnoDB 行格式设计的精妙之处。
原因:
在 COMPACT 行格式中,TEXT 字段超过 768 字节时,行内只存储前 768 字节 + 20 字节溢出页指针。在 DYNAMIC 行格式中,行内只存储 20 字节溢出页指针。
当查询不包含 TEXT 列时:
- InnoDB 从索引页读取行数据
- 发现 TEXT 列只存储了溢出页指针(20 字节),但查询不需要该列
- InnoDB 跳过该列,不跟随指针去读取溢出页
- 只返回查询需要的其他列
验证方法:
-- 开启 InnoDB 页 I/O 监控
SET GLOBAL innodb_monitor_enable = 'module_page';

-- 查询不含 TEXT 列
SELECT id, name FROM big_table WHERE id = 1;
-- 查看 page I/O 统计,只有 1 次索引页读取

-- 查询含 TEXT 列
SELECT id, name, json_data FROM big_table WHERE id = 1;
-- 查看 page I/O 统计,有 1 次索引页 + N 次溢出页读取
最佳实践: 将大字段拆分到独立表(垂直拆分),主表只存储常用列,大字段表只在需要时 JOIN。这样主表的行更小,每页可容纳更多行,Buffer Pool 效率更高。
面试官评分要点: 候选人是否理解"行内存储的是溢出页指针而非数据"这个关键点,以及是否知道垂直拆分的优化手段。
Q4:为什么 InnoDB 建议使用自增主键?UUID 主键对存储结构的影响?
参考答案:
从三个角度分析:
(1)页填充率
- 自增主键:新行总是插入到 B+Tree 的最右侧。页满时才分裂,分裂后两页各约 50% 填充率,后续插入继续填充到接近 100%。平均页填充率可达 90%+。
- UUID 主键:新行随机插入到 B+Tree 的任意位置。页分裂后,新数据可能不会继续填充该页,导致两页都只有 50% 填充率且不再增长。平均页填充率可能只有 60~70%。
(2)页分裂频率
- 自增主键:页分裂只发生在最右侧的叶子节点,频率低。每次分裂只影响 1 个叶子页和其父页。
- UUID 主键:页分裂发生位置随机,频率高。每次分裂可能需要更新父页、爷页甚至根页。大量随机分裂导致磁盘随机 I/O 激增。
(3)B+Tree 层数
- 自增主键:页填充率高,每页容纳更多行,同样数据量下层数更少。1 亿行可能只需 3 层。
- UUID 主键:页填充率低,每页容纳更少行,同样数据量下层数更多。1 亿行可能需要 4 层。
额外影响:
- 二级索引变大:二级索引叶子节点存储主键值。UUID(36 字节)比 BIGINT(8 字节)大 4.5 倍,导致所有二级索引膨胀。
- Buffer Pool 效率下降:UUID 主键的随机性导致热点数据分散在更多页中,Buffer Pool 命中率下降。
- 磁盘顺序写变为随机写:这是最致命的性能差异。自增主键的插入是顺序 I/O,UUID 主键的插入是随机 I/O,吞吐量可能差 10 倍以上。
结论: 除非有特殊的分库分表需求(需要全局唯一 ID),否则始终优先使用自增 BIGINT 作为主键。
面试官评分要点: 候选人能否从页填充率、页分裂频率、B+Tree 层数三个维度给出量化分析,并提到二级索引和 Buffer Pool 的连锁影响。
Q5:表 ibd 文件 100GB,但 COUNT(*) 只有 100 万行,为什么 ibd 这么大?
参考答案:
可能原因:
(1)大量 DELETE 未回收空间
InnoDB 的 DELETE 操作只是标记删除,不会立即释放磁盘空间。被删除的行在页中留下"空洞"。只有通过 OPTIMIZE TABLE 或 ALTER TABLE ... ENGINE=InnoDB 重建表才能回收空间。
(2)大字段溢出
如果表中有 TEXT/BLOB 列,平均每行有 100KB 的数据溢出到溢出页:100 万行 × 100KB = 100GB。行本身只有 1KB,但溢出页占用了大量空间。
(3)索引膨胀
如果有多个二级索引,每个索引的叶子节点都存储了索引键值 + 主键。一个表有 5 个二级索引,每个索引的叶子节点大小可能接近数据本身。
(4)碎片化
频繁的 UPDATE(特别是更新变长字段导致行变长)和 DELETE 导致页中出现大量碎片空间。页的填充率可能只有 50%,导致实际使用的空间是数据量的 2 倍。
排查方法:
-- 查看表和索引大小
SELECT table_name,
       ROUND(data_length/1024/1024/1024, 2) AS data_gb,
       ROUND(index_length/1024/1024/1024, 2) AS index_gb,
       ROUND(data_free/1024/1024/1024, 2) AS free_gb
FROM information_schema.tables
WHERE table_name = 'your_table';

-- 查看碎片率
SELECT table_name,
       ROUND(data_free / (data_length + index_length) * 100, 2) AS fragment_pct
FROM information_schema.tables
WHERE table_name = 'your_table';
回收空间:
-- 在线 DDL 重建表(MySQL 5.6+,不阻塞读写)
ALTER TABLE your_table ENGINE=InnoDB;
-- 或
OPTIMIZE TABLE your_table;
注意:OPTIMIZE TABLE 会锁表并重建,在业务低峰期执行。重建后 ibd 文件会显著缩小。
面试官评分要点: 候选人能否给出多种可能原因(不只是碎片化),并知道排查命令和回收方法。
Q6:Buffer Pool 8GB,能缓存多少个页?200 万行每行 1KB 能全部缓存吗?
参考答案:
(1)能缓存多少个页?
8GB / 16KB = 524,288 个页。但实际可用的页数略少,因为 Buffer Pool 内部有管理结构(页哈希表、LRU 链表、Free 链表等)占用约 5% 的内存。
实际可用约 500,000 个页。
(2)200 万行每行 1KB 能全部缓存吗?
数据页计算:
每页 16KB,扣除页头开销约 200 字节,实际可用约 15.8KB。每行 1KB,每页约 15 行。200 万行 / 15 ≈ 133,334 个数据页。
非叶子节点页:
假设主键 BIGINT(8 字节),页指针 6 字节:
- 1 层:1 个根页
- 2 层:1 个根页 + 133,334 / 1170 ≈ 114 个中间页
- 3 层:114 个中间页 + 133,334 个叶子页
总页数 ≈ 133,334 + 114 + 1 ≈ 133,449 个页。
二级索引:
如果有 2 个二级索引,每个索引的叶子节点存储索引键值 + 主键。假设每个索引键值约 50 字节 + 8 字节主键 = 58 字节,每页约 270 行。200 万行需要约 7,408 个叶子页。加上非叶子节点,每个二级索引约 7,500 个页。2 个二级索引 ≈ 15,000 个页。
总计: 133,449 + 15,000 ≈ 148,500 个页。
结论: 148,500 < 500,000,可以全部缓存。但需要预留空间给其他热点数据(如其他表的索引页、Undo 页、Change Buffer 等)。实际生产环境中,Buffer Pool 很少只给一张表使用。
面试官评分要点: 候选人能否给出完整的计算过程(数据页 + 非叶子节点 + 二级索引),并提到 Buffer Pool 的竞争和 LRU 淘汰机制。
全文完 | 编号 111 | 分类 08 MySQL 与关系型数据库