阅读时间:约 45 分钟 | 难度:中高级 | 编号:116
一、引言:EXPLAIN 是 DBA 的"听诊器"
EXPLAIN 是 MySQL 中最强大的诊断工具,没有之一。它不执行 SQL,而是展示 MySQL 优化器选择的执行计划。但很多开发者只会看 type=ALL 还是 type=ref,对 filtered、Extra 等关键字段视而不见。
本文从优化器的视角,逐字段解析 EXPLAIN 输出的每一个列,帮助你真正读懂执行计划。
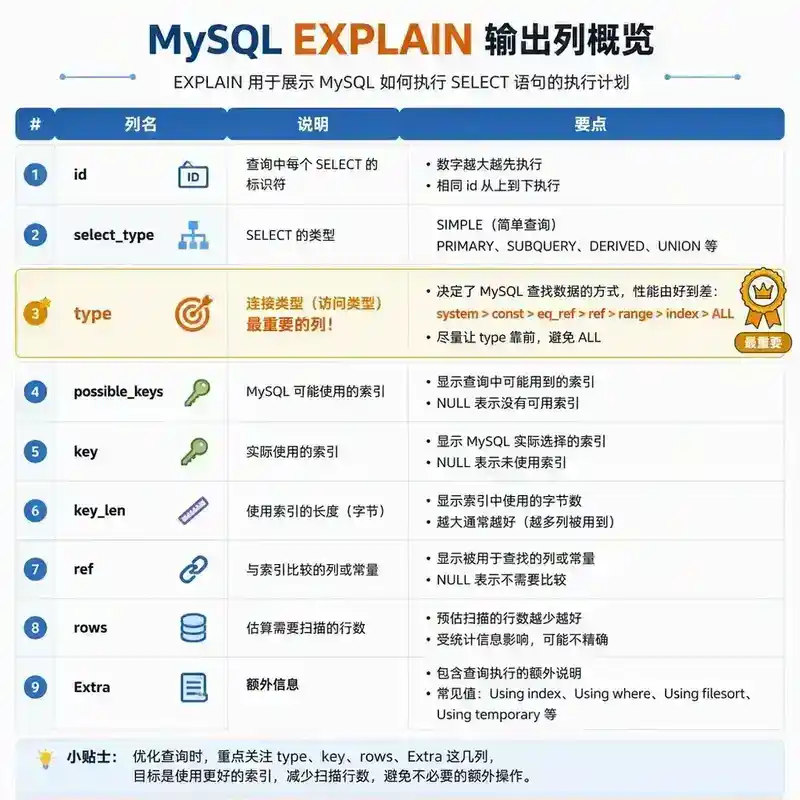
二、EXPLAIN 输出列全景
| 列名 | 含义 | 重要性 |
|---|---|---|
| id | SELECT 序号 | 识别子查询和 UNION |
| select_type | 查询类型 | 区分简单查询、子查询、UNION 等 |
| table | 访问的表 | 表名或别名 |
| partitions | 匹配的分区 | 分区表相关 |
| type | 访问类型 | 最重要!从优到劣排列 |
| possible_keys | 可能使用的索引 | 候选索引列表 |
| key | 实际使用的索引 | 优化器最终选择的索引 |
| key_len | 使用的索引长度 | 判断联合索引用了几列 |
| ref | 索引比较的列或常量 | 与 key 配合使用 |
| rows | 预估扫描行数 | 越小越好 |
| filtered | 按条件过滤的百分比 | 与 rows 配合计算实际行数 |
| Extra | 额外信息 | 判断是否回表、排序、临时表 |
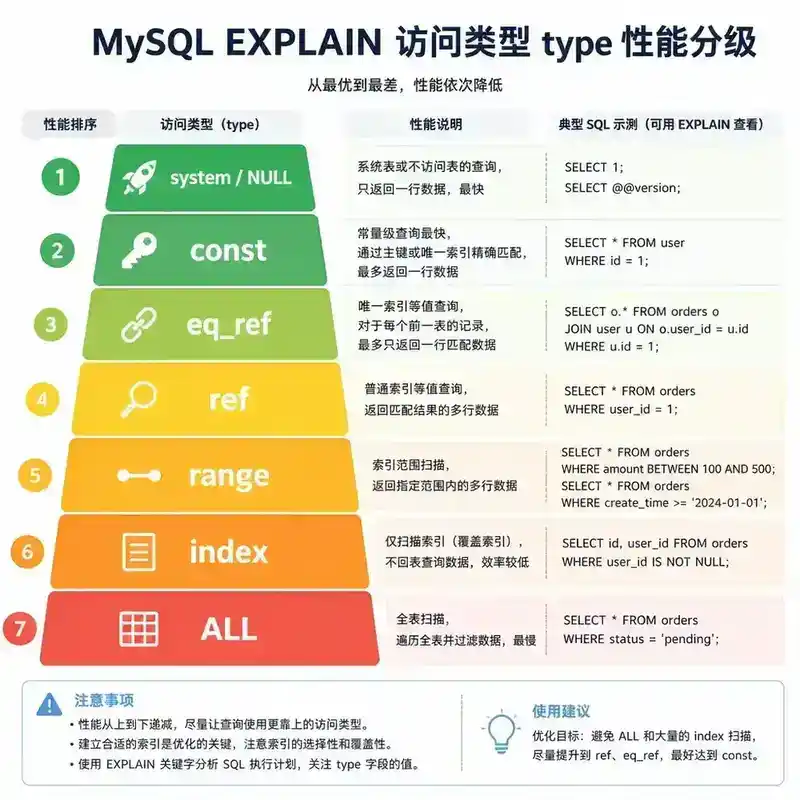
三、type:访问类型(最重要)
type 从优到劣排列,优化目标是至少达到 range 级别:
| type | 含义 | 示例 | 性能 |
|---|---|---|---|
| NULL | 不访问表 | SELECT 1 |
最优 |
| system | 系统表,仅一行 | 极少见 | 极优 |
| const | 主键或唯一索引等值查询 | WHERE id = 1 |
最优 |
| eq_ref | 联表查询,使用主键或唯一索引 | JOIN ON a.id = b.id |
极优 |
| ref | 非唯一索引等值查询 | WHERE name = 'Alice' |
优 |
| fulltext | 全文索引 | MATCH ... AGAINST |
一般 |
| ref_or_null | ref 变体,包含 NULL 查找 | WHERE name = 'A' OR name IS NULL |
一般 |
| index_merge | 索引合并 | WHERE a=1 OR b=2 |
一般 |
| unique_subquery | IN 子查询,主键 | WHERE id IN (SELECT ...) |
一般 |
| index_subquery | IN 子查询,非唯一索引 | 同上 | 一般 |
| range | 索引范围扫描 | WHERE id > 1, BETWEEN, IN |
较好 |
| index | 索引全扫描 | SELECT name FROM t |
较差 |
| ALL | 全表扫描 | SELECT * FROM t |
最差 |
type 优化目标:const > eq_ref > ref > range > index > ALL
四、key 与 key_len:实际使用的索引
4.1 key
key 是优化器实际选择的索引。注意与 possible_keys 区分——possible_keys 是候选索引列表,key 是最终选择。
EXPLAIN SELECT * FROM users WHERE name = 'Alice' AND age = 25;
-- possible_keys: idx_name, idx_age
-- key: idx_name  ← 优化器选择了 idx_name
4.2 key_len
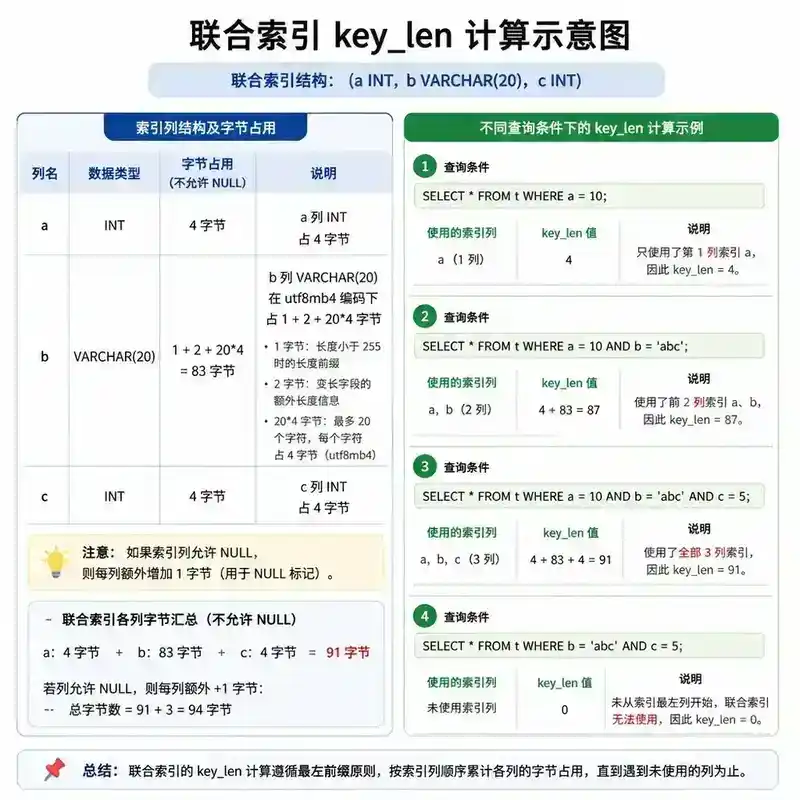
key_len 是索引使用的字节数,用于判断联合索引用了几列。
-- 索引: idx_abc (a INT, b VARCHAR(50), c INT)
-- a INT: 4 字节 (NOT NULL) 或 5 字节 (允许 NULL)
-- b VARCHAR(50) utf8mb4: 50*4+2 = 202 字节 (允许 NULL +1)
-- c INT: 4 字节 (NOT NULL) 或 5 字节 (允许 NULL)

EXPLAIN SELECT * FROM t WHERE a = 1 AND b = 'x';
-- key_len: 4+203 = 207 → 使用了 a 和 b

EXPLAIN SELECT * FROM t WHERE a = 1 AND b = 'x' AND c = 3;
-- key_len: 4+203+4 = 211 → 使用了 a, b, c 全部
五、rows 与 filtered:估算扫描行数
5.1 rows
rows 是优化器估算的需要扫描的行数,基于统计信息(innodb_index_stats)。不是实际行数!
EXPLAIN SELECT * FROM users WHERE age > 18;
-- rows: 800000  ← 优化器估算需要扫描 80 万行
5.2 filtered
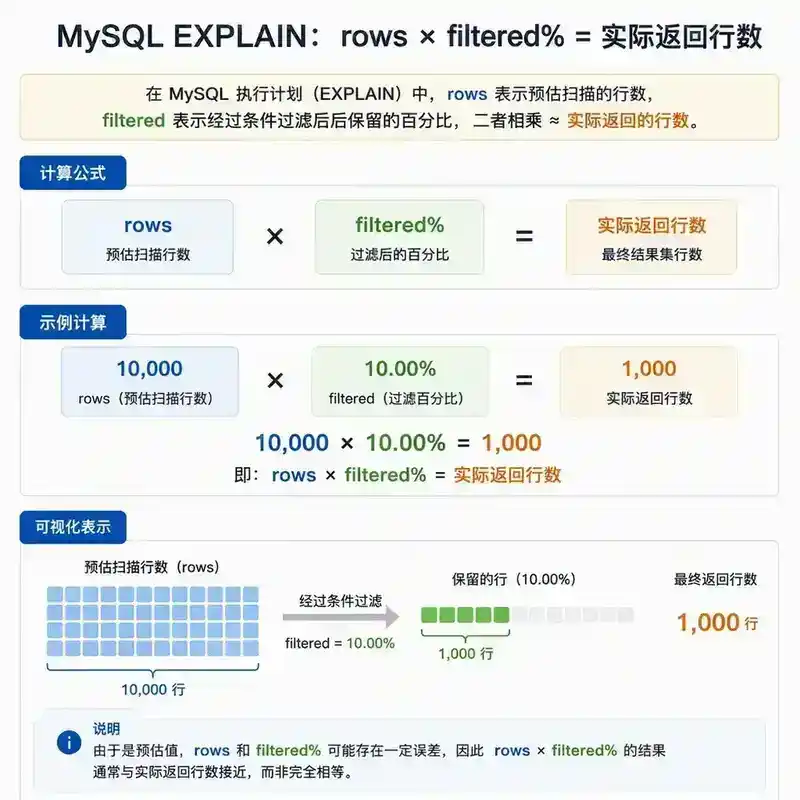
filtered 是 WHERE 条件过滤后剩余行数的百分比。
EXPLAIN SELECT * FROM users WHERE name LIKE 'A%' AND age = 25;
-- rows: 10000, filtered: 10.00
-- 实际扫描后剩余行数 ≈ 10000 × 10% = 1000 行
rows × filtered% = 预估最终返回行数。 这个值越小,查询越高效。
5.3 统计信息不准导致的问题
优化器依赖统计信息做决策。如果统计信息不准,可能导致优化器选择错误的索引。
-- 更新统计信息
ANALYZE TABLE users;

-- 查看统计信息
SELECT * FROM mysql.innodb_index_stats WHERE table_name = 'users';
六、Extra:最有价值的信息
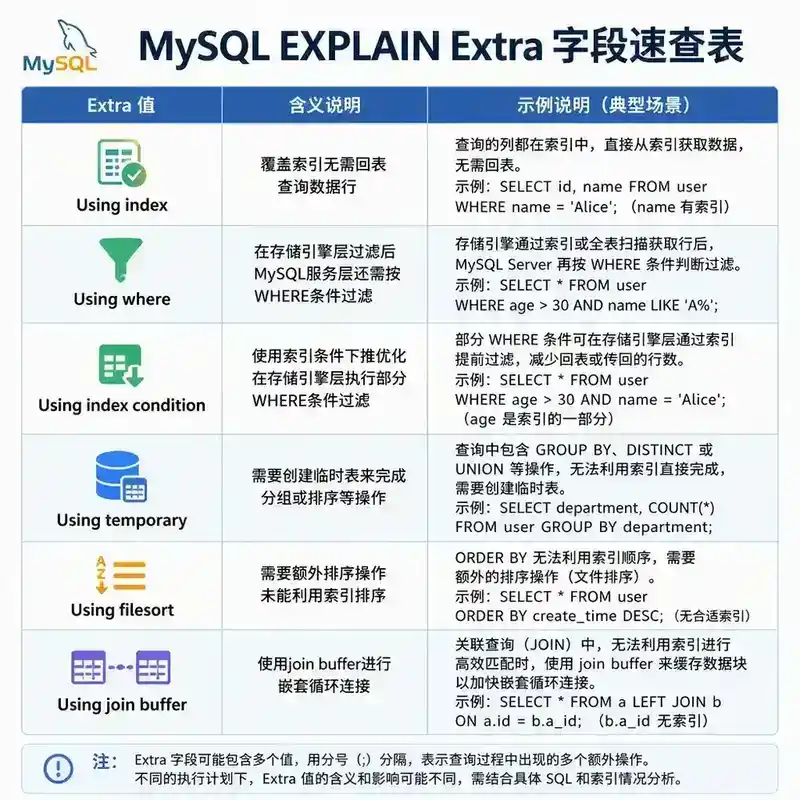
Extra 是 EXPLAIN 中信息量最大的字段,以下是关键值:
6.1 Using index(覆盖索引)
最优!查询只访问了索引,没有回表。
EXPLAIN SELECT name FROM users WHERE name = 'Alice';
-- Extra: Using index
6.2 Using index condition(ICP)
索引下推,在索引层过滤条件,减少回表。
EXPLAIN SELECT * FROM users WHERE name LIKE 'A%' AND age = 25;
-- Extra: Using index condition
6.3 Using where
Server 层在回表后进行了过滤。不如 ICP 高效。
6.4 Using temporary
使用了临时表,通常出现在 GROUP BY、DISTINCT、ORDER BY 不能利用索引时。
EXPLAIN SELECT DISTINCT status FROM orders;
-- Extra: Using temporary
6.5 Using filesort
需要额外排序,无法利用索引排序。性能杀手之一!
EXPLAIN SELECT * FROM users ORDER BY age;
-- Extra: Using filesort
6.6 Using join buffer
联表查询时使用了 Join Buffer(Block Nested Loop 或 Hash Join)。
-- MySQL 8.0+ 默认使用 Hash Join
EXPLAIN SELECT * FROM t1 JOIN t2 ON t1.a = t2.a;
-- Extra: Using join buffer (hash join)
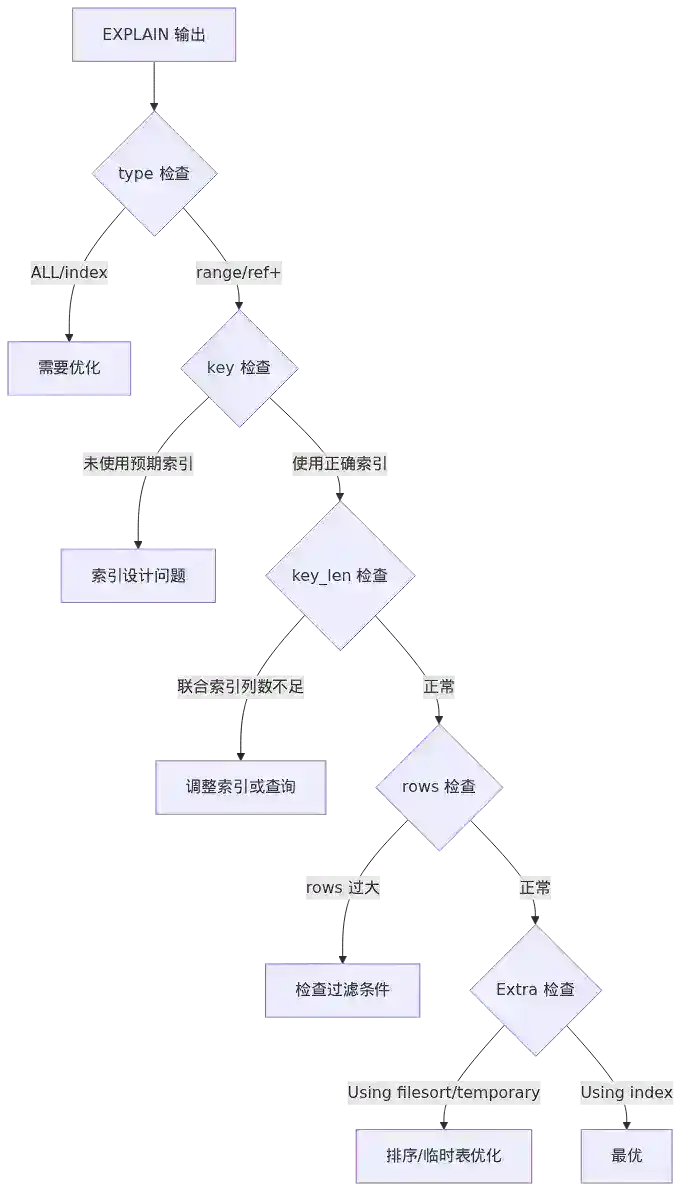
七、实战:EXPLAIN 诊断流程
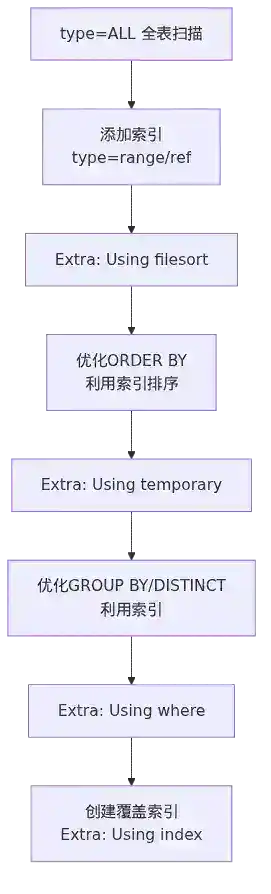
7.1 诊断优先级
1. type 是什么?
   ALL/index → 有问题,需要优化
   range/ref → 可以接受
   const/eq_ref → 最优

2. key 是否合理?
   是否使用了预期的索引?key_len 是否符合预期?

3. rows 是否合理?
   扫描行数是否远大于预期?

4. Extra 有什么?
   Using filesort → 排序问题
   Using temporary → 临时表问题
   Using index → 覆盖索引,确认
7.2 典型案例
案例一:未使用索引
EXPLAIN SELECT * FROM orders WHERE DATE(create_time) = '2024-01-01';
-- type: ALL, key: NULL, rows: 5000000
-- 诊断:函数导致索引失效,全表扫描 500 万行
-- 修复:WHERE create_time >= '2024-01-01' AND create_time < '2024-01-02'
案例二:排序无法利用索引
EXPLAIN SELECT * FROM orders WHERE user_id = 100 ORDER BY amount DESC;
-- type: ref, key: idx_user_id, Extra: Using filesort
-- 诊断:amount 不在索引中,排序需要 filesort
-- 修复:CREATE INDEX idx_user_amount ON orders(user_id, amount)
案例三:覆盖索引 vs 回表
EXPLAIN SELECT * FROM users WHERE name = 'Alice';
-- Extra: NULL (回表)

EXPLAIN SELECT name, id FROM users WHERE name = 'Alice';
-- Extra: Using index (覆盖索引)
八、EXPLAIN 高级用法
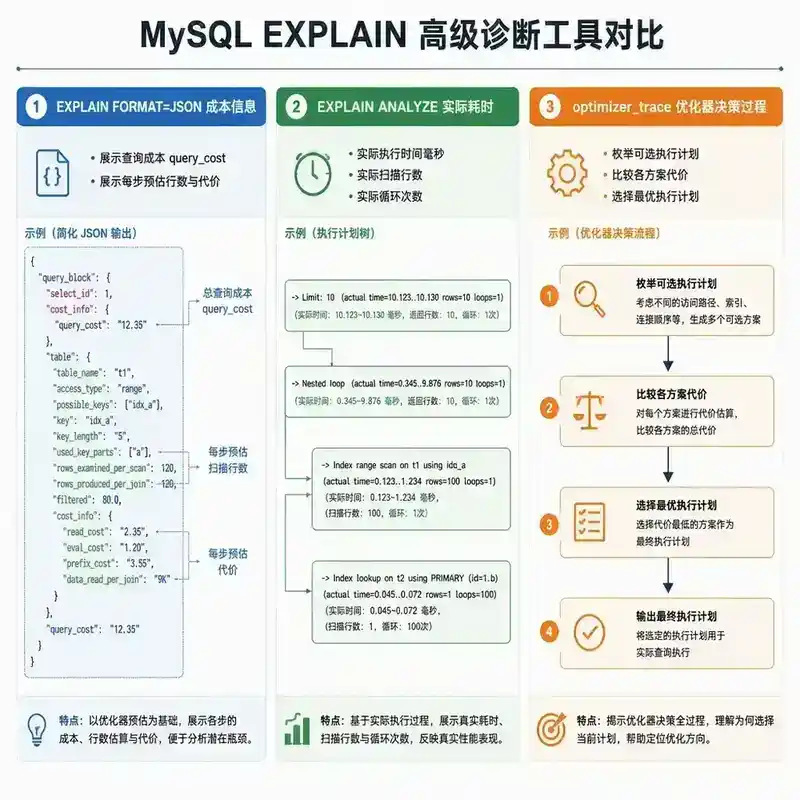
8.1 EXPLAIN FORMAT=JSON
提供更详细的执行计划信息,包括成本估算:
EXPLAIN FORMAT=JSON SELECT * FROM users WHERE name = 'Alice';
{
  "query_block": {
    "cost_info": {
      "query_cost": "123.45"  ← 查询总成本
    },
    "table": {
      "access_type": "ref",
      "rows_examined_per_scan": 100,
      "cost_info": {
        "read_cost": "100.00",
        "eval_cost": "20.00"
      }
    }
  }
}
8.2 EXPLAIN ANALYZE(MySQL 8.0.18+)
实际执行查询并输出执行计划,包含实际行数和耗时:
EXPLAIN ANALYZE SELECT * FROM users WHERE name = 'Alice';
-- -> Index lookup on users using idx_name (name='Alice')
--    (actual time=0.123..0.456 rows=100 loops=1)
EXPLAIN ANALYZE 会真实执行 SQL,不要在生产环境对大表使用!
8.3 优化器追踪
SET optimizer_trace = 'enabled=on';
SELECT * FROM users WHERE name = 'Alice';
SELECT * FROM information_schema.OPTIMIZER_TRACE;
SET optimizer_trace = 'enabled=off';
九、总结
EXPLAIN 诊断口诀:
- type 看访问方式:至少要到 range,目标是 ref
- key 看索引选择:是否用了预期的索引,key_len 判断联合索引使用列数
- rows 看扫描量:扫描行数越小越好,rows × filtered% = 实际行数
- Extra 看隐藏信息:Using index 最好,Using filesort/temporary 要警惕
十、面试官视角提问
Q1:**EXPLAIN SELECT * FROM t WHERE a = 1**,type=ref,key=idx_a,key_len=4。这个 key_len=4 说明了什么?如果 key_len=5 又说明了什么?
Q2:EXPLAIN 显示 rows=100,但实际查询返回了 10000 行。为什么 rows 不准确?什么情况下 rows 会严重偏差?
Q3:**SELECT * FROM t1 JOIN t2 ON t1.a = t2.a WHERE t1.b = 1**。EXPLAIN 显示 t1 的 type=ALL,t2 的 type=eq_ref。这是最优执行计划吗?如果不是,应该怎么优化?
Q4:Extra 中同时出现 Using index 和 Using where,这意味着什么?和只有 Using index 有什么区别?
Q5:MySQL 8.0 的 EXPLAIN ANALYZE 和传统 EXPLAIN 有什么区别?在什么场景下应该使用 EXPLAIN ANALYZE?使用它有什么风险?
Q6:一个慢查询,EXPLAIN 显示 type=ref,key=idx_a,rows=100,Extra=Using index condition。看起来没问题,但实际执行很慢。可能的原因是什么?你会怎么排查?
作者注:本文为系列第 116 篇,属于「08 MySQL 与关系型数据库」分类。
十一、面试官提问 · 参考答案
Q1:,type=ref,key=idx_a,key_len=4。key_len=4 说明什么?如果 key_len=5 呢?
参考答案:
key_len=4 说明 a 列是 INT NOT NULL(4 字节),key_len=5 说明 a 列是 INT 允许 NULL(4+1 字节)。
key_len 的计算规则:
| 列类型 | NOT NULL | 允许 NULL |
|---|---|---|
| INT | 4 | 5 (4+1) |
| BIGINT | 8 | 9 (8+1) |
| CHAR(10) utf8mb4 | 40 | 41 (40+1) |
| VARCHAR(50) utf8mb4 | 202 (50×4+2) | 203 (202+1) |
对于联合索引,key_len 可以判断使用了哪几列:
- key_len=4 → 只用了 a
- key_len=207 → 用了 a(4) + b(202+1)
- key_len=211 → 用了 a(4) + b(203) + c(4)
Q2:EXPLAIN 显示 rows=100,但实际返回 10000 行。为什么 rows 不准确?
参考答案:
rows 是优化器基于统计信息的估算,不是精确值。 统计信息来自 innodb_index_stats,只在以下时机更新:
- 表发生 10% 以上的数据变更(默认)
- 手动执行
ANALYZE TABLE - 首次打开表时
rows 严重偏差的常见原因:
- 统计信息过时:大量 INSERT/DELETE 后统计信息未更新
- 数据分布不均:优化器假设数据均匀分布,但实际严重倾斜
- JOIN 估算误差:多表 JOIN 时,rows 的误差会累积放大
- InnoDB 的随机采样:统计信息通过随机采样 20 个页估算,对于大表可能不准
解决方案:ANALYZE TABLE t 手动更新统计信息。
Q3:,t1 type=ALL,t2 type=eq_ref。最优吗?
参考答案:
不是最优。 t1 全表扫描(type=ALL)是性能瓶颈。
优化方案:
方案一:在 t1 上创建索引
CREATE INDEX idx_ab ON t1(a, b);
-- 或
CREATE INDEX idx_ba ON t1(b, a);
-- t1 的 type 变为 ref 或 range
方案二:调整驱动表顺序
如果 t2 比 t1 小很多,用 STRAIGHT_JOIN 强制 t2 作为驱动表:
SELECT * FROM t2 STRAIGHT_JOIN t1 ON t1.a = t2.a WHERE t1.b = 1;
方案三:覆盖索引减少回表
CREATE INDEX idx_t1_cover ON t1(b, a, 其他需要的列);
Q4:Extra 中同时出现 Using index 和 Using where 是什么意思?
参考答案:
Using index: 查询使用了覆盖索引,没有回表。 Using where: Server 层对索引返回的数据进行了额外的 WHERE 过滤。
同时出现意味着: 查询使用了覆盖索引(索引包含了所有需要的列),但 WHERE 条件中有些列无法在索引查找阶段完全过滤,需要在 Server 层进一步判断。
只有 Using index: 索引覆盖了所有需要的列,且 WHERE 条件完全在索引中解决。
示例:
-- 索引 (name, age)
-- Using index + Using where
SELECT name, age FROM users WHERE name LIKE 'A%' AND age > 25;
-- age>25 是范围条件,在索引中不能完全过滤,需要 Server 层再判断

-- 只有 Using index
SELECT name, age FROM users WHERE name = 'Alice';
-- 所有条件都在索引中精确匹配
Q5:MySQL 8.0 的 EXPLAIN ANALYZE 和传统 EXPLAIN 有什么区别?使用风险?
参考答案:
| 维度 | EXPLAIN | EXPLAIN ANALYZE |
|---|---|---|
| 是否执行 SQL | 否 | 是(真实执行) |
| 行数 | 预估(rows) | 实际(actual rows) |
| 耗时 | 无 | 实际(actual time) |
| 循环次数 | 未知 | 显示(loops) |
| 生产环境 | 安全 | 危险! |
EXPLAIN ANALYZE 的风险:
- 会真实执行 SQL:对大表的
SELECT *会扫描大量数据 - 会获取锁:
SELECT ... FOR UPDATE会真的加锁 - 会修改数据:如果查询包含
INSERT/UPDATE/DELETE(MySQL 8.0.18+ 支持),会真实修改
使用原则: 只在测试环境或生产从库使用,且确认查询是只读的。
Q6:慢查询,EXPLAIN 显示 type=ref, rows=100, Extra=Using index condition。看起来没问题但实际很慢,可能原因?
参考答案:
可能原因(按排查顺序):
- 回表导致随机 I/O:rows=100 只是索引扫描行数,实际回表可能分布在 100 个不同的页中,全是随机 I/O
- 统计信息不准:rows=100 是估算值,实际可能扫描了 10000 行
- 查询被阻塞:等待 MDL 锁或行锁
- 磁盘 I/O 瓶颈:即使 rows 小,如果数据不在 Buffer Pool 中,每次都是磁盘 I/O
- 网络延迟:应用和数据库之间的网络问题
排查方法:
-- 查看实际执行时间
EXPLAIN ANALYZE SELECT ...;

-- 查看等待事件
SELECT * FROM performance_schema.events_statements_current;

-- 查看 Buffer Pool 命中率
SHOW STATUS LIKE 'Innodb_buffer_pool_read%';
全文完 | 编号 116 | 分类 08 MySQL 与关系型数据库