阅读时间:约 45 分钟 | 难度:中高级 | 编号:115
一、引言:索引加了,为什么查询还是慢?
"我明明加了索引,EXPLAIN 却显示全表扫描。" 这是开发者最常遇到的困惑。索引失效的原因多种多样,但背后都有规律可循。
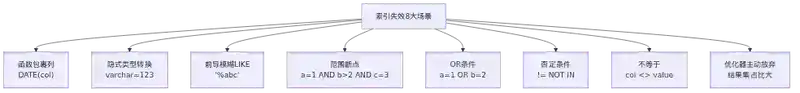
本文系统梳理索引失效的 8 大场景,从原理层面解释每种失效的原因,并给出可操作的优化方案。
二、对索引列使用函数
2.1 原理
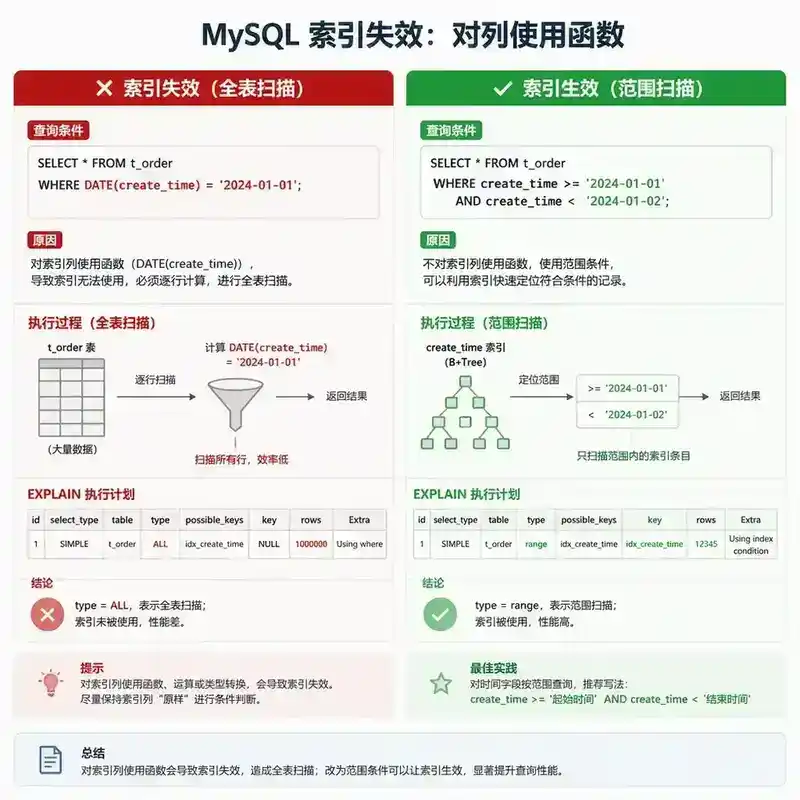
索引存储的是列的原始值。对列使用函数后,MySQL 需要先对每一行计算函数结果,再进行比较。计算后的值不在索引中,索引无法使用。
-- 索引失效:对 create_time 列使用了 DATE 函数
SELECT * FROM orders WHERE DATE(create_time) = '2024-01-01';

-- 索引生效:直接比较列值
SELECT * FROM orders
WHERE create_time >= '2024-01-01' AND create_time < '2024-01-02';
2.2 常见函数导致失效的场景
| 错误写法 | 正确写法 | 原因 |
|---|---|---|
DATE(create_time) = '2024-01-01' |
create_time >= '2024-01-01' AND create_time < '2024-01-02' |
函数包裹列 |
YEAR(create_time) = 2024 |
create_time BETWEEN '2024-01-01' AND '2024-12-31' |
同上 |
LEFT(name, 1) = 'A' |
name LIKE 'A%' |
LIKE 可利用索引 |
ABS(amount) = 100 |
增加计算列 + 索引 | 函数包裹列 |
LOWER(email) = 'a@b.com' |
应用层统一小写存储 | 列存储时已处理 |
2.3 函数在 WHERE 左侧 vs 右侧
-- 索引失效:函数在列上
SELECT * FROM t WHERE DATE(create_time) = '2024-01-01';

-- 索引生效:函数在值上,列保持原样
SELECT * FROM t WHERE create_time = STR_TO_DATE('2024-01-01', '%Y-%m-%d');
关键原则:让列保持原样,对值做变换。
三、隐式类型转换
3.1 原理
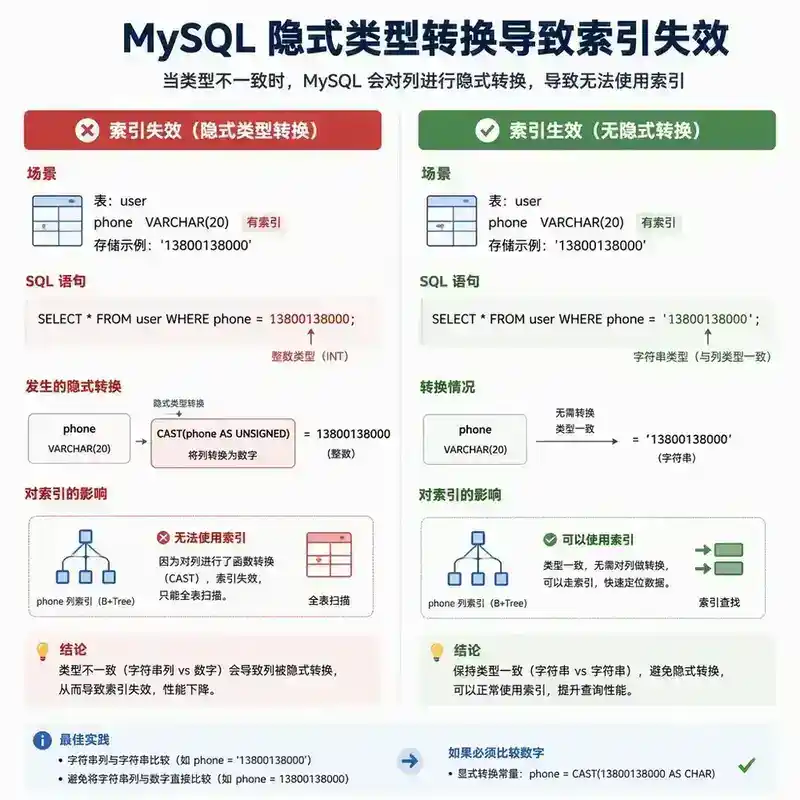
当 WHERE 条件中比较的两边类型不一致时,MySQL 会进行隐式类型转换。转换发生在列上时,索引失效。
-- phone 列是 VARCHAR 类型
-- 索引失效:数值 13800138000 被隐式转换为字符串,但转换在列上
SELECT * FROM users WHERE phone = 13800138000;

-- 索引生效:字符串匹配字符串
SELECT * FROM users WHERE phone = '13800138000';
3.2 隐式转换规则
MySQL 的类型转换规则:当字符串和数字比较时,将字符串转为数字。
-- phone VARCHAR '13800138000' 被转为数字 13800138000
-- 相当于 CAST(phone AS UNSIGNED) = 13800138000
-- 函数在列上 → 索引失效
3.3 字符集转换
不同字符集之间的比较也会导致隐式转换:
-- 表 t1 的 name 列字符集为 utf8mb4
-- 表 t2 的 name 列字符集为 utf8
SELECT * FROM t1 JOIN t2 ON t1.name = t2.name;
-- utf8 会被转为 utf8mb4,转换发生在 t2.name 上 → t2 的索引失效
解决方案: 统一字符集,避免表间字符集不一致。
四、LIKE 前导模糊查询
4.1 原理
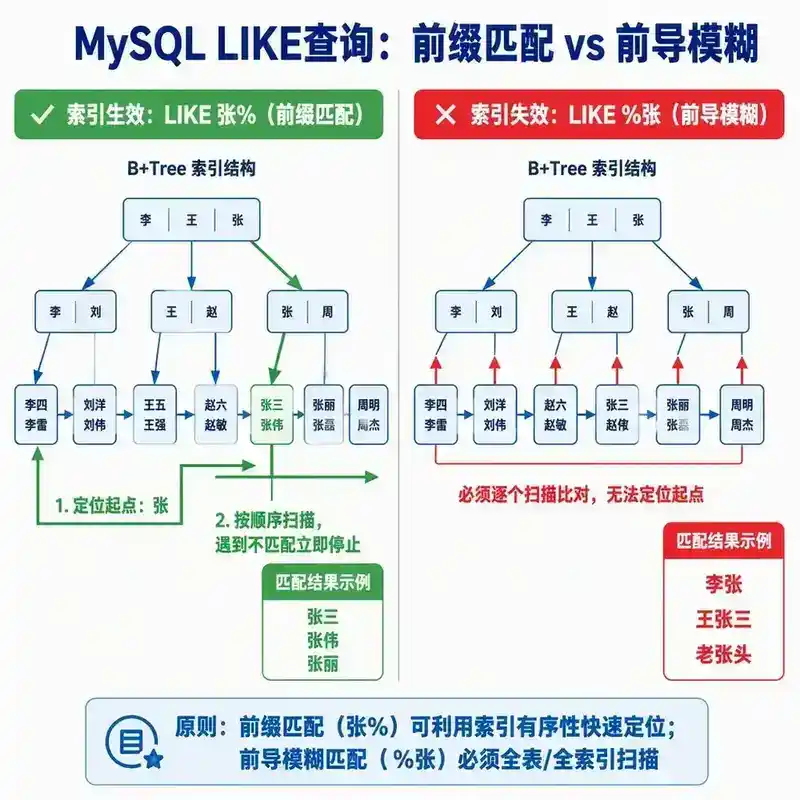
B+Tree 索引按列值从左到右排序。LIKE '%abc' 和 LIKE '%abc%' 需要扫描所有行,因为无法确定匹配值的起始位置。
-- 索引生效:前缀匹配,可以利用 B+Tree 的有序性
SELECT * FROM users WHERE name LIKE '张%';

-- 索引失效:前导模糊,无法利用有序性
SELECT * FROM users WHERE name LIKE '%张';

-- 索引失效:前后都模糊
SELECT * FROM users WHERE name LIKE '%张%';
4.2 解决方案
方案一:全文索引
ALTER TABLE users ADD FULLTEXT INDEX ft_name (name);
SELECT * FROM users WHERE MATCH(name) AGAINST('张' IN BOOLEAN MODE);
方案二:Elasticsearch
对于复杂的模糊搜索需求,使用 ES 专门处理。
方案三:反向存储 + 前缀匹配
-- 原需求:查找以 '张' 结尾的名字
-- 方案:存储时增加反向列
ALTER TABLE users ADD COLUMN name_rev VARCHAR(100);
UPDATE users SET name_rev = REVERSE(name);
CREATE INDEX idx_name_rev ON users(name_rev);

-- 查询:'张%' 匹配反向列
SELECT * FROM users WHERE name_rev LIKE CONCAT(REVERSE('张'), '%');
五、范围条件右边的列失效
5.1 原理
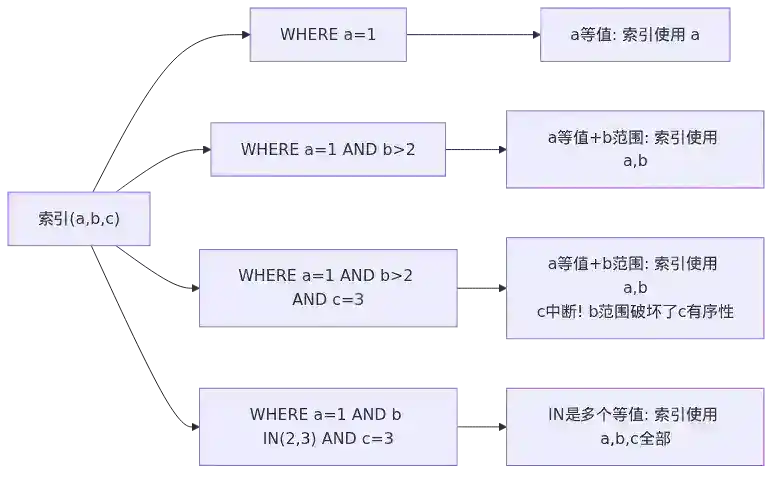
联合索引中,范围查询(>、<、>=、<=、BETWEEN、LIKE 'a%')会中断后续列的索引使用。
-- 索引: idx_abc (a, b, c)
-- 索引只用到了 a 和 b,c 失效
SELECT * FROM t WHERE a = 1 AND b > 2 AND c = 3;
b 是范围查询,b 的值不再相同,c 在不同 b 值下无序。
5.2 优化策略
策略一:调整索引列顺序,将范围列放最后
-- 原索引: (a, b, c),b 是范围条件
-- 优化: (a, c, b),让等值列 c 在范围列 b 前面
CREATE INDEX idx_acb ON t(a, c, b);
策略二:用 IN 替代范围(如果范围值有限)
-- 范围查询,c 失效
WHERE a = 1 AND b > 2 AND b < 6 AND c = 3;

-- 用 IN 替代,c 可以使用
WHERE a = 1 AND b IN (2, 3, 4, 5) AND c = 3;
六、OR 条件
6.1 原理
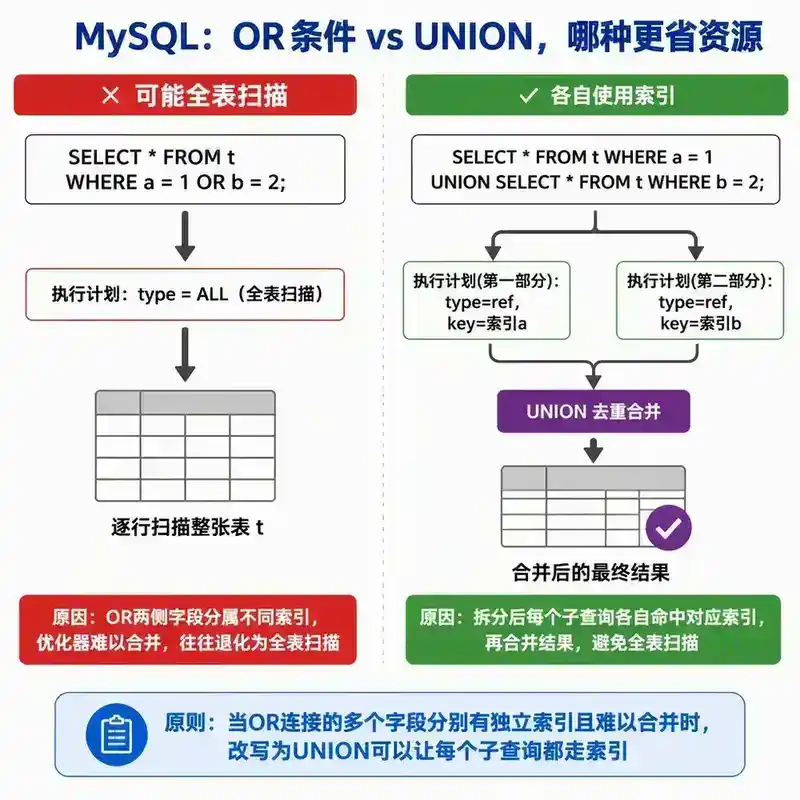
OR 条件中,如果部分条件没有索引,整个查询可能不走索引。
-- a 有索引,b 没有索引
SELECT * FROM t WHERE a = 1 OR b = 2;
-- 可能全表扫描,因为 b = 2 需要全表扫描
即使 a 和 b 都有独立的单列索引,OR 也可能导致索引失效。
6.2 解决方案
方案一:UNION 替代 OR
-- 原查询
SELECT * FROM t WHERE a = 1 OR b = 2;

-- 优化:UNION 各自使用索引
SELECT * FROM t WHERE a = 1
UNION
SELECT * FROM t WHERE b = 2;
方案二:IN 替代 OR(同一列)
-- 原查询
SELECT * FROM t WHERE a = 1 OR a = 2 OR a = 3;

-- 优化:IN 可以使用索引
SELECT * FROM t WHERE a IN (1, 2, 3);
七、NOT、!=、<> 否定条件
7.1 原理
否定条件通常需要扫描大量数据,MySQL 优化器可能选择全表扫描。
-- 索引可能失效
SELECT * FROM t WHERE status != 'DELETED';

-- 如果 'DELETED' 的行很少,全表扫描代价可能更低
7.2 优化方案
-- 用 IN 替代 !=
SELECT * FROM t WHERE status IN ('ACTIVE', 'PENDING');

-- 或用 UNION ALL
SELECT * FROM t WHERE status = 'ACTIVE'
UNION ALL
SELECT * FROM t WHERE status = 'PENDING';
八、优化器选择全表扫描
8.1 原理
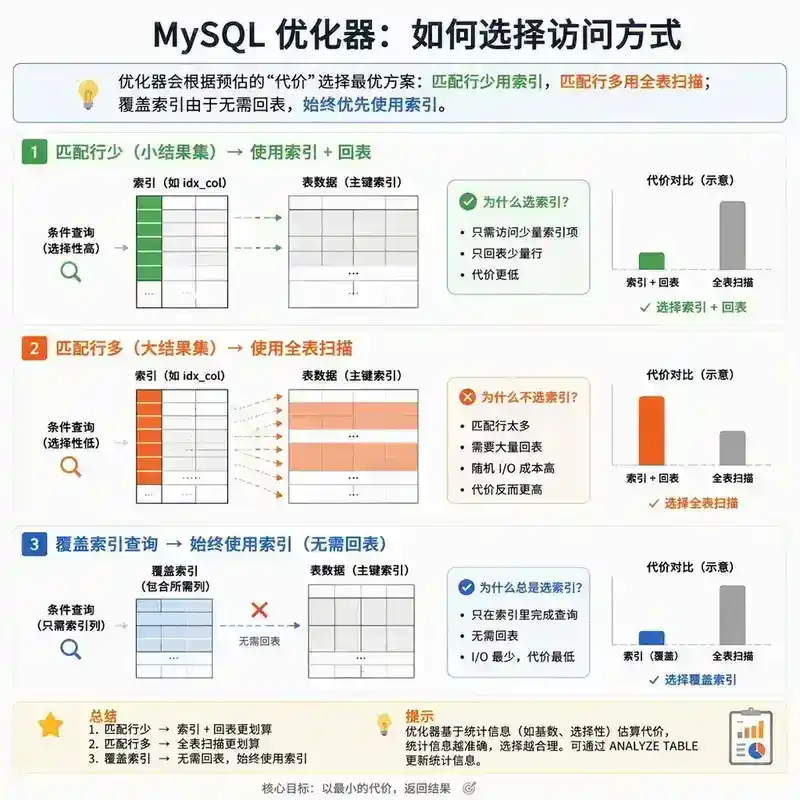
索引失效不一定是坏事。 有时优化器认为全表扫描比索引+回表更快,会主动放弃索引。
-- 假设 90% 的行满足 age > 18
SELECT * FROM users WHERE age > 18;
-- 优化器可能选择全表扫描,因为回表代价太高
8.2 判断标准
| 条件 | 优化器选择 |
|---|---|
| 结果集 > 表的 20-30% | 可能全表扫描 |
| 覆盖索引 | 优先使用索引 |
| LIMIT 小 | 优先使用索引 |
| ORDER BY + LIMIT | 可能使用索引排序 |
尊重优化器的选择。 如果优化器选择了全表扫描,通常是对的。强制使用索引(FORCE INDEX)只在确定优化器判断错误时使用。
九、索引失效速查表
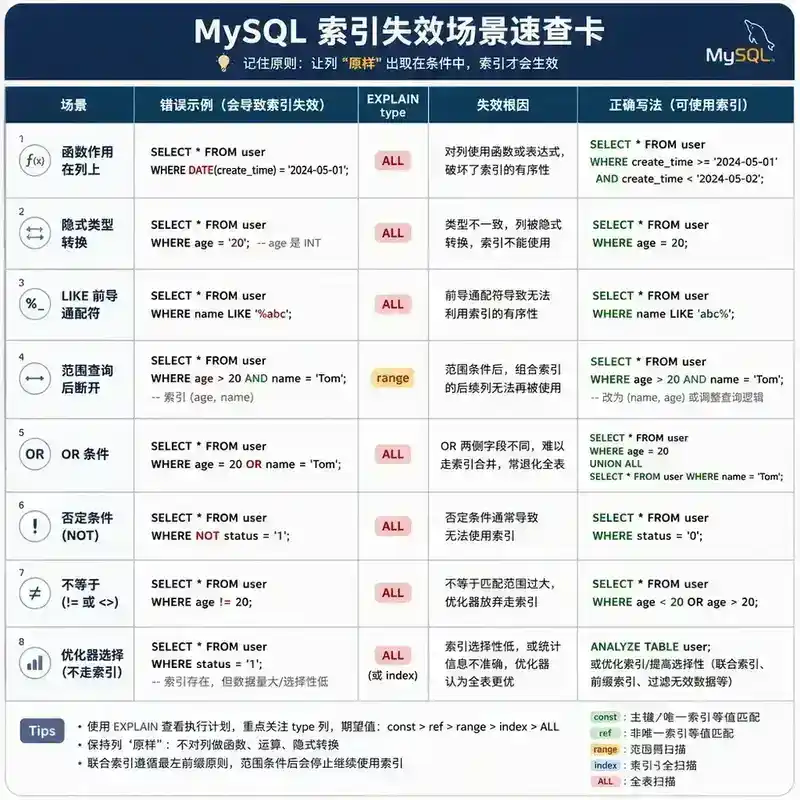
| 场景 | 示例 | 失效原因 | 解决方案 |
|---|---|---|---|
| 函数包裹 | DATE(col) = '2024-01-01' |
列被函数转换 | 对值做变换 |
| 隐式转换 | varchar_col = 123 |
列被转为数字 | 类型匹配 |
| 前导模糊 | LIKE '%abc' |
无法利用有序性 | 全文索引/ES |
| 范围断点 | a=1 AND b>2 AND c=3 |
范围中断后续列 | 调整列顺序 |
| OR 条件 | a=1 OR b=2 |
部分条件无索引 | UNION |
| 否定条件 | !=, NOT IN |
扫描范围大 | IN 替代 |
| 不等于 | col <> value |
同否定条件 | 等值条件 |
| 优化器选择 | 结果集占比大 | 回表代价高 | 覆盖索引 |
十、总结
索引失效的核心原因只有两个:
- 列被修改(函数、类型转换、字符集转换)→ 索引存储的是原始值
- 无法利用有序性(前导模糊、范围断点、OR、否定)→ B+Tree 依赖有序性
排查口诀: 先用 EXPLAIN 看 type,如果是 ALL 或 index,检查 WHERE 条件是否满足最左前缀、列是否被函数包裹、类型是否匹配。
十一、面试官视角提问
Q1:**WHERE DATE(create_time) = '2024-01-01'** 索引失效,为什么 **WHERE create_time = '2024-01-01'** 就能用索引?MySQL 对 '2024-01-01' 这个字符串做了什么处理?
Q2:**phone VARCHAR(20)** 有索引,查询 **WHERE phone = 13800138000** 和 **WHERE phone = '13800138000'** 在 EXPLAIN 中有什么区别?MySQL 8.0 对这个行为有优化吗?
Q3:索引 **(a, b, c)**,查询 **WHERE a = 1 AND c = 3**。c 是否一定无法使用索引?在什么情况下 c 可能被用到?
Q4:**SELECT * FROM t WHERE a = 1 OR b = 2**,a 和 b 都有独立索引。EXPLAIN 显示 type=index_merge,这是什么?和 UNION 方案有什么区别?
Q5:**LIKE 'abc%'** 能用索引,**LIKE '%abc'** 不能。如果业务确实需要后缀匹配,在不引入 ES 的前提下,MySQL 层面有什么优化方案?
Q6:一个表有 1000 万行,**WHERE status = 'ACTIVE'** 返回 900 万行。status 有索引,但 EXPLAIN 显示 ALL。你同意优化器的选择吗?为什么?如果不同意,你会怎么做?
作者注:本文为系列第 115 篇,属于「08 MySQL 与关系型数据库」分类。
十二、面试官提问 · 参考答案
Q1: 索引失效, 能用索引,MySQL 对字符串做了什么?
参考答案:
MySQL 会将 **'2024-01-01'** 隐式转换为 **DATE** 类型,但转换发生在值上,而不是列上。
关键区别:
DATE(create_time) = '2024-01-01':函数在列上,对每一行的 create_time 执行 DATE() 计算,索引中存储的是原始 TIMESTAMP 值,无法匹配create_time = '2024-01-01':列保持原样,MySQL 将字符串'2024-01-01'转为 DATETIME 值'2024-01-01 00:00:00',然后用这个值去索引中查找,索引可以使用
原则:让列保持原样,对值做变换。 索引存储的是列的原始值,任何对列的修改都会导致索引失效。
Q2: 有索引, vs 的区别?MySQL 8.0 有优化吗?
参考答案:
**phone=13800138000** 会导致索引失效,**phone='13800138000'** 正常使用索引。MySQL 8.0 没有改变这个行为。
原因: MySQL 的类型转换规则:数字和字符串比较时,将字符串转为数字。phone=13800138000 等价于 CAST(phone AS UNSIGNED) = 13800138000,函数在列上,索引失效。
EXPLAIN 差异:
phone=13800138000:type=ALL,全表扫描phone='13800138000':type=ref 或 const,使用索引
MySQL 8.0 没有优化这个行为,因为隐式转换规则是 SQL 标准的一部分,改变它可能导致兼容性问题。最佳实践是应用层确保类型匹配。
Q3:索引 ,,c 是否一定无法使用索引?什么情况下 c 可能被用到?
参考答案:
c 无法用于索引查找(index lookup),但可以通过 ICP(索引下推)在索引层过滤。
- 索引查找(Index Lookup): c 不能参与,因为跳过了 b,c 在 b 不同的情况下无序
- ICP 过滤: MySQL 5.6+ 可以将
c=3下推到索引层,在回表前判断。虽然 c 不能用于缩小索引扫描范围,但可以减少回表次数
如果查询是 **WHERE a=1 AND c=3 ORDER BY b**: c 仍然不能用于索引查找,但 ORDER BY b 可以利用索引排序(因为 a=1 等值,b 在 a 内有序)。
Q4:,a 和 b 都有索引。EXPLAIN 显示 type=index_merge,这是什么?
参考答案:
index_merge 是 MySQL 5.0+ 引入的优化,允许同时使用多个索引,然后将结果合并。
index_merge 的三种合并策略:
| 策略 | 说明 | 场景 |
|---|---|---|
| index_merge_union | 取并集 | WHERE a=1 OR b=2 |
| index_merge_intersection | 取交集 | WHERE a=1 AND b=2 |
| index_merge_sort_union | 排序后取并集 | WHERE a>1 OR b>2 |
index_merge vs UNION:
- index_merge 是 MySQL 自动选择的,一条 SQL 完成
- UNION 是手动拆分,两条 SQL 各自使用索引,然后合并
- 性能上 UNION 通常更可控,index_merge 有时性能不如预期
面试官评分要点: 候选人是否知道 index_merge 的存在及其三种策略,并能与 UNION 对比。
Q5: 能用索引, 不能。MySQL 层面有什么优化方案?
参考答案:
方案一:反向索引
ALTER TABLE t ADD COLUMN name_rev VARCHAR(100);
UPDATE t SET name_rev = REVERSE(name);
CREATE INDEX idx_name_rev ON t(name_rev);

-- 查询后缀匹配:'%abc' → 反向存储 + 前缀匹配 'cba%'
SELECT * FROM t WHERE name_rev LIKE CONCAT(REVERSE('abc'), '%');
方案二:全文索引 + 布尔模式
ALTER TABLE t ADD FULLTEXT INDEX ft_name (name);
SELECT * FROM t WHERE MATCH(name) AGAINST('*abc' IN BOOLEAN MODE);
方案三:生成列 + 索引
ALTER TABLE t ADD COLUMN name_suffix VARCHAR(50)
  GENERATED ALWAYS AS (RIGHT(name, 10)) STORED;
CREATE INDEX idx_suffix ON t(name_suffix);
方案四:如果后缀长度固定,直接用 SUBSTRING
-- 查找后缀为 '@company.com' 的邮箱
SELECT * FROM users WHERE email LIKE '%@company.com';
-- 优化:如果后缀固定,可以反向存储
SELECT * FROM users WHERE email_rev LIKE 'moc.ynapmoc@%';
Q6:1000 万行, 返回 900 万行,status 有索引但 EXPLAIN 显示 ALL。同意优化器吗?
参考答案:
同意优化器的选择。全表扫描在这个场景下是最优解。
原因分析:
- 使用索引:900 万次索引查找 + 900 万次回表 = 最多 1800 万次随机 I/O
- 全表扫描:1000 万行,每页约 32 行,约 31 万个页,顺序 I/O
顺序 I/O 31 万次 vs 随机 I/O 900 万次,全表扫描快约 30 倍。
如果不同意优化器,优化方案:
- 覆盖索引:
CREATE INDEX idx_status_cover ON t(status, 其他需要的列),避免回表 - 分区表: 按 status 分区,查询只扫描特定分区
- 汇总表: 定期维护统计表,查询走汇总表
面试官评分要点: 候选人能否理解"优化器选择全表扫描是合理的",并给出覆盖索引的优化方案,而不是盲目使用 FORCE INDEX。
全文完 | 编号 115 | 分类 08 MySQL 与关系型数据库