阅读时间:约 45 分钟 | 难度:中高级 | 编号:128
一、引言:数据库宕机的代价
数据库是业务系统的核心,宕机意味着服务不可用。高可用(HA)的目标是:当主库故障时,自动切换到备库,最小化服务中断时间。
但高可用不仅仅是"切换",还要解决:如何检测故障?如何避免脑裂?切换后数据如何恢复?这些问题的答案取决于你选择的高可用方案。
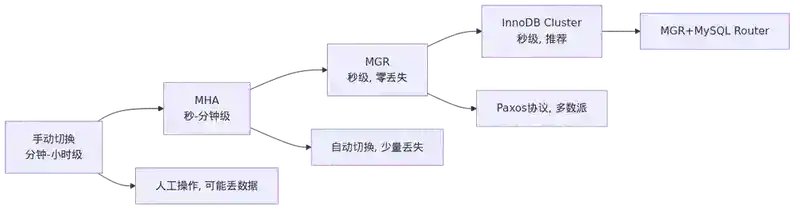
二、传统主从 + 手动切换
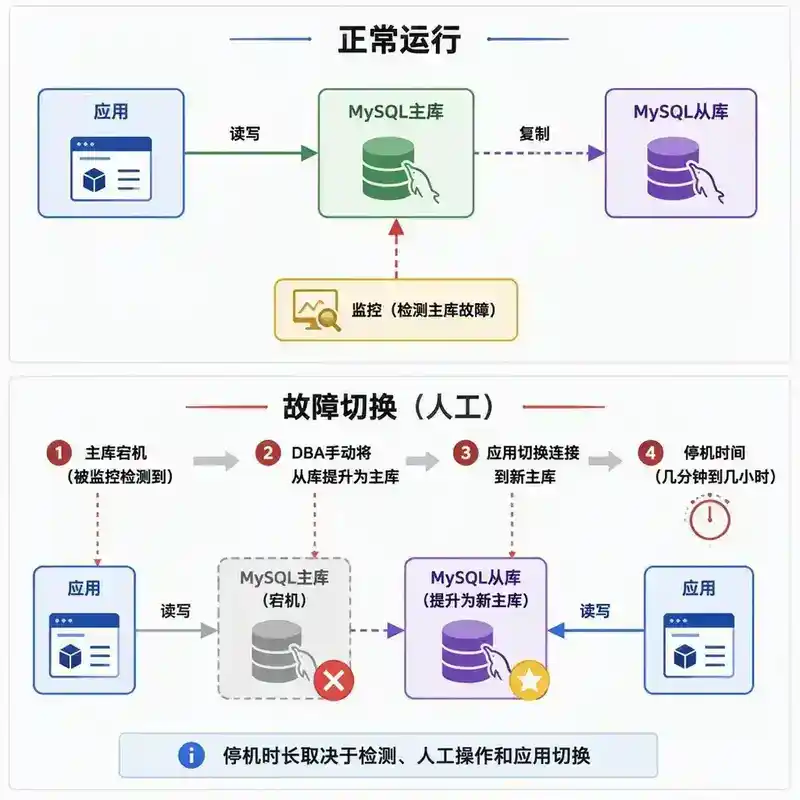
2.1 架构
主库 ←→ 从库(Standby)
  ↓ 故障
  人工介入:将从库提升为主库
2.2 缺点
- 切换时间长(分钟级到小时级)
- 需要人工判断和操作
- 可能丢失数据(异步复制)
2.3 提升
使用 MHA(Master High Availability) 或 Orchestrator 实现自动切换:
- 监控主库状态
- 自动选择最优从库提升为主库
- 自动补全 relay log 减少数据丢失
- 切换时间:秒级到分钟级
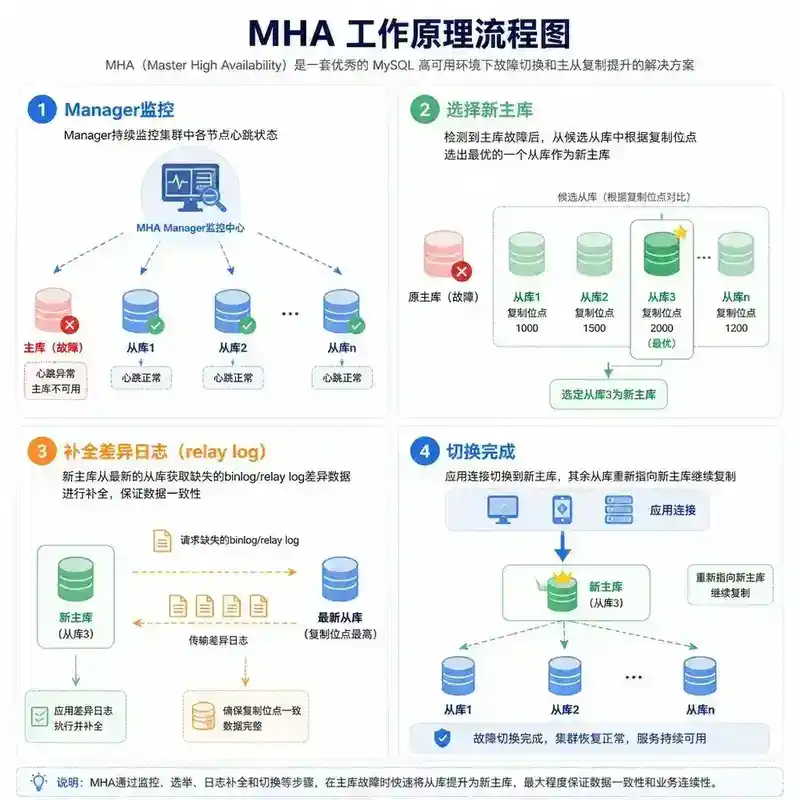
三、MHA(Master High Availability)
3.1 MHA 工作原理
MHA Manager 监控主库
  ↓ 主库故障
1. 选择最新从库
2. 从其他从库拉取差异 relay log
3. 应用到新主库(补全数据)
4. 新主库接管服务
5. 其他从库重新指向新主库
3.2 MHA 的局限
- 依赖 SSH 和 Perl
- 单 Manager 节点可能成为瓶颈
- 不支持 MySQL 8.0 的 GTID 增强功能
- 已停止维护
四、MySQL Group Replication(MGR)
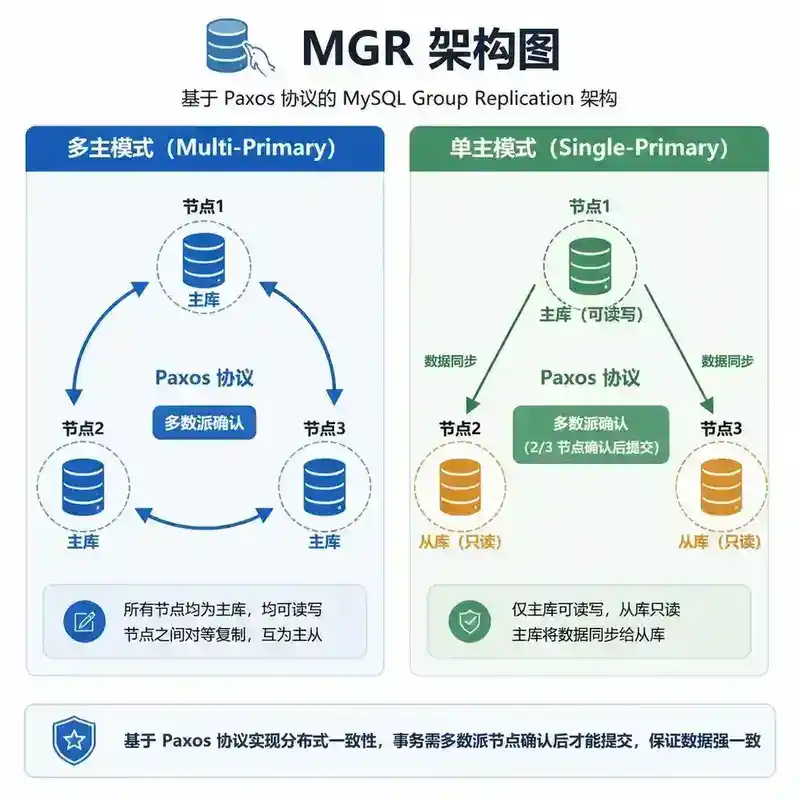
4.1 MGR 架构
MGR 是 MySQL 5.7+ 官方提供的多主复制方案,基于 Paxos 协议。
┌─────────────────────────────┐
│  MGR 集群(3 节点)          │
│  ┌───────┐ ┌───────┐ ┌───────┐ │
│  │ Node1 │ │ Node2 │ │ Node3 │ │
│  │ 主     │ │ 主     │ │ 主     │ │
│  └───────┘ └───────┘ └───────┘ │
│  多数派确认后才提交            │
└─────────────────────────────┘
4.2 单主模式 vs 多主模式
| 模式 | 写入 | 冲突 | 适用场景 |
|---|---|---|---|
| 单主 | 只有主节点写入 | 无 | 大多数场景 |
| 多主 | 所有节点可写入 | 可能冲突 | 跨地域写入 |
4.3 MGR 的优势
- 自动故障切换(秒级)
- 零数据丢失(多数派确认)
- 自动节点加入和恢复
- MySQL 官方支持
五、故障检测
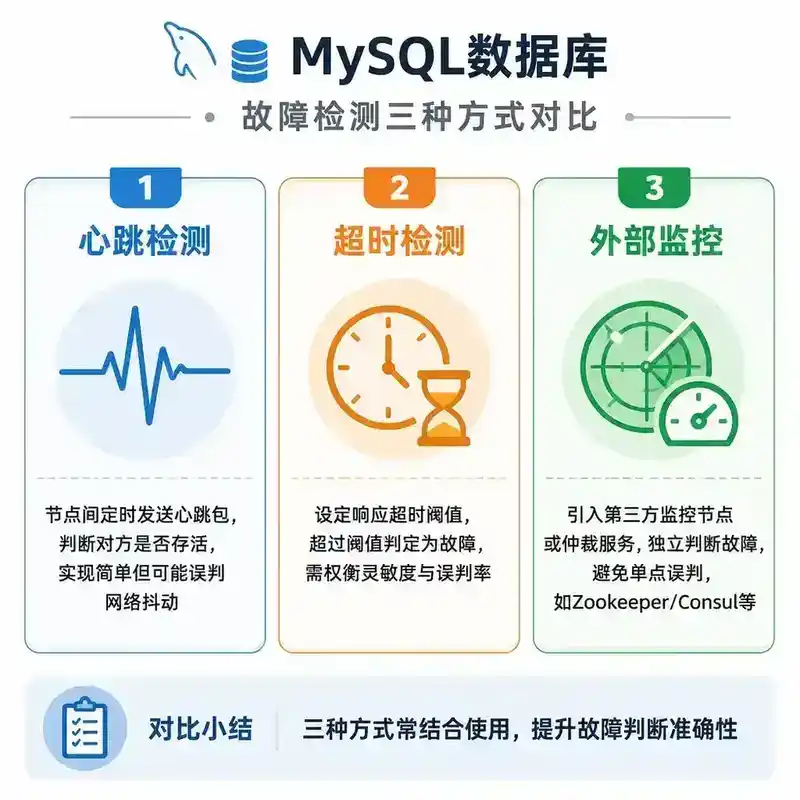
5.1 检测方式
| 方式 | 实现 | 检测时间 |
|---|---|---|
| 心跳检测 | 定期探测主库 | 秒级 |
| 超时检测 | 连接超时 | 秒级 |
| 外部监控 | Prometheus + 告警 | 分钟级 |
5.2 MGR 的故障检测
MGR 使用 Paxos 协议的心跳机制,如果节点在 5 秒内没有响应,会被标记为 SUSPICIOUS,10 秒后标记为 UNREACHABLE。
5.3 误判问题
- 网络抖动可能导致误判为故障
- 需要设置合理的超时时间
- MGR 的
group_replication_member_expel_timeout控制驱逐超时
六、脑裂与防护
6.1 什么是脑裂
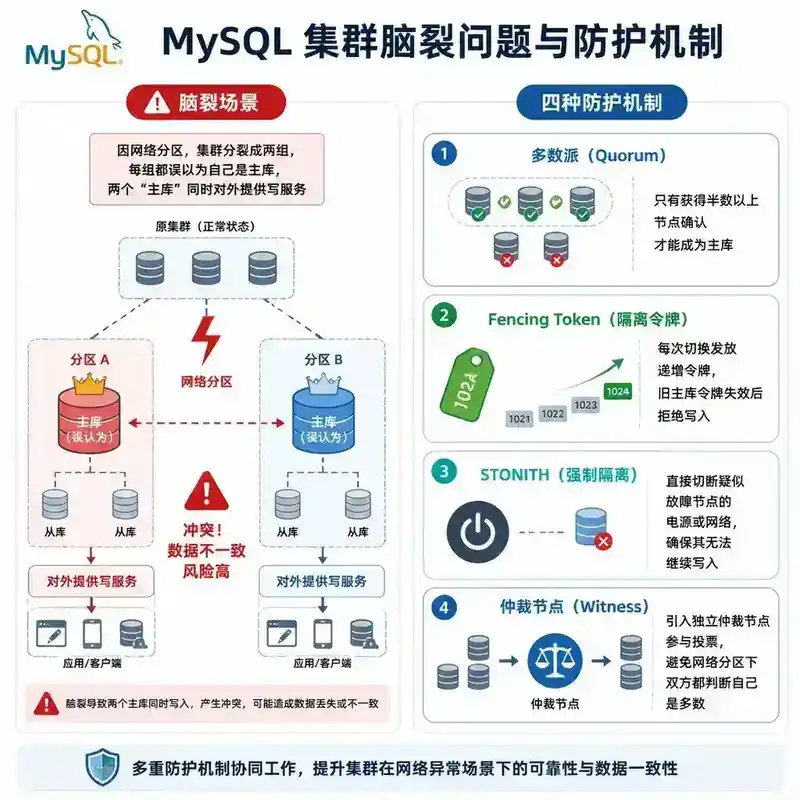
脑裂(Split Brain):网络分区导致集群分裂为两个子集群,每个子集群都认为自己是主,同时对外提供服务,导致数据不一致。
Node1 ←→ Node2 ←→ Node3
  ↓ 网络分区
Node1 (主) ←→ Node2 (主)  ← 两个主!
6.2 脑裂的防护
| 方案 | 原理 |
|---|---|
| 多数派(Quorum) | 只有获得多数票的节点才能成为主(MGR) |
| Fencing Token | 旧主被隔离后,无法写入(Redis Sentinel) |
| STONITH | 直接关闭旧主节点(物理隔离) |
| 仲裁节点 | 额外节点参与投票,打破平局 |
MGR 的脑裂防护: 使用 Paxos 协议,多数派确认,3 节点最多允许 1 个节点故障,5 节点最多允许 2 个节点故障。
七、数据恢复
7.1 切换后的数据恢复
| 场景 | 恢复方式 |
|---|---|
| 从库提升为主库 | 旧主恢复后变为从库,重新同步 |
| MGR 节点重新加入 | 自动从集群获取增量数据 |
| 数据丢失(异步复制) | 从 binlog 备份恢复丢失的数据 |
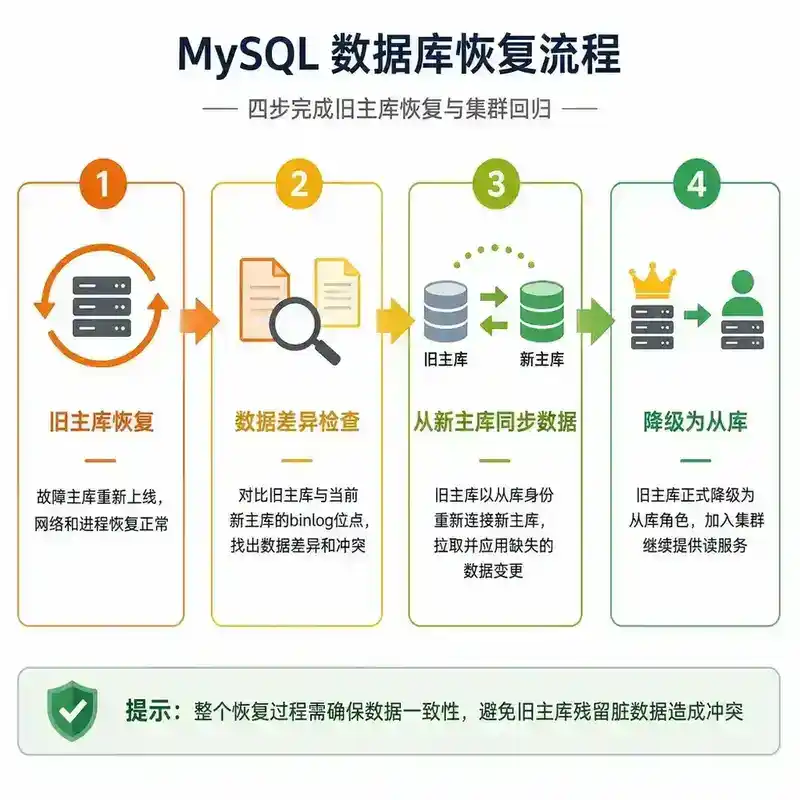
7.2 旧主恢复
1. 旧主宕机 → 从库提升为新主
2. 旧主恢复 → 检查数据差异
3. 差异数据 → 从 binlog 备份或新主补齐
4. 旧主变为从库 → 指向新主,开始复制
7.3 永远不要直接启动旧主
旧主恢复后,可能有一些未同步到新主的数据。如果直接启动旧主作为主库,这些数据会导致主从不一致。正确做法是:旧主恢复后作为从库,从新主同步数据。
八、总结
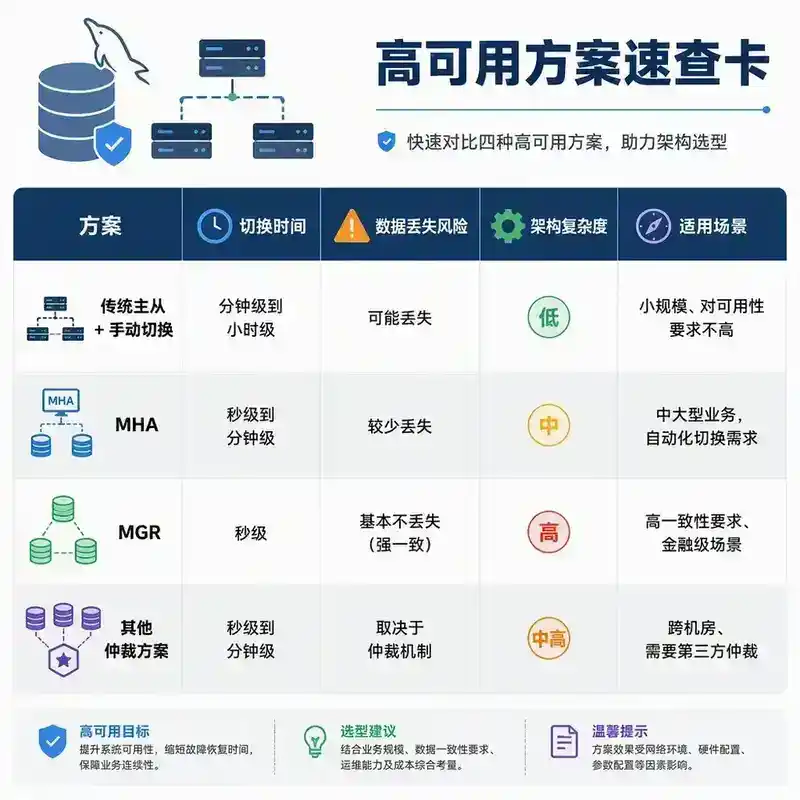
| 方案 | 切换时间 | 数据丢失 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 手动切换 | 分钟-小时 | 可能 | 低 | 非关键业务 |
| MHA | 秒-分钟 | 少量 | 中 | 传统主从 |
| MGR | 秒 | 零 | 高 | 金融级 |
| InnoDB Cluster | 秒 | 零 | 低 | 推荐 |
九、面试官视角提问
Q1:MHA 切换时如何补全 relay log?如果补全失败怎么办?
Q2:MGR 3 节点集群,1 个节点宕机,还能正常工作吗?2 个节点宕机呢?为什么?
Q3:脑裂发生后,旧主上写入的数据和旧主重新加入集群后的数据恢复,如何处理?
Q4:MGR 和传统主从 + MHA 相比,写入性能有什么区别?为什么 MGR 的写入延迟更高?
Q5:你如何设计一个跨机房的高可用 MySQL 集群?两个机房各 3 个节点,机房之间网络中断怎么办?
Q6:**group_replication_member_expel_timeout**设得太小和太大分别有什么问题?如何合理设置?
作者注:本文为系列第 128 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:MHA 切换时如何补全 relay log?补全失败怎么办?
参考答案:
补全流程: MHA 选择最新从库后,从其他从库拉取该从库缺失的 relay log,应用到新主库,确保数据最完整。
补全失败:
- 如果无法从其他从库获取 relay log(如其他从库也宕机),则放弃补全,接受部分数据丢失
- 如果主库 SSH 可达,MHA 会尝试从主库直接拉取 binlog
- 如果 binlog 也无法获取,标记为数据丢失,记录在 MHA 日志中
MHA 不能保证零丢失: 因为补全依赖其他从库,如果只有主库和一个从库,主库宕机后从库的 relay log 可能不完整。
Q2:MGR 3 节点集群,1 个宕机还能工作吗?2 个呢?
参考答案:
1 个节点宕机:可以正常工作。 剩余 2 个节点仍能形成多数派(2/3),可以继续写入和读取。
2 个节点宕机:不能正常工作。 剩余 1 个节点无法形成多数派(1/3),集群进入只读状态,不能写入。
MGR 的容错公式: N 个节点的集群,最多容忍 (N-1)/2 个节点故障。3 节点最多容忍 1 个,5 节点最多容忍 2 个。
Q3:脑裂后旧主写入的数据和旧主重新加入集群,数据如何处理?
参考答案:
MGR 的处理: 旧主被多数派驱逐后,旧主上的写入会被拒绝(因为无法获得多数派确认)。如果旧主上确实有未提交的事务,重新加入集群时:
- 旧主作为新节点加入,从集群获取最新数据
- 旧主上未提交的事务会被回滚
- 如果旧主在脑裂期间被配置为独立 MySQL 并有写入,这些数据与集群数据冲突,需要手动处理
传统主从的处理: 旧主恢复后,绝对不能直接启动为主库。必须作为从库从新主同步,旧主上多余的数据会被覆盖。
Q4:MGR 和传统主从+MHA 相比,写入性能有什么区别?
参考答案:
MGR 的写入延迟更高,因为需要多数派确认。
传统主从: 主库提交即返回,从库异步同步。写入延迟 = 主库本地提交时间。
MGR: 需要将事务发送给所有节点,多数派确认后才提交。写入延迟 = 主库本地提交 + 网络往返 + 多数派节点确认时间。
性能差异: MGR 的写入延迟通常是传统主从的 2-3 倍。跨机房部署时延迟更高。
优化: 使用 group_replication_consistency=AFTER 在需要强一致性的场景,BEFORE 在需要性能的场景。
Q5:跨机房 MySQL 高可用,两个机房各 3 节点,机房间网络中断怎么办?
参考答案:
不能使用 3+3 的对称部署。 机房间网络中断后,每个机房只有 3 个节点,无法形成多数派(需要 4 个),两个机房都不可用。
正确方案:机房 1 部署 3 个节点,机房 2 部署 2 个节点 + 1 个仲裁节点。
- 机房 1 故障:机房 2 的 3 个节点(2+1)形成多数派,接管服务
- 机房 2 故障:机房 1 的 3 个节点形成多数派,继续服务
- 机房间网络中断:机房 1 的 3 个节点形成多数派,机房 2 不可用
Q6: 设得太小和太大分别有什么问题?
参考答案:
太小(如 1 秒): 网络抖动可能被误判为节点故障,频繁驱逐和重新加入,导致集群不稳定。
太大(如 60 秒): 真正的节点故障需要 60 秒才能被检测到,切换时间过长,服务中断时间长。
合理设置: 5-10 秒。既能容忍短暂的网络抖动,又能在合理时间内检测到真正的故障。具体取决于网络质量。
全文完 | 编号 128 | 分类 08 MySQL 与关系型数据库