阅读时间:约 45 分钟 | 难度:中高级 | 编号:129
一、引言:容量规划是"防患于未然"
数据库容量规划不是"出了问题再扩容",而是在系统设计阶段就预估增长趋势,提前规划资源。好的容量规划可以避免 80% 的线上故障。
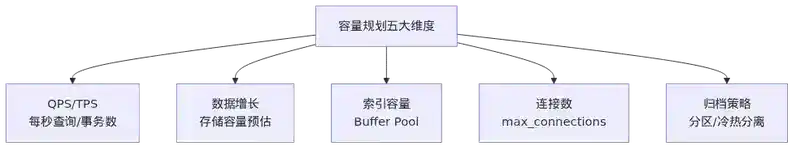
容量规划的五个维度: QPS/TPS、数据增长、索引容量、连接数、归档策略。
二、QPS/TPS 估算
2.1 QPS vs TPS
| 指标 | 含义 | 计算方式 |
|---|---|---|
| QPS | 每秒查询数 | Questions / Uptime |
| TPS | 每秒事务数 | (Com_commit + Com_rollback) / Uptime |
2.2 容量估算公式
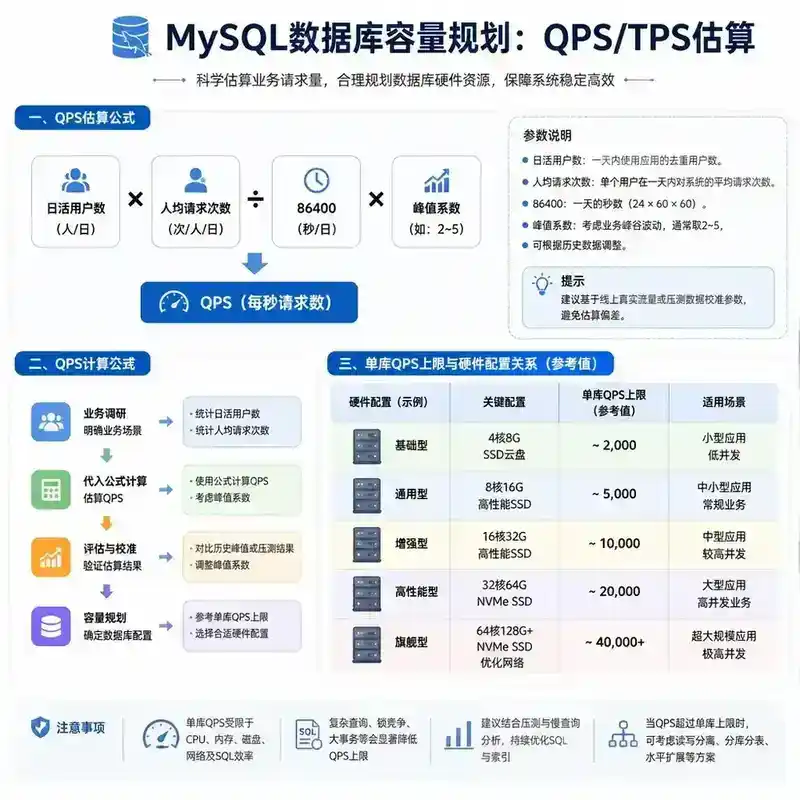
所需 QPS = 日活用户 × 人均请求数 / 86400 × 峰值系数
峰值系数 = 2~5(电商大促可能到 10)
示例: 100 万日活,人均 50 次请求,峰值系数 3
所需 QPS = 1,000,000 × 50 / 86400 × 3 ≈ 1736 QPS
2.3 单库 QPS 上限
| 场景 | 预估 QPS 上限 |
|---|---|
| 简单查询(主键) | 10,000-50,000 |
| 复杂查询(JOIN) | 1,000-5,000 |
| 写入(INSERT) | 5,000-20,000 |
| 混合读写 | 3,000-10,000 |
三、数据增长预估
3.1 数据增长模型
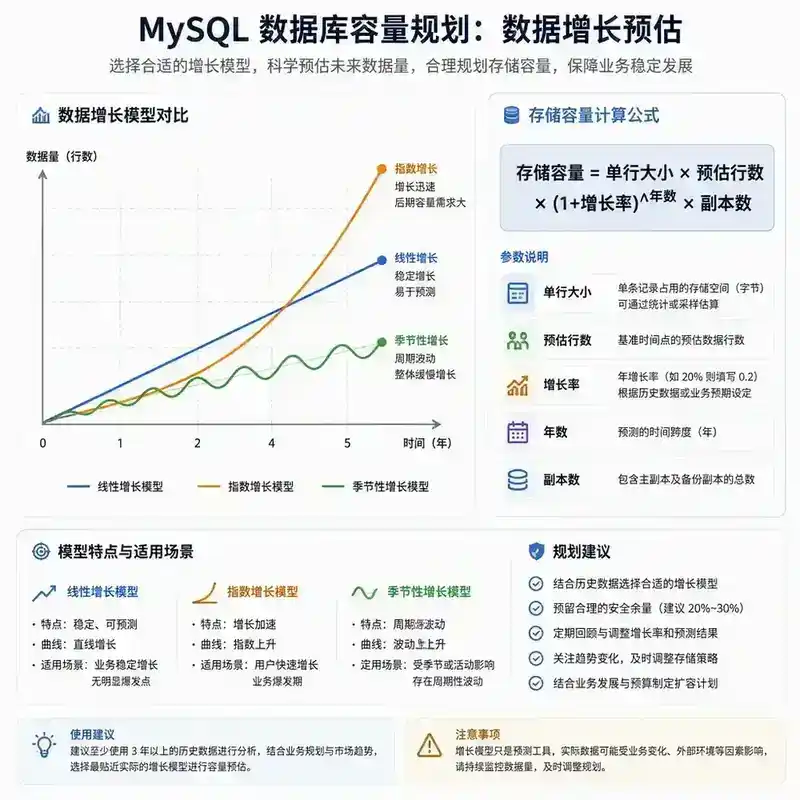
| 增长类型 | 说明 | 示例 |
|---|---|---|
| 线性增长 | 每天固定增长 | 日志表:每天 100 万行 |
| 指数增长 | 增长率递增 | 社交数据:用户越多,数据越多 |
| 季节性增长 | 定期波动 | 电商:大促期间暴增 |
3.2 存储容量计算
存储容量 = 数据大小 + 索引大小 + 日志大小 + 备份大小 + 预留空间

数据大小 = 每行大小 × 预估行数
索引大小 ≈ 数据大小 × 0.3~1.0(取决于索引数量)
日志大小 = binlog 大小 + redo log 大小 + undo log 大小
备份大小 = 全量备份 × 保留份数
预留空间 = (数据 + 索引 + 日志) × 0.5
3.3 容量告警阈值
| 阈值 | 动作 |
|---|---|
| 60% | 开始规划扩容 |
| 70% | 执行扩容 |
| 80% | 紧急扩容 |
| 90% | 危险!立即处理 |
四、索引容量规划
4.1 索引大小估算
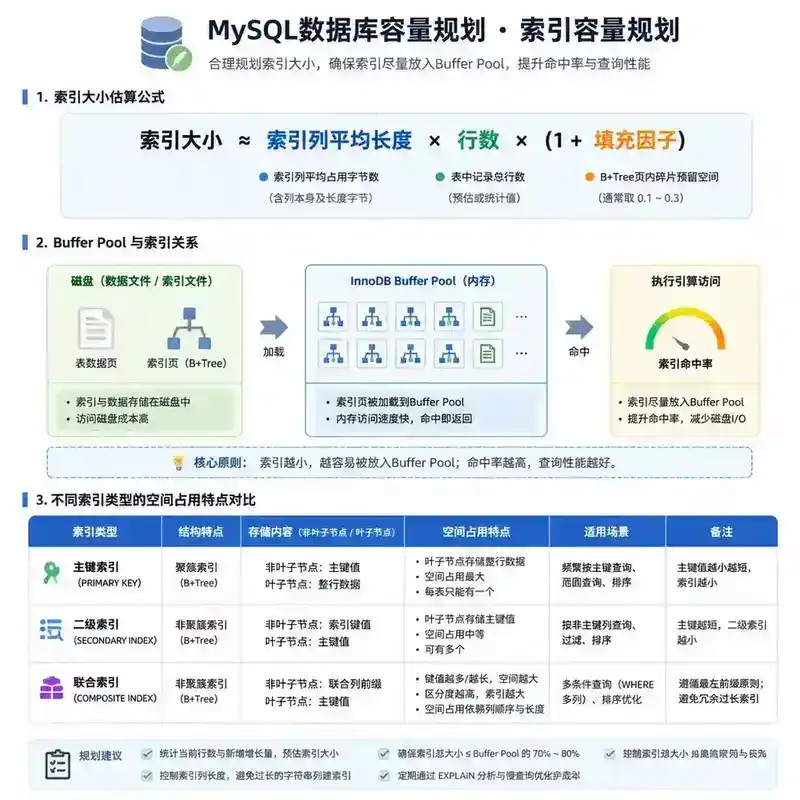
单列索引大小 ≈ 表行数 × (索引列大小 + 主键大小) × 1.5
联合索引大小 ≈ 表行数 × (所有索引列大小 + 主键大小) × 1.5

示例:1000 万行,BIGINT(8) 主键,VARCHAR(50) 索引
索引大小 ≈ 10,000,000 × (50 + 8) × 1.5 ≈ 870 MB
4.2 索引数量限制
- 建议每个表不超过 5-6 个索引
- 索引越多,写入越慢,空间越大
- 定期检查并删除未使用索引
4.3 Buffer Pool 与索引
Buffer Pool 大小 ≥ 热数据 + 热索引
如果 Buffer Pool 不够大,索引页频繁换入换出,性能骤降
五、连接数规划
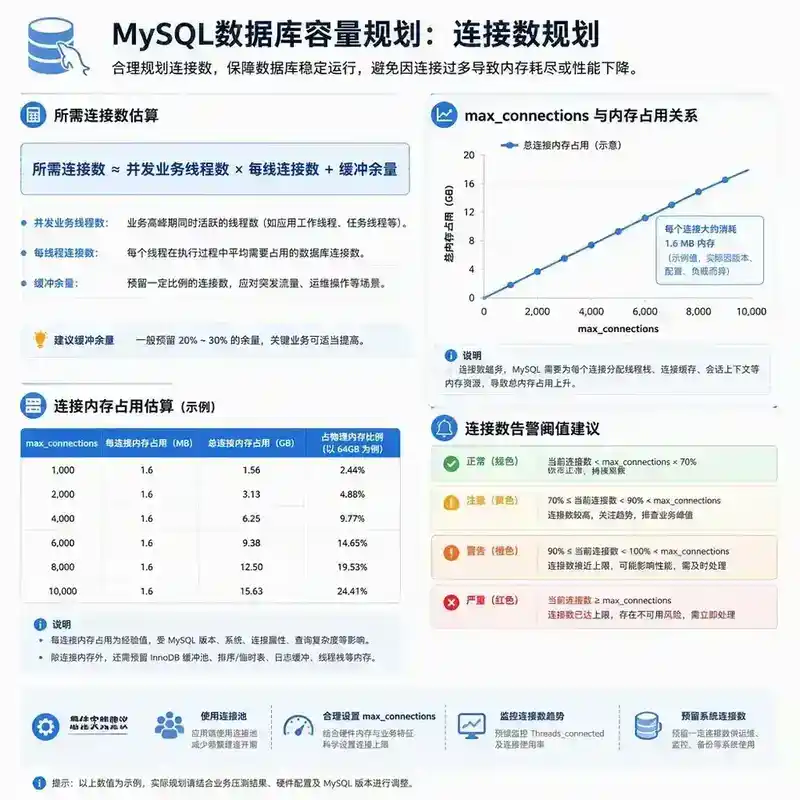
5.1 连接数估算
所需连接数 = 应用实例数 × 连接池大小 + 预留连接

示例:20 个应用实例,每实例连接池 20
所需连接数 = 20 × 20 + 50 = 450
5.2 连接数上限
-- 最大连接数
SHOW VARIABLES LIKE 'max_connections';  -- 默认 151

-- 当前连接数
SHOW STATUS LIKE 'Threads_connected';

-- 历史最大连接数
SHOW STATUS LIKE 'Max_used_connections';
5.3 连接数过多的危害
- 每个连接占用内存(约 256KB-512KB)
- 1000 个连接 = 256MB-512MB 内存
- 上下文切换开销
- 建议:单个 MySQL 实例连接数不超过 1000
六、数据归档策略
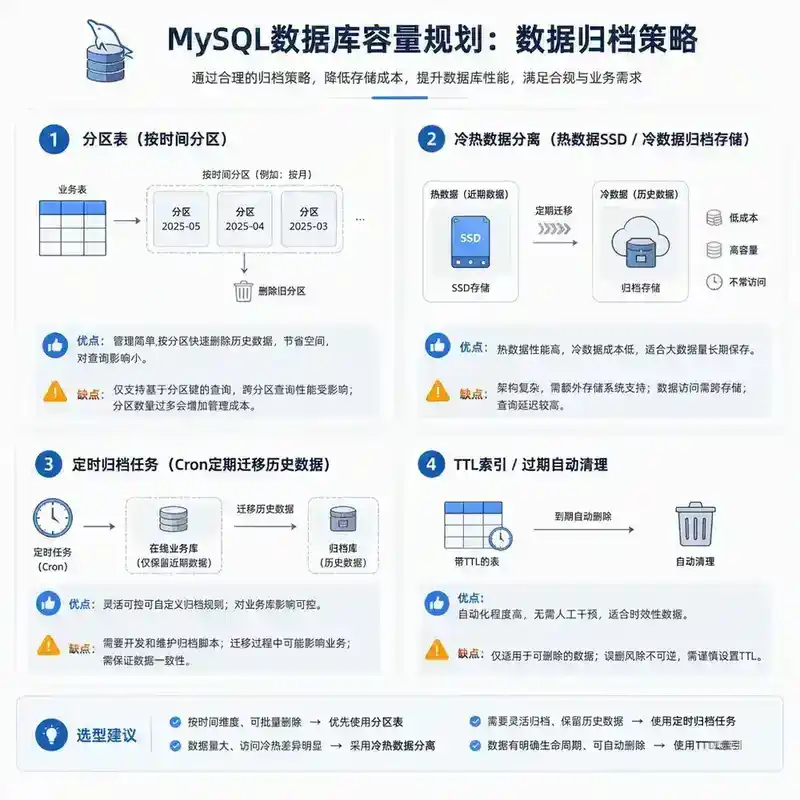
6.1 归档方案
| 方案 | 说明 | 适用场景 |
|---|---|---|
| 分区表 | 按时间分区,定期删除旧分区 | 日志类数据 |
| 冷热分离 | 热数据在 MySQL,冷数据在对象存储 | 历史订单 |
| 定时归档 | 定期将旧数据迁移到归档库 | 通用场景 |
| TTL 索引 | 数据带过期时间,自动清理 | MongoDB 风格 |
6.2 归档实践
-- 创建分区表
CREATE TABLE logs (
    id BIGINT, ts TIMESTAMP, msg TEXT
) PARTITION BY RANGE (UNIX_TIMESTAMP(ts)) (
    PARTITION p202401 VALUES LESS THAN (UNIX_TIMESTAMP('2024-02-01')),
    PARTITION p202402 VALUES LESS THAN (UNIX_TIMESTAMP('2024-03-01'))
);

-- 删除旧分区(秒级完成)
ALTER TABLE logs DROP PARTITION p202401;
七、容量规划工具
7.1 监控指标
-- QPS
SHOW STATUS LIKE 'Questions';

-- TPS
SHOW STATUS LIKE 'Com_commit';

-- 连接数
SHOW STATUS LIKE 'Threads_connected';

-- Buffer Pool 命中率
SHOW STATUS LIKE 'Innodb_buffer_pool_read_requests';
SHOW STATUS LIKE 'Innodb_buffer_pool_reads';
-- 命中率 = read_requests / (read_requests + reads)
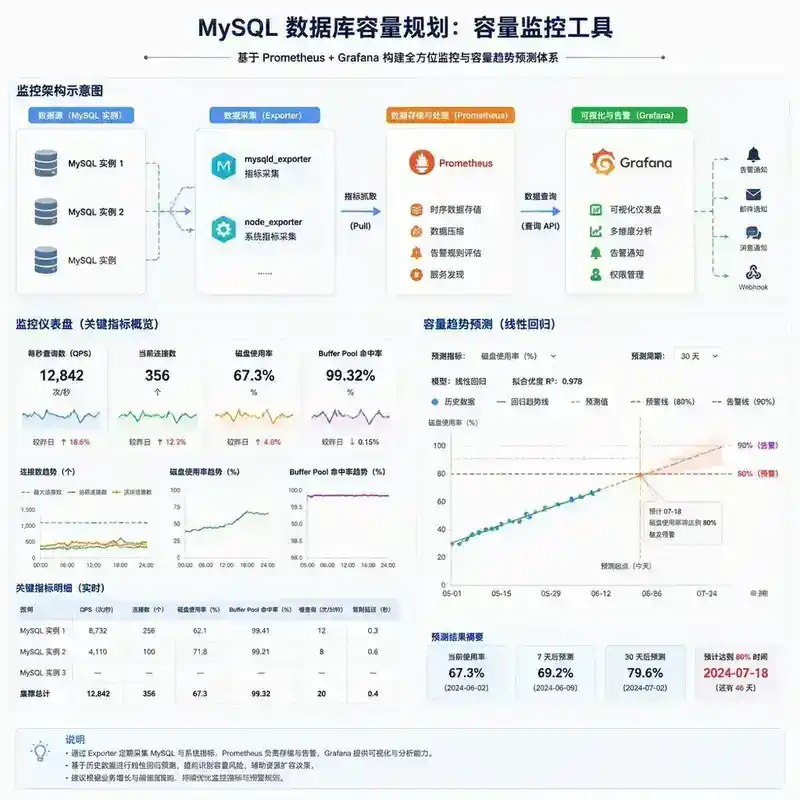
7.2 容量趋势分析
- Prometheus + Grafana 展示历史趋势
- 线性回归预测未来容量
- 设置告警,提前预警
八、总结
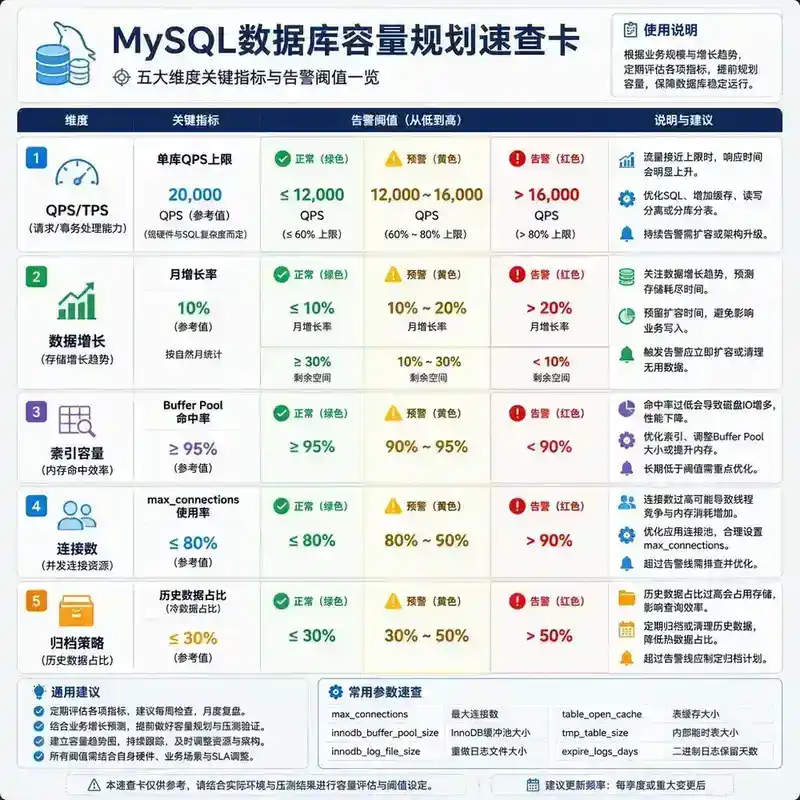
| 维度 | 关键指标 | 告警阈值 |
|---|---|---|
| QPS | 当前 / 上限 | > 70% |
| 数据量 | 当前 / 磁盘 | > 60% |
| 索引 | 数量 / 大小 | 每个表 ≤ 6 个 |
| 连接数 | 当前 / max | > 70% |
| Buffer Pool | 命中率 | < 99% |
九、面试官视角提问
Q1:100 万日活,人均 30 次请求,读写比 3:1。需要多少 QPS 的数据库?如果是大促(峰值 5 倍),需要多少 QPS?
Q2:一个表每天增长 100 万行,每行约 500 字节,有 3 个二级索引。一年后需要多少磁盘空间?如果 Buffer Pool 是 8GB,能装下所有数据吗?
Q3:**max_connections=1000**,但**Threads_connected=200**时数据库已经响应缓慢。可能的原因是什么?
Q4:一个 10 亿行的日志表,查询**WHERE ts > '2024-01-01'**很慢。如何通过分区表优化?分区表的选择原则是什么?
Q5:Buffer Pool 命中率从 99.9% 降到 95%,对数据库性能有什么影响?如何排查和处理?
Q6:你如何设计一个容量规划系统?需要监控哪些指标?如何设置告警?如何预测未来容量?
作者注:本文为系列第 129 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:100 万日活,人均 30 次请求,读写比 3:1,需要多少 QPS?大促峰值 5 倍呢?
参考答案:
日常 QPS: 100万 × 30 / 86400 × 2(峰值系数)≈ 694 QPS
大促 QPS: 694 × 5 = 3,470 QPS
读写分离后的读 QPS: 3,470 × 0.75 = 2,603 QPS(读),3,470 × 0.25 = 868 QPS(写)
结论: 日常 1 主 1 从足够。大促需要 1 主 2 从(读 QPS 分摊到 2 个从库,每个约 1300 QPS)。
Q2:每天增长 100 万行,每行 500 字节,3 个二级索引,一年后需要多少磁盘空间?
参考答案:
数据大小: 365 × 100万 × 500B = 182.5 GB
索引大小: 每个二级索引约 100万 × (8 + 50) × 1.5 ≈ 87 MB/天。3 个索引 × 365 天 × 87 MB ≈ 95 GB
总大小: 182.5 + 95 ≈ 277.5 GB。加上 binlog/redo/undo(约 50GB),预留 50%,约 500 GB。
Buffer Pool 8GB: 只能装下 8GB / 16KB ≈ 500,000 个页。277.5 GB / 16KB ≈ 17,000,000 个页。只能装下 3% 的数据,大部分查询需要磁盘 I/O。
Q3:max_connections=1000,Threads_connected=200 时就很慢,为什么?
参考答案:
可能原因:
- 单个连接占用内存:200 个连接 × 512KB ≈ 100MB,但每个连接还可能有临时表、排序缓冲区等额外内存
- 上下文切换:200 个并发线程,CPU 大量时间花在切换上
- 锁竞争:大量连接同时操作同一行,锁等待严重
- 磁盘 I/O 饱和:磁盘 I/O 跟不上请求量
排查:SHOW PROCESSLIST 看连接状态,SHOW ENGINE INNODB STATUS 看锁等待。
Q4:10 亿行日志表, 很慢,如何用分区表优化?
参考答案:
分区表优化: 按 ts 字段按月分区,查询时只扫描需要的分区。
CREATE TABLE logs (
    id BIGINT, ts TIMESTAMP, msg TEXT
) PARTITION BY RANGE (YEAR(ts) * 100 + MONTH(ts)) (
    PARTITION p202401 VALUES LESS THAN (202402),
    PARTITION p202402 VALUES LESS THAN (202403),
    ...
);
分区裁剪:WHERE ts > '2024-01-01' 只扫描 2024-01 及之后的分区,不需要扫描整个表。
选择原则: 分区键应该频繁出现在 WHERE 条件中,且每个分区大小适中(不超过 10GB)。
Q5:Buffer Pool 命中率从 99.9% 降到 95%,有什么影响?如何排查?
参考答案:
影响: 5% 的查询从内存命中变为磁盘 I/O。如果 QPS 为 5000,每秒多出 250 次磁盘 I/O。每次磁盘 I/O 约 100μs(SSD),延迟增加 250 × 100μs = 25ms/秒。
排查:
- 查看是否有新上线的查询扫描大量数据
- 是否有大表 JOIN 操作污染了 Buffer Pool
SHOW STATUS LIKE 'Innodb_buffer_pool_pages_data'查看 Buffer Pool 使用情况- 增加 Buffer Pool 大小或优化查询
Q6:如何设计一个容量规划系统?
参考答案:
监控指标: QPS、TPS、磁盘使用率、连接数、Buffer Pool 命中率、复制延迟
告警设置: 磁盘 > 60% 黄色告警,> 70% 红色告警。QPS 接近上限 60% 告警。Buffer Pool 命中率 < 99% 告警。
预测: 使用线性回归分析历史数据趋势,预测未来 3 个月、6 个月的容量需求。结合业务增长计划(如新增用户、新增功能)调整预测。
自动化: 定期生成容量报告,自动告警,与扩容流程联动。
全文完 | 编号 129 | 分类 08 MySQL 与关系型数据库