阅读时间:约 45 分钟 | 难度:中高级 | 编号:114
一、引言:为什么单列索引不够用?
在真实业务中,很少有查询只涉及一个条件。更常见的是:
SELECT * FROM orders WHERE user_id = 100 AND status = 'PAID' ORDER BY create_time DESC;
如果只在 user_id 上建索引,status 的过滤需要在回表后判断;如果只在 status 上建索引,user_id 的过滤同样低效。这就是联合索引(Composite Index)的用武之地。
联合索引的本质: 将多个列的值组合成一个"复合键",按列顺序构建 B+Tree。理解联合索引,就是理解 MySQL 索引优化的核心。
二、联合索引的存储结构
2.1 联合索引的 B+Tree 组织
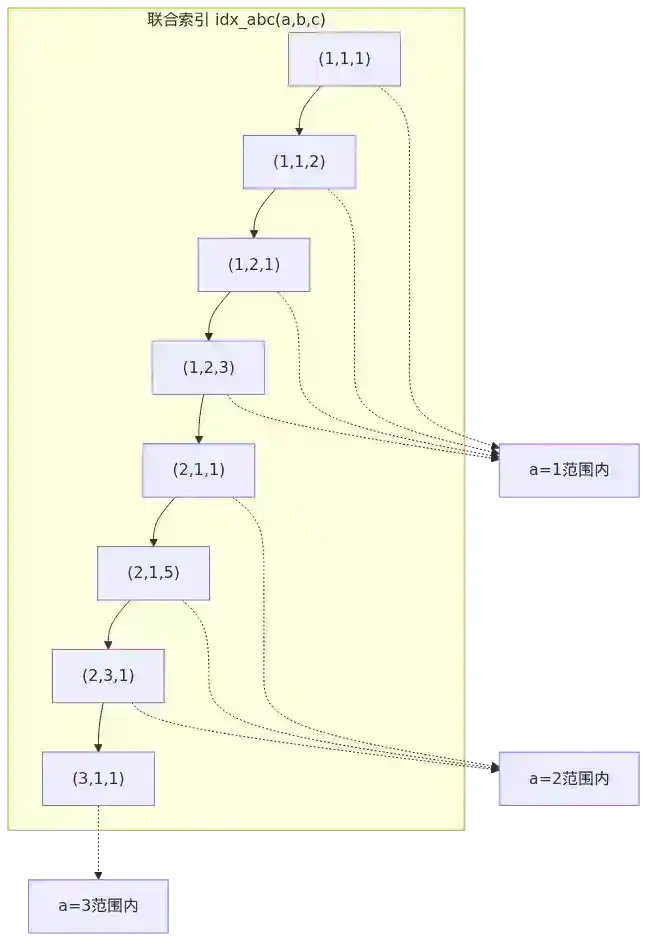
联合索引 idx_abc (a, b, c) 的 B+Tree 结构:
非叶子节点: (a, b, c) + 页指针
叶子节点: (a, b, c) + 主键值
数据排序规则: 先按 a 排序,a 相同按 b 排序,b 相同按 c 排序。
索引 (a, b, c) 的实际存储顺序:
(1, 1, 1), (1, 1, 2), (1, 2, 1), (1, 2, 3),
(2, 1, 1), (2, 1, 5), (2, 3, 1), (2, 3, 2),
(3, 1, 1), (3, 2, 1), (3, 2, 4)
关键观察: 在索引中,a 是全局有序的,b 只在 a 相同的情况下有序,c 只在 a 和 b 都相同的情况下有序。
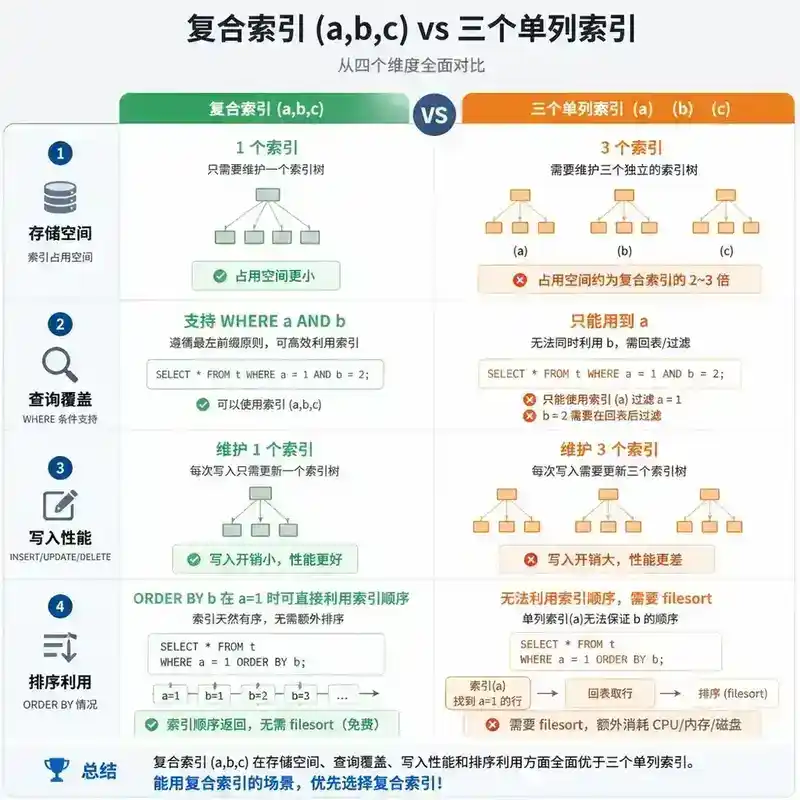
2.2 与三个单列索引的对比
-- 三个单列索引
CREATE INDEX idx_a ON t(a);
CREATE INDEX idx_b ON t(b);
CREATE INDEX idx_c ON t(c);
| 特性 | 联合索引 (a,b,c) | 三个单列索引 |
|---|---|---|
| 空间占用 | 1 个索引 | 3 个索引(约 3 倍空间) |
| WHERE a=1 | ✅ | ✅ |
| WHERE a=1 AND b=2 | ✅ | ⚠️ 可能只用 idx_a |
| WHERE b=2 | ❌ 无法使用 | ✅ |
| WHERE a=1 ORDER BY b | ✅ 免排序 | ❌ 需要 filesort |
| 写入性能 | 维护 1 个索引 | 维护 3 个索引 |
结论: 联合索引用更少的空间覆盖了更多的查询模式,但需要遵循最左前缀原则。
三、最左前缀原则:联合索引的"使用说明书"
3.1 什么是最左前缀
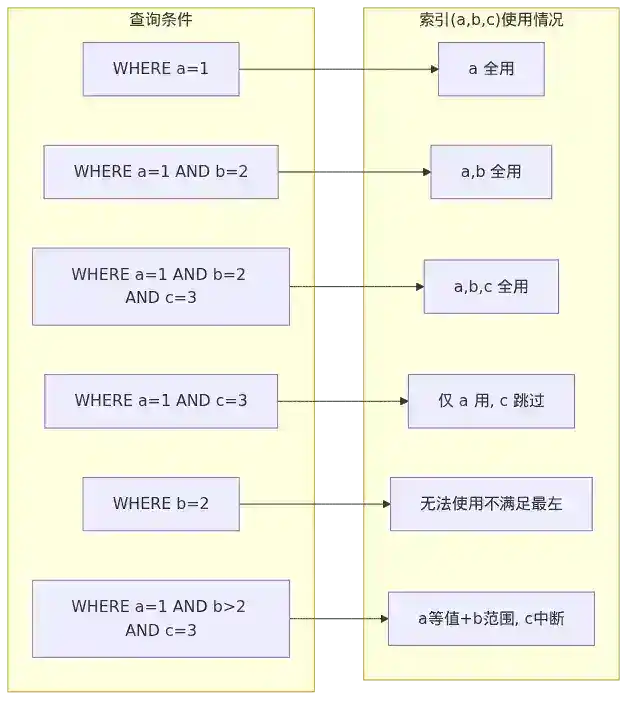
最左前缀原则: MySQL 使用联合索引时,必须从索引的最左列开始,且不能跳过中间的列。
对索引 idx_abc (a, b, c):
| 查询条件 | 是否使用索引 | 使用范围 |
|---|---|---|
WHERE a = 1 |
✅ | a |
WHERE a = 1 AND b = 2 |
✅ | a, b |
WHERE a = 1 AND b = 2 AND c = 3 |
✅ | a, b, c(全部) |
WHERE a = 1 AND c = 3 |
⚠️ | 只用 a,c 无法使用 |
WHERE b = 2 |
❌ | 无法使用(不满足最左) |
WHERE b = 2 AND c = 3 |
❌ | 无法使用(不满足最左) |
WHERE a = 1 AND b > 2 AND c = 3 |
⚠️ | a(等值) + b(范围),c 无法使用 |
3.2 为什么 b=2 无法使用 (a,b,c) 索引?
原因: 在联合索引 (a,b,c) 中,b 只在 a 相同的情况下有序。如果查询没有 a 的条件,b 在整棵 B+Tree 中是无序的,无法利用索引的排序特性进行高效查找。
索引中的 b 值顺序(没有 a 的约束):
a=1: b=1, 1, 2, 2
a=2: b=1, 1, 3, 3
a=3: b=1, 2, 2
b 的值在全局是:1, 1, 2, 2, 1, 1, 3, 3, 1, 2, 2——完全无序!
3.3 范围查询的"断点"效应
规则:范围查询会中断后续列的索引使用。
-- 索引 (a, b, c)
WHERE a = 1 AND b > 2 AND c = 3;
-- 使用: a (等值) + b (范围)
-- c 无法使用,因为 b 是范围查询,b 相等性被打破,c 不再有序
为什么? 在 b > 2 的条件下,b 的值不再相同(b=3, 4, 5...),c 在 b 不同的情况下是无序的。
a=1, b=1: c=1, 2, 5
a=1, b=2: c=3, 4, 6  ← b>2 从这里开始
a=1, b=3: c=1, 5, 7  ← c 在 b=3 内部有序,但跨 b 值无序
a=1, b=4: c=2, 3, 8
例外: 如果范围查询是 IN(多个等值),则后续列可以继续使用。
WHERE a = 1 AND b IN (2, 3) AND c = 5;
-- 使用: a (等值) + b (IN=多个等值) + c (等值)
-- IN 被视为多个等值查询,不会中断索引使用
四、覆盖索引:联合索引的"隐藏技能"
4.1 联合索引的覆盖能力
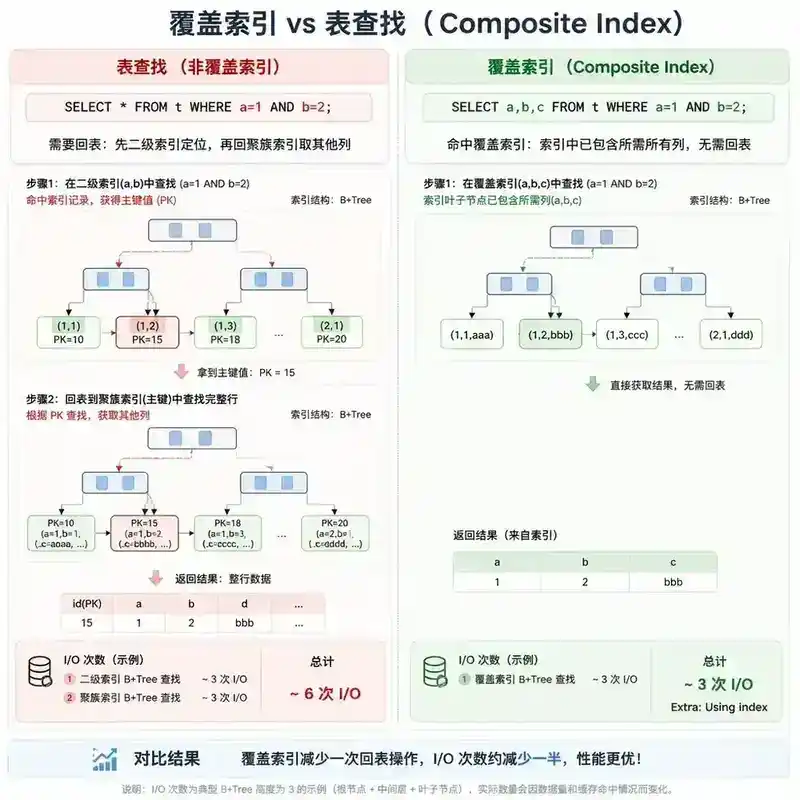
联合索引包含多个列,天然适合作为覆盖索引:
-- 索引: idx_user_status_time (user_id, status, create_time)

-- 覆盖索引:所有列都在索引中
SELECT user_id, status, create_time
FROM orders
WHERE user_id = 100 AND status = 'PAID';

-- 不需要回表!Extra: Using index
设计技巧: 即使查询不需要某个列,把它加入联合索引可以实现覆盖,避免回表。
-- 原查询
SELECT user_id, order_id FROM orders WHERE user_id = 100;

-- 如果 idx_user_id 只有 user_id,需要回表取 order_id(主键)
-- 创建 idx_user_id_order (user_id, order_id) 可以实现覆盖
4.2 覆盖索引的 EXPLAIN 标识
EXPLAIN SELECT user_id, status FROM orders
WHERE user_id = 100 AND status = 'PAID';

-- key: idx_user_status_time
-- Extra: Using index  ← 覆盖索引!
Using index 意味着查询只访问了索引,没有访问数据行。这是性能最优的标志。
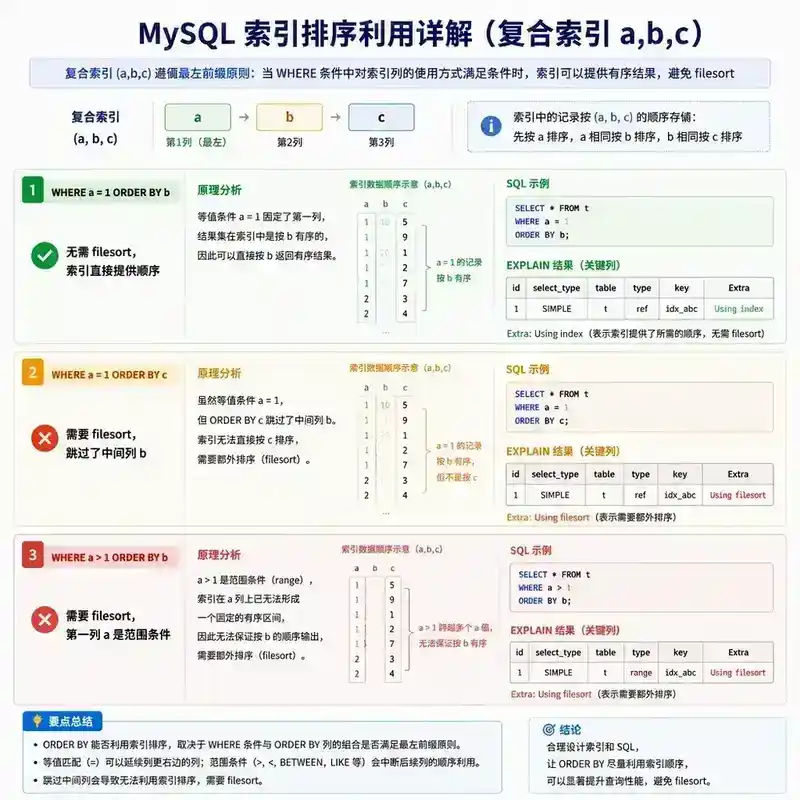
五、排序利用:联合索引的"免费 ORDER BY"
5.1 索引排序的原理
如果查询的 ORDER BY 列与索引的列顺序一致,MySQL 可以利用索引的有序性,避免 filesort。
-- 索引: idx_ab (a, b)

-- 利用索引排序:ORDER BY 的列顺序与索引一致
SELECT * FROM t WHERE a = 1 ORDER BY b;
-- Extra: 无 Using filesort

-- 利用索引排序:a 等值,b 在 a 内有序
SELECT * FROM t WHERE a = 1 ORDER BY a, b;
-- Extra: 无 Using filesort

-- 无法利用索引排序:ORDER BY 列顺序与索引不一致
SELECT * FROM t WHERE a = 1 ORDER BY b, a;
-- Extra: Using filesort

-- 无法利用索引排序:跳过了 a
SELECT * FROM t WHERE a = 1 ORDER BY c;
-- Extra: Using filesort
5.2 排序利用的规则
索引排序的三大条件:
- ORDER BY 的列顺序必须与索引的列顺序一致
- ORDER BY 的列必须都在索引中(且不跳过中间的列)
- WHERE 条件中的等值列与 ORDER BY 列拼起来,必须满足最左前缀
索引 (a, b, c):

WHERE a = 1 ORDER BY b, c     ✅ 利用索引排序
WHERE a = 1 ORDER BY b        ✅ 利用索引排序
WHERE a = 1 ORDER BY c        ❌ 跳过 b,无法利用
WHERE a > 1 ORDER BY b, c     ❌ a 是范围,b 不再是 a 下的有序
WHERE a = 1 AND b = 2 ORDER BY c  ✅ 利用索引排序
WHERE a = 1 AND b > 2 ORDER BY c  ❌ b 是范围,c 不再有序
5.3 经典优化案例
-- 慢查询
SELECT * FROM orders
WHERE user_id = 100
ORDER BY create_time DESC
LIMIT 10;

-- 优化:创建联合索引
CREATE INDEX idx_user_time ON orders(user_id, create_time);

-- 优化后:索引直接提供排序,不需要 filesort
-- 但 SELECT * 需要回表 10 次
进一步优化(覆盖索引):
-- 如果只需要 user_id, create_time, order_id
CREATE INDEX idx_user_time_id ON orders(user_id, create_time, order_id);

SELECT user_id, create_time, order_id FROM orders
WHERE user_id = 100
ORDER BY create_time DESC
LIMIT 10;
-- Extra: Using index(覆盖索引 + 免排序)
六、索引下推(ICP)在联合索引中的应用
6.1 ICP 的工作机制
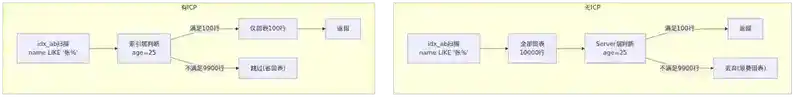
索引下推(Index Condition Pushdown) 是 MySQL 5.6 引入的优化,允许存储引擎在索引层过滤记录,减少回表。
-- 索引: idx_name_age (name, age)
SELECT * FROM users WHERE name LIKE '张%' AND age = 25;
没有 ICP:
- 在索引中扫描所有
name LIKE '张%'的行 - 对每一行都回表取完整数据
- 在 Server 层判断
age = 25
有 ICP:
- 在索引中扫描所有
name LIKE '张%'的行 - 在索引层直接判断
age = 25(age 在联合索引中) - 只有
age = 25的行才回表
性能差异: 如果 name LIKE '张%' 匹配 10000 行,但只有 100 行 age = 25,ICP 减少了 9900 次回表。
6.2 ICP 的适用条件
- 索引必须是联合索引
- WHERE 条件中引用了索引的非首列
- 不能用于覆盖索引(覆盖索引不需要回表,ICP 没有意义)
- 不能用于
type=ALL的全表扫描
七、联合索引设计实战
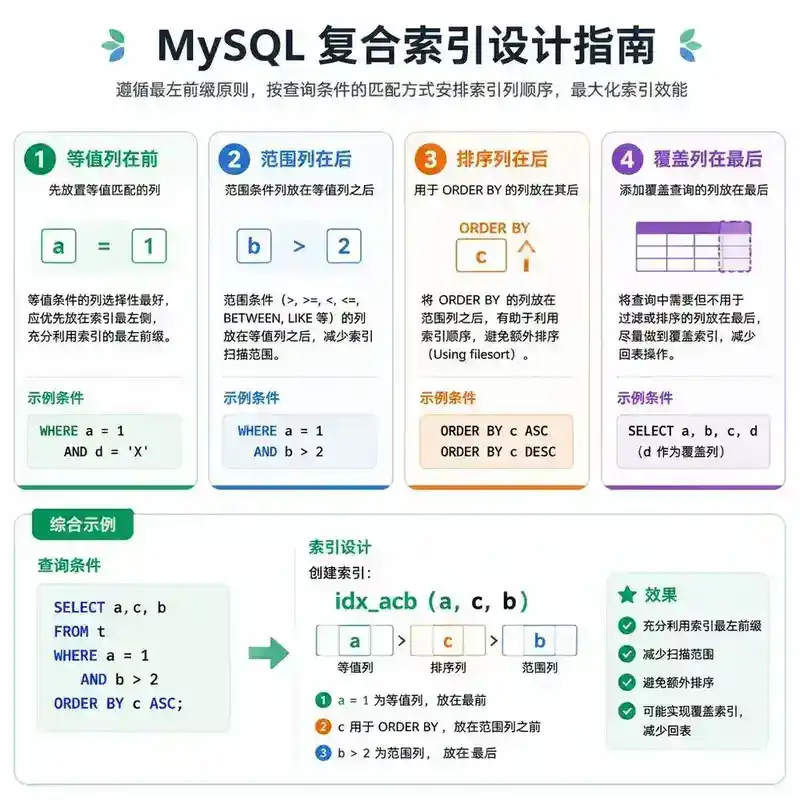
7.1 等值查询 + 范围查询 + 排序
场景: 订单列表查询
SELECT * FROM orders
WHERE user_id = 100 AND status = 'PAID'
ORDER BY create_time DESC
LIMIT 20;
索引设计:
-- 错误:status 是范围查询(IN),create_time 无法利用索引排序
CREATE INDEX idx_u_s_t ON orders(user_id, status, create_time);
-- 如果 status 是等值,这个索引最优
-- 如果 status 是 IN,create_time 排序需要 filesort

-- 正确:status 放后面,create_time 紧接等值列
CREATE INDEX idx_u_t_s ON orders(user_id, create_time, status);
-- WHERE user_id = 100: 等值,利用索引
-- ORDER BY create_time: user_id 等值,create_time 有序
-- status 过滤: 在索引中判断(ICP),或回表后判断
7.2 多个独立查询的索引设计
场景: 以下三个查询都很频繁:
-- Q1
SELECT * FROM t WHERE a = 1 AND b = 2;

-- Q2
SELECT * FROM t WHERE a = 1 ORDER BY c;

-- Q3
SELECT * FROM t WHERE b = 2 AND c = 3;
分析:
- Q1 需要
(a, b) - Q2 需要
(a, c),且ORDER BY c需要 a 等值后 c 有序 - Q3 需要
(b, c),但不能用(a, b, c)因为不满足最左前缀
方案:
-- 主索引:覆盖 Q1 和 Q2
CREATE INDEX idx_abc ON t(a, b, c);
-- Q1: a=1 AND b=2 ✅
-- Q2: a=1 ORDER BY c ✅

-- 辅助索引:覆盖 Q3
CREATE INDEX idx_bc ON t(b, c);
-- Q3: b=2 AND c=3 ✅
7.3 索引冗余判断
-- 已有索引
CREATE INDEX idx_ab ON t(a, b);

-- 是否还需要 idx_a?
CREATE INDEX idx_a ON t(a);
-- 答案:不需要!idx_ab 可以覆盖 WHERE a=1 的查询(最左前缀)
冗余索引规则:
(a, b)可以替代(a)— 不需要单独建(a)(a, b)不能替代(b)— 需要单独建(b)或(b, a)(a, b, c)可以替代(a)和(a, b)— 不需要单独建
八、常见陷阱
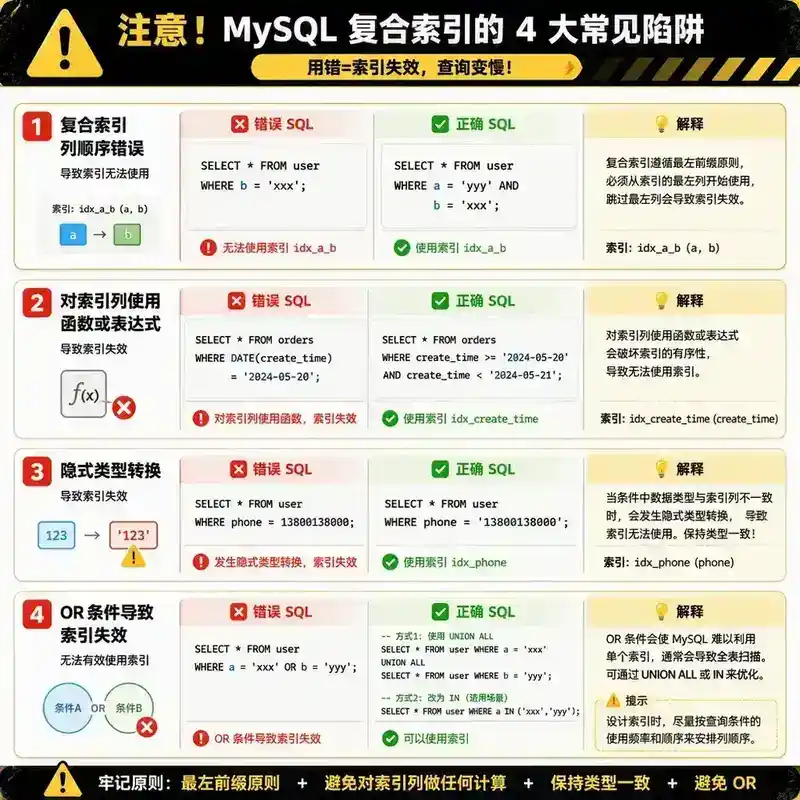
陷阱一:索引列顺序错误
-- 查询: WHERE a = 1 AND b = 2
-- 索引 (b, a): b 在前的索引对 WHERE a=1 AND b=2 也有效
-- 但查询稳定性不如 (a, b),因为 b 的选择性可能不如 a

-- 正确做法:高选择性的列放前面
CREATE INDEX idx_ab ON t(a, b);  -- a 的选择性高
陷阱二:函数导致索引失效
-- 索引 (create_time)
WHERE DATE(create_time) = '2024-01-01';  -- ❌ 索引失效
WHERE create_time >= '2024-01-01' AND create_time < '2024-01-02';  -- ✅ 使用索引
陷阱三:隐式类型转换
-- 索引 (phone VARCHAR)
WHERE phone = 13800138000;  -- ❌ 隐式转换,索引失效
WHERE phone = '13800138000';  -- ✅ 使用索引
陷阱四:OR 条件
-- 索引 (a), (b)
WHERE a = 1 OR b = 2;  -- ❌ 可能无法使用索引
-- 优化:
SELECT * FROM t WHERE a = 1 UNION SELECT * FROM t WHERE b = 2;
九、总结
联合索引是 MySQL 性能优化的核心武器:
- 最左前缀:查询必须从索引最左列开始,不能跳过
- 范围断点:范围查询中断后续列的索引使用(IN 除外)
- 覆盖索引:联合索引包含多列,天然适合覆盖
- 排序利用:ORDER BY 列顺序与索引一致时免排序
- ICP:索引下推在索引层过滤,减少回表
设计原则:等值列在前,范围列在后,排序列紧跟。
十、面试官视角提问
以下问题从面试官视角出发,考察候选人对联合索引的理解深度。不计入 40 分钟阅读时间。
Q1:索引 **(a, b, c)**,查询 **WHERE a = 1 AND c = 3**。b 没有被使用,c 能用上索引吗?为什么?如果把这个查询改成 **WHERE a = 1 AND c = 3 ORDER BY b**,排序能用上索引吗?
Q2:有一个查询 **WHERE a = 1 ORDER BY b LIMIT 10** 和另一个查询 **WHERE a > 1 ORDER BY b LIMIT 10**。它们对索引 **(a, b)** 的排序利用有什么不同?为什么?
Q3:索引 **(a, b, c)**,查询 **WHERE a = 1 AND b IN (2, 3) AND c = 4**。c 能用上索引吗?如果改成 **WHERE a = 1 AND b > 2 AND c = 4** 呢?区别在哪里?
Q4:表有 1000 万行,查询 **SELECT a, b FROM t WHERE a BETWEEN 1 AND 1000**。索引 **(a, b)** 和索引 **(a)** 在性能上有什么区别?如果是 **SELECT *** 呢?
Q5:索引 **(status, create_time)**,**status** 只有 3 个值('PENDING','PAID','CANCELLED'),分布均匀。查询 **WHERE status='PAID' ORDER BY create_time DESC LIMIT 10** 能高效利用这个索引吗?为什么?
Q6:一个表有两个高频查询:Q1: **WHERE a=1 AND b=2**,Q2: **WHERE b=2 AND c=3**。最少需要几个索引?请给出具体的索引设计和理由。
作者注:本文为系列第 114 篇,属于「08 MySQL 与关系型数据库」分类。
十一、面试官提问 · 参考答案
Q1:索引 ,查询 ,c 能用上索引吗? 呢?
参考答案:
c 不能用上索引。 因为跳过了 b。在联合索引 (a,b,c) 中,c 只在 a 和 b 都相同的情况下有序。WHERE a=1 确定了 a 的值,但 b 没有被约束,b 的值不同(b=1,2,3...),c 在 b 不同的情况下是无序的。
但 **ORDER BY b** 可以利用索引排序! 因为 WHERE a=1 确定了 a 的值,b 在 a=1 的范围内是有序的。索引 (a,b,c) 中,给了 a=1 的等值条件后,数据按 b 排序。所以 ORDER BY b 不需要 filesort。
关键区别: c 的过滤需要 b 的约束,但 b 的排序只需要 a 的约束。
Q2: 和 ,对索引 的排序利用有何不同?
参考答案:
**WHERE a=1 ORDER BY b**:可以利用索引排序。 a 是等值条件,确定了 a=1 的范围,在这个范围内 b 是有序的。索引直接提供排序,不需要 filesort。
**WHERE a>1 ORDER BY b**:无法利用索引排序。 a 是范围条件,a 的值不再相同(a=2,3,4...),b 在 a 不同的情况下是无序的。需要 filesort。
索引 (a,b) 的实际数据:
a=1: b=1, 2, 3, 4  ← WHERE a=1, b有序
a=2: b=1, 5, 8     ← WHERE a>1, 跨a值b无序
a=3: b=2, 3, 7
面试官评分要点: 候选人能否理解"等值条件确定范围,该范围内后续列有序;范围条件打破该列,后续列不再有序"。
Q3: vs ,c 的使用有何区别?
参考答案:
**b IN (2,3)**:c 能用上索引。 MySQL 将 IN 视为多个等值条件:(a=1,b=2) 和 (a=1,b=3)。在每个等值范围内,c 是有序的。优化器会将 IN 展开为多个等值查询,c 可以参与索引过滤。
**b > 2**:c 不能用上索引。 范围查询打破了 b 的相等性,c 在 b 不同的情况下不再有序。索引只能用到 (a, b),c 需要在回表后或 ICP 中判断。
关键区别:IN 是"多个等值"的语法糖,不破坏索引连续性;> 是真正的范围查询,会中断后续列的索引使用。
Q4:,索引 vs 的性能差异?
参考答案:
索引 **(a,b)**:覆盖索引,不需要回表。 查询只需要 a 和 b,都在索引 (a,b) 中。查询全程只访问索引,Extra 显示 Using index。
索引 **(a)**:需要回表。 索引中只有 a 和主键,b 需要回表到聚簇索引中获取。每行一次回表,如果是 1000 行就是 1000 次回表。
性能差异: 覆盖索引比回表快 10-15 倍(取决于数据是否在 Buffer Pool 中)。
如果是 **SELECT ***: 两个索引都需要回表,(a,b) 和 (a) 的性能差异不大。但 (a,b) 的空间占用更大,写入性能稍差。
Q5:,status 只有 3 个值且分布均匀,索引 高效吗?
参考答案:
高效。 这个索引对查询是完美的。
原因:WHERE status='PAID' 是等值条件,确定了 status 的范围。在 status='PAID' 的范围内,create_time 是有序的(因为索引按 (status, create_time) 排序)。ORDER BY create_time DESC 可以直接利用索引排序,不需要 filesort。
分布均匀不影响索引使用: 即使 status 只有 3 个值,每个值占 33% 的数据,WHERE status='PAID' 仍然是一个等值条件。索引中 status='PAID' 的所有行,create_time 是有序的。
唯一需要注意的是: 如果 LIMIT 10 且需要回表,最多回表 10 次。如果查询列都在索引中(覆盖索引),性能最优。
Q6:Q1: ,Q2: ,最少需要几个索引?
参考答案:
最少需要 2 个索引:**(a,b)** 和 **(b,c)**。
分析:
- Q1 需要
(a,b)或(b,a)。(a,b)可以覆盖 Q1。 - Q2 需要
(b,c)或(c,b)。(b,c)可以覆盖 Q2。 - 不能用一个索引同时覆盖两个查询,因为 Q2 的
b=2 AND c=3不满足(a,b,c)的最左前缀(缺少 a)。
如果 Q1 是 **WHERE a=1 AND b=2**,Q2 是 **WHERE a=1 AND c=3**:
只需要 1 个索引 (a,b,c):
- Q1: 使用
(a,b)部分 - Q2: 使用
(a)部分,c 在 ICP 中过滤
如果 Q1 是 **WHERE a=1**,Q2 是 **WHERE a=1 AND b=2**:
只需要 1 个索引 (a,b):
- Q1: 使用
(a)部分(最左前缀) - Q2: 使用
(a,b)全部
全文完 | 编号 114 | 分类 08 MySQL 与关系型数据库