阅读时间:约 45 分钟 | 难度:中高级 | 编号:113
一、引言:InnoDB 中两张最重要的"索引面孔"
在 MySQL InnoDB 中,索引只有两种:聚簇索引(Clustered Index)和二级索引(Secondary Index)。理解它们的区别和协作方式,是掌握 MySQL 性能优化的核心。
一个关键事实: InnoDB 的表本身就是一棵以主键为索引键的 B+Tree。数据不是存在"表"里,而是存在"聚簇索引的叶子节点"里。这意味着主键的选择直接决定了数据的物理存储方式。
本文将深入剖析聚簇索引和二级索引的存储结构、回表机制、以及主键选择的最佳实践。
二、聚簇索引:数据即索引
2.1 聚簇索引的定义
聚簇索引(Clustered Index):索引的叶子节点直接存储完整的行数据。数据和索引是一体的,不是分开存储的。
普通索引(如 MyISAM):         聚簇索引(InnoDB):
┌──────────┐  ┌──────────┐     ┌──────────────────┐
│ 索引页    │  │ 数据页    │     │ 索引页 即 数据页    │
│ id=1 → ptr│→│ id=1,name │     │ id=1, name, age   │
│ id=2 → ptr│→│ id=2,name │     │ id=2, name, age   │
└──────────┘  └──────────┘     └──────────────────┘
索引和数据分离                   索引和数据一体
关键特性:
- 每个 InnoDB 表有且只有一个聚簇索引
- 数据行按主键顺序物理存储
- 聚簇索引的叶子节点 = 数据页本身
2.2 聚簇索引的生成规则
InnoDB 按以下优先级选择聚簇索引:
| 优先级 | 条件 | 聚簇索引 |
|---|---|---|
| 1 | 有显式 PRIMARY KEY | 使用 PRIMARY KEY |
| 2 | 无 PRIMARY KEY,但有 UNIQUE NOT NULL 列 | 使用第一个 UNIQUE NOT NULL 列 |
| 3 | 以上都没有 | InnoDB 自动生成 6 字节的隐藏 ROW_ID |
验证方法:
-- 没有主键的表,InnoDB 自动生成了隐藏的聚簇索引
CREATE TABLE no_pk (name VARCHAR(50), age INT);

-- 查看隐藏的 ROW_ID(仅调试用)
SELECT _rowid, name, age FROM no_pk;
最佳实践: 始终显式定义 PRIMARY KEY,不要依赖 InnoDB 的自动生成。隐藏的 ROW_ID 对查询优化没有任何帮助,且无法用于 WHERE 条件。
2.3 聚簇索引的优势
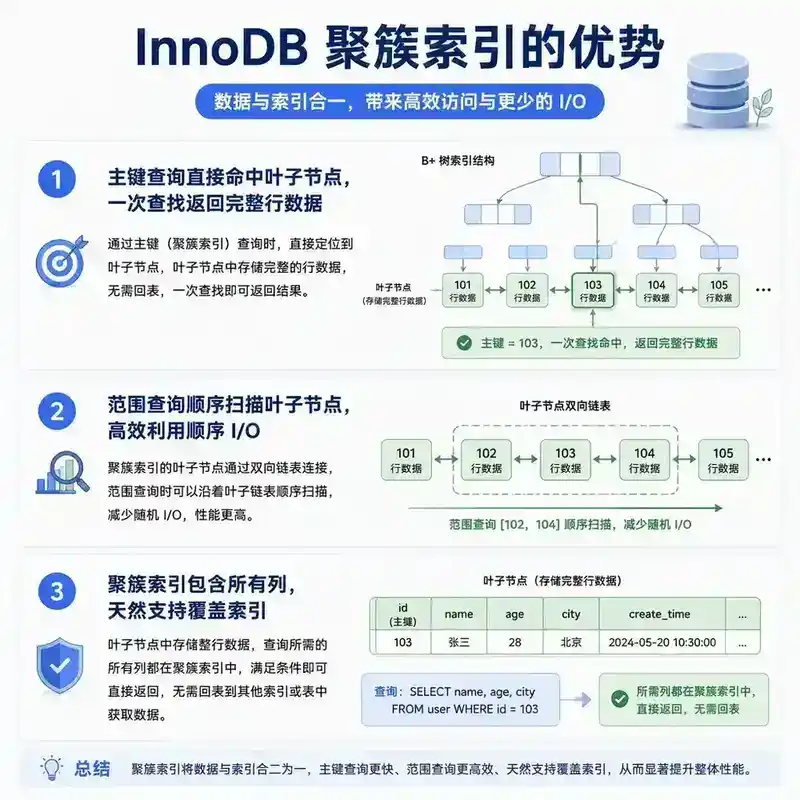
(1)主键查询极快
SELECT * FROM users WHERE id = 1000;
聚簇索引中,叶子节点直接包含完整行数据。不需要回表,一次 B+Tree 查找即可拿到所有列。
(2)范围查询高效
SELECT * FROM orders WHERE id BETWEEN 1000 AND 2000;
数据按主键顺序物理存储,范围查询只需沿着叶子节点链表顺序扫描,磁盘 I/O 是顺序的。
(3)覆盖索引天然优势
SELECT name FROM users WHERE id = 1000;
聚簇索引包含所有列,任何查询都可以通过聚簇索引"覆盖"。
三、二级索引:索引的"目录"
3.1 二级索引的存储结构
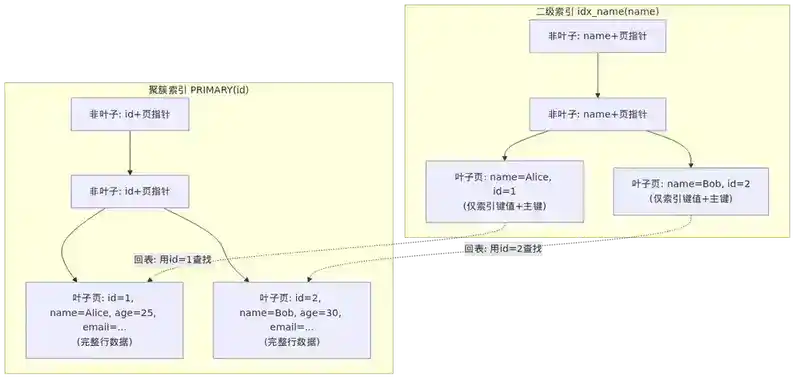
二级索引(Secondary Index):非聚簇索引,叶子节点存储的是索引键值 + 主键值,而不是完整数据行。
二级索引 (name) 的结构:           聚簇索引 (id) 的结构:
┌──────────────────┐              ┌──────────────────┐
│ 非叶子: name + 页指针 │              │ 非叶子: id + 页指针   │
├──────────────────┤              ├──────────────────┤
│ 叶子: name=Alice, id=5  │       │ 叶子: id=5, name=Alice, │
│ 叶子: name=Bob, id=3    │       │       age=25, email=... │
│ 叶子: name=Carol, id=8  │       │ 叶子: id=3, name=Bob,   │
└──────────────────┘              │       age=30, email=... │
                                  └──────────────────┘
关键观察: 二级索引的叶子节点只存储了 (name, id),不包含 age、email 等列。如果查询需要这些列,必须通过 id 去聚簇索引中查找——这就是回表。
3.2 回表:二级索引的"隐藏成本"
回表过程:
SELECT * FROM users WHERE name = 'Alice';
-- 假设 name 列有二级索引
- 在
idx_name的 B+Tree 中查找name='Alice'→ 找到(Alice, id=5) - 拿到
id=5,去聚簇索引中查找id=5→ 找到完整行数据 - 返回所有列
第 1 步是索引查找,第 2 步是回表——一次额外的 B+Tree 查找。
回表的代价:
- 每次回表都是一次随机 I/O(如果数据不在 Buffer Pool 中)
- 如果查询返回 1000 行,可能需要 1000 次回表 → 1000 次随机 I/O
- 回表是许多慢查询的根源
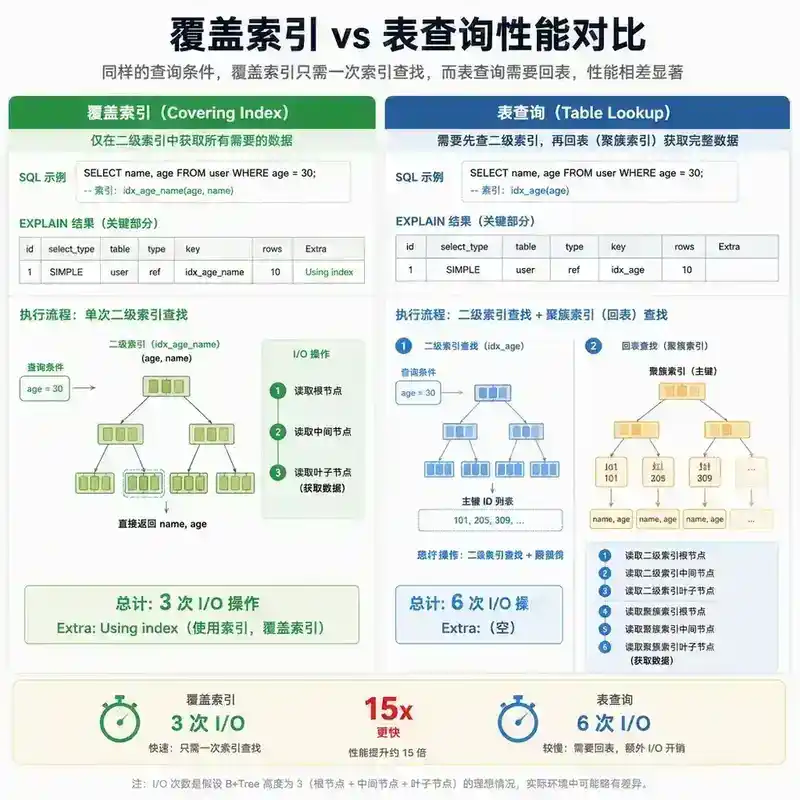
3.3 覆盖索引:避免回表的最佳方案
覆盖索引:查询需要的所有列都包含在索引中,不需要回表。
-- 需要回表(SELECT * 需要所有列,二级索引只有 name 和 id)
SELECT * FROM users WHERE name = 'Alice';

-- 覆盖索引(只查询索引中已有的列)
SELECT name, id FROM users WHERE name = 'Alice';
判断是否使用覆盖索引——EXPLAIN 的 Extra 列:
EXPLAIN SELECT name, id FROM users WHERE name = 'Alice';
-- Extra: Using index  ← 覆盖索引,没有回表

EXPLAIN SELECT * FROM users WHERE name = 'Alice';
-- Extra: NULL  ← 没有 Using index,发生了回表
Using index 表示查询只访问了索引,没有访问数据行。这是性能最优的查询模式。
四、主键选择:影响一生的决定
4.1 主键对聚簇索引的影响
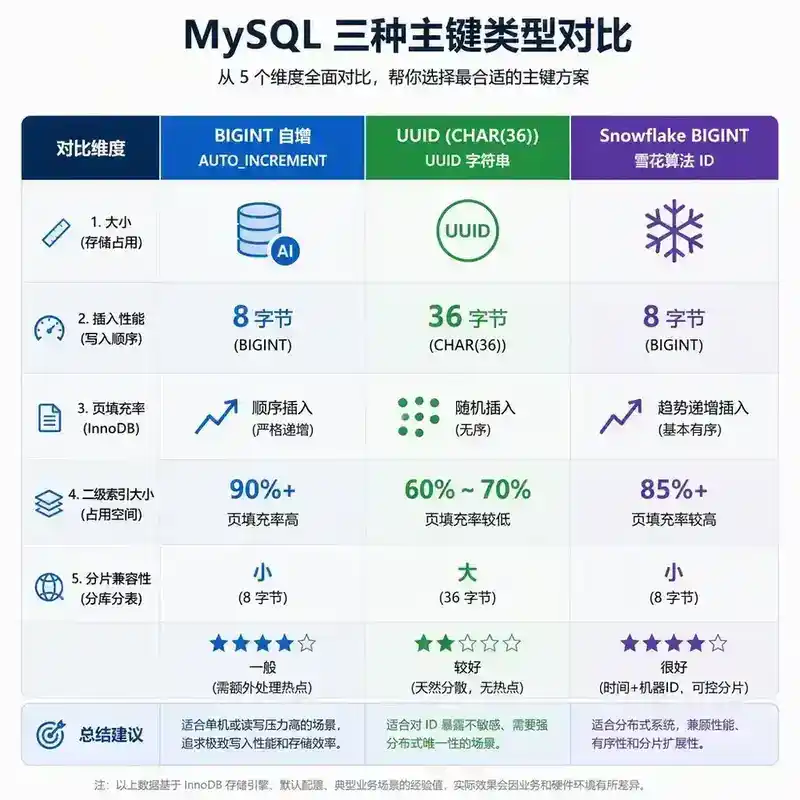
主键的选择直接影响聚簇索引的物理结构,进而影响所有二级索引的大小和性能。
| 主键类型 | 聚簇索引 | 二级索引 | 写入性能 | 空间占用 |
|---|---|---|---|---|
| BIGINT 自增 | 顺序插入,页填充率高 | 叶子节点 8 字节主键 | 高 | 小 |
| INT 自增 | 顺序插入,页填充率高 | 叶子节点 4 字节主键 | 最高 | 最小 |
| UUID CHAR(36) | 随机插入,页填充率低 | 叶子节点 36 字节主键 | 低 | 大 |
| 雪花算法 BIGINT | 趋势递增,接近顺序 | 叶子节点 8 字节主键 | 高 | 小 |
| 复合主键 (a,b,c) | 按 (a,b,c) 排序 | 叶子节点存储 (a,b,c) | 中 | 较大 |
4.2 主键对二级索引的"连带影响"
这是最容易被忽略的一点:主键的大小直接影响所有二级索引的大小。
假设表有 100 万行,3 个二级索引:

BIGINT 主键(8 字节):
  每个二级索引叶子节点:100万 × 8字节 = 8MB
  3 个二级索引:3 × 8MB = 24MB

UUID 主键(36 字节):
  每个二级索引叶子节点:100万 × 36字节 = 36MB
  3 个二级索引:3 × 36MB = 108MB

差距:108MB - 24MB = 84MB(3.5 倍)
这意味着:主键越大,所有二级索引越大,Buffer Pool 中能缓存的索引页越少,整体性能越差。
4.3 自增主键 vs UUID 主键
自增主键的优势:
- 顺序插入:新行总是追加到 B+Tree 最右侧,页分裂只发生在最右侧
- 页填充率高:约 90%+,空间利用率高
- 二级索引小:8 字节的 BIGINT 比 36 字节的 UUID 小得多
- Buffer Pool 友好:热点数据集中在少数页面中
自增主键的劣势:
- 不适合分库分表:多个库的自增主键会冲突
- 暴露数据量:用户可以推测出总用户数、订单数等
- 单点瓶颈:自增锁在极端并发下可能成为瓶颈
UUID 主键的优势:
- 全局唯一:适合分库分表场景
- 不暴露数据量:无法从 ID 推测数据规模
- 去中心化生成:不需要依赖数据库自增
UUID 主键的劣势:
- 随机插入:导致频繁的页分裂,写入性能下降 50%+
- 页填充率低:约 60-70%
- 二级索引膨胀:所有二级索引变大
- Buffer Pool 效率低:热点数据分散在更多页面中
4.4 雪花算法:自增和 UUID 的折中方案
雪花算法(Snowflake)生成的 64 位 ID 是趋势递增的,结合了自增和 UUID 的优点:
| 特性 | 自增 BIGINT | UUID | 雪花算法 |
|---|---|---|---|
| 全局唯一 | 否 | 是 | 是 |
| 趋势递增 | 是 | 否 | 是 |
| 大小 | 8 字节 | 36 字节 | 8 字节 |
| 页分裂 | 少 | 多 | 少 |
| 适合分库分表 | 否 | 是 | 是 |
雪花算法 ID 结构:
┌─────┬──────────────┬──────────┬────────────┐
│ 1bit │ 41bit 时间戳  │ 10bit 机器 │ 12bit 序列号 │
└─────┴──────────────┴──────────┴────────────┘
关键优势: 时间戳在高位,使得 ID 整体趋势递增,但同一毫秒内的 ID 会乱序。虽然不是完全递增,但比 UUID 的完全随机要好得多。
五、回表详解:从二级索引到聚簇索引的旅程
5.1 回表的完整流程
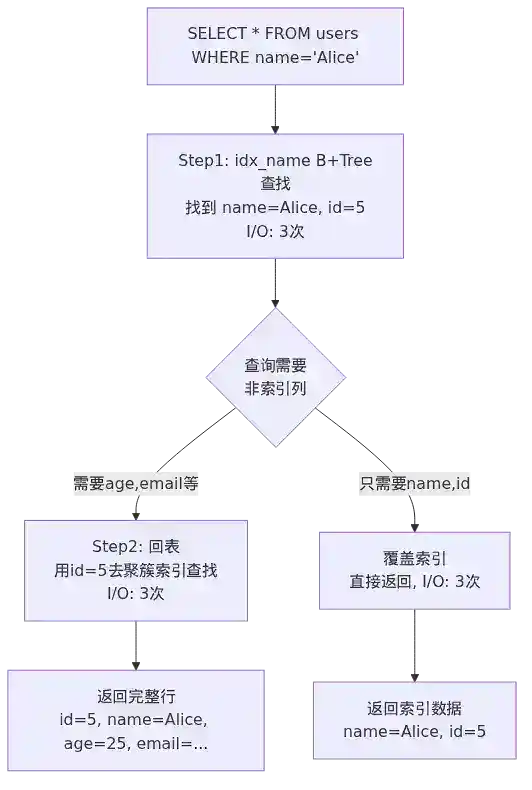
以 SELECT * FROM users WHERE name = 'Alice' 为例(假设 idx_name 存在):
Step 1: 在 idx_name 的 B+Tree 中查找 'Alice'
        → 根节点 → 非叶子节点 → 叶子节点
        → 找到记录: (name='Alice', id=5)
        → 磁盘 I/O: 3 次(如果不在 Buffer Pool 中)

Step 2: 用 id=5 去聚簇索引中查找
        → 根节点 → 非叶子节点 → 叶子节点
        → 找到完整行: (id=5, name='Alice', age=25, email='alice@...')
        → 磁盘 I/O: 3 次(如果不在 Buffer Pool 中)

总共: 6 次磁盘 I/O(最坏情况)
5.2 回表的优化器选择
MySQL 优化器会评估是否使用二级索引。如果回表代价太高,优化器可能选择全表扫描。
-- 假设 users 表有 100 万行,其中 90 万行 name LIKE 'A%'
SELECT * FROM users WHERE name LIKE 'A%';
优化器的决策:
- 使用
idx_name:90 万次索引查找 + 90 万次回表 = 180 万次 I/O - 全表扫描:100 万行,每页约 32 行,约 31250 个页,约 31250 次 I/O
优化器会选择全表扫描! 这就是为什么有时加了索引反而更慢——回表代价太高。
5.3 回表的优化策略
策略一:覆盖索引
-- 坏:需要回表
SELECT * FROM users WHERE name = 'Alice';

-- 好:覆盖索引
SELECT name, id FROM users WHERE name = 'Alice';
策略二:联合索引覆盖更多列
-- 创建联合索引,包含查询需要的所有列
CREATE INDEX idx_name_age_email ON users(name, age, email);

-- 查询可以完全由索引覆盖
SELECT name, age, email FROM users WHERE name = 'Alice';
策略三:延迟关联
-- 先通过覆盖索引获取主键,再回表取数据
SELECT u.* FROM users u
JOIN (
    SELECT id FROM users WHERE name LIKE 'A%' LIMIT 1000, 10
) tmp ON u.id = tmp.id;
先通过覆盖索引(idx_name 只返回 id)快速定位到目标主键,然后只回表 10 次取完整数据。避免了大量回表。
六、索引下推(ICP):5.6 的革命性优化
6.1 什么是索引下推
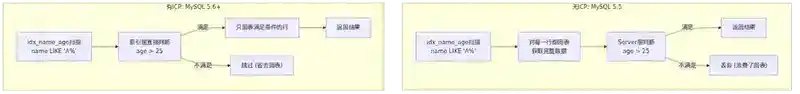
Index Condition Pushdown(ICP):将 WHERE 条件中可以在索引层判断的部分,下推到存储引擎层执行,减少回表次数。
SELECT * FROM users WHERE name LIKE 'A%' AND age > 25;
-- 假设索引: idx_name_age (name, age)
没有 ICP(MySQL 5.5 及之前):
- 在
idx_name_age中扫描所有name LIKE 'A%'的行 - 对每一行,回表取完整数据
- 在 Server 层判断
age > 25 - 如果
age > 25不成立,丢弃该行
问题: 步骤 2 的回表可能是不必要的——如果 age <= 25,回表就是浪费。
有 ICP(MySQL 5.6+):
- 在
idx_name_age中扫描所有name LIKE 'A%'的行 - 在索引层直接判断
age > 25(因为age在联合索引中) - 只有
age > 25成立的行才回表 - 减少了不必要的回表
EXPLAIN 中的 ICP 标识:
EXPLAIN SELECT * FROM users WHERE name LIKE 'A%' AND age > 25;
-- Extra: Using index condition  ← ICP 已启用
6.2 ICP 的适用条件
- 索引必须是联合索引,且 WHERE 条件中引用了索引中的非首列
- 适用于
range、ref、eq_ref、ref_or_null访问类型 - 不适用于覆盖索引(覆盖索引不需要回表,ICP 没有意义)
- 不适用于全文索引和空间索引
七、实战:索引选择与性能对比
7.1 主键类型对性能的影响
测试场景: 1000 万行数据,BIGINT 自增 vs UUID 主键。
| 指标 | BIGINT 自增 | UUID CHAR(36) | 差异 |
|---|---|---|---|
| 表空间大小 | 1.2 GB | 2.8 GB | 2.3× |
| 插入 100 万行耗时 | 45 秒 | 180 秒 | 4× |
| 点查询 (Buffer Pool 空) | ~0.3 ms | ~0.5 ms | 1.7× |
| 范围查询 1000 行 | ~2 ms | ~8 ms | 4× |
| 二级索引大小 | 200 MB | 500 MB | 2.5× |
7.2 覆盖索引 vs 回表的性能对比
测试场景: 100 万行,查询 1000 行。
-- 回表查询
SELECT * FROM users WHERE name LIKE 'A%' LIMIT 1000;
-- 耗时: ~120 ms(1000 次回表)

-- 覆盖索引查询
SELECT name, id FROM users WHERE name LIKE 'A%' LIMIT 1000;
-- 耗时: ~8 ms(0 次回表)

-- 差距: 15 倍
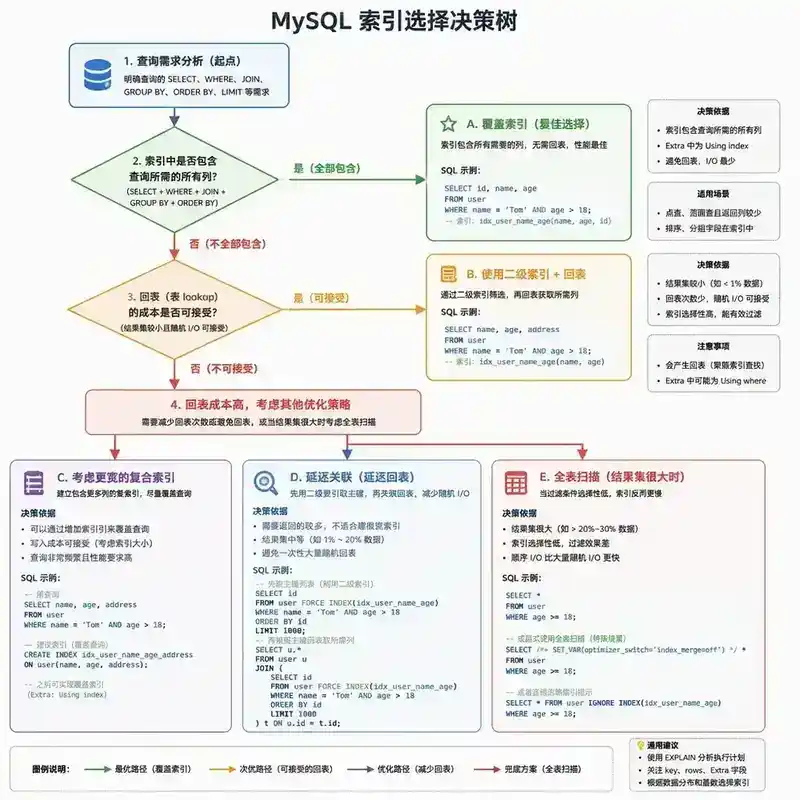
7.3 索引选择的决策树
需要查询的列是否都在索引中?
├── 是 → 覆盖索引,最优
└── 否 → 回表代价是否可接受?
    ├── 是 → 使用二级索引 + 回表
    └── 否 → 考虑:
        ├── 联合索引覆盖更多列
        ├── 延迟关联
        └── 全表扫描(如果结果集很大)
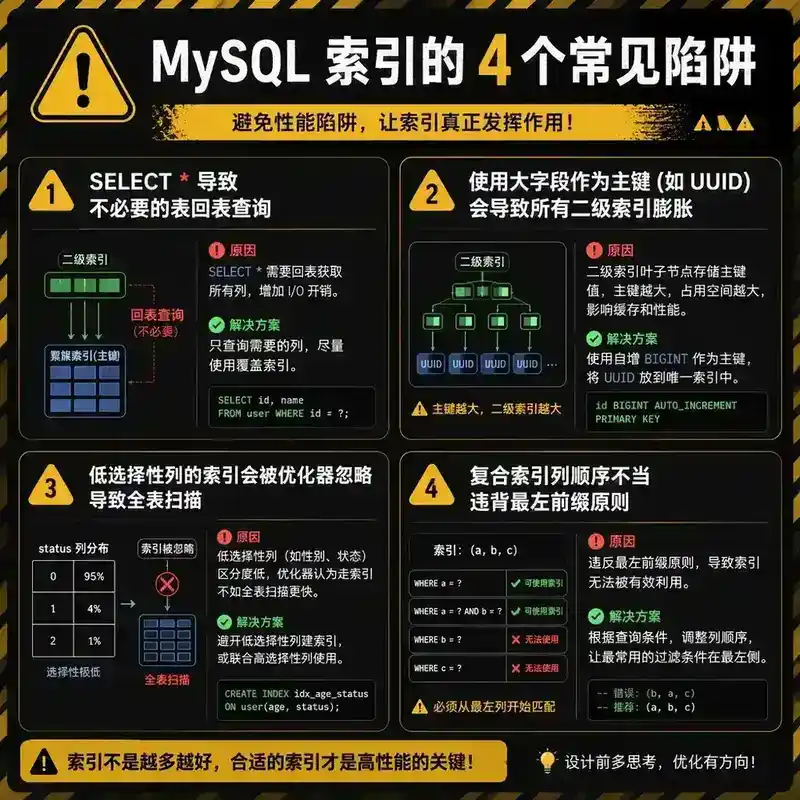
八、常见陷阱与避坑指南
陷阱一:SELECT * 导致回表
现象: 明明有索引,查询还是慢。
原因:SELECT * 需要所有列,二级索引无法覆盖,必须回表。
避坑: 只 SELECT 需要的列,尽量让索引覆盖查询。
陷阱二:大主键拖慢所有查询
现象: 表不大,但所有查询都慢。
原因: 主键用了 VARCHAR(64) 的 UUID,导致所有二级索引膨胀,Buffer Pool 效率下降。
避坑: 主键尽量小,优先 BIGINT 自增或雪花算法。
陷阱三:索引选择性低导致全表扫描
现象: 查询 WHERE status = 'ACTIVE' 很慢,但 status 列有索引。
原因: 如果 90% 的行都是 ACTIVE,优化器认为回表代价太高,选择全表扫描。
避坑: 低选择性列不适合建独立索引,考虑联合索引或使用其他过滤条件。
陷阱四:联合索引顺序错误
现象: 查询 WHERE b = 1 AND a = 2 用不上索引 (a, b)。
原因: 虽然 MySQL 优化器会调整 WHERE 条件的顺序,但 WHERE b = 1(没有 a 的条件)无法使用 (a, b) 索引。
避坑: 联合索引遵循最左前缀原则,等值查询的列放前面,范围查询的列放后面。
九、总结
聚簇索引和二级索引是 InnoDB 存储引擎的核心设计:
- 聚簇索引 = 数据本身:叶子节点存储完整行,主键决定了数据物理存储顺序
- 二级索引 = 索引 + 主键:叶子节点存储索引键值和主键,查询需要回表
- 回表是性能杀手:每次回表都可能是一次随机 I/O,覆盖索引是解决方案
- 主键选择影响全局:主键越大,所有二级索引越大,整体性能越差
- ICP 减少回表:MySQL 5.6+ 的索引下推在索引层过滤,减少不必要的回表
一句话总结: 聚簇索引决定了数据怎么存,二级索引决定了数据怎么查,主键决定了它们能有多快。
十、面试官视角提问
以下问题从面试官视角出发,考察候选人对聚簇索引和二级索引的理解深度。不计入 40 分钟阅读时间。
Q1:一个表没有显式定义 PRIMARY KEY,但有两个 UNIQUE 列:**email** 和 **phone**。InnoDB 会选择哪一列作为聚簇索引?如果这两个列都没有 NOT NULL 约束呢?
Q2:**SELECT * FROM orders WHERE user_id = 100 ORDER BY create_time DESC LIMIT 10**。有索引 **idx_user_time (user_id, create_time)**。这个查询会发生回表吗?如果会,回表多少次?
Q3:为什么建议主键越小越好?如果主键是 INT(4 字节) 和 BIGINT(8 字节),在 1000 万行的表上,二级索引的大小差异是多少?请给出计算过程。
Q4:一个表有 500 万行,**SELECT COUNT(*) FROM t WHERE status = 'ACTIVE'**。**status** 列有索引,但 EXPLAIN 显示 type=ALL(全表扫描)。为什么优化器选择全表扫描而不使用索引?
Q5:**SELECT id, name FROM users WHERE age > 18 ORDER BY id LIMIT 100**。有索引 **idx_age (age)** 和聚簇索引 **PRIMARY (id)**。MySQL 优化器会选择哪个索引?为什么?
Q6:你有一个分库分表系统,需要全局唯一的主键。你会选择 UUID、雪花算法还是数据库号段?请从聚簇索引的角度分析各方案的优缺点。
作者注:本文为"Java 技术专家与架构师面试:250 个高频考点"系列第 113 篇,属于「08 MySQL 与关系型数据库」分类。
十一、面试官提问 · 参考答案
以下为第十节中 6 道面试题的参考答案,从面试官视角评估候选人的理解深度。
Q1:无 PRIMARY KEY,有 email 和 phone 两个 UNIQUE 列,InnoDB 选哪个作聚簇索引?
参考答案:
选第一个定义的 UNIQUE NOT NULL 列。
InnoDB 的聚簇索引选择优先级:
- 显式 PRIMARY KEY → 使用 PRIMARY KEY
- 无 PRIMARY KEY,有 UNIQUE NOT NULL 列 → 使用第一个 UNIQUE NOT NULL 列
- 都没有 → 自动生成 6 字节隐藏 ROW_ID
如果 email 和 phone 都没有 NOT NULL 约束:
UNIQUE 列允许 NULL 值,但 NULL != NULL(在 UNIQUE 约束中,多个 NULL 可以共存)。因此 UNIQUE 列如果没有 NOT NULL 约束,不能作为聚簇索引——因为聚簇索引的键值必须唯一且非空。此时 InnoDB 会跳过这两个 UNIQUE 列,自动生成隐藏的 ROW_ID 作为聚簇索引。
实际影响:
CREATE TABLE no_pk_no_notnull (
    email VARCHAR(100) UNIQUE,
    phone VARCHAR(20) UNIQUE
);
-- 聚簇索引: 隐藏的 ROW_ID (6字节)
-- email 和 phone 各自是二级索引
-- 所有查询都需要回表,且无法通过主键优化
面试官评分要点: 候选人能否区分 UNIQUE 和 UNIQUE NOT NULL 在聚簇索引选择上的差异,以及 NULL 值在 UNIQUE 约束中的特殊行为。
Q2:,索引 ,会回表吗?
参考答案:
会回表,回表 10 次。
索引 **(user_id, create_time)** 的结构:
叶子节点内容: (user_id, create_time, PRIMARY KEY)
查询 SELECT * 需要所有列,但索引中只有 user_id、create_time 和主键。orders 表的其他列(如 amount、status 等)不在索引中。
执行过程:
- 在
idx_user_time中查找user_id=100,按create_time DESC顺序扫描 - 对每一行,拿到主键
order_id,去聚簇索引中查找完整行(回表) - 因为
LIMIT 10,只需要回表 10 次
如果能改成覆盖索引:
CREATE INDEX idx_user_time_cover ON orders(user_id, create_time, amount, status);
-- 或者只 SELECT 索引中的列
SELECT user_id, create_time, order_id FROM orders
WHERE user_id = 100 ORDER BY create_time DESC LIMIT 10;
面试官评分要点: 候选人能否准确回答"回表 10 次"(因为 LIMIT 10),以及能否说出覆盖索引的优化方案。
Q3:INT(4字节) vs BIGINT(8字节) 主键,1000 万行时二级索引大小差异?
参考答案:
差异计算:
假设有一个二级索引 idx_name (name VARCHAR(50)):
INT 主键(4 字节):
每个叶子节点条目 = name(50) + id(4) = 54 字节
每页条目数 ≈ 16KB / 54 ≈ 300 个
1000 万行 / 300 ≈ 33,334 个叶子页
二级索引大小 ≈ 33,334 × 16KB ≈ 520 MB
BIGINT 主键(8 字节):
每个叶子节点条目 = name(50) + id(8) = 58 字节
每页条目数 ≈ 16KB / 58 ≈ 282 个
1000 万行 / 282 ≈ 35,461 个叶子页
二级索引大小 ≈ 35,461 × 16KB ≈ 554 MB
加上非叶子节点(约 2% 开销):
- INT 主键:520 × 1.02 ≈ 530 MB
- BIGINT 主键:554 × 1.02 ≈ 565 MB
差异:565 - 530 = 35 MB(约 6.6%)
如果有 3 个二级索引:
- 3 × 35 MB = 105 MB 差异
如果有 10 个二级索引:
- 10 × 35 MB = 350 MB 差异
结论: 单个二级索引差异不大,但索引越多差距越大。更重要的是 Buffer Pool 效率——更大的索引意味着更少的页能被缓存。
面试官评分要点: 候选人能否给出完整的计算过程,并提到"索引越多,主键大小的影响越明显"。
Q4:,status 有索引但 EXPLAIN 显示全表扫描,为什么?
参考答案:
原因:**status='ACTIVE'** 的行数占比太高,优化器认为回表代价 > 全表扫描代价。
优化器的决策逻辑:
假设表有 500 万行,其中 450 万行 status='ACTIVE'(90%):
- 使用索引: 450 万次索引查找 + 450 万次回表。每次回表都是随机 I/O,450 万 × 0.1ms ≈ 450 秒
- 全表扫描: 500 万行,每页约 32 行,约 156,250 页。顺序 I/O,156,250 × 0.05ms ≈ 7.8 秒
优化器选择全表扫描,因为顺序 I/O 远快于大量随机 I/O。
解决方案:
方案一:覆盖索引(COUNT 不需要回表)
CREATE INDEX idx_status ON t(status);
SELECT COUNT(*) FROM t WHERE status = 'ACTIVE';
-- COUNT(*) 只需要统计行数,索引中 status 列就足够了
-- 实际上 COUNT(*) 会使用这个索引,因为不需要回表
方案二:汇总表
CREATE TABLE t_stats (status VARCHAR(20), cnt INT, PRIMARY KEY(status));
-- 定期更新或通过触发器维护
方案三:使用 EXPLAIN 验证
EXPLAIN SELECT COUNT(*) FROM t WHERE status = 'ACTIVE';
-- 如果 Extra 有 Using index → 覆盖索引,最优
-- 如果 type=index → 索引全扫描,比全表扫描好
-- 如果 type=ALL → 全表扫描(需要优化)
面试官评分要点: 候选人能否解释"优化器选择全表扫描是合理的"——不是 bug,而是基于成本模型的正确决策。
Q5:,索引 和聚簇索引 ,优化器选哪个?
参考答案:
优化器大概率选择聚簇索引 PRIMARY(id),进行全索引扫描。
原因分析:
选项一:使用 idx_age(age)
- 在 idx_age 中扫描所有
age>18的行 - 对每一行,拿到主键 id,回表取 name
- 回表后按 id 排序(但 id 是乱序的,因为 age 索引中 id 不连续)
- 取前 100 行
问题: 如果 age>18 的行很多(比如 80%),需要大量回表 + 排序。
选项二:使用 PRIMARY(id)
- 按 id 顺序扫描聚簇索引(天然有序)
- 对每一行判断
age>18 - 满足条件的加入结果集
- 凑够 100 行就停止
优势: 不需要排序,不需要回表(聚簇索引包含所有列),凑够 100 行就停。
关键判断: 如果 age>18 的行占比很高(比如 80%),PRIMARY 扫描可能只需要扫描前 125 行就能凑够 100 行满足条件的。这比 idx_age 的 80% 回表 + 排序快得多。
如果 **age>18** 的行占比很低(比如 1%): 优化器可能选择 idx_age,因为只需要回表 1% 的行。
面试官评分要点: 候选人能否理解"优化器选择聚簇索引的全索引扫描"是合理的——因为 ORDER BY id 和 LIMIT 100 使得聚簇索引扫描可以提前终止,而二级索引需要大量回表。
Q6:分库分表系统需要全局唯一主键,选 UUID、雪花算法还是数据库号段?
参考答案:
推荐雪花算法,它在聚簇索引性能和全局唯一性之间取得了最佳平衡。
三种方案对比:
| 维度 | UUID | 雪花算法 | 数据库号段 |
|---|---|---|---|
| 大小 | 36 字节(CHAR) | 8 字节(BIGINT) | 8 字节(BIGINT) |
| 递增性 | 完全随机 | 趋势递增 | 严格递增 |
| 页分裂 | 严重 | 轻微 | 几乎没有 |
| 页填充率 | 60-70% | 85-90% | 90%+ |
| 二级索引大小 | 大 | 小 | 小 |
| 去中心化 | 是 | 是 | 否(依赖 DB) |
| 性能瓶颈 | 无 | 无 | 号段 DB 可能瓶颈 |
雪花算法的最佳实践:
-- 雪花算法生成的 ID 是趋势递增的 BIGINT
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,  -- 雪花算法 ID
    user_id BIGINT,
    amount DECIMAL(10,2),
    -- ...
);
雪花算法的注意事项:
- 时钟回拨问题:如果服务器时钟回拨,可能导致 ID 重复。解决方案:记录上次生成的时间戳,如果发现回拨则等待或抛异常。
- workId 分配:在容器化环境中,需要为每个实例分配唯一的 workId。可以基于 IP、主机名或使用 ZooKeeper/Redis 分配。
- 趋势递增 ≠ 严格递增:同一毫秒内的 ID 可能乱序,但对页分裂的影响远小于完全随机的 UUID。
数据库号段的适用场景: 对 ID 严格递增有要求的场景(如订单号需要可读性),但需要接受数据库号段的单点风险。
面试官评分要点: 候选人能否从聚簇索引的角度(页分裂、页填充率、二级索引大小)分析各方案,而不只是从"唯一性"角度回答。
全文完 | 编号 113 | 分类 08 MySQL 与关系型数据库