阅读时间:约 45 分钟 | 难度:中高级 | 编号:126
一、引言:读写分离的"阿克琉斯之踵"
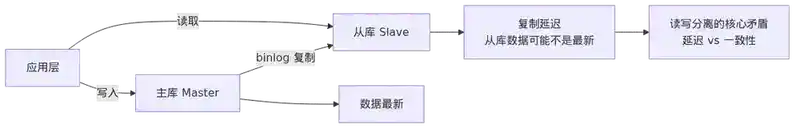
读写分离是 MySQL 最常见的扩展方案——主库写入,从库读取。但主从之间的复制延迟,意味着从库读取的数据可能不是最新的。这就是读写分离的核心矛盾:如何在延迟和一致性之间取得平衡?
二、复制延迟的原因
2.1 延迟的根源
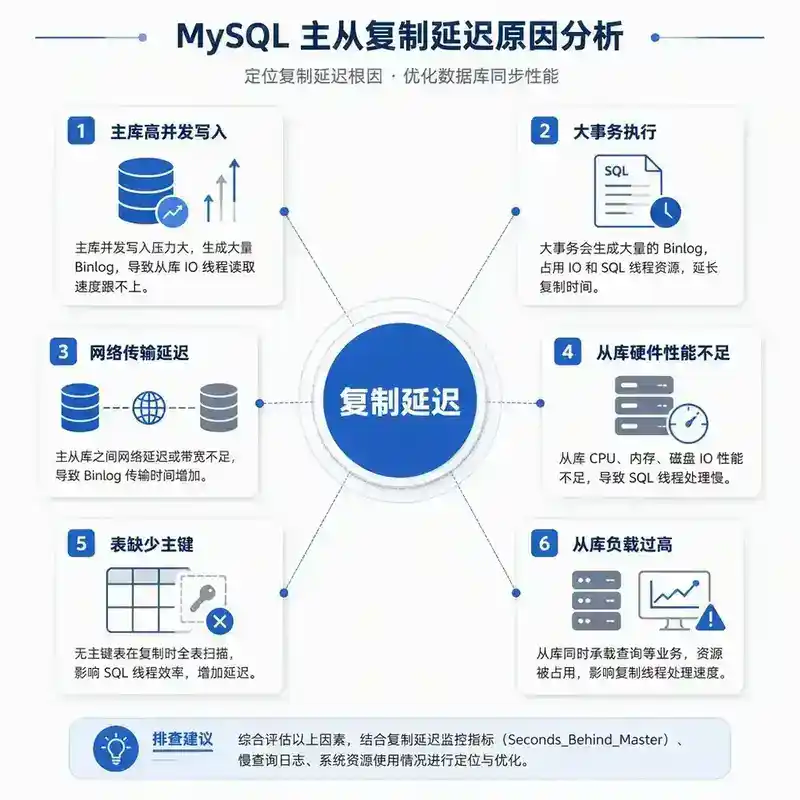
| 原因 | 说明 | 影响程度 |
|---|---|---|
| 主库并发写入高 | 从库单线程回放跟不上 | 高 |
| 大事务 | 主库执行快,从库回放慢 | 高 |
| 网络延迟 | 跨机房/跨地域复制 | 中 |
| 从库硬件差 | 从库 CPU/磁盘不如主库 | 高 |
| 无主键表 | ROW 格式下回放时需要全表扫描 | 高 |
| 从库有其他负载 | 报表查询占用资源 | 中 |
2.2 延迟的量化
Seconds_Behind_Master = 主库 binlog 时间戳 - 从库正在回放的事件的时间戳
注意: 如果主库写入停止,Seconds_Behind_Master 会逐渐减小到 0,但这不代表从库数据已经追上了——只是没有新数据写入而已。
三、延迟监控
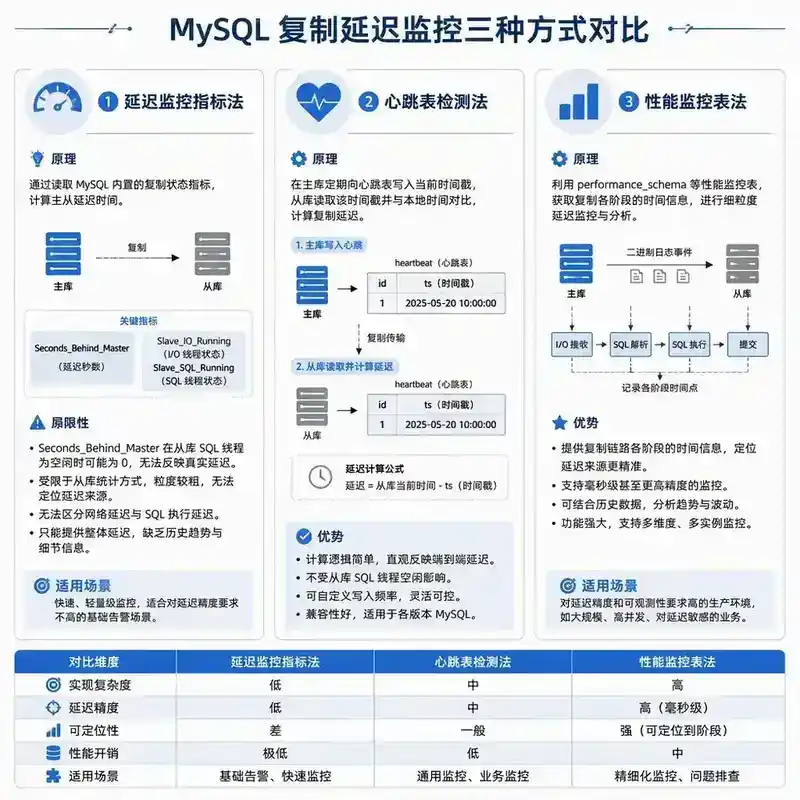
3.1 Seconds_Behind_Master
SHOW SLAVE STATUS\G
-- Seconds_Behind_Master: 5
局限性: 只能反映 SQL 线程的延迟,无法反映 I/O 线程的延迟。如果网络中断,I/O 线程停止,Seconds_Behind_Master 可能为 0(因为 SQL 线程已经回放完了所有 relay log)。
3.2 心跳表监控
-- 主库定期更新心跳表
CREATE TABLE heartbeat (id INT PRIMARY KEY, ts TIMESTAMP);
UPDATE heartbeat SET ts = NOW() WHERE id = 1;

-- 从库检查心跳延迟
SELECT TIMESTAMPDIFF(SECOND, ts, NOW()) AS lag FROM heartbeat WHERE id = 1;
3.3 Performance Schema
-- 查看复制延迟详情
SELECT * FROM performance_schema.replication_applier_status_by_worker;
SELECT * FROM performance_schema.replication_connection_status;
四、复制延迟治理
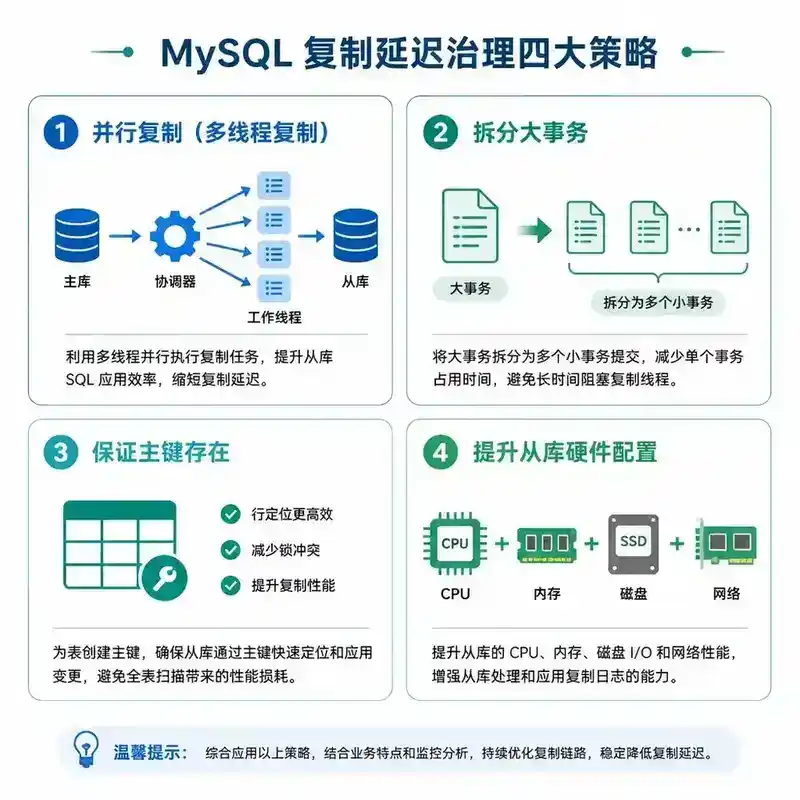
4.1 并行复制
-- 开启并行复制
STOP SLAVE SQL_THREAD;
SET GLOBAL slave_parallel_workers = 4;
SET GLOBAL slave_parallel_type = LOGICAL_CLOCK;
START SLAVE SQL_THREAD;
4.2 拆分大事务
-- 坏:一次更新 100 万行
UPDATE orders SET status = 'EXPIRED' WHERE ...;

-- 好:分批更新
UPDATE orders SET status = 'EXPIRED' WHERE ... LIMIT 1000;
-- 循环执行直到全部更新完
4.3 保证所有表有主键
-- 查找无主键表
SELECT t.table_schema, t.table_name
FROM information_schema.tables t
LEFT JOIN information_schema.statistics s
  ON t.table_schema = s.table_schema
  AND t.table_name = s.table_name
  AND s.index_name = 'PRIMARY'
WHERE t.table_type = 'BASE TABLE'
  AND s.index_name IS NULL;
4.4 从库硬件不低于主库
从库需要同时处理 I/O 线程写入、SQL 线程回放、业务读取,负载比主库更高。
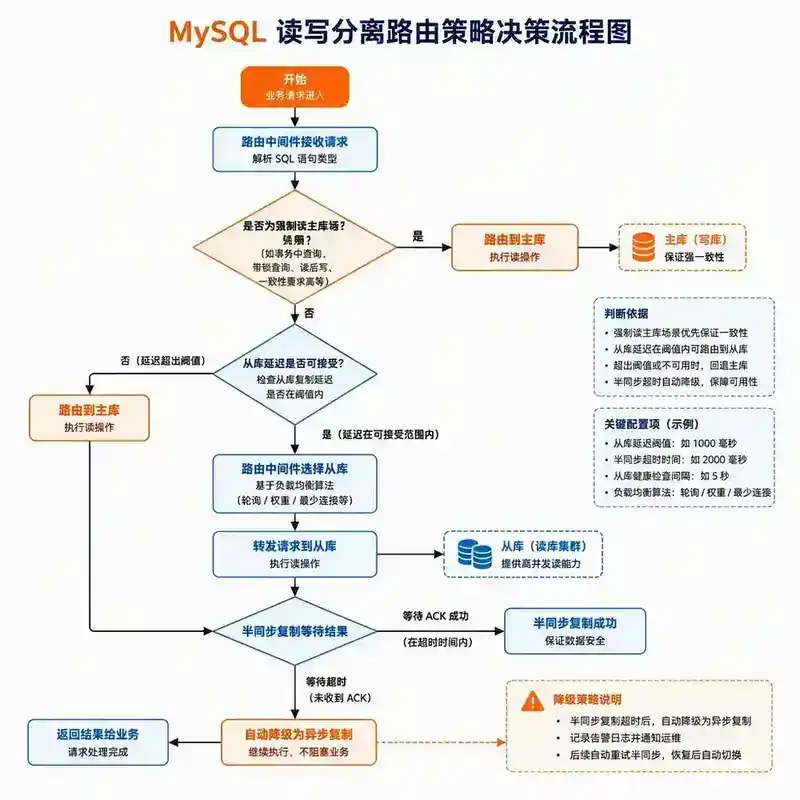
五、读写路由策略
5.1 场景一:强制读主库
// 写后立即读,必须读主库
@Transactional
public void updateAndRead() {
    orderMapper.update(order);
    // 直接从主库读取
    Order updated = orderMapper.selectById(order.getId());
}
5.2 场景二:延迟可接受
// 用户查看自己的订单列表,几秒延迟可接受
public List<Order> getUserOrders(Long userId) {
    // 从从库读取
    return orderMapper.selectByUserId(userId);
}
5.3 场景三:路由中间件
使用 ShardingSphere、MyCat 等中间件,根据 SQL 类型自动路由:
- SELECT → 从库
- INSERT/UPDATE/DELETE → 主库
- 事务内 → 主库
- Hint 强制指定 → 根据 Hint
5.4 场景四:半同步 + 读主库超时
// 如果从库延迟超过阈值,切换读主库
if (replicationLag > 5) {
    // 读主库
} else {
    // 读从库
}
六、数据一致性保障
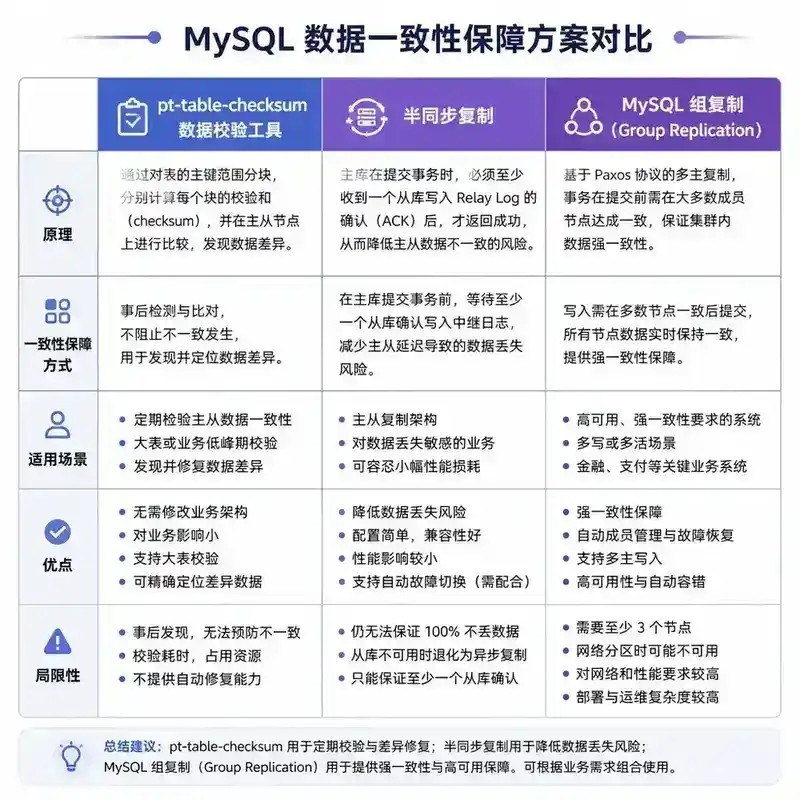
6.1 主从一致性检查
# pt-table-checksum 检查主从数据一致性
pt-table-checksum h=master,u=root --databases mydb

# pt-table-sync 修复不一致
pt-table-sync --sync-to-master h=slave,u=root --databases mydb --print
6.2 半同步复制
-- 主库安装半同步插件
INSTALL PLUGIN rpl_semi_sync_master SONAME 'semisync_master.so';
SET GLOBAL rpl_semi_sync_master_enabled = 1;

-- 从库安装半同步插件
INSTALL PLUGIN rpl_semi_sync_slave SONAME 'semisync_slave.so';
SET GLOBAL rpl_semi_sync_slave_enabled = 1;
6.3 全同步复制(Group Replication)
MySQL 8.0 的 MGR 使用 Paxos 协议,多数派确认后才提交,保证强一致性。
七、实战案例
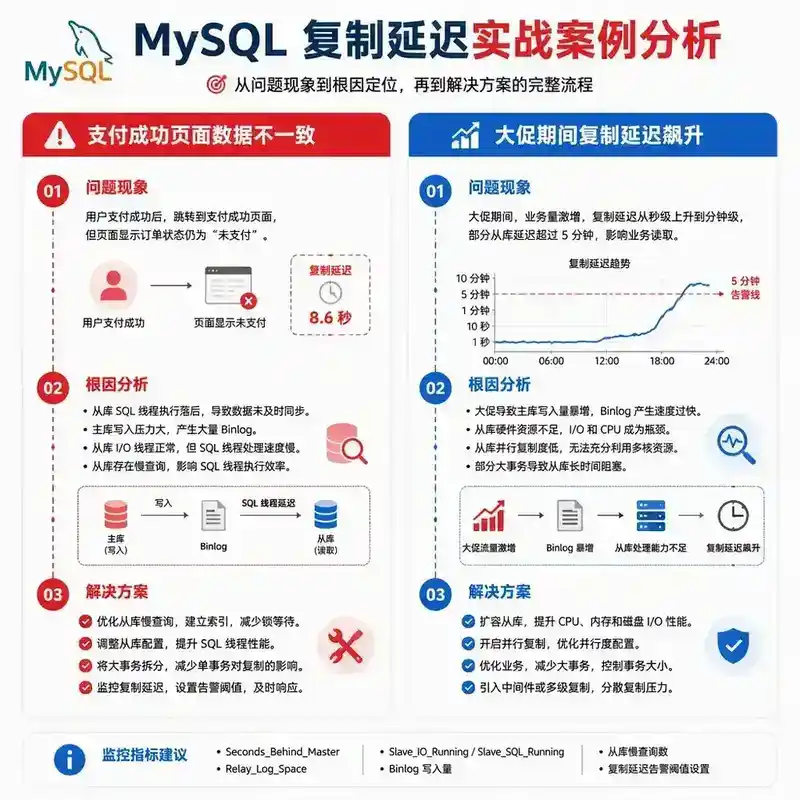
案例一:订单支付后跳转"支付成功"页面,显示"未支付"
原因: 支付写入主库,跳转页面从从库读取,复制延迟导致从库还未同步。
解决方案: 支付成功后的查询强制走主库。
案例二:大促期间从库延迟飙升到 30 秒
原因: 主库 TPS 从 5000 飙升到 50000,从库单线程回放跟不上。
解决方案: 开启并行复制(8 个 Worker),延迟降到 2 秒以内。
八、总结
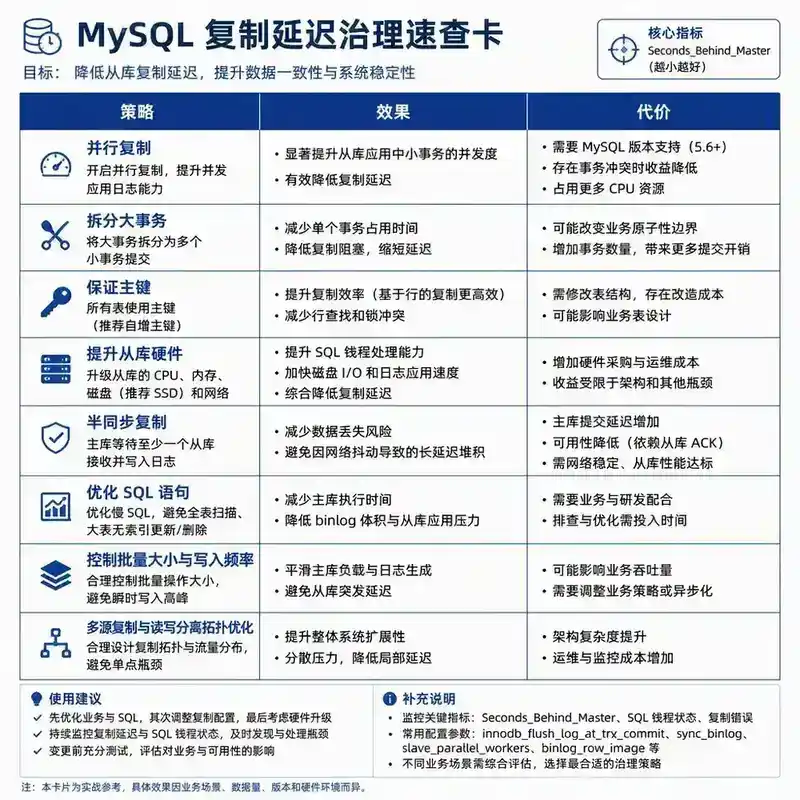
| 策略 | 效果 | 代价 |
|---|---|---|
| 并行复制 | 减少延迟 | 可能乱序 |
| 拆分大事务 | 减少延迟 | 需要应用改造 |
| 强制读主库 | 零延迟 | 主库压力增大 |
| 半同步复制 | 减少丢失 | 写入性能下降 |
| 心跳表监控 | 精确实时延迟 | 额外写入 |
九、面试官视角提问
Q1:**Seconds_Behind_Master=0**但数据实际上有延迟,为什么?什么情况下会出现这个现象?
Q2:并行复制可能导致事务在从库上的提交顺序与主库不同。这会导致什么问题?如何避免?
Q3:一个查询在从库上执行了 10 秒,主库上只需要 0.1 秒。从库配置和主库完全相同。可能的原因是什么?
Q4:半同步复制和 MGR 有什么区别?什么场景用半同步,什么场景用 MGR?
Q5:你设计了一个读写分离方案,但产品经理反馈"用户支付成功后,订单列表页偶尔显示未支付"。你怎么排查和解决?
Q6:**SHOW SLAVE STATUS**中**Seconds_Behind_Master**为 NULL,这意味着什么?可能的原因是什么?
作者注:本文为系列第 126 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1: 但数据实际上有延迟,为什么?
参考答案:
原因:Seconds_Behind_Master 是 SQL 线程当前回放事务的时间戳与主库当前时间戳的差值。如果主库停止写入,SQL 线程回放完所有 relay log 后,Seconds_Behind_Master=0,但 I/O 线程可能因为网络中断还未拉取到最新的 binlog。
场景: 网络中断期间,I/O 线程停止,SQL 线程回放完 relay log,Seconds_Behind_Master=0。但实际上从库数据落后于主库,只是没有新数据需要回放。
解决方案: 使用心跳表监控真实的复制延迟,或使用 pt-heartbeat 工具。
Q2:并行复制可能导致从库提交顺序与主库不同,会有什么问题?
参考答案:
主要问题:
- 外键约束冲突:主库上先插入父行再插入子行,从库上可能并行回放导致子行先插入而父行不存在
- 唯一键冲突:主库上先 DELETE 再 INSERT 相同值,从库上并行回放可能导致 INSERT 先执行
- 读写分离数据不一致:从库上的中间状态与主库上的任何时刻状态都不同
MySQL 8.0 WRITESET 的解决: 通过 Write Set 检测事务之间的行冲突,有冲突的事务串行回放,无冲突的并行回放,保证从库的提交顺序与主库等效。
Q3:从库查询 10 秒,主库 0.1 秒,配置相同,可能原因?
参考答案:
可能原因:
- 从库 Buffer Pool 未预热:主库的 Buffer Pool 已经缓存了热点数据,从库的 Buffer Pool 是冷的
- 从库磁盘 I/O 瓶颈:从库的 SQL 线程正在大量写入 relay log,磁盘 I/O 饱和
- 从库 CPU 被复制线程占用:并行复制的 Worker 线程占用了 CPU
- 从库有其他负载:报表、备份等任务与复制线程抢占资源
- 主从数据量不同:从库可能有额外的索引或数据
Q4:半同步复制和 MGR 的区别?什么场景用哪个?
参考答案:
| 维度 | 半同步 | MGR |
|---|---|---|
| 一致性 | 最终一致 | 强一致(Paxos) |
| 故障切换 | 手动/外部工具 | 自动选举 |
| 数据丢失 | 可能丢失少量 | 零丢失 |
| 写入性能 | 中等 | 较低(多数派确认) |
| 节点数 | 通常 1 主多从 | 多主或单主 |
| 复杂度 | 低 | 高 |
半同步场景: 对一致性要求较高但可接受少量丢失,架构简单。MGR 场景: 金融级别,零丢失,自动故障切换。
Q5:支付成功后订单列表偶尔显示未支付,如何排查和解决?
参考答案:
排查:
- 确认支付写入走主库,订单列表查询走从库
- 检查从库复制延迟:
SHOW SLAVE STATUS\G看Seconds_Behind_Master - 检查是否有大事务阻塞复制
- 确认路由中间件没有错误地将支付后的查询路由到从库
解决:
- 支付成功后立即跳转的查询强制走主库(
@Master注解或 Hint) - 如果从库延迟超过阈值(如 2 秒),自动切换读主库
- 开启并行复制减少从库延迟
Q6: 为 NULL 意味着什么?
参考答案:
可能原因:
- SQL 线程未运行:
Slave_SQL_Running: No,SQL 线程出错停止 - I/O 线程未运行:
Slave_IO_Running: No,无法连接到主库 - 从库未启动复制:
START SLAVE未执行 - 主库刚启动,未产生新 binlog:没有时间戳可以比较
排查: 先看 Slave_IO_Running 和 Slave_SQL_Running 的状态,再看 Last_IO_Error 和 Last_SQL_Error。
全文完 | 编号 126 | 分类 08 MySQL 与关系型数据库