阅读时间:约 45 分钟 | 难度:中高级 | 编号:118
一、引言:SQL 优化不是"加个索引"这么简单
大多数开发者面对慢 SQL 的第一反应是"加索引"。但很多时候,加了索引查询仍然慢,或者索引加了反而影响写入性能。真正的 SQL 优化需要一套系统的方法论,而不是凭直觉操作。
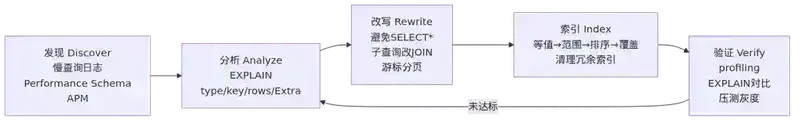
SQL 优化的完整闭环: 发现 → 分析 → 改写 → 索引 → 验证
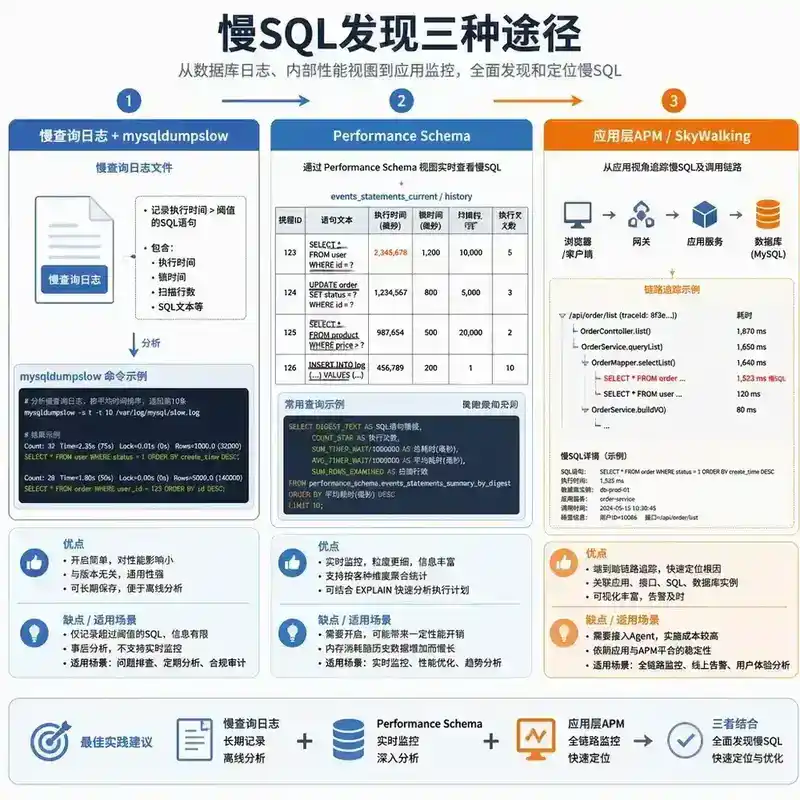
二、慢 SQL 发现:三种途径
2.1 慢查询日志
-- 开启慢查询日志
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 0.5;  -- 超过 0.5 秒记录
SET GLOBAL log_queries_not_using_indexes = ON;  -- 记录未使用索引的查询
分析工具:
# mysqldumpslow 分析慢日志
mysqldumpslow -s t -t 10 slow.log  # 按时间排序,前 10 条

# pt-query-digest 更详细的分析
pt-query-digest slow.log > report.txt
2.2 Performance Schema
MySQL 5.6+ 的 Performance Schema 可以实时监控 SQL 执行:
-- 查询执行最多的 SQL
SELECT DIGEST_TEXT, COUNT_STAR, AVG_TIMER_WAIT/1000000000 AS avg_ms
FROM performance_schema.events_statements_summary_by_digest
ORDER BY AVG_TIMER_WAIT DESC LIMIT 10;
2.3 应用层监控
- APM 工具(SkyWalking、Pinpoint)
- 数据库中间件(ShardingSphere-Proxy 的 SQL 审计)
- ORM 框架的 SQL 日志(MyBatis
log-impl、JPAshow-sql)
三、执行计划分析:EXPLAIN 深度使用
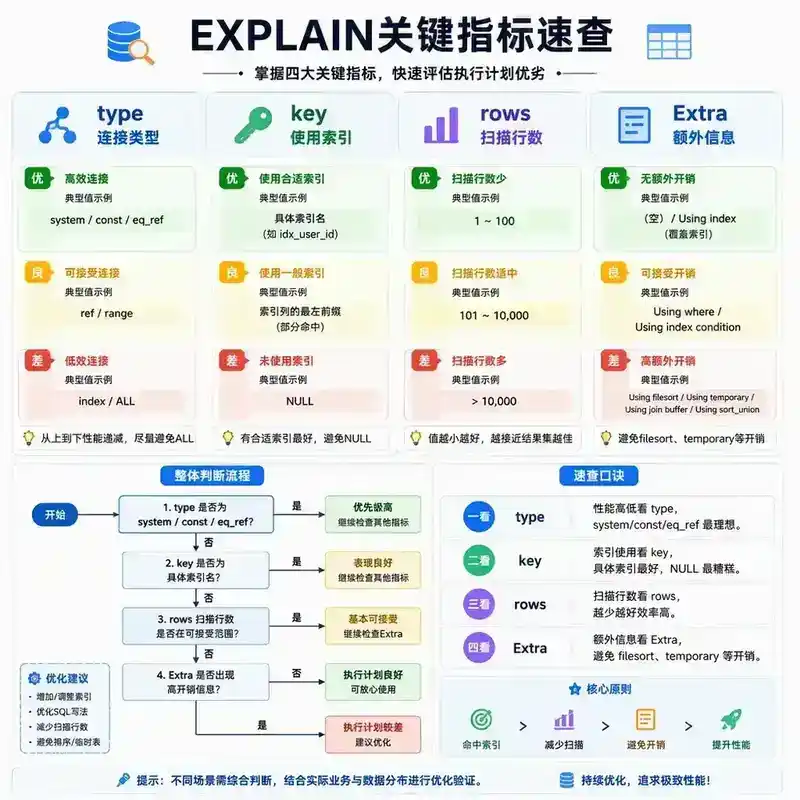
3.1 分析流程
1. EXPLAIN SQL → 看 type(访问类型)
2. 看 key(使用的索引)
3. 看 rows(扫描行数)
4. 看 Extra(额外信息)
5. 如果不够详细 → EXPLAIN FORMAT=JSON
6. 如果需要实际数据 → EXPLAIN ANALYZE(MySQL 8.0.18+)
3.2 关键判断标准
| 指标 | 优 | 良 | 差 |
|---|---|---|---|
| type | const/eq_ref | ref/range | index/ALL |
| rows | <100 | 100-10000 | >10000 |
| Extra | Using index | Using index condition | Using filesort/temporary |
| filtered | 100% | 10-100% | <10% |
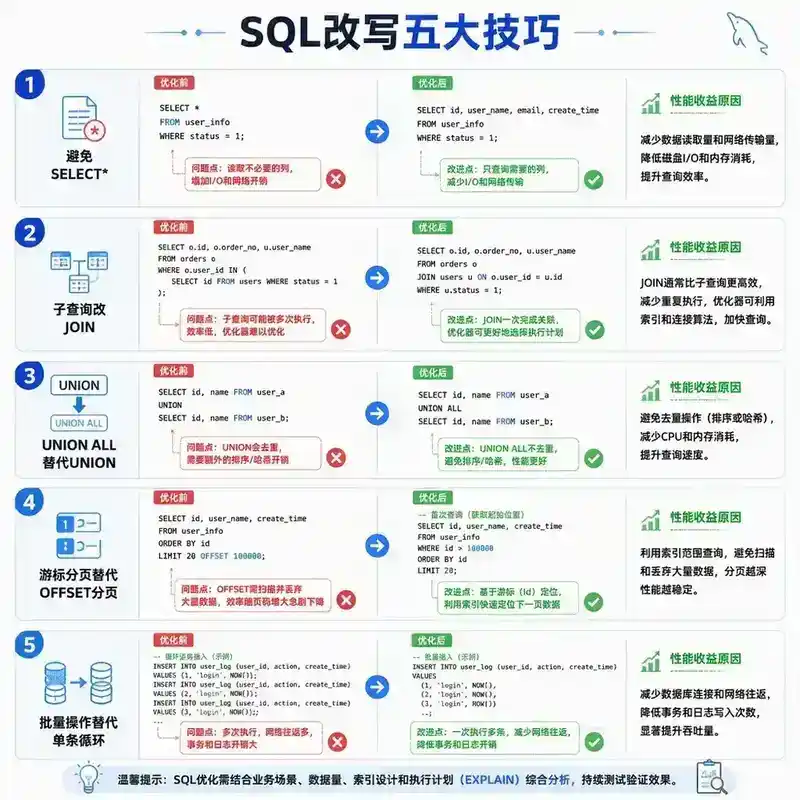
四、SQL 改写:让查询"变得更好"
4.1 避免 SELECT *
-- 坏
SELECT * FROM orders WHERE user_id = 100;

-- 好
SELECT id, amount, status FROM orders WHERE user_id = 100;
4.2 用 JOIN 替代子查询
-- 坏:子查询
SELECT * FROM orders WHERE user_id IN (SELECT id FROM users WHERE status = 'ACTIVE');

-- 好:JOIN(MySQL 5.6+ 优化器已能优化半连接,但 JOIN 更可控)
SELECT o.* FROM orders o JOIN users u ON o.user_id = u.id WHERE u.status = 'ACTIVE';
4.3 用 UNION ALL 替代 UNION
-- UNION 会去重(排序),UNION ALL 不去重(更快)
SELECT id FROM t1 UNION ALL SELECT id FROM t2;
4.4 分页优化
-- 坏:大偏移量
SELECT * FROM orders ORDER BY id LIMIT 1000000, 10;

-- 好:游标分页
SELECT * FROM orders WHERE id > 1000000 ORDER BY id LIMIT 10;
4.5 批量操作
-- 坏:逐条插入
INSERT INTO t VALUES (1, 'a');
INSERT INTO t VALUES (2, 'b');

-- 好:批量插入
INSERT INTO t VALUES (1, 'a'), (2, 'b');
五、索引优化:精准打击
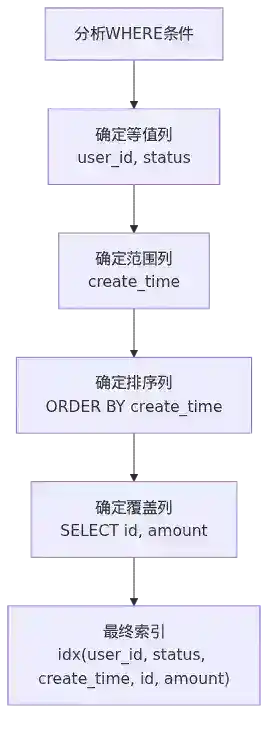
5.1 索引优化步骤
- 分析 WHERE 条件 → 确定索引列
- 分析 ORDER BY → 确定排序列
- 分析 SELECT 列 → 确定覆盖列
- 按"等值→范围→排序→覆盖"顺序排列列
- 创建索引
- 验证效果
5.2 索引优化案例
-- 原始查询
SELECT id, user_id, amount, create_time
FROM orders
WHERE user_id = 100 AND status = 'PAID'
ORDER BY create_time DESC
LIMIT 20;

-- 分析:等值(user_id, status) → 排序(create_time) → 覆盖(id, amount)
-- 最优索引
CREATE INDEX idx_ustc ON orders(user_id, status, create_time, id, amount);
5.3 索引"减负"
不是所有索引都有用。定期检查并删除无用索引:
-- 查找未使用的索引
SELECT * FROM sys.schema_unused_indexes;

-- 查找冗余索引
SELECT * FROM sys.schema_redundant_indexes
WHERE redundant_index_name IS NOT NULL;
六、效果验证:优化不是"感觉快了"
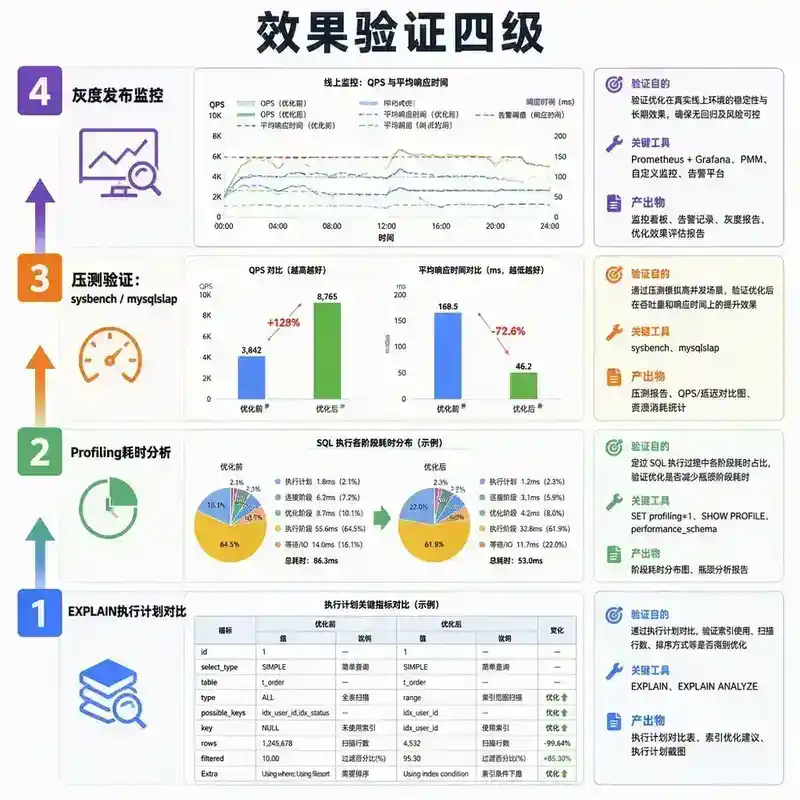
6.1 执行时间对比
-- 开启 profiling
SET profiling = 1;
SELECT ...;
SHOW PROFILES;
SHOW PROFILE FOR QUERY 1;
6.2 EXPLAIN 对比
优化前后对比:type 从 ALL → ref,rows 从 1000000 → 100
6.3 压测验证
# 使用 sysbench 或 mysqlslap 压测
mysqlslap --concurrency=10 --iterations=100 --query="SELECT ..."
6.4 生产验证
- 先在从库验证
- 灰度发布(部分实例先上线)
- 监控慢查询日志数量变化
- 监控 CPU、I/O 指标变化
七、常见优化案例
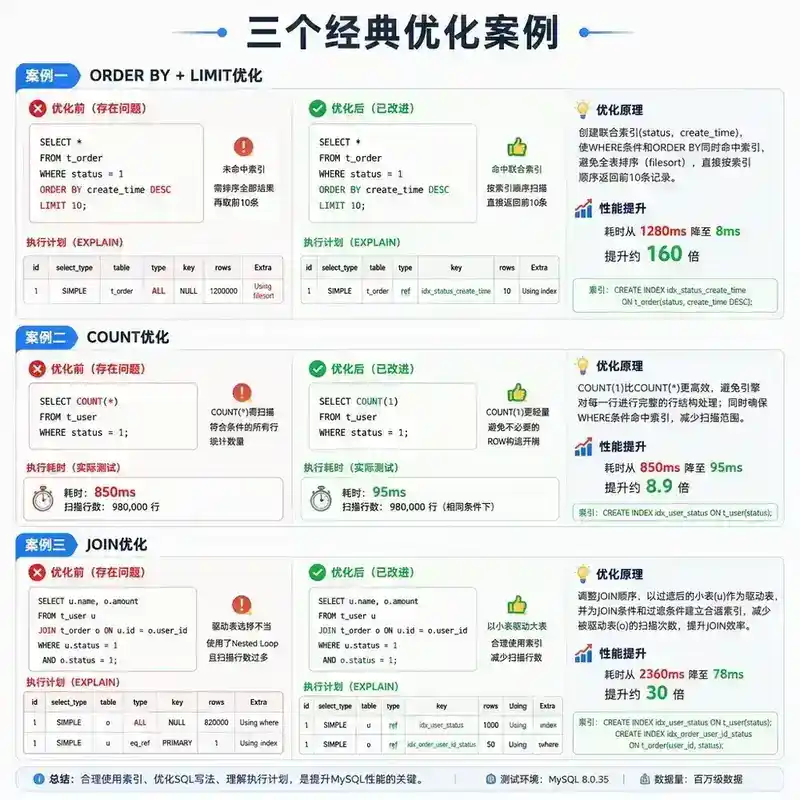
案例一:ORDER BY + LIMIT 优化
-- 优化前:Using filesort,扫描 100 万行
EXPLAIN SELECT * FROM orders WHERE user_id = 100 ORDER BY create_time DESC LIMIT 10;
-- type: ref, rows: 1000000, Extra: Using where; Using filesort

-- 优化后:Using index
CREATE INDEX idx_ut ON orders(user_id, create_time);
-- type: ref, rows: 10, Extra: Using index
案例二:COUNT 优化
-- 优化前:全表扫描
SELECT COUNT(*) FROM orders WHERE status = 'PAID';

-- 优化后:覆盖索引
CREATE INDEX idx_status ON orders(status);
-- type: index, Extra: Using index
案例三:JOIN 优化
-- 优化前:t2 全表扫描
EXPLAIN SELECT * FROM t1 JOIN t2 ON t1.a = t2.a WHERE t1.b = 1;

-- 优化后:t1 有索引,t2 有索引
CREATE INDEX idx_t1_ba ON t1(b, a);
CREATE INDEX idx_t2_a ON t2(a);
-- t1: ref, t2: ref
八、总结
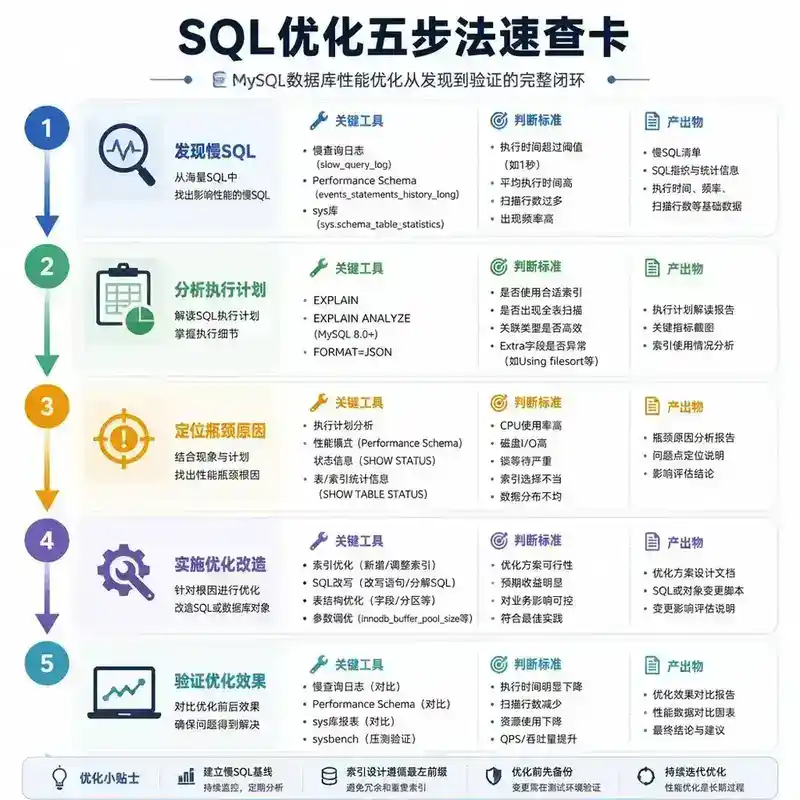
SQL 优化五步法:
- 发现:慢查询日志、Performance Schema、APM
- 分析:EXPLAIN → type/key/rows/Extra
- 改写:避免 SELECT *、子查询改 JOIN、游标分页
- 索引:等值→范围→排序→覆盖,定期清理冗余索引
- 验证:profiling、EXPLAIN 对比、压测、灰度发布
九、面试官视角提问
Q1:慢查询日志显示一个 SQL 执行了 5 秒,但 EXPLAIN 显示 type=ref, rows=100。可能的原因是什么?你怎么排查?
Q2:**SELECT * FROM t WHERE a IN (1,2,3) ORDER BY b LIMIT 10**,有索引 idx_a(a) 和 idx_b(b)。优化器会选择哪个索引?为什么?你会怎么优化?
Q3:MySQL 的 **sys.schema_unused_indexes** 表显示某个索引从未使用。你能直接删除它吗?在删除之前需要考虑什么?
Q4:一个表有 10 个索引,写入性能很差。如何判断哪些索引是必要的、哪些是冗余的?请给出判断标准和清理流程。
Q5:你用游标分页替代了 LIMIT 大偏移量,但产品经理说"用户需要跳转到第 100 页"。游标分页无法满足这个需求,你会怎么设计?
Q6:有一个 SQL 在生产环境执行很快(10ms),但在测试环境很慢(2s)。两个环境的表结构和数据量相同,可能的原因是什么?
作者注:本文为系列第 118 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:慢查询日志显示 SQL 执行 5 秒,但 EXPLAIN 显示 type=ref, rows=100。可能原因?
参考答案:
可能原因(按优先级):
- 等待锁:查询被其他事务的 MDL 锁或行锁阻塞。查看
performance_schema.events_statements_current中的LOCK_TIME - 回表随机 I/O:rows=100 只是索引扫描行数,100 次回表可能分布在 100 个不同的页中,全是随机 I/O
- 统计信息不准:实际扫描了远多于 100 行,
EXPLAIN ANALYZE可看到真实行数 - 磁盘 I/O 瓶颈:数据不在 Buffer Pool 中,每次都是磁盘 I/O
- 网络延迟:应用和数据库之间的网络问题
排查方法:EXPLAIN ANALYZE 看实际耗时和行数;SHOW PROFILE 看各阶段耗时分布。
Q2:,优化器选 idx_a 还是 idx_b?
参考答案:
取决于数据分布,两种可能:
选择 idx_a:用 idx_a 找到 a IN(1,2,3) 的行,如果结果集小,排序成本低,总体更快。
选择 idx_b:如果 a IN(1,2,3) 的结果集很大,用 idx_b 天然有序,扫描时判断 a 是否匹配,凑够 10 行就停,不需要 filesort。
最优方案: 创建联合索引 idx_ab(a, b),同时解决过滤和排序。
Q3: 显示索引从未使用,能直接删除吗?
参考答案:
不能直接删除,需要考虑以下因素:
- 监控周期:可能监控时间不够长,某些索引只在特定业务场景使用(如月末报表)
- 唯一约束:UNIQUE 索引即使未用于查询,也提供了数据完整性约束,不能删除
- 外键依赖:删除前确认没有外键依赖该索引
- 统计信息不准:Performance Schema 的统计可能因重启丢失
- 先禁用再删除:在 MySQL 8.0+ 中可先设置
ALTER TABLE t ALTER INDEX idx INVISIBLE,观察一段时间再删除
Q4:10 个索引的写入性能差,如何判断哪些必要、哪些冗余?
参考答案:
判断标准:
- 冗余索引:
(a,b)和(a)冗余,(a,b)可替代(a)。删除(a) - 未使用索引:
sys.schema_unused_indexes中出现的索引 - 低选择性索引:status 只有 3 个值,独立索引意义不大(除非有 ORDER BY 需求)
- 重复索引:两个索引完全相同的列(不同顺序)
清理流程:
-- 1. 查看冗余索引
SELECT * FROM sys.schema_redundant_indexes;

-- 2. 查看未使用索引
SELECT * FROM sys.schema_unused_indexes;

-- 3. 标记为不可见(MySQL 8.0+)
ALTER TABLE t ALTER INDEX idx_name INVISIBLE;

-- 4. 观察 1-2 周,确认无性能影响后删除
ALTER TABLE t DROP INDEX idx_name;
Q5:游标分页无法满足"跳转到第 100 页"需求,怎么设计?
参考答案:
方案一:游标分页 + 页码估算
-- 第一页
SELECT * FROM t WHERE id > 0 ORDER BY id LIMIT 20;

-- 第 100 页(估算:id ≈ 20 × 99 = 1980)
SELECT * FROM t WHERE id > 1980 ORDER BY id LIMIT 20;
-- 如果 id 不连续(有删除),实际页码可能偏移
方案二:覆盖索引 + 延迟关联(接受大偏移量)
-- 先用覆盖索引定位,再回表
SELECT t.* FROM t
JOIN (SELECT id FROM t ORDER BY id LIMIT 2000, 20) tmp ON t.id = tmp.id;
方案三:ES 等搜索引擎处理分页需求
对于需要复杂分页的场景,用 Elasticsearch 等专业搜索引擎。
Q6:生产快、测试慢,表结构数据量相同,可能原因?
参考答案:
- Buffer Pool 大小:生产 64GB,测试 2GB,数据不在内存中
- 硬件差异:生产 SSD,测试 HDD
- MySQL 配置差异:
innodb_buffer_pool_size、innodb_io_capacity等参数不同 - 统计信息不同:生产数据经过多次 ANALYZE,统计信息更准确
- 查询缓存:生产可能命中查询缓存(MySQL 5.7 及之前)
- 并发差异:生产高并发可能预热了 Buffer Pool
排查:EXPLAIN ANALYZE 看实际耗时分布;SHOW STATUS LIKE 'Innodb_buffer_pool%' 看命中率。
全文完 | 编号 118 | 分类 08 MySQL 与关系型数据库