阅读时间:约 45 分钟 | 难度:中高级 | 编号:123
一、引言:死锁是并发编程的经典问题
死锁不是 MySQL 的 bug,而是并发系统中锁互斥的必然结果。InnoDB 会自动检测死锁并回滚其中一个事务,但理解死锁的形成原因、学会分析死锁日志、掌握规避策略,是每个后端工程师的必备技能。
死锁的四要素: 互斥、持有并等待、不可剥夺、循环等待。只要满足这四个条件,死锁就可能发生。

二、死锁的形成原理
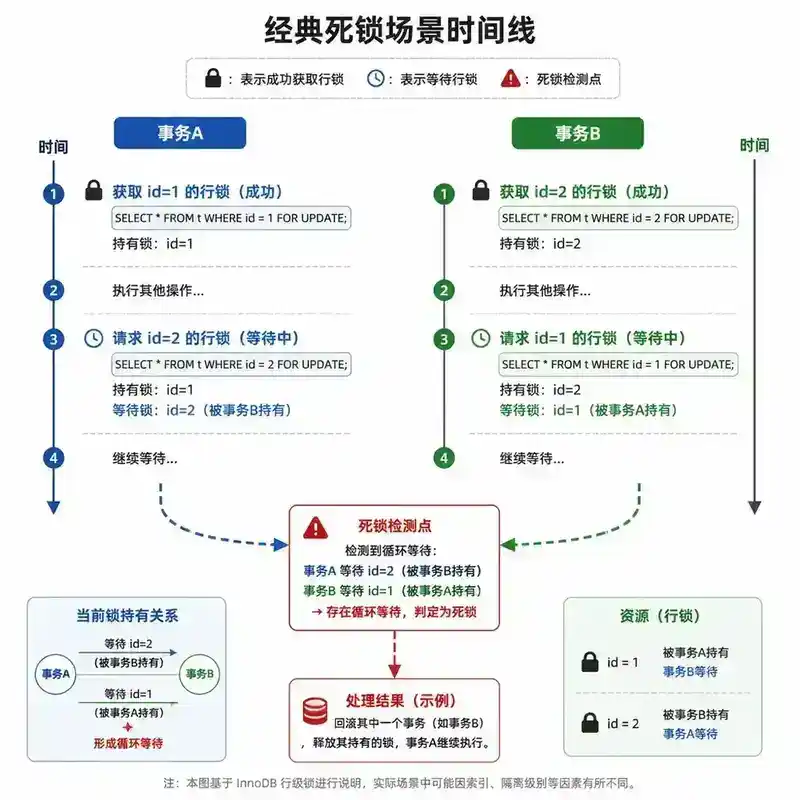
2.1 经典死锁场景
事务 A:                          事务 B:
START TRANSACTION;               START TRANSACTION;
UPDATE t SET name='A'             UPDATE t SET name='B'
WHERE id = 1;  -- 持有 id=1 X锁   WHERE id = 2;  -- 持有 id=2 X锁
                                   UPDATE t SET name='B'
UPDATE t SET name='A'              WHERE id = 1;  -- 等待 id=1 X锁
WHERE id = 2;  -- 等待 id=2 X锁     ← 互相等待 → 死锁!
2.2 死锁的四个必要条件
| 条件 | 说明 | 在 InnoDB 中的体现 |
|---|---|---|
| 互斥 | 资源只能被一个事务占用 | X 锁排他 |
| 持有并等待 | 持有资源的同时等待其他资源 | 事务持有行锁,等待其他行锁 |
| 不可剥夺 | 资源不能被强制释放 | 事务的锁不能被其他事务解除 |
| 循环等待 | 事务之间形成循环等待链 | A 等 B,B 等 A |
三、常见死锁场景
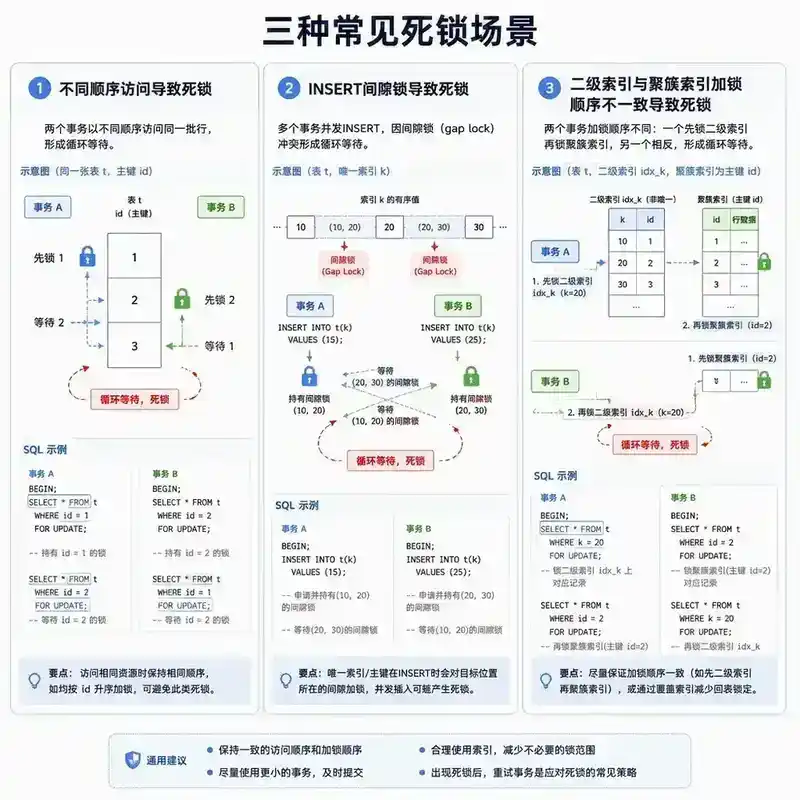
3.1 场景一:不同顺序访问相同资源
-- 事务 A: 先锁 id=1,再锁 id=2
UPDATE t SET name='A' WHERE id = 1;
UPDATE t SET name='A' WHERE id = 2;

-- 事务 B: 先锁 id=2,再锁 id=1(顺序相反!)
UPDATE t SET name='B' WHERE id = 2;
UPDATE t SET name='B' WHERE id = 1;
解决: 统一资源访问顺序,所有事务按相同顺序加锁。
3.2 场景二:INSERT 与间隙锁
-- 事务 A: 范围查询加锁
SELECT * FROM t WHERE id BETWEEN 10 AND 20 FOR UPDATE;

-- 事务 B: 插入 id=15
INSERT INTO t VALUES (15, 'B');
-- 等待事务 A 释放间隙锁

-- 事务 A: 插入 id=15
INSERT INTO t VALUES (15, 'A');
-- 等待事务 B... 死锁!
3.3 场景三:二级索引与聚簇索引
-- 索引 idx_name (name)
-- 事务 A: 通过二级索引更新
UPDATE t SET age = 25 WHERE name = 'Alice';
-- 先锁 idx_name 中的记录,再回表锁聚簇索引中的行

-- 事务 B: 直接通过主键更新
UPDATE t SET age = 30 WHERE id = 1;  -- id=1 对应 name='Alice'
-- 先锁聚簇索引,如果也要更新 name...

-- 加锁顺序相反 → 死锁
四、死锁检测与处理
4.1 InnoDB 的死锁检测
InnoDB 在事务等待锁时,自动检测死锁:
- 检测到死锁 → 回滚其中一个事务(通常是持有最少行锁的事务)
- 回滚的事务收到
ERROR 1213 (40001): Deadlock found when trying to get lock
死锁检测的性能开销: 当 innodb_deadlock_detect=ON(默认),InnoDB 需要检查等待图。在高并发下(如 1000+ 并发线程),死锁检测本身可能成为性能瓶颈。
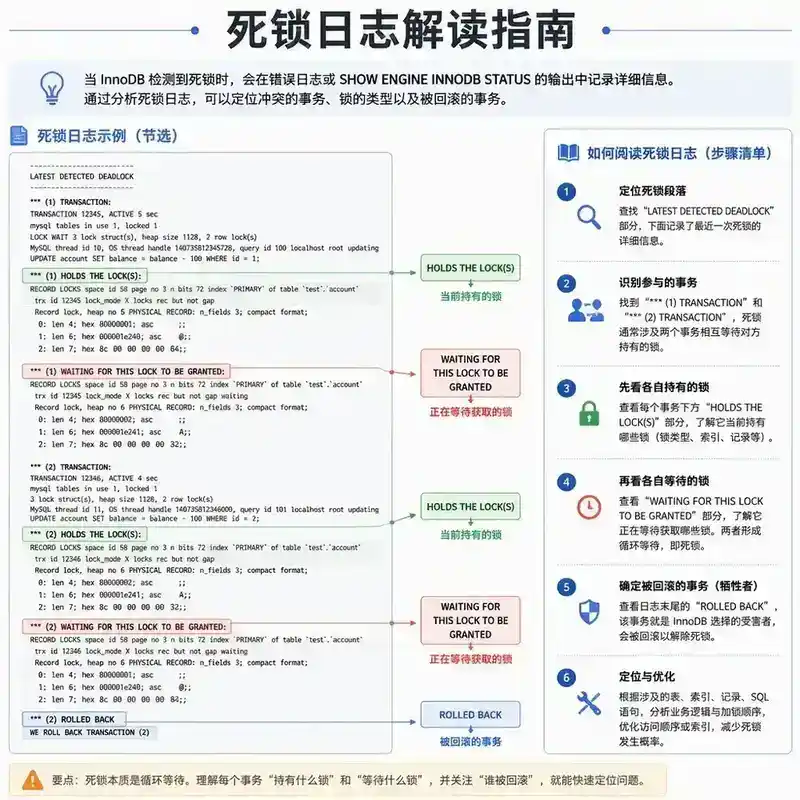
4.2 死锁日志分析
SHOW ENGINE INNODB STATUS\G
-- 搜索 "LATEST DETECTED DEADLOCK"
死锁日志关键信息:
------------------------
LATEST DETECTED DEADLOCK
------------------------
*** (1) TRANSACTION:
TRANSACTION 12345, ACTIVE 10 sec
mysql tables in use 1, locked 1
LOCK WAIT 3 lock struct(s)
MySQL thread id 10, query id 100
UPDATE t SET name='A' WHERE id = 2
*** (1) WAITING FOR THIS LOCK TO BE GRANTED:
RECORD LOCKS space id 0 page no 4 n bits 80
index PRIMARY of table `test`.`t` trx id 12345
lock_mode X locks rec but not gap waiting
Record lock, heap no 3 PHYSICAL RECORD

*** (2) TRANSACTION:
TRANSACTION 12346, ACTIVE 8 sec
*** (2) HOLDS THE LOCK(S):
RECORD LOCKS space id 0 page no 4 n bits 80
index PRIMARY of table `test`.`t` trx id 12346
lock_mode X locks rec but not gap
Record lock, heap no 3 PHYSICAL RECORD

*** (2) WAITING FOR THIS LOCK TO BE GRANTED:
RECORD LOCKS space id 0 page no 4 n bits 80
index PRIMARY of table `test`.`t` trx id 12346
lock_mode X locks rec but not gap waiting
Record lock, heap no 2 PHYSICAL RECORD

*** WE ROLL BACK TRANSACTION (2)
解读要点:
- 看 (1) WAITING FOR 和 (2) WAITING FOR → 理解互相等待什么锁
- 看 (1) HOLDS THE LOCK 和 (2) HOLDS THE LOCK → 理解各自持有什么锁
- 看
WE ROLL BACK TRANSACTION (2)→ 哪个事务被回滚
五、死锁的规避策略
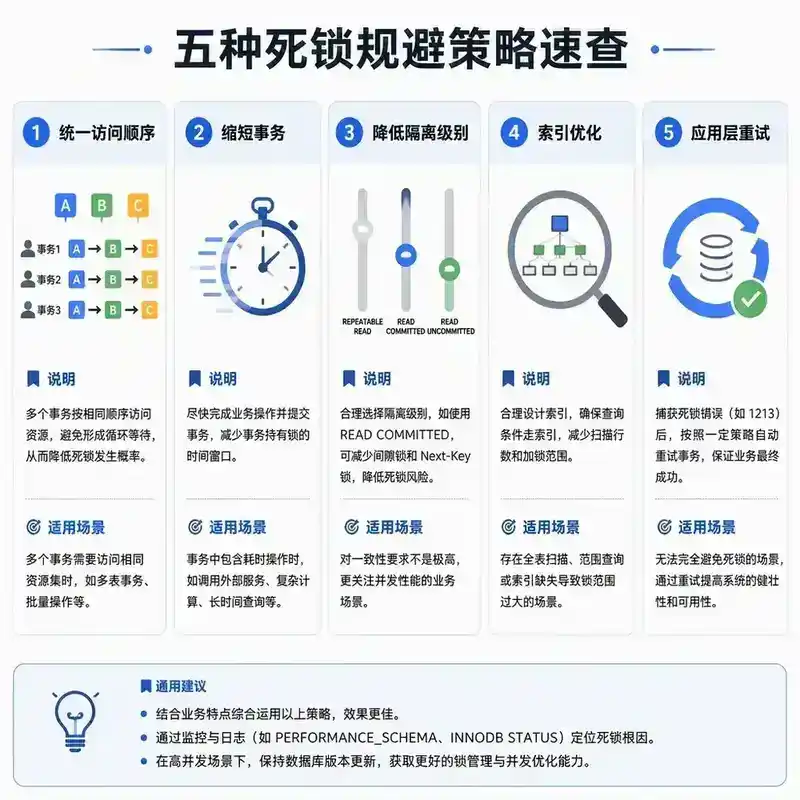
5.1 策略一:统一访问顺序
所有事务按相同顺序访问资源。例如,始终先锁 id 小的行,再锁 id 大的行。
-- 按 id 排序后处理
SELECT * FROM t WHERE id IN (2, 1) ORDER BY id FOR UPDATE;
5.2 策略二:缩短事务
事务越小,持有锁的时间越短,死锁概率越低。
-- 坏:大事务
START TRANSACTION;
UPDATE t1 SET ...;
-- 大量业务逻辑
UPDATE t2 SET ...;
COMMIT;

-- 好:小事务
START TRANSACTION;
UPDATE t1 SET ...;
COMMIT;

START TRANSACTION;
UPDATE t2 SET ...;
COMMIT;
5.3 策略三:使用低隔离级别
READ COMMITTED 不使用间隙锁,减少锁冲突。
5.4 策略四:索引优化
确保 UPDATE/DELETE 使用索引,避免全表扫描导致大量行锁。
5.5 策略五:应用层重试
int retry = 3;
while (retry-- > 0) {
    try {
        // 执行事务
        break;
    } catch (DeadlockLoserDataAccessException e) {
        if (retry == 0) throw e;
        Thread.sleep(100);  // 短暂等待后重试
    }
}
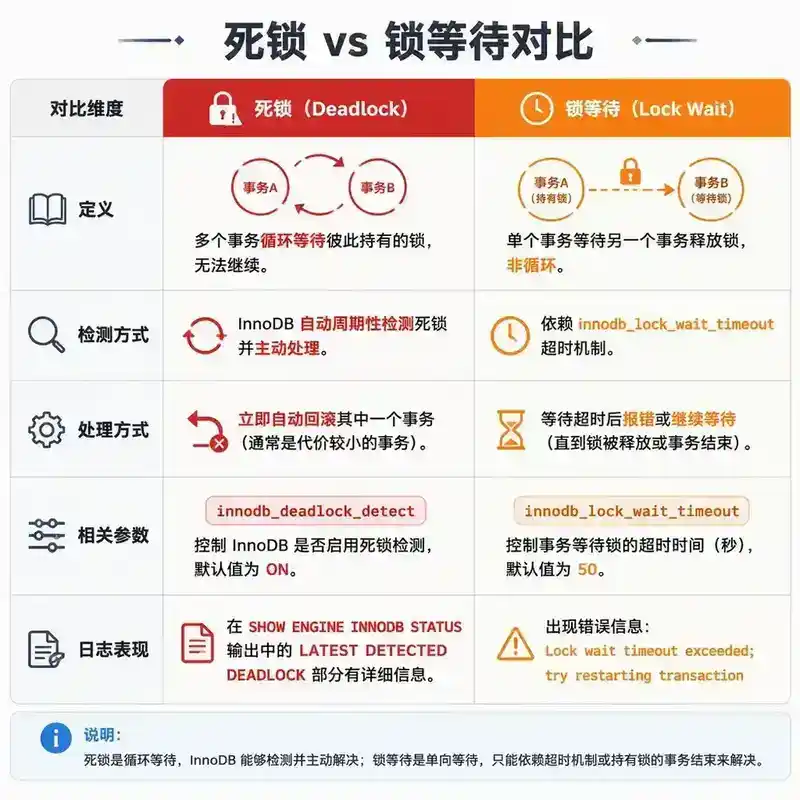
六、死锁与锁等待的区别
| 维度 | 死锁 | 锁等待 |
|---|---|---|
| 定义 | 互相等待,形成环 | 单向等待 |
| 检测 | InnoDB 自动检测 | 超时参数控制 |
| 处理 | 回滚一个事务 | 等待超时或锁释放 |
| 参数 | innodb_deadlock_detect | innodb_lock_wait_timeout |
| 日志 | SHOW ENGINE INNODB STATUS | performance_schema |
七、实战案例
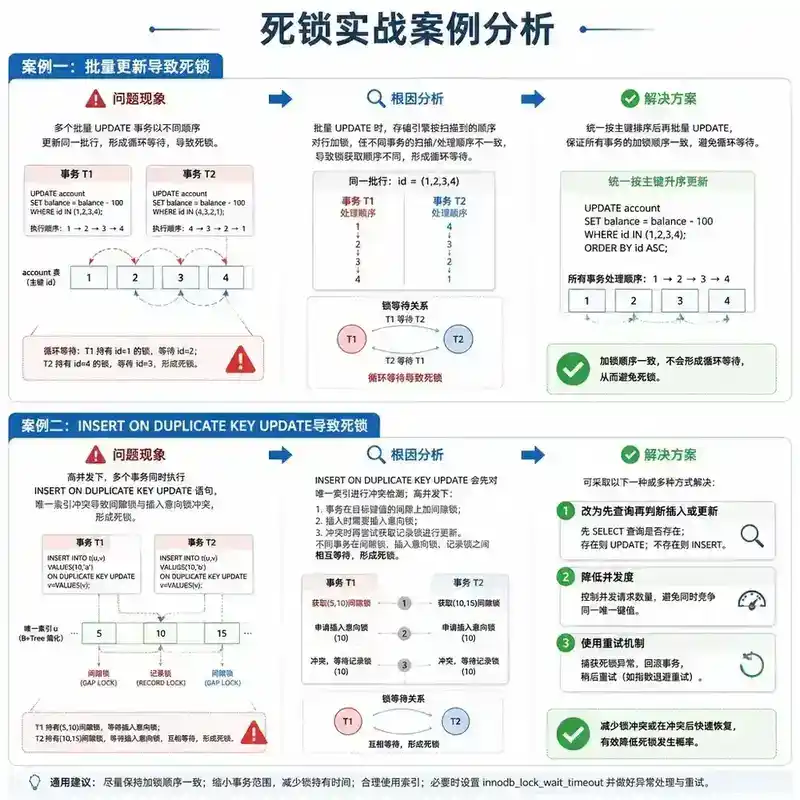
案例一:批量更新的死锁
-- 多个事务同时执行
UPDATE t SET status = 'DONE' WHERE id IN (1, 2, 3, 4, 5);
问题: 不同事务的 IN 列表中的 id 顺序不同,加锁顺序不同,导致死锁。
解决: 应用层对 id 排序后再执行。
案例二:INSERT ON DUPLICATE KEY UPDATE 死锁
-- 多个事务同时插入相同的唯一键
INSERT INTO t (id, name) VALUES (1, 'A')
ON DUPLICATE KEY UPDATE name = 'A';
问题: 三个事务同时 INSERT,都获取了 S 锁(duplicate key 检查),然后都需要升级为 X 锁,互相等待。
解决: 使用 INSERT ... ON DUPLICATE KEY UPDATE 时,确保不会有多个事务同时插入相同的唯一键。
八、总结
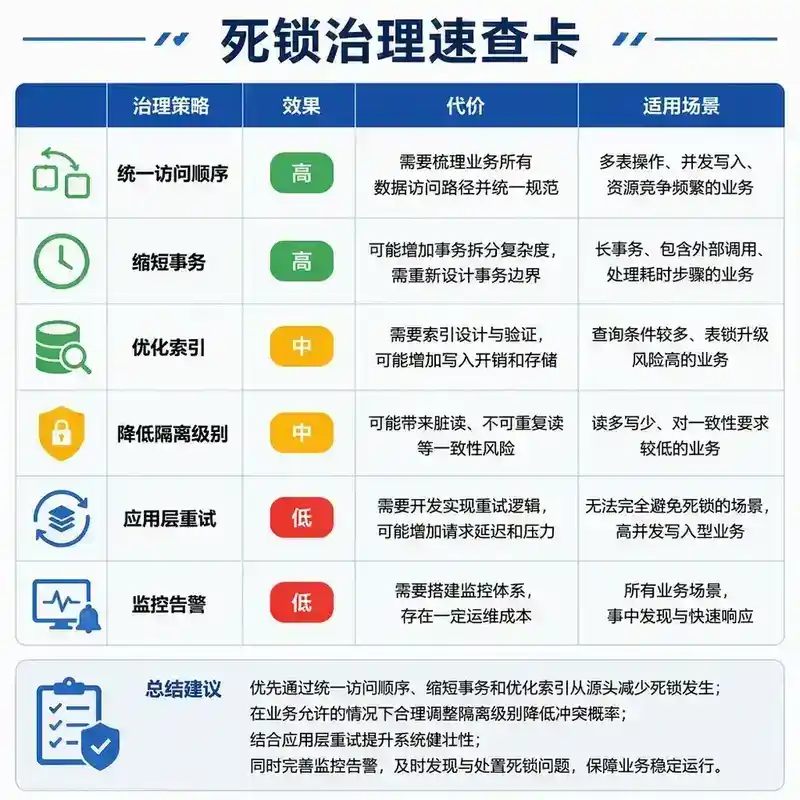
| 策略 | 效果 | 代价 |
|---|---|---|
| 统一访问顺序 | 消除循环等待 | 需要应用层配合 |
| 缩短事务 | 减少锁持有时间 | 需要拆分业务逻辑 |
| 低隔离级别 | 减少间隙锁 | 接受幻读 |
| 索引优化 | 减少锁范围 | 需要索引设计 |
| 应用层重试 | 自动恢复 | 增加代码复杂度 |
九、面试官视角提问
Q1:InnoDB 如何检测死锁?等待图(Wait-for Graph)是如何构建的?死锁检测的时间复杂度是多少?
Q2:**innodb_deadlock_detect=OFF**会有什么后果?什么场景下应该关闭死锁检测?
Q3:两个事务都执行**SELECT * FROM t WHERE id=5 FOR UPDATE**(id=5 不存在),会产生死锁吗?为什么?
Q4:**INSERT ... ON DUPLICATE KEY UPDATE**为什么容易导致死锁?从锁的角度分析整个过程。
Q5:一个事务持有 1000 个行锁,另一个事务等待其中 1 个行锁。如果发生死锁,InnoDB 会回滚哪个事务?为什么?
Q6:你在生产环境遇到过一次死锁,但日志中显示**WE ROLL BACK TRANSACTION (2)**,事务 (2) 是哪个?InnoDB 选择回滚事务的标准是什么?
作者注:本文为系列第 123 篇,属于「08 MySQL 与关系型数据库」分类。
十、面试官提问 · 参考答案
Q1:InnoDB 如何检测死锁?等待图如何构建?时间复杂度?
参考答案:
InnoDB 使用等待图(Wait-for Graph)检测死锁。 节点是事务,边是"事务 A 等待事务 B 释放锁"。当等待图中出现环时,死锁发生。
时间复杂度:O(n),n 是等待图中的节点数。 当并发线程数很高(如 1000+),死锁检测本身可能成为性能瓶颈。这就是 innodb_deadlock_detect=OFF 的动机——在高并发场景下,关闭死锁检测,依赖 innodb_lock_wait_timeout 超时回滚。
Q2: 有什么后果?什么场景关闭?
参考答案:
后果: 死锁不会被自动检测,事务会一直等待直到 innodb_lock_wait_timeout 超时(默认 50 秒)。用户体验变差。
关闭场景: 极高并发(1000+ 并发线程),死锁检测的 O(n) 开销超过死锁本身的开销。MySQL 官方建议在并发超过 200 时考虑关闭。
替代方案: 关闭死锁检测后,减小 innodb_lock_wait_timeout(如设为 5 秒),让等待超时的事务快速回滚。
Q3:两个事务都执行 (id=5 不存在),会死锁吗?
参考答案:
不会死锁。 两个事务都获取了 (上一个id, 下一个id) 的间隙锁。间隙锁之间不冲突,两个事务可以同时持有。
但如果一个事务尝试 INSERT id=5: 会被另一个事务的间隙锁阻塞,但不会死锁——只是单向等待。
Q4: 为什么容易死锁?
参考答案:
三个事务同时 INSERT 相同的唯一键值:
- 事务 A、B、C 都获取了该唯一键的 S 锁(duplicate key 检查)
- 发现记录已存在,都需要将 S 锁升级为 X 锁(执行 UPDATE)
- S 锁之间兼容,但 S→X 升级需要等待所有 S 锁释放
- A 等 B 释放 S 锁,B 等 C 释放 S 锁,C 等 A 释放 S 锁 → 死锁
解决: 使用 INSERT ... ON DUPLICATE KEY UPDATE 前,先用 SELECT ... FOR UPDATE 获取 X 锁,避免 S→X 升级。
Q5:事务 A 持有 1000 个行锁,事务 B 等待其中 1 个。发生死锁回滚谁?
参考答案:
回滚事务 B。 InnoDB 选择回滚"持有最少行锁"的事务,或者"undo log 最少"的事务(回滚代价最小)。
选择标准: 回滚代价最小的事务。事务 B 只持有 1 个行锁(或没有),回滚代价远小于事务 A(持有 1000 个行锁)。
注意: 这不是选择"回滚等待者",而是选择"回滚代价最小的"。如果事务 A 持有 1 个行锁,事务 B 持有 1000 个行锁,InnoDB 会回滚事务 A。
Q6:生产环境死锁日志 ,事务 (2) 是哪个?选择标准?
参考答案:
事务 (2) 是死锁日志中第二个列出的事务。 InnoDB 回滚的是"回滚代价最小"的事务,标准是:
- 持有行锁数量少的事务
- undo log 数量少的事务
- 如果两者相同,选择权重较小的事务(
**innodb_trx_weight**)
死锁日志中的 (1) 和 (2) 不是按时间顺序排列,而是 InnoDB 内部的编号。 回滚哪个事务由代价决定,不是由编号决定。
全文完 | 编号 123 | 分类 08 MySQL 与关系型数据库