阅读时间:约 45 分钟 | 难度:中高级 | 编号:112
一、引言:为什么 B+Tree 是数据库索引的事实标准?
在计算机科学中,可用于索引的数据结构有很多:哈希表、二叉搜索树、AVL 树、红黑树、B 树、跳表……但几乎所有主流关系型数据库(MySQL、PostgreSQL、Oracle、SQL Server)都不约而同地选择了 B+Tree 作为默认索引结构。
这不是巧合,而是由磁盘 I/O 特性决定的必然选择。理解 B+Tree,就是理解数据库索引的本质。
关键问题:
- 为什么不用二叉树而用多叉树?
- 为什么 B+Tree 所有数据都在叶子节点?
- 为什么范围查询用 B+Tree 特别快?
- 页分裂如何影响写入性能?
- 为什么 B+Tree 的层高几乎不超过 4 层?
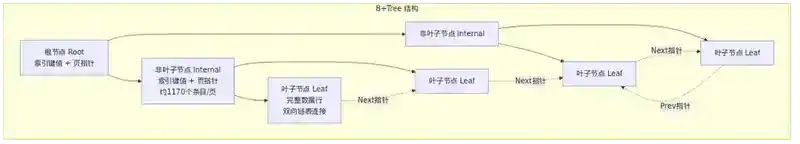
二、从磁盘 I/O 特性理解索引结构设计
2.1 磁盘 I/O 的基本事实
理解 B+Tree 之前,必须先理解它要解决的问题——磁盘 I/O:
| 操作 | 延迟 | 与内存对比 |
|---|---|---|
| L1 缓存访问 | ~1 ns | 基准 |
| 内存访问 | ~100 ns | 100× |
| SSD 随机读 | ~100 μs | 100,000× |
| HDD 随机读 | ~10 ms | 10,000,000× |
核心结论: 一次磁盘随机 I/O 的成本约等于 10 万次内存访问。因此,减少磁盘 I/O 次数是数据库索引设计的首要目标。
2.2 为什么不是二叉树?
假设用二叉搜索树存储 1000 万行数据:
- 平衡二叉树高度 ≈ log₂(10,000,000) ≈ 24 层
- 每次查找需要 24 次磁盘 I/O(每个节点可能在不同页)
- 即使每行只查 1 次,也需要 24 次 I/O
B+Tree 的解法: 将每个节点设计为一个页(16KB),一个页可以存储数百个索引条目。层高从 24 降到 3~4,I/O 次数从 24 降到 3~4。
这就是 B+Tree 的核心思想:用"矮胖"的多叉树替代"高瘦"的二叉树,用少量的磁盘 I/O 覆盖海量数据。
2.3 为什么不是 B 树?
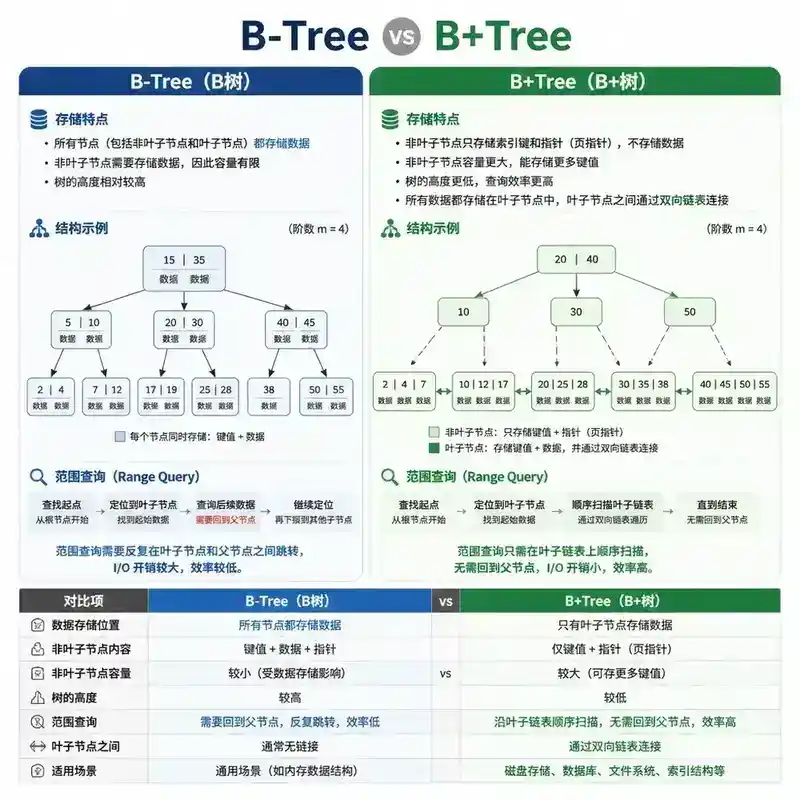
B 树和 B+Tree 最大的区别在于:B 树在所有节点(包括非叶子节点)都存储数据,B+Tree 只在叶子节点存储数据。
| 特性 | B 树 | B+Tree |
|---|---|---|
| 数据存储位置 | 所有节点 | 仅叶子节点 |
| 非叶子节点内容 | 索引键值 + 数据 | 仅索引键值 + 子页指针 |
| 非叶子节点容量 | 较小(数据占空间) | 较大(只存索引键值) |
| 范围查询 | 需要中序遍历,跨层跳转 | 叶子节点链表,顺序扫描 |
| 查询稳定性 | 可能 1 次 I/O 命中根节点 | 总是到达叶子节点,I/O 次数稳定 |
B+Tree 的两大优势:
- 非叶子节点不存数据,可以容纳更多索引条目:同样 16KB 的页,B+Tree 的非叶子节点可以存储约 1170 个条目(BIGINT 主键),而 B 树可能只有 500 个。层高更低。
- 叶子节点之间有双向链表:范围查询(
WHERE id BETWEEN 1 AND 1000)可以直接沿着链表顺序扫描,不需要回到父节点。这是 B+Tree 相比 B 树最大的性能优势。
三、B+Tree 的结构与操作
3.1 整体结构
B+Tree 由两种节点组成:
非叶子节点(Internal Node):
┌────────┬──────┬────────┬──────┬────────┐
│ Page Ptr │ Key₁ │ Page Ptr │ Key₂ │ Page Ptr │
└────────┴──────┴────────┴──────┴────────┘
  指向子页   分界键   指向子页   分界键   指向子页
每个非叶子节点包含多个 <Key, Page Pointer> 对。Key 是分界键,左边子页的所有键值 ≤ Key,右边子页的所有键值 > Key。
叶子节点(Leaf Node):
┌──────┬──────┬──────────┬──────┬──────┬──────────┐
│ Prev │ Key₁ │ Row Data │ Key₂ │ Row Data │ Next │
└──────┴──────┴──────────┴──────┴──────┴──────────┘
 前一页指针                    后一页指针(双向链表)
叶子节点包含完整的数据行(聚簇索引)或 <索引键值, 主键> 对(二级索引)。每个叶子节点有指向前后叶子节点的指针,形成双向链表。
3.2 查找过程
以查找 id = 500 为例:
1. 从根节点开始(通常已在 Buffer Pool 中)
2. 在根节点中二分查找:100 < 500 ≤ 1000?→ 进入中间子页
3. 在中间节点中二分查找:500 在哪个范围?→ 进入对应叶子页
4. 在叶子页中二分查找(通过 Page Directory 槽位)→ 找到目标行
总共 3 次磁盘 I/O(如果根节点和中间节点不在 Buffer Pool 中)。这就是 B+Tree 的典型查找成本。
3.3 范围查询
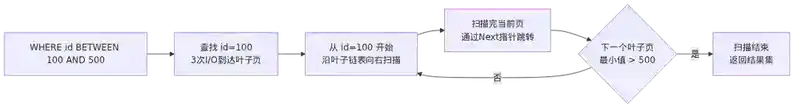
以 WHERE id BETWEEN 100 AND 500 为例:
1. 查找到 id=100 所在的叶子页(3 次 I/O)
2. 从 id=100 开始,沿着叶子节点链表向右扫描
3. 每扫描完一个叶子页,通过 Next 指针跳转到下一个叶子页
4. 直到 id > 500 停止
关键优势: 不需要回到非叶子节点!叶子节点之间的双向链表使得范围查询可以纯粹在叶子层完成,这是 B+Tree 相比 B 树的核心优势。
3.4 插入与页分裂
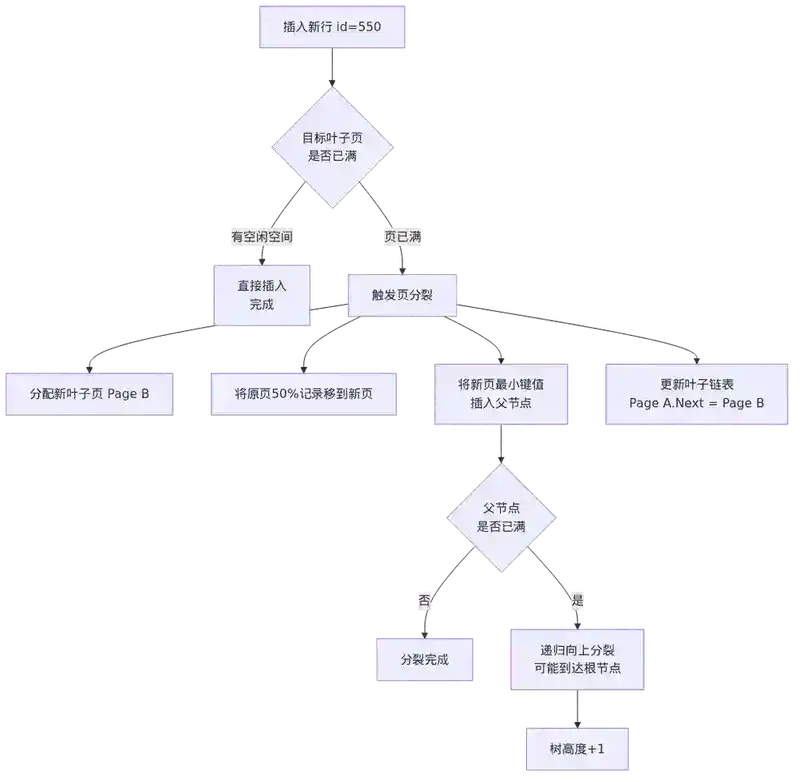
插入 id = 550 到一个已满的叶子页:
1. 查找到 id=550 应该插入的叶子页
2. 发现叶子页已满(没有足够的 Free Space)
3. 触发页分裂:
   a. 分配一个新的叶子页
   b. 将原页中约 50% 的记录移动到新页
   c. 将新页的最小键值和页指针插入到父节点
   d. 更新叶子节点链表(原页 Next → 新页,新页 Prev → 原页)
   e. 如果父节点也满了,递归向上分裂
页分裂的代价:
- 至少 2 次磁盘写入(原页 + 新页)
- 更新父节点(可能触发递归分裂)
- 更新叶子节点链表指针
- 如果父节点也满了,分裂会一直向上传播到根节点
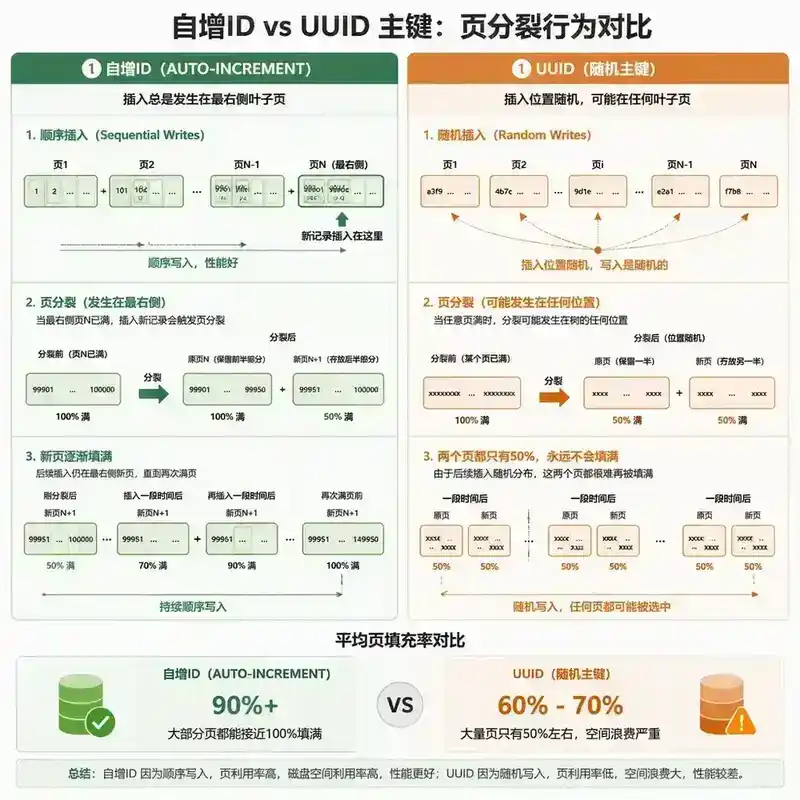
这就是为什么 UUID 主键的写入性能远低于自增主键——UUID 主键的插入位置随机,导致频繁的页分裂,而自增主键的插入总是在最右侧,页分裂只发生在最右侧的叶子节点。
四、层高:为什么 B+Tree 几乎不超过 4 层?
4.1 层高的计算
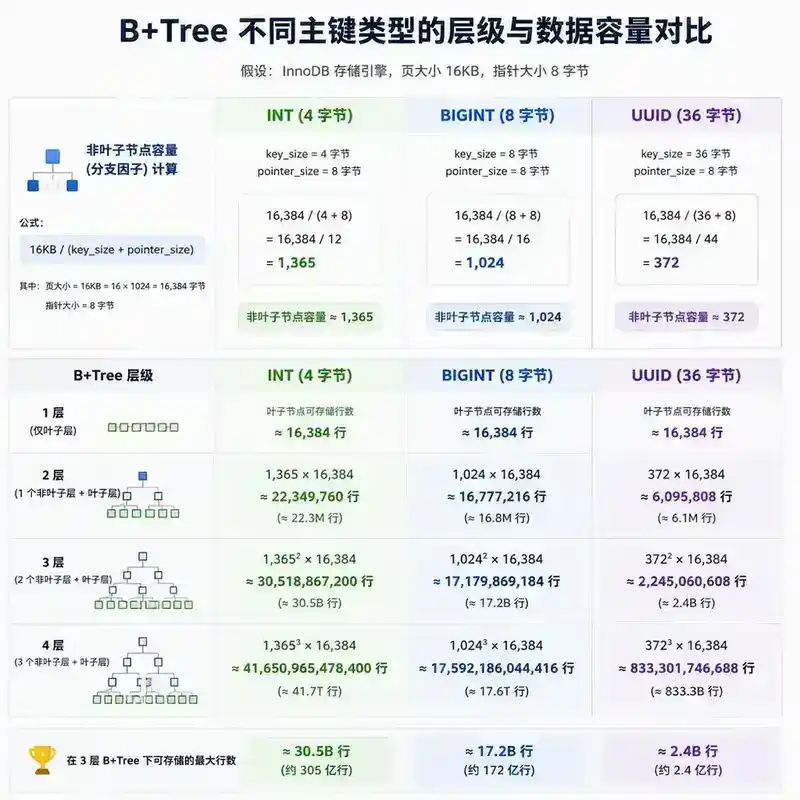
B+Tree 的层高取决于两个因素:
- 非叶子节点能容纳的索引条目数量
- 叶子节点能容纳的数据行数量
非叶子节点容量:
假设主键为 BIGINT(8 字节),页指针为 6 字节(InnoDB 内部 FIL_PAGE_PREV/FIL_PAGE_NEXT 用 4 字节,但 B+Tree 索引中的页指针实际是页号,4 字节足够,这里取 6 字节含开销)。
每个非叶子节点可容纳的条目数 ≈ 16KB / (8 + 6) ≈ 1170 个。
叶子节点容量:
假设每行数据 1KB,每个叶子节点可容纳约 16 行。
不同层高能存储的行数:
| 层数 | 非叶子节点数 | 叶子节点数 | 总行数 |
|---|---|---|---|
| 1 | 0 | 1 | 16 |
| 2 | 1 | 1,170 | 18,720 |
| 3 | 1,170 | 1,368,900 | 21,902,400 |
| 4 | 1,368,900 | 1,601,613,000 | 25,625,808,000 |
结论: 3 层就可以存 2000 万行,4 层可以存 250 亿行。这就是为什么你几乎看不到 5 层的 B+Tree。
4.2 影响层高的因素
主键大小: 主键越大,非叶子节点能容纳的条目越少,层高越高。
| 主键类型 | 大小 | 每页条目数 | 3 层最多行数 |
|---|---|---|---|
| INT | 4 字节 | ~1638 | ~4300 万 |
| BIGINT | 8 字节 | ~1170 | ~2200 万 |
| UUID CHAR(36) | 36 字节 | ~390 | ~240 万 |
| 复合主键 (2×BIGINT) | 16 字节 | ~744 | ~880 万 |
这就是为什么主键要尽可能小——它直接影响 B+Tree 的层高和索引大小。
4.3 如何查看 B+Tree 层高?
MySQL 没有直接显示层高的命令,但可以通过以下方式推断:
-- 查看索引的页数(近似)
SELECT index_name, stat_value AS pages
FROM mysql.innodb_index_stats
WHERE table_name = 'your_table'
  AND stat_name = 'size';

-- 层高 ≈ log₁₁₇₀(pages)
-- 例如:pages = 1000,层高 ≈ 2
--       pages = 1,000,000,层高 ≈ 3
五、页分裂:写入性能的隐形杀手
5.1 页分裂的触发条件
页分裂发生在新行插入时,目标页没有足够的空闲空间。具体来说:
- 页的 Free Space 不足以容纳新行
- 新行 + 现有行 > 页大小 - 页头开销(约 200 字节)
5.2 页分裂的过程
分裂前:                         分裂后:
┌─────────────────────┐         ┌──────────┐  ┌──────────┐
│ Page A (已满)        │         │ Page A   │  │ Page B   │
│ 1, 2, 3, 4, 5, 6    │   →    │ 1, 2, 3  │  │ 4, 5, 6  │
│ 空闲空间:0           │         │ 空闲:50% │  │ 空闲:50% │
└─────────────────────┘         └──────────┘  └──────────┘
分裂策略:
- 找到插入位置
- 将页中约 50% 的记录移动到新页
- 将新页的最小键值插入父节点
- 更新叶子节点链表
- 如果父节点也满了,递归分裂
5.3 页分裂的性能影响
| 影响 | 说明 |
|---|---|
| 磁盘 I/O | 至少 2 次写入(原页 + 新页),可能更多(父节点递归分裂) |
| 页填充率下降 | 分裂后两页各约 50%,空间利用率下降 |
| 索引碎片化 | 逻辑上连续的数据在物理上分散,范围查询效率下降 |
| Buffer Pool 抖动 | 新页加入 Buffer Pool,可能挤出热点页 |
5.4 自增主键 vs UUID 主键的页分裂对比
| 维度 | 自增主键 | UUID 主键 |
|---|---|---|
| 分裂位置 | 总是最右侧叶子页 | 随机位置 |
| 分裂频率 | 低(只在最右侧满了才分裂) | 高(任意位置都可能满) |
| 分裂后填充率 | 旧页 100%,新页 50%→逐渐填满 | 两页各 50%,之后不一定填满 |
| 平均页填充率 | 90%+ | 60~70% |
| 磁盘 I/O 模式 | 顺序写 | 随机写 |
优化手段:
innodb_fill_factor:控制页分裂时的填充率。默认 100%(插满才分裂),可设为 70% 为后续更新预留空间。- 自增主键:避免随机插入导致的页分裂。
- 定期
OPTIMIZE TABLE:重建表,回收碎片空间,提高页填充率。
六、范围查询:B+Tree 的杀手锏
6.1 为什么范围查询是 B+Tree 的强项?
B+Tree 的叶子节点通过双向链表连接,这是它相比其他索引结构最大的优势。
场景:SELECT * FROM orders WHERE order_date BETWEEN '2024-01-01' AND '2024-01-31'
B+Tree 的执行过程:
- 在 B+Tree 中查找到
order_date = '2024-01-01'的第一个叶子页(3 次 I/O) - 从该位置开始,沿着叶子节点链表向右扫描
- 每扫描完一个页,通过 Next 指针跳转到下一个页
- 直到
order_date > '2024-01-31'停止
不需要:
- 回到非叶子节点
- 额外的索引查找
- 对结果排序(叶子节点本身有序)
对比其他数据结构:
| 数据结构 | 范围查询 | 原因 |
|---|---|---|
| B+Tree | O(log n + k),k 为结果行数 | 叶子节点链表顺序扫描 |
| B 树 | O(log n + k × log n) | 每次跨页需要回到父节点 |
| 哈希索引 | 不支持 | 哈希表无序 |
| 跳表 | O(log n + k) | 类似 B+Tree,但内存结构 |
6.2 范围查询的优化技巧
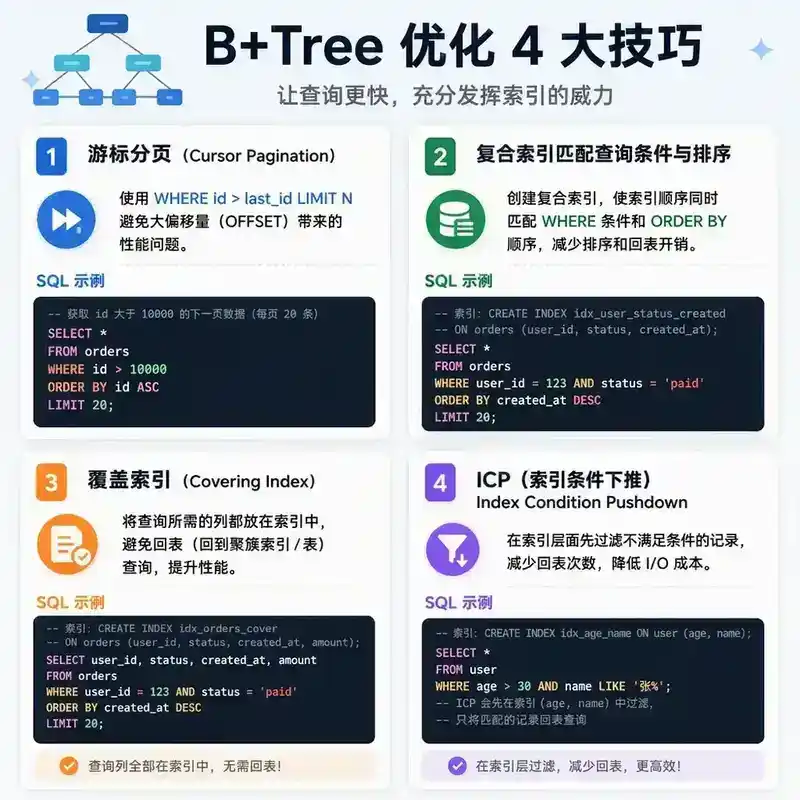
(1)利用覆盖索引
-- 需要回表(对每一行都要通过主键查聚簇索引)
SELECT * FROM orders WHERE order_date BETWEEN '2024-01-01' AND '2024-01-31';

-- 覆盖索引,不需要回表
SELECT order_id, order_date FROM orders
WHERE order_date BETWEEN '2024-01-01' AND '2024-01-31';
(2)避免大范围扫描
-- 坏:扫描 100 万行
SELECT * FROM orders WHERE id BETWEEN 1 AND 1000000;

-- 好:分批扫描
SELECT * FROM orders WHERE id BETWEEN 1 AND 1000;
SELECT * FROM orders WHERE id BETWEEN 1001 AND 2000;
-- ...
(3)利用索引下推(ICP)
MySQL 5.6+ 支持 Index Condition Pushdown,在索引层就过滤掉不符合条件的行,减少回表次数。
-- 开启 ICP(默认开启)
SET optimizer_switch = 'index_condition_pushdown=on';

-- ICP 会在 idx_name_age 索引中过滤 name LIKE 'A%',减少回表
SELECT * FROM users WHERE name LIKE 'A%' AND age > 20;
七、磁盘 I/O 视角:B+Tree 的性能秘密
7.1 为什么 B+Tree 对磁盘友好?
(1)节点大小 = 页大小
B+Tree 的每个节点恰好是一个 InnoDB 页(16KB)。这意味着每次磁盘 I/O 读写的都是完整的 B+Tree 节点,没有浪费。
(2)高扇出(Fan-out)
B+Tree 的非叶子节点可以容纳大量索引条目,使得树的高度极低。1000 万行数据只需要 3 层,每次查找最多 3 次磁盘 I/O。
(3)局部性原理
B+Tree 的叶子节点在物理上尽可能连续(通过区分配机制)。范围查询时,相邻的叶子节点很可能在同一个区中,可以顺序读取。
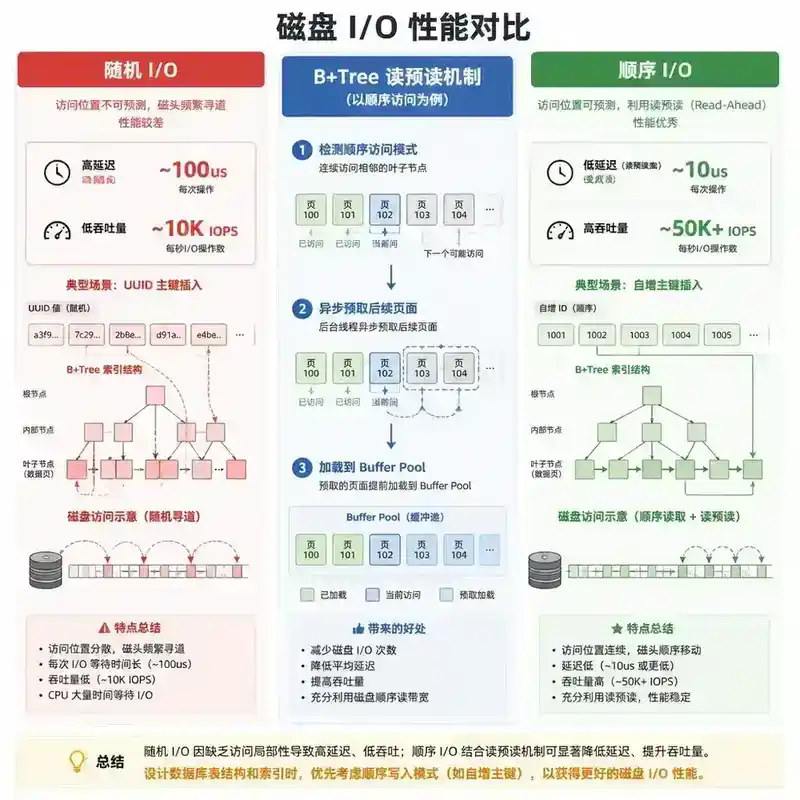
(4)预读(Read-Ahead)
InnoDB 检测到顺序访问模式时,会异步预读后续的页到 Buffer Pool 中。范围查询时,预读可以显著减少 I/O 等待时间。
7.2 随机 I/O vs 顺序 I/O
| 场景 | I/O 模式 | 典型延迟 | 吞吐量 |
|---|---|---|---|
| 主键点查询(Buffer Pool 命中) | 无 I/O | 0 | N/A |
| 主键点查询(Buffer Pool 未命中) | 随机读 | ~100 μs (SSD) | ~10K QPS |
| 自增主键插入 | 顺序写 | ~100 μs (SSD) | ~50K QPS |
| UUID 主键插入 | 随机写 | ~100 μs × 多次 | ~5K QPS |
| 主键范围查询 | 顺序读 | ~100 μs + 预读 | 高吞吐 |
| 二级索引范围查询 + 回表 | 随机读 | ~100 μs × N | 低吞吐 |
关键洞察: 自增主键的范围查询和插入都是顺序 I/O,而 UUID 主键的插入是随机 I/O。这就是为什么 InnoDB 强烈建议使用自增主键——不仅仅是写入性能,还有范围查询性能。
八、实战:B+Tree 相关的性能问题与优化
8.1 为什么 LIMIT 大偏移量很慢?
SELECT * FROM orders ORDER BY id LIMIT 1000000, 10;
B+Tree 需要扫描前 100 万行(虽然不回表),然后丢弃它们,只返回最后 10 行。这是 "越往后越慢" 的根本原因。
优化方案——游标分页:
-- 第一页
SELECT * FROM orders WHERE id > 0 ORDER BY id LIMIT 10;

-- 第二页(用上一页最后一条的 id 作为游标)
SELECT * FROM orders WHERE id > 10 ORDER BY id LIMIT 10;
游标分页利用 B+Tree 的叶子节点链表,直接从 id > 10 的位置开始扫描,不需要跳过前面的行。
8.2 为什么 ORDER BY 和 WHERE 用不同列时可能用不上索引?
SELECT * FROM orders
WHERE status = 'PAID'
ORDER BY create_time DESC
LIMIT 10;
B+Tree 只能按一个顺序组织数据。如果索引是 (status, create_time),则数据先按 status 排序,同 status 内按 create_time 排序。但如果 WHERE 条件筛选后,剩余行的 create_time 可能不连续,仍需要排序。
优化: 建立联合索引 (status, create_time),并确保查询条件与索引顺序匹配。
8.3 为什么 COUNT(*) 在大表上慢?
COUNT(*) 需要遍历所有行(通过最小的二级索引来减少扫描页数)。对于 10GB 的表:
- 如果使用二级索引(每个叶子页约 200 行),需要扫描约 30 万个页
- 每次 16KB 的顺序读,约 30 万 × 100μs ≈ 30 秒
优化: 使用汇总表、缓存、或者近似值(SHOW TABLE STATUS)。
九、总结
B+Tree 是数据库索引的事实标准,因为它完美解决了磁盘 I/O 的核心矛盾:
- 矮胖多叉:层高极低(≤4 层),每次查找只需 3~4 次磁盘 I/O
- 叶子节点链表:范围查询不需要回父节点,顺序扫描效率极高
- 节点 = 页:完美匹配磁盘 I/O 的最小单位
- 自平衡:通过页分裂和页合并自动维护平衡
一句话总结: B+Tree 用"矮胖"结构将海量数据的查找代价降到对数级别,用叶子节点链表将范围查询代价降到近乎线性扫描。
十、面试官视角提问
以下问题从面试官视角出发,考察候选人对 B+Tree 索引的深入理解和工程经验。不计入 40 分钟阅读时间。
Q1:一个表有 5000 万行数据,主键是 BIGINT 自增,每行约 500 字节。B+Tree 大概有几层?如果主键改成 VARCHAR(64) 的 UUID,层数会怎么变化?请给出计算过程。
Q2:你用 **SELECT * FROM orders WHERE id BETWEEN 1000000 AND 1001000** 查询了 1000 行数据。假设 Buffer Pool 中没有任何相关页,这个查询最少需要多少次磁盘随机 I/O?最多需要多少次?请解释你的推理。
Q3:为什么 InnoDB 的 B+Tree 叶子节点之间使用双向链表而不是单向链表?双向链表解决了什么单向链表无法解决的问题?
Q4:一个表使用自增主键,每天插入 100 万行。经过 100 天后,你发现写入性能下降了 30%。可能的原因是什么?如何排查和优化?
Q5:**SELECT * FROM table WHERE a > 1 ORDER BY b LIMIT 10**,有索引 **(a, b)**。这个查询能用上索引的排序吗?为什么?如果不能用,怎么优化?
Q6:如果让你设计一个 LSM-Tree 存储引擎(如 LevelDB/RocksDB)的索引结构,你会继续使用 B+Tree 吗?为什么?B+Tree 和 LSM-Tree 分别适合什么场景?
作者注:本文为"Java 技术专家与架构师面试:250 个高频考点"系列第 112 篇,属于「08 MySQL 与关系型数据库」分类。
十一、面试官提问 · 参考答案
以下为第十节中 6 道面试题的参考答案,从面试官视角评估候选人的理解深度。
Q1:5000 万行 BIGINT 自增主键,B+Tree 几层?换成 UUID 呢?
参考答案:
BIGINT 自增主键:
非叶子节点容量:16KB / (8 + 6) ≈ 1170 个条目/页。叶子节点:每行 500 字节,16KB / 500 ≈ 32 行/页。
| 层数 | 叶子节点数 | 总行数 |
|---|---|---|
| 2 | 1,170 | 37,440 |
| 3 | 1,368,900 | 43,804,800 |
5000 万行 > 4300 万(3 层上限),所以需要 4 层。4 层可存约 250 亿行,远超 5000 万。
UUID VARCHAR(64):
非叶子节点容量:16KB / (64 + 6) ≈ 234 个条目/页。叶子节点容量不变,32 行/页。
| 层数 | 叶子节点数 | 总行数 |
|---|---|---|
| 3 | 54,756 | 1,752,192 |
| 4 | 12,812,904 | 410,012,928 |
5000 万行 > 4.1 亿?不,5000 万 < 4.1 亿(4 层上限),但仍需要 4 层(3 层只有 175 万行)。
关键差异: UUID 的 4 层 B+Tree 只有约 1281 万个非叶子节点页面,而 BIGINT 的 4 层可容纳 250 亿行。UUID 主键不仅每层容量更小,而且页填充率更低(60-70% vs 90%+),实际可存储的行数比理论值还要打折扣。
面试官评分要点: 候选人能否给出完整的计算过程,并提到页填充率对实际容量的影响。
Q2: 查询 1000 行,最少/最多多少次随机 I/O?
参考答案:
最少(B+Tree 3 层,数据连续,Buffer Pool 全空):
- 查找 id=1000000:根节点(1 次) → 非叶子节点(1 次) → 叶子节点(1 次) = 3 次
- 沿叶子链表扫描:1000 行 / 32 行/页 ≈ 32 个叶子页,但相邻叶子页可能在同一区中,InnoDB 预读机制可减少实际 I/O。实际约 3~8 次(预读合并)。
- 总计:约 6~11 次随机 I/O。
最多(极端碎片化,每页只有 1 行):
- 查找 id=1000000:3 次
- 扫描 1000 行,每行一个页,每个页都需要一次随机 I/O:1000 次
- 总计:约 1003 次随机 I/O。
实际场景: 自增主键、数据未大量删除 → 接近最少。UUID 主键、频繁删除 → 接近最多。
面试官评分要点: 候选人能否区分"最少"和"最多"场景,并关联到页填充率和主键设计。
Q3:为什么 B+Tree 叶子节点用双向链表而不是单向链表?
参考答案:
双向链表解决的核心问题:
(1)逆向范围查询
SELECT * FROM t WHERE id BETWEEN 100 AND 500 ORDER BY id DESC;
如果只有单向链表,需要先找到 id=500,然后无法向左遍历。必须回到父节点找前一个叶子页,复杂度 O(k × log n)。双向链表可以直接从 id=500 向左遍历,复杂度 O(log n + k)。
(2)DELETE 操作后的叶子节点合并
当删除大量数据导致两个相邻叶子页都很空时,InnoDB 会触发页合并。双向链表使得合并时可以方便地更新前后页的指针——Prev 和 Next 都需要更新。如果只有单向链表,需要回到父节点或重新查找来定位前一个页。
(3)并发控制
在页分裂时,需要同时更新原页的 Next 指针和新页的 Prev 和 Next 指针。双向链表使得分裂操作可以原子化地完成,而不需要额外的查找。
(4)反向扫描的优化器选择
MySQL 优化器在某些场景下会选择反向扫描(Backward index scan),例如 ORDER BY id DESC LIMIT 10。双向链表使得反向扫描和正向扫描一样高效。
面试官评分要点: 候选人不能只回答"双向链表可以反向遍历",要能说出具体的 SQL 场景(ORDER BY DESC、页合并、并发控制)。
Q4:自增主键表,每天插入 100 万行,100 天后写入性能下降 30%,为什么?
参考答案:
可能原因(按可能性排序):
(1)B+Tree 层数增加
100 天 × 100 万 = 1 亿行。假设每行 500 字节,3 层 B+Tree 最多存 4300 万行。1 亿行需要 4 层。每增加一层,每次插入需要多一次 I/O(更新更多层的父节点)。层数从 3 到 4,写入性能下降约 25-33%。
(2)Buffer Pool 不够用
1 亿行 × 500 字节 ≈ 50GB 数据 + 索引。如果 Buffer Pool 只有 8GB,热点数据无法全部缓存,越来越多的插入需要触发磁盘 I/O 来加载目标页。
(3)页分裂导致碎片化
虽然自增主键的页分裂只发生在最右侧,但 100 天后的表可能经历了多次页分裂,叶子节点在物理上不再完全连续,顺序写的优势减弱。
(4)二级索引维护成本
如果有多个二级索引,每次插入都需要更新所有二级索引。1 亿行数据,二级索引的 B+Tree 可能也达到了 4 层,维护成本翻倍。
排查方法:
-- 查看索引大小和层数
SELECT index_name, stat_value AS pages
FROM mysql.innodb_index_stats
WHERE table_name = 'your_table' AND stat_name = 'size';

-- 查看 Buffer Pool 命中率
SHOW STATUS LIKE 'Innodb_buffer_pool_read%';

-- 查看页分裂次数
SHOW STATUS LIKE 'Innodb_pages_split';
面试官评分要点: 候选人能否给出多种可能原因并有排查思路,而不只是说"数据多了就慢了"。
Q5:,索引 能用上排序吗?
参考答案:
不能用上索引排序。 需要 filesort。
原因:
联合索引 (a, b) 的数据组织方式:先按 a 排序,a 相同再按 b 排序。但 WHERE a > 1 筛选出的行,a 值不同(2, 3, 4, ...),在索引中 b 的值不是全局有序的。
索引 (a, b) 的数据顺序:
(1, 10), (1, 20), (2, 5), (2, 15), (3, 8), (3, 25)
                  ↑
WHERE a > 1 筛选出:
(2, 5), (2, 15), (3, 8), (3, 25)
但 b 不是有序的:5, 15, 8, 25 ← 需要 filesort
能用上排序的场景:
-- 场景1:a 等值查询,b 排序
SELECT * FROM t WHERE a = 1 ORDER BY b;  -- 可用索引排序

-- 场景2:索引改为 (b, a)
SELECT * FROM t WHERE a > 1 ORDER BY b;  -- b 在前,全局有序
优化方案:
- 如果 a 的取值范围很小(如状态值),考虑
WHERE a IN (1,2,3) ORDER BY b,优化器可能使用索引合并排序 - 建立
(b)单独索引,但需要权衡回表成本 - 如果 a 是范围查询且结果集很大,接受 filesort 可能是最优选择
面试官评分要点: 候选人能否解释"联合索引中 b 只在 a 相同的情况下有序"这个核心概念,并给出具体的索引数据示例。
Q6:如果设计 LSM-Tree 存储引擎,会继续用 B+Tree 吗?为什么?
参考答案:
不会用 B+Tree,LSM-Tree 和 B+Tree 有根本不同的设计哲学。
B+Tree 适合的场景(OLTP):
- 读多写少,点查询和范围查询为主
- 需要事务支持(MVCC 基于 B+Tree 的 Undo 日志)
- 数据需要实时一致性
LSM-Tree 适合的场景(OLAP/时序/日志):
- 写多读少,批量写入为主
- 写吞吐量优先,可接受读放大
- 数据按时间顺序写入,很少更新
LSM-Tree 的核心思想:
- 写入先到内存 MemTable(跳表/红黑树)
- MemTable 满了刷到磁盘为 SSTable(不可变)
- 后台 Compaction 合并多个 SSTable,去除重复和删除
- 查询需要从 MemTable + 多个 SSTable 中查找
B+Tree 和 LSM-Tree 的对比:
| 维度 | B+Tree | LSM-Tree |
|---|---|---|
| 写入 | 随机写(页分裂) | 顺序写(追加) |
| 读取 | 单次 I/O | 多次 I/O(读放大) |
| 空间放大 | 页填充率 | Compaction 开销 |
| 典型产品 | MySQL InnoDB | LevelDB, RocksDB, HBase |
面试官评分要点: 候选人需要理解两种数据结构的设计哲学差异,而不是简单说"B+Tree 更好"或"LSM-Tree 更好"。关键是"合适场景"的判断。
全文完 | 编号 112 | 分类 08 MySQL 与关系型数据库