阅读指南
- 阅读时间:约 40-50 分钟
- 目标读者:3 年以上 Java 后端工程师、技术专家、架构师
- 前置知识:MySQL 基础、主从复制概念、Spring 框架基础
- 你将收获:从原理到生产实践的完整读写分离知识体系,以及面试中可能被追问的 8 个深度问题
1. 为什么需要读写分离?——从单机瓶颈说起
任何一个互联网系统,当用户量增长到一定规模,数据库都会成为瓶颈。而瓶颈最典型的特征就是:读远多于写。
以电商系统为例,商品详情页的 QPS 可能是下单接口的 100 倍以上。社交 Feed 流、内容平台、IM 消息列表,几乎都符合"读多写少"的模式。如果所有请求都打到同一台 MySQL 实例上,即使 SQL 优化到极致、索引建得再好,单机的 CPU 和 IOPS 也总是有上限的。
读写分离的本质思路非常简单:把读请求和写请求分开,让主库专注写,让从库分担读。这看起来是一个简单的架构决策,但真正落地时会遇到三个核心挑战:
- 复制延迟:主库写入的数据,从库什么时候能看到?
- 读一致性:在复制延迟存在的前提下,如何保证用户读到的是"正确"的数据?
- 故障切换:主库挂了怎么办?从库挂了怎么办?切换过程如何保证数据不丢、业务不中断?
这三个问题,就是本文要深入拆解的核心。
2. 读写分离的架构模型
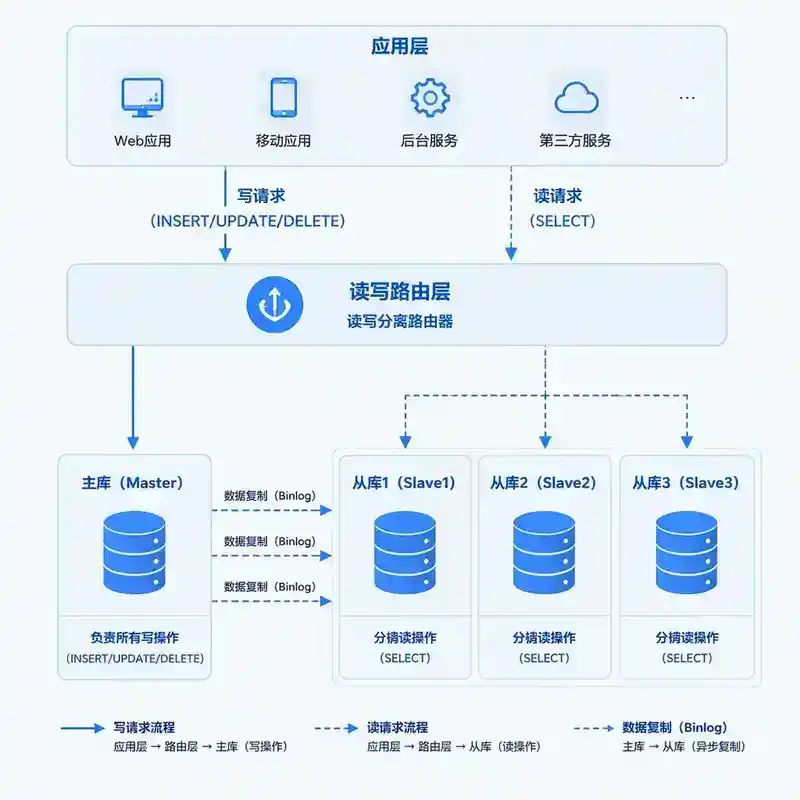
2.1 最基本的"一主多从"架构
┌──────────┐
│   应用层   │
│  读写路由  │
└────┬─────┘
     │
     ├── 写 ──→  ┌──────────┐
     │           │  主库(M)  │
     │           └────┬─────┘
     │                │ 复制
     │        ┌───────┼───────┐
     │        ▼       ▼       ▼
     ├── 读 ──→ ┌────┐ ┌────┐ ┌────┐
     │         │从库1│ │从库2│ │从库3│
     │         └────┘ └────┘ └────┘
这是最经典的形态。主库负责所有写入(INSERT/UPDATE/DELETE),从库通过异步复制同步数据,应用层通过路由规则将 SELECT 分发到从库。
关键参数:从库的数量不是越多越好。每增加一个从库,主库就要多推一份 binlog,网络和 I/O 压力线性增长。一般建议 3-5 个从库是性价比最高的区间。
2.2 多级级联架构
当从库数量需要更大时(比如几十个只读实例),可以在主库和从库之间加一层"中继从库":
主库 ──→ 中继从库1 ──→ 叶子从库A/B/C
       ──→ 中继从库2 ──→ 叶子从库D/E/F
这样主库只需要向 2 个中继从库推送 binlog,中继从库再向下分发。代价是延迟会多一级 —— 叶子从库的延迟 = 中继从库的延迟 + 中继到叶子从库的延迟。
2.3 单元化架构中的读写分离
在异地多活架构中,读写分离会融合进单元化设计。每个单元内部有自己的读写分离拓扑,但跨单元的数据同步通过更复杂的复制机制实现。这个话题在第 198 期已经详细讨论过,本文不再展开。
3. MySQL 主从复制:读写分离的基石
读写分离能跑起来,底层依赖的是 MySQL 的复制机制。理解复制,才能真正理解延迟从哪来、一致性怎么保。
3.1 复制的基本流程
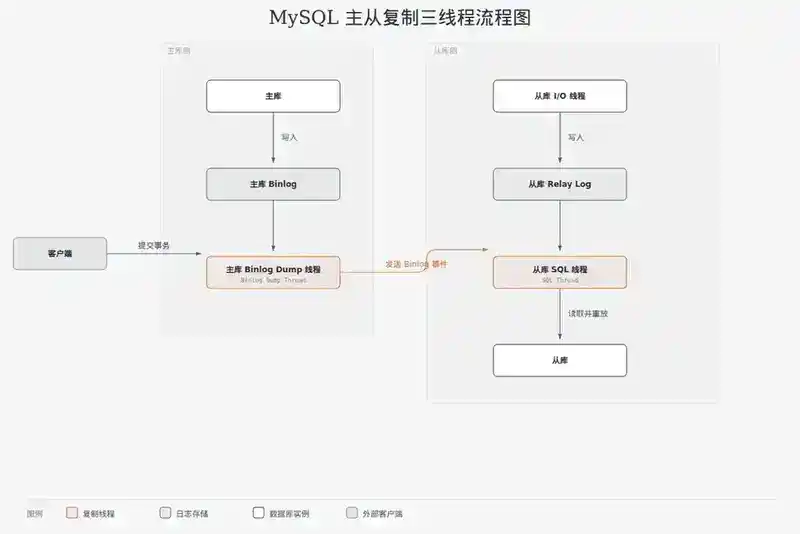
MySQL 的传统复制(基于 binlog)有三个线程参与:
- 主库的 Binlog Dump 线程:主库上运行的线程,负责把 binlog 事件发送给从库
- 从库的 I/O 线程:从库上运行的线程,负责接收主库的 binlog 事件,写入中继日志(relay log)
- 从库的 SQL 线程:从库上运行的线程,负责读取 relay log 中的事件并重放执行
主库                          从库
┌──────────┐              ┌──────────────┐
│ Binlog   │── dump线程 ──→│ I/O线程       │
│          │              │   ↓          │
│ 事务提交  │              │ Relay Log    │
│ 写入binlog│              │   ↓          │
└──────────┘              │ SQL线程       │
                          │   ↓          │
                          │ 执行SQL      │
                          └──────────────┘
关键时间节点:从库看到主库数据的时间差 = 主库事务提交耗时 + binlog 网络传输耗时 + relay log 写入耗时 + SQL 线程重放耗时。在正常情况下,这个延迟在毫秒级到秒级,但高峰期可能到分钟级甚至更久。
3.2 三种复制模式
MySQL 支持三种 binlog 格式,对应三种复制模式:
| 模式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| STATEMENT | 复制 SQL 语句本身 | 日志量小 | 不确定函数(NOW()、UUID())导致主从不一致 |
| ROW(推荐) | 复制每行数据的变化 | 精确、不会不一致 | 日志量大,批量操作时尤其明显 |
| MIXED | 默认 STATEMENT,不确定时切 ROW | 折中 | 复杂度高,行为不可预测 |
生产建议:绝大多数场景应该使用 ROW 模式。虽然日志量大一些,但数据一致性是底线。不要为了省一点磁盘空间去冒主从不一致的风险。
3.3 异步复制 vs 半同步复制
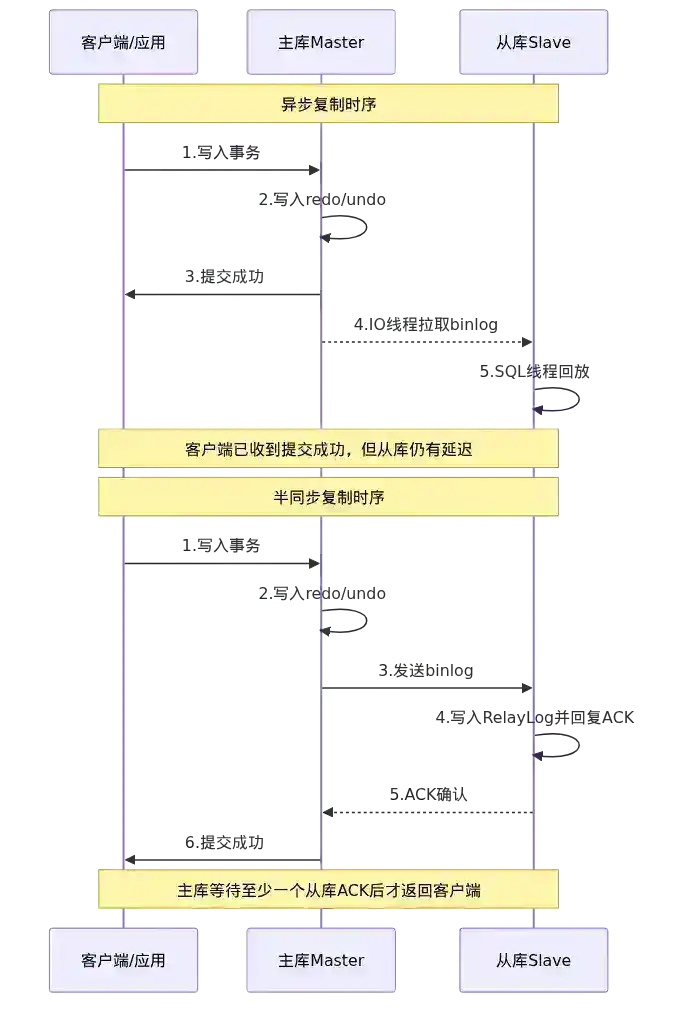
默认的 MySQL 复制是异步的:主库提交事务后立即返回给客户端,binlog 发送给从库是异步进行的。这意味着:
- 如果主库在事务提交后、binlog 发送前崩溃,从库永远收不到这条数据
- 主库返回"写入成功"≠从库已经有这条数据
为了在"数据不丢"和"性能"之间取得平衡,MySQL 5.5 引入了半同步复制(Semi-Synchronous Replication):
异步复制:
客户端 → 主库提交 → 返回成功 → ...(异步)... → 从库收到

半同步复制:
客户端 → 主库提交 → 发给至少一个从库 → 从库ACK → 返回成功
在半同步模式下,主库提交事务后,会等待至少一个从库确认收到了 binlog 事件(不是等从库执行完,只是确认"收到了"),然后才返回给客户端。如果等待超时,主库会退化为异步复制。
半同步复制的延迟代价:每次提交多一个网络往返(RTT),在 1ms RTT 的环境下,TPS 下降约 20%-30%。这就是为什么很多对延迟敏感的场景仍然选择异步复制的原因。
3.4 GTID 复制
MySQL 5.6 引入的 GTID(Global Transaction Identifier)给每个事务分配一个全局唯一的 ID。相比传统的基于 binlog 文件名+位置的复制,GTID 的优势在于:
- 故障切换更简单:不需要手动计算 MASTER_LOG_POS,从库知道自己执行到哪个 GTID
- 自动找点:CHANGE MASTER TO 时指定 MASTER_AUTO_POSITION=1,从库自动从正确的位置开始复制
- 防止重复执行:从库已经执行过的 GTID 不会重复执行
-- 传统方式
CHANGE MASTER TO
  MASTER_LOG_FILE='mysql-bin.000123',
  MASTER_LOG_POS=456789;

-- GTID 方式
CHANGE MASTER TO
  MASTER_AUTO_POSITION=1;
生产建议:新系统全部使用 GTID 复制。老系统迁移需要停服窗口,但值得做。
4. 复制延迟:读写分离的"阿喀琉斯之踵"
4.1 延迟从哪里来?
复制延迟是读写分离架构中最核心的挑战。延迟的来源有四个层面:
1. 主库层面:大事务(批量 UPDATE、DDL 操作)会让 binlog 瞬间产生大量数据,dump 线程需要时间发送。
2. 网络层面:跨机房、跨地域的复制,网络延迟和带宽都可能成为瓶颈。
3. 从库 I/O 层面:接收 binlog 写入 relay log 的速度受磁盘 I/O 影响。如果从库同时承担大量读请求,磁盘 I/O 竞争会让 I/O 线程变慢。
4. 从库 SQL 层面:这是最关键的延迟来源。SQL 线程是单线程重放的(MySQL 5.6 及之前),如果主库上多个事务并发执行只用了 1 秒,从库上单线程重放可能需要 10 秒。
4.2 并行复制:MySQL 5.7 的解决方案
MySQL 5.7 引入了基于逻辑时钟的并行复制(LOGICAL_CLOCK),让从库的 SQL 线程可以并行执行不同事务组的事务。原理是:
- 主库在 binlog 中记录每个事务的
last_committed和sequence_number - 同一个
last_committed值的事务之间没有冲突,可以在从库并行执行 - 不同
last_committed的事务可能依赖前一组,必须等前一组执行完
last_committed=1 的事务组:T1, T2, T3  → 并行执行
last_committed=4 的事务组:T4, T5     → 等上面执行完,再并行执行
last_committed=6 的事务组:T6         → 等上面执行完
效果:在 TPS 较高的场景下,并行复制可以将延迟从几十秒降低到 1-2 秒。但前提是主库的并发度足够高,才能产生足够多的并行组。
4.3 MySQL 8.0 的 WRITESET 并行复制
MySQL 8.0 进一步优化了并行复制,支持基于 WRITESET 的依赖跟踪:
- 主库记录每个事务修改了哪些行(writeset)
- 两个事务的 writeset 没有交集 → 可以在从库并行
- 比 LOGICAL_CLOCK 的粒度更细,并行度更高
-- 从库配置
SET GLOBAL replica_parallel_type = 'LOGICAL_CLOCK';
SET GLOBAL replica_parallel_workers = 4;  -- 并行工作线程数
SET GLOBAL replica_preserve_commit_order = ON;  -- 保持提交顺序
生产建议:MySQL 8.0 的 WRITESET 并行复制是目前最好的方案,能显著降低延迟。建议从库设置 replica_parallel_workers=4 到 8,根据 CPU 核心数调整。
4.4 监控复制延迟
监控是治理延迟的前提。常用的监控指标:
-- 查看从库状态
SHOW REPLICA STATUS\G
-- 关键字段:
-- Seconds_Behind_Master: 从库落后主库的秒数(粗略值)
-- Retrieved_Gtid_Set: 已接收的 GTID 集合
-- Executed_Gtid_Set: 已执行的 GTID 集合
Seconds_Behind_Master 是一个常用但不精确的指标——它只在 I/O 线程和 SQL 线程都在运行时才准确,而且网络抖动可能导致它跳变。
更精确的方式是通过 GTID 对比:
-- 在主库上
SELECT @@global.gtid_executed;
-- 在从库上
SELECT @@global.gtid_executed;
-- 差值就是未执行的事务数
或者使用 Percona Toolkit 的 pt-heartbeat:在主库上定期写入心跳记录,在从库上检查心跳记录的延迟时间来精确测量。
5. 读一致性:在延迟中保持正确
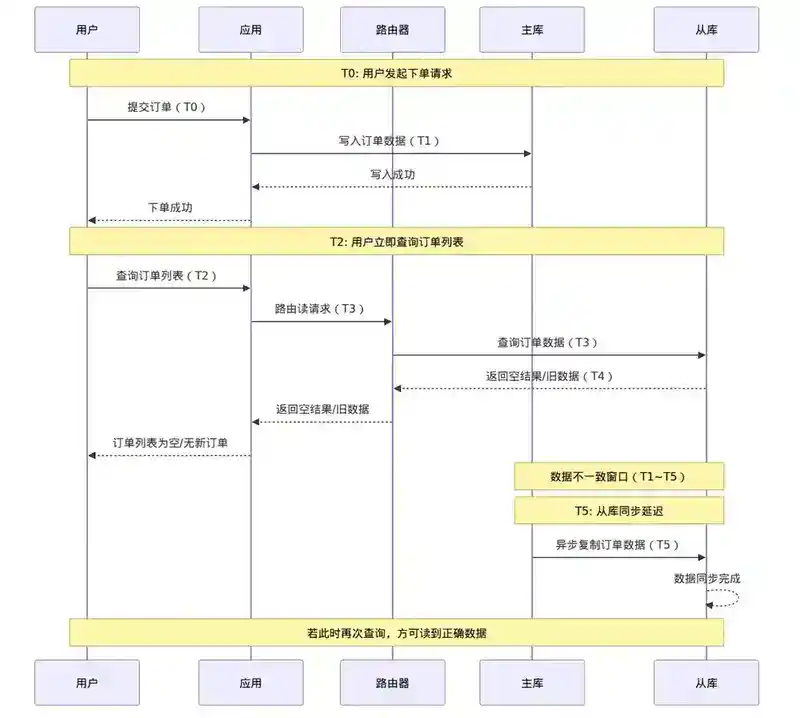
5.1 问题场景
假设用户在电商系统中下单:
- 用户提交订单,写入主库 → 成功
- 前端跳转到订单详情页,从从库读取订单 → 读不到!
这是因为步骤 1 的写入还没同步到从库。用户刷新几次页面,突然又看到了——这就是典型的"读你所写"(Read-Your-Writes)一致性问题。
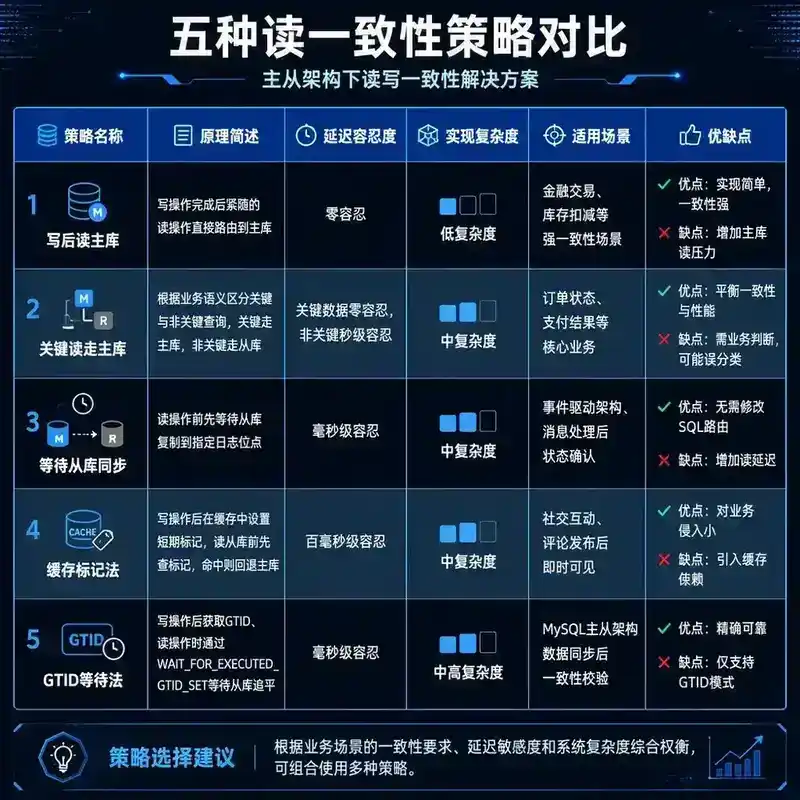
5.2 解决方案矩阵
| 方案 | 原理 | 延迟容忍 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 写后读主库 | 写入后 N 秒内的读全走主库 | 低 | 低 | 简单场景,写入量不大 |
| 关键读强制走主库 | 特定业务操作(下单后查订单)走主库 | 低 | 低 | 中小规模业务 |
| 等待从库同步 | 主库写入后等待从库同步完成再返回 | 零容忍 | 中 | 强一致性要求 |
| 缓存标记法 | 写入后标记缓存 Key,读时检查标记 | 中 | 中 | 高并发读场景 |
| GTID 等待法 | 从库等待特定 GTID 执行完成 | 灵活 | 中 | MySQL 5.7+ |
| Proxy 层一致性控制 | 在数据库中间件层统一处理 | 灵活 | 高 | 大厂基础设施 |
5.3 方案一:写后读主库
最简单的实现,在应用层做:
// 伪代码:写入后 1 秒内的读操作走主库
public Order getOrder(String orderId) {
    if (isRecentWrite(orderId, Duration.ofSeconds(1))) {
        return masterDao.findById(orderId);  // 走主库
    }
    return slaveDao.findById(orderId);  // 走从库
}
优点:简单、直接、不需要基础设施改动。 缺点:时间窗口是经验值,无法保证 100% 一致;高并发时主库压力增大。
5.4 方案二:GTID 等待法(推荐)
MySQL 5.7 引入了 WAIT_FOR_EXECUTED_GTID_SET 函数,允许从库等待特定 GTID 执行完成:
@Service
public class OrderService {
    @Transactional
    public Order createOrder(OrderDTO dto) {
        // 1. 写入主库
        Order order = masterDao.insert(dto);
        // 2. 获取本次写入的 GTID
        String gtid = masterDao.getLastGtid();
        // 3. 把 GTID 返回给调用方(通过响应头或消息体)
        order.setGtid(gtid);
        return order;
    }

    public Order getOrder(String orderId, String gtid) {
        // 如果有 GTID,等待从库同步
        if (gtid != null) {
            slaveDao.waitForGtid(gtid, 1);  // 最多等 1 秒
        }
        return slaveDao.findById(orderId);
    }
}

// 从库的 waitForGtid 实现
public void waitForGtid(String gtid, int timeoutSeconds) {
    jdbcTemplate.query(
        "SELECT WAIT_FOR_EXECUTED_GTID_SET(?, ?)",
        ps -> {
            ps.setString(1, gtid);
            ps.setInt(2, timeoutSeconds);
        }
    );
}
优点:精确、不依赖经验值、能做到 100% 读你所写。 缺点:需要传递 GTID(增加通信开销);等待本身有延迟;从库如果挂了会超时。
5.5 方案三:Proxy 层一致性控制
在 ShardingSphere-Proxy、Mycat 等数据库中间件层面,可以透明地处理一致性:
# ShardingSphere 配置示例
rules:
  - !READWRITE_SPLITTING
    dataSources:
      ds_master:
        writeDataSourceName: ds_master
        readDataSourceNames:
          - ds_slave_0
          - ds_slave_1
        loadBalancerName: round_robin
    # 配置在同一事务内或同一连接内的读操作走主库
中间件可以通过 Hint 机制 强制读主库:
// 强制走主库
HintManager hintManager = HintManager.getInstance();
hintManager.setPrimaryRouteOnly();  // 后续所有操作走主库
try {
    Order order = orderMapper.findById(orderId);
} finally {
    hintManager.close();
}
优点:业务代码无侵入,中间件统一管理。 缺点:引入额外组件,增加运维复杂度;Hint 机制可能被滥用。
6. 故障切换:当主库挂了
6.1 故障检测
故障切换的第一步是准确检测到主库故障。常用的检测机制:
1. 心跳检测:监控组件(如 Orchestrator、MHA)定期向主库发送心跳查询,超时未响应则判定故障。
2. 多路检测:避免网络抖动导致的误判。从多个节点(监控节点、其他从库、应用服务器)同时检测主库可达性。
3. 半数以上判定:至少 N/2+1 个检测节点认为主库不可达,才触发切换。防止单点网络故障导致误切。
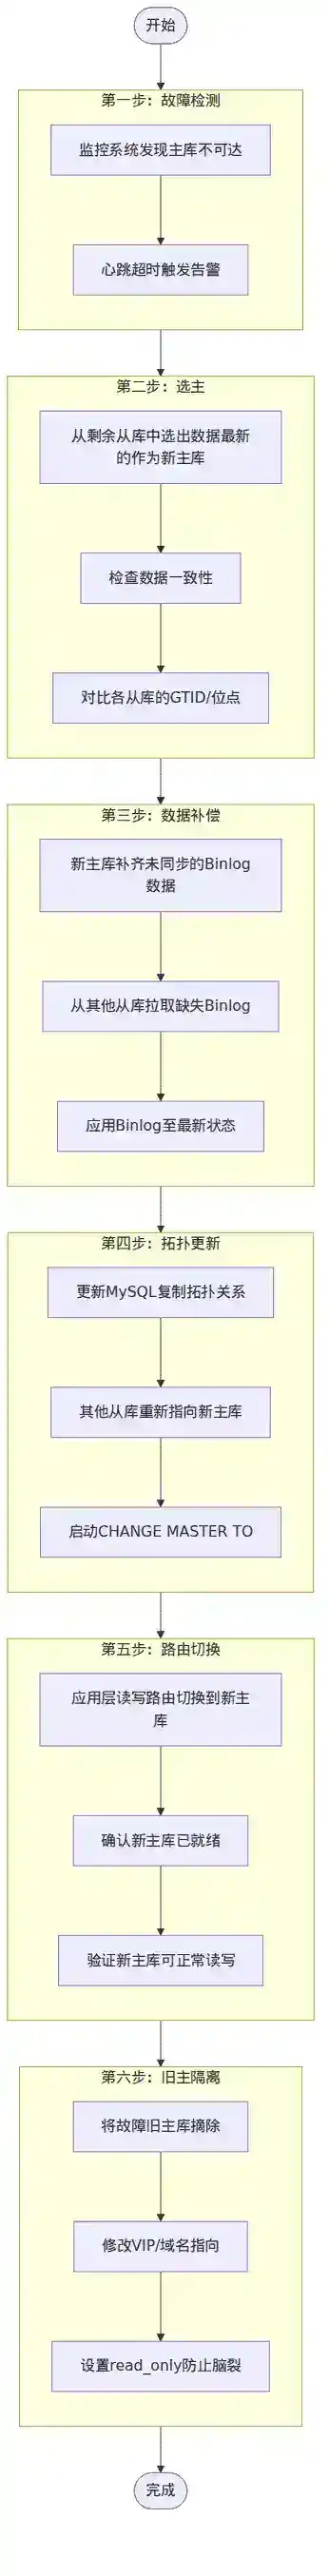
6.2 切换流程
1. 故障检测 → 确认主库不可达
2. 选主 → 从所有从库中选出一个新主库
3. 数据补偿 → 让新主库追上原主库的 binlog(尽量)
4. 拓扑更新 → 其余从库改指到新主库
5. 路由切换 → 应用层/DNS/VIP 指向新主库
6. 旧主下线 → 隔离原主库,防止脑裂
6.3 选主策略
MHA(Master High Availability)的选主逻辑:
- 选出所有从库中 binlog 位点最新的那个(数据最全)
- 如果多个从库位点相同,选延迟最小的
- 如果还有多个,可以按优先级配置(机器配置、机房位置等)
Orchestrator 的选主逻辑:基于拓扑感知,优先选与旧主库同机房的从库,避免跨机房切换带来的延迟。
6.4 数据补偿
切换过程中,原主库可能有一部分 binlog 没有同步到从库。补偿策略:
- 半同步复制:如果配置了半同步,至少有一个从库有完整的 binlog,补偿量最小
- binlog server:独立的 binlog 备份服务,用于补偿丢失的数据
- 人工介入:如果丢失的数据无法自动恢复,需要人工从 binlog 解析并补入
注意:切换后原主库如果恢复,绝对不能让它重新加入集群——它上面的数据可能比新主库多(已经写入但未同步到从库的"幽灵数据"),直接加入会导致数据不一致。
6.5 自动切换 vs 手动切换
| 维度 | 自动切换 | 手动切换 |
|---|---|---|
| 恢复时间 | 秒级 | 分钟级 |
| 误切风险 | 有(网络抖动导致) | 低 |
| 实现复杂度 | 高 | 低 |
| 适用场景 | 核心业务、高可用要求 | 非核心、可容忍短时间不可用 |
生产建议:核心业务配置半自动切换——监控系统自动检测并发出告警,同时推荐切换方案,由运维人员确认后一键执行。这样既避免了误切风险,又不会因为人在睡觉而延误切换。
7. 路由策略:请求如何分发?
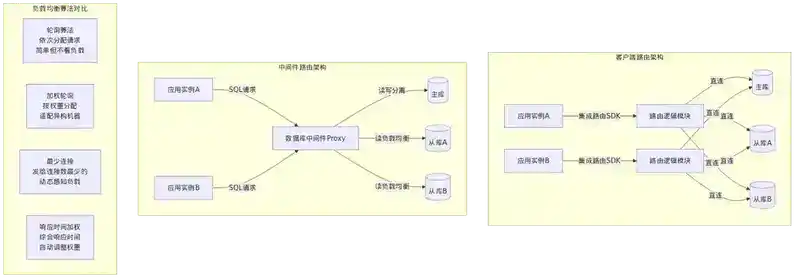
7.1 客户端路由 vs 中间件路由
客户端路由:在应用代码中配置多个数据源,根据 SQL 类型选择数据源。
// Spring 动态数据源示例
@Component
public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        // 从 ThreadLocal 中获取当前操作的数据源类型
        return DataSourceContextHolder.getDataSourceType();
    }
}

// AOP 切面:根据方法名或注解选择数据源
@Aspect
@Component
public class ReadWriteSplittingAspect {
    @Around("@annotation(transactional)")
    public Object aroundTransactional(ProceedingJoinPoint pjp) {
        DataSourceContextHolder.setDataSourceType("master");
        return pjp.proceed();
    }

    @Around("execution(* com.example.dao.*.select*(..))")
    public Object aroundSelect(ProceedingJoinPoint pjp) {
        DataSourceContextHolder.setDataSourceType("slave");
        return pjp.proceed();
    }
}
中间件路由:通过 ShardingSphere-Proxy、Mycat、Atlas 等中间件透明代理。
# ShardingSphere 读写分离配置
rules:
  - !READWRITE_SPLITTING
    dataSources:
      readwrite_ds:
        writeDataSourceName: ds_master
        readDataSourceNames:
          - ds_slave_0
          - ds_slave_1
        loadBalancerName: round_robin
    loadBalancers:
      round_robin:
        type: ROUND_ROBIN
| 维度 | 客户端路由 | 中间件路由 |
|---|---|---|
| 性能 | 无额外网络跳转 | 多一跳,延迟+0.5-1ms |
| 灵活性 | 高,可以精细控制 | 受限于中间件能力 |
| 运维复杂度 | 与应用耦合 | 独立部署和维护 |
| 故障影响 | 代码级故障 | 中间件成为瓶颈 |
| 适用场景 | 中小规模、灵活控制 | 大规模、统一治理 |
7.2 负载均衡算法
从库之间如何分配读请求?
1. 轮询(Round Robin):最简单的策略,每个从库轮流接收请求。适用于所有从库配置相同、延迟相近的场景。
2. 加权轮询(Weighted Round Robin):给不同配置的从库分配不同权重。高配机器权重高,低配机器权重低。
3. 最少连接(Least Connections):把请求发送给当前活跃连接数最少的从库。适用于请求耗时差异大的场景。
4. 响应时间加权(Response Time Weighted):定期探测从库响应时间,响应快的从库获得更多流量。能自动适应从库性能变化。
5. 一致性哈希(Consistent Hash):按用户 ID 哈希路由到固定从库。好处是缓存命中率高,但可能导致负载不均。
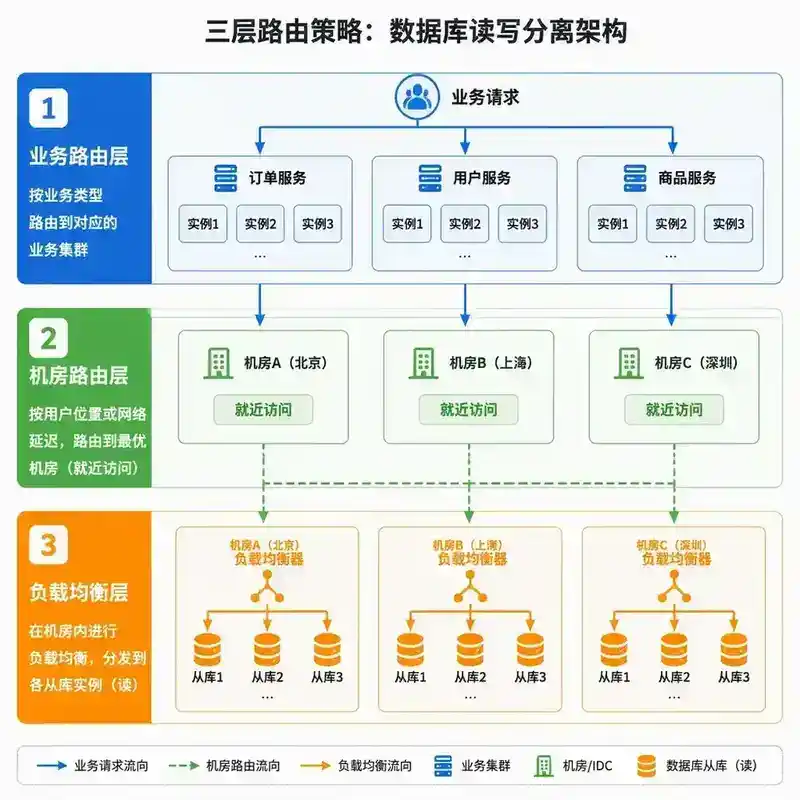
7.3 多级路由策略

大型系统通常采用多级路由:
┌─────────────────────────────────────┐
│ 第一级:业务路由                      │
│ 核心业务读(订单查询)→ 专用从库        │
│ 非核心业务读(日志、报表)→ 共享从库    │
└──────────────┬──────────────────────┘
               │
┌──────────────▼──────────────────────┐
│ 第二级:机房路由                      │
│ 同机房优先(延迟低)→ 跨机房兜底       │
└──────────────┬──────────────────────┘
               │
┌──────────────▼──────────────────────┐
│ 第三级:负载均衡                      │
│ 加权轮询 / 最少连接 / 响应时间加权     │
└─────────────────────────────────────┘
7.4 从库健康检测与隔离
路由层必须持续检测从库的健康状态:
// 健康检查逻辑
public class SlaveHealthChecker {
    public boolean isHealthy(DataSource slave) {
        try {
            // 1. 连接检测
            Connection conn = slave.getConnection();
            // 2. 复制延迟检测
            int delay = getReplicationDelay(conn);
            if (delay > MAX_DELAY_SECONDS) {
                return false;  // 延迟过大,标记不健康
            }
            // 3. 基本查询检测
            conn.createStatement().execute("SELECT 1");
            return true;
        } catch (Exception e) {
            return false;
        }
    }
}
健康判定标准:
- 可达性:能建立连接并执行 SELECT 1
- 延迟阈值:复制延迟不超过 N 秒(可配置,一般 3-10 秒)
- 错误率:最近 N 次请求的错误率不超过阈值
8. 生产实践与常见陷阱
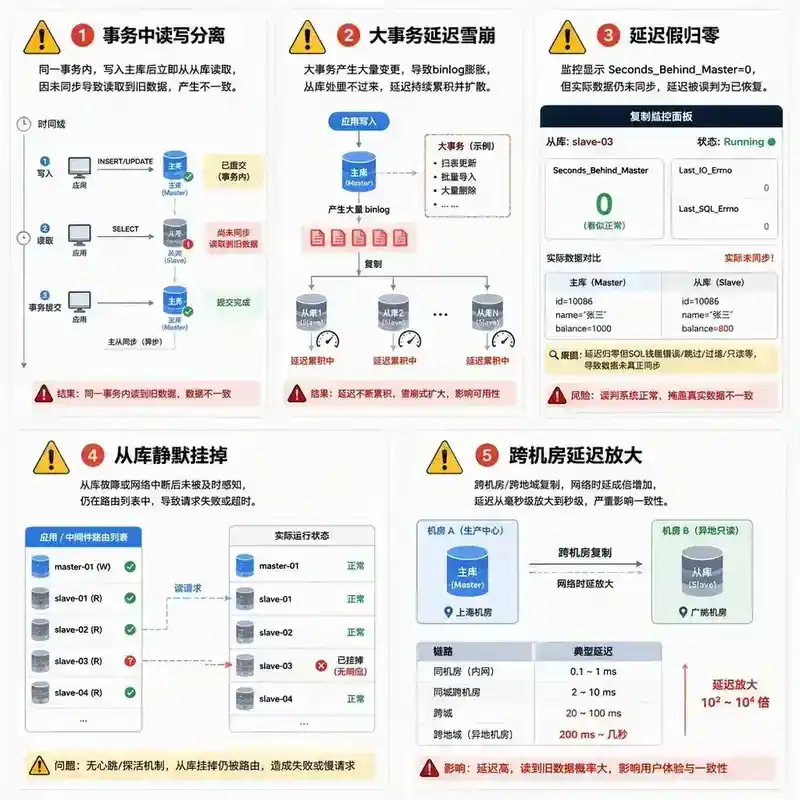
8.1 陷阱一:事务中的读写分离
在同一个事务中,如果先写主库再读从库,会读到旧数据:
@Transactional  // 这个事务里,所有操作应该走主库!
public void processOrder(Long orderId) {
    orderDao.updateStatus(orderId, "PAID");  // 写主库
    Order order = orderDao.findById(orderId); // 如果读从库,可能读到旧状态!
    // 后续操作基于 order 的状态...
}
解法:在事务内,所有数据库操作强制走主库。Spring 的 @Transactional 方法内,应该将数据源切换为主库。
8.2 陷阱二:大事务导致延迟雪崩
-- 危险操作:在主库上执行大事务
UPDATE orders SET status = 'ARCHIVED'
WHERE created_at < '2020-01-01';  -- 几百万行
这个 UPDATE 可能产生几千万行的 binlog,导致所有从库延迟飙升。延迟飙升后,读请求读到过期数据,用户体验变差,业务方投诉,DBA 紧急处理——这就是典型的"延迟雪崩"。
解法:
- 大事务拆分:用小批量循环替代大 UPDATE
- 错峰执行:在业务低峰期执行大操作
- 使用 pt-online-schema-change 等工具进行在线 DDL
8.3 陷阱三:从库延迟的"假归零"
SHOW REPLICA STATUS\G
-- Seconds_Behind_Master: 0
看到这个值归零,不代表从库真的追上了主库。Seconds_Behind_Master 的计算逻辑是:当前时间 - SQL 线程最后执行的事务的时间戳。如果主库停止写入,或者 I/O 线程因为网络问题卡住了但仍然在接收(只是 SQL 线程已经执行完了所有接收到的),这个值也会显示为 0。
正确的判断方式:对比主库和从库的 gtid_executed 集合,或者用 pt-heartbeat 的精确延迟值。
8.4 陷阱四:从库挂了没人知道
从库默默地挂了,但路由层没有检测到,读请求全部失败或者降级到主库,导致主库压力飙升——然后主库也挂了。
必须做的:
- 从库健康检查必须有独立的监控告警
- 从库故障时,自动从读负载均衡池中摘除
- 如果所有从库都挂了,要么全部读请求走主库(可能压垮主库),要么降级返回缓存数据或错误提示
8.5 陷阱五:跨机房复制的延迟会被放大
同机房内复制延迟通常 < 10ms,但跨机房(尤其是跨地域)的网络延迟可能达到 50-200ms。如果从库在异地,延迟会显著增加。
建议:读写分离尽量在同机房内完成。如果业务需要跨地域部署,使用多活架构而不是简单的读写分离。
9. 面试官视角:8 个追问
以下问题不在正文阅读范围内,供你检验自己的理解深度。
Q1:你们的系统读写分离是客户端路由还是中间件路由?为什么选这个方案?如果让你重新设计,你会怎么选?
参考答案: 这个问题考察的是架构决策能力和对两种方案的深刻理解。回答时不要只说"我们用了XX",要讲清楚为什么。
思路框架: 先描述现状,再分析选型原因,最后给出反思。
- 客户端路由(如 Spring AbstractRoutingDataSource + AOP):选择它的原因通常是团队规模小、希望降低运维复杂度、不想引入额外组件。优点是零额外网络开销、代码可控性强。缺点是每个服务都要配一套,规则散落在各个服务中,全局治理困难。
- 中间件路由(如 ShardingSphere-Proxy):选择它的原因通常是团队规模大、服务数量多、需要统一治理。优点是读写分离规则集中管理、对业务代码透明、支持更复杂的路由策略。缺点是引入额外一跳(延迟+0.5~1ms)、中间件本身成为新的故障点。
- 重新设计的思考:小团队不建议一上来就上中间件,客户端路由足够;但如果有 10+ 个服务都需要读写分离,中间件的统一治理优势就体现出来了。关键判断标准:你的团队是否有能力维护中间件本身的高可用? 如果答案是否,就老老实实用客户端路由。
Q2:复制延迟最大能容忍多少秒?这个数字是怎么定出来的?如果延迟超过阈值,你们是怎么处理的——是降级还是等待?
参考答案: 这个问题考察的是 SLO 定义和降级设计能力。
设定延迟阈值的方法:
- 不是拍脑袋定的,而是从业务能接受的数据新鲜度反推。比如订单查询,用户能接受 3 秒内看到刚下的单,那延迟阈值就设为 3 秒。
- 从用户体验曲线分析:延迟 1 秒用户几乎无感,3 秒略有感知,10 秒以上用户会投诉。不同业务差异很大——报表查询能容忍 30 秒延迟,下单后查订单只能容忍 1-2 秒。
- 还要考虑从库的常态延迟分布:P99 延迟是多少?如果 P99 延迟已经 5 秒,阈值设 3 秒会导致大量从库被摘除。
超过阈值的处理策略:
- 方案一(降级):摘除该从库,读请求分流到其他从库或主库。风险是主库压力增大。需要配合最小可用从库数的兜底——如果可用从库数低于 N,宁可返回过期数据也不走主库。
- 方案二(等待):在从库上执行
WAIT_FOR_EXECUTED_GTID_SET等待同步完成,超时后再决定降级还是报错。适合对一致性要求极高的场景。 - 方案三(标记降级):在响应中带上
stale: true标记,由前端/调用方决定是否接受过期数据。
Q3:半同步复制能保证数据不丢吗?如果主库提交后、从库 ACK 前主库挂了,会发生什么?和异步复制相比,真的能保证"零丢失"吗?
参考答案: 这个问题考察的是对半同步复制边界条件的精确理解。
核心结论:半同步复制不能保证"零丢失",只能保证"至少一个从库收到了 binlog"。
关键场景分析:
- 主库提交事务 → 发送 binlog 给从库 → 等待从库 ACK → 主库在收到 ACK 前崩溃。此时,客户端收到的是"失败"(或者超时),但这笔事务在主库上已经提交了(binlog 已写入),从库没收到。当主库恢复后,这笔事务在主库上存在,但从库没有——这就是"幽灵事务"。
- 如果主库彻底损坏无法恢复,这笔事务就丢失了。
- 半同步解决的是"主库提交后立即崩溃,从库没有 binlog"的问题,但解决不了"主库提交后,从库还没 ACK,主库崩溃"的窗口问题。
after_sync vs after_commit(MySQL 5.7+):
after_commit:主库先提交到存储引擎,再等从库 ACK。如果主库在等待 ACK 时崩溃,从库没有 binlog 但主库已提交——不一致。after_sync:主库先等从库 ACK(收到 binlog),再提交到存储引擎。主库崩溃时,binlog 已经在从库,即使主库数据丢失,从库拿到 binlog 后可以补偿。强烈建议使用 after_sync。
真相: 真正要保证"零丢失",需要 Group Replication(Paxos 协议)或者同步复制集群,代价是性能大幅下降。半同步复制是在"性能"和"可靠性"之间取折中。
Q4:GTID 复制在故障切换时,如果新主库的 GTID 集合和旧主库不完全一致,会发生什么?如何判断是否发生了数据丢失?
参考答案: 这个问题考察的是 GTID 复制下的故障切换实战经验。
切换时 GTID 不一致的情况:
- 新主库的 GTID 集合 ⊆ 旧主库的 GTID 集合:新主库缺少一些事务。这些事务是旧主库已提交但未同步到新主库的。
- 新主库的 GTID 集合 ⊇ 旧主库的 GTID 集合:新主库多出一些事务。这种情况通常发生在旧主库被隔离后有新写入,或者选主时选了一个实际位点更靠前的从库。
- 两者有交集但不完全包含:最复杂的情况,说明拓扑中出现了不一致。
如何判断数据丢失:
-- 在新主库上查看自己的 GTID 集合
SELECT @@global.gtid_executed;
-- 在旧主库上(如果还能访问)查看 GTID 集合
-- 对比两者的差集
SELECT GTID_SUBTRACT('旧主库gtid_executed', '新主库gtid_executed');
-- 如果结果非空,说明有事务在新主库上缺失
处理策略:
- 如果旧主库还能访问:从旧主库导出缺失的 GTID 对应的事务,手动补入新主库。
- 如果旧主库无法访问但有 binlog 备份:从 binlog 备份中恢复缺失的事务。
- 如果两者都不可用:承认数据丢失,记录丢失的 GTID 范围,评估业务影响,启动补偿流程。
- 预防措施:配置
gtid_purged策略,定期检查所有节点的 GTID 一致性。
Q5:你有没有遇到过主从数据不一致的情况?不一致是怎么发现的?怎么修复的?有没有办法预防?
参考答案: 这个问题考察的是生产环境数据一致性的实战经验。
不一致的常见原因:
- STATEMENT 模式 binlog + 不确定函数:NOW()、UUID()、RAND() 在主从库上执行结果不同
- 从库直接写入:误操作或应用 bug 直接写从库
- 大事务回滚:主库回滚了但在从库上部分执行
- 并行复制 bug:MySQL 5.7 早期版本的并行复制在某些边界条件下导致不一致
- DDL 在从库上失败:主库执行 DDL 成功,但从库因为数据差异执行失败
发现不一致的方法:
- pt-table-checksum(Percona Toolkit):在主库上执行校验和查询,通过复制传播到从库,对比校验和。这是最常用的方法。
- 定期全量对比:导出主从库的关键表数据,用 diff 工具对比。
- 业务监控:订单数量对不上、金额对不上等业务指标异常告警。
- 应用层校验:读写后对比,写入后从主库和从库分别读取进行对比(抽样)。
修复方法:
- pt-table-sync:自动生成修复 SQL,让从库和主库一致。注意:一定要先在测试环境验证。
- 重做从库:如果差异太大,直接重建从库——从主库全量备份恢复,再开启复制。
预防措施:
- 使用 ROW 格式 binlog(消除不确定函数问题)
- 设置从库
read_only=ON和super_read_only=ON(防止误写) - 开启
sync_binlog=1和innodb_flush_log_at_trx_commit=1(防止崩溃导致不一致) - 定期运行 pt-table-checksum 并监控结果
- 使用 GTID 复制,防止位点错误
Q6:如果所有从库都因为延迟过高被健康检查摘除了,这时候读请求应该怎么处理?走主库可能压垮主库,不走主库用户请求就失败了——你选哪个?为什么?
参考答案: 这个问题考察的是极端故障场景下的决策能力,没有标准答案,关键是你的思考过程。
首先分析根因: 所有从库同时延迟过高,说明不是单个从库的问题,而是主库写入压力过大(大事务、批量操作)或者复制链路整体故障(网络问题、主库 binlog dump 线程异常)。
选项分析:
选项 A:全部走主库
- 风险:主库已经是高写入压力状态,再把所有读请求压上去,可能导致主库彻底崩溃
- 适用场景:主库资源充足,平时 CPU 利用率 < 30%,可以承受峰值
- 保底:如果主库挂了,整个系统不可用,比"部分用户报错"更严重
选项 B:降级——读请求返回缓存数据或默认值
- 前提:有本地缓存(Caffeine/Guava Cache)或分布式缓存兜底
- 效果:核心业务(如下单)不受影响,但非核心查询(如历史订单列表)可能返回过期数据
- 用户体验:比直接报错好,但需要前端配合展示"数据可能不是最新的"
选项 C:限流 + 部分拒绝
- 对读请求做限流,只放行核心业务的读请求,非核心的直接拒绝
- 同时触发告警,人工介入恢复从库
推荐回答思路: "我会选择分级降级——核心业务(下单、支付)的读请求走主库,非核心业务(报表、历史查询)限流或返回缓存数据。同时立即告警,排查从库延迟原因。如果主库 CPU 利用率已经超过 70%,则核心业务的读也走限流,优先保证写入不受影响。"
关键点: 面试官要听的是你分层思考的能力,而不是一个简单的"走主库"或"不走主库"。
Q7:在设计一个秒杀系统时,读写分离会遇到什么问题?秒杀场景下的"读你所写"一致性要求,和普通电商场景有什么不同?
参考答案: 这个问题考察的是将通用架构模式应用到特殊场景的能力。
秒杀场景下读写分离的特殊问题:
- 热点商品读达到峰值:秒杀开始前,所有用户都在刷新商品详情页——读请求集中到某几个商品。如果这些读均匀分布到从库还好,但如果有缓存层,从库的读压力可能被缓存挡住,反而体现不出读写分离的价值。
- "读你所写"更严格:秒杀场景下,用户点击"抢购"后,必须立即知道结果(成功/失败)。如果因为读写分离导致用户看到"抢购成功"但查订单时看不到,体验极差。秒杀场景要求读你所写延迟 < 100ms,而普通电商可以容忍 1-2 秒。
- 库存扣减的一致性:秒杀的核心是库存扣减。如果扣减走主库,库存查询走从库,复制延迟会导致从库看到的库存大于实际库存,造成超卖。解法:库存相关的读写全部走主库,从库只用于商品详情等非关键读。
- 主库压力集中的矛盾:读写分离的目的是分担主库压力,但秒杀场景下核心操作(扣库存、下单、查订单)全部要强一致性,反而都集中在主库。读写分离在秒杀场景下的价值不是分担"一致性读",而是分担"非关键读"(如商品介绍、活动规则)。
- 从库延迟放大:秒杀瞬间主库的写入 TPS 可能从 1000 飙升到 10000,但复制是单线程/有限并行的,从库延迟会瞬间飙升。
核心差异: 普通电商场景下读写分离是"锦上添花",秒杀场景下读写分离很容易变成"形同虚设"——因为大部分关键操作需要强一致性,天然走主库。秒杀系统更需要的是缓存、异步化、排队等手段,而不是依赖读写分离来抗读。
Q8:MySQL 8.0 的 Group Replication 和传统的"一主多从 + 读写分离"架构相比,有什么本质区别?什么场景下应该用 Group Replication 替代传统读写分离?
参考答案: 这个问题考察的是对 MySQL 高可用架构演进的理解。
本质区别:
| 维度 | 传统一主多从 + 读写分离 | Group Replication (MGR) |
|---|---|---|
| 复制机制 | 基于 binlog 的异步/半同步 | 基于 Paxos 协议的多数派共识 |
| 数据一致性 | 最终一致(异步)/ 半同步(有窗口) | 强一致(事务提交前需多数节点确认) |
| 故障切换 | 外部组件(MHA/Orchestrator) | 内置自动故障检测和选主 |
| 主节点 | 固定一个主库 | 多主模式(Multi-Primary)或单主模式 |
| 脑裂防护 | 依赖外部组件(VIP/Keepalived) | Paxos 协议天然防脑裂(少数派自动踢出) |
| 写入性能 | 高(单节点写入,无共识开销) | 较低(每次提交需多数派确认,RTT 开销) |
| 节点数 | 通常 1 主 + 2-5 从 | 建议 3-9 个节点(奇数) |
| 故障恢复时间 | 秒-分钟级(依赖外部组件) | 秒级(内置机制) |
本质区别一句话总结: 传统架构是"一主多从 + 外部高可用组件",MGR 是"原生多副本共识协议"。前者追求性能和运维灵活性,后者追求数据安全和自动化。
适用场景判断:
应该用 Group Replication 的场景:
- 金融、支付等对数据一致性要求极高的场景(不能容忍任何数据丢失)
- 需要自动化故障切换,且不希望依赖外部组件
- 多机房部署,需要同城容灾
- 小规模集群(3-5 个节点),写入 TPS 可以接受共识开销
不适合 Group Replication 的场景:
- 写入 TPS 很高(> 10000),共识开销会显著影响性能
- 读多写少,且读可以容忍一定延迟(传统读写分离 + 多个读副本更经济)
- 节点分布在跨地域(网络延迟 > 50ms),Paxos 协议性能急剧下降
- 需要大量只读副本(> 10 个),MGR 每个节点都是全功能节点,成本高
MGR + 读写分离的混合架构: 实践中,MGR 集群作为核心写入集群(保证数据安全),外部挂传统异步从库用于读扩展——这样既保证了写入的强一致性,又保留了读扩展的能力。这是目前比较推荐的混合架构。
延伸阅读
- MySQL 官方文档:Replication 章节
- 《高性能 MySQL》第 10 章:复制
- MySQL 8.0 并行复制:WRITESET 原理详解
- ShardingSphere 官方文档:读写分离配置
- Orchestrator:MySQL 高可用与拓扑管理
- MHA 项目:Master High Availability Manager and tools for MySQL