阅读时间:约 45 分钟 适用人群:高级 Java 工程师、技术专家、应用架构师 前置知识:分布式系统基础、至少参与过 1-2 个中大型系统的设计
一、为什么系统设计面试是架构师的核心门槛
系统设计面试不是考察你是否背过某套方案,而是考察你在模糊需求、约束冲突、信息不完备的条件下,能否结构化地推导出一套合理架构。它模拟的是架构师日常工作中最核心的场景:拿到一个业务目标,把它变成可落地的技术方案。
面试官真正想看到的不是答案,是过程:
- 你有没有主动澄清模糊需求?
- 你能不能快速估算系统容量?
- 你的API设计是否考虑扩展性?
- 你的数据模型是否匹配访问模式?
- 你的架构是否考虑到了演进路径?
- 你做技术选型时有没有明确说出"为什么选A不选B"?
下面从六个维度逐一拆解这套方法论。
二、需求澄清:在动手画图之前,先问对问题
2.1 需求澄清为什么重要
大多数系统设计面试的题目以一句话开头:"请你设计一个类似Twitter的社交系统"。如果你听完这句话就开始画架构图,你已经输了。因为这句话里有太多未定义的变量:
- "类似Twitter"是指发推文功能,还是包括私信、搜索、广告系统?
- 用户规模是多少?DAU 1万还是1亿?
- 延迟要求是多少?发布一条推文,粉丝多久能看到?
- 需要支持哪些客户端?Web、iOS、Android 还是 IoT?
需求澄清的本质是:把模糊的商业目标翻译成可量化的技术约束。
2.2 需求澄清的四维度框架
你可以用以下四个维度系统性地提问:
| 维度 | 关键问题 | 为什么重要 |
|---|---|---|
| 功能需求 | 系统要支持哪些核心功能?哪些是 MVP,哪些是可选? | 决定架构边界,避免过度设计 |
| 非功能需求 | 可用性、一致性、延迟、吞吐量的要求是什么? | 决定技术选型的天花板 |
| 规模约束 | DAU、QPS、数据量级、读写比例? | 决定是否需要分片、缓存、异步 |
| 业务约束 | 多语言、多时区、合规要求、遗留系统依赖? | 决定架构的特殊约束 |
实战技巧:
- 先列出你假设的功能列表,然后问面试官:"我假设核心功能包括A、B、C,非核心包括D、E,你看这个优先级对吗?"——这展示了你对功能边界有判断力。
- 对于非功能需求,直接用数字确认:"假设我们要支持 1000万 DAU,发布推文的 P99 延迟 < 500ms,可用性 99.99%,这个假设合理吗?"
- 把确认结果写在白板/文档的显眼位置,后续所有设计决策都引用这些约束——这证明你的设计是有据可依的。

三、容量估算:用数字说话,而不是"应该够用"
3.1 容量估算的核心价值
容量估算不是为了精确计算(面试中你不可能精确),而是为了:
- 证明你的系统规模感——你知道 1亿 DAU 大概需要多少服务器
- 驱动架构决策——单机能承载就不用分片,缓存命中率估算决定缓存层设计
- 暴露瓶颈——哪个组件先达到极限,就需要优先考虑扩展方案
3.2 容量估算的基本公式
面试中你需要记住以下关键数字:
| 指标 | 典型值 | 说明 |
|---|---|---|
| 单机 QPS | 1,000 ~ 10,000 | 取决于业务复杂度,简单 KV 可达万级,复杂事务可能只有千级 |
| MySQL 单库容量 | 500GB ~ 2TB | 超过后分库分表成本急剧上升 |
| Redis 单节点 | 10万 QPS / 32GB | 内存型,容量是瓶颈 |
| Kafka 单 Partition 吞吐 | 10 ~ 50 MB/s | 带宽和磁盘顺序写瓶颈 |
| CDN 带宽成本 | 按流量计费 | 图片/视频类系统的主要成本 |
| 网络延迟 | 同机房 < 1ms,跨机房 5-20ms,跨洲 100-300ms | 驱动多机房部署决策 |
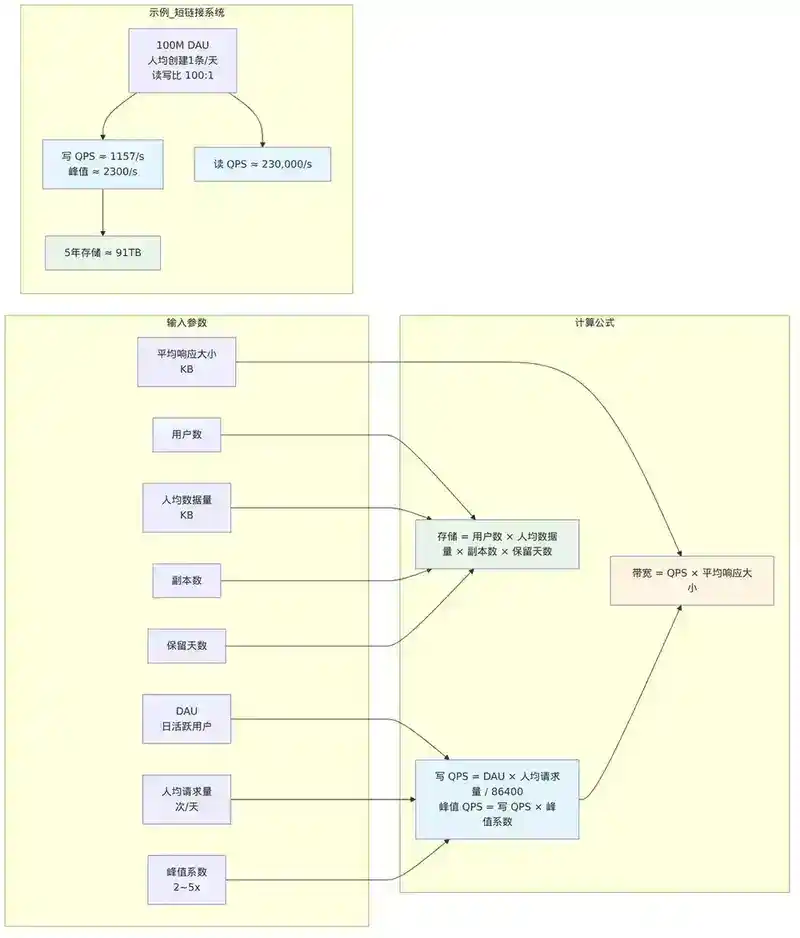
核心估算公式:
QPS = DAU × 人均请求量 / 86400 × 峰值系数
存储 = 用户数 × 人均数据量 × 副本数 × 保留天数
带宽 = QPS × 平均响应大小
估算示例:假设设计一个短链接系统,100M DAU,人均创建 1 条短链接/天,读写比 100:1。
- 写 QPS = 100M / 86400 ≈ 1,157/s,峰值 × 2 ≈ 2,300/s
- 读 QPS = 2,300 × 100 = 230,000/s
- 存储(5年):100M × 365 × 1 × 5 = 182.5B 条记录,每条 ~500B → 约 91TB
- 结论:需要分库分表,读路径需要 Redis 缓存层
### 3.3 容量估算的常见陷阱
- 只看平均值不看峰值:系统崩溃往往发生在峰值,不是平均值。峰值系数通常取 2-5x。
- 忽略存储增长:数据是持续增长的,5 年后的存储量可能远超当前。
- 忘记副本和冗余:MySQL 主从、Redis 哨兵、Kafka 副本都会增加实际存储。
- 不估算带宽:图片/视频类系统,带宽成本可能是最大开销。
四、API设计:接口是系统的"皮肤"
4.1 API设计的核心原则
API 设计的质量直接决定了系统的可维护性和扩展性。好的 API 设计遵循以下原则:
- 面向资源设计(RESTful):URL 表达资源,HTTP 方法表达操作
- 接口与实现分离:API 不应暴露内部实现细节
- 向后兼容:新增字段不能破坏已有调用方
- 幂等性:写操作应支持安全重试
- 分页与限流:列表接口必须有分页,高频接口必须有速率限制
4.2 RESTful API 设计规范
# 创建短链接
POST /api/v1/urls
Request:  { "original_url": "https://...", "expire_at": "..." }
Response: { "short_url": "https://short.ly/abc123", "expire_at": "..." }

# 获取短链接详情
GET /api/v1/urls/{short_code}

# 获取用户创建的短链接列表
GET /api/v1/users/{user_id}/urls?page=1&size=20

# 删除短链接
DELETE /api/v1/urls/{short_code}
版本管理:URL 路径中带版本号 /v1/,当需要不兼容变更时升级到 /v2/。不要用 Header 做版本控制——调试困难,且网关路由基于 URL 更高效。
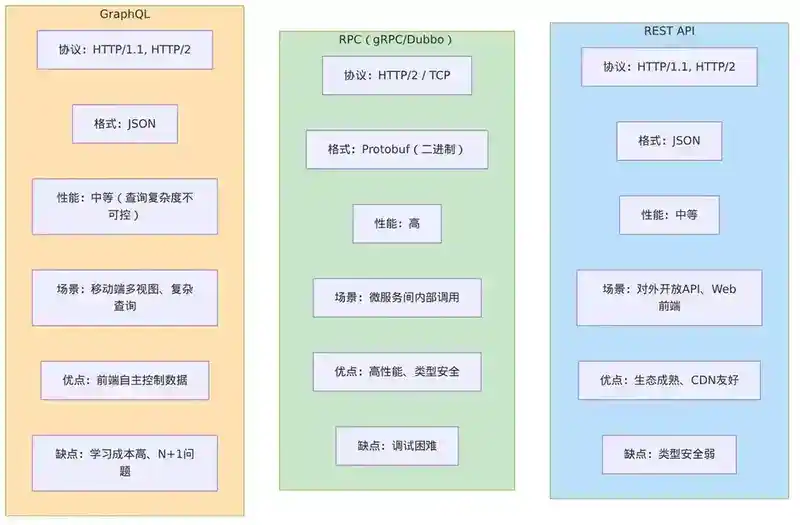
4.3 RPC vs REST vs GraphQL 选型
| 特性 | REST | RPC (gRPC/Dubbo) | GraphQL |
|---|---|---|---|
| 通信协议 | HTTP/1.1, HTTP/2 | HTTP/2 (gRPC) / TCP (Dubbo) | HTTP/1.1, HTTP/2 |
| 数据格式 | JSON | Protobuf(二进制) | JSON |
| 性能 | 中等 | 高(二进制序列化,多路复用) | 中等(查询复杂度不可控) |
| 适用场景 | 对外开放 API、Web 前端 | 微服务间内部调用 | 移动端多视图、复杂查询 |
| 类型安全 | 弱(需额外 Schema) | 强(Protobuf 定义) | 强(Schema 定义) |
| 学习成本 | 低 | 中 | 中高 |
选型建议:
- 对外 API → REST:生态成熟,CDN/网关支持好,调试方便
- 微服务内部 → RPC:性能高,类型安全,服务治理(超时/重试/熔断)成熟
- 移动端多视图 → GraphQL:前端自主控制数据获取,减少 over-fetching/under-fetching
五、数据模型设计:先理解访问模式,再选存储
5.1 数据建模的核心原则
数据模型不是根据"实体关系"来设计的,而是根据"访问模式"来设计的。 这是许多工程师常犯的错误——他们一上来就画 ER 图,忽略了系统实际怎样读写数据。
正确的顺序:
- 列出所有查询模式(谁、什么时候、以什么频率、查什么数据)
- 为每个查询模式设计最优的数据结构
- 权衡数据冗余和一致性
5.2 SQL vs NoSQL 的决策框架
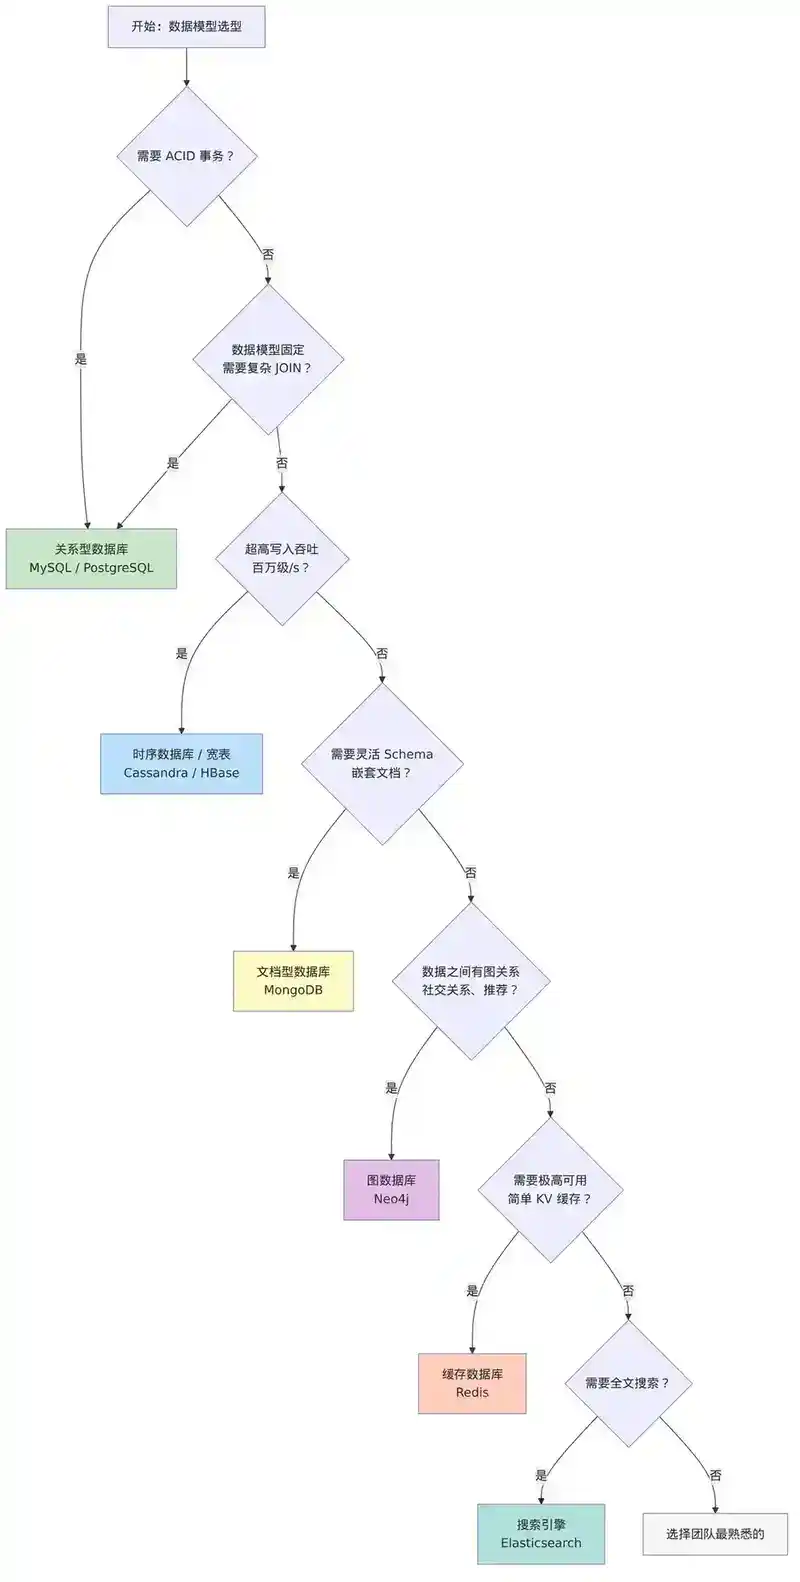
不要用"我熟悉 MySQL"或"NoSQL 是趋势"来决定存储选型。用以下决策树:
需要 ACID 事务? → 是 → 关系型数据库(MySQL/PostgreSQL)
    ↓ 否
数据模型固定、需要复杂 JOIN? → 是 → 关系型数据库
    ↓ 否
超高写入吞吐(百万级/s)? → 是 → 时序数据库 / 宽表(Cassandra/HBase)
    ↓ 否
需要灵活 Schema、嵌套文档? → 是 → 文档型(MongoDB)
    ↓ 否
数据之间有图关系(社交关系、推荐)? → 是 → 图数据库(Neo4j)
    ↓ 否
需要极高可用、简单 KV、缓存? → 是 → Redis
    ↓ 否
需要全文搜索? → 是 → Elasticsearch
    ↓ 否
选择你团队最熟悉的
5.3 实战:短链接系统的数据模型设计
核心查询模式:
- 通过短码查原始 URL(读 > 99%)
- 创建短链接(写 < 1%)
- 按用户查询创建记录
数据模型:
-- MySQL 主表
CREATE TABLE short_urls (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    short_code VARCHAR(8) NOT NULL UNIQUE,
    original_url TEXT NOT NULL,
    user_id BIGINT,
    created_at DATETIME NOT NULL,
    expire_at DATETIME,
    click_count BIGINT DEFAULT 0,
    INDEX idx_user_id (user_id),
    INDEX idx_short_code (short_code)
);

-- Redis 缓存(热数据)
-- Key: short_code, Value: original_url, TTL: 7天
为什么选 MySQL + Redis 而不是纯 Redis?
- 数据需要持久化,Redis 内存成本高,不适合存储 91TB 数据
- 读多写少,Redis 缓存命中率 > 95%,够用
- 短码唯一性需要数据库约束保证
六、架构演进:从单体到分布式的渐进步伐
6.1 不要一开始就过度设计
架构师最常犯的错误是上来就设计"全球多活+微服务+事件溯源+Serverless"。好的架构是演进出来的,不是设计出来的。
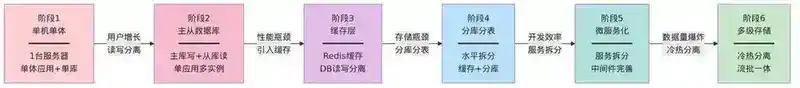
架构演进的典型路径:
阶段1:单机单体
  ↓ 用户增长 → 读写分离
阶段2:主从数据库 + 单应用
  ↓ 性能瓶颈 → 引入缓存
阶段3:缓存层 + 数据库读写分离
  ↓ 存储瓶颈 → 分库分表
阶段4:分库分表 + 缓存 + 单应用
  ↓ 开发效率 → 服务拆分
阶段5:微服务化 + 中间件
  ↓ 数据量爆炸 → 冷热分离
阶段6:多级存储 + 流批一体
关键原则:
- 用数据说话:当前 QPS、存储量、延迟是否触发瓶颈?没有就别拆。
- 先垂直扩展再水平扩展:升级机器配置比加机器简单得多
- 先优化单点再引入分布式:分布式带来的复杂度(一致性、网络、调试)远超想象
6.2 每一步演进要回答的问题
每一步演进前,问自己三个问题:
- 当前瓶颈是什么?(CPU/内存/IO/网络/存储)
- 这个方案为什么能解决瓶颈?(不是"大家都这么做")
- 引入的新复杂度是什么?(一致性、运维、调试、成本)
以"引入缓存"为例:
- 瓶颈:数据库读 QPS 接近上限
- 方案:Redis 缓存热点数据,命中率 95%,数据库读 QPS 降低 20 倍
- 新复杂度:缓存一致性、缓存穿透/击穿/雪崩、缓存容量规划
七、技术选型与权衡:没有银弹,只有取舍
7.1 技术选型的决策框架
技术选型不是"选最好的技术",而是在给定约束下,选择最合适的技术。约束包括:
- 团队能力(能不能用好)
- 运维成本(出问题谁来修)
- 生态成熟度(社区活跃度、文档质量、踩坑经验)
- 性能要求(能不能满足)
- 成本预算(自建还是云服务)
决策框架:
- 列出候选方案(至少 2 个)
- 对每个方案,列出优缺点
- 用约束条件过滤
- 给出明确推荐并说明理由
7.2 常见选型场景的权衡分析
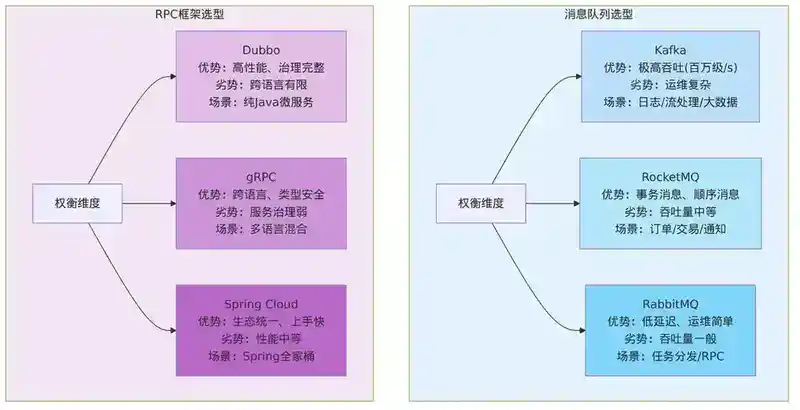
场景1:消息队列选型——Kafka vs RocketMQ vs RabbitMQ
| 维度 | Kafka | RocketMQ | RabbitMQ |
|---|---|---|---|
| 吞吐量 | 极高(百万级/s) | 高(十万级/s) | 中等(万级/s) |
| 延迟 | 毫秒级(批量) | 毫秒级 | 微秒级(低负载) |
| 消息可靠性 | 高(副本机制) | 高(同步刷盘) | 高(镜像队列) |
| 顺序消息 | 分区内有序 | 支持全局有序 | 弱 |
| 事务消息 | 支持 | 支持 | 不支持 |
| 运维复杂度 | 高(自建) | 中 | 低 |
| 典型场景 | 日志、流处理、大数据 | 交易、订单、通知 | 任务分发、RPC |
选择逻辑:
- 日志/流处理 → Kafka(高吞吐、持久化、流计算生态)
- 订单/交易/分布式事务 → RocketMQ(事务消息、顺序消息、阿里系)
- 任务分发/低延迟 → RabbitMQ(灵活路由、低延迟、运维简单)
场景2:RPC 框架选型——Dubbo vs gRPC vs Spring Cloud
| 维度 | Dubbo | gRPC | Spring Cloud |
|---|---|---|---|
| 协议 | 自定义(TCP) | HTTP/2 | HTTP/1.1 |
| 序列化 | 多协议(Hessian/Kryo/Protobuf) | Protobuf | JSON |
| 服务治理 | 完整(注册/路由/限流/熔断) | 弱(需配合 Istio) | 完整(Netflix 生态) |
| 跨语言 | 有限 | 原生支持 | 有限 |
| 性能 | 高 | 高 | 中 |
| 生态 | 阿里系 | Google 系 | Spring 系 |
选择逻辑:
- 纯 Java 微服务体系 → Dubbo(性能高、治理完整、阿里系)
- 多语言混合 → gRPC(跨语言原生支持、Protobuf 类型安全)
- Spring 全家桶 → Spring Cloud(生态统一、上手快)
7.3 权衡的表达方式
在面试中,你的权衡表达应该遵循这个模板:
"对于 [场景],我推荐 [方案A],而不是 [方案B]。原因是 [1-2个核心优势]。但 [方案A] 的代价是 [1个核心劣势],我们可以通过 [缓解措施] 来应对。如果未来 [条件变化],也可以迁移到 [方案C]。"
示例:
"对于短链接系统的核心读写路径,我推荐 MySQL + Redis,而不是纯 Redis。原因是 MySQL 提供持久化保证、事务支持和低成本海量存储(91TB 数据放内存成本过高)。但 MySQL 的读性能有限,我们通过 Redis 缓存热点数据来应对——95% 的读请求命中缓存,数据库只需承载 5% 的读流量。如果未来数据量增长到 PB 级别,可以考虑引入 TiDB 或 Cassandra 来实现水平扩展。"
八、完整案例:设计一个短链接系统
把以上方法论串联起来,完整走一遍短链接系统的设计。
8.1 需求澄清
假设确认:
- 功能:创建短链接、重定向到原始 URL、查看点击统计、自定义短码
- 规模:100M 月活用户,日均创建 10M 条短链接
- 非功能:重定向延迟 < 10ms,可用性 99.99%,短码长度 7 字符
- 读多写少:读写比约 100:1
8.2 容量估算
- 写 QPS:10M / 86400 ≈ 116/s,峰值 × 2 = 232/s
- 读 QPS:232 × 100 = 23,200/s
- 5 年存储:10M × 365 × 5 = 18.25B 条记录,每条 ~500B → 约 9.1TB
- 结论:需要分库分表,Redis 缓存
8.3 短码生成算法
方案对比:
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 哈希截断 | MD5/SHA256 取前 7 位 | 简单 | 碰撞率高 |
| 自增 ID + Base62 | 自增 ID 转 62 进制 | 无碰撞 | 依赖自增 ID 生成器 |
| 预生成 + 随机分配 | 提前生成一批短码 | 高性能 | 需管理短码池 |
推荐方案:分布式 ID 生成器(Snowflake)+ Base62 编码。
Snowflake ID: 64 bits
→ 转为十进制 → Base62 编码 → 7 位短码(62^7 ≈ 3.5万亿,足够用)
8.4 API 设计
POST   /api/v1/urls          # 创建短链接
GET    /api/v1/urls/{code}   # 获取短链接信息
DELETE /api/v1/urls/{code}   # 删除短链接
GET    /{short_code}         # 重定向(核心路径)
GET    /api/v1/urls/{code}/stats  # 点击统计
8.5 数据模型
MySQL: urls 表(按 short_code 哈希分 16 库)
Redis: short_code → original_url(缓存热数据,TTL 7天)
Redis: short_code → click_count(计数器,定期同步到 MySQL)
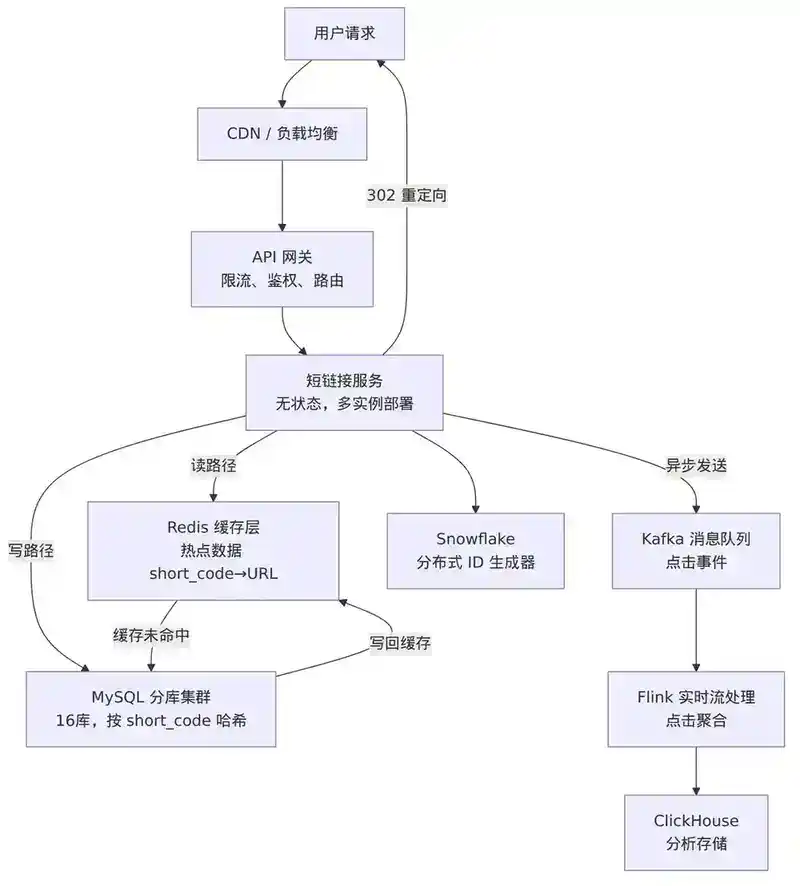
8.6 架构设计
用户请求 → CDN/LB → API Gateway
                         ↓
              短链接服务(无状态)
              ↙           ↘
    Redis 缓存层        MySQL 分库集群
    (读路径)            (写路径 + 冷数据)
                         ↓
                    Kafka(点击事件)
                         ↓
                    Flink 实时统计
                         ↓
                    ClickHouse 分析存储
核心流程:
- 创建短链接:生成 Snowflake ID → Base62 → 写 MySQL → 写 Redis 缓存
- 重定向:查 Redis 缓存 → 命中直接 302 → 未命中查 MySQL → 写回 Redis → 302
- 点击统计:异步发送 Kafka → Flink 聚合 → 写入 ClickHouse
8.7 关键设计决策与权衡
| 决策 | 选择 | 原因 | 代价 |
|---|---|---|---|
| 存储引擎 | MySQL + Redis | 持久化 + 高性能缓存 | 缓存一致性 |
| ID 生成 | Snowflake | 全局唯一、趋势递增 | 时钟回拨 |
| 分库策略 | 按 short_code 哈希 | 均匀分布、查询定位 | 跨库聚合困难 |
| 统计系统 | Kafka + Flink + ClickHouse | 异步解耦、高吞吐 | 实时性有延迟 |
九、常见陷阱与避坑指南
9.1 需求阶段的陷阱
陷阱1:假设需求而不是确认需求
- 错误:"我假设用户需要实时统计"
- 正确:"点击统计需要实时吗?还是准实时(T+1分钟)就可以?"
陷阱2:遗漏非功能性需求
- 错误:只讨论功能,不讨论延迟、可用性、一致性
- 正确:主动确认 SLA 期望
9.2 设计阶段的陷阱
陷阱3:过早优化
- 错误:100 个用户就上微服务、分库分表
- 正确:先简单架构,预留扩展接口
陷阱4:忽略故障场景
- 错误:只设计正常路径
- 正确:每个组件都要考虑故障时怎么办
陷阱5:技术选型没有理由
- 错误:"我选 Redis 因为它是缓存"
- 正确:"我选 Redis 因为读写比 100:1,需要支持 23K QPS 读,MySQL 不够,而 Redis 10万 QPS 单节点足够"
9.3 沟通阶段的陷阱
陷阱6:自顾自画图,不互动
- 错误:埋头画图 20 分钟,面试官睡着
- 正确:每完成一个模块,停下来问面试官是否有问题或补充
陷阱7:遇到盲区硬撑
- 错误:不懂装懂,绕圈子
- 正确:"这块我经验不多,但根据我的理解,我会这样处理...你觉得合理吗?"
十、总结
系统设计面试的方法论可以浓缩为六个字:澄清、估算、取舍。
- 澄清:把模糊需求变成可量化的技术约束
- 估算:用数字证明架构决策的合理性
- 取舍:没有完美方案,只有最合适的权衡
记住:面试官不是在找"标准答案",而是在找思考过程。你的价值不在于知道多少种技术,而在于面对一个模糊问题时,能否结构化地推导出合理方案。
面试官视角提问
以下问题不计入阅读时间,建议先独立思考再参考答案。
Q1:你设计了短链接系统的缓存方案,Redis 缓存命中率 95%。如果突然有一个热点短链接被大量访问(比如某个明星的微博链接),你的缓存层会出什么问题?如何解决?
参考答案:
问题:热点 Key 会导致 Redis 集群中某个节点 QPS 远超其他节点,可能造成该节点 CPU 打满、响应变慢,甚至触发集群故障转移。
解决方案:
- 本地缓存前置:在应用服务器加一层 Caffeine/Guava 本地缓存,秒级 TTL,拦截大部分热点请求
- 热点 Key 复制:检测到热点 Key 后,将同一数据复制到多个 Redis 分片节点,客户端随机选择一个节点读取
- 读写分离:Redis 主从架构,读请求分发到多个从节点
- 限流兜底:对单 Key 做 QPS 限制,超过阈值直接返回静态页面或降级结果
Q2:你用了 Snowflake 生成分布式 ID。如果机器时钟回拨了怎么办?Snowflake 的 41 位时间戳在 69 年后会溢出,你打算怎么处理?
参考答案:
时钟回拨:
- 短时间回拨(< 100ms):等待(自旋或 sleep),直到时钟追上上次生成的时间
- 中等回拨(< 5s):使用备用机器 ID,即临时切换到另一个 worker ID 继续生成
- 长时间回拨:拒绝服务,报警,人工介入——因为长时间回拨通常是 NTP 配置错误
时间戳溢出:
- 41 位时间戳从 1970 年开始,约 69 年溢出(约 2039 年)
- 方案:使用 自定义纪元(epoch),不从 1970 年而是从 2020 年开始,可用到 2089 年
- 或者扩展为 42 位时间戳(从序列号中借 1 位),可用到 2139 年
Q3:你设计的短链接系统用 Base62 编码 Snowflake ID。Base62 字符集是 [0-9a-zA-Z],假如产品经理想让短码中不包含容易混淆的字符(如 0/O、1/l/I),你会怎么调整?对短码长度有什么影响?
参考答案:
调整方案:
- 移除混淆字符后的字符集:去掉 0、O、1、l、I,从 62 个字符变为 57 个字符
- 短码长度影响:62^7 ≈ 3.5 万亿,57^7 ≈ 1.9 万亿,仍然足够
- 或者保持 7 位不变,57^7 约 1.9 万亿,足够用很久
- 编码实现:将 Base62 的字符映射表替换为过滤后的 57 字符表即可
延伸思考:
- 如果对短码长度有更严格要求(比如 5 位),57^5 ≈ 6 亿,可能不够
- 此时可以考虑:预生成短码池 + 6 位长度 + 大小写敏感(去掉混淆字符后仍有 57 个)
Q4:你说架构要"演进而不是一步到位"。假设短链接系统从日均 10M 增长到 100M 创建量,你的架构哪些地方需要调整?具体怎么调?
参考答案:
需要调整的关键点:
- 数据库分片:从 16 库扩展到 64 库,使用一致性哈希减少迁移量
- 短码生成:Snowflake 单机 QPS 足够(100M/86400≈1157/s),但需要增加 worker 节点
- 缓存层:热点 Key 问题更严重,需要引入本地缓存 + 热点 Key 自动检测和复制
- 统计系统:Kafka 分区数增加,Flink 并行度提升,ClickHouse 集群扩容
- API 网关:限流策略从单机限流升级为全局限流(Redis 令牌桶)
- CDN:如果短链接点击涉及大量海外用户,需要部署多区域 CDN 边缘节点减少延迟
Q5:你提到技术选型要考虑"团队能力"。假设你们团队只有 Java 和 MySQL 经验,但有一项需求是"实时推荐",需要用到向量数据库和近邻搜索。你会怎么选型?
参考答案:
思路:技术选型要在"团队能力"和"业务需求"之间找平衡。
方案对比:
- 自建向量数据库(Milvus/Qdrant):功能完整,但团队需要学习运维、监控、调优,学习曲线陡峭
- 云服务托管向量数据库:阿里云 AnalyticDB、腾讯云 VectorDB,降低运维成本,但增加云厂商锁定
- 在现有 MySQL 上实现近似方案:MySQL 8.0+ 支持部分向量运算,但性能和精度有限
推荐方案:云服务托管 + 逐步培养团队能力。
- 短期:用云厂商托管向量数据库,快速上线
- 中期:团队学习向量数据库原理和运维,搭建测试环境
- 长期:根据成本和性能评估是否迁移到自建
核心原则:不要让技术选型成为业务瓶颈,也不要让团队能力成为技术债。先跑通,再优化。
下一考点预告:193|高并发系统设计方法:流量估算、瓶颈识别、分层优化和容量冗余