阅读时间:约 45 分钟 | 难度:高级 | 适用场景:系统设计面试、架构评审、大规模系统演进
一、引言:可扩展性——架构的第一性原理
2010 年,Instagram 只有 2 台服务器支撑 100 万用户;2012 年被 Facebook 收购时,用户量已达 3000 万,服务器从 2 台变成了几百台。如果当初的架构不支持水平扩展,这个增长曲线根本不可能实现。
可扩展性(Scalability)不是"系统能跑多快",而是"当负载增长时,系统能否通过增加资源来线性提升处理能力"。它关注的是增长曲线,而非某个静态的性能指标。
一个可扩展的架构需要回答三个核心问题:
- 能不能加——系统是否支持通过增加机器来提升容量?
- 加多少——增加 N 台机器,处理能力是否接近 N 倍?
- 加哪里——瓶颈在哪一层?加机器真的能解决瓶颈吗?
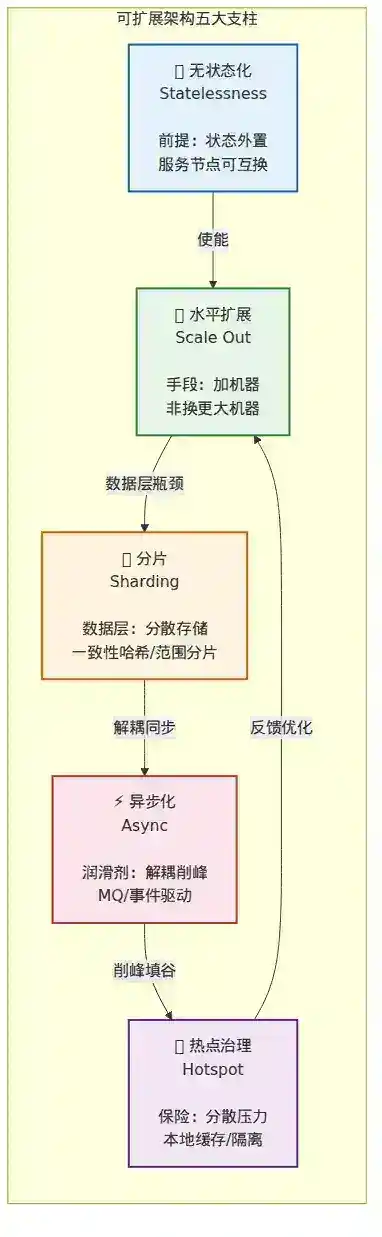
本文围绕可扩展架构的五大支柱展开:
| 支柱 | 解决的问题 | 核心思想 |
|---|---|---|
| 无状态化 | 应用层能否任意复制 | 状态外置,服务节点可互换 |
| 水平扩展 | 如何增加处理能力 | 加机器而非换更大机器 |
| 分片 | 数据层如何扩展 | 数据拆分,分散存储和计算 |
| 异步化 | 如何应对流量尖峰 | 解耦同步链路,削峰填谷 |
| 热点治理 | 不均匀负载如何应对 | 识别并分散集中访问的压力 |
二、无状态化:水平扩展的基石
2.1 什么是"状态"
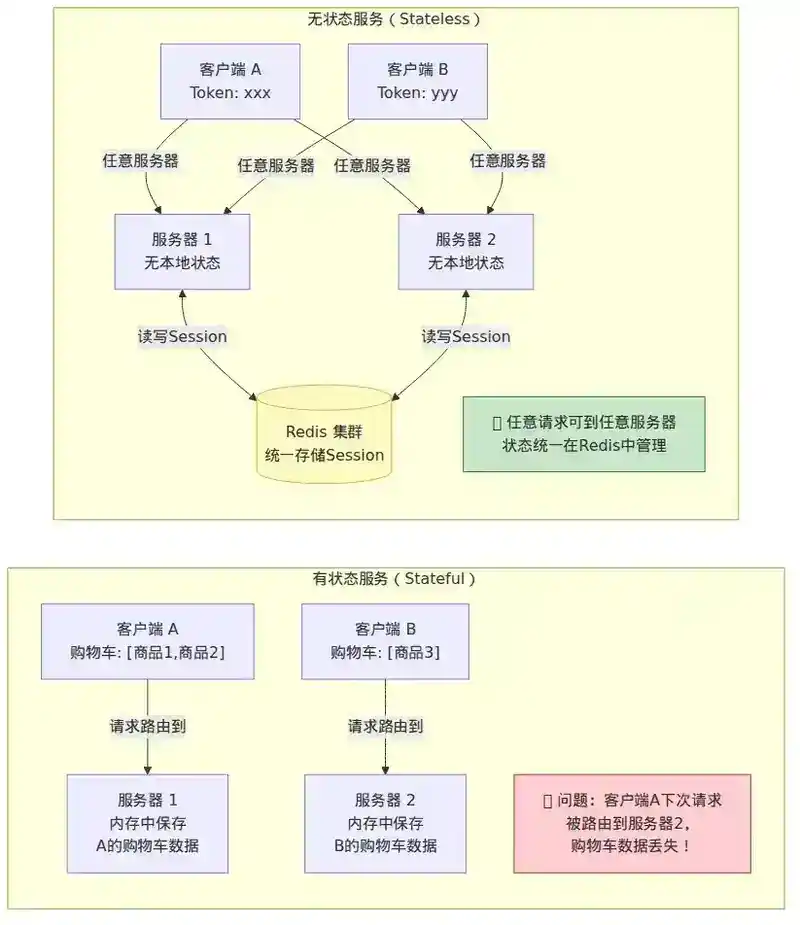
在分布式系统中,"状态"(State)指的是服务在处理请求时需要记住的信息。有状态和无状态的区别如同"速记员"和"翻译官":
- 有状态服务:像一个速记员,需要记住之前说了什么才能继续记录。每个请求之间有关联,服务实例不能被随意替换。
- 无状态服务:像一个翻译官,每句话独立翻译,不依赖之前的对话。任何翻译官都能处理任何一句话。
// ❌ 有状态:Session 存在本地内存
@RestController
public class OrderController {
    private Map<String, Cart> userCarts = new ConcurrentHashMap<>(); // 本地状态

    @PostMapping("/cart/add")
    public void addToCart(HttpSession session, @RequestBody Item item) {
        Cart cart = userCarts.get(session.getId());
        cart.add(item);
        // 问题:如果请求被负载均衡到另一台机器,购物车就"丢了"
    }
}

// ✅ 无状态:Session 外置到 Redis
@RestController
public class OrderController {
    @Autowired private RedisTemplate<String, Cart> redis;

    @PostMapping("/cart/add")
    public void addToCart(@RequestHeader("token") String token, @RequestBody Item item) {
        Cart cart = redis.opsForValue().get("cart:" + token);
        if (cart == null) cart = new Cart();
        cart.add(item);
        redis.opsForValue().set("cart:" + token, cart, 30, TimeUnit.MINUTES);
        // 任何机器都能处理,因为状态在 Redis 中
    }
}
2.2 无状态化的三个层次
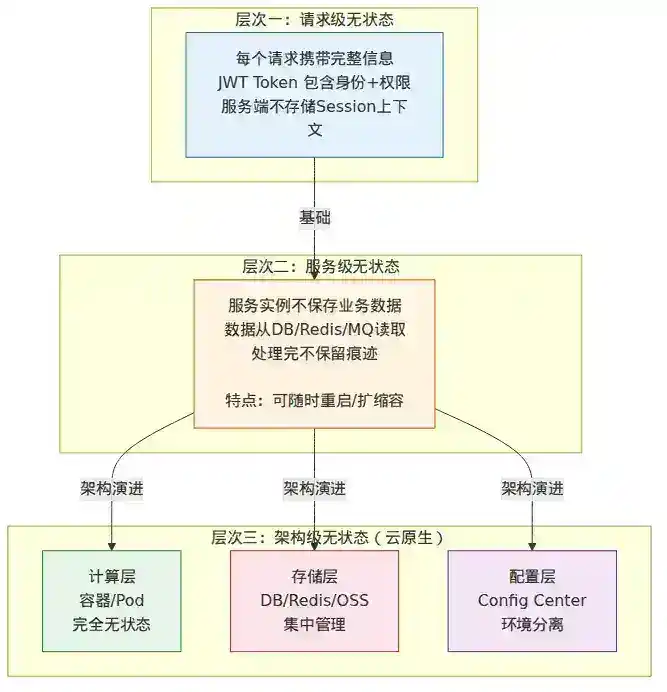
无状态化不只是"把 Session 放到 Redis",它有三个递进的层次:
层次一:请求级无状态
每个请求携带所有必要信息,不依赖服务端上下文。典型实践:JWT Token 携带用户身份和权限信息,服务端不存 Session。
层次二:服务级无状态
服务实例本身不保存任何业务数据。所有数据从外部存储(DB、Redis、MQ)读取,处理完成后不保留痕迹。这意味着:
- 服务可以随时重启,不丢失数据
- 服务可以任意扩容缩容,不需要数据迁移
- 服务宕机后,请求可以透明切换到其他实例
层次三:架构级无状态
整个系统的状态集中管理,计算与存储彻底分离。这是云原生架构的核心思想:
- 计算层(容器/Pod):完全无状态,随时创建和销毁
- 存储层(DB/Redis/OSS):集中管理,有专门的扩容和容灾策略
- 配置层(Config Center):配置与代码分离,环境差异由配置中心管理
2.3 无状态化的工程实践
Session 外置
最经典的无状态化手段。将 HTTP Session 从应用服务器内存迁移到 Redis 集群:
// Spring Session + Redis 自动完成 Session 外置
// 只需引入依赖和配置,代码零改动
@Configuration
@EnableRedisHttpSession(maxInactiveIntervalInSeconds = 1800)
public class SessionConfig {
    @Bean
    public RedisConnectionFactory connectionFactory() {
        return new LettuceConnectionFactory();
    }
}
关键注意事项:
- Redis 的可用性直接影响用户登录态——Redis 挂了,所有用户需要重新登录。需要 Redis 集群或 Sentinel 保障高可用
- Session 序列化:对象要实现 Serializable,且版本升级时要考虑兼容性
- 每次请求都读 Redis 会增加几毫秒延迟——可以配合本地缓存(Caffeine)减少 Redis 访问
文件存储外置
用户上传的文件(头像、附件)不能存在应用服务器本地磁盘,必须使用对象存储(OSS/MinIO/S3)。上传后返回 URL,文件访问走 CDN 或对象存储,不经过应用服务器。
定时任务的无状态化
多个应用实例同时运行定时任务怎么办?需要分布式调度框架:
- Elastic-Job:基于 ZooKeeper 的分片调度,每个实例只执行属于自己的分片
- XXL-JOB:中心化调度,通过路由策略(第一个/最后一个/轮询/分片广播)决定执行实例
- SchedulerLock(ShedLock):基于数据库锁或 Redis 锁,确保同一时刻只有一个实例执行
// ShedLock 示例:基于 Redis 的分布式锁
@Scheduled(cron = "0 0 2 * * ?")
@SchedulerLock(name = "cleanExpiredOrders", lockAtMostFor = "PT30M")
public void cleanExpiredOrders() {
    // 多个实例同时触发,但只有获取到锁的实例真正执行
    orderService.cleanExpired();
}
2.4 无状态化的代价
无状态化不是免费的:
| 代价 | 说明 | 缓解措施 |
|---|---|---|
| 网络延迟 | 每次请求都要访问外部存储(Redis/DB) | 本地缓存 + 连接池复用 |
| 外部依赖可用性 | Redis 挂了,所有服务受影响 | 集群/Sentinel 保障高可用 |
| 序列化开销 | 对象需要序列化/反序列化才能存储到 Redis | 选择高效序列化协议(Protobuf/Kryo) |
| 数据一致性 | 多实例通过共享存储通信,存在并发问题 | 分布式锁、CAS 操作 |
三、水平扩展:从"换更大的"到"加更多的"
3.1 垂直扩展 vs 水平扩展
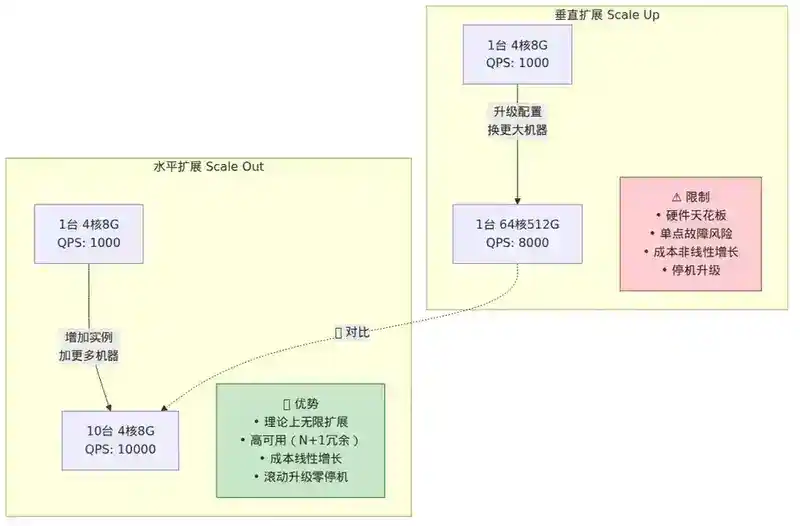
垂直扩展(Scale Up):换更大的机器
┌─────────────────────┐
│   4核 8G → 64核 512G  │    简单但有限,单机性能天花板
└─────────────────────┘

水平扩展(Scale Out):加更多的机器
┌────┐ ┌────┐ ┌────┐ ┌────┐
│ 4C │ │ 4C │ │ 4C │ │ 4C │    复杂但无限,理论上可无限扩展
└────┘ └────┘ └────┘ └────┘
垂直扩展的极限是硬件天花板。2024 年最强单机 CPU 约 192 核,内存约 24TB,但成本和可靠性都不可控——单机宕机等于整个服务宕机。水平扩展没有理论上限,但要求架构设计支持分布式。
3.2 水平扩展的前提条件
水平扩展不是"加机器就行",它需要满足三个前提:
前提一:无状态化
这是最基础的前提。如果每个服务实例都保存了独有的状态数据,负载均衡器不知道该把请求发到哪台机器,水平扩展就失去了意义。
前提二:负载均衡
请求如何均匀地分发给多个实例?常见策略:
| 策略 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 轮询(Round Robin) | 依次分发 | 简单,绝对公平 | 不考虑实例负载差异 |
| 加权轮询 | 按权重分发 | 适合异构集群 | 需要手动配置权重 |
| 最少连接 | 发给连接数最少的实例 | 自适应负载 | 需要维护连接状态 |
| 一致性哈希 | 按请求特征哈希 | 适合有状态场景 | 可能不均衡 |
| 随机 | 随机选择 | 简单,统计均匀 | 短时间可能不均衡 |
前提三:共享资源的线性扩展
有些资源即使加机器也无法线性扩展。最典型的是数据库——单库写入能力有限,加应用服务器不能解决数据库瓶颈。这种情况需要分库分表(见第四节)。
3.3 扩展性的度量:Amdahl 定律与 Gunther 定律
Amdahl 定律定义了加速比的上限:
加速比 = 1 / ((1 - P) + P/N)
其中 P = 可并行化的比例,N = 处理器数量
当 P = 0.95(95% 可并行化)、N = 10 时,加速比 ≈ 6.9(而非 10)。那 5% 的串行部分成为瓶颈。
Gunther 定律(通用扩展定律) 更贴近现实,引入了一致性延迟(Coherency Delay):
C(N) = N / (1 + α(N-1) + β·N(N-1))
其中 α = 争用系数,β = 一致性延迟系数
β 项解释了为什么扩展性会"倒退"——当节点数过多时,节点间通信和协调开销反而会让吞吐下降。这就是为什么分布式系统有"最优集群规模"。
3.4 不同层次的水平扩展
接入层扩展:最简单,Nginx/HAProxy/LVS 等反向代理本身无状态,DNS 轮询或 VIP 漂移即可实现。
应用层扩展:前提是无状态化。配合 K8s HPA(Horizontal Pod Autoscaler)可实现自动扩缩容:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: order-service-hpa
spec:
  scaleTargetRef:
    kind: Deployment
    name: order-service
  minReplicas: 3
  maxReplicas: 50
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: "1000"
缓存层扩展:Redis Cluster 原生支持水平扩展,通过哈希槽分配实现数据分片。扩容时槽会重新分配,数据自动迁移。
数据库层扩展:最复杂,需要分库分表(见第四节)。
四、分片:数据层的水平扩展
4.1 为什么数据层最难以扩展
应用层可以无状态,但数据层天然有状态。数据不能随意复制(一致性要求),也不能随意拆分(查询需求)。分片(Sharding)是在一致性、可用性和查询灵活性之间取平衡。
4.2 分片策略

策略一:Range 分片(范围分片)
按数据的某个连续范围分片,如订单表按创建时间分片:
Shard-0: 2024-01 ~ 2024-06
Shard-1: 2024-07 ~ 2024-12
Shard-2: 2025-01 ~ 2025-06
- 优点:范围查询高效,扩容简单(加新分片即可)
- 缺点:写入热点——新数据总是写入最新分片,老分片几乎空闲
策略二:Hash 分片(哈希分片)
按分片键的哈希值取模:
Shard = hash(user_id) % N
- 优点:数据分布均匀,无写入热点
- 缺点:扩容困难——N 变化时,几乎所有数据都要重新分配(
hash(key) % 4 ≠ hash(key) % 5)
策略三:一致性哈希
解决 Hash 分片扩容难的问题。将哈希空间组织成一个环(0 ~ 2^32-1),节点和 Key 都映射到环上,Key 分配给顺时针方向最近的节点。
扩容前:4 个节点,每个负责 1/4 的哈希空间
扩容后:5 个节点,只有约 1/5 的数据需要迁移(而非全部)
一致性哈希引入了虚拟节点(Virtual Node)概念——每个物理节点对应多个虚拟节点,分散在环上不同位置,进一步均衡数据分布。
策略四:Directory 分片(目录分片)
维护一个中心化的路由表,记录每条数据在哪个分片:
user_001 → Shard-A
user_002 → Shard-B
user_003 → Shard-A
- 优点:最灵活,可以按任意规则分配,扩容时只需更新路由表
- 缺点:路由表成为瓶颈和单点,需要缓存和高可用保障
4.3 分片键的选择黄金法则
分片键的选择是分片设计中最关键的决策,选错几乎无法纠正。三个原则:
- 查询模式决定分片键:90% 以上的查询应该能通过分片键精确定位到单个分片。如果选 user_id 作为分片键但 80% 的查询按 order_id 查,设计就失败了。
- 避免跨分片查询:跨分片查询需要 Scatter-Gather(分散到所有分片查询再聚合),性能随分片数线性下降。
- 分片键尽量不可变:如果分片键会变化(如用户修改了 user_id),数据需要跨分片迁移,操作复杂且风险高。
常见反模式:
-- 按 user_id 分片,但需要按 order_id 查询
SELECT * FROM orders WHERE order_id = 'ORD-2024-001';
-- 这会导致全分片扫描!

-- 解决方案:建立 order_id → user_id 的映射
-- 方案A:额外维护一张映射表
-- 方案B:order_id 中编码 user_id(如 ORD-{user_id}-{seq})
-- 方案C:通过 ES 等搜索引擎建立二级索引
4.4 分片带来的挑战
跨分片 Join
分库分表后,Join 操作无法跨分片执行。解决方案:
- 应用层 Join:先查一个分片,再用结果查另一个分片(但性能差)
- 数据冗余:将需要 Join 的数据冗余存储在同一分片
- 宽表设计:提前将关联数据聚合为一张宽表
分布式事务
跨分片的事务无法使用数据库本地事务。解决方案:
- 尽量避免跨分片事务(通过分片键设计)
- 使用分布式事务方案(Seata AT/TCC/Saga)
- 最终一致性 + 补偿机制
全局唯一 ID
分片后不能依赖数据库自增 ID。解决方案:
- Snowflake 算法:64 位 Long,时间戳 + 机器 ID + 序列号
- 数据库号段模式:批量预分配 ID 段
- UUID:简单但无序,对索引不友好
扩容与再平衡
数据量增长需要增加分片。扩容策略:
- 停服扩容:暂停写入,全量数据重新分配(简单粗暴,适用于可接受维护窗口的场景)
- 双写扩容:新旧分片同时写入,异步迁移历史数据,完成后切换读流量(平滑但复杂)
- 逻辑分片:物理分片数固定(如 64 个),初期部署在少量物理节点上,扩容时将部分逻辑分片迁移到新节点
五、异步化:解耦与削峰
5.1 同步 vs 异步:一个订单的生命周期
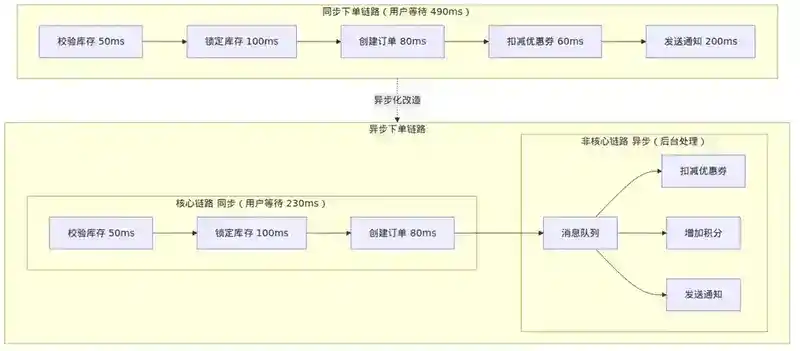
用户在电商平台下单,从点击"提交订单"到看到"下单成功",如果所有操作同步执行:
同步链路(用户等待):
┌──────────┐   ┌──────────┐   ┌──────────┐   ┌──────────┐   ┌──────────┐
│ 校验库存  │──→│ 锁定库存  │──→│ 创建订单  │──→│ 扣减优惠券 │──→│ 发送通知  │
│ 50ms     │   │ 100ms    │   │ 80ms     │   │ 60ms     │   │ 200ms    │
└──────────┘   └──────────┘   └──────────┘   └──────────┘   └──────────┘
总耗时:490ms,用户一直在等待
异步化后:
核心链路(同步,用户等待):
┌──────────┐   ┌──────────┐   ┌──────────┐
│ 校验库存  │──→│ 锁定库存  │──→│ 创建订单  │
│ 50ms     │   │ 100ms    │   │ 80ms     │
└──────────┘   └──────────┘   └──────────┘
总耗时:230ms,用户等待时间减少 53%

非核心链路(异步,后台处理):
┌──────────────┐   ┌──────────────┐   ┌──────────────┐
│ 扣减优惠券(MQ) │   │ 增加积分(MQ)  │   │ 发送通知(MQ)  │
└──────────────┘   └──────────────┘   └──────────────┘
5.2 异步化的四种模式
模式一:生产者-消费者(Producer-Consumer)
最基础的异步模式。生产者将消息发送到消息队列,消费者异步处理。Kafka/RocketMQ/RabbitMQ 是典型实现。
// 生产者
@Transactional
public OrderResult createOrder(OrderRequest req) {
    Order order = orderRepository.save(req.toOrder());         // 核心:同步
    rocketMQTemplate.send("order-created", order.toEvent());   // 非核心:异步
    return OrderResult.success(order.getId());
}

// 消费者
@RocketMQMessageListener(topic = "order-created", consumerGroup = "coupon-consumer")
public class CouponConsumer implements RocketMQListener<OrderEvent> {
    @Override
    public void onMessage(OrderEvent event) {
        couponService.deductCoupon(event.getUserId(), event.getCouponId());
    }
}
模式二:事件驱动(Event-Driven)
异步化的高级形态。业务操作产生事件,多个消费者独立响应事件,形成松耦合的事件驱动架构(EDA)。
订单创建事件(OrderCreatedEvent)
  ├── 库存服务:扣减库存
  ├── 优惠券服务:核销优惠券
  ├── 积分服务:增加积分
  ├── 通知服务:发送短信/推送
  └── 数据分析:实时统计
每个消费者独立演进、独立部署,互不影响。但需要确保事件的 Schema 兼容性(如使用 Avro/Protobuf + Schema Registry)。
模式三:请求-响应异步化(Async Request-Reply)
有些场景下,请求需要等待结果,但等待时间可能很长。异步化方案:
客户端 → 服务端(提交任务,返回 taskId)
客户端 → 轮询/回调(查询 taskId 的执行结果)
典型应用:报表导出、批量处理、AI 推理等耗时任务。
模式四:CQRS(命令查询职责分离)
读和写使用不同的模型,异步同步数据:
写操作 → Command Model(MySQL) → 事件 → Query Model(ES/Redis) ← 读操作
写的复杂性和读的灵活性各自由不同的模型最优处理。
5.3 异步化的可靠性保障
异步化解决了延迟问题,但引入了新的可靠性挑战:
消息不丢
- 生产者端:使用同步发送 + 确认机制(Kafka acks=all,RocketMQ 同步刷盘)
- Broker 端:多副本冗余(Kafka min.insync.replicas ≥ 2)
- 消费者端:手动提交 Offset,处理成功后再 ACK
消息不重复(幂等性)
消息队列保证"至少一次"投递,消费者必须实现幂等:
@RocketMQMessageListener(topic = "order-created", consumerGroup = "coupon-consumer")
public class CouponConsumer implements RocketMQListener<OrderEvent> {
    @Autowired private RedisTemplate<String, String> redis;

    @Override
    public void onMessage(OrderEvent event) {
        // 幂等性:通过唯一键去重
        String dedupKey = "coupon:dedup:" + event.getOrderId();
        Boolean success = redis.opsForValue().setIfAbsent(dedupKey, "1", Duration.ofHours(24));
        if (Boolean.FALSE.equals(success)) {
            return; // 已处理过,跳过
        }
        couponService.deductCoupon(event.getUserId(), event.getCouponId());
    }
}
消息有序性
如果需要严格顺序消费,确保同一类消息发到同一分区/队列:
// Kafka:相同 key 的消息进入同一分区
producer.send(new ProducerRecord<>("topic", userId, message));

// RocketMQ:使用 MessageQueueSelector
producer.send(msg, (mqs, m, arg) -> {
    int index = Math.abs(arg.hashCode()) % mqs.size();
    return mqs.get(index);
}, userId);
5.4 异步化不是银弹
过度异步化的陷阱:
- 调试困难:同步调用有清晰调用栈,异步调用需要追踪多个系统
- 最终一致性:用户下单后优惠券可能还没扣,需要合理的用户提示
- 死信处理:消息处理失败需要重试、死信队列和人工补偿机制
- 事务边界:数据库事务和消息发送不在同一事务中,需要事务消息或 Outbox 模式
六、热点治理:不均匀负载的克星
6.1 热点的本质
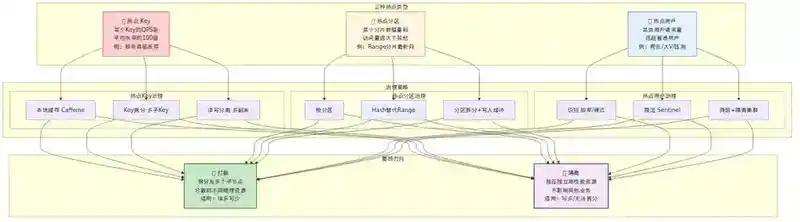
在分布式系统中,热点(Hotspot)指的是负载严重不均衡的现象——某些资源(Key、分区、机器)承受了远超平均水平的访问压力。热点不是"系统整体不够强",而是"局部承受不住"。
三种典型热点:
| 热点类型 | 现象 | 案例 |
|---|---|---|
| 热点 Key | 某个 Key 的 QPS 是平均水平的 100 倍 | 秒杀商品库存、明星微博 |
| 热点分区 | 某个分片的数据量和访问量远大于其他 | 按时间分片,最新数据集中在最新分片 |
| 热点用户 | 某类用户产生的请求量远超普通用户 | 爬虫、压测流量、大 V |
6.2 热点 Key 治理
热点 Key 是 Redis 场景中最常见的问题。一个秒杀商品的库存 Key,在秒杀瞬间可能被 10 万 QPS 集中访问,而单个 Redis 分片的处理能力一般在 5~10 万 QPS。
检测热点 Key
# Redis 热 Key 检测
redis-cli --hotkeys

# 或者通过 monitor 命令采样(生产慎用)
redis-cli monitor | grep "GET stock:item:12345"

# 更推荐:通过客户端 SDK 统计(如 Jedis/Lettuce 的 metrics)
治理策略一:本地缓存
将热点数据缓存在应用进程内存中,直接从本地读取,避免每次访问 Redis:
@Service
public class StockService {
    // 本地缓存:Caffeine,5 秒过期
    private final Cache<String, Integer> localCache = Caffeine.newBuilder()
        .expireAfterWrite(5, TimeUnit.SECONDS)
        .maximumSize(1000)
        .build();

    @Autowired private RedisTemplate<String, Integer> redis;

    public int getStock(String itemId) {
        // 先查本地缓存
        Integer stock = localCache.getIfPresent(itemId);
        if (stock != null) return stock;

        // 本地缓存未命中,查 Redis
        stock = redis.opsForValue().get("stock:" + itemId);
        if (stock != null) {
            localCache.put(itemId, stock);
        }
        return stock != null ? stock : 0;
    }
}
治理策略二:Key 拆分
将热点 Key 拆分为多个子 Key,分散到不同分片:
原始:stock:item:12345 → 分片 A(单点压力)

拆分后:
stock:item:12345:0 → 分片 A
stock:item:12345:1 → 分片 B
stock:item:12345:2 → 分片 C
...
stock:item:12345:9 → 分片 J

读取时随机选一个子 Key,写入时更新所有子 Key(或异步同步)
治理策略三:读写分离
Redis Cluster 中,热点 Key 所在分片可以增加只读副本,读请求分散到副本:
// Lettuce 支持读写分离
@Bean
public LettuceConnectionFactory connectionFactory() {
    LettuceClientConfiguration config = LettuceClientConfiguration.builder()
        .readFrom(ReadFrom.REPLICA_PREFERRED) // 优先读副本
        .build();
    return new LettuceConnectionFactory(redisClusterConfig(), config);
}
6.3 热点分区治理
热点分区最常见于 Range 分片场景——按时间分片时,最新时间段的数据总是访问最频繁的。
治理策略:
- 预分区:提前创建足够多的分区,避免数据倾斜。如 HBase 建表时指定 100 个预分区。
- Hash 分区替代 Range 分区:如果不需要范围查询,使用 Hash 分片消除热点分区。
- 分区拆分:当某个分区过大时,动态拆分为两个分区(如 HBase Region Split)。
- 写入缓冲:写入先进入 MQ 缓冲,批量写入存储,减少存储层的热点压力。
6.4 热点用户治理
热点用户可能是爬虫、恶意攻击或正常的大 V。治理策略需要区分对待:
- 识别:通过请求频率、请求模式(是否遍历 ID)、User-Agent 等特征识别
- 限流:对单个用户/IP 实施细粒度限流(Sentinel 热点参数限流)
- 降级:对非核心用户(如爬虫)返回降级数据或空结果
- 隔离:将热点用户的请求路由到专用集群,避免影响普通用户
// Sentinel 热点参数限流
@GetMapping("/item/{itemId}")
@SentinelResource(value = "getItem",
    blockHandler = "getItemBlockHandler",
    fallback = "getItemFallback")
public Item getItem(@PathVariable String itemId) {
    // 对热点商品 ID 实施不同限流阈值
    return itemService.getItem(itemId);
}
6.5 热点的"打散"与"隔离"
所有热点治理最终归结为两个方向:
打散(分散压力):将热点拆分为多个子节点,分散到不同物理资源上。适用于读多写少场景。 隔离(物理隔离):将热点放在独立的高性能资源上,不影响其他业务。适用于写多或无法拆分的场景。
七、五者协同:一个完整的可扩展架构
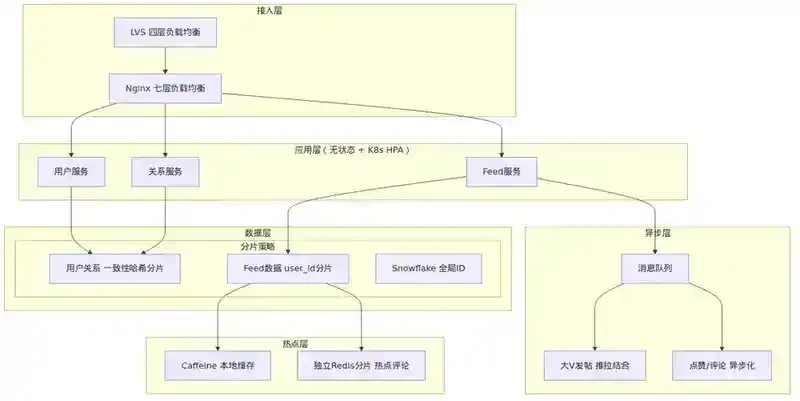
将无状态化、水平扩展、分片、异步化和热点治理串联起来,看一个完整的可扩展架构实例——社交 Feed 流系统。
需求
设计一个支持 1 亿用户、峰值 QPS 50 万的 Feed 流系统(类似微博/朋友圈)。
架构设计
第一层:无状态化 + 水平扩展
- Feed 服务、用户服务、关系服务全部无状态化,Session 存储在 Redis 中
- 每个服务部署 100+ 个 Pod,通过 K8s HPA 自动扩缩容
- 接入层使用 Nginx + LVS,通过轮询策略分发请求到各 Pod
第二层:分片
- 用户关系数据(关注/粉丝)按 user_id 分片,使用一致性哈希,便于扩容
- Feed 数据按 user_id 分片,保证同一用户的 Feed 在同一分片,避免跨分片聚合
- 使用 Snowflake 生成全局唯一 Feed ID
第三层:异步化
- 用户发帖后,写入操作通过 MQ 异步分发给所有粉丝的 Feed 收件箱
- 大 V 发帖采用"推拉结合"模式:活跃粉丝推(写入 inbox),非活跃粉丝拉(查询时聚合)
- 点赞、评论、转发等非核心操作全部异步化
第四层:热点治理
- 大 V 的 Feed 是天然热点——被大量粉丝同时读取
- 热点 Feed 使用本地缓存(Caffeine),过期时间 5 秒
- 大 V 发帖时,Feed 写入操作限流(防止瞬间写入数百万粉丝的 inbox)
- 热点 Feed 的评论使用独立 Redis 分片,避免影响普通 Feed
第五层:容量冗余
- 每层 N+1 冗余
- 核心链路配置熔断和降级
- 定期全链路压测,验证扩展性
八、总结
可扩展架构的五大支柱,记住这个口诀:
无状态化是前提(没它不能加机器) 水平扩展是手段(加机器而非换机器) 分片是数据层的解(数据分散才能扩展) 异步化是润滑剂(解耦和削峰,让系统更流畅) 热点治理是保险(局部不崩,全局才稳)
这五大支柱不是孤立的,它们相互依赖、协同工作。无状态化让水平扩展成为可能,分片解决了数据层的扩展瓶颈,异步化解耦了同步链路,而热点治理则确保扩展的均匀性。
面试中如何展现架构思维:
- 被问到"如何设计一个高并发系统"时,不要直接跳到方案,先展示你的分析框架——从无状态化开始,依次讨论各层扩展策略
- 每个设计决策都要能说出"为什么"——为什么选一致性哈希而非取模?为什么选推模式而非拉模式?
- 主动提及每个选择的代价和替代方案——面试官更看重你的权衡能力,而非"正确答案"
- 用数据说话——"这个方案能把热点 QPS 从 10 万降到 1000",比"这个方案能解决热点问题"有说服力得多
九、面试官视角提问
以下问题来自面试官视角,考察你对可扩展架构的深度理解和实战经验。建议在阅读完正文后,尝试独立回答。
Q1:你设计了一个无状态的服务,部署了 10 台机器,每台能处理 1000 QPS。但实际压测发现,10 台机器的总 QPS 只有 7000 而非 10000,线性扩展比只有 70%。请分析可能的原因。如果要定位具体瓶颈,你会怎么做?
Q2:你决定对订单表按 user_id 进行 Hash 分片,分 16 个库。运营提了一个需求:需要按订单金额排序,查询近 7 天金额最高的 100 个订单。这个查询在分片架构下如何实现?请至少给出两种方案,并分析各自的优劣。
Q3:一致性哈希中,如果节点数量较少(如 3 个),即使加了虚拟节点,数据分布也可能不均匀——某个节点可能分配到 45% 的数据,另一个只有 25%。你如何改进一致性哈希的均匀性?除了虚拟节点,还有哪些手段?
Q4:你的团队将一个同步下单流程改为异步化之后,客服每天收到大量投诉:"下单成功了但优惠券没扣"、"积分没有增加"。请分析异步化引入了什么问题,以及如何系统性地解决这些问题。
Q5:Redis Cluster 中,某个热点 Key 的 QPS 达到 20 万,单分片 CPU 100%。你决定用本地缓存解决,但本地缓存带来了数据不一致问题——库存数量在多个实例间不一致。请设计一个方案,既能解决热点问题,又能保证库存扣减的准确性。
Q6:你负责的系统从单体架构演进到微服务架构,需要进行数据拆分。原来的订单表有关联查询用户表和商品表。请设计数据拆分方案,并说明如何处理跨库 Join、分布式事务和全局 ID 三个核心问题。
本文是"Java 技术专家 / 架构师面试:250 个高频考点"系列的第 195 篇。下一篇预告:系统容量规划——峰值流量、吞吐、延迟、存储、带宽和资源预算。