阅读时间:约 40-50 分钟 关键词:推荐系统、召回、排序、重排、协同过滤、向量化召回、冷启动、实时特征、AB实验、特征平台
一、引言:推荐系统为什么是"系统"而非"算法"
很多人把推荐系统等同于推荐算法——协同过滤、矩阵分解、深度学习。但真正面试中,面试官想听到的远不止算法本身。推荐系统是一个工程系统,它涉及数据管道、在线服务、模型更新、AB实验、特征工程、延迟优化等一系列工程问题。
一个典型的工业级推荐系统,每天处理数十亿次请求,每次请求必须在 100ms 以内完成从数据获取到结果返回的全链路。这种量级下,算法的精度提升 1% 和系统的延迟降低 10ms,往往后者对业务指标的贡献更大。
本文从系统设计视角出发,覆盖推荐系统的四个核心环节——召回、排序、重排——以及冷启动、实时特征、在线服务、AB实验等工程关键问题。
本文的核心脉络:
- 推荐系统的整体架构和数据流
- 召回层:多路召回策略与协同过滤
- 排序层:从逻辑回归到深度学习的模型演进
- 重排层:多样性、打散与业务规则
- 冷启动:用户、物品、系统三个层面的解决策略
- 实时特征与在线服务:特征平台、模型推理、性能优化
- AB实验:离线评估与在线实验的设计
二、推荐系统整体架构:漏斗模型
2.1 为什么是漏斗?
工业级推荐系统普遍采用漏斗架构:召回 → 粗排 → 精排 → 重排。每一层逐步缩小候选集规模,同时逐步提高模型的复杂度。
| 层级 | 候选集规模 | 单 Item 计算量 | 延迟预算 | 核心目标 |
|---|---|---|---|---|
| 召回 | 百万→千 | 极低 | ~20ms | 不漏掉用户可能感兴趣的 |
| 粗排 | 千→百 | 低 | ~10ms | 快速过滤明显不相关的 |
| 精排 | 百→十 | 高 | ~30ms | 精确预估点击率/转化率 |
| 重排 | 十→N | 中 | ~10ms | 多样性、打散、业务规则 |
这个漏斗设计的核心思想是计算资源的合理分配:在百万级候选上做复杂模型推理是不可行的,所以先用简单高效的方法快速缩小候选集,再用复杂模型精细排序。 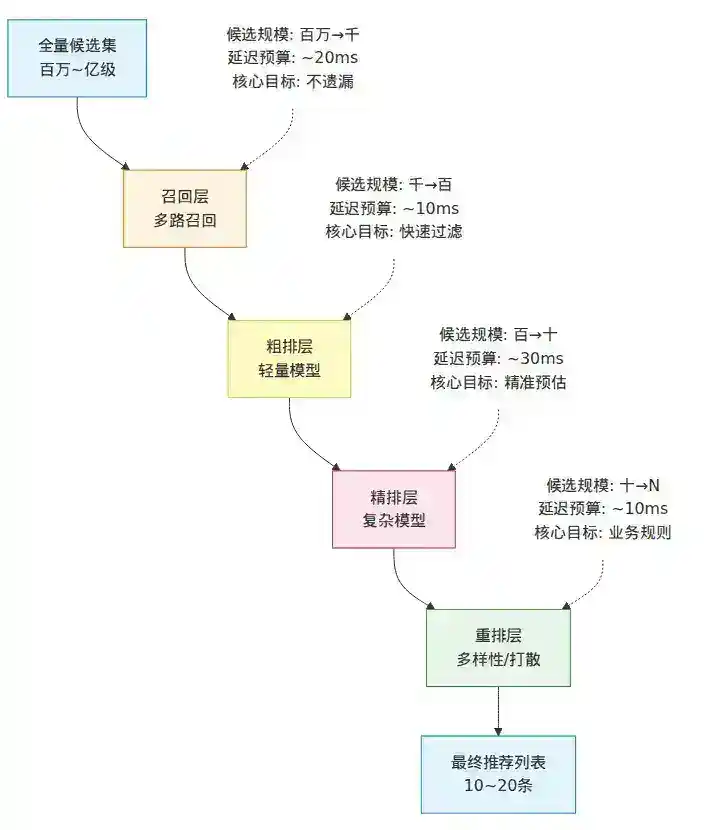
▲ 推荐系统漏斗架构:召回→粗排→精排→重排,每层逐步缩小候选集规模
2.2 数据流全景
推荐系统的数据流可以分为离线和在线两条路径:
- 离线路径:用户行为日志 → 数据清洗 → 特征工程 → 模型训练 → 模型部署
- 在线路径:用户请求 → 特征获取 → 召回 → 排序 → 重排 → 返回结果
两条路径的核心纽带是特征平台和模型仓库。离线训练的模型和特征,需要在在线服务中以极低延迟的方式被访问。 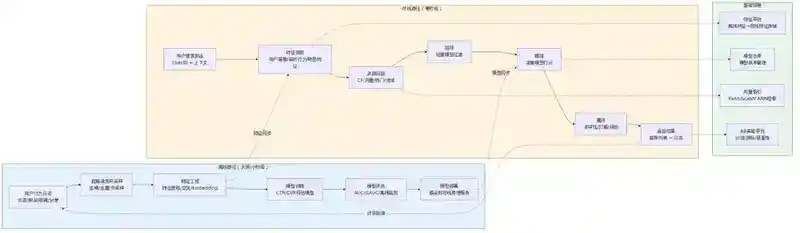
▲ 推荐系统数据流全景:离线训练路径与在线推理路径的完整链路
三、召回层:多路召回与协同过滤
3.1 召回的核心问题
召回层的输入是全量候选集(百万到亿级),输出是少量候选集(百到千级)。它的核心矛盾是:计算量太大,不能逐个计算,必须用索引或近似方法快速筛选。
3.2 多路召回策略
单一召回策略往往有盲区,工业界普遍采用多路召回,每条路有独立的索引和召回逻辑:
| 召回路 | 原理 | 优势 | 局限 |
|---|---|---|---|
| 协同过滤 | 相似用户/物品的交互历史 | 可解释性强,发现意外兴趣 | 冷启动困难,稀疏性问题 |
| 向量化召回 | 用户/物品 Embedding 内积 | 语义理解,跨域迁移 | 可解释性弱,训练成本高 |
| 热门召回 | 全局热门物品 | 简单可靠,兜底 | 个性化弱 |
| 地域召回 | 同城/附近的内容 | 本地化相关性强 | 覆盖有限 |
| 社交召回 | 好友/关注的行为 | 社交信任背书 | 依赖社交关系 |
| 实时兴趣召回 | 近期行为的即时反馈 | 捕捉短期兴趣 | 数据稀疏 |
多路召回后需要做合并去重,归并策略通常是根据各路召回的置信度做加权融合,或者直接保留所有结果交给粗排层处理。
3.3 协同过滤:UserCF 与 ItemCF
协同过滤(Collaborative Filtering)是推荐系统最经典的算法,核心思想是"跟你相似的人喜欢的东西你也可能喜欢"。
UserCF(基于用户的协同过滤):
- 计算用户之间的相似度(余弦相似度、皮尔逊相关系数)
- 找到与目标用户最相似的 K 个用户
- 将这些用户喜欢但目标用户未交互过的物品推荐给目标用户
ItemCF(基于物品的协同过滤):
- 计算物品之间的相似度(基于共同被哪些用户交互过)
- 对于目标用户交互过的物品,找到与其相似的物品
- 将这些相似物品推荐给用户
两者的核心差异:
| 维度 | UserCF | ItemCF |
|---|---|---|
| 适用场景 | 用户数少于物品数 | 物品数少于用户数(电商常见) |
| 实时性 | 用户有新行为后推荐变化慢 | 用户有新行为后推荐实时变化 |
| 冷启动 | 新物品冷启动好,新用户差 | 新用户冷启动好,新物品差 |
| 可解释性 | "跟你相似的人也喜欢" | "跟你喜欢过的物品相似" |
| 计算复杂度 | O(N²) 用户相似度 | O(M²) 物品相似度 |
矩阵分解(MF) 是协同过滤的进阶形式,它将用户-物品交互矩阵分解为用户隐向量和物品隐向量的乘积,解决了原始协同过滤的稀疏性问题,同时隐含了降维和泛化能力。 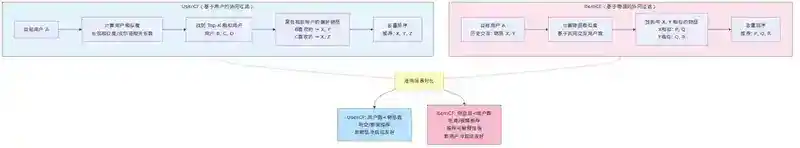
▲ UserCF与ItemCF协同过滤原理对比:找相似用户 vs 找相似物品
3.4 向量化召回(Embedding-based Recall)
向量化召回是近年来的主流方案,核心流程:
- 训练 Embedding:将用户和物品映射到同一个低维向量空间(如 d=128)
- 构建索引:将所有物品的 Embedding 存入向量索引(如 Faiss、ScaNN)
- 在线检索:用户请求到来时,用用户的 Embedding 在索引中做 ANN(近似最近邻)搜索
- 返回 Top-K:返回与用户 Embedding 最相似的 K 个物品
Embedding 训练方法:
- 双塔模型(Two-Tower/DSSM):用户塔和物品塔独立计算,最后点积得到相似度。训练时用用户交互过的物品作为正样本,随机采样作为负样本
- YouTube DNN:将推荐问题转化为极端多分类问题,最后一层 softmax 覆盖所有物品
- Graph Embedding:在用户-物品二部图上做随机游走(如 DeepWalk、Node2Vec),生成 Embedding
向量索引选型:
| 索引类型 | 原理 | 召回率 | 速度 | 内存 |
|---|---|---|---|---|
| Flat(暴力搜索) | 逐个计算内积 | 100% | 慢 | 低 |
| IVF(倒排索引) | 聚类后只在最近几个类中搜索 | 95-99% | 快 | 中 |
| HNSW(图索引) | 构建多层可导航小世界图 | 98-99% | 很快 | 高 |
| PQ(乘积量化) | 向量分段量化压缩 | 90-95% | 快 | 很低 |
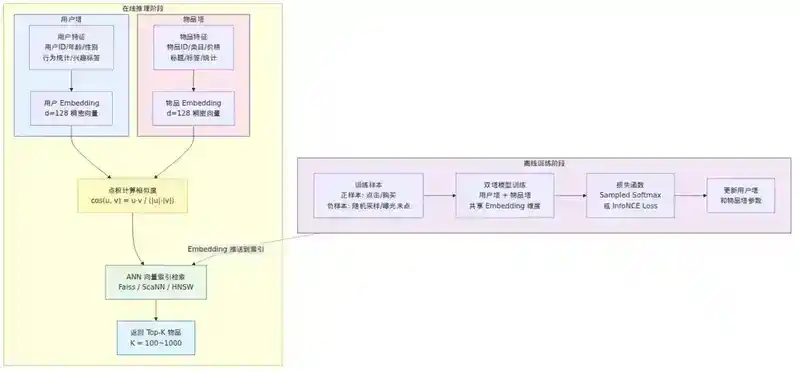
▲ 向量化召回双塔模型:用户塔与物品塔独立计算Embedding,ANN检索Top-K
四、排序层:从 LR 到 DeepFM 的模型演进
4.1 排序层的目标
排序层(特别是精排)的核心目标是准确预估用户对物品的偏好,通常建模为 CTR(点击率)预估或 CVR(转化率)预估。排序层的输入是召回层产出的数百个候选,输出是按预估分数排序的列表。
4.2 特征工程
特征工程是排序模型效果的关键。推荐系统中的特征可以分为以下几类:
| 特征类别 | 示例 | 特点 |
|---|---|---|
| 用户画像 | 年龄、性别、消费水平、兴趣标签 | 相对稳定 |
| 用户行为统计 | 近7天点击次数、近30天购买品类分布 | 周期性更新 |
| 物品属性 | 类目、价格、品牌、发布时间 | 相对稳定 |
| 物品统计特征 | CTR、收藏数、好评率 | 实时更新 |
| 上下文特征 | 时间(早/中/晚)、设备、网络、位置 | 请求时确定 |
| 交叉特征 | 用户品类偏好 × 物品品类 | 需人工设计或自动学习 |
| 序列特征 | 用户最近 N 次行为序列 | 捕捉短期兴趣演变 |
特征处理的关键技术:
- 离散化/分桶:连续特征(如价格)离散化为桶,降低噪声
- 特征交叉:人工特征交叉(如
gender × category)是早期 LR 模型的核心 - Embedding:高维稀疏特征(如用户 ID、物品 ID)通过 Embedding 降维为稠密向量
- 特征归一化:数值特征做 z-score 或 min-max 归一化,避免梯度问题
4.3 模型演进路线
第一阶段:LR + 人工特征交叉
逻辑回归(Logistic Regression)是推荐系统的起点。模型简单、可解释性强、训练快。但 LR 是线性模型,无法自动学习特征交叉,需要人工设计大量交叉特征,被称为"特征工程的艺术"。
第二阶段:GBDT + LR
Facebook 2014 年提出:用 GBDT 自动做特征变换,将原始特征映射为高阶特征,再输入 LR。GBDT 的叶子节点 ID 作为新的特征,实现了自动特征交叉,效果大幅提升。
第三阶段:FM / FFM
FM(Factorization Machines)引入了特征隐向量的概念,为每个特征学习一个低维 Embedding,通过隐向量内积自动建模二阶特征交叉。解决了 LR 需要人工设计交叉特征的问题,同时参数规模从 O(N²) 降至 O(Nk)。
FFM(Field-aware FM)进一步引入特征域(Field)的概念,同一个特征对不同域的特征有不同的隐向量。
第四阶段:Wide & Deep / DeepFM / DCN
深度学习时代,推荐模型进入"记忆 + 泛化"双路架构:
- Wide & Deep(Google 2016):Wide 部分(LR)负责记忆(记住历史共现模式),Deep 部分(DNN)负责泛化(学习未出现的特征组合)。两者输出相加后 sigmoid。
- DeepFM(华为 2017):用 FM 替代 Wide 部分的 LR,FM 和 DNN 共享 Embedding 层。FM 负责低阶特征交叉,DNN 负责高阶特征交叉。
- DCN/DCN-V2(Google 2017/2020):引入 Cross Network,通过显式的交叉层($x_{l+1} = x_0 x_l^T w_l + b_l + x_l$ )学习有界的高阶特征交叉。DCN-V2 进一步将 Cross Network 从向量级升级为矩阵级。
第五阶段:多任务学习与序列模型
- 多任务学习(MTL):同时预估 CTR、CVR、时长等多个目标。典型架构如 ESMM(CVR 预估,用 CTR 和 CTCVR 辅助)、MMOE(多门控专家混合)、PLE(渐进式分层提取)。
- 序列模型:捕捉用户行为序列中的兴趣演变。DIN(Deep Interest Network)用注意力机制对用户历史行为加权;DIEN 引入 GRU 建模兴趣演化;SIM 用两阶段检索处理超长序列。
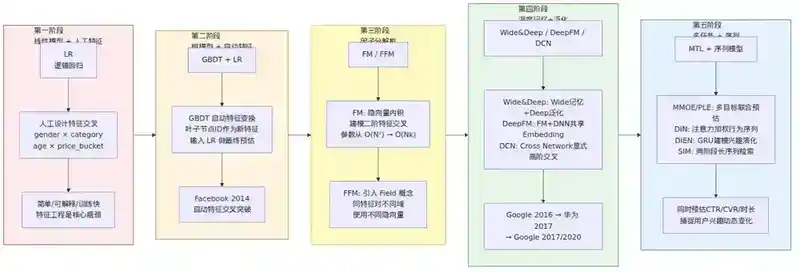
文章配图
▲ 排序模型演进路线:LR→GBDT+LR→FM/FFM→Wide&Deep/DeepFM/DCN→多任务学习→序列模型
4.4 模型训练与更新
排序模型的训练和更新需要解决几个关键问题:
- 样本选择:正样本通常是有点击/转化的曝光,但负样本的选择很微妙——未点击 ≠ 不喜欢,可能只是没看到。实践中常用"曝光未点击"作为负样本,但需注意位置偏差(position bias)。
- 样本权重:有时需要根据业务目标给样本加权,如高价值用户的样本权重更高。
- 模型更新策略:
- 全量更新:每天用全量数据重新训练,计算量大但稳定
- 增量更新:在线学习,实时更新模型参数,能快速捕捉热点变化
- 天级全量 + 小时级增量:工业界常见方案,兼顾稳定性和时效性
五、重排层:多样性、打散与业务规则
5.1 重排的核心价值
精排层给出的排序是"逐 Item 独立打分"的结果,可能出现以下问题:
- 同一品类/作者的内容扎堆出现
- 低质量但点击率高的"标题党"内容排在前面
- 不符合业务规则(如敏感内容需降权)
重排层在精排结果上做全局优化,保证最终推荐列表的质量。
5.2 多样性打散
MMR(Maximal Marginal Relevance) 是最经典的多样性算法:
$MMR = \arg\max_{D_i \in R \setminus S} [\lambda \cdot \text{relevance}(D_i) - (1-\lambda) \cdot \max_{D_j \in S} \text{similarity}(D_i, D_j)]$
逐步选择候选,每次选择既相关(relevance 高)又不与已选结果过于相似(similarity 低)的 Item。
滑动窗口打散:确保同一品类在连续 N 个位置中最多出现 K 次。简单高效,是最常用的工程方案。
DPP(Determinantal Point Process):基于行列式点过程的多样性方法,通过核矩阵的行列式来同时衡量集合的质量和多样性。理论上更优雅,但计算复杂度高,通常用快速贪心算法近似。
5.3 常见重排策略
| 策略 | 说明 | 示例 |
|---|---|---|
| 品类打散 | 同一品类不连续出现 | 手机→衣服→手机→食品 |
| 作者打散 | 同一作者不连续出现 | 避免刷屏 |
| 强插/固定位 | 运营指定位置插入特定内容 | 第3位固定放活动 Banner |
| 降权/过滤 | 某些条件下降低分数或移除 | 低质量内容、敏感内容 |
| 去重 | 跨路去重、历史去重 | 已购买/已读的不再推荐 |
| 探索位 | 预留位置给新内容探索 | 第10位放新上架商品 |
六、冷启动问题
冷启动是推荐系统的"阿喀琉斯之踵"——无论模型多精妙,没有数据就是没有推荐。
6.1 用户冷启动
新用户没有任何行为数据,推荐的策略包括:
- 热门推荐:推荐全局热门内容,作为冷启动的兜底
- 人口统计推荐:基于年龄、性别、地域等画像信息做粗粒度推荐
- 注册引导:让用户选择兴趣标签,基于标签推荐
- 社交导入:通过社交关系链,推荐好友喜欢的内容
- 跨域迁移:如果用户在其他产品域有行为数据,可以通过用户 ID 映射迁移兴趣信号
- Exploration-Exploitation 平衡:通过 Bandit 算法(如 UCB、Thompson Sampling)在利用已知偏好和探索新内容之间做权衡
6.2 物品冷启动
新物品没有足够的用户交互数据,推荐的策略包括:
- 内容特征:基于物品的标题、描述、图片、标签等属性做内容推荐
- 协同过滤兜底:新物品上线时,通过类目信息找到相似物品的 Embedding 作为初始值
- 流量扶持:给新物品分配一定的曝光流量(如"新品专区")
- 冷启动池:新物品先在一个小流量池中积累数据,达到阈值后进入正常推荐流程
6.3 系统冷启动
全新系统没有任何数据,推荐策略包括:
- 专家规则:基于领域知识的人工规则(如"新用户推荐入门级商品")
- 内容推荐优先:初期没有行为数据,只能依赖内容特征
- 快速试错迭代:用小流量快速验证不同策略,逐步收敛
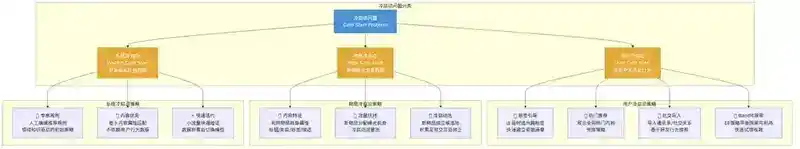
文章配图
▲ 冷启动三元分类解决策略:用户冷启动、物品冷启动、系统冷启动的差异化方案
七、实时特征与在线服务
7.1 特征平台
推荐系统的特征分为离线特征和实时特征:
- 离线特征:每天/每小时批量计算,如用户过去30天的购买品类分布、物品的30天CTR。存储在 KV 存储(如 Redis)中,在线服务时直接读取。
- 实时特征:用户最近的实时行为,如"最近5次点击的品类"、"当前 Session 的行为序列"。需要在流处理框架(如 Flink、Kafka Streams)中实时计算,存储在低延迟存储中。
特征平台的核心职责:
- 统一的特征定义和注册
- 离线/实时特征的计算和存储
- 特征 Serving:在线服务时以极低延迟获取特征
- 特征监控:数据漂移检测、覆盖度监控
- 特征回溯:用于模型训练时获取历史特征快照
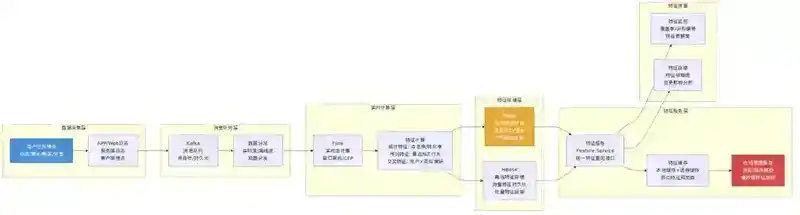
文章配图
▲ 实时特征平台架构:Kafka→Flink实时计算→Redis/HBase存储→在线特征服务读取
7.2 在线服务架构
推荐系统的在线服务需要满足高并发、低延迟、高可用的要求:
请求流:
客户端 → API网关 → 推荐服务 → 召回服务 (多路并行)
                              → 特征服务 (获取用户/物品特征)
                              → 排序服务 (模型推理)
                              → 重排服务 (打散/强插)
关键设计要点:
- 多路召回并行化:各路召回是独立的,可以并行请求,用线程池或异步 IO 实现
- 特征缓存:用户特征可以按 Session 缓存,物品特征在物品信息变更时失效
- 模型推理优化:
- 模型量化(float32 → int8)减少计算量和内存
- 推理引擎优化(TensorRT、ONNX Runtime)
- 模型预热,避免冷启动延迟
- 批量推理(Batching),将多个请求合并为一个 batch
- 降级策略:当某个服务不可用时,用兜底策略(如热门推荐)替代
- 超时控制:每一层设置超时时间,超时则跳过该路或使用缓存结果
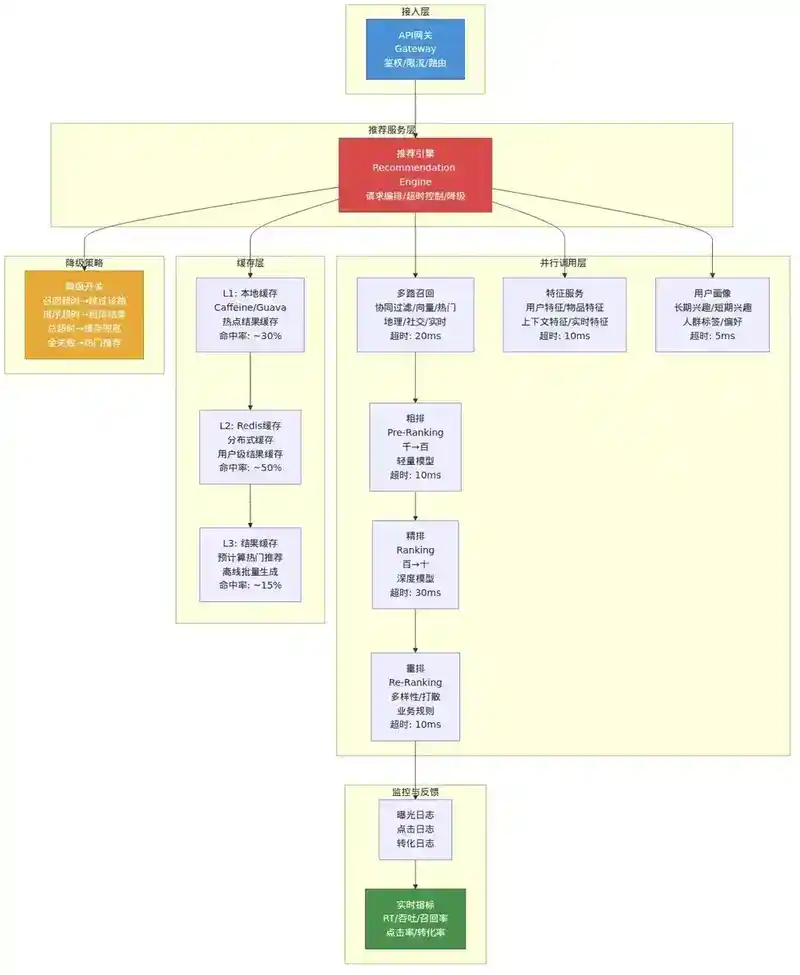
文章配图
▲ 推荐系统在线服务架构:API网关→推荐服务→并行调用召回+特征+排序+重排
7.3 实时特征流
实时特征的计算链路:
用户行为 → Kafka → Flink 实时计算 → Redis/HBase 存储 → 在线特征服务读取
典型实时特征:
- 用户最近 N 次点击的 Item ID 序列
- 用户当前 Session 内的行为统计(点击数、停留时长、浏览深度)
- 物品的实时 CTR(最近 1 小时/5 分钟窗口)
- 地理位置、设备、网络等上下文特征
八、AB实验与效果评估
8.1 离线评估 vs 在线评估
离线评估指标:
- AUC(ROC 曲线下面积):衡量排序模型的区分能力
- NDCG@K:衡量排序质量,位置越靠前权重越高
- Recall@K / Precision@K:召回层的评估指标
- 覆盖率(Coverage):推荐系统覆盖的物品比例
- 多样性(Diversity):推荐列表的类目/作者多样性
离线评估的局限:离线指标好 ≠ 线上效果好。离线评估无法衡量用户满意度、长期留存、推荐新颖性等维度。
在线评估:AB 实验是唯一可信的在线评估方式。
8.2 AB实验设计
AB 实验的核心要素:
- 分流:基于用户 ID 或其他标识符做哈希分流,确保同一用户始终在同一组
- 实验层:多个实验可以共享流量,通过层间正交保证独立性
- 样本量计算:基于预期效果大小(MDE)、显著性水平(α=0.05)、统计功效(1-β=0.8)计算所需样本量
- 核心指标:北极星指标(如 GMV、DAU),护栏指标(如延迟、崩溃率)
- 辛普森悖论:注意分组后的子群分析可能产生反转结论
AB实验平台的功能:
- 实验创建、配置、上线、下线
- 实时指标看板
- 假设检验(t-test、bootstrap、序贯检验)
- 实验报告自动生成
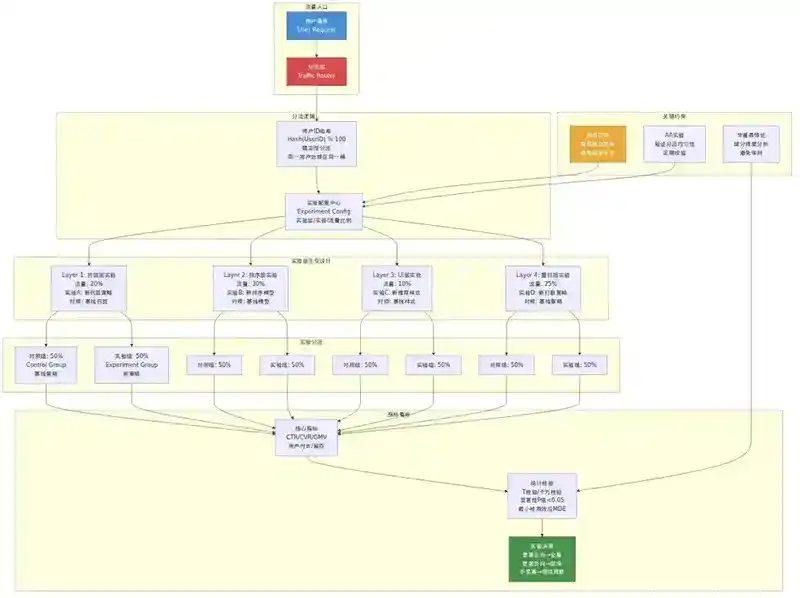
▲ AB实验分流与实验层架构:用户ID哈希分流→实验层正交设计→对照组/实验组→指标看板
流量正交保证
8.3 Interleaving 实验
Interleaving 是 AB 实验的替代方案:将两个算法产生的结果交错混合展示给同一用户,通过用户偏好(点击哪个算法的结果更多)来判断哪个算法更好。优势是方差小、所需样本量少,但由于用户体验混合结果,不适合评估宏观业务指标。
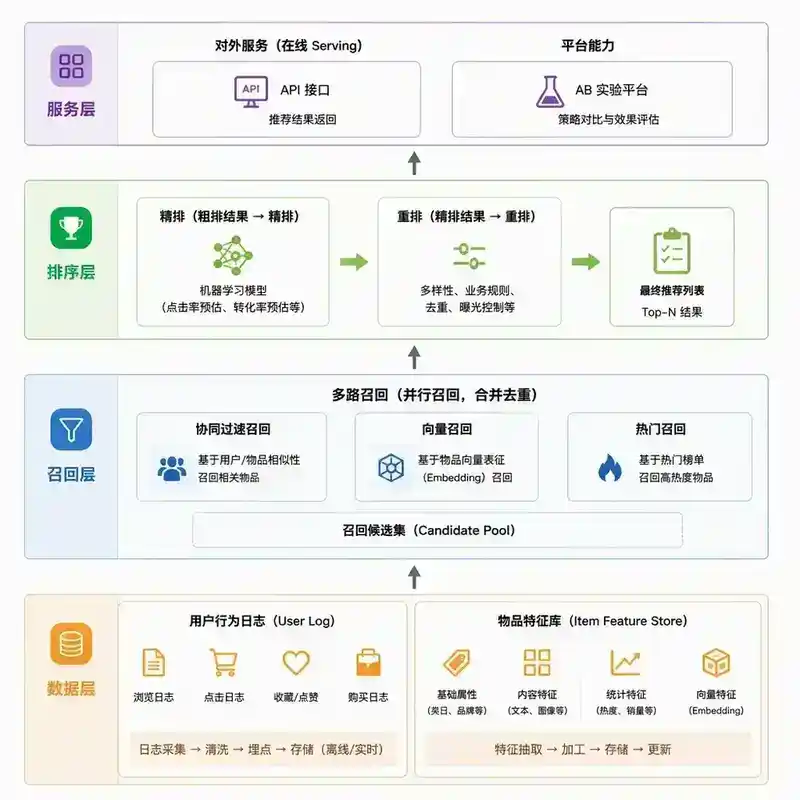
▲ 推荐系统全链路示意:从用户行为产生到"猜你喜欢"结果展示的完整数据流
九、工程实践与常见陷阱
9.1 数据管道
推荐系统的数据管道涵盖:
- 用户行为日志采集(埋点 → Kafka → HDFS/Hive)
- 数据清洗(去重、去噪、反作弊过滤)
- 样本构造(正负样本拼接、特征拼接)
- 特征工程(离线特征计算、特征回填)
9.2 模型管理
- 模型版本管理:每次训练产出的模型需有版本号,支持回滚
- 模型验证:上线前在验证集上评估,确认指标不低于当前线上模型
- 灰度发布:先小流量验证,逐步放量
- 模型监控:线上模型预测分布监控(如预测 CTR 均值是否偏离)
9.3 常见陷阱
- 特征穿越(Feature Leakage):训练时使用了标签之后的信息。例如用"用户是否购买了该商品"作为特征去预测"用户是否会点击该商品"。必须在时间维度上做严格的特征回溯。
- 位置偏差(Position Bias):排在前面的物品天然有更高的点击率,模型会学到"位置靠前 = 好"的错误关联。需要在训练时加入位置特征,推理时置为固定值。
- 反馈循环(Feedback Loop):推荐系统只推荐它认为好的物品,被推荐的物品获得更多曝光和交互,模型进一步强化"这些物品好"的认知,形成马太效应。需要引入探索机制打破循环。
- 数据分布漂移:用户行为模式随时间变化(如季节、节日),模型效果会逐渐衰减。需要定期重训和监控。
- 离线在线不一致:离线训练使用的特征和在线推理使用的特征可能存在差异(如特征计算逻辑不同、数据延迟不同),导致线上效果远差于离线。
十、总结
推荐系统是一个算法 × 工程 × 产品的交叉领域。从系统设计视角看,核心要点包括:
- 漏斗架构是工业级推荐系统的基础范式,召回 → 粗排 → 精排 → 重排,每一层有明确的职责和延迟预算
- 多路召回是保障召回多样性的关键,协同过滤和向量化召回是两条核心路线
- 排序模型从 LR 演进到 DeepFM/DCN/DIN 等深度模型,特征工程始终是决定性因素
- 重排层通过多样性算法和业务规则保证最终推荐列表的质量
- 冷启动需要在用户、物品、系统三个层面分别设计策略
- 实时特征和在线服务决定了推荐系统的用户体验下限
- AB实验是在线效果评估的唯一可信手段
面试提问
以下问题从面试官视角设计,考察对推荐系统的工程理解和深度思考,而非死记硬背。
Q1:你在设计一个推荐系统的召回层时,会选 ItemCF 还是向量化召回?什么场景下 ItemCF 反而更优?
Q2:双塔模型训练时,负样本怎么选?如果只用随机负采样会有什么问题?如何改进?
Q3:精排模型上线后,发现线上 CTR 远低于离线 AUC 对应的水平,你从哪些维度排查?
Q4:推荐系统如何应对"热点事件"(如突发新闻、爆款商品)?从召回、排序、特征三个层面说明。
Q5:精排模型的延迟从 30ms 涨到了 50ms,你如何定位原因?有哪些优化手段?
Q6:AB 实验显示实验组 CTR 显著提升,但用户留存下降了,可能的原因是什么?如何设计实验来避免这种"指标冲突"?
Q7:设计一个电商首页的"猜你喜欢"推荐模块,你的整体架构和数据流是怎样的?容量估算(DAU 1 亿,人均请求 5 次/天,峰值 QPS 是均值的 3 倍)。
Q8:冷启动场景下,推荐系统如何平衡"探索"(Exploration)和"利用"(Exploitation)?除了 ε-greedy 和 UCB,你知道哪些更适用于推荐系统的 Bandit 变体?
Q9:多任务学习(MTL)中,各个任务的 loss 如何加权?如果其中一个任务(如时长预估)的 loss 远大于其他任务怎么办?
Q10:如何处理推荐系统中的"低俗内容"问题?从样本构造、模型设计、重排策略三个层面回答。